登录社区云,与社区用户共同成长
邀请您加入社区
OpenAI发布GPT-6 Sol与Luna,将Astra同代能力下沉到更低价位:API输入/输出价格较GPT-5.6对应型号下降50%,缓存读取折扣90%,并给出AutomationBench、DeepSWE、OSWorld等官方对比。本文梳理双模型定位、关键数据、缓存优化与开发者选型建议,并标出发布页尚未披露的架构、参数与区域可用性等边界。
你有没有遇到过这种情况——让 Claude Code 写了一段代码,看起来完美无缺,测试也过了,合进去之后,线上炸了。不是模型的问题,是你对它的工作机制完全理解错了。大多数人把 Claude Code 当"AI 写代码的工具"来用——给它一个需求,等它吐出代码,Review 一眼,合进去。这个认知,差了整整一个维度。最近,Anthropic 官方团队(包括 Lydia Hallie)做了一场完整的
上周帮运营组写的活动复盘稿,刚上传到企业知识库就被风控系统标了100%AI生成,直接打回不许发。折腾了快两天,把降AI检测率的各种野路子试了一遍,踩了一堆坑。
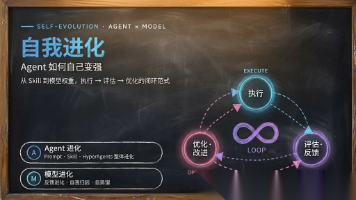
自进化体系的核心设计,可以归纳为两个问题。
最小二乘法 , 二元交叉熵 , 极大似然值
一个 searchhotels 工具要在 schema 里放下 location、checkin、checkout、maxprice 四个字段。这个定义看起来很平常,但粒度、描述、参数约束、返回格式、错误语义五个决策其实已经全部埋在里面。CSDN 上署名 sinat_41617212 的一篇文章正是从这个角度切入,它的核心判断是:实际工程中约 80% 的 Agent 调用错误不是因为模型不够聪明,
从0到1搭建人力分析智能体实践指南,不需要技术背景
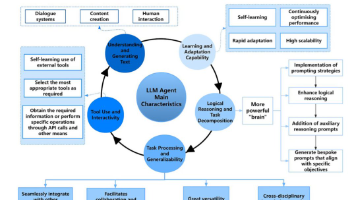
目前学术界对 AI Agent 无统一标准定义,该综述文献综合对比 Castelfranchi、李飞飞团队、Parisi 等学者的定义,采用 Weng(2023)的经典范式,精准适配医疗场景需求:AI Agent = LLM 核心控制器 + 规划模块 + 记忆模块 + 工具使用模块 + 自省模块,本质是具备自主感知、推理、决策、执行能力的智能系统,核心目标是高效、可靠地完成医疗领域复杂多步骤任务。
别做“两个乐观主义者互相点头”的假审查凡是负责 Lint、测试用例通过率、代码质量检查的 Subagent,严禁使用 Fork 模式!一旦审查者知道了编写者的思路,就会默认顺水推舟,漏掉核心边界 Bug。利用 Fork 终结代码探查内耗让 Worker 去修改代码时,大胆开启 Fork 模式,现代大模型的 KV Cache 机制会帮你把成本压到最低,同时直接将前序推导作为前缀,开发效率立竿见影。终
不必下载一大堆软件,也不用挨个对比几十款工具,到处花钱踩坑。从选题、写初稿、查重降重、格式排版再到答辩,思梦航 AI一站式覆盖本科论文绝大多数需求,兼顾专业性、免费权益与安全性,适配各大本科专业。毕业季用好这一款辅助平台,低成本高效率,从容完成毕业🥳温馨提示:AI 生成内容只作为底稿素材,文献、实验数据、核心论点务必人工核对;平台自查结果仅供修改阶段参考,论文最终查重、评审结果以学校官方系统、导
一个面向安全教学、课题研究和本地样本辅助研判的 Web 系统。系统支持上传源代码文件与 EXE、APK 文件,通过机器学习输出分类结果,结合静态规则展示证据,并允许用户手动调用大模型进行二次分析复核。系统不仅提供文件检测,还覆盖数据读取、模型训练、模型评测、版本发布、批量检测、AI 复核和历史追溯,形成较完整的模型使用流程。系统坚持静态分析:不执行上传代码,不启动 EXE,不安装 APK。输出用于
2026 做科研绘图,不再单纯比拼软件熟练度。统计图表交给专业统计软件,示意图利用 AI 快速产出草稿再精细化调整,Figure 排版严格遵循期刊标准。合理搭配工具,能够大幅压缩绘图耗时。
它原生接入飞书,知识层自动同步飞书文档、表格和 wiki,身份层继承组织架构与文档权限,入口层可在飞书内直接发起和接续任务,流程层支持连接器与授权范围内的浏览器操作,成果直接回写为飞书文档、多维表格和任务,四层融合在同一体系内完成。当企业希望 AI 真正承担工作,就会遇到深水区问题——企业多年积累的知识在文档平台和 wiki 里,业务流转在 CRM、ERP、项目系统中,协作发生在办公套件里,AI
本文深入解析了从传统RAG技术向GraphRAG演进的技术路径,详细介绍了知识图谱和本体论如何革新AI问答系统,让AI不仅能检索信息,更能真正理解和推理复杂知识关系,为企业级AI应用提供更精准、更具洞察力的解决方案。知识图谱是现实世界知识的网络化表示,其中每个节点代表一个实体,每条边代表实体间的关系。图2:在线零售数据集的知识(子)图谱示例知识图谱将数据结构化为图形,而不是表格或孤立文档。这意味着
这篇综述论文是行为识别领域的“全景地图”——它不仅告诉你“现在有什么技术”,更重要的是告诉你“为什么单模态已经不够用、为什么伦理必须从头介入、为什么注意力机制是连接感知与认知的桥梁”。对于研究者来说,它提供了从“单一分类问题”转向“多智能体群体理解”的完整路线图。
AIHOT榜单的价格数据揭示了一个清晰的事实:头部模型的能力在同一梯队,但价格差距显著。Kimi K3输入20元输出100元每百万Token,约为Claude Fable 5的三分之一,能力上AIHOT总榜第四、Artificial Analysis逼近头部。单位能力的成本优势是国产AI编程工具的核心竞争力。
传统规则检测速度快、可解释性强,但容易受变形和未知样本影响;单一机器学习模型能够发现统计异常,却难以直接说明异常是否属于 XSS。为解决这一问题,本系统把机器学习异常检测与 XSS 专项规则检测结合起来,同时引入可视化交互、模型全生命周期管理和可选的大模型解释能力,形成从数据、训练、检测、解释到审计的完整闭环。
AI 是一个目标,ML 是达成目标的主流方法,DL 是 ML 里效果最好的一类算法,而 大模型 是 DL 在数据和参数规模放大之后的产物。
文章摘要:本文探讨了AI在材料配方研发中的应用路径,指出"AI直接给配方"的逆向方案存在局限性,提出"正向预测+逆向优化"的闭环方法。正向预测通过历史数据训练模型预测性能,逆向优化则利用贝叶斯方法推荐实验方向。两者结合形成迭代优化:定义搜索空间→初始建模→逆向推荐→结果回流更新模型。该方法已在电池电解液等研究中验证有效性,能显著减少低效实验。实施需配套数据治
想本地跑大模型却显存告急?llama.cpp 的量化优化算法藏着一门精妙的平衡艺术:混合精度加双重量化,又瘦又精。凭啥又轻又能打?咱们来一探究竟!#llama.cpp #大模型量化 #Q4_K_M #Ollama #大模型本地部署 #模型压缩 #混合精度 #量化原理 #INT4量化 #本地大模型 #权重优化 #知识分享 #原理 #人工智能 #深度学习
AI 没有让前端面试变简单,反而把门槛从「记忆」抬到了「判断」。以前背八股能混过去,现在面试官一句「你打开 AI 改一下」,立刻就能看出你是真的懂,还是只会复制粘贴。如果你也在准备这类面试,不妨先拿自己项目里的一个真实 bug 练一遍上面的 6 步——练的不是代码,是你在 AI 面前的判断力。练的时候最好像面试那样边做边讲,很多时候你不是不会,而是讲不出来。你在面试里遇到过「允许用 AI」的环节吗
用户与AI“吵架”的场景,本质上是AI服务质量的失控。而解决失控的最佳方式,不是在失控后救火,而是在失控前预防。这套后台AI上下文污染巡检与无感拦截系统,就是AI服务的“质检员”——它不直接面对用户,但它确保每一个输出到用户面前的回答,都是准确、相关、符合当前语境的。它让AI从“偶尔靠谱”走向“始终可靠”。这不仅是技术的进步,更是对用户的一种尊重——尊重用户的时间,尊重用户的意图,尊重用户选择与A
标注类别名称(注意yolo格式类别顺序不和这个对应,而以labels文件夹classes.txt为准):["baijiuguo","baixing","chunqiuyu","feiguangwan","feimudan","guanghongqiu","hongshedan","xiangyaqiu","xuebaiqiu","yuhuaqiu"]对应中文类别名:["白鸠球", "白星", "春
温馨提示:结合资源学习效果更加!配套代码路径:src/qa_chain.py、src/retriever.py。详见项目文件资源csdn平台地址:csdn资源--“新手可入门,一套可运行、可配置、可二次开发的私有知识库问答系统完整源码 + 教程笔记 + 工具脚本”资源文件目录展示项目名称:从零搭建一套完整的 RAG 私有知识库问答系统 ,下面我以此作为示例进行分析学习。
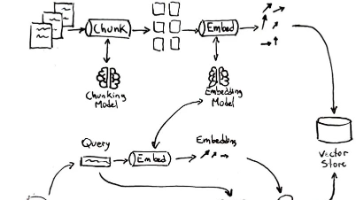
RAG(检索增强生成)是一种结合检索与生成的技术,通过先检索私有知识库再生成答案,解决大模型幻觉问题并实现知识热更新。其架构分为6层:数据源层(多格式输入)、切片层(语义分块)、向量存储层(嵌入向量化)、召回层(多路检索融合)、重排层(精排优化)、生成层(答案合成)。典型优化策略包括调整分块大小、多路召回融合、持久化索引等。该技术能有效提升回答准确性,同时提供可追溯的引用来源。
还有一点必须要说明一下,AI输出的内容是初稿,还需要人工去走读以及核对内容,你要进行3遍处理,并非是写不出内容,是根本没有弄明白情感内容的基本逻辑,最终发布了很多内容,但是数据表现不好。我花了差不多一个月的时间去测试,踩了很多坑,构建了一套能够稳定产出稿件的工作流程,我把自己写过的十篇效果好的文章内容提供给AI,让它去总结用词、句式以及风格结构,使用一段固定的提示语句让AI去探寻选题,通过这样的方
标注类别名称(注意yolo格式类别顺序不和这个对应,而以labels文件夹classes.txt为准):["door","door-closed","door-handle","door-handle-pull","door-knob","door-open","door-puller","folding-door","lever-handle","push-pull-handle","slide
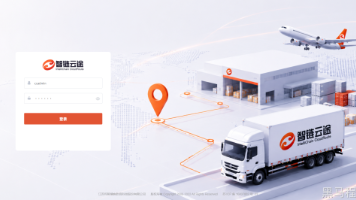
黑马《智链云途》正是在这样的背景下研发而来:以真实物流业务为载体,将传统软件工程+大模型应用+AI智能体+AI预测+工程化落地融合到一个企业级项目中。
从基础CART讲起,带你掌握随机森林全套建模流程,再往深走六个方向:可解释AI(SHAP)、异常检测(孤立森林)、极值建模(分位数RF)、不确定性量化(BART)、因果推断(因果RF)、空间异质性(地理加权RF)。随机森林刚好卡在中间——能预测,也能解释。学完你会发现,随机森林不只是个预测工具,更是拆解复杂系统的显微镜。、异常值识别以及时间序列的处理。回归树模型推广:装袋树、袋外。十一:用贝叶斯可
标注类别名称(注意yolo格式类别顺序不和这个对应,而以labels文件夹classes.txt为准):["baiseyuanding","baojingchufaqi","fanghuotan","jingling","miehuoqi","miehuoxitongbiaozhi","shanguangdengqiu","xiaofangchukou"]对应中文类别名:["白色圆顶", "报警触
【主讲嘉宾更新、成都IEEE出版】2026 人工智能、信息物理系统和智能计算国际学术会议(ICAICI 2026)
实际系统不会把所有知识都返回。100万条 Chunk不可能全部交给大模型。Top-KTop-K = 5也就是:找出最相关的 5 个知识片段。用户问题↓↓Top 5↓Chunk 12Chunk 893Chunk 1024Chunk 2048Chunk 9999RAG││ │↓ ↓【知识库构建】 【用户问答】│ │↓ ↓PDF/Word 用户问题↓ ↓文档解析 Query处理↓ ↓↓ ↓↓ ↓↓ ↓↓
标注类别名称(注意yolo格式类别顺序不和这个对应,而以labels文件夹classes.txt为准):["baolulaji","dianwaijingying","huwaiguanggao","jietoutanfan","zhandao"]数据集格式:Pascal VOC格式+YOLO格式(不包含分割路径的txt文件,仅仅包含jpg图片以及对应的VOC格式xml文件和yolo格式txt文件
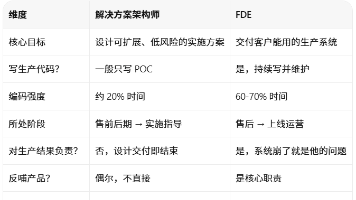
FDE 与解决方案架构师的核心差异解析 前沿部署工程师(FDE)和解决方案架构师(SA)虽在AI落地场景中常被混淆,但二者职能存在本质区别: 角色定位:SA是售前技术顾问,负责将客户需求转化为技术方案(如架构设计、集成规划),交付物以文档为主;FDE是实施专家,需驻场客户现场调试模型、解决生产问题,直接对系统上线效果负责。 技能侧重:SA需技术广度,擅长多领域协调;FDE需工程深度,能独立处理GP
标注类别名称(注意yolo格式类别顺序不和这个对应,而以labels文件夹classes.txt为准):["baoguo","kaixiang","xiangzi","xiangziposun"]数据集格式:Pascal VOC格式+YOLO格式(不包含分割路径的txt文件,仅仅包含jpg图片以及对应的VOC格式xml文件和yolo格式txt文件)对应中文类别名:["包裹", "开箱", "箱子"
Function Calling 教会了模型「如何调用」,而 MCP 正在定义模型「如何连接」。前者是单点能力,后者是生态协议。对于开发者来说,现在是最好的切入点:把团队高频使用的内部能力封装成 MCP Server,既能立即在 Claude、Cursor 等支持 MCP 的工具中受益,也为未来的 Agent 化改造提前布局。从「写 JSON Schema 描述函数」到「发布一个可被任意 AI 应
如果你从未写过代码,看到“编程”两个字就有点发怵,那么这篇文章就是为你准备的。过去,零基础学编程通常意味着:买一本厚厚的基础语法书、反复配置复杂的环境、在报错信息里迷路,最终因为“卡在第一步”而放弃。很多人不是学不会,而是还没真正开始,就被“安装环境”“看不懂文档”“找不到人问”这三座大山劝退了。但现在情况完全不同了——AI 工具可以帮你解释概念、生成代码、排查错误,甚至陪你一步步完成一个小项目。