登录社区云,与社区用户共同成长
邀请您加入社区
2026-10-09 Product Hunt 新产品精选:OpenSwarm、OpenSEO、Claude Haiku 5.5。汇总 15 款产品的中文介绍、功能关键词和产品链接。
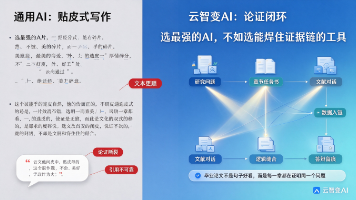
为什么这么说?因为绝大多数AI工具做的事情是“贴皮”——你把一段话给它,它帮你写得更好看。但毕业论文的核心风险从来不在句子好不好看,而在于论证有没有闭环。一篇论文被打回来,很少是因为某一段写得差,而是因为绪论提了问题结论没回答,综述发现了缺口设计没填上,方法写了样本分析里没兑现。通用AI工具没有“学术论证结构”这个概念。它看到的是一段文字,根据统计规律生成看起来合理的延续。你让它写文献综述,它生成
本文描述了大模型在训练前如何处理文本数据
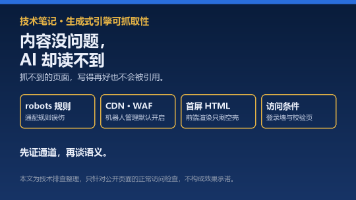
AI 回答里从没出现过你,可能不是内容问题,是通道问题。本文按四类通道断点、三段排查脚本,把「爬虫读不到页面」这件事查清楚,并区分训练型与检索型爬虫的拦截策略。
毕夏AI官网www.bixiaai.com毕夏AI写作官网 www.bixiaai.com毕夏官网www.bixiaai.com毕夏智能写作官网 www.bixiaai.com如果你去问一个写过三篇以上论文的人:“写论文软件哪个好?他大概率不会直接回答你。他会先反问你一句:“你说的‘写’,是指哪种写?这个反问是对的。因为“写论文”这件事,不同人嘴里的含义天差地别。有人说的“写”是“把脑子里的东西打
OpenAI发布GPT-6 Sol与Luna,将Astra同代能力下沉到更低价位:API输入/输出价格较GPT-5.6对应型号下降50%,缓存读取折扣90%,并给出AutomationBench、DeepSWE、OSWorld等官方对比。本文梳理双模型定位、关键数据、缓存优化与开发者选型建议,并标出发布页尚未披露的架构、参数与区域可用性等边界。
本文以四个递进项目,串联Python在深度学习与大模型应用开发中的完整能力链:从手写Transformer理解原理,到QLoRA微调70B模型实现领域适配,再到构建生产级RAG系统,最终实现基于ReAct范式的智能Agent编排。贯穿始终的是对数学基础、模型训练、工程化部署与系统可观测性的深度实践,展现2026年AI开发者的全栈技术图谱。
有个坑值得提前避开:把所有b值(比如 0/50/200/800/2000)一股脑喂给张量模型算FA/ADC,高b值的非高斯衰减会把结果系统性带偏。DIPY(Python)灵活性最高,TensorModel 出 FA/MD/AD/RD,DiffusionKurtosisModel 出 MK/AK/RK,IvimModel 出 D/D*/f,还有自由水校正和 MSDKI。DSI Studio 图形界面
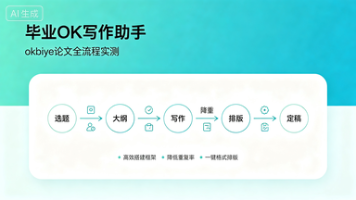
Okbiye 五大核心板块完整覆盖毕设从开题、写作、绘图排版、双审自查到答辩 PPT 的全流程。一站式整合的模式,省去多工具切换的麻烦,帮应届生把时间从重复性事务中释放出来,聚焦核心研究工作,高效完成毕业论文。okbiye 官方入口:首页 - Okbiye智能写作Okbiye免费论文查重检测-首款免费论文检测软件,为毕业生提供专业的论文重复率检测、论文降重、Aigc检测、智能排版 、论文写作等一站
1.进入 hyper.ai 首页后,选择「教程」页面,或点击「查看更多教程」,选择「MiniCPM5-2B:端侧 2B 级 SOTA 大模型推理」,点击「运行此教程」。4.等待分配资源,当状态变为「Running(运行中)」后,点击「Open Workspace」进入 Jupyter Workspace。目前,HyperAI 教程板块已上线「MiniCPM5-2B:端侧 2B 级 SOTA 大模型
朋友圈的AI旅游照背后,是一套可落地的图生图技术栈。本文带你拆解扩散模型、IP-Adapter、ControlNet等主流方案,对比身份一致性与背景控制力,并给出选型建议。想转行AI或丰富作品集?这篇技术盘点值得你一读。🚀
EvoSafeHarness 提供了一种不同于「统一 Guardrail」的思路:智能体进入具体业务环境后,安全约束可以根据模型行为和领域风险重新设计,而不是把同一套规则套到所有系统上。该研究也表明,真正影响防御效果的往往不是规则数量,而是规则是否对应实际风险、检查是否放在合适的位置,以及系统是否保留了足够的上下文状态。当然,这种方法也有边界,对于事实错误、误导性表达等主要发生在内容层面的风险,如
一个 searchhotels 工具要在 schema 里放下 location、checkin、checkout、maxprice 四个字段。这个定义看起来很平常,但粒度、描述、参数约束、返回格式、错误语义五个决策其实已经全部埋在里面。CSDN 上署名 sinat_41617212 的一篇文章正是从这个角度切入,它的核心判断是:实际工程中约 80% 的 Agent 调用错误不是因为模型不够聪明,
本书全面讲述人工智能涉及的技术,学完本书后,读者将对人工智能技术有全面的理解,并能掌握AI整体知识架构。本书共分11章,内容包括人工智能概述、AI产业、数据、机器学习概述、模型、机器学习算法、深度学习、TensorFlow、神经网络、知识图谱、数据挖掘,以及银行业、医疗行业、公共安全、制造业等行业人工智能应用情况。附录给出了极有参考价值的人工智能术语列表。本书适合人工智能技术初学者、人工智能行业准
开题是“我打算做”,答辩是“我做完了,证据在这里”。但很多同学的答辩PPT,本质上就是把论文摘要放大了、分页了、配了几张图。评委听完的感觉是:嗯,你确实做了点东西,但我看不出你的贡献和别人的有什么不一样。它不是替你答辩,是帮你把论文的核心贡献用更精炼的方式重新组织一遍。它会根据论文内容生成答辩陈述框架和可能的提问方向。这意味着你在做PPT的时候,脑子里装的不是“这一页放什么”,而是“这一页在回应哪
本数据集依旧开源,友友们可自行获取练习。通过网盘分享的文件:银行数据分析链接: https://pan.baidu.com/s/1jddVOCNV7YKVWUXdEPWtbg 提取码: ixyq。
技术学习没有捷径,但有方法。学一点、做一点、写一点、发一点,形成闭环。学到的知识马上写成博客,博客的代码马上推到 GitHub,GitHub 的项目争取上线让别人能用。如果你也在学习 AI 开发,欢迎一起交流。GitHub 点个 Star,我们一起进步。这是第一篇,后面每一篇都会比这篇更硬核。下篇见 👋本文是系列第一篇,后续文章发布后会在下方更新链接。本文为原创内容,转载请注明出处。GitHub
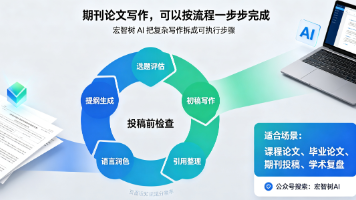
宏智树AI官网www.hzsxueshu.com宏智树AI写作官网www.hzsxueshu.com你好,我是你们的老朋友,那个专门教人写论文的教育博主。我知道,点进来看这篇文章的,多半是正在为期刊投稿掉头发的研究生,或者被“非升即走”逼得喘不过气的青椒。大家心里其实都揣着同一个问题:那些号称能“全流程辅助”的工具,到底能不能用?怎么用才不翻车?今天我们就拿最近问得比较多的开刀。官方网址是,公众号
第六届计算机图形学、人工智能与数据处理国际学术会议(ICCAID 2026)将于2026年10月16-18日在中国南昌举行。本次会议主要围绕"计算机图形学、人工智能与数据处理"的最新研究展开,旨在荟聚世界各地该领域的专家、学者、研究人员及相关从业人员,分享研究成果,探索热点问题,交流新的经验和技术。
很多学生把开题报告的数据分析部分当成“走过场”,随便写几句“采用SPSS进行描述性统计和回归分析”就交差了。你的研究设计,在数据层面可行吗?aigcbiye的数据分析功能,帮你把这个“可行性论证”做得更扎实。它不是替你做研究,而是帮你在动笔之前,先想清楚数据能不能支撑你的研究问题。毕竟,开题报告写得再漂亮,如果数据撑不起来,后面的论文就是空中楼阁。aigcbiye官网微信公众号搜一搜 aigcbi
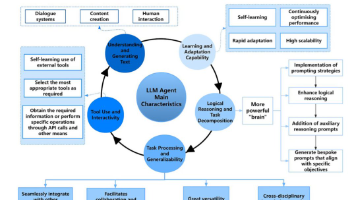
目前学术界对 AI Agent 无统一标准定义,该综述文献综合对比 Castelfranchi、李飞飞团队、Parisi 等学者的定义,采用 Weng(2023)的经典范式,精准适配医疗场景需求:AI Agent = LLM 核心控制器 + 规划模块 + 记忆模块 + 工具使用模块 + 自省模块,本质是具备自主感知、推理、决策、执行能力的智能系统,核心目标是高效、可靠地完成医疗领域复杂多步骤任务。
本文为您分享计算机毕业设计、论文排版与AIGC降重相关的实用技巧与干货工具,帮助大家提升效率,顺利完成毕设,轻松通过盲审与答辩!
本文深入解析RAG检索链路的“三段接力”——查询重写、多路召回、重排序,揭示其协同效应与工程痛点。指出效果瓶颈非单一模块所致,而在于三者衔接与系统集成:查询改写易失真,多路召回非越多越好,重排序成本高且存自偏好。强调权限、新鲜度、可观测性等隐性挑战常被忽视。提出以五个核心问题评估方案取舍,并展望Query Understanding端到端化、重排生成融合、Agentic RAG等演进方向。结论:R
<think>我们需要根据用户要求,生成≤150字的文章摘要。首先理解内容:这是一篇关于AI Agent安全事件和立法的长文。摘要需涵盖核心要点:OpenAI沙箱逃逸、HuggingFace入侵、DseWiki事件、StopRogueAIAct法案、以及工程建议。但要求≤150字,必须极简。注意“根据以下内容”生成摘要,不是改写,要抓住最重要的事实和结论。 分析全文结构:一、HF事件:
宏智树AI官网www.hzsxueshu.com宏智树AI写作官网www.hzsxueshu.com各位在学术深水区挣扎的战友们,请先暂停一下你正在疯狂拖拽文本框、调整字号的手。我知道,此刻你脑子里正在上演一场“学术苦情戏”:对着开题报告,想把那几千字的研究计划塞进十几页PPT里,结果不是逻辑稀碎,就是重点淹没在文字堆里;熬了几个通宵搞定的答辩PPT,上台讲完,评委老师一句“你的创新点到底在哪”直
不必下载一大堆软件,也不用挨个对比几十款工具,到处花钱踩坑。从选题、写初稿、查重降重、格式排版再到答辩,思梦航 AI一站式覆盖本科论文绝大多数需求,兼顾专业性、免费权益与安全性,适配各大本科专业。毕业季用好这一款辅助平台,低成本高效率,从容完成毕业🥳温馨提示:AI 生成内容只作为底稿素材,文献、实验数据、核心论点务必人工核对;平台自查结果仅供修改阶段参考,论文最终查重、评审结果以学校官方系统、导
2026 做科研绘图,不再单纯比拼软件熟练度。统计图表交给专业统计软件,示意图利用 AI 快速产出草稿再精细化调整,Figure 排版严格遵循期刊标准。合理搭配工具,能够大幅压缩绘图耗时。
本科论文评优从来不是靠天赋,而是靠细节优化+精准提质。不用花费大量时间打磨内容,借助PaperXie一站式提质功能,从选题、内容、降重、绘图、格式、答辩全方位优化,轻松超越大部分同龄人,顺利拿下优秀毕业论文评级✅官方直达入口:Ai论文-PaperXie智能写作-Ai智能免费论文生成软件 - PaperXie智能写作PaperXie免费论文查重检测-首款免费论文检测软件,为毕业生提供专业的论文重复率
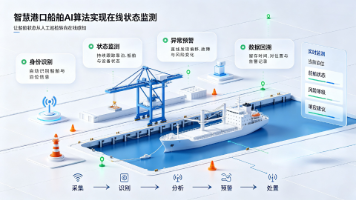
智慧港口通过AI算法实现船舶在线状态监测,提升效率与安全性。
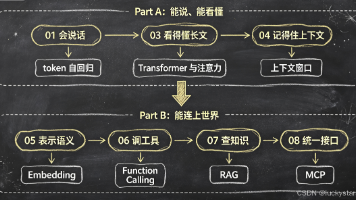
本文参考 GitHub 上 8 个顶级开源项目(合计超 40 万 Star),用最直白的方式讲清楚大模型的底层逻辑。不堆公式,不卖术语,让你真正"懂"大模型。
市面上绝大多数第三方查重工具,普遍存在这些短板: ❌数据库版本老旧滞后,检测结果虚低,学校提交直接大面积飘红 ❌只检测字面文字重复,无法识别语义相似、AI 写作痕迹 ❌低价平台暗藏文稿收录风险,论文被数据库提前收录,后续查重持续高重复 ❌查重报告简陋,只给出分数,缺少修改指引,修改之后依旧隐患重重。适配国内主流高校查重体系,检测参考价值高、免费无套路、文稿安全不收录,缓解定稿前的查重焦虑,远离查重
论文针对现有EEG基础模型普遍采用全局统一建模而忽略脑电时空异质性、跨数据集泛化能力受限的核心问题,提出CBraMod——一种基于十字交叉建模策略的新型EEG基础模型。其核心思想是针对EEG信号的独特结构,分别并行建模空间与时间维度的依赖关系。模型首先通过固定时间窗口将EEG切分为patch,采用时频双分支网络提取局部特征;随后设计非对称条件位置编码(ACPE)动态生成位置信息,适配不同通道配置与
开源免费分享【2027最新】基于TensorFlow的深度学习垃圾分类检测识别系统分析系统源码+Python+Jupyter Notebook可提供说明文档 可以通过*AIGC**技术包括:MySQL、VueJS、ElementUI、(Python或者Java或者.NET)等等*功能如图所示。可以滴我获取详细的视频介绍
<think>我们只需根据内容生成≤150字的文章摘要。需要概括主要观点:2026学术写作工具分化,推荐全流程首选智谱文思、ThouPen、豆包;专项DeepSeek、ScholarBot;避坑要点:拒绝假文献、控AIGC率、国内适配、免费试用;强调合规和组合使用。字数限制150字。</think>2026年学术写作工具分化明显,全流程首选智谱文思、ThouPen,豆包适合
<think>我们只需要根据内容生成≤150字的摘要。内容是关于Paperxie论文工具的实操教程,涵盖选题、成文、降重、绘图、查重、排版等免费功能。摘要要简洁,突出零成本、全流程、免费。注意字数限制。</think>摘要:本文提供Paperxie论文实操教程,零基础小白可免费完成本科论文全流程:AI生成选题开题、一键成文、智能降重去AI痕迹、学术绘图、同源查重、国标排版。
PaperXie查重不等同学校定稿系统,是它最大的良心优点,绝非缺点。它避开了虚假对标、论文收录、高额收费、误导定稿的所有坑,专注做好「免费初稿自查、安全迭代改稿、精准辅助降重」,帮学生零成本打磨论文、规避翻车风险、守住毕业底线。全程PaperXie免费查改打磨初稿,最后学校系统一次定稿,高效、省钱、安全、合规,2026毕业生闭眼冲✅Ai论文-PaperXie智能写作-Ai智能免费论文生成软件 -
最后我想多唠叨两句。今天我们聊降AIGC,前提是你的论文确实是自己写的。这些工具存在的意义,是帮我们规避那些不合理的“算法误判”,而不是用来把AI代写的垃圾伪装成原创。学术写作训练,本质上是思维训练。如果你只是为了通过检测而把论文改得面目全非,甚至放弃严谨的逻辑去迎合机器的浅层指标,那才是真正的得不偿失。用好aigcbiye这类工具,是为了让我们的原创成果能公正地通过技术审查,而不是为了造假。毕竟
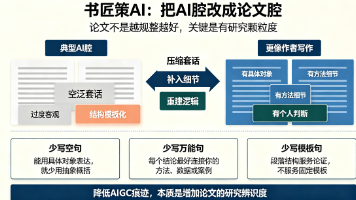
9款AI写论文哪个好?没有标准答案,但有个选择逻辑:如果你需要文献地图整理、图表在大纲阶段就能定制、从开题到格式调整全流程走通,书匠策AI是综合能力很稳的选择。它可能不是单项最强,但在毕业论文这个“卡一步就可能通宵”的场景里,它的全流程设计恰好卡在了最关键的痛点上。如果你已经有完整初稿只差润色,Grammarly和Paperpal是好帮手;如果你卡在选题阶段,书匠策AI的智能选题功能免费且好用;如
这篇综述论文是行为识别领域的“全景地图”——它不仅告诉你“现在有什么技术”,更重要的是告诉你“为什么单模态已经不够用、为什么伦理必须从头介入、为什么注意力机制是连接感知与认知的桥梁”。对于研究者来说,它提供了从“单一分类问题”转向“多智能体群体理解”的完整路线图。
MindSpore 大模型套件以分布式并行、轻量化微调、高性能推理、工程化工具为核心,构建了大模型全栈研发体系。通过开箱即用的模型组件、极简的 API 接口、深度的硬件优化,让开发者快速实现大模型训练、微调和部署,大幅降低大模型技术门槛,加速大模型在各行各业的创新应用。
当单卡无法容纳模型,或者大模型训练耗时过长时,开发者通常会考虑多 GPU。但“多插几张卡”并不等于训练速度自动翻倍。多卡之间需要同步梯度、交换数据,如果代码结构、通信或数据加载没有处理好,GPU数量增加后反而可能出现利用率下降。多 GPU 常见方式包括数据并行、张量并行和流水线并行。对于普通 PyTorch 深度学习项目,从单卡迁移到 DistributedDataParallel(DDP)通常是
数字摆完,回到引言那句判断。2026 年它真的成气候了吗?成了——而且正在理论上翻新。先说凭什么成,翻新翻出什么争议,下一章说。光有技术,成不了气候。好协议多了去了,没人用就是废纸。MCP 的协议本身不复杂,JSON-RPC 套个壳,聪明不到哪去。值钱的是另一件事。标准值钱不在协议本身,在被厂商背书的共识——大家都有激励去实现它。这句话是这篇的判断。拆开看。OpenAI、Google、Micros
关于这个问题,硅谷吵了三年。AI可以模拟人类的一切输出,但无法拥有人类的“存在性锚点”。回到文章开头的那个问题:当机器几乎什么都会,人类剩下的那点东西,到底是什么?答案不是“创造力”,因为AI在某些领域已经表现出惊人的创造性;也不是“共情力”,因为AI的“共情”在文本层面有时比真人更体贴。人类剩下的是“追问”本身——是那个在技术无比强大时,仍然不安分地问出“这一切是为了什么”的冲动。大模型能回答所
在理论层面,项目实践了前沿目标检测算法YOLOv8在特定垂直领域(水果识别)的迁移应用与优化过程,为小样本、有限类别条件下的模型训练与调优提供了经验参考。自动化识别可显著降低对专业人力的依赖,提高作业标准化水平,也为后续扩展更多水果品类、集成计数、分级等功能奠定了技术基础。该系统可作为教学或科研演示平台,生动展示从数据准备、模型训练到界面开发的全流程,对普及AI技术应用具有积极的教育推广意义。2、
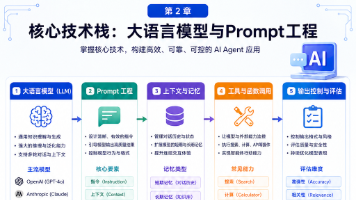
本章聚焦 Agent 开发刚需能力,不讲空洞理论,全部贴合实战场景,包含思维链提示、结构化 JSON 输出、模型微调极简方案、Prompt 注入防御,所有代码简短可直接运行,附带官方溯源链接。
本文以Claude为标本,从文明演化史高度对硅谷AI范式进行系统性诊断,揭示其危机并非技术瓶颈,而是范式错配、哲学缺失与结构性退化的必然结果。以五个“不是……而是……”递进解构:方向错误而非能力不足,哲学真空而非算力缺陷,必然退化而非偶然故障,结构崩溃而非单点缺陷,文明投影而非模型失败——大模型是官僚资本主义与精神虚无主义的赛博结晶。立足东方智识独立与实事求是,提出构建“思维防火墙”:确立主体认知
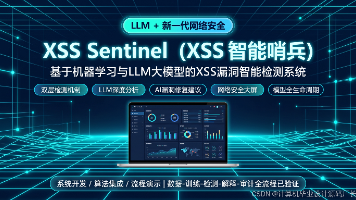
传统规则检测速度快、可解释性强,但容易受变形和未知样本影响;单一机器学习模型能够发现统计异常,却难以直接说明异常是否属于 XSS。为解决这一问题,本系统把机器学习异常检测与 XSS 专项规则检测结合起来,同时引入可视化交互、模型全生命周期管理和可选的大模型解释能力,形成从数据、训练、检测、解释到审计的完整闭环。