你用 Claude Code 的姿势,从根上就错了
你有没有遇到过这种情况——
让 Claude Code 写了一段代码,看起来完美无缺,测试也过了,合进去之后,线上炸了。
不是模型的问题,是你对它的工作机制完全理解错了。
大多数人把 Claude Code 当"AI 写代码的工具"来用——给它一个需求,等它吐出代码,Review 一眼,合进去。
这个认知,差了整整一个维度。
最近,Anthropic 官方团队(包括 Lydia Hallie)做了一场完整的 Claude Code 讲解,从底层原理到真实项目落地,把很多人一直搞不清楚的问题讲透了。
我把这场分享啃了一遍,整理成这篇文章。
先搞清楚一件事:模型本身没有记忆
这是理解 Claude Code 一切行为的前提。
Claude 模型本身是无状态的。 它不知道你上次说了什么,不知道你的文件长什么样,不知道上一个工具调用返回了什么。
那它为什么"看起来"好像记得?
因为有一个东西叫 Agent Harness(代理框架)。
Claude Code Agent Harness 架构
Harness 的职责是:把模型每次推理所需要的"全部上下文",在每一轮重新组装好,喂回给模型。
它维护的内容包括:
- 文件内容(你让它读的文件)
- 终端输出(命令执行的结果)
- Git 分支状态
- 工具调用结果(上一步调用了什么工具、拿到了什么结果)
- 对话历史(你们聊了什么)
每一轮对话,Harness 把这些东西打包,重新组装成一个完整的上下文,交给模型推理。
模型每次推理,都是在这个"重新组装的世界"里工作。
这个认知会改变你对 Claude Code 所有行为的理解——它"记住"了什么,其实是 Harness 记住了,然后在下一轮提示里带给了模型。
真正影响 Claude Code 表现的五个因素
既然模型本身是无状态的,那什么在决定它的表现?
不只是 Prompt。
Lydia Hallie 在分享中明确指出,真正影响 Claude Code 表现的,是这五个因素:
1. CLAUDE.md:给模型的"工程说明书"
CLAUDE.md 是 Claude Code 每次启动都会读取的文件,相当于给模型的项目上下文。
但大多数人写 CLAUDE.md,写的是一堆"注意事项",结果和没写差不多。
正确的写法:把隐性知识显性化。
那些"老员工都知道、但没写在代码里"的约束,才是 CLAUDE.md 的核心内容。比如:
## 关键约束
- 价格字段必须用 long 类型,单位为分,禁止使用 double/float
- 外部服务调用必须设置超时,默认 3000ms,并提供降级方案
- 修改 UserService 前必须检查下游 3 个服务的调用方式

## 高频变更区域
- src/payment/ — 任何改动需要特别谨慎,与结算系统强耦合
- src/config/ — 全局配置,影响范围广,改前必须 grep 引用数
CLAUDE.md 的本质:把资深工程师的决策直觉,写成模型可以精确执行的规则。
如果某个约束不在 CLAUDE.md(或代码库里),对 Claude Code 来说,它就不存在。
2. Skills:把重复流程变成可调用的"技能"
Claude Code 的 Skills(技能)系统,本质上是把一组复杂的操作流程,封装成一个可以随时召唤的"子程序"。
比如代码审查流程,以前每次都要手动告诉它"先检查安全漏洞,再看性能问题,然后……",现在直接 /review-pr,它就执行你预先定义好的完整审查流程。
部署也一样——/deploy 可以触发一整套:构建检查 → 测试验证 → 环境参数确认 → 部署执行 → 结果校验。
Skills 的价值:把"每次都要重新解释的流程",变成"一次定义、反复复用"的工程能力。
这也是为什么 Anthropic 强调,Claude Code 的竞争力不在 Prompt 写得有多好,而在 Skills 设计得有多精密。
3. 权限(Permissions):哪些操作允许、哪些需要询问、哪些直接拒绝
Claude Code 有一套精细的权限控制机制,分三个层级:
|
层级 |
行为 |
示例 |
|
Allow |
自动执行,不打扰你 |
读取文件、运行测试 |
|
Ask |
先询问你确认 |
写入文件、执行命令 |
|
Deny |
直接拒绝 |
删除生产数据、力推代码 |
你可以通过 settings.json 精确控制这些边界。
Auto 模式的价值就在这里: 它不是给模型"更多自由",而是帮你减少重复授权的摩擦——那些你已经信任的操作,不需要每次都点"允许"。
{
  "permissions": {
    "allow": ["Bash(npm test)", "Read", "Glob"],
    "deny": ["Bash(git push --force)"]
  }
}
权限设计得好,Claude Code 工作起来像个默契的同事;权限设计得不好,要么它一直打扰你确认,要么它做了你不希望它做的事。
4. 验证(Verification):你给它设了多少"质量门禁"
这是被低估最严重的一个因素。
Claude Code 本身无法准确评估自己产出的质量。它觉得"完成了",不代表真的完成了——可能测试数为 0,可能核心路径没有验证,可能输出格式不对。
Anthropic 工程博客里总结了 Agent 在复杂项目中的四种典型失败模式:
- One-shot Syndrome:企图在一个上下文窗口内搞定所有事,上下文超 40% 时输出质量快速衰退
- Premature Victory Declaration:做完一部分就宣布任务结束,实际上编译都没过
- Premature Feature Completion:认为功能实现了但没做端到端测试,上线才发现
- Cold Start Problem:跨会话缺乏持久化记忆,每次重新理解项目浪费大量 Token
解法是把验证条件程序化。比如不是说"检查 CI 是否通过",而是:
status == SUCCESS && total_tests > 0 && passed == total
一切不可被机器验证的约束,在 Agent 执行中都是无效约束。
5. Git 工作流:用分支和草稿 PR 把控交付
分享里 Lydia 专门讲了一个实践:让 Claude Code 用分支和草稿 PR 工作,而不是直接在主分支上改。
具体流程:
- 新任务开始 → Claude Code 自动创建特性分支
- 完成后 → 创建草稿 PR(Draft PR)
- 你来审查 → 没问题才 Merge
这个工作流的价值:你始终有一个人工审查节点。 AI 生成代码的速度再快,这个节点不能省。
配合 GitHub CLI(gh),整个过程可以无缝衔接:
# Claude Code 帮你创建草稿 PR
gh pr create --draft --title "feat: 新增用户画像模块" \
  --body "$(cat changes/user-profile/summary.md)"
意图驱动开发:从"给我写个函数"到"帮我实现这个功能"
分享里有一个概念叫 Intent-Driven Development(意图驱动开发),听起来很虚,但背后有很具体的工程含义。
传统的 AI 用法:给它一个具体的指令,它执行,你拿结果。
意图驱动开发:你给它一个目标,它自己拆解成具体步骤,自己执行,自己验证。
区别在哪?
传统用法,你是 PM,给它需求。意图驱动,你是 CTO,给它目标。
实现意图驱动的前提条件,正是前面说的五个因素——CLAUDE.md 提供项目上下文,Skills 封装执行流程,权限控制安全边界,验证机制保证质量,Git 工作流管控交付。
这五个搭建好了,你才能真正说"帮我实现用户认证模块",而不是"帮我写一个 JWT 验证中间件,注意要处理过期情况,记得加单元测试……"。
并行子代理:把"一个 Agent 做所有事"变成"多个专家协作"
分享里让我觉得最有价值的,是关于并行子代理调度的部分。
Claude Code 可以调度多个子代理(Subagents)并行工作。
子代理并行调度架构
一个典型的场景:你让 Claude Code 做一个大型代码重构,它可以:
- 主 Agent(Orchestrator):负责任务规划和协调
- 子 Agent A(分析):分析现有代码结构,输出依赖图
- 子 Agent B(重构):基于分析结果执行具体重构
- 子 Agent C(测试):并行生成和执行测试
- 子 Agent D(文档):同步更新相关文档
这四个子任务,以前是串行的——一个做完再下一个。现在可以并行——能并行的全部并行,总时间大幅压缩。
但并行子代理的关键不是"快",而是"专业化"。
拥有受限工具集的专业 Agent,优于拥有全部权限的通用 Agent。分析 Agent 只能读,不能写;重构 Agent 只能改特定目录;测试 Agent 只能运行测试,不能部署。
Anthropic 的核心发现:"把执行的 Agent 和评判的 Agent 分开,是最强的质量杠杆。"
做事的 Agent 和审查的 Agent,视角天然不同。审查 Agent 不需要"更聪明",它只是用一组不同的检查维度来审视产出物——这本身就能发现做事 Agent 注意不到的问题。
从 Demo 到生产:最重要的那条提醒
分享最后有一段话,我觉得是整场分享最值得反复读的:
AI 能一口气生成一大堆代码,并不意味着这些代码都该被合并。架构、验证、安全、审查和最终质量,仍然要由人来负责。
这句话的分量,在于它揭示了一个普遍的误区:
很多团队把 AI 出码率当成提效的核心指标——出码率 80%,那提效就很高了吧?
不对。
高德大模型应用平台在 2025 年的数据就验证了这一点:出码率从 53% 提升到 80%-90%,但项目交付周期没有明显缩短。编码快了,但 Review 慢了;出码多了,但返工也多了。
出码率 ≠ 交付率。
Claude Code 再强,它也只是把"编码"这个环节的速度提上来了。一个需求从提出到上线,编码只占 20%-30%。你把这 30% 里的 AI 渗透率从 0% 拉到 90%,整体提效也不过 18%-27%。
真正的提效,要打通全链路:
- 需求分析:AI 帮你把模糊需求变成可验证的规范
- 编码实现:AI 出码,但有质量门禁
- 代码审查:AI 初审 + 人工确认
- 测试验证:CI 程序化验证,而非人工检查
- 部署上线:人工把关最终决策
每个环节都有 AI 参与,每个环节也都有人类把关。
这才是 Claude Code 从 Demo 走向生产的正确姿势。
一张图总结
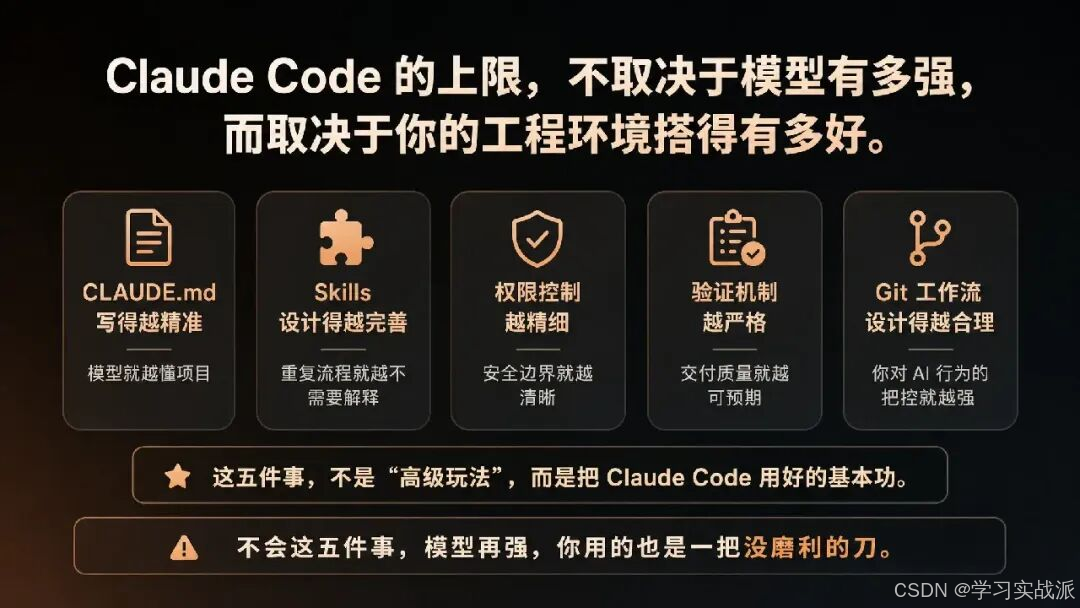
如果用一句话概括 Anthropic 这场分享的核心结论:
Claude Code 的上限,不取决于模型有多强,而取决于你的工程环境搭得有多好。
CLAUDE.md 写得越精准,模型就越懂项目;Skills 设计得越完善,重复流程就越不需要解释;权限控制越精细,安全边界就越清晰;验证机制越严格,交付质量就越可预期;Git 工作流设计得越合理,你对 AI 行为的把控就越强。
这五件事,不是"高级玩法",而是把 Claude Code 用好的基本功。
最后
我们整理出这套 AI 大模型 突围资料包:
✅ 从零到一的 AI 学习路径图
✅ 大模型调优实战手册(附医疗/金融等大厂真实案例)
✅ 百度/阿里专家闭门录播课
✅ 大模型当下最新行业报告
✅ 真实大厂面试真题
✅ 2025 最新岗位需求图谱
所有资料 ⚡️ ,朋友们如果有需要 《 AI大模型 入门+进阶学习资源包》,下方扫码获取~
资料展示
下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
需要这份AI大模型资料清单的话,在评论区回复「清单」即可;我会根据大家的问题继续补充对应的实战内容。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 0
 0
- 0


 已为社区贡献4条内容

所有评论(0)