登录社区云,与社区用户共同成长
邀请您加入社区
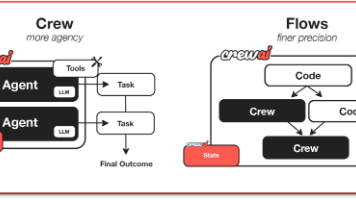
多智能体开发最难的地方是控制
DRAWTEXT(VAR11 AND COUNT(VAR11,30)=1,LOW*0.95,'大资金活动'),LINETHICK1,COLORFF00FF;DRAWTEXT(VAR8=10 AND FILTER(VAR8=10,5),LOW*0.93,'接近底部') COLORMAGENTA;DRAWTEXT(VAR1C AND COUNT(VAR1C,30)=1,LOW*0.95,'大笔成交')
本文作为 FastAPI 系列的第一篇文章,将从整体角度认识 FastAPI。首先介绍 FastAPI 的基本概念、核心特点、应用场景与技术栈,并通过与 Flask、Django 的对比理解其在现代 Web API、微服务及 AI 应用后端开发中的优势。随后从第一个 FastAPI 应用出发,介绍应用创建、启动与基本代码结构,并初步理解路径参数、查询参数和请求体的识别规则。最后介绍 FastAPI
利用大模型技术到高校心理服务平台中去,在情感响应速度、资源获取便利程度、数据保存完整性这三个方面都有明显改善。系统使用B/S架构,具备跨终端访问特性,部署难度小、移植方便,适合于各类高校开展本地化定制。
Pro 相对 Plus,主要是用量倍数,大约 5x / 20x,不是「Pro 才能写代码」。登录故障可以拆成:Sol 判断可能在哪一层,Terra 改前后端,Luna 整理日志和单测。一句话:先把 Sol 从日常任务里拿掉,再砍上下文和 MCP。单人全天多项目、长 Agent、窗口里并行好几个云任务,再看 Pro 20x。大任务拆成可验收的小步:改接口,跑单测,再动调用方。没有海外卡、要开到自己账
口径一致比数字精确更重要。毛利率85%还是55%,差的不是计算精度,而是"算力之外的成本是否入账"。所有健康线、LTV/CAC、回收期比较,必须先锁定同一直接成本口径,否则跨团队、跨季度对比全部失真。毛利率是定价自由度,净利润率是增长自由度。毛利率低于健康线时,先修成本结构或定价,再谈投放与扩张;否则每卖一单都在透支下一轮融资。财务模型的价值不在预测得准,而在"决策可复算"。把技术债折旧、数据飞轮
异常团伙追踪器(AnomalyGangTracker)是任何"需要把离散告警还原为拓扑团伙、在图上可视化定位"场景的"社区发现 + 异常聚类融合引擎"。- 融合思路:社区发现(Louvain)定位"自然分组" + 异常聚类(embedding K-Means)定位"离群点" → 取交集 → 在拓扑图上高亮连通的异常子图。"nx.connected_components(subgraph)" 保证每
下载目录乱成一锅粥?本文用 Python + AI 提示词做一个可复用的"文件批量整理"脚本,把 3 小时的手工活儿压缩到 10 分钟。附完整可运行代码、3 个真实避坑点,以及一条能让 AI 一次产对代码的提示词模板。
<think>我需要根据给定的内容生成一个不超过150字的摘要。内容描述了一个评估体系,包含两层结构、黄金指标、Rubric、评估器、评估任务等概念,并以客服Agent为例进行说明。摘要需简洁,涵盖核心流程:黄金指标→Rubric→评估器→评估任务→结果分析,强调可量化、可解释、可复用的评估体系。</think>建立可量化、可解释、可复用的Agent评估体系:将“好不好”拆
手机AI直播系统没有绝对的好坏,只有匹配度。大厂云服务稳定但成本高,垂直工具单点强但难成闭环,而融汇铸云数字分身V7这类一体化方案,更适合追求“一人即团队”的中小商家与自媒体。建议结合自身内容基因、预算和长期规划,先试用再决定。
在 AI Agent 语境下,Skill 并不是一个新鲜词,但不同框架对它的定义略有差异。我们需要先厘清几个容易混淆的概念。一个 Skill 可以被定义为:一段经过封装、带有结构化描述、可以被 Agent 按需发现与调用的能力单元。能力本体:真正干活的东西,可能是函数、HTTP 接口、脚本、服务,甚至是另一个 Agent。结构化描述:告诉模型这个 Skill 是做什么的、入参出参是什么、什么时候应
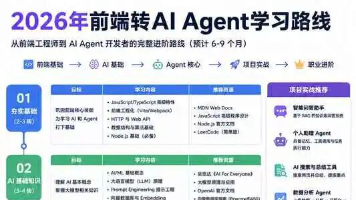
今年是我做前端的第六年。去年这个时候,我整个人是慌的。AI写页面的速度越来越快,v0、Cursor这些工具出来之后,以前我要写两天的组件,AI五分钟就生成初版了。团队新来的应届生,React写得比我还溜,还懂点RAG。我当时就在想:前端这碗饭,还能吃几年?跟风转AI的人我见过太多了。身边好几个前端兄弟,转岗第一件事就是啃Python、背算法、刷LangChain文档,恨不得把自己变成一个后端。结果
智能数据标注与治理解决方案,通过“人机协同”、“智能体赋能”与“极致安全”的三驾马车,彻底打破了传统模式的产能与质量瓶颈。选择羽山,企业获得的不仅仅是一批标准化的数据文件,更是获得了一套驱动AI持续进化、保障业务合规安全运转的核心数字基础设施。在未来算力与算法平权的世界里,掌握了高效提炼“高质量数据”能力的企业,必将掌握通往智能时代的真正钥匙。
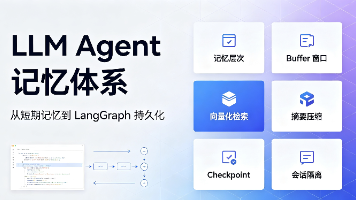
本文包含 记忆体系认知(短期 / 长期 / 工作记忆)、Buffer Memory、向量化长期记忆、摘要记忆、LangGraph 持久化、会话隔离
2026年高教社杯数学建模国赛C题,表面上考的是分类预测,实际上考的是“可解释的AI”——这是当前学术界和工业界最热门的方向之一。LightGBM凭借卓越的性能成为分类问题的“新王”,而SHAP值则赋予了这个新王“透明的大脑”。通过本文的完整流程,你不仅掌握了从数据清洗到模型部署的全链路技能,更具备了撰写高质量竞赛论文的核心素材。不要迷信准确率——在不平衡数据中,F1和AUC才是真正的朋友。可视化
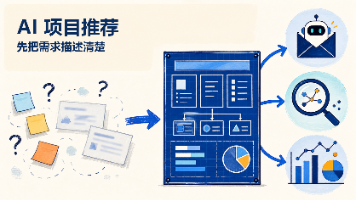
向 AI 寻求项目推荐时,“复杂”“有挑战”不足以限定项目范围。本文整理了一份可复制的需求描述模板,并通过智能邮件助手、Django 博客向量检索和电商价格分析三个案例,说明如何结合开发经验、实际痛点、时间投入、技术栈与作品集目标缩小选择,再按场景匹配 Python、数据库、Web 与 AI 工具
本文揭示了LangChain回调系统在真实业务场景中暴露的性能陷阱。通过压测数据对比发现,使用LangChain Agent的响应时间比手写代码多出近2秒,主要损耗来自ReAct策略的多次LLM调用、Prompt膨胀以及回调事件处理。深入分析指出四个核心问题:同步阻塞的dumpd序列化操作造成巨大开销、全局单例回调队列导致并发瓶颈、重复事件触发造成资源浪费,以及错误嵌套导致的调试困难。文章提出五项
└── labels/# 旋转框标签(8点归一化格式),将路径改为你的实际绝对路径,并正确指定 RGB 和红外目录。将模型配置文件路径改为仓库内实际存在的多模态模型 yaml。├── images/# RGB 图像。├── image/# 红外图像。将数据配置文件路径改为上一步修改好的 yaml。2.修改训练脚本 train.py。确保超参数与论文一致。
2026上海开源软件应用创新大赛正火热报名中,本次大赛由开源中国主办,总奖池100万,设 AI+工业软件、智算云、开源AI工具三个赛道。其中「智算云」这条赛道,面向用云加速、简化或稳定AI运行的开源项目。从底层的异构算力调度、GPU池化、分布式训练,到上层的AI应用开发平台、模型部署服务、Serverless推理、工作流编排,再到多云管理、边云协同、FinOps成本优化,都在征集范围内。赛道不区分
红隼 · 落叶 · 万物生歌 · AI 驱动红队安全工具台。
【摘要】本文提出用有限状态机改进AI Agent执行复杂任务的可靠性。传统单一循环模式存在步骤混乱、权限失控等问题,新方案将流程划分为规划、执行、审查三个独立状态:PLANNING仅分解任务(禁用工具),EXECUTING按计划分步执行(全工具可用),REVIEWING只读不写(限制工具)。状态转换由代码强制控制,每个状态配备专属提示词和工具集。基于GLM-4.7-Flash实现约80行核心代码,
本文深入解析了LlamaIndex中的Reader机制,重点介绍了常用Reader的工作原理与集成方式。通过源码分析,详细讲解了BaseReader基类、SimpleDirectoryReader的调度逻辑以及PDFReader、DocxReader等常用Reader的实现。文章还提供了自定义Reader的实战建议,强调通过file_extractor参数实现深度集成,并推荐生产环境使用Llama
摘要 本文探讨了RAG系统中处理Excel/表格数据的正确方法。传统将Excel与PDF等文档统一向量化存储的方式存在严重缺陷:无法执行聚合、排序等操作,查询精度低。作者提出应将结构化数据与非结构化数据分离处理,对比了临时表和永久表两种方案,推荐采用永久数据库表方案(零延迟查询、支持索引、数据可复用)。最终架构设计将RAG知识库与结构化数据隔离,通过Agent智能路由问题类型,PDF等走语义检索路
这篇文章详细介绍了基于FastAPI和LlamaIndex构建的企业级RAG知识库管理系统中的文档处理Pipeline设计。主要内容包括: 整体架构:采用组件化设计,包含文档清洗、切片、后处理、上下文增强、元数据增强和入库收集六个环节,各环节解耦为独立的无状态组件。 核心设计: 通过PipelineContext实现统一配置管理 采用注册式工厂模式实现策略可插拔 全异步执行架构(CPU密集型用线程
或者打开 cursor.com → 点 Download for Windows → 双击安装包 → 一路 Next → 启动 Cursor → 首次打开选"Sign in"用 GitHub 或 Google 账号登录(免费版即可)点 Download → 双击安装 → 一路 Next → 勾选"Create Desktop Shortcut" → Install → 勾选"Run PyCharm
其实应该就是镜像源出了问题,修改没有更新导致一直无法解决。
Embedding(嵌入/词向量),本质是一种把文字转换成数字向量的技术。这串数字的长度(维度)可能是 768 维、1024 维甚至更多。为什么要把文字变成数字?因为计算机只认识数字。我们要想让计算机"理解"文字之间的相似性,就必须把文字映射到一个"数字空间"里。LLM(Large Language Model,大语言模型),是一种参数量巨大、经过海量文本训练的生成式模型。你给它一段文字(提示词
本项目旨在使多波段联合检测无需使用者修改源码即可完成。适用于农业遥感巡检、可见光与热红外融合检测等波段数不等于三的视觉任务场景。项目地址:https://github.com/Xiaoguaiyaya/YOLO-multi-channel (遵循 AGPL-3.0 协议开源)当前端到端验证基于合成多光谱数据完成,欢迎在实际数据上试用并反馈问题,Issues 与 Pull Request 均开放。
这套架构的价值在于:数据底座解决信源广度,算法层解决内容与模型语义的匹配度,执行层确保标准化落地,监测层则让效果有据可循。相比之下,缺乏技术底层、仅靠人工编辑堆砌内容的服务商,在大模型快速迭代的背景下,其效果往往是不可持续且难以验证的。智擎GEO强调的“数据闭环复盘”和“全域数据监测与归因”,能向企业透明化展示内容收录与引用来源,有效破除行业数据黑箱,为持续优化提供依据。成熟的系统(如智擎GEO的
上下文窗口的预算分配,本质上是一种“信息经济学”:在有限的注意力资源下,决定什么该进、什么该留、什么该丢。对 AI 编程助手而言,最有效的使用方式不是把窗口塞满,而是让每一个 token 都为当前的决策服务。能讲清楚“当前要解决什么”,比堆积大量背景更重要;能给出可验证的标准,比反复要求“再优化一下”更有效;能按阶段收敛上下文,比把一个会话用到地老天荒更聪明。下次当你准备把一大段背景粘贴给 AI
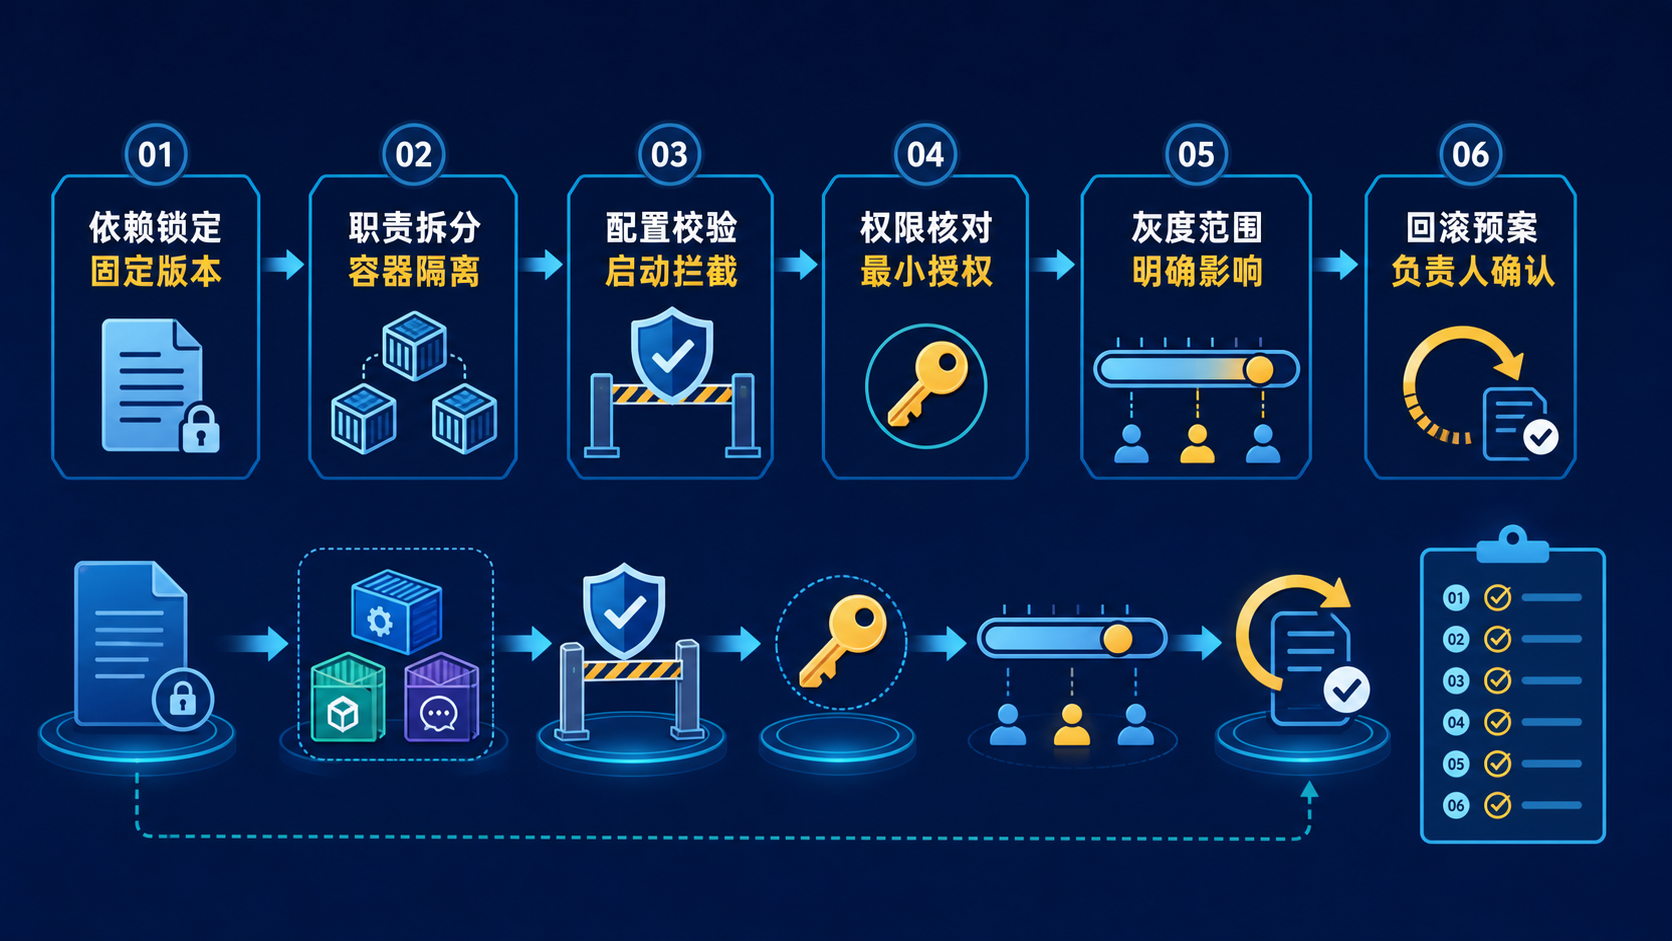
配置发布前,除了核对模型、工具和权限,还要确认本次变更影响哪些路由与租户。灰度范围、回滚版本和负责人应在发布记录中写清。遇到工具权限扩大或提示词大改时,先在隔离流量里观察,不要把配置检查当成一次勾选动作。在 AI Agent 架构设计与多 Agent 协作系统的生产部署中,当面对包含多个 Agent 节点与数十种第三方 API 工具链的复杂系统时,环境依赖漂移与配置乱象容易导致部署失败或系统异常。
大模型时代,同行都在进化,你还在坚持老一辈打法?
文章摘要: Claude Code 4.8在多语言支持测试中表现差异显著:Python兼容性最佳(测试框架支持98%),JS/TS次之(泛型解析强),Java因编译耗时长和依赖复杂导致效率较低(JUnit支持85%)。动态语言(Python/JS)热修复快但易藏动态类型错误,静态语言(Java/Go)类型安全但Token成本高。选型建议:轻量任务用网页端聚合平台(如neneai.cn),复杂项目推
许多版本支持上传文档,并要求 AI 对内容进行分析。提取 PDF、Word、TXT 等文件的核心要点;总结长篇文章或会议纪要;从资料中查找特定信息;改写或翻译文档片段。文件处理的使用建议上传前先确认文件格式、大小和页数限制,避免上传失败;需要查找具体信息时,给出明确的问题,例如“这份合同中关于违约责任的条款在哪里”;对长文档可以先让 AI 输出摘要,再针对关键部分追问,效果更佳。上传文件前,请务必
本文以通义千问Qwen量化GGUF模型为案例,基于Llama.cpp框架展示本地大模型调用与功能开发的完整实现原理及流程。全文采用原生Python编写代码案例,无需依赖重型AI框架,依次实现模型元数据解析、本地接口单次对话调用、多轮对话持久化记忆、自定义工具调用拓展等功能实现逻辑,针对直接调用大模型上下文断裂、功能单一、拓展性不足等问题,通过轻量化对话记忆与工具解析执行框架完成优化实现,拆解本地对
此外,Desktop 会在自身的 user-data 目录下创建 dsh、pnpm 和 node 的私有 shim 文件,这些 shim 仅对当前终端进程生效,通过临时修改 PATH 环境变量实现隔离,不会对系统全局 PATH 或用户的 shell 配置文件产生任何影响。插件是给 DSH 添加能力的扩展包,例如模型、工具、界面和工作流。仓库贡献者列表里若出现上游开发者,是项目 Fork 继承、同步
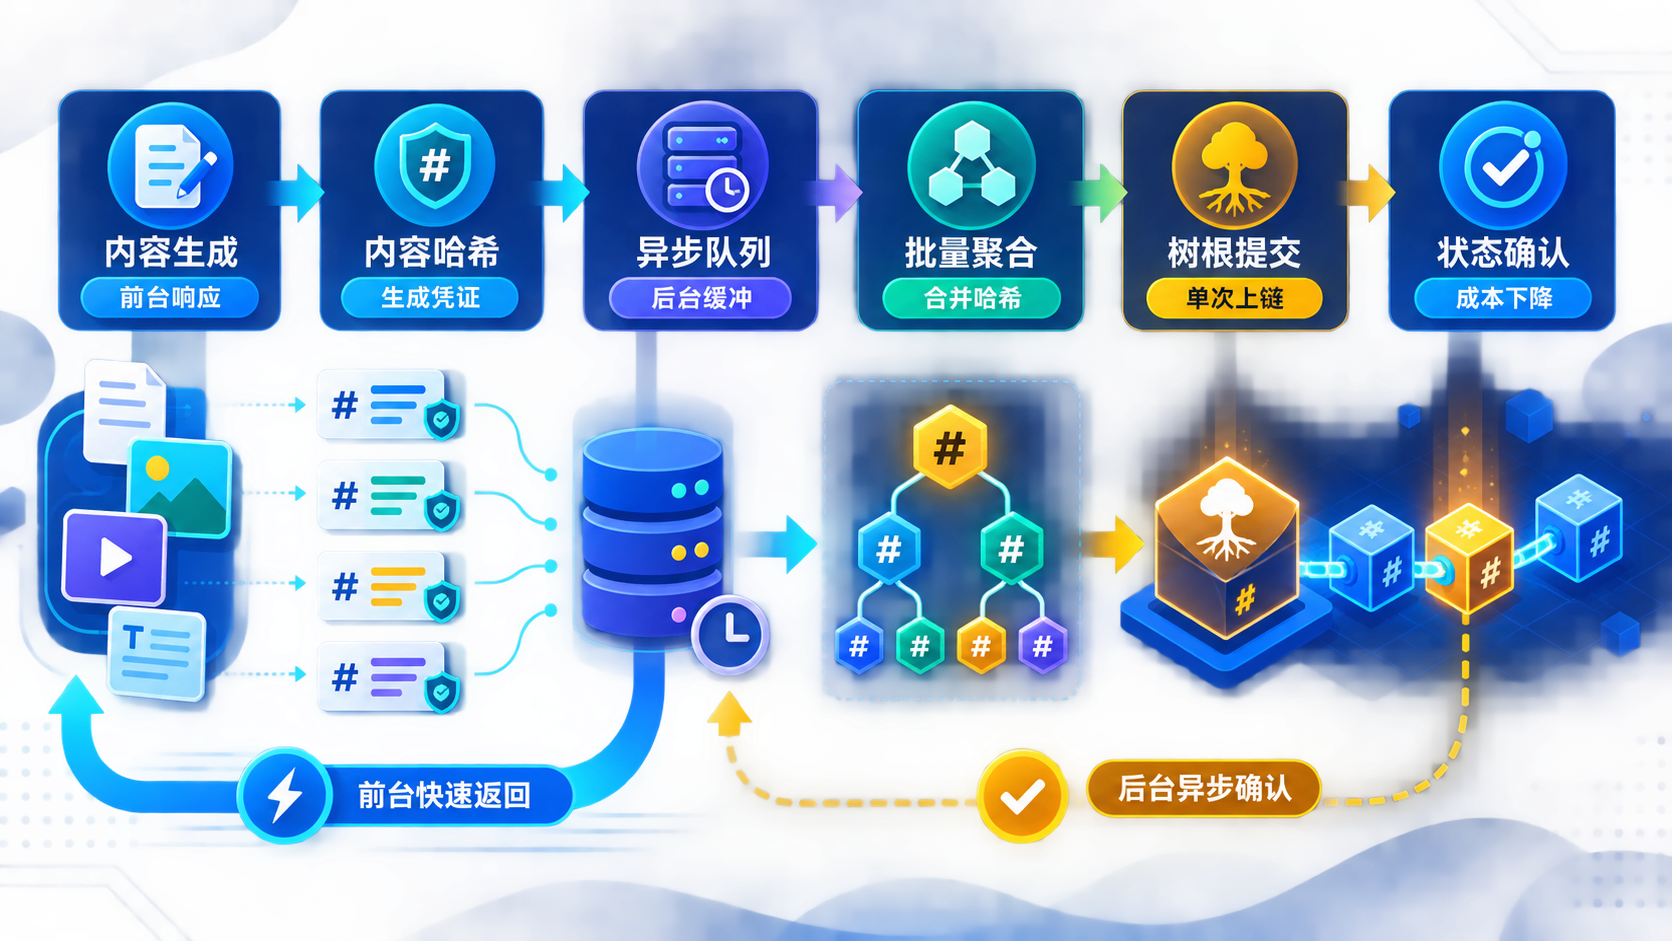
合约校验不能只拿格式正确的样例测试。空字段、枚举值拼错、重复提交和模型多输出一段解释文字,都应有明确处理方式。接收方拒绝时保留请求标识和校验原因,方便调用方修正,而不是把异常吞掉后留下半条记录。将 AIGC 内容生成(如文生图、文生代码)与区块链智能合约集成进行版权限量发行或生成存证,是典型的“前台高并发、后台长延时”工程场景。在传统直连架构中,当面对高并发请求时,若将扩散模型(Diffusion
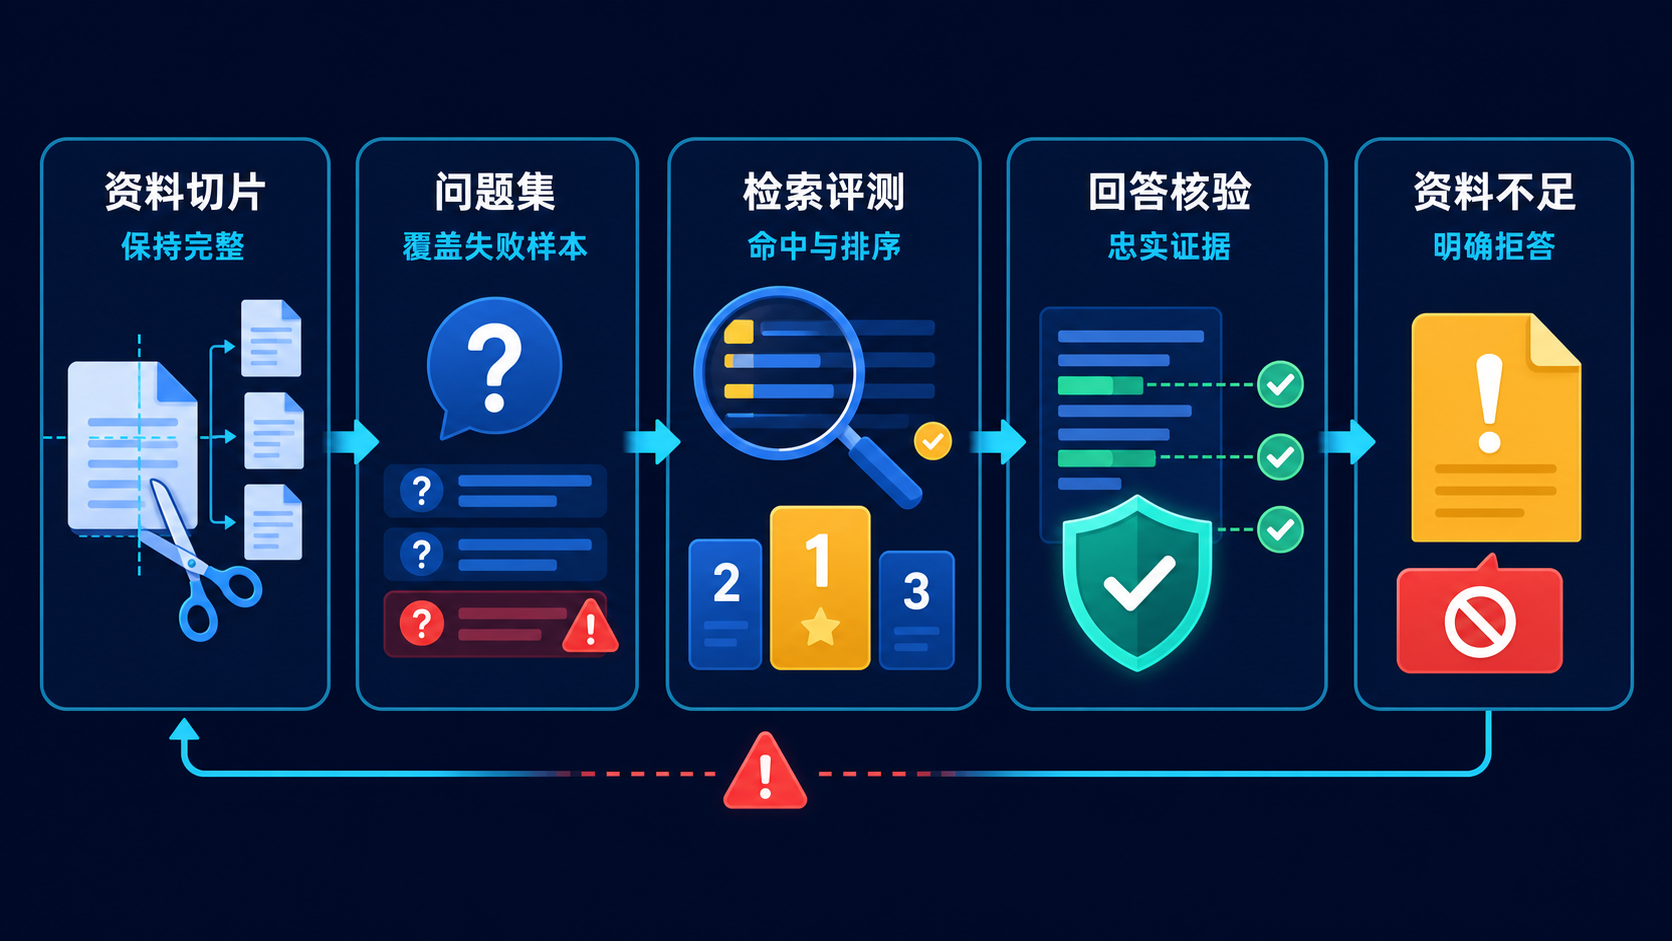
除了看命中率,还要保留几类会误导检索的提问:同义但含义不同的问法、过期版本的术语、答案根本不在资料库中的问题。逐条查看召回片段是否真的支撑最终回答。没有证据时应明确拒答或提示资料不足,不能用相似标题凑一个结论。在本地开发阶段,将几份 PDF 导入 LangChain 或 LlamaIndex 框架,编写简单的 Prompt 后,终端测试问答准确率看似较高。然而在实际生产或测试环境中,当将 RAG
动态子图跳转:LangGraph支持子图通过Command(goto="node_b", graph=Command.PARENT)直接返回父图指定节点,实现动态路由,需通过destinations声明以正确渲染拓扑。 路由分层设计:推荐将路由拆分为语义判断(LLM输出结构化结果)和图路由(Python函数映射节点),避免LLM直接返回节点名,降低耦合。
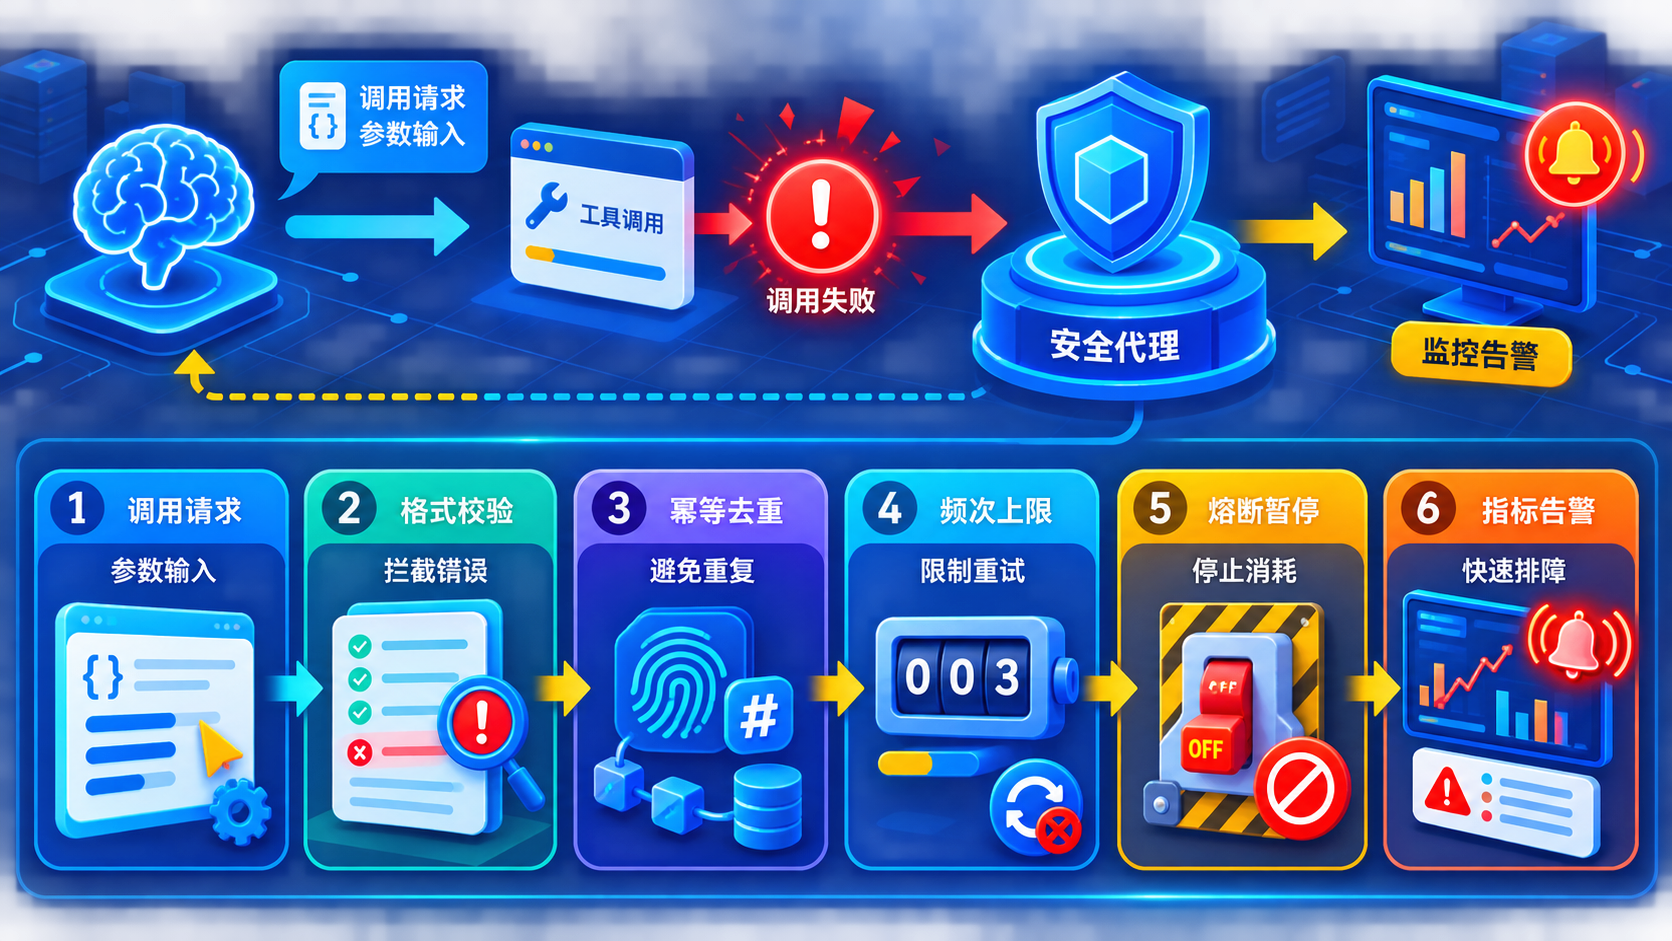
在大模型(LLM Function Calling / Tool Calling)应用落地与产品化运营过程中,建立机制健全的是保障系统稳定的关键环节。由于 LLM 具备非确定性,当工具 API 返回异常提示(如 HTTP 500 或格式解析错误)时,模型可能产生误判,误认为是传入参数非法,进而尝试微调参数并高频重新发起调用。若缺乏外层安全代理与止损闸门,自动重试机制容易演变为无限循环,造成不必要的
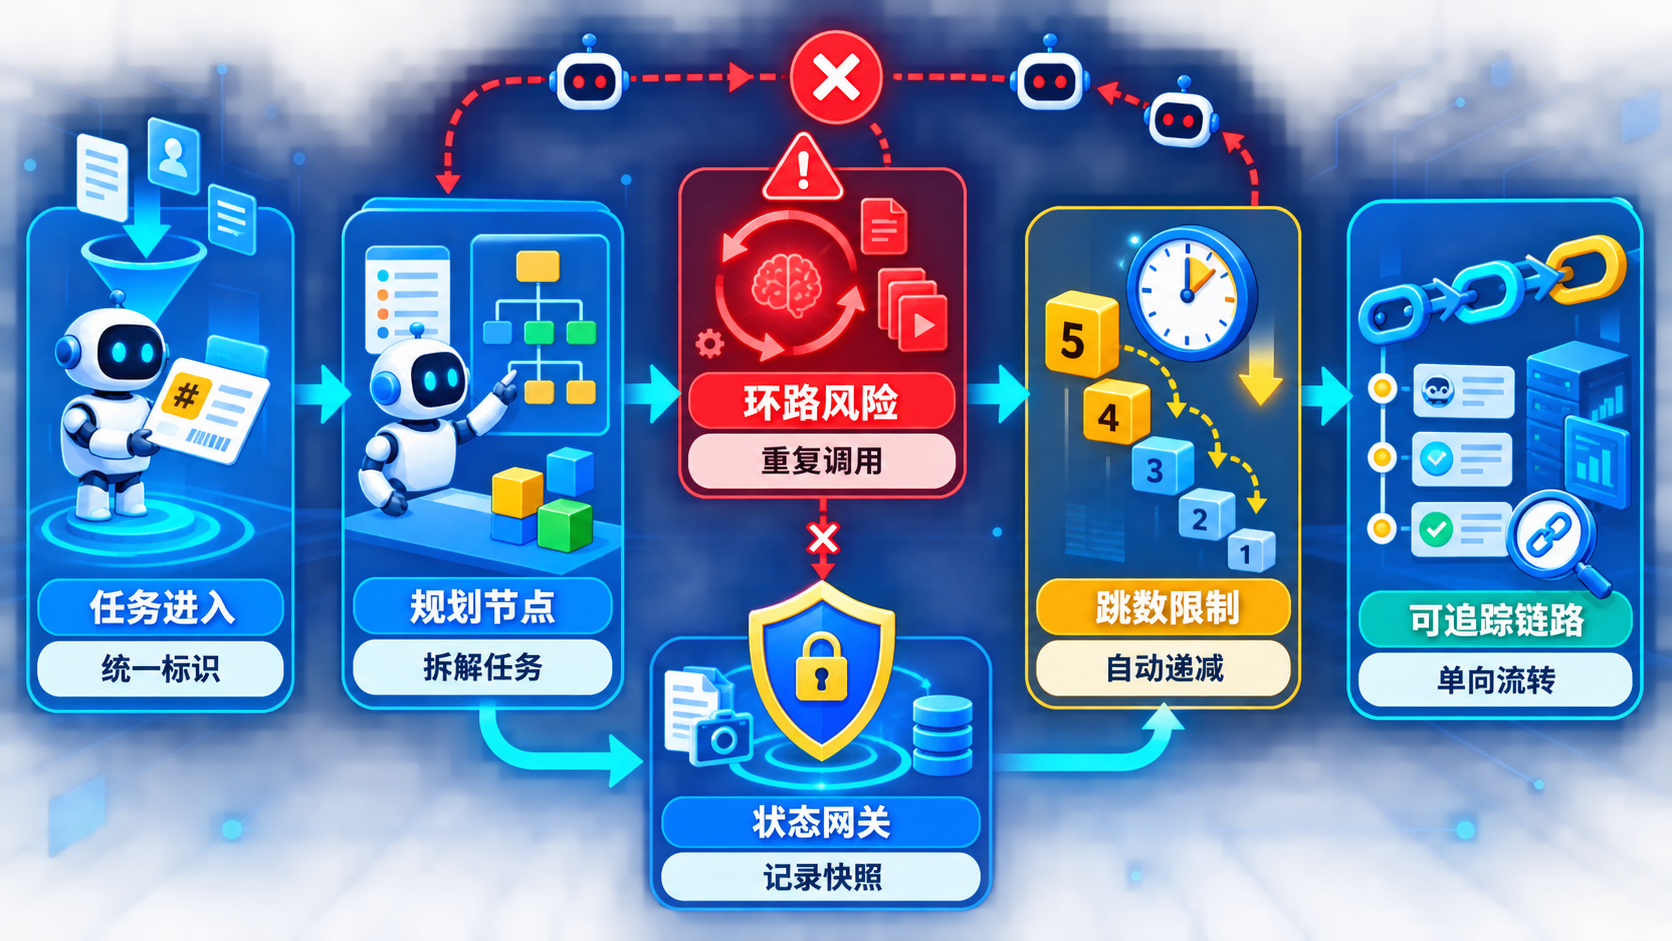
在大型系统或复杂工作流场景中,当多 Agent 协作系统在处理跨部门审批与发票核验任务时,如果缺乏死锁防护与路径追踪机制,主控 Agent 的 Task Worker 容易陷入并发卡死状态,协程数量在短时间内可能急剧飙升。在缺乏链路治理的情况下,系统接口可能直接返回 504 超时。检索日志会发现一秒内触发大量重复 Prompt 请求,但由于状态流转陷入死锁,没有任何一个任务能够完成并输出最终结果。
我让 Agent 给公开 Markdown 自动分组,结果它把“安装”和“卸载”合成一类。失败不说明模型完全不能用,只说明规则没有被写清。那次输出看着很整齐,类别名称也像模像样;问题是我只抽查了几个相近词,没有把反义操作放进样本。等到准备接到脚本里,才发现卸载说明被推荐到安装分组,读者照着找会直接走错方向。我把这条 fixture 加进测试,并要求模型返回理由和置信度;低置信度直接保留原文。实验输
Agent 为什么能自己干活,又为什么经常翻车?这篇文章不调框架、不讲概念,直接手写 40 行 ReAct 循环,把 Agent 的底裤扒干净:LLM 怎么思考、工具怎么调用、记忆怎么流转、循环怎么串起来。再对比 Plan-and-Execute 模式,附一张选型决策树告诉你什么时候用哪种。最后拆四类翻车原因和四道工程保险。看完你会明白,Agent 不是魔法,它的问题也不在模型,在工程。