《行动认知研究综述:多模式方法、伦理考量和反馈机制》
论文原标题:A Survey on Action Recognition: Multimodal Approaches, Ethical Considerations, and Feedback Mechanisms
这是一篇2026年发表在《Electronics》期刊上的综述论文,由CUNY(纽约城市大学)的研究团队完成。这是一篇综述,它的任务不是提出新方法,而是梳理、分类、批判性地总结整个行为识别领域的发展现状、技术路线、伦理挑战和未来方向。
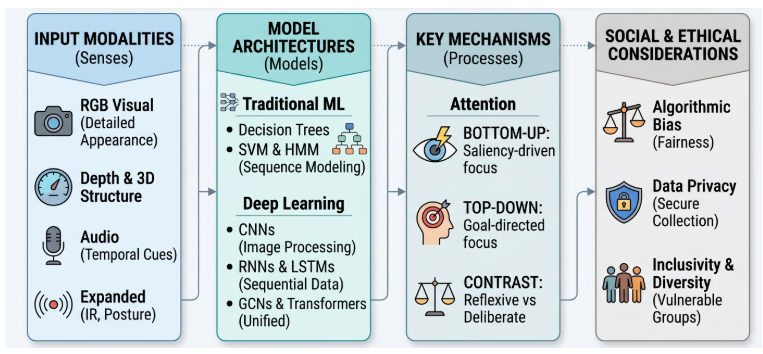
一、 论文的核心思想与范式转变
1. 核心命题
论文开篇就点明了一个关键趋势:行为识别正在经历一个“范式转变”——从“受控环境下的单一个体动作分类”,转向“真实世界中的多人群体动态理解”。
2. 三个核心支柱(论文的结构骨架)
论文将当前行为识别面临的开放世界挑战,归纳为三个相互交织的核心议题:
| 支柱 | 核心问题 | 为什么重要 |
|---|---|---|
| 多模态融合 | 如何整合RGB、深度、音频、热成像、文本等多种数据源 | 单模态(如纯RGB)在遮挡、光照变化下极不可靠,多模态是应对真实世界的必要条件 |
| 伦理与社会考量 | 如何在提升识别能力的同时保护隐私、避免偏见、保证公平 | 能力越强,潜在的监控风险越大;技术越普及,偏见的影响面越广 |
| 反馈/注意力机制 | 如何让模型像人一样“先看整体、再盯细节”,动态分配计算资源 | 在多人场景中,模型必须学会“该看谁、不该看谁”,否则计算资源会被海量无关信息淹没 |
最关键的观点:这三个支柱不是独立的研究方向,而是相互依赖的架构要求。多模态融合提供感官广度,但带来计算负担;注意力机制提供认知效率,但若部署不当会加剧伦理风险;伦理框架必须从一开始就融入技术设计(隐私保护计算、联邦学习、视觉匿名化等),而非事后的政策补救。
二、 行为识别的发展简史
论文第2节梳理了行为识别的技术演进脉络,其概括为五个阶段:
| 阶段 | 时间 | 核心技术 | 代表性方法/数据集 |
|---|---|---|---|
| 早期手工特征 | 1990s | 光流、运动历史图像(MHI)、手工特征 | 耦合HMM |
| 特征工程时代 | 2000s | 时空兴趣点(STIP)、轨迹描述子、HOG/HOF | KTH、Weizmann |
| 词袋模型 | mid-2000s | 视觉词袋、HOG | 引入文本检索思想到视觉 |
| 深度学习革命 | 2010s | 双流CNN、3D CNN、RNN/LSTM | UCF101、HMDB51、Kinetics |
| 自监督/大模型时代 | 2020s | 视频掩码自编码器(VideoMAE)、视觉-语言模型(CLIP/VLM)、状态空间模型(SSM/Mamba) | 零样本、少样本、多模态融合 |
关键转折点
论文特别强调了几个重要转变:
-
从有监督到自监督:VideoMAE等掩码自编码器通过“遮住大部分视频、让模型重建”的方式,无需标注就能学到强大的运动表征。
-
从视觉到跨模态:CLIP类模型通过对比学习对齐视觉和语言,让行为识别具备了零样本能力。
-
从端到端到多智能体:最新的Vision-Language-Action (VLA)模型利用LLM的推理能力,不仅能“看”动作,还能“理解”动作的意图并执行相应操作。
三、 重点内容1:多模态融合(Section 3)
这是论文最核心的技术章节,详细讨论了各种模态的特点、融合策略和挑战。
3.1 模态分类
论文将行为识别中的“模态”定义为:用于解释人类动作的数据或传感器输入类型。主要包括:
| 模态 | 优势 | 局限性 | 典型方法/技术 |
|---|---|---|---|
| RGB(视觉) | 信息最丰富、最直观 | 受光照、遮挡、视角影响大 | CNN、ViT、OpenPose、3D CNN |
| 深度(Depth) | 3D空间信息、不受光照影响、能解决遮挡 | 距离远时精度下降、户外性能差 | Kinect、ToF相机、RGB-D融合 |
| 音频(Audio) | 提供视觉之外的上下文(如脚步声、语言、环境音) | 需要同步、噪声敏感 | 音视频融合、TBN |
| 姿势/骨架 | 轻量、隐私友好、计算效率高 | 缺乏物体交互、场景上下文信息 | ST-GCN、MotionBERT、GCN |
| 热成像(IR) | 夜间/低光照下依然有效 | 分辨率较低、缺乏纹理细节 | 安全监控、夜间检测 |
| 文本/语言 | 提供高层语义上下文 | 标注成本高、模态异构 | LLM、CLIP、LA-GCN |
3.2 融合策略的三层架构
论文将多模态融合分为三种策略,并详细分析了各自的适用场景:
| 融合策略 | 做法 | 适用场景 | 代表方法 |
|---|---|---|---|
| 早期融合 | 在输入层拼接多模态数据 | 需要紧密同步的任务(如演奏乐器:手部动作+音符) | 3D CNN、早期特征拼接 |
| 晚期融合 | 各模态独立处理,最后融合决策 | 模态独立性强、互补性高(如识别街头抗议:人群画面+远处喊声) | 双流网络、独立分支 |
| 中间融合 | 在网络的中间层进行特征交互 | 动态环境中的中等粒度同步(如厨房切菜:节奏+动作) | TBN、MMNet |
3.3 论文特别强调了解决“遮挡”问题
在多人的真实场景中(如拥挤的人行道),RGB摄像机常常无法区分重叠的人体。论文指出:
深度数据是解决RGB严重遮挡问题的“首要解药”——通过3D空间映射,系统可以在一个人被另一个人遮挡时,仍然保持对其的追踪。(这解释了为什么近年来RGB-D(RGB+深度)方法在行为识别中越来越受重视。)
3.4 文本/语言知识辅助的行为识别
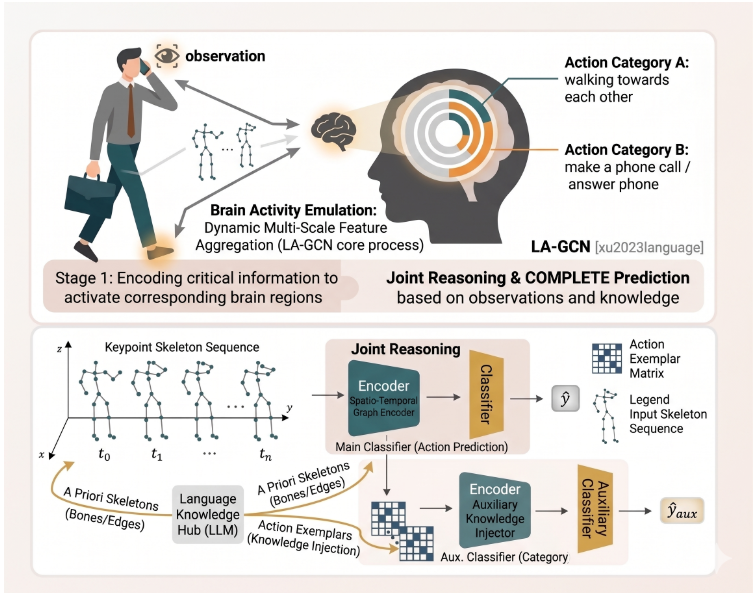
论文专门讨论了LLM如何辅助行为识别(与之前读过的论文PURLS、SUGAR等工作一脉相承):
-
语言知识辅助的骨架表示学习:如LA-GCN(Language-Assisted GCN),利用文本描述构建“全局节点关系图”,让骨架编码器理解“哪些关节是相关的”。
-
LLM作为零样本识别器:如“LLMs are Good Action Recognizers”(Qu et al., CVPR 2024),将骨架序列投影成“动作句子”,直接让LLM作为分类器。
-
动态生成上下文感知的side information:用LLM为骨架动作生成细粒度的运动描述,作为监督信号。
四、 重点内容2:伦理与社会考量(Section 4)
这是该综述区别于大多数技术论文的独到之处——它用了整整一个章节讨论行为识别技术的伦理问题。
4.1 三个核心伦理挑战
| 挑战 | 描述 | 具体风险 |
|---|---|---|
| 隐私侵犯 | 多模态系统在公共场所持续监控 | “风险倍增器”效应:RGB+音频+热成像同时采集,无死角监控 |
| 偏见与歧视 | 训练数据代表性不足导致系统误判 | 文化差异:如将某种文化中的热情问候误判为“攻击性行为” |
| 透明性与问责 | AI系统的“黑箱”特性 | 执法、交通、医疗等关键领域的决策缺乏可追溯性 |
4.2 论文特别强调了“风险倍增器”效应
单模态系统有自然局限(如RGB在黑暗中失效),但多模态融合(RGB+音频+热成像)剥离了这些自然隐私缓冲层。一个个体可以在黑暗中通过热成像被识别,其对话通过定向音频被捕捉,其姿势通过RGB被追踪。多模态融合创造了一种远比任何单一传感器都更具侵入性的监控能力。
4.3 隐私保护的技术方案
论文不仅指出了问题,还系统梳理了隐私保护机器学习(PPML)的技术路线:
| 技术 | 核心思想 | 适用场景 |
|---|---|---|
| 视觉匿名化 | 在特征提取前剥离敏感生物特征(模糊面部、生成虚拟形象、只保留骨架) | 公共场所监控 |
| 联邦学习 | 原始视频数据不离设备,只上传加密的模型梯度 | 医疗康复、养老院监控 |
| 差分隐私 | 在训练数据或梯度中注入校准噪声,使“排除/包含某一个人”不会显著改变模型 | 任何需要严格隐私保证的场景 |
五、 重点内容3:注意力与反馈机制(Section 5)
论文将“注意力机制”分为三个层次,并明确区分了概念:
5.1 三个层次的区分
| 层次 | 定义 | 举例 |
|---|---|---|
| 注意力机制(计算机视觉) | 算法动态分配权重给特定输入特征 | Transformer的自注意力、空间注意力 |
| 反馈机制(神经认知) | 高层认知(目标、记忆)主动调节低层感官处理 | 人类“主动寻找”某个东西 |
| 后向生成反馈(DNN) | 高层抽象语义在推理过程中反向路由到低层特征提取器 | 图注意力、反馈GCN |
5.2 自下而上 vs 自上而下
Architecture of the interactive attention (IA) model [136], demonstrating the integration
of language-driven top-down attention:
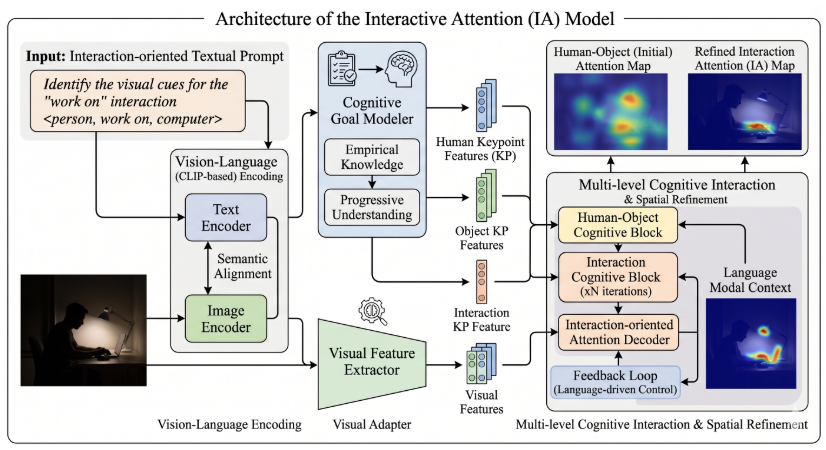
| 类型 | 驱动因素 | 特性 | 在行为识别中的应用 |
|---|---|---|---|
| 自下而上(Bottom-up) | 数据驱动/刺激驱动 | 自动、快速、由显著特征触发 | 检测突然动作、突发行为 |
| 自上而下(Top-down) | 目标驱动/任务驱动 | 受先验知识引导、可过滤背景噪声 | 根据任务目标主动寻找特定身体部位 |
核心洞察:在多人场景中,需要从“个体内注意力”(关注一个人的手臂和躯干)扩展到“社交注意力/跨智能体注意力”——模型需要学会在几十个人的群体中,动态聚焦于特定的几对交互个体。
5.3 2024-2025年的最新进展
论文特别关注了最新的架构演进:
-
Vision-Language Models (VLMs):如Qwen2.5-VL,将LLM作为“主动认知控制器”,通过解析复杂的语言指令来动态路由视觉注意力(不再依赖静态文本提示)。
-
State Space Models (SSMs):如VideoMamba,提供线性复杂度 O(N) 的时序建模,弥补了标准Transformer在长视频上的二次复杂度 O(N2) 问题。
表3的量化对比(关键数据):
| 架构 | 模型 | 输入尺寸 | Top-1 Acc | 参数量 | FLOPs | 复杂度 |
|---|---|---|---|---|---|---|
| CNN | I3D | 64 × 224² | 71.1% | 12.1M | 108.0G | O( |
| GCN | InfoGCN | 64 × 25 × 3 | 93.0% | 1.5M | 3.1G | O(V×E) |
| Transformer | MotionBERT | 243 × 25 × 3 | 94.5% | 16.0M | 131.0G | O( |
| Transformer | VideoMAE V2 | 16 × 224² | 81.5% | 86.0M | 180.0G | O( |
| SSM | VideoMamba | 16 × 224² | 80.8% | 26.0M | 68.0G | O(N) |
六、 未来方向(Section 6)
论文指出的六大未来方向:
| 方向 | 核心挑战 | 技术路线 |
|---|---|---|
| 多人场景与严重遮挡 | 从个体边界框转向群体场景图 | 场景图表示、跨智能体注意力 |
| 先进序列建模 | 标准Transformer在长视频中二次复杂度 | SSM(VideoMamba)+ 内存增强架构(MeMViT) |
| 语义推理(VLM/LLM) | 理解“为什么”群体行为发生 | VLMs作为认知推理引擎、零样本群体行为解释 |
| 泛化能力 | 训练数据多样性和模态融合 | 热成像与RGB融合、自监督跨模态学习 |
| 跨领域应用 | 从实验室到城市基础设施 | 城市动态分析(行人流、交通拥堵)、无障碍评估 |
| 伦理与隐私 | 在边缘设备上部署轻量级SSM,VLM仅作为“二级认知控制器” | 混合异步架构:SSM(低延迟追踪) → VLM(异常触发时的语义推理) |
总结:
这篇综述论文是行为识别领域的“全景地图”——它不仅告诉你“现在有什么技术”,更重要的是告诉你“为什么单模态已经不够用、为什么伦理必须从头介入、为什么注意力机制是连接感知与认知的桥梁”。对于研究者来说,它提供了从“单一分类问题”转向“多智能体群体理解”的完整路线图。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐


 6
 0
- 0


 已为社区贡献1条内容

所有评论(0)