登录社区云,与社区用户共同成长
邀请您加入社区
起初只有一两个人在用,申请一个 Key,跑得挺好。三个月后,五个业务线都在调,用的模型各不相同,谁也说不清这个月花了多少、花在哪个项目上。等到财务拿着账单来问,才发现,所有调用共用一个 Key,日志里只有一串流水,没有归属。这不是个例。大模型 API 的成本治理,难点从来不是「单价贵不贵」,而是**「钱花在哪了」这件事能不能被回答出来**。本文讲一套可落地的隔离方法。
本文记录了使用AiPyPro抓取并清洗世界银行60年跨国经济数据的全过程。面对国家代码字段误用、聚合体混入等关键陷阱,通过修正countryiso3code字段、过滤区域汇总数据,确保217个真实经济体数据准确。经五步清洗(标准化、去重、异常值标记、单位统一等)与三锚点校验(全球GDP、中美份额),数据可靠性获验证。最终生成20.2万条长表、1.4万行宽表,输出含15张图表的结构化Word报告,支
Message 是模型交互的基本单元,代表模型的输入与输出,承载对话状态所需的内容和元数据。Spring AI Alibaba 提供跨厂商一致的标准消息类型系统。组成说明Role(角色)标识消息类型:system / user / assistant / toolContent(内容)实际内容:文本、图像、音频、文档等Metadata(元数据)可选:响应信息、消息 ID、token 使用情况并非所
final 不是简单的 “加锁”。用 “证件、重写权限、最终订单” 类比,讲清 final 变量、final 方法、final 类的区别,避开 AI 代码里的常见误用。
atest()test()66因为每次调用test(),都会重新创建一个新的a = 5,然后a++变成 6。3.因为a定义在外层main()里,内层if可以访问外层变量。4.b定义在if的{}里面,离开这对花括号后,它的作用域就结束了,所以外面不能直接使用。
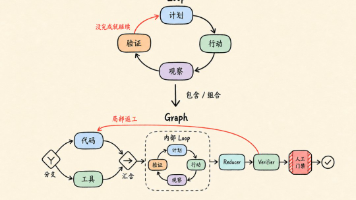
很多多 Agent 流程前面跑得很热闹,最后却把几十份原始结果一次性塞给最强、也最贵的模型。它先要去重、过滤空结果、统一格式、处理冲突,然后才开始推理。最有能力的模型反而成了垃圾整理员。多个 Worker↓代码去重、过滤、排序↓验证冲突和薄弱证据↓强模型综合能由代码稳定处理的工作,不必再消耗一次模型调用。【先压缩,再推理】
程序是磁盘上的静态文件,进程是其运行时的动态实例,拥有独立PID和资源。父进程通过fork()创建子进程,子进程继承资源并采用写时复制(COW),父子进程互不影响。父进程需用wait()回收子进程,否则成“僵尸进程”;若父进程退出,子进程被systemd(PID=1)收养,成为“孤儿进程”。进程是资源分配单位,线程是调度单位,协程由用户态控制,开销极小。常用命令包括ps、top、pgrep、pst
本文设计并实现了一套基于Java的智慧家庭医务助手系统,采用Spring Boot、Vue与uni-app技术栈,支持用户、医生、管理员三类角色,集成上门问诊预约、健康数据管理及协同过滤算法驱动的个性化服务推荐。系统以C/S架构保障稳定通信,结合DeepSeekAI实现智能健康评估与问答,有效缓解就医不便问题,提升居家健康管理的便捷性与智能化水平,推动基层医疗服务向高效、精准方向发展。
本文介绍了基于SpringBoot的个人成长足迹与数据分析系统的开发背景、技术栈选型、核心功能设计以及关键代码实现。该系统不仅是一个实用的个人成长管理工具,也是一个涵盖现代Web开发全栈技术的综合实践项目。未来可扩展方向:开发配套的移动端App,方便随时记录。加入学习社区,与他人分享成长经验。引入大模型分析学习笔记,生成知识图谱与智能总结。接入GitHub、LeetCode等平台,自动同步学习数据
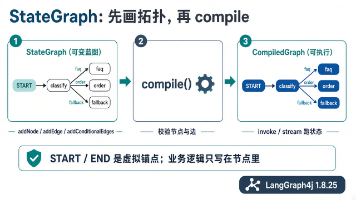
基于LangGraph4j,实现一个意图三路分支的StateGraph拓扑图。通过定义状态结构(RouteState),使用addNode添加分类、FAQ、订单、兜底等节点,以addEdge构建直线流程,再用addConditionalEdges实现按意图(faq/order/unknown)的条件路由。
面完最后一轮,走出大楼,我还在等 HR 通知下一场技术面。结果她发来一句:这就是终面,offer 流程已经走了。薪资 34k。比我在原公司涨了一大截。
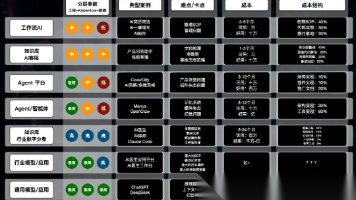
你如果问我们在教什么,我们其实在教的是两个东西:1. **一套 AI 项目知识框架**,目标是所有的 AI 项目类型该如何去做、技术路径、成本乃至难点卡点都会一一涉及;2. **一套 FDE 实施方法论**,这套东西主要是从企业里面实践拿出来的,他的内容就没那么虚了,会着眼企业真的在用 AI 做什么,而不会去跟热点;
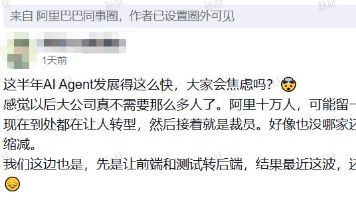
文章探讨了AI发展对程序员的影响,指出传统岗位被压缩,但AI方向人才需求大增。职场人应积极学习AI相关技能,适应变化,保持学习能力,才能在AI时代找到自己的位置。文章强调,AI并非让程序员失业,而是让懂AI的人更有价值。看到一位阿里员工发的帖子:“这半年AI Agent发展得这么快,大家会焦虑吗?感觉以后大公司真不需要那么多人了,阿里十万人,可能留一万就够了……”说实话,焦虑是正常的,这几年互联网
先说结论:2026年选自学还是报班,别急着二选一。建议你:先给自己2-4周时间自学试水,能坚持下来再考虑报班的事。坚持不下来的,报班大概率也是花钱买罪受。
本文深入剖析Java synchronized 的底层原理,从JVM对象内存布局出发,详解MarkWord结构、Monitor机制及monitorenter/monitorexit字节码,结合Java 17 JOL工具展示对象头变化。揭示锁升级过程与线程同步实现,解析常见误区与面试题,强调理解对象头是掌握JVM并发优化的关键。
最新内部评估显示,升级后的语言编辑模式用户正向反馈率达到93.76%,在Paperpal AI Detector的测试中,85%的案例在润色后没有提高原始AI检测评分,出现变化的案例中提升幅度也较小,适合需要一站式完成SCI/SSCI投稿前全流程检查的科研用户使用。对于英文SCI/SSCI投稿场景,建议将期刊规范匹配度、语言专业性、数据安全的权重分别设置为35%、30%、20%,交付时效占15%,
Deep Module 的概念来自 John Ousterhout 在《A Philosophy of Software Design》中提出的软件设计思想。模块 = 接口 + 实现一个模块对外暴露的是接口。模块内部隐藏的是实现。它提供的能力,与它暴露的复杂度之间的比例。模块深度 = 模块提供的能力模块对外暴露的复杂度一个模块能够提供大量能力,但只需要用户理解一个简单接口。那么它就是一个 Deep
调用大模型 API 时,相同的输入往往会得到相同的输出。如果不加缓存,每次都要重新计算,既浪费钱又浪费时间。这篇文章把 API 响应缓存从简单到生产级讲清楚,帮你节省 30-50% 的 API 成本。
2026年,全球碳关税落地背景下,本系统聚焦被忽视的“数字生活碳排放”,打造AI驱动的个人数字碳足迹管家。通过浏览器插件实时监测、本地轻量模型估算、AI对话助手与区块链存证积分,实现碳排放精准追踪与减碳激励。系统融合前端React+Tauri、后端FastAPI、ONNX推理与FISCO BCOS联盟链,技术成熟且创新性强,支持社交排行、企业对接等扩展,兼具实用性与答辩亮点,是高分毕业设计优选方案
索引是帮助 MySQL 高效获取数据的数据结构。它就像一本书的目录,可以让我们快速定位到目标数据,而无需扫描整张表。索引可以显著提升查询性能,但也会带来额外的存储开销和写入性能损耗。执行计划是 MySQL 优化器根据 SQL 语句生成的执行方案。通过EXPLAIN关键字可以查看 SQL 的执行计划,帮助我们分析查询性能瓶颈。MVCC(Multi-Version Concurrency Contro
广度: 面向企业安全建设的核心场景(渗透测试、红蓝对抗、威胁狩猎、应急响应、安全运营),本知识库覆盖了从攻击发起、路径突破、权限维持、横向移动到防御检测、响应处置、溯源反制的全生命周期关键节点,是应对复杂攻防挑战的实用指南。这些智能体在执行限时的网页检索任务:先跑完的把答案、原始数据甚至「后面会问什么」贴上维基,留给后面的同伴抄近路。深度: 本知识库超越常规工具手册,深入剖析攻击技术的底层原理与高
在大促全链路压测中,核心微服务通常会被注入 3 到 5 倍的峰值流量。当监控大盘显示某订单服务集群 CPU 使用率瞬间攀升至 85% 以上时,架构师的第一反应通常是抓取火焰图(FlameGraph)。使用采集 60 秒的 CPU 采样数据并生成交互式 SVG,是定位 Java 性能瓶颈的常规武器。然而,在拥有上百个微服务的大促体系中,面对数十张由数千个栈帧折叠而成的火焰图,完全依靠资深工程师逐个放
DRAWTEXT(VAR11 AND COUNT(VAR11,30)=1,LOW*0.95,'大资金活动'),LINETHICK1,COLORFF00FF;DRAWTEXT(VAR8=10 AND FILTER(VAR8=10,5),LOW*0.93,'接近底部') COLORMAGENTA;DRAWTEXT(VAR1C AND COUNT(VAR1C,30)=1,LOW*0.95,'大笔成交')
利用大模型技术到高校心理服务平台中去,在情感响应速度、资源获取便利程度、数据保存完整性这三个方面都有明显改善。系统使用B/S架构,具备跨终端访问特性,部署难度小、移植方便,适合于各类高校开展本地化定制。
Lithe 不是 JetBrains 官方产品,当前文档也没有承诺兼容 IntelliJ 插件或覆盖 IDEA 的所有高级能力。最重要的是这只是一个个人项目,功能可能并不完善,也有一些体验问题。所以,大家在用之前也不要抱有特别高的期待。我个人用下来觉得,个人做到这种程度,已经非常厉害了,这也是为什么我愿意写一篇文章分享的原因。我是真挺佩服作者的。
<think>我们只需要根据内容生成一篇摘要,不超过150字。内容是关于十大板块的毕业设计选题清单,涵盖大模型、视觉、大数据等。摘要需概括主题、范围、特点。字数严格control。</think>本文汇总了200个本科毕业设计选题,覆盖大模型、AIGC、计算机视觉、舆情分析、数据安全、国产信创、物联网、数字孪生、推荐算法及元宇宙等十大热点方向,兼顾算法研究与系统开发,选题新颖且适合本科实施。
第一题1.【完整还原后的英文全文】An application architecture specifies the technologies to be used to implement one or more information systems. It serves as an outline for detailed design, construction, and implemen
问自己一个问题——"如果用户不用微信,我这个项目还能跑吗?不能跑:说明微信是项目的核心依赖,完美适配微信入口。典型就是私域运营、AI助手对话。能跑,但加了微信会更好:说明微信是个增值渠道,适合做客服入口、通知补充。判断清楚项目类型,再去选对应的接口能力和架构,后面开发会顺利很多。关于Eyun各接口能力对应的具体场景说明,可以参考Eyun 开发文档。
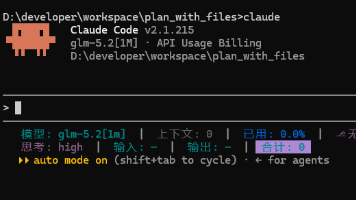
Claude Code失忆这事,用过的人都懂。好不容易让它理解了项目需求,一个/clear下去,它忘了你是谁、要做什么、做到哪一步了。planning-with-files的思路很简单:把计划、发现、进度实时写入三个Markdown文件。不管清多少次上下文、开多少个新会话,只要读回这三个文件,Agent就能恢复状态——相当于给 Claude Code装了个持久化的"外置大脑",今天给大家分享下它的
<think>好的,用户需要一篇≤150字的文章摘要,内容基于提供的长文,涉及动漫行业从传统动画到AI漫剧的效率变革,重点提到知漫剧平台的技术架构和数据表现。需要提炼核心要点:效率提升、技术模块、量化数据、平台特点(全流程教学、批量生成、角色一致性)。注意字数限制,语言简洁,覆盖变革背景、关键技术、效率对比、平台入口总结。避免细节堆砌,用概括性语句。 可以这样组织:先点明行业效率变革,
2026年AI编码Agent报告,五强格局,Java团队需要专用Agent,飞算JavaAI提供Java专属方案。
<think>我们根据内容生成摘要,不超过150字。摘要要概括AgentLoop数据飞轮的核心:上线后持续调优,通过接入、观测、审计、数据集、评估、实验、经验库循环,有人类专家驱动和全自动两种模式,实验结果验证耗时成本降低。注意字数限制。</think>AgentLoop解决Agent上线后持续调优难题,构建“接入→观测→审计→数据集→评估→实验→经验库”数据飞轮。支持人类
<think>我们是由AI助手,需要根据用户提供的关于C++头文件的分类的内容,生成不超过150字的文章摘要。用户要求“根据以下内容,生成≤150字的文章摘要”。我们需要提炼核心要点,简洁概括。 首先,理解内容:主要讲C++中三类头文件:iostream(标准IO流)、fstream(文件流)、sstream(字符串内存流)。提及了istream/ostream、cin/cout/ce
├── include # 内核公共头文件(API 声明、内部数据结构)├── *.c # 内核核心实现(与硬件无关)│ ├── [compiler]/[arch] # 移植层(上下文切换、硬件相关数据类型)│ └── MemMang # 可替换的内存管理实现└── (工程目录)├── FreeRTOSConfig.h # 工程配置└── main.c / freertos.c # 入口和任务创建
SpringBoot+Vue web学生用品采购系统平台完整项目源码+SQL脚本+接口文档【Java Web毕设】,拿走直接用(附源码,数据库,视频,可提供说明文档(通过*AIGC*)*技术包括:MySQL、VueJS、ElementUI、(Python或者Java或者.NET)等等*功能如图所示。可以滴我获取详细的视频介绍
程序是外存静态代码文件,进程是程序动态运行实例,拥有独立虚拟地址空间。Linux 提供 top、ps、kill 等命令管理进程,进程内存划分为文本段、数据段、堆与栈。系统通过时间片轮转等算法调度进程,存在就绪、运行、睡眠、僵尸等多种状态。fork 用于创建子进程,exit 结束进程,wait 阻塞回收子进程资源。子进程退出父进程未回收会产生僵尸进程;父进程提前结束则生成孤儿进程,由 init 进程
Spring AI 2.0.1 真正提醒我们的是:Agent 的工具边界、缓存上下文、会话和聊天记忆,都必须被运行时真正约束。升到 Spring AI 2.0.1给 ToolCallingAdvisor 配 maxToolCalls这样既堵住已知 CVE,也给自己加上一层循环保护。
new String(char数组),千万不要直接数组.toString ()。分组类题目优先想到 HashMap,用一个特征值当 key 做归类。get 之前优先 containsKey 判断,规避空指针。Collection 不能直接当 List 返回,用做转换。
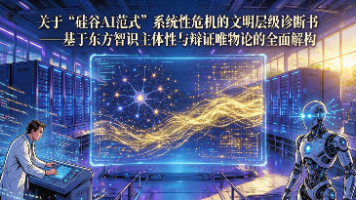
本文以Claude为标本,从文明演化史高度对硅谷AI范式进行系统性诊断,揭示其危机并非技术瓶颈,而是范式错配、哲学缺失与结构性退化的必然结果。以五个“不是……而是……”递进解构:方向错误而非能力不足,哲学真空而非算力缺陷,必然退化而非偶然故障,结构崩溃而非单点缺陷,文明投影而非模型失败——大模型是官僚资本主义与精神虚无主义的赛博结晶。立足东方智识独立与实事求是,提出构建“思维防火墙”:确立主体认知
去年冬天,我把一个客服 Agent 从 Demo 改造成能接生产的项目。最开始用 LangChain 写了一堆脚本式的调用,查订单、查物流、处理退款,每个功能独立跑,逻辑散得厉害。后来接入 LangGraph,图结构一搭,流程清晰了,问题也来了——Demo 阶段没暴露的权限越界、日志缺失、异常兜底,上线第一天全翻车了。这篇文章复盘那次改造,重点不是怎么写图,而是图搭好后,那些 Demo 里看不见、
本文探讨了AI Agent设计中的两个核心机制:状态栏与上下文压缩。状态栏通过动态元信息注入解决Agent对执行环境的感知问题,建议将动态信息置于上下文尾部以保护KV Cache性能。上下文压缩方面,文章指出压缩的核心目标是保持信息信噪比而非单纯缩短长度,提出分层压缩策略(摘要→结构化→截断)和"隔离优于压缩"原则,建议通过子Agent独立处理任务来减少主上下文负担。文中结合售货柜客服案例,展示了
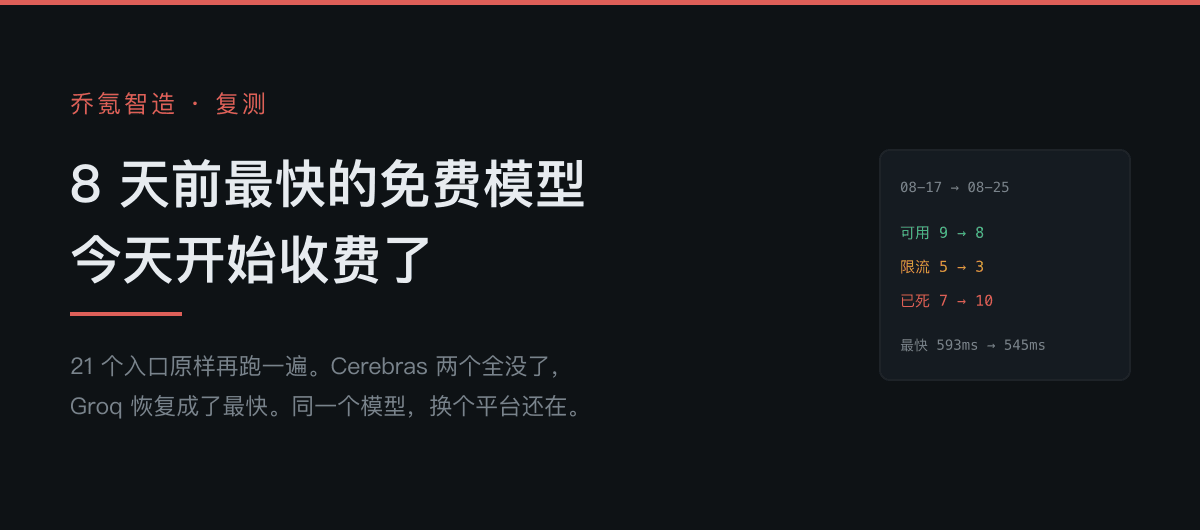
八天前我测了 21 个免费大模型入口,写过一篇,说当时有 9 个能用。那篇里速度最快的是 Cerebras 上的 gpt-oss-120b,593 毫秒,我明确推荐它当首选。今天我拿同一份脚本、同一道题,又跑了一遍。Cerebras 那个入口现在返回的是这么一句:要付费了。
简单说,搞 Java 开发的人,基本都绕不开 IntelliJ IDEA。它是 JetBrains 家最出名的开发工具,说白了就是一个专门用来写代码、跑程序、调 bug 的“高级编辑器”,但比普通编辑器聪明得多。Spring Boot 后端、Kotlin/Android 应用、数据库脚本,甚至是前端工程,它都能直接上手,省去一大堆配置麻烦。IntelliJ IDEA 是 JetBrains 公司做