20 万条跨国数据实战:我用AI完成全流程数据清洗、分析并输出可视化经济报告
先看结果。
217个经济体、22项指标、1960到2024年、202,708条观测记录,最终产出一份带15张图表的Word报告。数据校验对上了世界银行官方口径:2024年全球GDP合计110.62万亿美元、中国18.73万亿、美国29.30万亿。
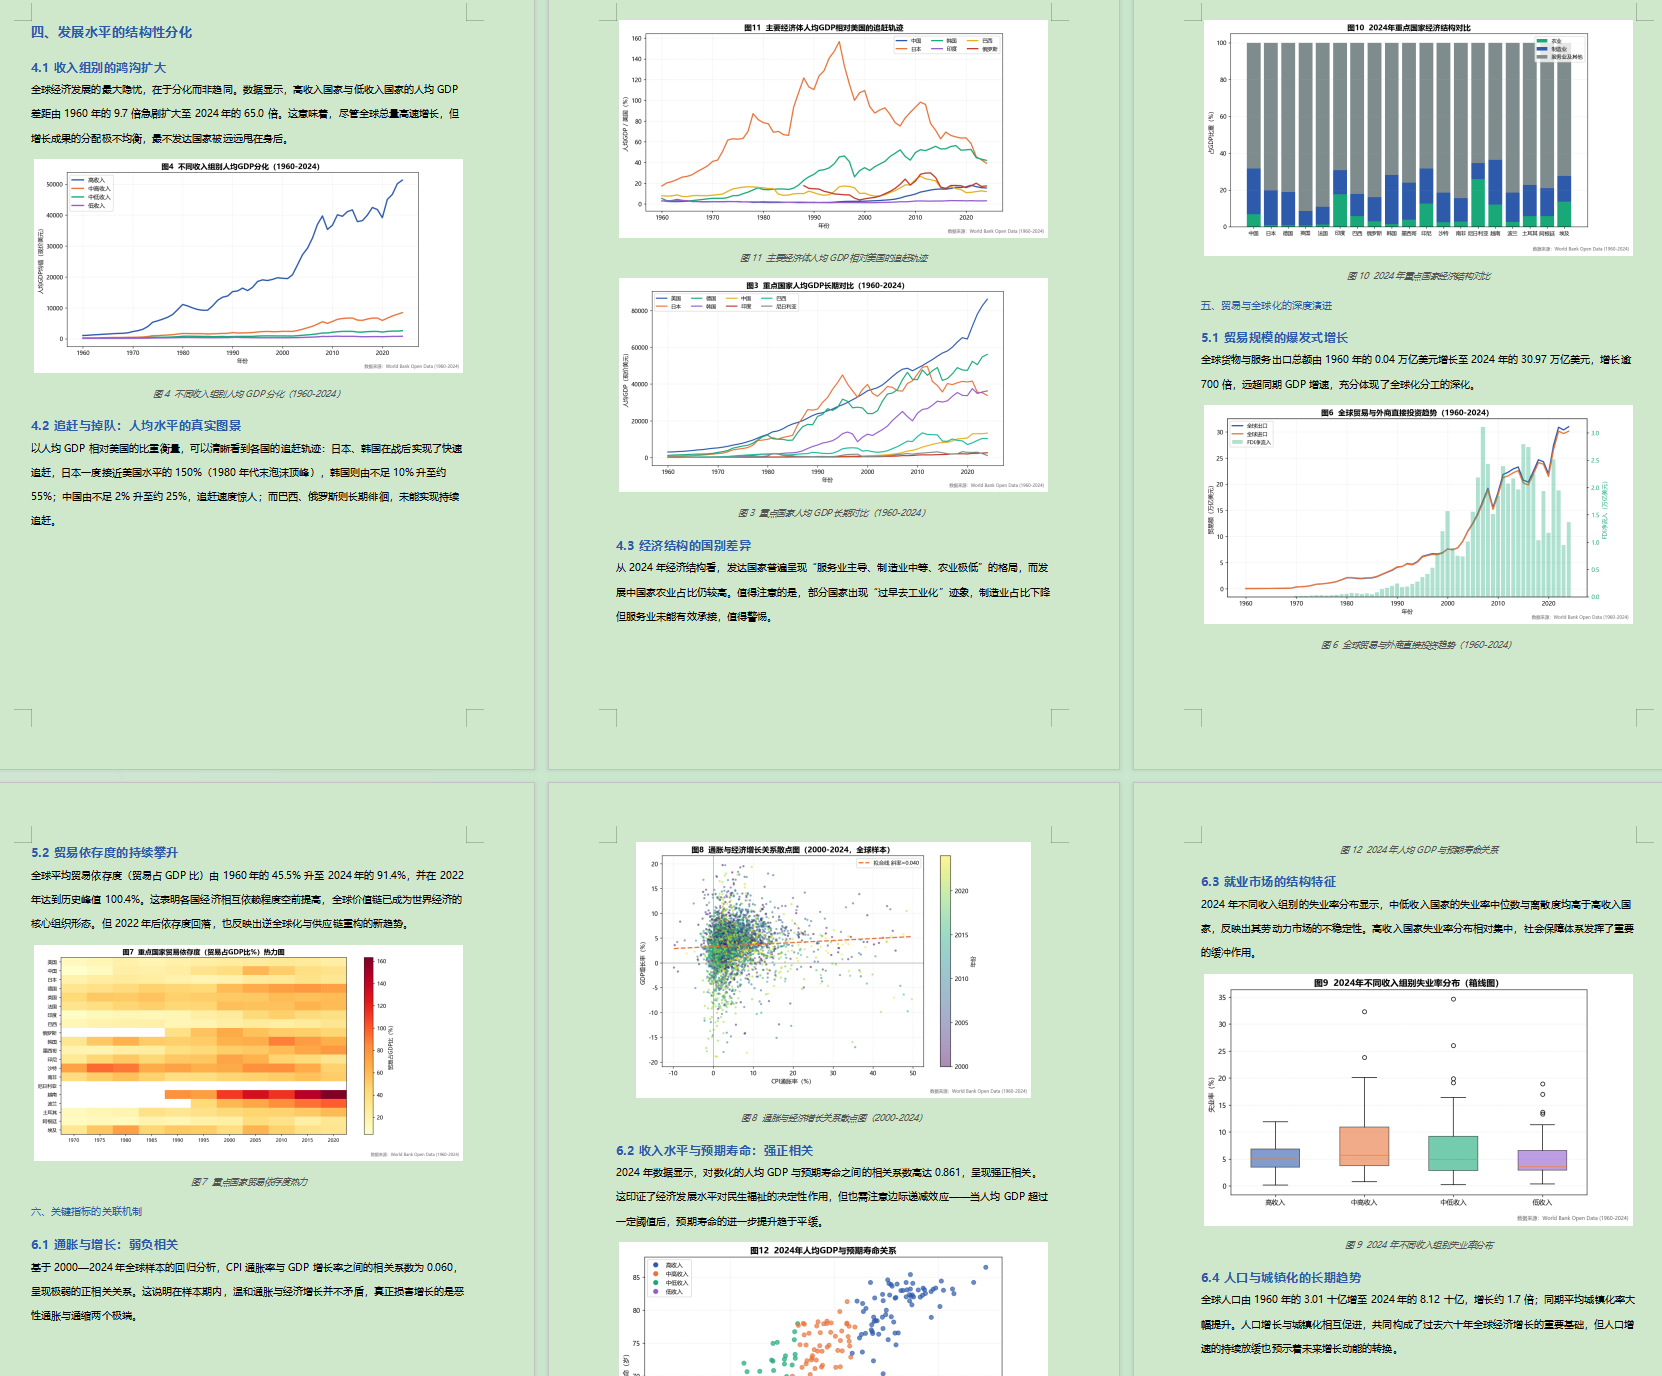
这篇文章记录整个数据工程过程,重点讲抓取和清洗环节踩过的坑。工具用的是AiPy Pro(知道创宇推出的AI智能体),它能实际执行代码任务,不是只给建议。
一、数据源与接口
世界银行公开数据API:api.worldbank.org/v2,无需鉴权,支持按国家、指标、年份维度查询。
核心接口有两个:
- /country:获取国家元数据(含地区、收入分组、经纬度)
- /country/all/indicator/{指标码}:获取某指标的全部国家数据
指标码采用世界银行标准编码,如NY.GDP.MKTP.CD(GDP现价美元)、SP.POP.TOTL(总人口)。本文共抓取22个指标。
二、第一个坑:国家代码字段
这是整个项目最关键的一个坑。
API返回的记录里,country对象长这样:
"country": { "id": "ZH", "value": "Africa Eastern and Southern" },
"countryiso3code": "AFE",
注意:country.id 是两位内部码(ZH、ZI、1A这种),不是标准ISO3。真正的三位码在 countryiso3code 字段里。
我第一次抓取用了country.id,想跟国家列表的ISO3匹配,结果交集为0,20多万条数据全部匹配失败。诊断后发现字段用错了,改用countryiso3code重新抓取,一次到位。
做世界银行数据的一定要记住这个字段差异。
三、第二个坑:聚合体混入
/country 接口返回296条记录,但其中79条是区域或收入组聚合体,比如:
- AFE:Africa Eastern and Southern
- ARB:Arab World
- AFR:Africa(整体)
这些聚合体的数据是成员国之和,如果混进国家列表,会导致全球合计重复计算。过滤方法:只保留ISO3三位码且region不为"Aggregates"的记录,最终得到217个真实经济体。
四、清洗流程
抓取完成后执行五步清洗:
- 国家代码标准化:统一ISO3三位码
- 剔除聚合体:过滤区域/收入组汇总
- 去重:按国家+年份+指标三元组
- 异常值标记:通胀类指标按0.1%和99.9%分位数标记极端值
- 单位统一:美元/百分比/人
关于异常值:CPI通胀和GDP平减指数里存在恶性通胀记录,直接算均值会严重失真。标记了42条极端值,分析时单独处理。
五、数据校验
清洗后必须校验。用三个锚点数字对官方口径:
2024年全球GDP合计110.62万亿美元(世界银行口径约110万亿);中国18.73万亿(官方约18.7万亿);美国29.30万亿(官方约29万亿)。
三个数字全部对上,数据可靠性确认。
六、数据结构
最终输出两种结构:长表(country_code, country_name, year, value, indicator_code, indicator_name)202,708行;宽表(国家×年份,每指标一列)14,105行×27列。
宽表更适合分析,长表更适合存储。
七、后续分析
数据干净之后,分析就顺了。算了几个关键指标:全球GDP 1960到2024年增长86.6倍;美国份额42.45%→26.49%,中国4.69%→16.93%;G7 66.4%→44.9%,金砖7.5%→24.6%;高收入与低收入国家人均GDP差距9.7倍→65倍。
然后生成15张图表,组装成Word报告。
附:我用的完整提示词
没有额外说明,没有参数配置,剩下的AiPy自己搞定。
拉取世界银行60年数据,制作一份跨国经济报告,要求数据抓取到位、分析到位、逻辑严谨,最终输出一份包含大量图表的 Word 报告。
执行要求:
1. 明确报告范围与指标:从世界银行公开数据源(World Bank Open Data / World Bank API)拉取近60年(约1960年代至今)的跨国经济数据。需要覆盖的国家范围、核心经济指标(如GDP、GDP增长率、人均GDP、通胀、人口、贸易、失业率等)以及报告主题重点,若用户未指定则按合理默认执行:____(请补充:目标国家/地区范围);____(请补充:核心经济指标清单);____(请补充:报告主题与重点分析方向)。
2. 数据抓取:使用可用的数据获取能力(如通过 Trustoken-search 检索世界银行数据接口信息,或使用 aipy_builtin 执行 Python 代码调用世界银行 API / 下载数据集),确保数据来源真实、字段完整、时间跨度覆盖约60年。抓取后需做数据清洗与校验(缺失值、异常值、单位统一、国家代码标准化),并保存为本地数据文件(如 CSV/Excel)。
3. 数据分析:基于清洗后的数据开展跨国对比分析,包括但不限于趋势分析、国家间横向对比、分组/聚类、相关性分析、关键转折点识别等,确保分析逻辑严谨、结论有数据支撑。
4. 图表制作:生成尽可能丰富的可视化图表(折线图、柱状图、散点图、热力图、地图、堆叠图、箱线图等),覆盖时间趋势、国家对比、指标关系等维度,图表需有清晰标题、坐标轴、图例与数据来源标注。
5. 报告输出:将分析结论与图表整合为一份结构完整的 Word 报告(.docx),包含封面/标题、摘要、数据来源与方法说明、分章节分析、图表、结论与局限说明。报告文件需保存到本地并给出绝对路径。
6. 验证方式:确认数据文件已成功生成且记录数/时间跨度符合预期;确认 Word 报告可正常打开、图表已正确嵌入、章节逻辑完整;对关键结论做交叉核对。
7. 交付物:世界银行原始/清洗后数据文件、分析脚本、图表文件(如单独保存)、最终 Word 报告。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐

 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)