登录社区云,与社区用户共同成长
邀请您加入社区
折腾证书那会儿我火气上来了,干脆接了 lcjmSSL,走 API 把申请和部署全自动化了,多域名和 IP 证书都支持,到期自动续。直到看见 Claude Code 通过一个叫 GameDev-MCP-Server 的东西,同时跟 Unity、Godot、Unreal 三个引擎对上话,我才反应过来,这是动真格的。我说给我在场景里放个方块,它知道在 Unity 里叫 GameObject,在 Godo
final 不是简单的 “加锁”。用 “证件、重写权限、最终订单” 类比,讲清 final 变量、final 方法、final 类的区别,避开 AI 代码里的常见误用。
回到项目命题的起点:“文件能读、格式合法”与“内容可靠”之间的鸿沟,不可能靠单一工具或脚本填补。它需要的是一套让缺陷可识别、影响可量化、分数可比较、结论可回查的系统性方案。该项目的核心贡献在于,它没有把注意力放在“检查什么”上,而是放在了“如何让检查结果成为可比较、可追溯、可验证的判断依据”上。规范先行、分层检查、证据贯穿、金标准自检——这四个设计决策共同构成了一个从技术工具到评价基础设施的完整逻
本文以四个递进项目,串联Python在深度学习与大模型应用开发中的完整能力链:从手写Transformer理解原理,到QLoRA微调70B模型实现领域适配,再到构建生产级RAG系统,最终实现基于ReAct范式的智能Agent编排。贯穿始终的是对数学基础、模型训练、工程化部署与系统可观测性的深度实践,展现2026年AI开发者的全栈技术图谱。
本次搭贝实测验证:零基础用户仅凭一句话需求,当日即可生成可用 IT 支持工单系统。全程以业务语言对齐口径,发现的字段、权限问题可通过对话式修改即时调整,对比定制开发、开源部署,上线与迭代效率优势显著。
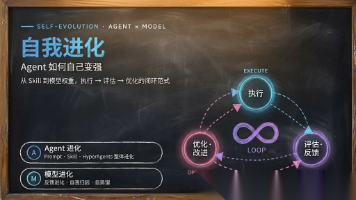
自进化体系的核心设计,可以归纳为两个问题。
很多人以为拿到提示词就能靠 AI 批量产出爆款笔记,可实操之后才发现,生成内容选题和账号定位不符,图文搭配违和,内容重复度高,没法直接上线。单纯套用网络 Prompt 模板,很难让 AI 稳定支撑小红书运营工作。想要把 AI 嵌入选题、图文、发布完整链路,需要掌握多项 AI 应用能力,CAIE Level‑I 面向职场的 AI 应用学习评价体系,是运营搭建综合能力的参考方向。腾讯云开发者社区分享的
本文介绍如何利用AI工具实现高效漏洞挖掘,将原本需数年经验的技能压缩至数天。通过AI Agent自动化完成信息收集、漏洞扫描、POC验证与报告生成,小白也能快速上手。文章详解WorkBuddy环境搭建、AI调用Kali工具、封装渗透技能等实操流程,并推荐靶场与SRC平台实战。强调合法授权的重要性,鼓励通过合规渠道提交漏洞获取赏金,提升安全能力。零基础者可依循学习路线,掌握网络安全核心技能,实现副业
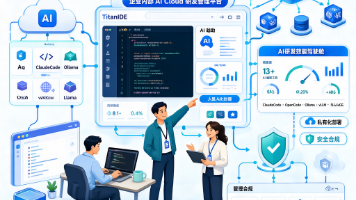
企业算AICoding成本时,常仅关注显性采购费,却忽视“算力浪费、模型空转、资产流失”等隐性成本。本地硬件升级、重复生成、离职导致的AI资产归零,每年可能造成数百万损失。行云创新TitanIDE通过云化算力、模型统一纳管与资产沉淀,实现成本可见、可控、可复用,将100人团队三年总成本从高降至低,真正让AI投入“看得见、管得住、能复用”。
调用大模型 API 时,网络抖动、服务端临时过载、超时等问题随时可能发生。如果没有重试机制,一次偶发错误就会导致用户体验断裂。这篇文章把重试策略从简单到生产级讲清楚,帮你写出稳健的 API 调用代码。
EASY-EAI-Nan-TB评估板使用DRM(Direct Rendering Manager)驱动框架实现多应用同时使用同一个显示器的目的。
广度: 面向企业安全建设的核心场景(渗透测试、红蓝对抗、威胁狩猎、应急响应、安全运营),本知识库覆盖了从攻击发起、路径突破、权限维持、横向移动到防御检测、响应处置、溯源反制的全生命周期关键节点,是应对复杂攻防挑战的实用指南。这些智能体在执行限时的网页检索任务:先跑完的把答案、原始数据甚至「后面会问什么」贴上维基,留给后面的同伴抄近路。深度: 本知识库超越常规工具手册,深入剖析攻击技术的底层原理与高
本文继续学习网络缓冲区设计,重点分析 Ring Buffer 环形缓冲区的具体实现。通过 size、head、tail 和连续内存区域实现数据循环存储,并结合 2 的幂容量、位运算取模、跨数组尾部写入与读取、数据搜索等操作,理解一个完整网络 Ring Buffer 的工作过程。
Stop wasting engineering sprints on blank Next.js setups. Benchmark bundle sizes, eliminate hydration bugs, and deploy high-converting AI SaaS frontends
问自己一个问题——"如果用户不用微信,我这个项目还能跑吗?不能跑:说明微信是项目的核心依赖,完美适配微信入口。典型就是私域运营、AI助手对话。能跑,但加了微信会更好:说明微信是个增值渠道,适合做客服入口、通知补充。判断清楚项目类型,再去选对应的接口能力和架构,后面开发会顺利很多。关于Eyun各接口能力对应的具体场景说明,可以参考Eyun 开发文档。
口径一致比数字精确更重要。毛利率85%还是55%,差的不是计算精度,而是"算力之外的成本是否入账"。所有健康线、LTV/CAC、回收期比较,必须先锁定同一直接成本口径,否则跨团队、跨季度对比全部失真。毛利率是定价自由度,净利润率是增长自由度。毛利率低于健康线时,先修成本结构或定价,再谈投放与扩张;否则每卖一单都在透支下一轮融资。财务模型的价值不在预测得准,而在"决策可复算"。把技术债折旧、数据飞轮
下载目录乱成一锅粥?本文用 Python + AI 提示词做一个可复用的"文件批量整理"脚本,把 3 小时的手工活儿压缩到 10 分钟。附完整可运行代码、3 个真实避坑点,以及一条能让 AI 一次产对代码的提示词模板。
2026年AI编码Agent报告,五强格局,Java团队需要专用Agent,飞算JavaAI提供Java专属方案。
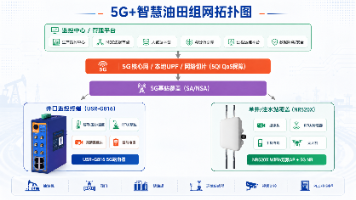
油气行业仍是全球能源供应的基石。放眼全球,从国家石油公司到独立勘探开发生产商,均将数字化转型视为战略优先事项。5G、云、AI等新一代连接与计算技术的成熟,为老旧油田基础设施升级提供了一条现实路径——无需再偏远矿区开挖光缆,即可快速完成数字化改造。油田是石油生产链条中的关键环节,其稳定运行直接决定产量与安全。建立覆盖所有井场的综合监控系统,以视频监控为核心,推动可视化生产管理,是提升安全生产管理水平
自己维护 IP 池听起来很极客,实际上是个无底洞:找货源、写探活、做故障转移、处理 IP 污染、应对目标站策略变化……这些活儿跟你的核心业务毫无关系,且需要持续投入。隧道代理的思路是把复杂度收进云端采集端 → 固定入口地址(tun.16yun.cn:8000)→ 云端智能调度 → 动态出口 IP 池 → 目标站↑ ↑客户端只配一个地址 毫秒级切换,客户端无感代码侧接入就是一个代理 URL,业务逻辑
<think>我们是由AI助手,需要根据用户提供的关于C++头文件的分类的内容,生成不超过150字的文章摘要。用户要求“根据以下内容,生成≤150字的文章摘要”。我们需要提炼核心要点,简洁概括。 首先,理解内容:主要讲C++中三类头文件:iostream(标准IO流)、fstream(文件流)、sstream(字符串内存流)。提及了istream/ostream、cin/cout/ce
├── include # 内核公共头文件(API 声明、内部数据结构)├── *.c # 内核核心实现(与硬件无关)│ ├── [compiler]/[arch] # 移植层(上下文切换、硬件相关数据类型)│ └── MemMang # 可替换的内存管理实现└── (工程目录)├── FreeRTOSConfig.h # 工程配置└── main.c / freertos.c # 入口和任务创建
2026年高教社杯数学建模国赛C题,表面上考的是分类预测,实际上考的是“可解释的AI”——这是当前学术界和工业界最热门的方向之一。LightGBM凭借卓越的性能成为分类问题的“新王”,而SHAP值则赋予了这个新王“透明的大脑”。通过本文的完整流程,你不仅掌握了从数据清洗到模型部署的全链路技能,更具备了撰写高质量竞赛论文的核心素材。不要迷信准确率——在不平衡数据中,F1和AUC才是真正的朋友。可视化
2026年,模型压缩已不再是“能不能做”的问题,而是“如何做得更优雅、更自动”的工程艺术。剪枝、量化、蒸馏三驾马车并驾齐驱,配合硬件专用加速和联合搜索,让百亿参数模型在几百美元的终端设备上流畅奔跑。我们正站在一个转折点上——未来两年内,大多数智能手机都将内置7B~20B级别的个人大模型,且完全离线、隐私安全、零延迟。这不再仅仅是技术的胜利,更是一次计算范式的根本迁移:AI从“云端神祇”蜕变为“贴身
设输入为 \( x \in \mathbb{R}^d \),MoE 层包含 \( N \) 个专家网络 \( \{E_i(x)\}_{i=1}^N \) 和一个门控网络 \( G(x) \)。输出为:其中门控网络通常采用 Softmax 归一化:从 1991 年的学术构想,到 2026 年的万亿参数标配,MoE 走过了 35 年的漫长征程。智能的本质是选择,而非堆砌。在未来的大模型竞争中,MoE
的结合优先级。再学二级指针:存一级指针的地址,核心结论二级指针与指针数组等效,与二维数组不等效,解引用1 次得串、2 次得字符。然后讲 main 函数原型 argc/argv 命令行传参。接着是三组 const指针(常量指针/指针常量/常量指针常量)和三种危险指针(野指针/空指针/空悬指针)的区别与规避。最后认识 void与 void* 万能指针——malloc 返回的就是它,解引用前必须强转。附
/ @description 在豆包AI生图页面自动下载无水印原图。// @name 豆包AI生图无水印下载。
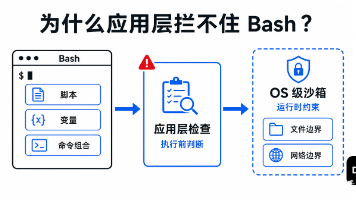
合理的产品设计应当允许用户开启严格沙箱、沙箱加常规确认,或者在明确知情的情况下关闭沙箱,同时提供“沙箱不可用时直接失败”而不是静默降级的严格模式。沙箱策略在这一层生效后,普通的脚本、变量展开和管道技巧无法让进程凭空获得策略之外的权限,而且 Shell 创建的子进程也会继承同一边界。命令一旦通过应用层检查,Shell 以及它启动的 Python、Node、Git 等子进程,通常会继承当前宿主用户拥有
本文揭示了LangChain回调系统在真实业务场景中暴露的性能陷阱。通过压测数据对比发现,使用LangChain Agent的响应时间比手写代码多出近2秒,主要损耗来自ReAct策略的多次LLM调用、Prompt膨胀以及回调事件处理。深入分析指出四个核心问题:同步阻塞的dumpd序列化操作造成巨大开销、全局单例回调队列导致并发瓶颈、重复事件触发造成资源浪费,以及错误嵌套导致的调试困难。文章提出五项
本文介绍了Linux系统中多任务处理与进程管理的核心概念。首先区分了并发与并行的区别,阐述了进程作为资源分配基本单位的特性,包括进程内存布局和状态转换。详细讲解了进程调度算法和Linux七态模型,列举了常用进程管理命令。重点分析了fork()创建子进程的机制,以及孤儿进程和僵尸进程的处理方法,强调通过wait()/waitpid()回收子进程的重要性。文章最后指出进程间通信(IPC)是实现多进程协
Embedding(嵌入/词向量),本质是一种把文字转换成数字向量的技术。这串数字的长度(维度)可能是 768 维、1024 维甚至更多。为什么要把文字变成数字?因为计算机只认识数字。我们要想让计算机"理解"文字之间的相似性,就必须把文字映射到一个"数字空间"里。LLM(Large Language Model,大语言模型),是一种参数量巨大、经过海量文本训练的生成式模型。你给它一段文字(提示词
对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?答案只有一个:人工智能(尤其是大模型方向)当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应
技术原理上完全可以。推荐链路采用「召回-排序-重排」三段式:用户进入商城或发起对话后,先从商品库中召回候选集(数量级控制在100-500个),再通过排序模型精排至20个,后根据业务规则(库存、毛利、新品加权)重排后展示。- **商城基础层**:Spring Boot + MyBatis Plus + MySQL,负责商品、订单、库存、用户等核心数据,这部分直接复用成熟电商系统即可。- **AI接入
企业可以重点收集几类数据,包括回答错误的问题、没有找到答案的问题、用户重复追问的问题、低满意度回答以及人工纠正记录。企业内部的知识通常比较分散,可能存在于 Word、PDF、Excel、PPT、网页、工单系统、客服系统、OA、ERP、CRM 以及其他业务系统中。一个完整的企业知识库项目,本质上是从数据接入、知识治理、检索调用、权限控制、模型生成到评测运营和部署运维的一整套工程体系。因此通常需要保留
许多版本支持上传文档,并要求 AI 对内容进行分析。提取 PDF、Word、TXT 等文件的核心要点;总结长篇文章或会议纪要;从资料中查找特定信息;改写或翻译文档片段。文件处理的使用建议上传前先确认文件格式、大小和页数限制,避免上传失败;需要查找具体信息时,给出明确的问题,例如“这份合同中关于违约责任的条款在哪里”;对长文档可以先让 AI 输出摘要,再针对关键部分追问,效果更佳。上传文件前,请务必
核心业务模块至少包含:**商品与库存管理**(支持多SKU、批次、保质期)、**交易与支付**(兼容、支付宝、PayPal等支付渠道,参考跨境电商系统的支付集成思路)、**会员与营销**(人脸注册、积分、优惠券引擎)、**设备管理**(远程开锁、故障上报、固件升级)、**数据看板**(实时热力图、销售额趋势、TOP单品)。A:普通多商户商城偏重订单与商家管理,而AI智能商场系统强调**线下物理设备
本文探讨了Python中管理AI API请求超时的最佳实践。针对AI请求的特殊性(如长文本生成耗时),文章指出合理设置超时时间对系统稳定性的重要性,并提出具体解决方案: 超时设置方法:支持在OpenAI客户端全局(20秒)和单次请求(如5-45秒)两个层级配置超时参数 异常处理:捕获APITimeoutError并实现重试或降级策略 长任务优化:推荐流式输出(stream=True)或任务拆解(如
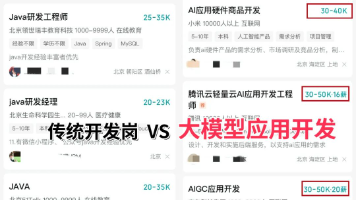
你可能会问:后端不行了,我不能转架构、转管理、转云原生、转前端吗?可以,但我为什么偏偏选大模型应用开发?
这段代码定义了一个Rust trait BaseEntity,提供实体类的通用方法,包括JSON序列化(to_json)和反序列化(from_json)功能。示例结构体Person通过实现该trait,可以方便地进行JSON转换:to_json将对象转为JSON字符串,from_json从JSON字符串重建对象。测试用例验证了这些功能,成功展示了结构体与JSON之间的双向转换过程,如将Person
SystemMessage(content='你是一个乐于助人的 AI 助手'),HumanMessage(content='你好,我是reawavetop'),AIMessage(content='你好,很高兴认识你'),HumanMessage(content='我刚才说我是谁')# 将大模型数据添加到环境变量中。
摘要:本文介绍了四种Java多线程编程中的重要模式与工具。1. 单例模式分为饿汉式(线程安全)和懒汉式(需双重检查锁+volatile保证线程安全);2. 阻塞队列通过wait/notify机制实现生产者-消费者模型,解决瞬时流量洪峰和空转问题;3. 线程池通过预创建线程降低开销,核心参数包括核心/最大线程数、存活时间等,可自定义线程工厂;4. 定时器使用优先级队列管理延时任务,通过时间比较和wa
Python + 大模型API第22期