火焰图 AI 自动化解读:快速定位 CPU 密集型热点方法
·
火焰图 AI 自动化解读:快速定位 CPU 密集型热点方法
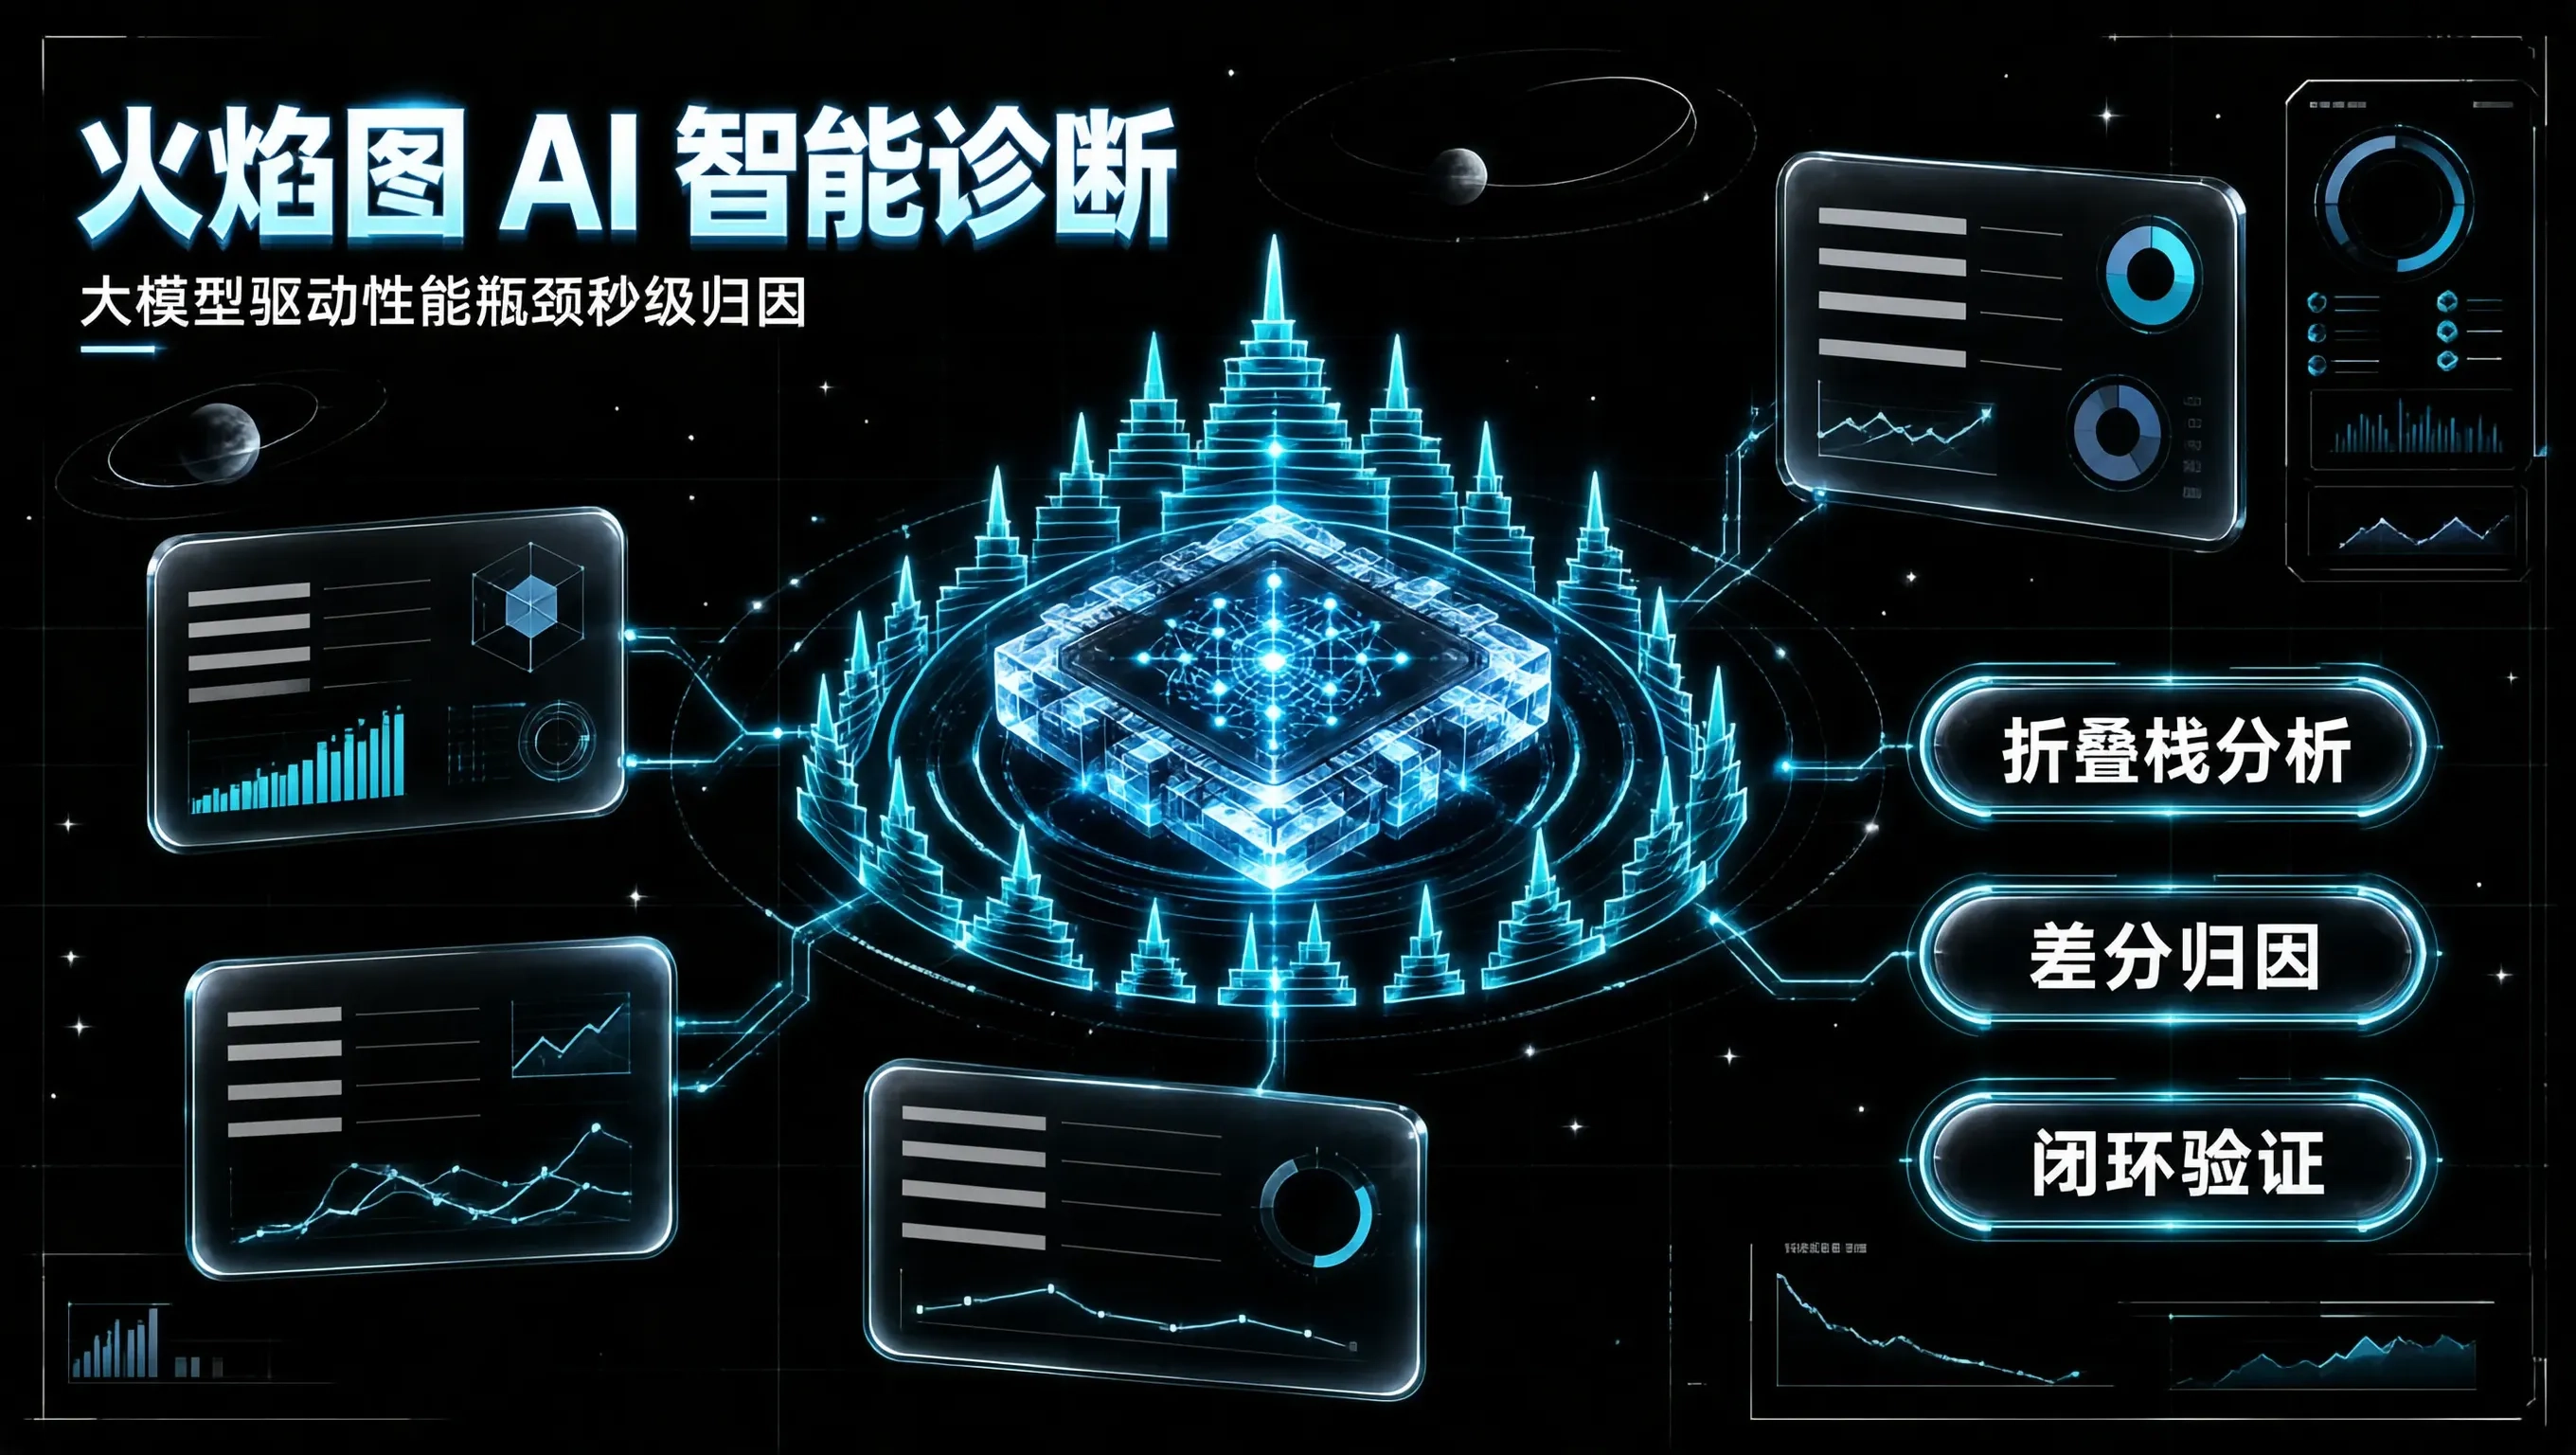
在大促全链路压测中,核心微服务通常会被注入 3 到 5 倍的峰值流量。当监控大盘显示某订单服务集群 CPU 使用率瞬间攀升至 85% 以上时,架构师的第一反应通常是抓取火焰图(FlameGraph)。使用 async-profiler 采集 60 秒的 CPU 采样数据并生成交互式 SVG,是定位 Java 性能瓶颈的常规武器。
然而,在拥有上百个微服务的大促体系中,面对数十张由数千个栈帧折叠而成的火焰图,完全依靠资深工程师逐个放大、比对宽度、排查耗时,不仅效率低下,而且容易遗漏那些分散在各个业务分支中的“微小但高频”的 CPU 泄漏点。通过构建火焰图的自动化解析引擎,并借助大模型对折叠栈(Folded Stacks)进行语义识别与差分归因,可以实现秒级定位 CPU 密集型热点。
折叠栈数据的标准化提取与预处理
火焰图的原始数据本质上是采样周期的调用栈聚合文本(Collapsed Stacks)。每一行记录了一条完整的调用链路及其被采样的样本数(Samples):
org/springframework/web/servlet/DispatcherServlet.doDispatch;com/example/trade/OrderController.createOrder;com/example/trade/util/JsonUtils.parseObject 14502
org/springframework/web/servlet/DispatcherServlet.doDispatch;com/example/trade/OrderController.createOrder;java/util/regex/Pattern.matcher 9820
在将数据输入分析管道前,必须进行三级降噪处理:
- 系统与框架底层栈帧折叠:将 JVM 内部调用(如
Interpreter、CallStub)以及框架通用分发层(如 Spring MVC 的前置 Filter 链)压缩为标准命名节点,保留业务边界。 - 绝对采样转占比差分(Differential Ratio):压测基线版本(Baseline)与当前版本(Target)的采样总数不同,必须将行样本数归一化为百分比,并计算每个方法节点的占用宽度增量 $\Delta W$。
- Top-N 热点栈剪枝:提取自耗时(Self Time,即作为栈顶出现的频率)最高的前 20 个方法,以及总耗时(Total Time,作为调用链中继出现的频率)增量最大的前 10 条路径。
def parse_collapsed_stacks(file_path: str) -> dict:
    stacks = {}
    total_samples = 0
    with open(file_path, 'r', encoding='utf-8') as f:
        for line in f:
            parts = line.strip().rsplit(' ', 1)
            if len(parts) == 2:
                stack, count = parts[0], int(parts[1])
                stacks[stack] = count
                total_samples += count

    # 归一化为占比
    return {stack: count / total_samples for stack, count in stacks.items()}
AI 智能诊断的三大识别范式
将预处理后的差分栈摘要以结构化上下文形式传递给大模型,模型结合 Java 底层运行时特征,能迅速归纳出具体的性能病灶:
1. 隐式高频对象序列化与反序列化
在大促下单链路中,很多开发习惯在 AOP 切面或日志打印中无意识调用 JSON.toJSONString(largeRequest)。
- 特征表现:
Jackson/Fastjson的SerializerProvider或ASMSerializer在火焰图中占据宽达 25% 的平台期,且分布在各非核心业务方法内部。 - AI 诊断结论:提示存在不必要的全量日志序列化,建议将日志级别提升为 DEBUG,或使用针对特定字段的惰性 ToString 构建器。
2. 正则表达式编译回溯与非预编译 Pattern
- 特征表现:
java.util.regex.Pattern.compile频繁出现在栈顶,或Pattern.matcher伴随极深的递归循环。 - AI 诊断结论:识别出代码在高频循环内重复调用
String.matches()或未声明static final Pattern,指出潜在的 ReDoS 风险和 CPU 烧毁点。
3. 隐式装箱与并发数据结构低效遍历
- 特征表现:
java.lang.Long.valueOf或ConcurrentHashMap.size()占据异常高的采样宽度。 - AI 诊断结论:精准定位 Stream 流操作中的频繁拆装箱开销,建议替换为基本类型专用的
LongStream或使用LongAdder替代并发计数。
// 典型的热点排查修复样例:消除正则重复编译与无效反序列化
public class HotMethodOptimizationSample {
    // 错误写法:每次方法调用都触发正则编译与字节码解析
    public boolean validateItemCodeBad(String code) {
        return code.matches("^[A-Z]{3}-\\d{8}$");
    }

    // 优化写法:预编译 Pattern,消除栈顶 CPU 消耗
    private static final Pattern CODE_PATTERN = Pattern.compile("^[A-Z]{3}-\\d{8}$");
    public boolean validateItemCodeOptimized(String code) {
        return CODE_PATTERN.matcher(code).matches();
    }
}
闭环验证:自动化生成优化 Pull Request 建议
AI 分析不仅仅停留在“输出文字报告”,其核心价值在于直接给出修复代码上下文与预期收益评估:
- 调用栈逆向索引:根据火焰图热点方法的完整类名与行号,直接关联至 GitLab 仓库的最新 Commit 变更。
- 性能回归验证:在 CI 阶段的压测流水线中自动比对优化前后的火焰图 SVG,当目标方法的 CPU 占用比例下降超过预设阈值(例如从 18% 下降至 1.5%)时,自动标记优化生效。
在大促备战期的实际运行中,该体系将单次压测瓶颈的排查耗时从平均 45 分钟缩短至 3 分钟以内,帮助团队在大促封网前拔除了 30 余处隐蔽的 CPU 性能地雷。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 7
 0
- 0


 已为社区贡献5条内容

所有评论(0)