【AI大模型部署】6种常用的大模型部署方式,你知道几种?
前言
本文详细介绍Transformers、ModelScope、vLLM、Llama.cpp、Ollama、TGI 这几种常用的大模型部署方式,包含具体的部署方法、适用情况以及优缺点分析,为大家做大模型部署技术选型提供依据。
1. Transformers
1.1 部署方法:
- 使用 Hugging Face 的 Transformers 库,该库集成了上千个预训练模型以及丰富的推理管道和示例代码。
- 可以通过 AWS SageMaker Inference Toolkit 将模型打包成容器,并一键发布为实时 API Endpoint。
- 也可以在 HF 平台上创建托管式推理端点,支持自动扩缩容、版本管理与监控。
1.2 适用情况:
- 适用于需要快速部署和推理多种预训练模型的场景。
- 适合于需要利用 Hugging Face 丰富生态和社区支持的项目。
1.3 优缺点:
- 优点:成熟的开源生态,丰富的预训练模型和推理支持。
- 缺点:可能对于特定硬件或部署环境的优化不足,需要额外的配置和调整。
案例:
1、安装依赖
pip install transformers torch fastapi uvicorn
2、加载预训练模型和分词器
from transformers import BertForSequenceClassification, BertTokenizer
model_name = 'Qwen/Qwen3-8B'model = BertForSequenceClassification.from_pretrained(model_name)tokenizer = BertTokenizer.from_pretrained(model_name)
3、构建API服务
from fastapi import FastAPI, HTTPExceptionfrom pydantic import BaseModelimport torch
app = FastAPI()
class TextIn(BaseModel):	text: str
@app.post("/predict")async def predict(text_in: TextIn):try:# 对输入文本进行编码		inputs = tokenizer(text_in.text, return_tensors="pt", padding=True, truncation=True, max_length=512)# 使用模型进行预测with torch.no_grad():			outputs = model(**inputs)# 获取预测结果		predictions = torch.nn.functional.softmax(outputs.logits, dim=-1)		predicted_class = predictions.argmax().item()return {'predicted_class': predicted_class, 'probabilities': predictions.tolist()[0]}except Exception as e:raise HTTPException(status_code=500, detail=str(e))
4、运行运行API服务
uvicorn app:app --reload --host 0.0.0.0 --port 8000
2. ModelScope
2.1 部署方法:
- 登录阿里云 PAI 控制台,在「模型在线服务(EAS)」中选择 ModelScope 模型进行场景化部署。
- 只需配置模型、版本与实例规格等参数即可完成部署。
- 也支持本地容器化部署,通过 Docker 拉取镜像并启动服务。
2.2 适用情况:
- 适用于金融风控、内容审核、智能推荐等需要快速迭代与多模型共存的业务场景。
- 适合于阿里云生态内的用户,能够无缝对接阿里云的其他服务。
2.3 优缺点:
- 优点:端到端的一站式体验,便于快速构建 MLOps 流水线。
- 缺点:主要关注深度学习模型,可能不适用于非深度学习模型或特定的深度学习架构;学习曲线较陡峭;文档和社区支持相对较少。
3. vLLM
3.1 部署方法:
- 通过 pip 安装 vLLM,支持 CUDA 12.1 及更高版本。
- 可以从 Hugging Face 加载模型,也可以指定本地模型路径启动服务。
- 支持多 GPU 分布式部署,通过调整参数实现高效的并行推理。
3.2 适用情况:
- 适用于需要高效推理大模型的场景,尤其是 GPU 资源有限的场景。
- 适合于需要跨多个设备进行推理任务并行执行的分布式部署。
3.3 优缺点:
- 优点:优化了内存使用,高效的并行化,适用于推理优化。
- 缺点:功能较为单一,主要针对推理,缺少一些训练相关的优化;社区和生态相对较小。
案例:
1、安装vLLM
pip install vllm
或者源码安装
git clone https://github.com/vllm-project/vllm.gitcd vllmpip install -e .
2、加载运行模型
从 Hugging Face 加载模型
vllm serve Qwen/Qwen2-7B-Instruct
加载本地模型
vllm serve /path/to/local/model
3、启动方式
单卡启动
vllm serve deepseek-ai/DeepSeek-V3-0324 --port 8000
多卡启动
vllm serve deepseek-ai/DeepSeek-V3-0324 --tensor-parallel-size 4
4. Llama.cpp
4.1 部署方法:
- 克隆 Llama.cpp 代码库并编译生成可执行文件。
- 准备支持的模型格式(如 PyTorch 的 .pth、Hugging Face 的 .safetensors 等),并下载至指定目录。
- 使用 Llama.cpp 提供的工具将模型转换为 GGUF 格式,并进行量化以优化推理速度。
- 启动服务化组件,对外提供模型的 API。
4.2 适用情况:
- 适用于需要优化推理性能的场景,尤其是资源受限的环境。
- 适合于对模型进行量化以减少显存占用和加速推理的需求。
4.3 优缺点:
- 优点:使用 C 语言实现,性能提升明显;提供模型量化工具,优化推理速度。
- 缺点:可能对于某些特定模型或格式的支持不够完善;需要一定的编译和配置工作。
案例:
1、下载代码
git clone https://github.com/ggerganov/llama.cppcd llama.cpp
2、编译
cmake -B build -DGGML_CUDA=ON -DGGML_CUDA_ENABLE_UNIFIED_MEMORY=1cmake --build build --config Release -j 8
3、下载模型和格式转换
从 Hugging Face 或其他模型库下载所需的 LLM 模型,通常是以 .pth(PyTorch 格式)或 .safetensors 格式存在
转换为 GGUF 格式
python convert.py ./models/your-model-path --vocabtype spm
4、部署模型
./llama-server -m ./models/your-model-q8.gguf --port 8080
5. Ollama
5.1 部署方法:
- 安装 Ollama,并配置环境变量以指定模型存储路径。
- 通过命令行执行指令下载并运行模型。
- 支持 Docker 部署,结合 Streamlit/Gradio 快速构建 Web UI。
5.2 适用情况:
- 适用于边测边迭代或资源受限环境下的快速试验。
- 适合于需要完全本地化部署,确保数据隐私性的场景。
5.3 优缺点:
- 优点:完全本地化,无须云端依赖;Docker 支持,便于快速构建 Web UI。
- 缺点:可能对于某些高级功能或复杂场景的支持不够完善;社区和文档资源相对较少。
案例:
安装ollama
curl -fsSL https://ollama.com/install.sh | sh
下载和运行模型
ollama run qwen3
6. TGI
6.1 部署方法:
- 准备训练好的模型,并保存为指定格式(如 .h5)。
- 编写 TGI 配置文件,定义模型的输入输出和部署参数。
- 使用 TGI 框架提供的命令行工具部署模型,启动模型服务。
- 创建 API 服务(如使用 FastAPI),使模型可以被外部应用程序访问。
6.2 适用情况:
- 适用于需要高效部署和推理自定义模型的场景。
- 适合于需要构建可扩展的 AI 模型服务的项目。
6.3 优缺点:
- 优点:提供了统一的部署框架和 API 服务构建工具,便于快速部署和推理自定义模型。
- 缺点:可能对于某些特定模型或格式的支持不够完善;需要一定的配置和编码工作。
案例:
1、安装TGI需要的环境
sudo apt-get install libssl-dev gcc -ycurl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | shPROTOC_ZIP=protoc-21.12-linux-x86_64.zipcurl -OL https://github.com/protocolbuffers/protobuf/releases/download/v21.12/$PROTOC_ZIPsudo unzip -o $PROTOC_ZIP -d /usr/local bin/protocsudo unzip -o $PROTOC_ZIP -d /usr/local 'include/*'rm -f $PROTOC_ZIP
2、克隆 TGI 仓库
git clone https://github.com/huggingface/text-generation-inference.gitcd text-generation-inference
3、编译和安装 TGI:
conda activate llm-plus # 激活一个虚拟环境(可选)BUILD_EXTENSIONS=True make install -j
4、下载和部署模型
从 Hugging Face 或其他模型库下载所需的大模型,确保模型格式与 TGI 兼容。
使用 TGI 提供的命令行工具启动模型服务
text-generation-launcher --model-id /path/to/your/model --trust-remote-code --port 4000
好的,以上就是这6种大模型的详细部署方式,你可以根据项目需求、硬件条件等因素进行选择。
如何学习AI大模型?
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

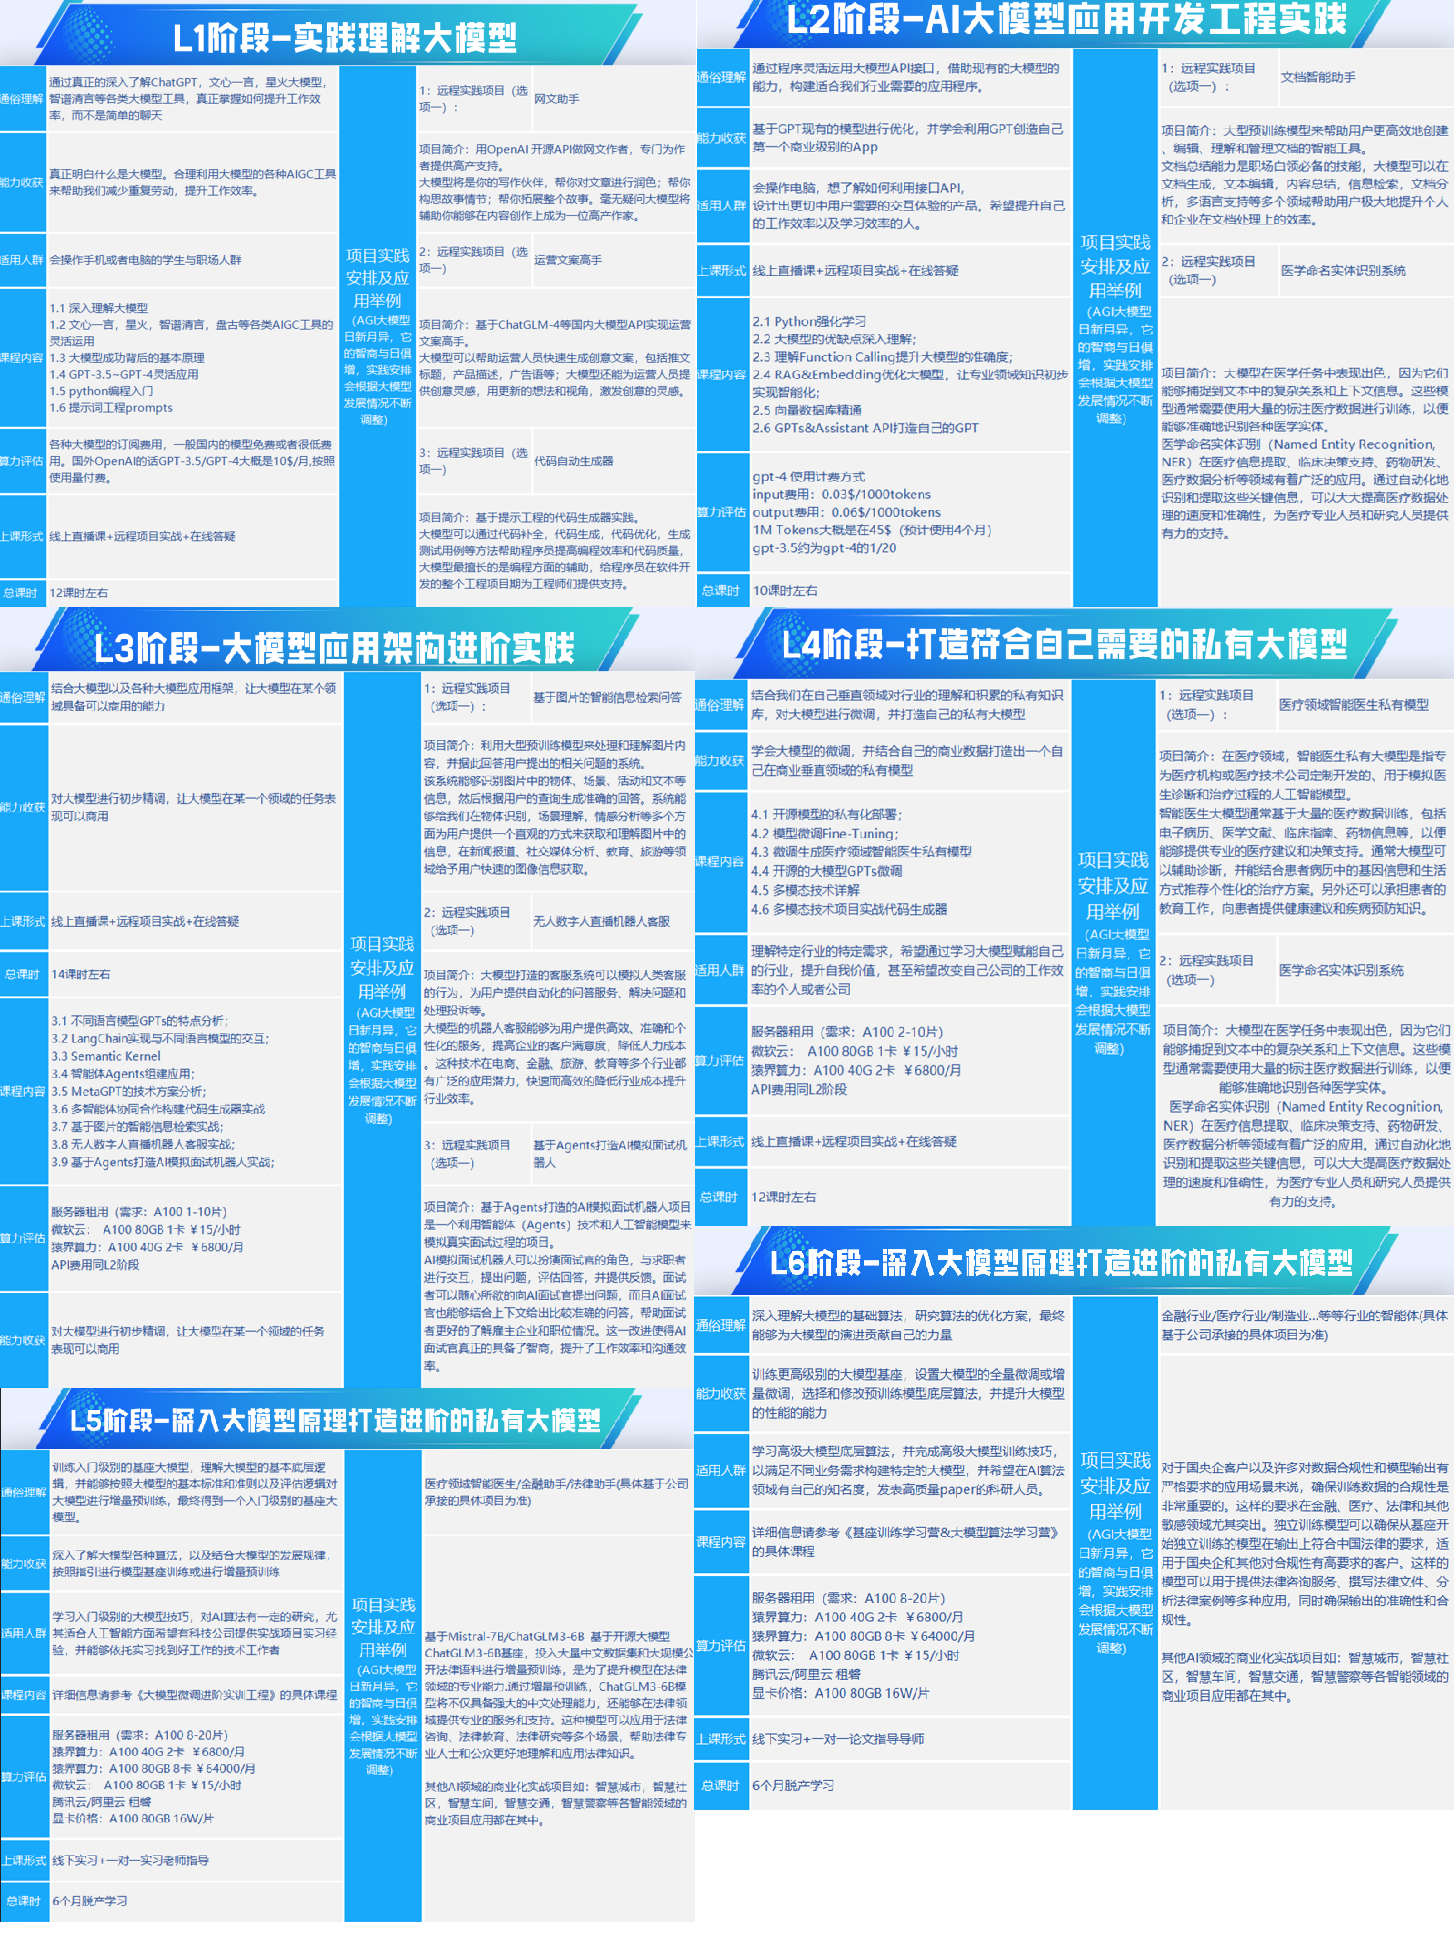
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
四、AI大模型商业化落地方案

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 0
 0
- 0


 已为社区贡献6条内容

所有评论(0)