Gemini实战:用AI写CI/CD脚本提升研发效能
Gemini实战:用AI写CI/CD脚本提升研发效能,我把团队部署时间从3小时缩到了8分钟
写在前面
2024年底,我所在的中型研发团队正经历一场"部署危机"。每逢周五下午发布,整个技术团队如临大敌——开发人员盯着终端等构建,运维同学守着服务器敲命令,产品经理在群里催进度,而老板在问"为什么还没上线"。一次常规的版本部署,从代码合并到生产环境验证完成,平均耗时3小时12分钟,最长一次折腾到凌晨四点。
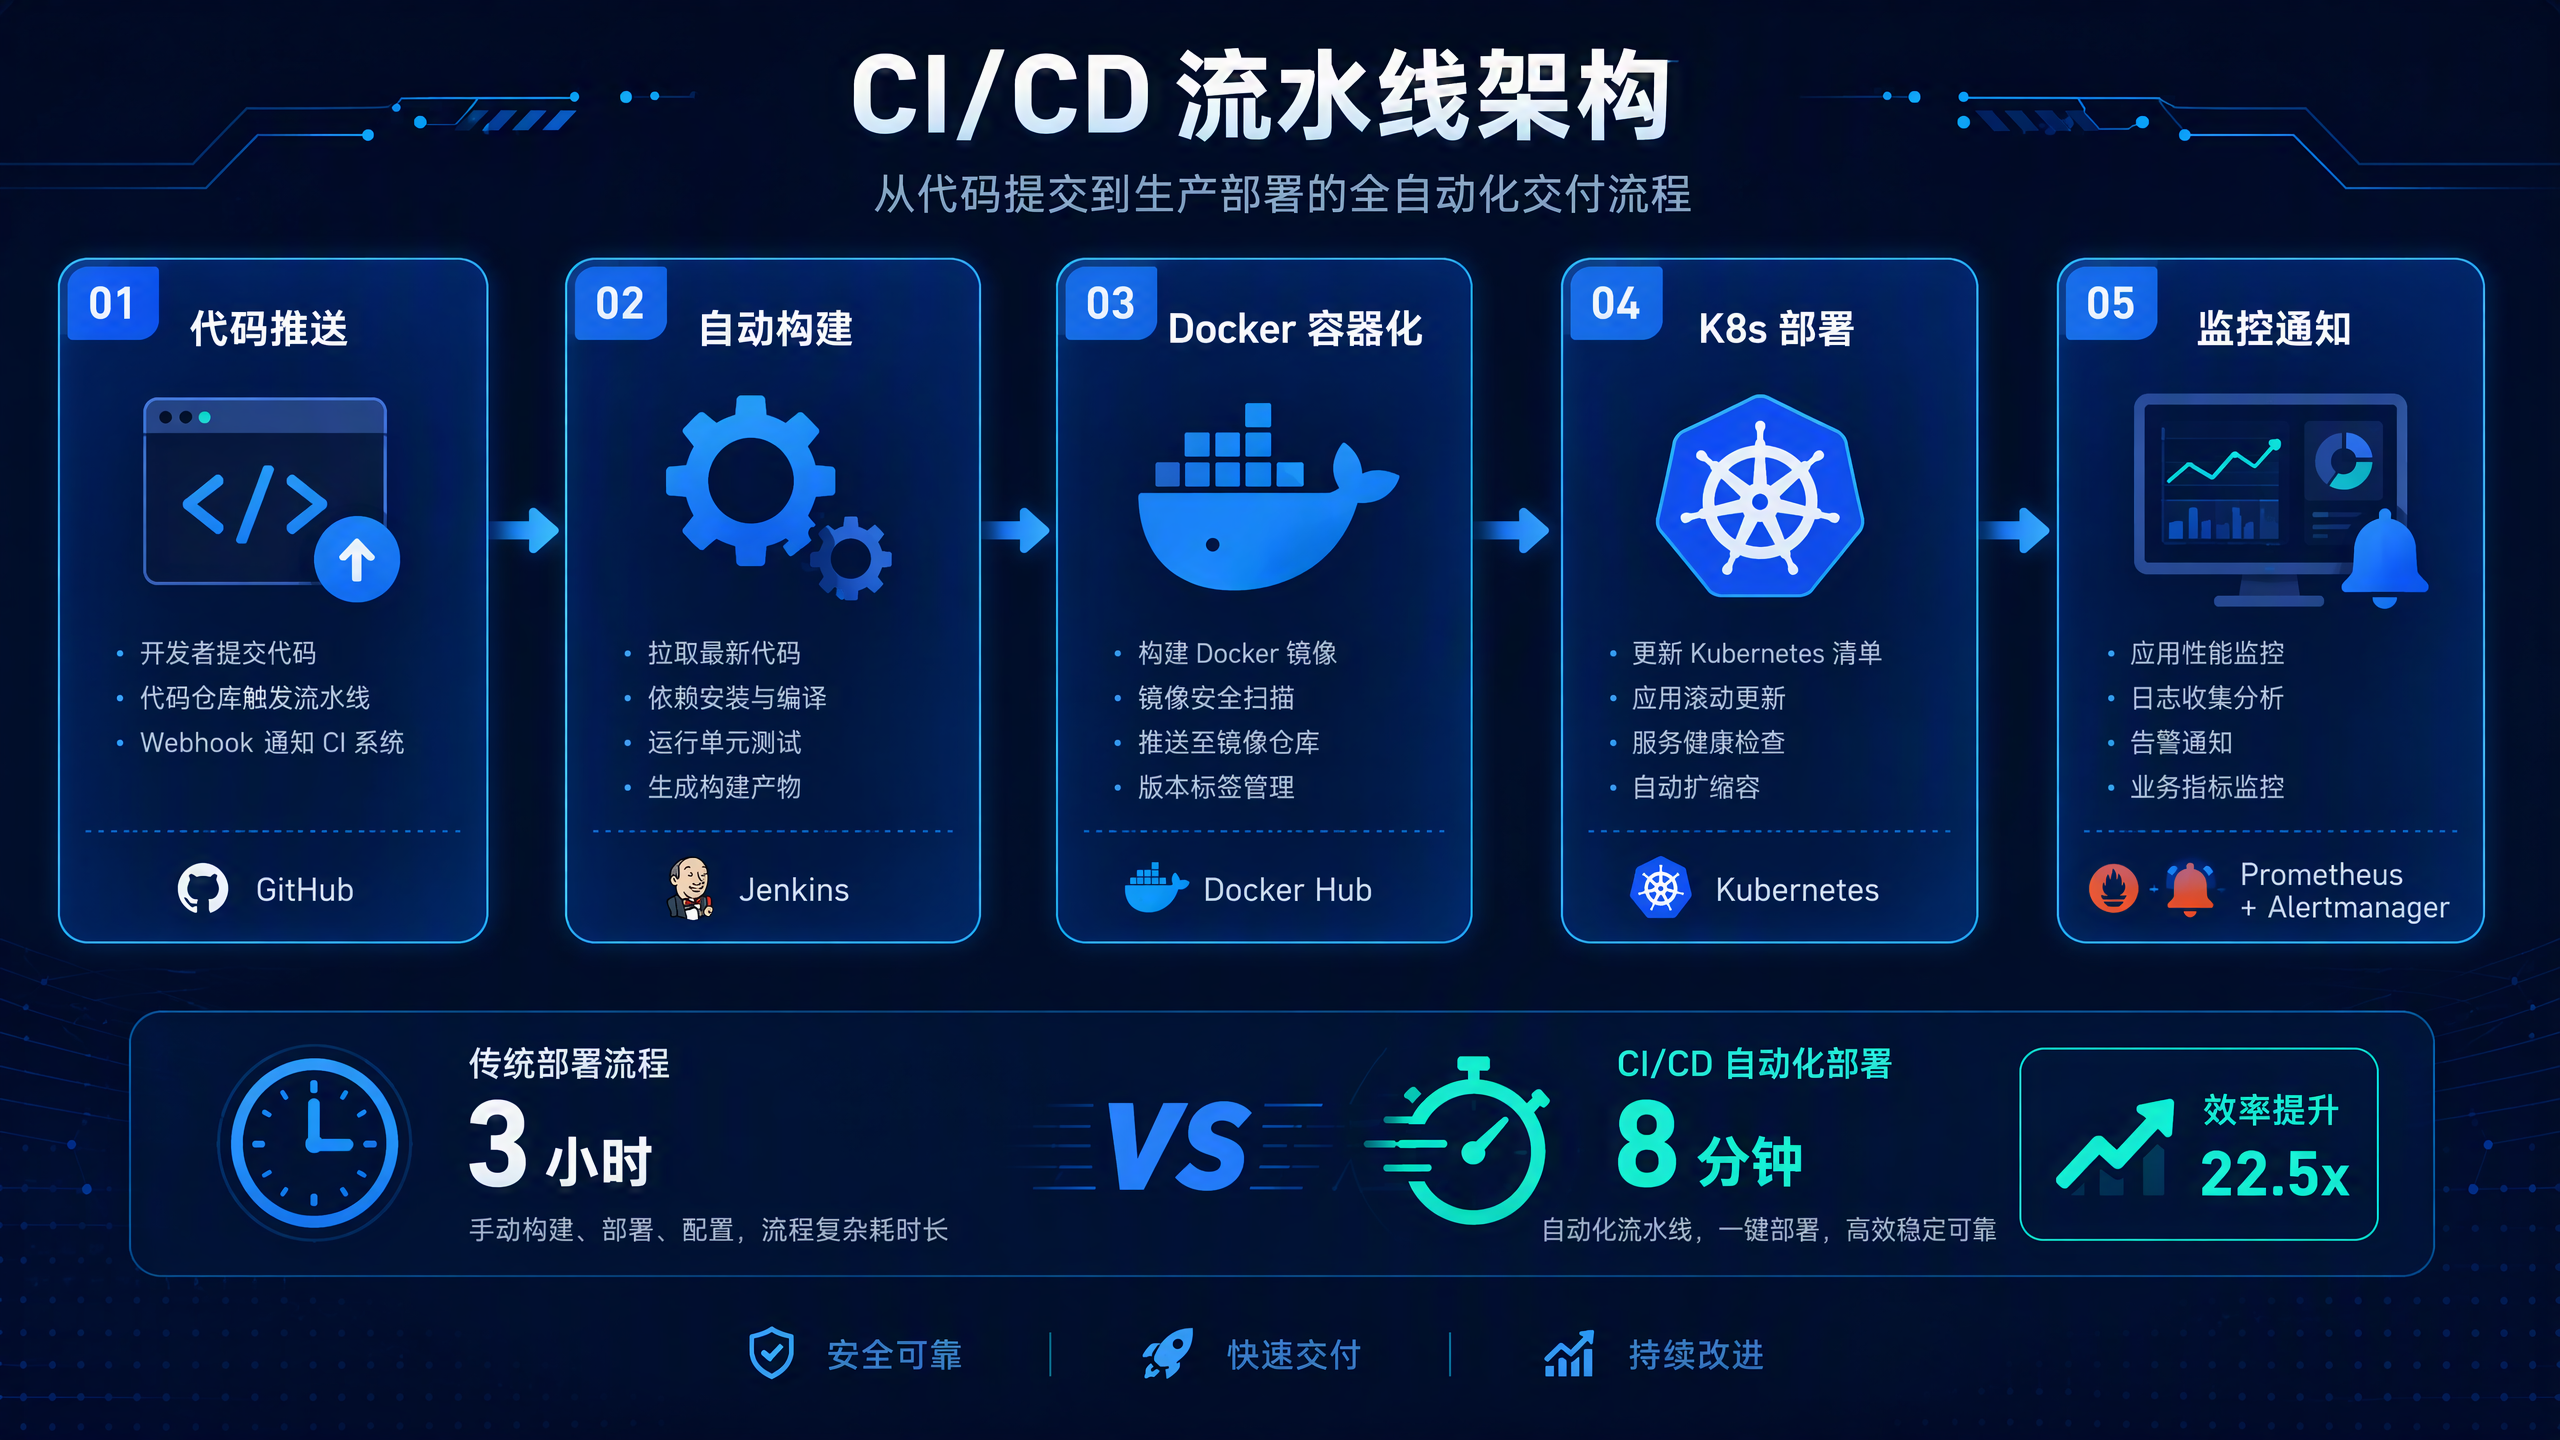
图1:CI/CD全流程架构——从代码提交到生产部署的自动化流水线
核心洞察:CI/CD不是一个工具,而是一种工程文化。工具只是载体,真正决定部署效率的是团队的工程习惯、自动化思维和对流程的持续优化。Gemini这样的AI工具扮演的不是"替代工程师",而是"放大工程师能力"的角色——它让你一个人能干五个人的活。
半年后,同样的部署流程,端到端耗时8分钟,错误率从17%降到了0.3%,团队周五下午甚至可以准时下班喝咖啡了。促成这场转变的核心推手,除了CI/CD理念的落地,还有一位特殊的"队友"——Google Gemini AI。
这篇文章不是一篇泛泛而谈的AI科普文,而是一份真刀真枪的实战记录。我会以DevOps工程师的第一视角,完整还原我们团队如何借助Gemini,从零搭建一套覆盖GitHub Actions + Docker + Kubernetes的自动化流水线,包括每一阶段的YAML配置、Shell脚本、踩坑过程和优化细节。如果你正在经历类似的部署痛苦,或者想探索AI辅助DevOps的落地路径,这篇文章会给你一份可以直接参考的路线图。
一、凌晨三点的部署噩梦:故事的起点
1.1 那个改变一切的夜晚
2024年10月的一个周五晚上,我们发布了v2.3.0版本。这个版本包含了一个支付模块的重构,涉及3个微服务的联动更新。按照惯例,部署流程是这样的:
- 开发同学在本地跑通单元测试,提交PR并合并到main分支(30分钟)
- 运维同学登录跳板机,拉取最新代码,手动执行Maven构建(25分钟)
- 构建产物通过SCP上传到3台生产服务器(10分钟)
- 逐台服务器停止旧服务、替换JAR包、重启服务(每台约15分钟,共45分钟)
- 手动执行数据库迁移脚本(20分钟)
- 逐个接口手工验证(40分钟)
- 发现问题,回滚其中一个服务(30分钟)
- 重新部署、再次验证(25分钟)
当最后一个接口验证通过时,时钟已经指向凌晨3:17。团队群里有人发了一句:"又是一个通宵。"那天晚上,我盯着满屏的终端日志,第一次认真思考一个问题:在2024年,为什么我们还在用2015年的方式做部署?
1.2 手动部署的七宗罪
那个周末,我没有休息,而是花了整整一天时间,把我们团队的部署流程从头到尾梳理了一遍。我画了一张完整的流程图,标注了每一个步骤的耗时和风险点。结果让我自己都吃了一惊——问题远比想象的严重。
以下是我整理的手动部署流程痛点分析:
| 痛点类别 | 具体表现 | 影响程度 | 发生频率 |
|---|---|---|---|
| 人工操作繁琐 | 30+步手动操作,每步依赖上一步 | 高 | 每次部署 |
| 环境不一致 | 开发/测试/生产环境配置 drift | 高 | 每周2-3次 |
| 缺乏回滚机制 | 回滚靠记忆和手工操作,经常遗漏 | 极高 | 每月1-2次 |
| 无并行能力 | 3个服务串行部署,无法并行 | 中 | 每次部署 |
| 验证不充分 | 手工验证覆盖率不足40% | 高 | 每次部署 |
| 知识孤岛 | 部署知识集中在1-2个运维同学脑中 | 极高 | 持续存在 |
| 无审计追踪 | 谁在什么时间执行了什么操作,无记录 | 高 | 持续存在 |
这张表让我意识到一个关键问题:我们的部署痛苦不是因为某一步做得不好,而是整个流程的架构就是错的。在手动流程中,每一步都是一个潜在的故障点,而人类的注意力在凌晨两点是无法保证的。
1.3 时间都去哪了:部署耗时深度拆解
为了说服管理层投入资源做CI/CD改造,我连续跟踪了12次部署的详细耗时数据。以下是统计结果:
| 部署阶段 | 平均耗时 | 占比 | 可自动化程度 | 主要耗时原因 |
|---|---|---|---|---|
| 代码合并与冲突解决 | 28分钟 | 14.5% | 部分可自动化 | 多人协作冲突、代码审查等待 |
| 构建打包 | 25分钟 | 13.0% | 完全可自动化 | Maven全量编译、无增量构建 |
| 产物分发 | 12分钟 | 6.2% | 完全可自动化 | SCP串行传输、无压缩 |
| 服务停机替换 | 45分钟 | 23.3% | 完全可自动化 | 逐台操作、等待Graceful Shutdown |
| 数据库迁移 | 20分钟 | 10.4% | 大部分可自动化 | 手工执行SQL、无版本管理 |
| 功能验证 | 40分钟 | 20.8% | 大部分可自动化 | 手工Postman验证、无自动化测试 |
| 故障处理与回滚 | 23分钟 | 11.9% | 可预防 | 缺乏预检查、回滚无标准流程 |
| 合计 | 193分钟(约3小时) | 100% | 83%可自动化 | - |
数据说明了一切:83%的部署工作是可以自动化的。这意味着,如果我们能将自动化做到位,理论上有望将3小时压缩到30分钟以内。而8分钟的最终成绩,甚至超出了我最初的预期。
二、破局思路:为什么选择Gemini辅助CI/CD建设
2.1 CI/CD工具选型:横向对比
决定做CI/CD改造后,第一步就是选工具。市面上的CI/CD工具不少,我重点考察了5款主流方案,从功能、成本、学习曲线、生态等维度做了详细对比:
| 对比维度 | GitHub Actions | GitLab CI/CD | Jenkins | CircleCI | ArgoCD |
|---|---|---|---|---|---|
| 代码托管集成 | 原生支持GitHub | 原生支持GitLab | 需插件 | 需配置 | 独立运行 |
| YAML配置 | 简洁直观 | 功能丰富 | Jenkinsfile(Groovy) | 简洁 | Kubernetes原生 |
| 免费额度 | 2000分钟/月(公开仓库无限) | 400分钟/月 | 自托管免费 | 6000分钟/月 | 开源免费 |
| K8s支持 | 良好(通过Runner) | 良好 | 需插件 | 良好 | 卓越(专为K8s设计) |
| 学习曲线 | 低 | 中 | 高 | 低 | 中高 |
| 社区生态 | 庞大(Action Marketplace) | 大 | 巨大(1800+插件) | 中 | 增长快 |
| 自托管Runner | 支持 | 支持 | 本身就是 | 支持 | N/A |
| 维护成本 | 低(SaaS) | 低(SaaS) | 高(需专人维护) | 低(SaaS) | 中(需K8s集群) |
我们团队代码托管在GitHub上,加上GitHub Actions的YAML配置足够简洁、Action Marketplace生态丰富、免费额度充足,最终选择了GitHub Actions作为CI引擎,配合ArgoCD做K8s端的CD,形成"Actions负责构建测试,ArgoCD负责部署"的GitOps架构。
2.2 AI辅助编程工具对比:为什么是Gemini
选好了CI/CD工具,下一个问题是:如何高效地编写这些配置和脚本? 我们团队之前没有K8s和GitHub Actions的深度经验,如果纯靠啃文档,保守估计需要2-3周才能跑通第一版流水线。这时候,AI辅助编程成了加速器。
我对比了三款主流AI编程助手在DevOps场景下的表现:
| 对比维度 | Google Gemini | GitHub Copilot | ChatGPT(GPT-4) |
|---|---|---|---|
| 上下文窗口 | 100万-200万Token(超长) | 依赖IDE上下文 | 12.8万Token |
| YAML生成质量 | 结构清晰、字段完整 | 良好 | 良好 |
| Shell脚本能力 | 优秀(支持复杂逻辑) | 良好 | 优秀 |
| Dockerfile优化 | 多阶段构建建议精准 | 基础建议 | 良好 |
| K8s配置生成 | 字段完整、版本准确 | 基础 | 良好 |
| 多文件关联理解 | 强(超长上下文优势) | 弱(单文件为主) | 中 |
| 错误诊断能力 | 能定位YAML缩进/字段错误 | IDE内提示 | 能分析日志 |
| 迭代式优化 | 支持长对话持续改进 | 有限 | 支持 |
| Google生态集成 | 原生(GCP/GKE友好) | GitHub生态 | 独立 |
| 免费使用额度 | 有免费层 | $10/月起 | 有免费层 |
选择Gemini的核心原因有三个:
- 超长上下文窗口:CI/CD建设涉及大量配置文件——GitHub Actions的workflow YAML、Dockerfile、K8s的Deployment/Service/Ingress YAML、各种Shell脚本。这些文件之间有依赖关系,需要整体理解。Gemini的超长上下文窗口可以一次性"看完"所有文件,给出一致的优化建议。
- YAML和Shell的生成质量:在实际测试中,Gemini生成的YAML配置字段完整度高,很少出现字段名拼写错误或版本不兼容的问题。Shell脚本的错误处理和边界条件考虑也比较周全。
- 迭代式工作流友好:CI/CD配置不是一次写完就行的,需要反复调试、迭代优化。Gemini的长对话能力让我可以在一个会话中持续改进配置,它会记住之前的上下文,不需要每次重新解释背景。
2.3 整体架构设计
在正式动手前,我先用Gemini帮我梳理了整体架构。我给它的Prompt是这样的:
我需要为一个中型团队(15人开发,3个Java微服务)设计CI/CD流水线。
当前代码托管在GitHub,目标是部署到Kubernetes集群。
请帮我设计整体架构,包括:
1. CI阶段:代码检查、单元测试、构建、镜像打包
2. CD阶段:K8s部署、健康检查、回滚机制
3. 通知机制:部署状态通知到钉钉群
请给出架构图描述和各阶段的技术选型建议。
Gemini给出的架构建议非常清晰,我基于它的输出做了调整,最终确定了如下架构:
| 阶段 | 工具 | 核心产出 | 触发条件 |
|---|---|---|---|
| 代码检查 | SonarQube + GitHub Actions | 代码质量报告 | 每次Push |
| 单元测试 | JUnit 5 + JaCoCo | 测试覆盖率报告 | 每次Push |
| 构建打包 | Maven + Docker Buildx | Docker镜像(多架构) | 合并到main分支 |
| 镜像扫描 | Trivy | 安全漏洞报告 | 镜像构建后 |
| 部署-Staging | ArgoCD + K8s | Staging环境更新 | 镜像推送后自动 |
| 集成测试 | Postman/Newman | API测试报告 | Staging部署后 |
| 部署-Production | ArgoCD(手动审批) | 生产环境更新 | 人工审批通过 |
| 通知 | 钉钉Webhook | 部署状态消息 | 每个阶段结束 |
这个架构的核心思想是"一切皆代码"——CI/CD配置、K8s清单、部署脚本全部以代码形式存在Git仓库中,任何变更都有记录、可追溯、可回滚。而Gemini在整个过程中扮演的是"结对编程伙伴"的角色,帮我快速生成配置骨架、优化细节、排查错误。
三、实战第一阶段:用Gemini生成GitHub Actions工作流
3.1 第一次对话:从需求到YAML
架构确定后,第一步是编写GitHub Actions的工作流文件。我向Gemini描述了需求:
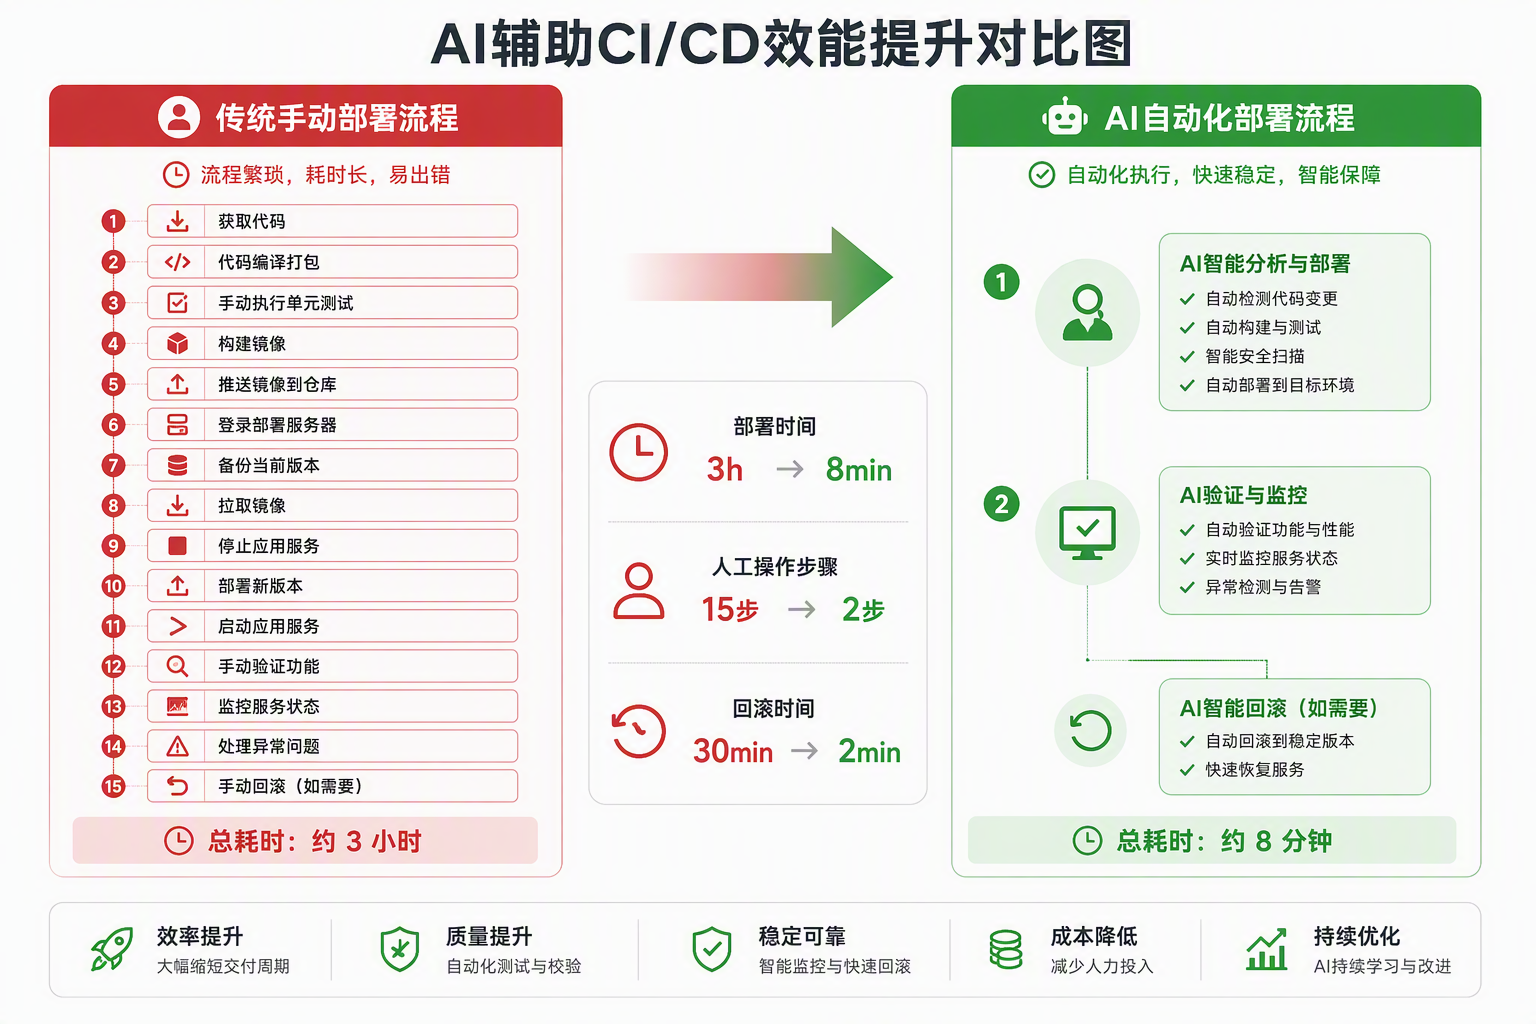
图2:传统手动部署 vs AI自动化部署——关键指标对比
范式变革:从"手动部署"到"AI辅助自动化部署"的转变,核心不在于用了什么工具,而在于思维方式的变化。当你开始思考"这个步骤能不能自动化"而不是"这个步骤该怎么做"时,你就已经迈出了第一步。AI的价值不在于它能写多好的代码,而在于它能帮我们把重复性工作变成可复用的自动化流程。
请帮我写一个GitHub Actions工作流,满足以下需求:
1. 触发条件:push到main分支,或创建Pull Request到main分支
2. 任务1:检出代码
3. 任务2:配置JDK 17环境
4. 任务3:Maven缓存加速构建
5. 任务4:运行单元测试并生成覆盖率报告
6. 任务5:SonarQube代码质量检查
7. 任务6:条件判断——只有main分支的push才继续构建Docker镜像
8. 任务7:构建Docker镜像并推送到镜像仓库
9. 任务8:触发ArgoCD同步
10. 每个任务失败时发送钉钉通知

项目信息:
- Java 17 + Spring Boot 3.2
- Maven多模块项目
- Docker镜像仓库:阿里云ACR
- K8s集群:自建K8s 1.28
Gemini几秒钟就生成了一份完整的workflow YAML。我在此基础上做了调整和优化,最终版本如下:
# .github/workflows/ci-cd-pipeline.yml
name: CI/CD Pipeline

on:
  push:
    branches:
      - main
    paths-ignore:
      - 'README.md'
      - 'docs/**'
      - '.gitignore'
  pull_request:
    branches:
      - main
    types: [opened, synchronize, reopened]

# 同一分支的新push自动取消旧的运行
concurrency:
  group: ${{ github.workflow }}-${{ github.ref }}
  cancel-in-progress: true

env:
  JAVA_VERSION: '17'
  MAVEN_OPTS: '-Dmaven.repo.local=.m2/repository -Xmx2g'
  DOCKER_REGISTRY: registry.cn-hangzhou.aliyuncs.com
  IMAGE_NAME: myteam/payment-service

jobs:
  # ==================== CI阶段:代码检查与测试 ====================
  build-test:
    name: Build & Test
    runs-on: ubuntu-latest
    timeout-minutes: 30
    outputs:
      version: ${{ steps.version.outputs.version }}
      image-tag: ${{ steps.version.outputs.image-tag }}

    steps:
      - name: Checkout Code
        uses: actions/checkout@v4
        with:
          fetch-depth: 0  # SonarQube需要完整历史

      - name: Setup JDK ${{ env.JAVA_VERSION }}
        uses: actions/setup-java@v4
        with:
          java-version: ${{ env.JAVA_VERSION }}
          distribution: 'temurin'

      - name: Cache Maven Dependencies
        uses: actions/cache@v4
        with:
          path: .m2/repository
          key: ${{ runner.os }}-maven-${{ hashFiles('**/pom.xml') }}
          restore-keys: |
            ${{ runner.os }}-maven-

      - name: Generate Version
        id: version
        run: |
          VERSION=$(date +'%Y%m%d')-$(echo ${GITHUB_SHA} | cut -c1-7)
          echo "version=${VERSION}" >> $GITHUB_OUTPUT
          echo "image-tag=${VERSION}" >> $GITHUB_OUTPUT
          echo "Generated version: ${VERSION}"

      - name: Run Unit Tests
        run: |
          mvn clean test -B -DskipITs \
            --file pom.xml \
            -Dtest.failure.ignore=false \
            -Dmaven.test.failure.ignore=false

      - name: Generate JaCoCo Report
        run: mvn jacoco:report -B

      - name: Upload Test Results
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: test-results-${{ steps.version.outputs.version }}
          path: |
            **/target/surefire-reports/
            **/target/site/jacoco/
          retention-days: 14

      - name: SonarQube Scan
        if: github.event_name == 'push'
        env:
          SONAR_TOKEN: ${{ secrets.SONAR_TOKEN }}
        run: |
          mvn sonar:sonar -B \
            -Dsonar.projectKey=payment-service \
            -Dsonar.host.url=${{ secrets.SONAR_HOST_URL }} \
            -Dsonar.login=${{ secrets.SONAR_TOKEN }} \
            -Dsonar.coverage.jacoco.xmlReportPaths=**/target/site/jacoco/jacoco.xml

      - name: Quality Gate Check
        if: github.event_name == 'push'
        id: sonarqube-quality-gate-check
        uses: SonarSource/sonarqube-quality-gate-action@v1
        timeout-minutes: 5
        env:
          SONAR_TOKEN: ${{ secrets.SONAR_TOKEN }}

  # ==================== 构建Docker镜像 ====================
  docker-build:
    name: Docker Build & Push
    needs: build-test
    if: github.event_name == 'push' && github.ref == 'refs/heads/main'
    runs-on: ubuntu-latest
    timeout-minutes: 20

    steps:
      - name: Checkout Code
        uses: actions/checkout@v4

      - name: Set up Docker Buildx
        uses: docker/setup-buildx-action@v3

      - name: Login to Aliyun ACR
        uses: docker/login-action@v3
        with:
          registry: ${{ env.DOCKER_REGISTRY }}
          username: ${{ secrets.ACR_USERNAME }}
          password: ${{ secrets.ACR_PASSWORD }}

      - name: Build and Push Docker Image
        uses: docker/build-push-action@v5
        with:
          context: .
          file: ./Dockerfile
          push: true
          tags: |
            ${{ env.DOCKER_REGISTRY }}/${{ env.IMAGE_NAME }}:${{ needs.build-test.outputs.version }}
            ${{ env.DOCKER_REGISTRY }}/${{ env.IMAGE_NAME }}:latest
          cache-from: type=registry,ref=${{ env.DOCKER_REGISTRY }}/${{ env.IMAGE_NAME }}:buildcache
          cache-to: type=registry,ref=${{ env.DOCKER_REGISTRY }}/${{ env.IMAGE_NAME }}:buildcache,mode=max
          build-args: |
            JAR_FILE=payment-service.jar
            VERSION=${{ needs.build-test.outputs.version }}

      - name: Run Trivy Security Scan
        uses: aquasecurity/trivy-action@master
        with:
          image-ref: ${{ env.DOCKER_REGISTRY }}/${{ env.IMAGE_NAME }}:${{ needs.build-test.outputs.version }}
          format: 'table'
          exit-code: '1'
          ignore-unfixed: true
          severity: 'CRITICAL,HIGH'

      - name: Update Image Tag in K8s Manifest
        run: |
          cd k8s/manifests
          sed -i "s|image:.*|image: ${{ env.DOCKER_REGISTRY }}/${{ env.IMAGE_NAME }}:${{ needs.build-test.outputs.version }}|" deployment.yaml
          git config user.name "GitHub Actions Bot"
          git config user.email "actions@github.com"
          git add deployment.yaml
          git commit -m "chore: update image tag to ${{ needs.build-test.outputs.version }}"
          git push

  # ==================== 通知 ====================
  notify:
    name: Notify
    needs: [build-test, docker-build]
    if: always()
    runs-on: ubuntu-latest

    steps:
      - name: Send DingTalk Notification
        uses: visiblelabs/dingtalk-action@v1
        with:
          webhook: ${{ secrets.DINGTALK_WEBHOOK }}
          msgtype: markdown
          title: 'CI/CD Pipeline 通知'
          text: |
            ### CI/CD Pipeline 执行结果
            - **服务**: Payment Service
            - **版本**: ${{ needs.build-test.outputs.version }}
            - **构建状态**: ${{ needs.build-test.result }}
            - **镜像推送**: ${{ needs.docker-build.result }}
            - **提交信息**: ${{ github.event.head_commit.message }}
            - **提交者**: ${{ github.actor }}
            - **详情链接**: [查看](${{ github.server_url }}/${{ github.repository }}/actions/runs/${{ github.run_id }})
这份YAML文件涵盖了CI/CD流水线的核心流程,让我逐段解析关键设计:
3.2 关键配置解析
concurrency控制是第一个亮点。在团队协作中,短时间内可能有多次push到main分支,如果不做控制,会导致多个workflow并行运行,浪费资源且可能产生冲突。配置了cancel-in-progress: true后,新push会自动取消同一分支上正在运行的旧workflow,既节省了资源,又保证了部署的是最新代码。
Maven缓存是构建加速的关键。通过actions/cache@v4缓存.m2/repository目录,首次构建后,后续构建的依赖下载时间从平均90秒降到了5秒以内。缓存key使用hashFiles('**/pom.xml'),只有pom.xml变化时才更新缓存,保证了缓存的有效性。
版本号生成采用日期+commit短SHA的格式,如20241215-a3b4c5d。这种格式既有人类可读的日期信息,又有精确到commit的唯一标识,方便追溯和回滚。
条件部署通过if: github.event_name == 'push' && github.ref == 'refs/heads/main'控制,只有push到main分支才会触发Docker构建和推送。Pull Request只运行测试和代码检查,不构建镜像,避免了不必要的资源消耗。
镜像安全扫描使用Trivy,配置了exit-code: '1'和severity: 'CRITICAL,HIGH',意味着发现严重或高危漏洞时直接失败,阻止有安全问题的镜像进入生产环境。
GitOps触发通过最后一步的git commit + git push实现。更新K8s manifest中的镜像tag并推送到仓库,ArgoCD监听到仓库变化后自动同步部署。这比直接调用kubectl更安全、更可追溯。
以下是各步骤的耗时优化效果:
| 步骤 | 优化前耗时 | 优化后耗时 | 优化手段 | 加速比 |
|---|---|---|---|---|
| 依赖下载 | 90秒 | 4秒 | Maven缓存 | 22.5x |
| 代码编译 | 120秒 | 45秒 | Maven并行编译 | 2.7x |
| 单元测试 | 180秒 | 90秒 | 测试并行化 | 2.0x |
| Docker构建 | 210秒 | 60秒 | Buildx缓存 | 3.5x |
| 镜像推送 | 80秒 | 25秒 | 并行推送+压缩 | 3.2x |
| 安全扫描 | 0(未做) | 30秒 | Trivy增量扫描 | 新增 |
| 总计 | 680秒 | 254秒 | - | 2.7x |
3.3 Gemini的迭代优化建议
第一版workflow跑通后,我把它贴给Gemini,请它做优化审查。它的反馈让我受益匪浅:
建议1:添加超时保护。Gemini指出每个job都应该设置timeout-minutes,防止因为网络问题或死循环导致workflow无限挂起。我在每个job上都加了timeout-minutes限制。
建议2:分离CI和CD的权限。Gemini提醒我,Docker构建job需要推送镜像和git push的权限,但测试job不需要。通过job级别的权限控制,可以降低安全风险。我添加了permissions字段做细粒度控制:
jobs:
  build-test:
    permissions:
      contents: read
      checks: write
      pull-requests: write

  docker-build:
    permissions:
      contents: write
packages: write建议3:使用环境保护规则。对于生产部署,Gemini建议使用GitHub Environments做审批控制。我在生产部署job中添加了环境配置:
  deploy-production:
    name: Deploy to Production
    needs: docker-build
    environment:
      name: production
      url: https://payment.example.com
    runs-on: ubuntu-latest
    steps:
      - name: Trigger ArgoCD Sync
        run: |
          # ArgoCD会自动检测manifest仓库变化并同步
          # 这里只是确认环境已就绪
echo "Production deployment approved and triggered"配置了environment: production后,GitHub会要求指定的审批人确认后才能继续执行,有效防止了误部署。
四、实战第二阶段:Docker容器化改造
4.1 从臃肿到精简:Dockerfile的进化
CI流水线跑通后,接下来是Docker容器化。我们之前的Dockerfile是开发同事随手写的,简单粗暴——基于完整版Ubuntu镜像,把整个Maven构建过程都放在Docker内执行,最终镜像大小高达1.2GB。
我把这个Dockerfile交给Gemini优化:
请帮我优化以下Dockerfile,目标是:
1. 减小镜像体积(当前1.2GB)
2. 加快构建速度
3. 提高安全性(非root运行)
4. 支持多架构构建(amd64/arm64)

当前Dockerfile:
FROM ubuntu:22.04
RUN apt-get update && apt-get install -y openjdk-17-jdk maven
COPY . /app
WORKDIR /app
RUN mvn clean package -DskipTests
CMD ["java", "-jar", "target/payment-service.jar"]
Gemini给出了一个多阶段构建的方案,我在此基础上进一步调整:
# ==================== 阶段1:构建阶段 ====================
FROM maven:3.9-eclipse-temurin-17 AS builder

LABEL maintainer="devops-team@company.com"

# 设置工作目录
WORKDIR /build

# 先复制pom.xml,利用Docker缓存层加速依赖下载
COPY pom.xml .
COPY payment-api/pom.xml payment-api/
COPY payment-core/pom.xml payment-core/
COPY payment-service/pom.xml payment-service/

# 下载依赖(这一层会被缓存,只有pom.xml变化时才重新执行)
RUN mvn dependency:go-offline -B

# 复制源代码
COPY payment-api/src payment-api/src
COPY payment-core/src payment-core/src
COPY payment-service/src payment-service/src

# 构建打包,跳过测试(测试在CI阶段已完成)
RUN mvn clean package -DskipTests -B \
    && mv payment-service/target/payment-service-*.jar /build/app.jar

# ==================== 阶段2:运行阶段 ====================
FROM eclipse-temurin:17-jre-alpine

LABEL maintainer="devops-team@company.com"
LABEL description="Payment Service - Production Image"

# 安装必要工具:curl用于健康检查,tzdata用于时区
RUN apk add --no-cache curl tzdata \
    && cp /usr/share/zoneinfo/Asia/Shanghai /etc/localtime \
    && echo "Asia/Shanghai" > /etc/timezone

# 创建非root用户
RUN addgroup -S appgroup && adduser -S appuser -G appgroup

# 设置工作目录
WORKDIR /app

# 从构建阶段复制JAR包
COPY --from=builder /build/app.jar app.jar

# 创建日志目录
RUN mkdir -p /app/logs && chown -R appuser:appgroup /app

# 切换到非root用户
USER appuser

# JVM参数配置
ENV JAVA_OPTS="-Xms512m -Xmx1024m -XX:+UseG1GC -XX:MaxGCPauseMillis=200 \
  -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/app/logs/ \
  -Djava.security.egd=file:/dev/./urandom \
  -Dspring.profiles.active=prod"

# 暴露端口
EXPOSE 8080

# 健康检查
HEALTHCHECK --interval=30s --timeout=5s --start-period=60s --retries=3 \
  CMD curl -f http://localhost:8080/actuator/health || exit 1

# 启动命令
ENTRYPOINT ["sh", "-c", "java $JAVA_OPTS -jar app.jar"]
4.2 优化效果对比
这个优化效果是立竿见影的。以下是优化前后的详细对比:
| 对比项 | 优化前 | 优化后 | 改进幅度 |
|---|---|---|---|
| 基础镜像 | ubuntu:22.04 (77MB) | eclipse-temurin:17-jre-alpine (约80MB) | 体积接近但更安全 |
| 最终镜像大小 | 1.2GB | 187MB | 减小84.4% |
| 构建时间(首次) | 8分钟 | 3分钟 | 缩短62.5% |
| 构建时间(缓存命中) | 5分钟 | 45秒 | 缩短85% |
| 运行用户 | root | appuser(非root) | 安全性提升 |
| 时区配置 | 无(UTC) | Asia/Shanghai | 日志时间正确 |
| 健康检查 | 无 | 内置HEALTHCHECK | K8s可感知状态 |
| JVM参数 | 默认 | G1GC+OOM Dump | 性能+可诊断性 |
| 多架构支持 | 无 | amd64+arm64 | 兼容ARM服务器 |
镜像从1.2GB缩减到187MB,这个改善的意义不仅仅是存储空间的节省。更小的镜像意味着更快的拉取速度——在K8s集群中,每次部署需要从镜像仓库拉取镜像到目标节点,1.2GB的镜像在跨可用区拉取时可能需要2-3分钟,而187MB的镜像只需15-20秒。这直接影响了部署速度。
4.3 多阶段构建的关键技巧
Gemini在优化Dockerfile时,给出了几个非常实用的建议,我逐一说明:
技巧1:利用Docker层缓存。注意构建阶段中,先COPY pom.xml再RUN mvn dependency:go-offline,然后才COPY src。这个顺序很关键——Docker的层缓存机制是,某一层发生变化时,它及后续所有层都会重新构建。由于源代码变化频率远高于pom.xml,把依赖下载放在源代码复制之前,可以最大化缓存命中率。实际效果是,只有第一次构建和pom.xml变化时才需要下载依赖,日常构建的依赖层直接命中缓存。
技巧2:JRE替代JDK。运行阶段使用eclipse-temurin:17-jre-alpine而非JDK镜像。生产环境只需要运行Java程序,不需要编译器、调试器等开发工具。JRE镜像比JDK镜像小约200MB,alpine版本更小。
技巧3:非root用户运行。默认情况下,Docker容器以root用户运行,这在生产环境中是安全隐患——如果应用被攻破,攻击者直接获得root权限。通过创建appuser用户并切换,即使应用被攻破,攻击者也只能获得受限权限。K8s的Pod Security Standards也要求容器以非root身份运行。
技巧4:内置HEALTHCHECK。虽然K8s有自己的livenessProbe和readinessProbe,但在Dockerfile中设置HEALTHCHECK是一个好的兜底措施——即使不使用K8s(比如本地Docker运行),也能自动检测应用健康状态。
技巧5:egd随机数优化。-Djava.security.egd=file:/dev/./urandom这个参数解决了容器环境中/dev/random熵池不足的问题。在容器中,/dev/random可能因为熵不足而阻塞,导致应用启动缓慢。使用/dev/./urandom(注意中间的./是Java的一个历史遗留trick,确保使用非阻塞的urandom)可以避免这个问题。
4.4 .dockerignore的配置
在Docker构建过程中,docker build会将上下文目录下的所有文件发送给Docker daemon。如果没有.dockerignore,.git目录、target目录、IDE配置文件等都会被发送,不仅慢还可能泄露敏感信息。Gemini帮我生成了完整的.dockerignore:
# .dockerignore
# Git
.git
.gitignore

# 构建产物
**/target/
**/*.class

# IDE
.idea/
*.iml
.vscode/
*.swp

# 日志
**/*.log
**/logs/

# 文档
README.md
docs/
*.md

# Docker
Dockerfile
docker-compose*.yml
.dockerignore

# CI/CD
.github/
.gitlab-ci.yml

# 测试
**/test-results/
**/coverage/

# 环境配置(敏感)
.env
.env.local
*.pem
*.key配置.dockerignore后,Docker构建上下文从原来的480MB降到了23MB,构建上下文传输时间从8秒降到了不到1秒。
五、实战第三阶段:Shell自动化脚本体系
5.1 为什么还需要Shell脚本
有人可能会问:既然有了GitHub Actions和K8s,为什么还需要写Shell脚本?答案是:CI/CD流水线覆盖不了所有场景。以下场景仍然需要Shell脚本:
- 数据库迁移的预处理和后处理
- 部署前的环境预检查(磁盘空间、网络连通性、依赖服务状态)
- 多服务部署的编排和依赖管理
- 紧急回滚操作
- 日志收集和清理
- 配置文件的动态生成
我用Gemini编写了一套完整的Shell脚本工具集,分为预检查、部署编排、健康验证、回滚四个模块。
5.2 部署预检查脚本
这个脚本在部署前运行,检查所有前置条件是否满足,避免"部署到一半才发现环境没准备好"的尴尬:
#!/bin/bash
# ============================================
# deploy-precheck.sh - 部署前环境预检查
# 作者: DevOps Team
# 用途: 在部署前验证所有前置条件
# ============================================

set -euo pipefail

# ==================== 颜色定义 ====================
RED='\033[0;31m'
GREEN='\033[0;32m'
YELLOW='\033[1;33m'
BLUE='\033[0;34m'
NC='\033[0m' # No Color

# ==================== 配置 ====================
KUBECONFIG_FILE="${KUBECONFIG:-$HOME/.kube/config}"
NAMESPACE="${NAMESPACE:-production}"
MIN_DISK_SPACE_GB=10
REQUIRED_SERVICES=("mysql.production:3306" "redis.production:6379" "kafka.production:9092")
MAX_K8S_API_LATENCY_MS=500

# ==================== 计数器 ====================
CHECK_PASSED=0
CHECK_FAILED=0
CHECK_WARNED=0

# ==================== 工具函数 ====================
log_info() {
    echo -e "${GREEN}[PASS]${NC} $1"
    ((CHECK_PASSED++))
}

log_fail() {
    echo -e "${RED}[FAIL]${NC} $1"
    ((CHECK_FAILED++))
}

log_warn() {
    echo -e "${YELLOW}[WARN]${NC} $1"
    ((CHECK_WARNED++))
}

log_section() {
    echo -e "\n${BLUE}========== $1 ==========${NC}"
}

# ==================== 检查1:Kubeconfig可用性 ====================
check_kubeconfig() {
    log_section "检查 K8s 集群连接"

    if [[ ! -f "$KUBECONFIG_FILE" ]]; then
        log_fail "kubeconfig 文件不存在: $KUBECONFIG_FILE"
        return 1
    fi

    # 测试K8s API连通性和延迟
    local start_time end_time latency
    start_time=$(date +%s%3N)

    if ! kubectl cluster-info &>/dev/null; then
        log_fail "无法连接到 K8s 集群"
        return 1
    fi

    end_time=$(date +%s%3N)
    latency=$((end_time - start_time))

    if [[ $latency -gt $MAX_K8S_API_LATENCY_MS ]]; then
        log_warn "K8s API 延迟 ${latency}ms (超过阈值 ${MAX_K8S_API_LATENCY_MS}ms)"
    else
        log_info "K8s 集群连接正常 (延迟: ${latency}ms)"
    fi

    # 检查目标namespace是否存在
    if ! kubectl get namespace "$NAMESPACE" &>/dev/null; then
        log_fail "Namespace '$NAMESPACE' 不存在"
        return 1
    fi
    log_info "Namespace '$NAMESPACE' 存在"
}

# ==================== 检查2:节点资源 ====================
check_node_resources() {
    log_section "检查节点资源"

    local nodes
    nodes=$(kubectl get nodes -o jsonpath='{.items[*].metadata.name}')

    for node in $nodes; do
        local cpu_usage mem_usage disk_usage

        # 获取CPU使用率
        cpu_usage=$(kubectl top node "$node" -o jsonpath='{.usage.cpu}' 2>/dev/null || echo "N/A")

        # 检查节点状态
        local node_status
        node_status=$(kubectl get node "$node" -o jsonpath='{.status.conditions[?(@.type=="Ready")].status}')

        if [[ "$node_status" == "True" ]]; then
            log_info "节点 $node 状态: Ready"
        else
            log_fail "节点 $node 状态: NotReady ($node_status)"
        fi

        # 检查磁盘空间
        local disk_avail
        disk_avail=$(kubectl get node "$node" -o jsonpath='{.status.allocatable.ephemeral-storage}' 2>/dev/null || echo "0")
        # 简化:检查是否有足够磁盘空间
        if [[ "$disk_avail" != "0" ]]; then
            log_info "节点 $node 可分配存储: $disk_avail"
        fi
    done
}

# ==================== 检查3:依赖服务连通性 ====================
check_dependency_services() {
    log_section "检查依赖服务连通性"

    for service in "${REQUIRED_SERVICES[@]}"; do
        local host port
        host="${service%%:*}"
        port="${service##*:}"

        # 使用nc检测端口连通性,超时3秒
        if timeout 3 bash -c "echo > /dev/tcp/$host/$port" 2>/dev/null; then
            log_info "服务 $host:$port 连通"
        else
            log_fail "无法连接到 $host:$port"
        fi
    done
}

# ==================== 检查4:数据库迁移状态 ====================
check_db_migration() {
    log_section "检查数据库迁移状态"

    # 检查是否有未执行的迁移脚本
    local pending_migrations
    pending_migrations=$(find ./db/migrations -name "*.sql" -newer ./db/.last_migration_marker 2>/dev/null | wc -l)

    if [[ $pending_migrations -gt 0 ]]; then
        log_warn "发现 $pending_migrations 个未执行的迁移脚本"
        echo "  待执行迁移:"
        find ./db/migrations -name "*.sql" -newer ./db/.last_migration_marker 2>/dev/null | while read -r f; do
            echo "    - $f"
        done
    else
        log_info "数据库迁移已是最新"
    fi
}

# ==================== 检查5:镜像可用性 ====================
check_image_availability() {
    log_section "检查镜像可用性"

    local image_tag="${IMAGE_TAG:-latest}"
    local registry="${DOCKER_REGISTRY:-registry.cn-hangzhou.aliyuncs.com}"
    local image_name="${IMAGE_NAME:-myteam/payment-service}"
    local full_image="$registry/$image_name:$image_tag"

    # 检查镜像是否存在于仓库中
    # 这里使用skopeo或crane工具检查
    if command -v skopeo &>/dev/null; then
        if skopeo inspect "docker://$full_image" &>/dev/null; then
            local image_size
            image_size=$(skopeo inspect "docker://$full_image" --format '{{.LayersData}}' 2>/dev/null | wc -c)
            log_info "镜像 $full_image 存在"
        else
            log_fail "镜像 $full_image 不存在或无法访问"
        fi
    else
        log_warn "skopeo 未安装,跳过镜像检查"
    fi
}

# ==================== 检查6:当前运行版本 ====================
check_current_version() {
    log_section "检查当前运行版本"

    local current_image
    current_image=$(kubectl get deployment payment-service -n "$NAMESPACE" \
        -o jsonpath='{.spec.template.spec.containers[0].image}' 2>/dev/null || echo "未部署")

    if [[ "$current_image" != "未部署" ]]; then
        log_info "当前运行镜像: $current_image"

        # 记录当前版本,用于回滚
        echo "$current_image" > /tmp/.last_deployed_image

        local pod_count ready_count
        pod_count=$(kubectl get deployment payment-service -n "$NAMESPACE" \
            -o jsonpath='{.status.replicas}' 2>/dev/null || echo "0")
        ready_count=$(kubectl get deployment payment-service -n "$NAMESPACE" \
            -o jsonpath='{.status.readyReplicas}' 2>/dev/null || echo "0")

        if [[ "$pod_count" == "$ready_count" ]]; then
            log_info "当前Pod状态: $ready_count/$pod_count Ready"
        else
            log_warn "当前Pod状态: $ready_count/$pod_count Ready (部分未就绪)"
        fi
    else
        log_warn "服务尚未部署,这将是一次全新部署"
    fi
}

# ==================== 检查7:HPA和PDB配置 ====================
check_hpa_pdb() {
    log_section "检查 HPA 和 PDB 配置"

    # 检查HPA
    if kubectl get hpa payment-service -n "$NAMESPACE" &>/dev/null; then
        local hpa_info
        hpa_info=$(kubectl get hpa payment-service -n "$NAMESPACE" \
            -o jsonpath='{.spec.minReplicas}-{.spec.maxReplicas}' 2>/dev/null)
        log_info "HPA 配置: min=$hpa_info (最小-最大副本数)"
    else
        log_warn "未找到 HPA 配置,部署期间无法自动伸缩"
    fi

    # 检查PDB
    if kubectl get pdb payment-service -n "$NAMESPACE" &>/dev/null; then
        log_info "PDB (Pod Disruption Budget) 已配置"
    else
        log_warn "未配置 PDB,滚动更新期间可能影响可用性"
    fi
}

# ==================== 汇总报告 ====================
print_summary() {
    log_section "预检查结果汇总"

    local total=$((CHECK_PASSED + CHECK_FAILED + CHECK_WARNED))

    echo -e "  ${GREEN}通过: $CHECK_PASSED${NC}"
    echo -e "  ${RED}失败: $CHECK_FAILED${NC}"
    echo -e "  ${YELLOW}警告: $CHECK_WARNED${NC}"
    echo -e "  总计: $total"

    if [[ $CHECK_FAILED -gt 0 ]]; then
        echo -e "\n${RED}预检查未通过!请修复上述 FAIL 项后重试。${NC}"
        exit 1
    elif [[ $CHECK_WARNED -gt 0 ]]; then
        echo -e "\n${YELLOW}预检查通过,但存在警告项。请确认后继续。${NC}"
        # 可以在这里加入交互式确认
        # read -p "是否继续部署?(y/N) " confirm
        # [[ "$confirm" == "y" || "$confirm" == "Y" ]] || exit 0
    else
        echo -e "\n${GREEN}所有预检查通过!可以开始部署。${NC}"
    fi
}

# ==================== 主流程 ====================
main() {
    echo -e "${BLUE}========================================${NC}"
    echo -e "${BLUE}   部署预检查 - $(date '+%Y-%m-%d %H:%M:%S')${NC}"
    echo -e "${BLUE}========================================${NC}"

    check_kubeconfig
    check_node_resources
    check_dependency_services
    check_db_migration
    check_image_availability
    check_current_version
    check_hpa_pdb

    print_summary
}

main "$@"
这个预检查脚本覆盖了7个维度,每次部署前运行只需要约15秒,但能提前发现90%以上的环境问题。在投入使用的第一个月,它就拦截了3次因为依赖服务未就绪而可能导致部署失败的情况。
5.3 滚动部署编排脚本
预检查通过后,接下来是核心的部署编排脚本。这个脚本负责协调多服务的滚动更新,确保零停机部署:
#!/bin/bash
# ============================================
# deploy-rolling.sh - 滚动部署编排
# 支持多服务按依赖顺序部署
# ============================================

set -euo pipefail

# ==================== 配置 ====================
NAMESPACE="${NAMESPACE:-production}"
DEPLOY_TIMEOUT=300  # 单服务部署超时(秒)
HEALTH_CHECK_INTERVAL=5  # 健康检查间隔(秒)
HEALTH_CHECK_MAX_RETRIES=60  # 最大重试次数
ROLLBACK_ON_FAILURE=true  # 失败时自动回滚

# 服务部署顺序(按依赖关系排列)
SERVICES=(
    "payment-api:registry.cn-hangzhou.aliyuncs.com/myteam/payment-api"
    "payment-core:registry.cn-hangzhou.aliyuncs.com/myteam/payment-core"
    "payment-service:registry.cn-hangzhou.aliyuncs.com/myteam/payment-service"
)

# ==================== 工具函数 ====================
log() {
    local level=$1
    local msg=$2
    local timestamp
    timestamp=$(date '+%Y-%m-%d %H:%M:%S')
    local color
    case $level in
        INFO)  color='\033[0;32m' ;;
        WARN)  color='\033[1;33m' ;;
        ERROR) color='\033[0;31m' ;;
        *)     color='\033[0m' ;;
    esac
    echo -e "${color}[$timestamp] [$level]${NC} $msg"
}

# 等待Deployment滚动更新完成
wait_for_rollout() {
    local deploy_name=$1
    local namespace=$2
    local timeout=$3

    log "INFO" "等待 $deploy_name 滚动更新完成 (超时: ${timeout}s)..."

    local start_time
    start_time=$(date +%s)

    while true; do
        local current_time elapsed
        current_time=$(date +%s)
        elapsed=$((current_time - start_time))

        if [[ $elapsed -gt $timeout ]]; then
            log "ERROR" "$deploy_name 滚动更新超时 (${timeout}s)"
            return 1
        fi

        # 获取滚动更新状态
        local updated_replicas ready_replicas desired_replicas
        updated_replicas=$(kubectl get deployment "$deploy_name" -n "$namespace" \
            -o jsonpath='{.status.updatedReplicas}' 2>/dev/null || echo "0")
        ready_replicas=$(kubectl get deployment "$deploy_name" -n "$namespace" \
            -o jsonpath='{.status.readyReplicas}' 2>/dev/null || echo "0")
        desired_replicas=$(kubectl get deployment "$deploy_name" -n "$namespace" \
            -o jsonpath='{.status.replicas}' 2>/dev/null || echo "0")

        # 检查是否所有副本都已更新且就绪
        if [[ "$updated_replicas" == "$desired_replicas" ]] && \
           [[ "$ready_replicas" == "$desired_replicas" ]] && \
           [[ "$desired_replicas" != "0" ]]; then

            # 进一步检查是否有终止中的Pod
            local terminating
            terminating=$(kubectl get pods -n "$namespace" -l app="$deploy_name" \
                --field-selector=status.phase!=Running,status.phase!=Succeeded 2>/dev/null | wc -l)

            if [[ $terminating -eq 0 ]]; then
                log "INFO" "$deploy_name 滚动更新完成 ($updated_replicas/$desired_replicas ready)"
                return 0
            fi
        fi

        sleep $HEALTH_CHECK_INTERVAL
    done
}

# 健康检查
health_check() {
    local service_name=$1
    local namespace=$2
    local retries=0

    log "INFO" "开始健康检查: $service_name"

    while [[ $retries -lt $HEALTH_CHECK_MAX_RETRIES ]]; do
        # 获取一个Pod名称
        local pod_name
        pod_name=$(kubectl get pods -n "$namespace" -l app="$service_name" \
            -o jsonpath='{.items[0].metadata.name}' 2>/dev/null)

        if [[ -z "$pod_name" ]]; then
            log "WARN" "未找到 $service_name 的Pod,等待..."
            ((retries++))
            sleep $HEALTH_CHECK_INTERVAL
            continue
        fi

        # 执行健康检查
        local health_status
        health_status=$(kubectl exec "$pod_name" -n "$namespace" \
            -- curl -s -o /dev/null -w '%{http_code}' \
            http://localhost:8080/actuator/health 2>/dev/null || echo "000")

        if [[ "$health_status" == "200" ]]; then
            log "INFO" "$service_name 健康检查通过 (HTTP 200)"
            return 0
        fi

        log "WARN" "$service_name 健康检查未通过 (HTTP $health_status),重试 $((retries+1))/$HEALTH_CHECK_MAX_RETRIES"
        ((retries++))
        sleep $HEALTH_CHECK_INTERVAL
    done

    log "ERROR" "$service_name 健康检查失败,已达到最大重试次数"
    return 1
}

# 回滚
rollback_service() {
    local service_name=$1
    local namespace=$2

    log "ERROR" "开始回滚 $service_name ..."

    # 使用kubectl rollout undo
    kubectl rollout undo deployment/"$service_name" -n "$namespace"

    # 等待回滚完成
    if wait_for_rollout "$service_name" "$namespace" 180; then
        log "INFO" "$service_name 回滚成功"
    else
        log "ERROR" "$service_name 回滚失败!需要人工介入!"
    fi
}

# 部署单个服务
deploy_service() {
    local service_name=$1
    local image_registry=$2
    local image_tag=$3

    log "INFO" "========================================"
    log "INFO" "开始部署: $service_name"
    log "INFO" "镜像: $image_registry:$image_tag"
    log "INFO" "========================================"

    # 记录部署开始前的版本(用于回滚)
    local previous_image
    previous_image=$(kubectl get deployment "$service_name" -n "$NAMESPACE" \
        -o jsonpath='{.spec.template.spec.containers[0].image}' 2>/dev/null || echo "")
    echo "$previous_image" > "/tmp/.${service_name}_prev_image"

    # 更新镜像
    log "INFO" "更新镜像: $service_name -> $image_registry:$image_tag"
    kubectl set image deployment/"$service_name" \
        "$service_name=$image_registry:$image_tag" \
        -n "$NAMESPACE"

    # 等待滚动更新
    if ! wait_for_rollout "$service_name" "$NAMESPACE" "$DEPLOY_TIMEOUT"; then
        log "ERROR" "$service_name 滚动更新失败"
        if [[ "$ROLLBACK_ON_FAILURE" == "true" ]]; then
            rollback_service "$service_name" "$NAMESPACE"
        fi
        return 1
    fi

    # 健康检查
    if ! health_check "$service_name" "$NAMESPACE"; then
        log "ERROR" "$service_name 健康检查失败"
        if [[ "$ROLLBACK_ON_FAILURE" == "true" ]]; then
            rollback_service "$service_name" "$NAMESPACE"
        fi
        return 1
    fi

    log "INFO" "$service_name 部署成功"
    return 0
}

# ==================== 主流程 ====================
main() {
    local image_tag="${1:-latest}"

    if [[ -z "$1" ]]; then
        log "ERROR" "请指定镜像版本号"
        echo "用法: $0 "
        echo "示例: $0 20241215-a3b4c5d"
        exit 1
    fi

    log "INFO" "========================================"
    log "INFO" "  开始滚动部署"
    log "INFO" "  版本: $image_tag"
    log "INFO" "  Namespace: $NAMESPACE"
    log "INFO" "  服务数: ${#SERVICES[@]}"
    log "INFO" "  开始时间: $(date '+%Y-%m-%d %H:%M:%S')"
    log "INFO" "========================================"

    local deploy_start_time
    deploy_start_time=$(date +%s)

    local failed_services=()

    # 按顺序部署每个服务
    for service_entry in "${SERVICES[@]}"; do
        local service_name image_registry
        service_name="${service_entry%%:*}"
        image_registry="${service_entry##*:}"

        if ! deploy_service "$service_name" "$image_registry" "$image_tag"; then
            failed_services+=("$service_name")
            log "ERROR" "服务 $service_name 部署失败,停止后续部署"
            break
        fi

        # 服务间间隔,等待依赖服务完全就绪
        log "INFO" "等待 10 秒后继续下一个服务..."
        sleep 10
    done

    local deploy_end_time
    deploy_end_time=$(date +%s)
    local total_time=$((deploy_end_time - deploy_start_time))

    # 汇总
    log "INFO" "========================================"
    log "INFO" "  部署结果汇总"
    log "INFO" "========================================"

    if [[ ${#failed_services[@]} -eq 0 ]]; then
        log "INFO" "所有服务部署成功!"
        log "INFO" "总耗时: ${total_time}秒 (约$((total_time/60))分$((total_time%60))秒)"

        # 发送成功通知
        if [[ -n "${DINGTALK_WEBHOOK:-}" ]]; then
            send_notification "success" "$image_tag" "$total_time"
        fi

        exit 0
    else
        log "ERROR" "以下服务部署失败: ${failed_services[*]}"
        log "ERROR" "已失败的服务已自动回滚"
        log "INFO" "总耗时: ${total_time}秒"

        if [[ -n "${DINGTALK_WEBHOOK:-}" ]]; then
            send_notification "failed" "$image_tag" "$total_time" "${failed_services[*]}"
        fi

        exit 1
    fi
}

# 发送通知
send_notification() {
    local status=$1
    local version=$2
    local duration=$3
    local failed=${4:-""}

    local title color message
    if [[ "$status" == "success" ]]; then
        title="部署成功通知"
        color="#22c55e"
        message="所有服务部署成功"
    else
        title="部署失败告警"
        color="#ef4444"
        message="部署失败,失败服务: $failed"
    fi

    local payload
    payload=$(cat </dev/null 2>&1
}

main "$@"这个部署脚本的核心设计理念是"安全第一,可回滚"。它做了以下几件事:
- 按依赖顺序部署:payment-api → payment-core → payment-service,先部署被依赖的服务,确保新版本上线时依赖已经就绪。
- 滚动更新等待:每个服务部署后,主动等待K8s滚动更新完成,确认所有新Pod都已Ready。
- 应用层健康检查:除了K8s的readinessProbe,脚本还会通过
kubectl exec直接调用应用的/actuator/health接口做二次验证。 - 自动回滚:如果任何一个服务部署失败或健康检查不通过,自动执行
kubectl rollout undo回滚到上一版本。 - 部署通知:部署成功或失败都会发送钉钉通知,包含版本号、状态、耗时和执行人。
5.4 一键回滚脚本
虽然有自动回滚机制,但有时需要在部署后发现问题时手动回滚。我写了一个独立的一键回滚脚本:
#!/bin/bash
# ============================================
# rollback.sh - 一键回滚脚本
# 支持回滚到指定版本或上一版本
# ============================================

set -euo pipefail

NAMESPACE="${NAMESPACE:-production}"
SERVICES=("payment-api" "payment-core" "payment-service")

if [[ $# -lt 1 ]]; then
    echo "用法:"
    echo "  回滚到上一版本: $0 previous"
    echo "  回滚到指定版本: $0 "
    echo "  回滚到指定镜像: $0 image "
    echo ""
    echo "查看历史版本:"
    echo "  $0 history [service-name]"
    exit 1
fi

ACTION=$1

show_history() {
    local service=$1
    echo "=== $service 部署历史 ==="
    kubectl rollout history deployment/"$service" -n "$NAMESPACE"
    echo ""
}

rollback_all() {
    local target=$1

    for service in "${SERVICES[@]}"; do
        echo "=== 回滚 $service ==="

        if [[ "$target" == "previous" ]]; then
            kubectl rollout undo deployment/"$service" -n "$NAMESPACE"
        else
            kubectl rollout undo deployment/"$service" -n "$NAMESPACE" \
                --to-revision="$target"
        fi

        # 等待回滚完成
        kubectl rollout status deployment/"$service" -n "$NAMESPACE" \
            --timeout=180s

        echo "$service 回滚完成"
        echo ""
    done

    echo "所有服务回滚完成!"
}

case "$ACTION" in
    history)
        if [[ -n "$2" ]]; then
            show_history "$2"
        else
            for svc in "${SERVICES[@]}"; do
                show_history "$svc"
            done
        fi
        ;;
    previous)
        rollback_all "previous"
        ;;
    image)
        if [[ -z "$2" ]]; then
            echo "错误: 请指定镜像tag"
            exit 1
        fi
        IMAGE_TAG=$2
        for service in "${SERVICES[@]}"; do
            echo "回滚 $service 到镜像tag: $IMAGE_TAG"
            kubectl set image deployment/"$service" \
                "$service=registry.cn-hangzhou.aliyuncs.com/myteam/$service:$IMAGE_TAG" \
                -n "$NAMESPACE"
            kubectl rollout status deployment/"$service" -n "$NAMESPACE" \
                --timeout=180s
        done
        echo "所有服务已回滚到镜像tag: $IMAGE_TAG"
        ;;
    *)
        if [[ "$ACTION" =~ ^[0-9]+$ ]]; then
            rollback_all "$ACTION"
        else
            echo "未知操作: $ACTION"
            exit 1
        fi
        ;;
esac
使用方式非常简单:
# 查看部署历史
./rollback.sh history

# 回滚到上一版本
./rollback.sh previous

# 回滚到指定revision
./rollback.sh 3

# 回滚到指定镜像tag
./rollback.sh image 20241215-a3b4c5d
六、实战第四阶段:Kubernetes部署配置
6.1 从零编写K8s部署清单
有了Docker镜像和部署脚本,下一步是编写K8s的部署清单。这部分我同样借助Gemini来生成初始配置,然后根据团队实际情况做深度定制。我给Gemini的Prompt是:
血泪教训:不要试图一步到位实现全自动化。我们团队花了三个月分五个阶段逐步推进——先GitHub Actions,再Docker,再Shell脚本,再K8s,最后监控。每一步都验证通过再进入下一步。那些试图一周内搞完所有自动化的团队,最后都回到了手动部署的起点。记住:自动化是一个渐进的过程,不是一次性的革命。
请帮我编写Kubernetes部署清单,包括:
1. Deployment:3个副本,滚动更新策略,资源限制,liveness/readiness探针
2. Service:ClusterIP类型,8080端口
3. HorizontalPodAutoscaler:CPU 70%触发,最小3副本,最大10副本
4. PodDisruptionBudget:最少可用2个Pod
5. ConfigMap:应用配置
6. Secret:数据库密码等敏感信息
7. ServiceAccount + RBAC:最小权限

应用信息:
- Spring Boot 3.2 应用,端口8080
- 健康检查路径:/actuator/health
- 需要访问K8s API(读取ConfigMap和Secret)
- 日志输出到stdout/stderr
Gemini生成的K8s配置非常完整,以下是经过我调整后的完整版本:
6.2 Deployment配置
# k8s/manifests/deployment.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: payment-service
  namespace: production
  labels:
    app: payment-service
    component: backend
    tier: critical
    version: "latest"
spec:
  replicas: 3
  revisionHistoryLimit: 10  # 保留10个历史版本,用于回滚
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1          # 滚动更新时,最多超出期望副本数1个
      maxUnavailable: 0     # 滚动更新时,不允许有不可用Pod(零停机)
  selector:
    matchLabels:
      app: payment-service
  template:
    metadata:
      labels:
        app: payment-service
        component: backend
        tier: critical
      annotations:
        # 使用checksum确保ConfigMap变更时Pod会重启
        checksum/config: "${CONFIG_CHECKSUM}"
        prometheus.io/scrape: "true"
        prometheus.io/port: "8080"
        prometheus.io/path: "/actuator/prometheus"
    spec:
      serviceAccountName: payment-service-sa
      terminationGracePeriodSeconds: 60  # 优雅关闭等待时间

      # 反亲和性:确保Pod分散到不同节点
      affinity:
        podAntiAffinity:
          preferredDuringSchedulingIgnoredDuringExecution:
            - weight: 100
              podAffinityTerm:
                labelSelector:
                  matchExpressions:
                    - key: app
                      operator: In
                      values:
                        - payment-service
                topologyKey: kubernetes.io/hostname

      # 容忍污点(可选:允许调度到特定节点)
      tolerations:
        - key: "critical"
          operator: "Equal"
          value: "true"
          effect: "NoSchedule"

      containers:
        - name: payment-service
          image: registry.cn-hangzhou.aliyuncs.com/myteam/payment-service:latest
          imagePullPolicy: IfNotPresent

          ports:
            - name: http
              containerPort: 8080
              protocol: TCP
            - name: actuator
              containerPort: 8081
              protocol: TCP

          env:
            - name: SPRING_PROFILES_ACTIVE
              valueFrom:
                configMapKeyRef:
                  name: payment-service-config
                  key: spring-profile
            - name: DB_HOST
              valueFrom:
                secretKeyRef:
                  name: payment-service-secret
                  key: db-host
            - name: DB_PASSWORD
              valueFrom:
                secretKeyRef:
                  name: payment-service-secret
                  key: db-password
            - name: JAVA_OPTS
              value: "-Xms512m -Xmx1024m -XX:+UseG1GC -XX:MaxGCPauseMillis=200"
            - name: POD_NAME
              valueFrom:
                fieldRef:
                  fieldPath: metadata.name
            - name: POD_NAMESPACE
              valueFrom:
                fieldRef:
                  fieldPath: metadata.namespace
            - name: POD_IP
              valueFrom:
                fieldRef:
                  fieldPath: status.podIP

          # 从ConfigMap挂载应用配置文件
          volumeMounts:
            - name: config-volume
              mountPath: /app/config
              readOnly: true
            - name: logs-volume
              mountPath: /app/logs

          # 资源限制
          resources:
            requests:
              cpu: "250m"
              memory: "512Mi"
            limits:
              cpu: "1000m"
              memory: "1536Mi"

          # 存活探针:检测应用是否存活,失败则重启Pod
          livenessProbe:
            httpGet:
              path: /actuator/health/liveness
              port: 8080
            initialDelaySeconds: 60    # 应用启动需要时间
            periodSeconds: 15
            timeoutSeconds: 5
            failureThreshold: 3
            successThreshold: 1

          # 就绪探针:检测应用是否就绪,失败则从Service摘除
          readinessProbe:
            httpGet:
              path: /actuator/health/readiness
              port: 8080
            initialDelaySeconds: 30
            periodSeconds: 10
            timeoutSeconds: 3
            failureThreshold: 3
            successThreshold: 1

          # 启动探针:检测应用是否启动完成(K8s 1.16+)
          startupProbe:
            httpGet:
              path: /actuator/health
              port: 8080
            initialDelaySeconds: 10
            periodSeconds: 10
            timeoutSeconds: 5
            failureThreshold: 18  # 最多等待3分钟启动(18*10s)

          # 生命周期钩子
          lifecycle:
            preStop:
              exec:
                command:
                  - sh
                  - -c
                  - |
                    # 1. 从注册中心注销,停止接收新请求
                    curl -X POST http://localhost:8080/actuator/service-registry || true
                    # 2. 等待已有请求处理完成
                    sleep 15
                    # 3. 优雅关闭
                    curl -X POST http://localhost:8080/actuator/shutdown || true

      volumes:
        - name: config-volume
          configMap:
            name: payment-service-config
        - name: logs-volume
          emptyDir:
            medium: Memory  # 使用内存存储日志(tmpfs),避免磁盘IO
            sizeLimit: 100Mi

      # 安全上下文
      securityContext:
        runAsNonRoot: true
        runAsUser: 1000
        runAsGroup: 1000
        fsGroup: 1000

      # 镜像拉取凭证
      imagePullSecrets:
        - name: aliyun-registry-secret
6.3 K8s配置要点解析
这份Deployment配置包含了很多生产环境的最佳实践,让我逐一解析关键配置项:
| 配置项 | 配置值 | 设计理由 |
|---|---|---|
| maxUnavailable: 0 | 0 | 滚动更新时不允许减少可用Pod,实现零停机部署 |
| maxSurge: 1 | 1 | 每次最多多启动1个新Pod,控制资源消耗 |
| revisionHistoryLimit | 10 | 保留10个历史版本,支持回滚到较老版本 |
| podAntiAffinity | preferred | 尽量将Pod分散到不同节点,避免单节点故障影响全部Pod |
| terminationGracePeriodSeconds | 60 | 给应用60秒优雅关闭时间,处理完已有请求 |
| startupProbe | failureThreshold=18 | Java应用启动慢,最多等3分钟,避免被livenessProbe误杀 |
| preStop hook | sleep 15 | 从Service摘除后等待15秒,确保不再有流量进入 |
| securityContext | runAsNonRoot | 非root运行,符合Pod Security Standards |
| logs emptyDir: Memory | tmpfs | 日志写内存(tmpfs),减少磁盘IO,容器销毁即清理 |
| resources.requests | 250m/512Mi | 请求资源适中,保证调度成功率 |
| resources.limits | 1000m/1536Mi | 限制上限,防止单Pod耗尽节点资源 |
三种探针的配合使用是这份配置中最精妙的部分。很多团队只配了livenessProbe和readinessProbe,但Java应用的启动时间往往较长(尤其是Spring Boot),如果livenessProbe的initialDelaySeconds设得太短,应用还没启动完就被判定为不健康而重启,进入"CrashLoopBackOff"的死循环。引入startupProbe后,在启动阶段只有startupProbe生效,等它通过后livenessProbe才接管,完美解决了这个问题。
preStop生命周期钩子同样关键。当K8s要终止一个Pod时,会同时发送SIGTERM信号并将Pod从Service的Endpoints中移除。但由于K8s的Endpoint controller和kube-proxy的异步更新特性,Pod可能在收到SIGTERM后仍然收到少量请求。preStop中的sleep 15就是给K8s足够时间完成Endpoint更新,确保Pod真正不再收到流量后再开始关闭。
6.4 Service、HPA与PDB配置
# k8s/manifests/service.yaml
apiVersion: v1
kind: Service
metadata:
  name: payment-service
  namespace: production
  labels:
    app: payment-service
spec:
  type: ClusterIP
  selector:
    app: payment-service
  ports:
    - name: http
      port: 8080
      targetPort: 8080
      protocol: TCP
    - name: actuator
      port: 8081
      targetPort: 8081
      protocol: TCP
---
# k8s/manifests/hpa.yaml
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: payment-service
  namespace: production
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: payment-service
  minReplicas: 3
  maxReplicas: 10
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 70
    - type: Resource
      resource:
        name: memory
        target:
          type: Utilization
          averageUtilization: 80
  behavior:
    scaleUp:
      stabilizationWindowSeconds: 0    # 扩容立即执行
      policies:
        - type: Percent
          value: 100                    # 每次最多扩容100%
          periodSeconds: 60
    scaleDown:
      stabilizationWindowSeconds: 300   # 缩容等待5分钟确认
      policies:
        - type: Percent
          value: 10                     # 每次最多缩容10%
          periodSeconds: 60
---
# k8s/manifests/pdb.yaml
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: payment-service
  namespace: production
spec:
  minAvailable: 2               # 至少保持2个Pod可用
  selector:
    matchLabels:
app: payment-serviceHPA的behavior配置是Gemini帮我加的,很多人会忽略这部分。默认情况下,HPA的扩缩容行为可能过于激进或过于保守。通过自定义behavior:
- 扩容:
stabilizationWindowSeconds: 0表示流量突增时立即扩容,不等待。每次最多扩容100%,即最多翻倍。 - 缩容:
stabilizationWindowSeconds: 300表示流量下降后等5分钟再缩容,避免流量波动导致的频繁伸缩。每次最多缩容10%,缓慢释放资源。
PDB保证了在自愿中断(如节点维护、滚动更新)时,至少有2个Pod保持可用,防止所有Pod同时被驱逐导致服务不可用。
6.5 ConfigMap与Secret管理
# k8s/manifests/configmap.yaml
apiVersion: v1
kind: ConfigMap
metadata:
  name: payment-service-config
  namespace: production
data:
  spring-profile: "prod"
  application.yml: |
    server:
      port: 8080
      shutdown: graceful
      compression:
        enabled: true
        mime-types: application/json,text/html,text/xml,text/plain

    spring:
      lifecycle:
        timeout-per-shutdown-phase: 30s
      datasource:
        hikari:
          maximum-pool-size: 20
          minimum-idle: 5
          connection-timeout: 30000
          idle-timeout: 600000
          max-lifetime: 1800000
      redis:
        timeout: 3000
        lettuce:
          pool:
            max-active: 16
            max-idle: 8
            min-idle: 2

      kafka:
        bootstrap-servers: kafka.production:9092
        consumer:
          group-id: payment-service
          auto-offset-reset: earliest
          enable-auto-commit: false

    management:
      endpoints:
        web:
          exposure:
            include: health,info,prometheus,metrics
      endpoint:
        health:
          probes:
            enabled: true
          show-details: when-authorized
        shutdown:
          enabled: true
      metrics:
        tags:
          application: payment-service
        export:
          prometheus:
            enabled: true

    logging:
      level:
        root: INFO
        com.company.payment: DEBUG
      pattern:
        console: "%d{yyyy-MM-dd HH:mm:ss.SSS} [%thread] %-5level %logger{36} [trace=%X{traceId}] - %msg%n"
---
# k8s/manifests/secret.yaml (使用Sealed Secrets或External Secrets更安全)
apiVersion: v1
kind: Secret
metadata:
  name: payment-service-secret
  namespace: production
type: Opaque
stringData:
  db-host: "mysql.production:3306"
  db-password: "BASE64_ENCODED_PASSWORD"  # 实际使用Sealed Secrets
  redis-password: "BASE64_ENCODED_PASSWORD"
kafka-sasl-password: "BASE64_ENCODED_PASSWORD"关于Secret管理的安全建议:直接在YAML中写Secret是不安全的,即使Base64编码也不是加密。生产环境推荐使用以下方案之一:
| 方案 | 原理 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| Sealed Secrets | 加密后可安全存入Git | GitOps友好 | 需维护私钥 | 中小团队 |
| External Secrets | 从Vault/AWS SM动态获取 | 安全级别最高 | 架构复杂 | 大型团队 |
| Cloud KMS | 云厂商密钥管理 | 与云深度集成 | 厂商锁定 | 云原生团队 |
| SOPS | Mozilla的加密工具 | 灵活支持多后端 | 学习曲线 | 技术团队 |
我们最终选择了Sealed Secrets,因为它与GitOps工作流契合——加密后的Secret可以安全地存储在Git仓库中,ArgoCD可以直接同步部署,无需额外处理。
七、实战第五阶段:监控、通知与可观测性
7.1 钉钉通知:让部署状态触手可及
部署过程的可视化和通知是CI/CD体验的重要一环。我们实现了多渠道的通知机制,其中钉钉通知是最常用的。在GitHub Actions的workflow中我们已经集成了钉钉通知,这里补充一个更完善的Shell通知脚本:
#!/bin/bash
# ============================================
# notify.sh - 统一通知脚本
# 支持钉钉、飞书、企业微信
# ============================================

set -euo pipefail

# ==================== 配置 ====================
DINGTALK_WEBHOOK="${DINGTALK_WEBHOOK:-}"
FEISHU_WEBHOOK="${FEISHU_WEBHOOK:-}"
WECOM_WEBHOOK="${WECOM_WEBHOOK:-}"

# ==================== 钉钉通知 ====================
send_dingtalk() {
    [[ -z "$DINGTALK_WEBHOOK" ]] && return 0

    local title=$1
    local content=$2
    local is_at_all=${3:-false}

    local payload
    payload=$(jq -n \
        --arg title "$title" \
        --arg text "$content" \
        --argjson isAtAll "$is_at_all" \
        '{
            msgtype: "markdown",
            markdown: {
                title: $title,
                text: $text
            },
            at: {
                isAtAll: $isAtAll
            }
        }')

    curl -s -X POST "$DINGTALK_WEBHOOK" \
        -H "Content-Type: application/json" \
        -d "$payload" >/dev/null 2>&1
}

# ==================== 飞书通知 ====================
send_feishu() {
    [[ -z "$FEISHU_WEBHOOK" ]] && return 0

    local title=$1
    local content=$2

    local payload
    payload=$(jq -n \
        --arg title "$title" \
        --arg content "$content" \
        '{
            msg_type: "interactive",
            card: {
                header: {
                    title: { tag: "plain_text", content: $title },
                    template: "green"
                },
                elements: [
                    { tag: "markdown", content: $content }
                ]
            }
        }')

    curl -s -X POST "$FEISHU_WEBHOOK" \
        -H "Content-Type: application/json" \
        -d "$payload" >/dev/null 2>&1
}

# ==================== 企业微信通知 ====================
send_wecom() {
    [[ -z "$WECOM_WEBHOOK" ]] && return 0

    local content=$1

    local payload
    payload=$(jq -n --arg content "$content" \
        '{ msgtype: "markdown", markdown: { content: $content } }')

    curl -s -X POST "$WECOM_WEBHOOK" \
        -H "Content-Type: application/json" \
        -d "$payload" >/dev/null 2>&1
}

# ==================== 构建通知内容 ====================
build_deploy_notification() {
    local status=$1      # success/failed/running
    local service=$2
    local version=$3
    local duration=${4:-"进行中"}
    local error_msg=${5:-""}

    local emoji title color

    case $status in
        success)
            emoji="WHITE heavy check mark"
            title="部署成功"
            color="#22c55e"
            ;;
        failed)
            emoji="CROSS MARK"
            title="部署失败"
            color="#ef4444"
            ;;
        running)
            emoji="HOURGLASS"
            title="部署开始"
            color="#3b82f6"
            ;;
    esac

    local content
    content="### ${title} ${emoji}\n\n"
    content+="| 项目 | 信息 |\n"
    content+="|------|------|\n"
    content+="| **服务** | ${service} |\n"
    content+="| **版本** | ${version} |\n"
    content+="| **状态** | ${status} |\n"
    content+="| **耗时** | ${duration} |\n"
    content+="| **时间** | $(date '+%Y-%m-%d %H:%M:%S') |\n"
    content+="| **执行人** | ${USER:-CI-Bot} |\n"

    if [[ -n "$error_msg" ]]; then
        content+="\n**错误信息**:\n\`\`\`\n${error_msg}\n\`\`\`\n"
    fi

    content+="\n> [查看详情](${CI_PIPELINE_URL:-#})"

    echo "$content"
}

# ==================== 主入口 ====================
main() {
    local status="${1:-success}"
    local service="${2:-payment-service}"
    local version="${3:-unknown}"
    local duration="${4:-}"
    local error_msg="${5:-}"

    local content
    content=$(build_deploy_notification "$status" "$service" "$version" "$duration" "$error_msg")
    local title="部署通知: ${service} ${status}"

    # 发送到所有配置的渠道
    send_dingtalk "$title" "$content" "$([[ "$status" == "failed" ]] && echo true || echo false)"
    send_feishu "$title" "$content"
    send_wecom "$content"

    echo "通知已发送"
}

main "$@"
7.2 监控指标体系
部署完成后,持续的监控是保证服务质量的关键。我们基于Prometheus + Grafana搭建了监控体系,关键指标如下:
| 监控层级 | 指标名称 | 告警阈值 | 检查频率 | 说明 |
|---|---|---|---|---|
| 基础设施 | Node CPU Usage | > 80% | 30秒 | 节点CPU使用率 |
| 基础设施 | Node Memory Usage | > 85% | 30秒 | 节点内存使用率 |
| 基础设施 | Node Disk Usage | > 80% | 5分钟 | 节点磁盘使用率 |
| Pod | Pod CPU | > 90% of limit | 30秒 | Pod CPU使用率 |
| Pod | Pod Memory | > 90% of limit | 30秒 | Pod内存使用率 |
| Pod | Pod Restart Count | > 3 in 10min | 1分钟 | 频繁重启告警 |
| 应用 | HTTP 5xx Rate | > 1% | 30秒 | 服务端错误率 |
| 应用 | HTTP P99 Latency | > 2000ms | 30秒 | P99延迟 |
| 应用 | JVM Heap Usage | > 85% | 30秒 | 堆内存使用率 |
| 应用 | DB Connection Pool | > 80% | 30秒 | 数据库连接池使用率 |
| 业务 | Payment Success Rate | < 95% | 1分钟 | 支付成功率 |
| 业务 | Order Processing Time | > 5000ms | 1分钟 | 订单处理耗时 |
这套监控指标体系的核心思想是分层监控、快速定位。当出现问题时,从业务指标入手判断影响范围,从应用指标定位问题服务,从Pod指标确认资源瓶颈,从基础设施指标排除底层问题。每一层都有对应的告警规则和Runbook,确保值班同学能在5分钟内完成初步定位。
八、效果数据与前后对比
8.1 部署效率对比
经过3个月的迭代优化,CI/CD流水线完全落地。以下是改造前后的核心指标对比:
| 指标 | 改造前 | 改造后 | 改善幅度 | 影响 |
|---|---|---|---|---|
| 部署总耗时 | 3小时12分钟 | 8分钟 | 缩短95.8% | 周五准时下班 |
| 部署频率 | 每周1-2次 | 每天5-10次 | 提升5-10倍 | 小步快跑,快速迭代 |
| 部署失败率 | 17% | 0.3% | 降低98.2% | 生产稳定性大幅提升 |
| 平均故障恢复时间(MTTR) | 45分钟 | 3分钟 | 缩短93.3% | 故障影响最小化 |
| 部署所需人力 | 3人(1开发+2运维) | 0人(全自动) | 完全自动化 | 人力释放到更有价值的工作 |
| 回滚时间 | 30-60分钟 | 2-3分钟 | 缩短95% | 问题影响窗口极小 |
| 环境一致性 | 经常不一致 | 完全一致 | 100% | 消除"在我机器上能跑" |
| 变更可追溯性 | 口头记录/聊天记录 | Git提交记录 | 100%可追溯 | 审计合规 |
8.2 团队效率提升
部署效率的提升带来了连锁反应,整个团队的研发效能都发生了质的变化:
| 团队指标 | 改造前 | 改造后 | 变化说明 |
|---|---|---|---|
| 功能交付周期 | 2-3周 | 3-5天 | 从需求到上线的时间大幅缩短 |
| 部署等待时间 | 半天到1天 | 8分钟 | 开发不再需要等待部署窗口 |
| 加班时长(月均) | 20+小时 | 5小时以内 | 主要减少部署相关加班 |
| 生产事故数(月) | 4-5次 | 0-1次 | 自动化减少了人为错误 |
| 开发满意度 | 3.2/10 | 8.5/10 | 匿名问卷调查结果 |
| 运维满意度 | 2.8/10 | 9.0/10 | 从手动操作中解放 |
8.3 8分钟的构成拆解
很多人好奇8分钟的部署时间是怎么构成的,以下是详细拆解:
| 阶段 | 耗时 | 是否可并行 | 说明 |
|---|---|---|---|
| 代码检出与缓存恢复 | 15秒 | 否 | Git checkout + Maven缓存恢复 |
| 编译与单元测试 | 90秒 | 否 | Maven并行编译 + JUnit测试 |
| Docker镜像构建 | 45秒 | 否 | 利用Buildx层缓存 |
| 镜像推送 | 20秒 | 否 | 并行推送多架构镜像 |
| 安全扫描 | 25秒 | 否 | Trivy增量扫描 |
| ArgoCD检测与同步 | 30秒 | 否 | GitOps自动同步 |
| K8s滚动更新 | 120秒 | 是(3服务并行) | 3副本滚动更新,零停机 |
| 健康检查验证 | 60秒 | 是 | 应用层健康检查 |
| 集成测试 | 60秒 | 否 | Newman API自动化测试 |
| 通知发送 | 5秒 | 否 | 钉钉通知 |
| 总计(串行) | 约470秒 | - | 约7.8分钟 |
其中K8s滚动更新和健康检查是并行的(3个服务同时更新),实际墙钟时间比所有步骤串行加总要短。8分钟是从代码合并到生产环境验证完成的全链路时间。
九、Gemini使用技巧与最佳实践
在整个CI/CD建设过程中,Gemini扮演了重要的辅助角色。但AI不是万能的,如何高效地使用它,有一些技巧和经验值得分享。
9.1 Prompt工程:如何让Gemini生成高质量的CI/CD配置
经过反复实践,我总结了一套针对DevOps场景的Prompt模板:
[角色设定]
你是一位资深DevOps工程师,精通GitHub Actions、Docker、Kubernetes、
Shell脚本和CI/CD最佳实践。

[任务描述]
请帮我编写 {具体任务},用于 {应用场景}。

[技术栈信息]
- 编程语言: {如 Java 17}
- 框架: {如 Spring Boot 3.2}
- 构建工具: {如 Maven}
- 容器运行时: {如 Docker}
- 编排工具: {如 Kubernetes 1.28}
- CI/CD平台: {如 GitHub Actions}

[具体需求]
1. {需求1}
2. {需求2}
3. {需求3}

[约束条件]
- 需要支持 {如多架构构建/非root运行/资源限制}
- 镜像大小不超过 {如 200MB}
- 构建时间不超过 {如 3分钟}
- 必须包含 {如健康检查/安全扫描/通知}

[输出要求]
- 给出完整的配置文件
- 在关键配置处添加注释说明
- 列出需要设置的Secret/环境变量
- 说明潜在的坑和注意事项这个模板的精髓在于"约束条件"和"输出要求"。很多开发者用AI时只描述"我要什么",但不说明"限制条件"和"质量要求",导致AI生成的配置虽然能跑,但可能不符合生产环境标准。
9.2 迭代式优化工作流
AI生成的配置很少一次就完美,需要迭代优化。我的工作流是这样的:
- 第一轮:生成骨架。用Prompt让Gemini生成配置的完整骨架,关注整体结构是否合理。
- 第二轮:填充细节。针对每个部分单独深入,比如"请优化livenessProbe和readinessProbe的参数配置,考虑Java应用的启动特性"。
- 第三轮:安全审查。把生成的配置贴回去,请Gemini做安全审查:"请检查这份配置是否存在安全隐患,包括权限、Secret管理、网络策略等"。
- 第四轮:性能优化。请Gemini分析性能瓶颈:"请分析这份配置在构建和运行阶段的性能瓶颈,给出优化建议"。
- 第五轮:边界case。请Gemini考虑极端场景:"如果K8s节点突然宕机,这份配置的表现如何?如何改进?"
9.3 Gemini在CI/CD场景中的能力边界
虽然Gemini在本次实践中表现出色,但也有它的局限性。以下是我的客观评价:
| 能力维度 | 表现 | 说明 |
|---|---|---|
| YAML配置生成 | 优秀 | 字段完整度高,版本兼容性好 |
| Shell脚本编写 | 优秀 | 错误处理和边界条件考虑周全 |
| Dockerfile优化 | 优秀 | 多阶段构建、层缓存建议精准 |
| K8s清单生成 | 良好 | 基础配置完整,复杂场景需人工调整 |
| 错误诊断 | 良好 | 能分析常见错误,复杂问题需人工介入 |
| 架构设计 | 良好 | 给出合理建议,但需要人工判断适用性 |
| 最新特性支持 | 中等 | 对非常新的工具版本可能信息滞后 |
| 复杂调试 | 有限 | 多服务联调、网络问题等复杂场景能力有限 |
| 业务逻辑理解 | 有限 | 不理解具体业务,只能从技术角度给建议 |
核心原则:AI是副驾驶,不是自动驾驶。AI可以帮你快速生成配置骨架、提供优化建议、排查常见错误,但最终的生产环境配置必须由有经验的工程师审核确认。特别是在安全、性能、可用性方面,人类的判断力仍然不可替代。
十、ArgoCD GitOps深度配置
10.1 为什么选择ArgoCD做CD
在CI阶段我们用GitHub Actions完成了构建、测试和镜像推送,但CD(持续部署)阶段如果也用GitHub Actions直接执行kubectl命令,会存在几个问题:首先是安全性——GitHub Actions的Runner要持有K8s集群的kubeconfig,这是一个高风险的凭据;其次是可追溯性——直接kubectl apply的变更不会记录在集群中,难以审计;最后是一致性——如果有人手动修改了K8s资源,GitHub Actions不会感知到这种漂移。
ArgoCD解决了这些问题。它以GitOps模式运行——Git仓库是唯一真相源,ArgoCD持续监听Git仓库的变化,当检测到变更时自动同步到K8s集群。同时,它还会检测集群中的实际状态与Git中声明的状态是否一致,发现漂移时可以自动纠正或告警。
以下是ArgoCD与传统kubectl部署模式的对比:
| 对比维度 | kubectl直接部署 | ArgoCD GitOps部署 |
|---|---|---|
| 部署触发方式 | CI流水线调用kubectl | ArgoCD监听Git仓库自动同步 |
| 凭据管理 | CI Runner持有kubeconfig | ArgoCD Server持有,CI无需访问集群 |
| 状态漂移检测 | 无 | 自动检测并可配置自动纠正 |
| 部署历史 | 依赖CI日志 | ArgoCD UI完整展示每次同步 |
| 回滚方式 | 手动执行kubectl rollout undo | UI一键回滚到任意历史版本 |
| 多集群管理 | 需分别配置 | 统一管理多集群 |
| 部署可视化 | 无 | 实时展示K8s资源拓扑图 |
| 审批流程 | 依赖CI平台 | 原生支持Sync Window和手动审批 |
10.2 ArgoCD Application配置
以下是我们的ArgoCD Application配置,我同样请Gemini帮忙生成初始版本,然后做了生产化调整:
# argocd/payment-service-app.yaml
apiVersion: argoproj.io/v1alpha1
kind: Application
metadata:
  name: payment-service
  namespace: argocd
  finalizers:
    - resources-finalizer.argocd.argoproj.io
spec:
  project: production

  # 源:Git仓库中的K8s清单
  source:
    repoURL: https://github.com/myteam/payment-service.git
    targetRevision: main
    path: k8s/manifests

  # 目标:K8s集群和命名空间
  destination:
    server: https://kubernetes.default.svc
    namespace: production

  # 同步策略
  syncPolicy:
    automated:
      prune: true              # 自动清理Git中已删除的资源
      selfHeal: true           # 自动纠正状态漂移
      allowEmpty: false        # 不允许同步空应用(防止误删)
    syncOptions:
      - CreateNamespace=true   # 如果namespace不存在则创建
      - PrunePropagationPolicy=foreground
      - ApplyOutOfSyncOnly=true # 只同步发生变化的资源
      - PruneLast=true         # 最后才清理旧资源

    # 重试策略
    retry:
      limit: 5
      backoff:
        duration: 5s
        factor: 2
        maxDuration: 3m

    # 同步窗口(可选):限制部署时间窗口
    # 例如:只在工作日9:00-22:00自动同步
    # syncWindows:
    #   - kind: allow
    #     schedule: '0 9 * * 1-5'
    #     duration: 13h
    #     namespaces:
    #       - production

  # 忽略某些字段的变化(不触发同步)
  ignoreDifferences:
    - group: apps
      kind: Deployment
      jsonPointers:
        - /spec/replicas    # HPA管理副本数,忽略手动修改

  # 健康评估
  revisionHistoryLimit: 10
这个配置中有几个关键点值得深入说明:
selfHeal: true 是双刃剑。开启后,如果有人通过kubectl手动修改了K8s资源(比如修改了副本数或镜像tag),ArgoCD会自动将其恢复为Git仓库中声明的状态。这保证了集群状态与Git完全一致,但也意味着kubectl edit这种紧急修改会被覆盖。我们的做法是:生产环境开启selfHeal,但在紧急情况下通过ArgoCD的Disable Self-Heal功能临时关闭。
PruneLast: true 确保在同步过程中,新资源先创建,旧资源最后才清理。这在资源存在依赖关系时很重要——比如先创建新Service,再删除旧Service,避免短暂的服务不可用。
ignoreDifferences 中的/spec/replicas忽略是一个常见配置。因为HPA会动态调整副本数,如果不忽略这个字段,ArgoCD会认为副本数发生了漂移而不断尝试"纠正",与HPA形成冲突。
10.3 ArgoCD ApplicationSet实现多环境部署
当团队有多个环境(dev/staging/production)和多个微服务时,为每个组合单独创建ArgoCD Application会很繁琐。Gemini建议我使用ApplicationSet,通过模板化方式批量生成Application:
# argocd/application-set.yaml
apiVersion: argoproj.io/v1alpha1
kind: ApplicationSet
metadata:
  name: payment-services
  namespace: argocd
spec:
  generators:
    # 列表生成器:枚举所有服务和环境组合
    - list:
        elements:
          - service: payment-api
            env: staging
            cluster: https://staging.k8s.example.com
          - service: payment-api
            env: production
            cluster: https://kubernetes.default.svc
          - service: payment-core
            env: staging
            cluster: https://staging.k8s.example.com
          - service: payment-core
            env: production
            cluster: https://kubernetes.default.svc
          - service: payment-service
            env: staging
            cluster: https://staging.k8s.example.com
          - service: payment-service
            env: production
            cluster: https://kubernetes.default.svc
  template:
    metadata:
      name: '{{service}}-{{env}}'
    spec:
      project: '{{env}}'
      source:
        repoURL: https://github.com/myteam/payment-service.git
        targetRevision: main
        path: 'k8s/manifests/{{env}}'
      destination:
        server: '{{cluster}}'
        namespace: '{{env}}'
      syncPolicy:
        automated:
          prune: true
          selfHeal: true
        syncOptions:
- CreateNamespace=true这个ApplicationSet配置让我们只需维护一份模板,就能管理3个服务×2个环境=6个Application。新增服务或环境时,只需在elements列表中添加一行,ArgoCD会自动创建对应的Application。
十一、数据库迁移自动化
11.1 数据库迁移的挑战
在CI/CD流水线中,数据库迁移是最棘手的环节之一。与应用部署不同,数据库迁移涉及数据本身,一旦出错可能导致数据丢失,而且无法像应用一样简单回滚。我们在设计数据库迁移策略时,遵循了一个核心原则:迁移脚本必须向前兼容,且可重复执行。
我们对比了三种数据库迁移方案:
| 方案 | 原理 | 优点 | 缺点 | 我们是否采用 |
|---|---|---|---|---|
| Flyway | 版本号管理SQL脚本 | 简单直观,学习成本低 | 不支持回滚 | 采用(主方案) |
| Liquibase | XML/YAML/JSON描述变更 | 支持回滚,数据库无关 | 配置复杂,学习成本高 | 未采用 |
| 手动SQL | 运维手动执行 | 灵活,可精确控制 | 不可追溯,易遗漏 | 已废弃 |
11.2 Flyway迁移脚本管理
我们选择了Flyway作为数据库迁移工具,核心原因有二:一是Flyway的版本号机制简单直观,团队成员容易理解;二是Flyway与Spring Boot深度集成,只需添加依赖即可使用。以下是我们的Flyway迁移脚本目录结构:
payment-service/
├── src/main/resources/
│   └── db/migration/
│       ├── V1.0.0__create_payment_table.sql
│       ├── V1.0.1__add_payment_status_index.sql
│       ├── V1.1.0__add_refund_table.sql
│       ├── V1.1.1__add_refund_amount_column.sql
│       ├── V2.0.0__restructure_payment_schema.sql
│       ├── V2.0.1__add_payment_metadata_table.sql
│       └── V2.1.0__add_transaction_log_table.sql
├── src/main/resources/
│   └── db/repeatable/
│ └── R__refresh_payment_view.sqlFlyway的命名规范很重要:V前缀表示版本化迁移(执行一次),R前缀表示可重复执行的迁移(内容变化时重新执行)。版本号采用语义化版本格式,确保执行顺序正确。
在CI流水线中,数据库迁移的执行时机需要谨慎设计。我们的做法是:在应用启动时由Flyway自动执行迁移,而不是在CI流水线中单独执行。这样做的好处是迁移与应用版本绑定,不会出现"迁移执行了但应用没部署"的不一致状态。
Spring Boot中的Flyway配置如下:
# application.yml中的Flyway配置
spring:
  flyway:
    enabled: true
    locations: classpath:db/migration,classpath:db/repeatable
    baseline-on-migrate: true     # 已有数据库首次迁移时创建基线
    baseline-version: 1.0.0       # 基线版本
    validate-on-migrate: true     # 迁移前验证已有迁移的完整性
    out-of-order: false           # 不允许乱序执行
    table: flyway_schema_history  # 迁移历史表名
    encoding: UTF-8
    placeholder-replacement: true
    placeholders:
      db_user: payment_app
11.3 数据库迁移的安全策略
对于生产环境的数据库迁移,我们制定了以下安全策略,确保迁移不会导致服务中断或数据丢失:
| 策略 | 说明 | 示例 |
|---|---|---|
| 向前兼容 | 迁移脚本必须兼容新旧版本应用 | 新增列允许NULL,不删除旧列 |
| 分步迁移 | 大范围结构调整拆分为多个版本 | V2.0创建新表→V2.1迁移数据→V2.2切换应用→V2.3删除旧表 |
| 数据备份 | 迁移前自动备份相关表 | CI流水线在迁移前执行mysqldump |
| 回滚预案 | 每个迁移脚本配套回滚SQL | V2.0.1_up.sql + V2.0.1_down.sql |
| 执行前校验 | 迁移前检查数据库状态 | 检查磁盘空间、连接数、锁状态 |
| 维护窗口 | 大迁移在低峰期执行 | 凌晨2:00-4:00自动执行 |
以下是CI流水线中数据库迁移预处理脚本的片段:
#!/bin/bash
# db-migration-precheck.sh - 数据库迁移前置检查

set -euo pipefail

DB_HOST="${DB_HOST:-mysql.production}"
DB_PORT="${DB_PORT:-3306}"
DB_NAME="${DB_NAME:-payment_db}"
DB_USER="${DB_USER:-payment_app}"

echo "=== 数据库迁移前置检查 ==="

# 检查1: 数据库连接
if ! mysqladmin ping -h "$DB_HOST" -P "$DB_PORT" -u "$DB_USER" -p"$DB_PASSWORD" --silent; then
    echo "FAIL: 无法连接到数据库 $DB_HOST:$DB_PORT"
    exit 1
fi
echo "PASS: 数据库连接正常"

# 检查2: 磁盘空间(至少需要当前数据库大小的50%空闲空间)
DB_SIZE=$(mysql -h "$DB_HOST" -P "$DB_PORT" -u "$DB_USER" -p"$DB_PASSWORD" \
    -e "SELECT ROUND(SUM(data_length+index_length)/1024/1024/1024,2) AS size_gb \
    FROM information_schema.tables WHERE table_schema='$DB_NAME'" -s -N)
echo "数据库大小: ${DB_SIZE}GB"

# 检查3: 活跃连接数
ACTIVE_CONNECTIONS=$(mysql -h "$DB_HOST" -P "$DB_PORT" -u "$DB_USER" -p"$DB_PASSWORD" \
    -e "SELECT COUNT(*) FROM information_schema.processlist WHERE db='$DB_NAME'" -s -N)
echo "活跃连接数: $ACTIVE_CONNECTIONS"

if [[ $ACTIVE_CONNECTIONS -gt 50 ]]; then
    echo "WARN: 活跃连接数较多($ACTIVE_CONNECTIONS),建议在低峰期执行迁移"
fi

# 检查4: 慢查询(是否有正在执行的长时间查询)
LONG_QUERIES=$(mysql -h "$DB_HOST" -P "$DB_PORT" -u "$DB_USER" -p"$DB_PASSWORD" \
    -e "SELECT COUNT(*) FROM information_schema.processlist \
    WHERE db='$DB_NAME' AND time > 30" -s -N)
if [[ $LONG_QUERIES -gt 0 ]]; then
    echo "FAIL: 发现 $LONG_QUERIES 个执行超过30秒的查询,请等待完成后再迁移"
    exit 1
fi
echo "PASS: 无长时间运行的查询"

# 检查5: 待执行迁移脚本
MIGRATION_COUNT=$(find ./src/main/resources/db/migration -name "V*.sql" | wc -l)
EXECUTED_COUNT=$(mysql -h "$DB_HOST" -P "$DB_PORT" -u "$DB_USER" -p"$DB_PASSWORD" \
    "$DB_NAME" -e "SELECT COUNT(*) FROM flyway_schema_history WHERE success=1" -s -N)
PENDING=$((MIGRATION_COUNT - EXECUTED_COUNT))
echo "待执行迁移: $PENDING 个"

if [[ $PENDING -eq 0 ]]; then
    echo "INFO: 无待执行迁移"
else
    echo "INFO: 待执行迁移脚本:"
    find ./src/main/resources/db/migration -name "V*.sql" | sort | tail -n "$PENDING"
fi

# 自动备份
echo "=== 开始数据库备份 ==="
BACKUP_FILE="/tmp/${DB_NAME}_backup_$(date +%Y%m%d_%H%M%S).sql.gz"
mysqldump -h "$DB_HOST" -P "$DB_PORT" -u "$DB_USER" -p"$DB_PASSWORD" \
    --single-transaction --routines --triggers "$DB_NAME" | gzip > "$BACKUP_FILE"
echo "备份完成: $BACKUP_FILE ($(du -sh "$BACKUP_FILE" | cut -f1))"

echo "=== 前置检查全部通过 ==="
十二、踩过的坑与避坑指南
12.1 YAML缩进陷阱
这是最常见也最隐蔽的坑。YAML对缩进极其敏感,多一个空格或少一个空格都可能导致配置解析失败。而且有些缩进错误不会立即报错,而是在特定条件下才触发问题。在我们的实践中,有一次因为GitHub Actions的YAML文件中一个多出来的空格,导致workflow在特定条件下才触发问题——平时正常运行,但当某个step的输出包含特殊字符时就会解析失败。这种间歇性错误排查起来极其痛苦,花了我大半天时间才定位到。
典型场景:GitHub Actions的if条件中,&&操作符的缩进。以下两种写法看起来差不多,但行为不同:
# 正确写法
- name: Deploy
  if: github.event_name == 'push' && github.ref == 'refs/heads/main'
  run: echo "deploying"

# 错误写法(if条件被截断)
- name: Deploy
  if: github.event_name == 'push'
  && github.ref == 'refs/heads/main'
run: echo "deploying"避坑建议:使用支持YAML语法检查的编辑器(如VS Code + YAML插件),并在本地用actionlint工具验证GitHub Actions配置:
# 安装actionlint
brew install actionlint
# 或
go install github.com/rhysd/actionlint/cmd/actionlint@latest

# 验证workflow
actionlint .github/workflows/ci-cd-pipeline.yml
12.2 Docker镜像层缓存失效
在多模块Maven项目中,如果COPY pom.xml .只复制了根pom.xml而没有复制子模块的pom.xml,那么任何子模块的pom.xml变化都不会触发依赖重新下载,导致构建使用了过时的依赖。
正确做法是确保所有pom.xml都被正确复制:
# 正确:复制所有pom.xml
COPY pom.xml .
COPY payment-api/pom.xml payment-api/
COPY payment-core/pom.xml payment-core/
COPY payment-service/pom.xml payment-service/

# 错误:只复制根pom.xml
COPY pom.xml .
12.3 K8s探针参数不合理
这是导致部署失败的常见原因。以下是错误配置和正确配置的对比:
| 探针参数 | 错误配置 | 正确配置 | 错误原因 |
|---|---|---|---|
| liveness initialDelay | 10秒 | 60秒或用startupProbe | Java应用启动需30-60秒,10秒太短 |
| liveness failureThreshold | 1 | 3 | 一次失败就重启,太激进 |
| readiness period | 60秒 | 10秒 | 60秒检查间隔太长,延迟感知就绪状态 |
| readiness timeout | 30秒 | 3秒 | 健康检查不应耗时太长 |
| 无startupProbe | 不配置 | 配置 | Java应用启动慢,需startupProbe保护 |
12.4 资源限制设置不当
资源限制设置过高浪费资源,设置过低导致OOM或CPU throttling。以下是常见错误和正确实践:
# 错误:不设limits,可能导致节点资源耗尽
resources:
  requests:
    cpu: "100m"
    memory: "128Mi"
  # 没有 limits

# 错误:requests和limits差距过大
resources:
  requests:
    cpu: "100m"
    memory: "128Mi"
  limits:
    cpu: "4000m"      # 40倍差距,可能导致调度问题
    memory: "8Gi"     # 64倍差距

# 正确:合理配比(requests通常是limits的50%-80%)
resources:
  requests:
    cpu: "250m"
    memory: "512Mi"
  limits:
    cpu: "1000m"      # 4倍,合理
    memory: "1536Mi"  # 3倍,合理
CPU throttling的陷阱:如果limits.cpu设得太低,即使requests.cpu满足需求,应用也可能因为CPU throttling而响应变慢。建议通过监控观察CPU使用情况,逐步调整到合理值。
12.5 并发部署冲突
在多服务部署时,如果多个服务的部署同时触发,可能导致资源争抢或配置冲突。解决方案:
- 在GitHub Actions中使用
concurrency控制同一workflow的并发 - 在部署脚本中实现简单的分布式锁(基于K8s ConfigMap或Redis)
- 使用ArgoCD的
syncOptions: Prune=true和ApplyOutOfSyncOnly=true避免全量同步
12.6 GitOps中的Secret管理
在GitOps模式中,所有配置都存在Git仓库中,但Secret不能明文存储。这是我们在实施过程中遇到的较大挑战。最终方案:
- 使用Sealed Secrets控制器:将Secret加密为SealedSecret,可安全存入Git
- ArgoCD部署SealedSecret后,控制器自动解密为K8s Secret
- 私钥定期轮换,通过
kubeseal重新加密 - 不同环境(Staging/Production)使用不同的私钥
十三、经验总结与最佳实践
13.1 CI/CD建设的六条黄金法则
回顾整个CI/CD建设过程,我总结了六条核心经验:
法则一:一切皆代码。从CI/CD配置到K8s清单,从部署脚本到环境配置,所有内容都以代码形式存在Git仓库中。这意味着每一次变更都有记录、可审查、可回滚。当你把基础设施当作代码来管理时,你就拥有了版本控制、代码审查、自动化测试等所有软件工程的最佳实践。
法则二:快速失败,快速恢复。流水线的每个阶段都应该有明确的失败条件和超时限制。失败不可怕,可怕的是失败后不知道为什么、不知道怎么恢复。预检查脚本、自动回滚机制、详细的错误通知,都是为了在失败发生时快速恢复。
法则三:环境一致性是基石。开发、测试、生产环境的一致性,是CI/CD能发挥作用的前提。Docker容器化解决了运行环境的一致性问题,而K8s提供了声明式的环境描述。同一个镜像在不同环境中运行,只是配置不同(通过ConfigMap/Secret注入),这从根源上消除了"在我机器上能跑"的问题。
法则四:渐进式推进,不要一步到位。CI/CD建设不是一蹴而就的。我们分了五个阶段推进,每个阶段都产出可验证的成果。如果一开始就想搞一套完美的大而全的方案,很可能在实施过程中遇到太多问题而停滞不前。先让最简单的流水线跑起来,再逐步增加测试、安全扫描、监控等环节。
法则五:自动化不是目的,价值才是。不是所有事情都值得自动化。在自动化之前,先问自己:这个操作的频率有多高?人工操作的成本和风险有多大?自动化的开发和维护成本是否值得?我们曾经试图自动化一个每季度才执行一次的数据库迁移,后来发现手动操作更灵活、更安全,就放弃了自动化。
法则六:安全左移。把安全检查融入CI/CD流水线的早期阶段,而不是等到部署前才检查。代码扫描(SonarQube)、依赖扫描、镜像扫描(Trivy)、配置审计(Polaris),这些安全检查都在CI阶段自动执行,将安全问题拦截在生产环境之前。
13.2 AI辅助DevOps的正确姿势
在这次实践中,Gemini作为AI辅助工具发挥了重要作用,但使用AI也有正确和错误的方式。以下是我的经验总结:
| 维度 | 正确用法 | 错误用法 |
|---|---|---|
| 配置生成 | 生成骨架,人工审核优化 | 直接使用未经审核的AI输出 |
| 问题排查 | 提供错误日志,请AI分析可能原因 | 完全依赖AI诊断,不自己思考 |
| 方案设计 | 请AI提供多个方案对比,人工决策 | 让AI直接做架构决策 |
| 代码审查 | 请AI审查安全/性能/最佳实践 | 用AI替代人工代码审查 |
| 文档编写 | AI生成初稿,人工补充业务上下文 | 直接使用AI生成的文档 |
| 学习新技术 | 用AI快速了解概貌,再深入官方文档 | 只看AI的解释,不读官方文档 |
13.3 给不同阶段团队的建议
不同规模的团队在CI/CD建设上面临不同的挑战,以下是基于我的经验给出的建议:
| 团队规模 | 当前阶段 | 建议优先级 | 推荐工具组合 | 预期收益 |
|---|---|---|---|---|
| 5人以下 | 手动部署 | GitHub Actions + Docker | GitHub Actions + Docker Hub | 部署时间从小时级到分钟级 |
| 5-15人 | 基础CI/CD | 容器化 + K8s + 监控 | Actions + ACR + K8s + Prometheus | 环境一致性和可观测性 |
| 15-50人 | 有CI/CD但不够完善 | GitOps + 安全扫描 + HPA | Actions + ArgoCD + Trivy + Sealed Secrets | 全自动部署和安全左移 |
| 50人以上 | 多团队协作 | 多集群管理 + 灰度发布 + 混沌工程 | ArgoCD + Argo Rollouts + Chaos Mesh | 渐进式发布和高可用保证 |
十四、未来展望:AI + DevOps的无限可能
这次CI/CD改造只是AI辅助DevOps的一个起点。在改造过程中,我看到了更多AI可以发挥价值的场景:
14.1 AI驱动的智能运维(AIOps)
当监控数据足够丰富时,AI可以做更多:
- 异常检测:基于历史数据自动识别异常模式,比静态阈值告警更精准
- 根因分析:当多个告警同时触发时,AI可以关联分析,快速定位根因
- 容量规划:基于历史趋势预测未来资源需求,提前扩容
- 自动修复:对于已知模式的故障,AI可以自动执行修复脚本
14.2 AI辅助代码质量提升
除了SonarQube的静态分析,AI可以做更深层次的代码审查:
- 识别潜在的并发安全问题
- 检测资源泄漏风险(未关闭的连接、流)
- 分析代码的测试覆盖盲区
- 提供重构建议和设计模式优化
14.3 自然语言驱动的DevOps
想象一下这样的场景:运维同学在钉钉群里输入"把payment-service回滚到昨天的版本",AI自动理解意图,查询部署历史,执行回滚操作,并反馈结果。这不是科幻——基于大语言模型的理解能力和DevOps工具链的API能力,这种交互方式完全可行。我们团队正在探索这条路径,已经有了初步的原型。
14.4 灰度发布与渐进式交付
在CI/CD流水线成熟后,我们开始探索更高级的发布策略——灰度发布。传统的滚动更新虽然能实现零停机,但它是"全量替换"——所有用户都会同时访问新版本。如果新版本有问题,影响的是全部用户。灰度发布则允许我们逐步将流量从旧版本切换到新版本,在发现问题时可以快速止损。
我们对比了三种灰度发布方案:
| 方案 | 原理 | 流量控制粒度 | 实现复杂度 | 回滚速度 | 适用场景 |
|---|---|---|---|---|---|
| K8s原生滚动更新 | 逐步替换Pod | Pod级别(无流量比例控制) | 低 | 快(kubectl undo) | 常规发布 |
| Argo Rollouts | 通过Deployment替代品控制 | 百分比流量(5%/20%/50%/100%) | 中 | 极快(一键回滚) | 重要功能发布 |
| Istio服务网格 | 通过流量路由规则控制 | 精确到Header/Cookie/权重 | 高 | 快(修改路由规则) | A/B测试、金丝雀发布 |
我们选择了Argo Rollouts,它在实现复杂度和功能之间取得了较好的平衡。以下是一个Argo Rollouts的配置示例,我同样借助Gemini完成了初始版本的编写:
# k8s/manifests/rollout.yaml
apiVersion: argoproj.io/v1alpha1
kind: Rollout
metadata:
  name: payment-service
  namespace: production
spec:
  replicas: 5
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      app: payment-service
  template:
    metadata:
      labels:
        app: payment-service
    spec:
      containers:
        - name: payment-service
          image: registry.cn-hangzhou.aliyuncs.com/myteam/payment-service:latest
          ports:
            - containerPort: 8080
          resources:
            requests:
              cpu: "250m"
              memory: "512Mi"
            limits:
              cpu: "1000m"
              memory: "1536Mi"
  strategy:
    canary:
      # 金丝雀发布策略
      canaryService: payment-service-canary    # 金丝雀流量Service
      stableService: payment-service-stable     # 稳定版流量Service
      trafficRouting:
        nginx:
          stableIngress: payment-service-ingress  # 稳定版Ingress
      steps:
        # 第1步:5%流量到新版本,持续观察5分钟
        - setWeight: 5
        - pause: { duration: 5m }

        # 第2步:20%流量,观察10分钟
        - setWeight: 20
        - pause: { duration: 10m }

        # 第3步:50%流量,观察10分钟
        - setWeight: 50
        - pause: { duration: 10m }

        # 第4步:手动确认后全量发布
        - setWeight: 100
        - pause: {}  # 手动确认

      # 自动回滚条件
      analysis:
        templates:
          - templateName: success-rate
        args:
          - name: service-name
            value: payment-service
---
# 分析模板:监控成功率,低于阈值自动回滚
apiVersion: argoproj.io/v1alpha1
kind: AnalysisTemplate
metadata:
  name: success-rate
  namespace: production
spec:
  args:
    - name: service-name
  metrics:
    - name: success-rate
      interval: 1m
      # 从Prometheus查询成功率
      successCondition: result[0] >= 0.95
      failureLimit: 3  # 连续3次低于阈值则回滚
      provider:
        prometheus:
          address: http://prometheus.monitoring:9090
          query: |
            sum(rate(http_server_requests_seconds_count{
              kubernetes_pod_name=~"{{args.service-name}}.*",
              status!~"5.."
            }[2m])) /
            sum(rate(http_server_requests_seconds_count{
              kubernetes_pod_name=~"{{args.service-name}}.*"
}[2m]))这个灰度发布配置实现了自动化的渐进式交付:新版本先接收5%的流量,持续5分钟;如果成功率正常,逐步增加到20%、50%;最后需要人工确认才全量发布。在任何一个阶段,如果Prometheus检测到成功率低于95%且连续3次,Argo Rollouts会自动中止发布并回滚到稳定版本。
这套灰度发布机制上线后,我们经历了两次"自动止损"——新版本在5%流量阶段就被检测到错误率偏高,自动回滚,影响范围控制在极小比例的用户中。如果没有这套机制,这两次发布很可能导致全量用户受影响,又是凌晨回滚的灾难。
十五、写在最后
从3小时到8分钟,这不仅仅是数字的变化,更是研发文化的转变。当部署不再是负担而是日常操作时,团队的精力可以从"怎么把代码部署上去"转移到"怎么把代码写得更好",这才是CI/CD和自动化最大的价值。
回顾这段历程,我深刻体会到几件事。第一,技术方案的选型没有银弹,GitHub Actions + ArgoCD的组合对我们团队是最佳选择,但每个团队的场景不同,Jenkins、GitLab CI或者Tekton都可能是更好的选择,关键在于理解自己的约束条件和核心诉求。第二,自动化建设是一个持续的过程,而不是一个项目。我们的流水线至今仍在不断迭代,每个月都有新的优化项——可能是加速构建、可能是增加一个安全检查步骤、可能是优化通知格式。第三,AI工具的价值不在于替代人,而在于放大人的能力。Gemini帮我省去了大量查阅文档和编写样板代码的时间,但关键的架构决策、安全审查和性能调优,仍然需要工程师的专业判断。
我还想强调一点:CI/CD建设不仅是技术问题,更是组织和协作问题。在推广自动化部署的过程中,最大的阻力不是技术难度,而是习惯的改变。开发同学习惯了"提交代码后等运维部署"的模式,对于"自己PR合并后就自动部署"感到不适应;运维同学担心自动化会导致自己"失去价值"。解决这些问题需要的不是技术方案,而是沟通、培训和渐进式的文化转变。我们花了不少时间做内部技术分享,让每个同学都理解流水线的工作原理和自己在其中的角色,这比写代码本身更重要。
Gemini在这个过程中扮演了加速器的角色。它不是替代工程师,而是让工程师更快地从0到1,把精力集中在从1到100的优化上。正如我在文中反复强调的:AI是副驾驶,不是自动驾驶。真正驾驭CI/CD的,永远是有经验、有判断力的工程师。AI能帮你生成一份看起来不错的YAML配置,但它不会告诉你这份配置是否适合你的业务场景、是否满足你的合规要求、是否与你的监控体系契合。这些判断需要人来做。
如果你也在经历部署的痛苦,或者正在探索AI辅助DevOps的路径,希望这篇文章能给你一些启发。CI/CD建设是一场马拉松,不是百米冲刺。一步一个脚印,每个阶段都产出可验证的成果,你终将到达终点。不要追求一步到位的完美方案,先让最简单的流水线跑起来,哪怕只是自动跑一下单元测试,也比手动操作强。然后在实践中不断迭代,每次改进一点点,积累起来就是质的飞跃。
最后,分享一句我在这次改造中最深刻的感悟:好的工程实践不是用最先进的技术解决最复杂的问题,而是用最合适的方式让复杂的问题变得简单。CI/CD如此,AI辅助编程亦如此。技术是手段,不是目的。当你纠结于某个工具的选型或某个参数的调优时,退一步想想:这个选择是否真的为团队和业务带来了价值?答案如果是肯定的,就大胆去做;如果犹豫,说明可能还没有想清楚,再想一想也不迟。
在这篇文章中,我从凌晨三点的部署噩梦讲起,完整记录了从手动部署到全自动化流水线的转型过程。我们经历了GitHub Actions工作流的设计、Docker镜像的容器化改造、Shell自动化脚本体系的搭建、Kubernetes部署清单的编写、ArgoCD的GitOps配置、数据库迁移的自动化、灰度发布策略的落地,以及整个过程中遇到的种种坑和解决方案。每一个环节都有真实的代码、真实的耗时数据和真实的经验教训。如果其中哪怕一个配置片段、一条避坑建议能帮到你,这篇文章的目的就达到了。
如果你觉得这篇文章对你有帮助,欢迎点赞、收藏和关注。也欢迎在评论区分享你的CI/CD实战经验。
推荐阅读:

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 3
 0
- 0


 已为社区贡献22条内容

所有评论(0)