代码库感知索引系统:为 AI 编码工作流提供精准上下文
1 导言
AI编码工具需理解开发的代码库并提供建议。但大多系统依赖通用嵌入 API 索引代码片段和文档,导致嵌入虽能捕获文本相似性,却忽略结构关系;索引每几分钟才刷新,开发无法获得最新上下文。
代码库感知索引系统,将代码向量、代码图谱和预构建的代码库知识相结合,为 AI 编码工作流程提供准确、安全且实时的上下文。
2 通用代码搜索的挑战
2.1 延迟和过时上下文
传统检索流程依赖外部 API 计算嵌入,并用远程向量数据库搜索相似的代码片段。这些流程的更新间隔长达数分钟;当开发人员切换分支或重命名函数时,索引会出现滞后并返回不相关的上下文。即使索引已更新,大型代码库也会产生大量嵌入,传输和查询这些数据会引入明显延迟。
2.2 缺乏结构感知能力
嵌入向量是衡量文本相似性,但代码库查询需理解结构关系和架构设计:
- 调用点与其函数定义之间可能几乎没有词法重叠
- 文档可能使用代码中不存在的术语
- 同一算法的跨语言实现看起来可能完全不同
仅依赖嵌入向量会漏这些关系和设计知识,导致结果不相关浪费提示空间。
3 混合检索架构
3.1 服务器端向量搜索
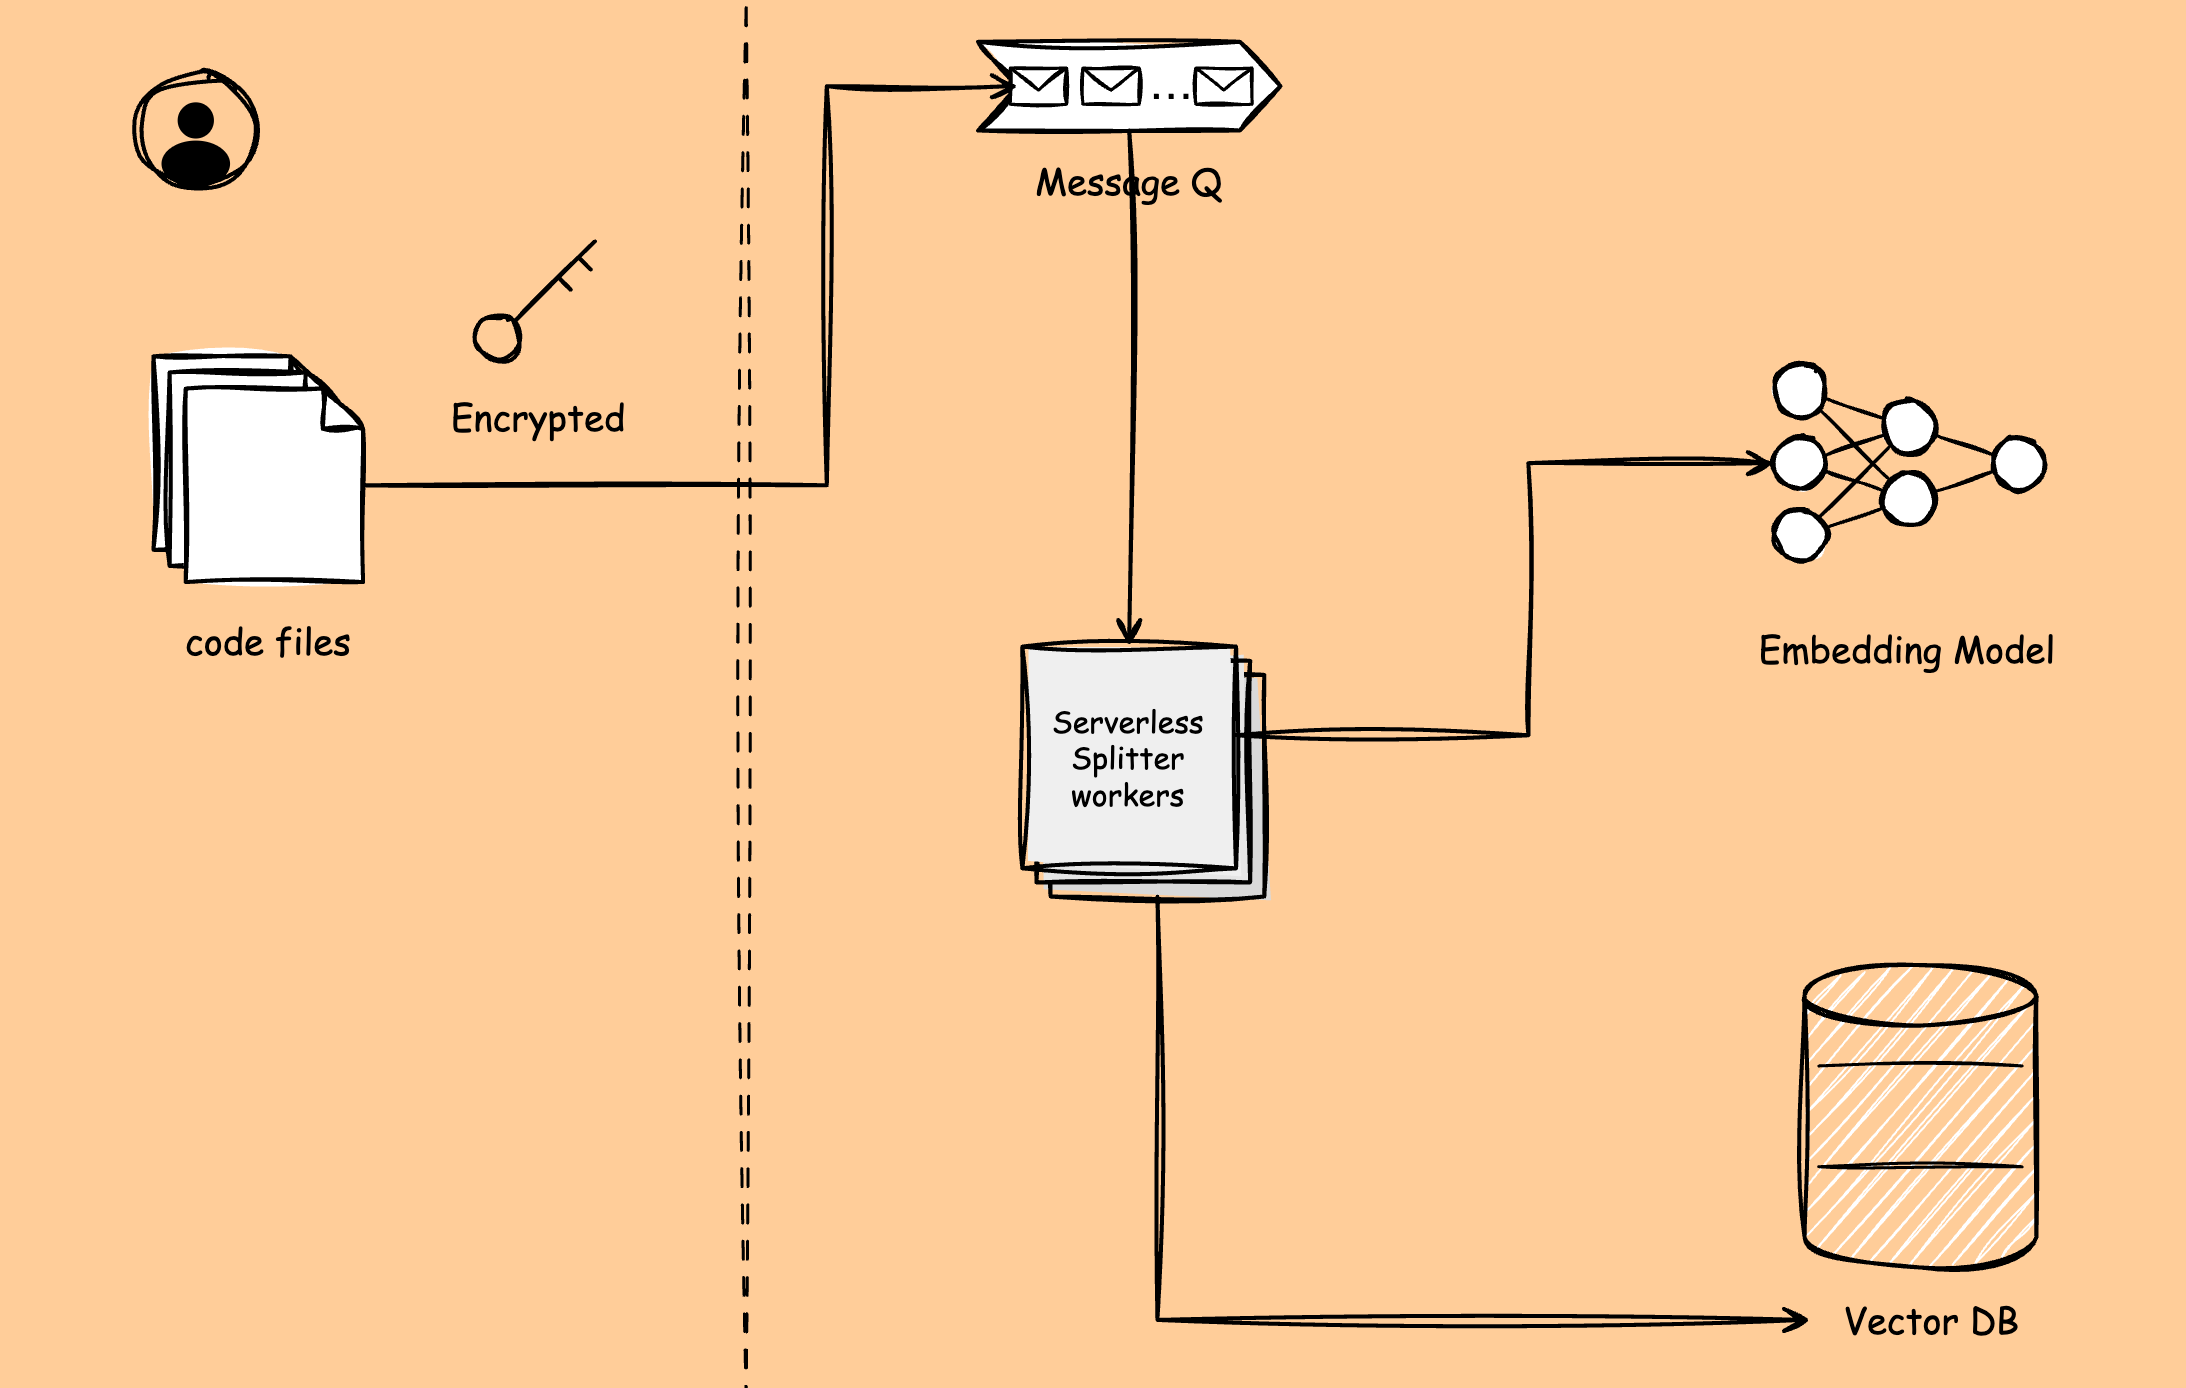
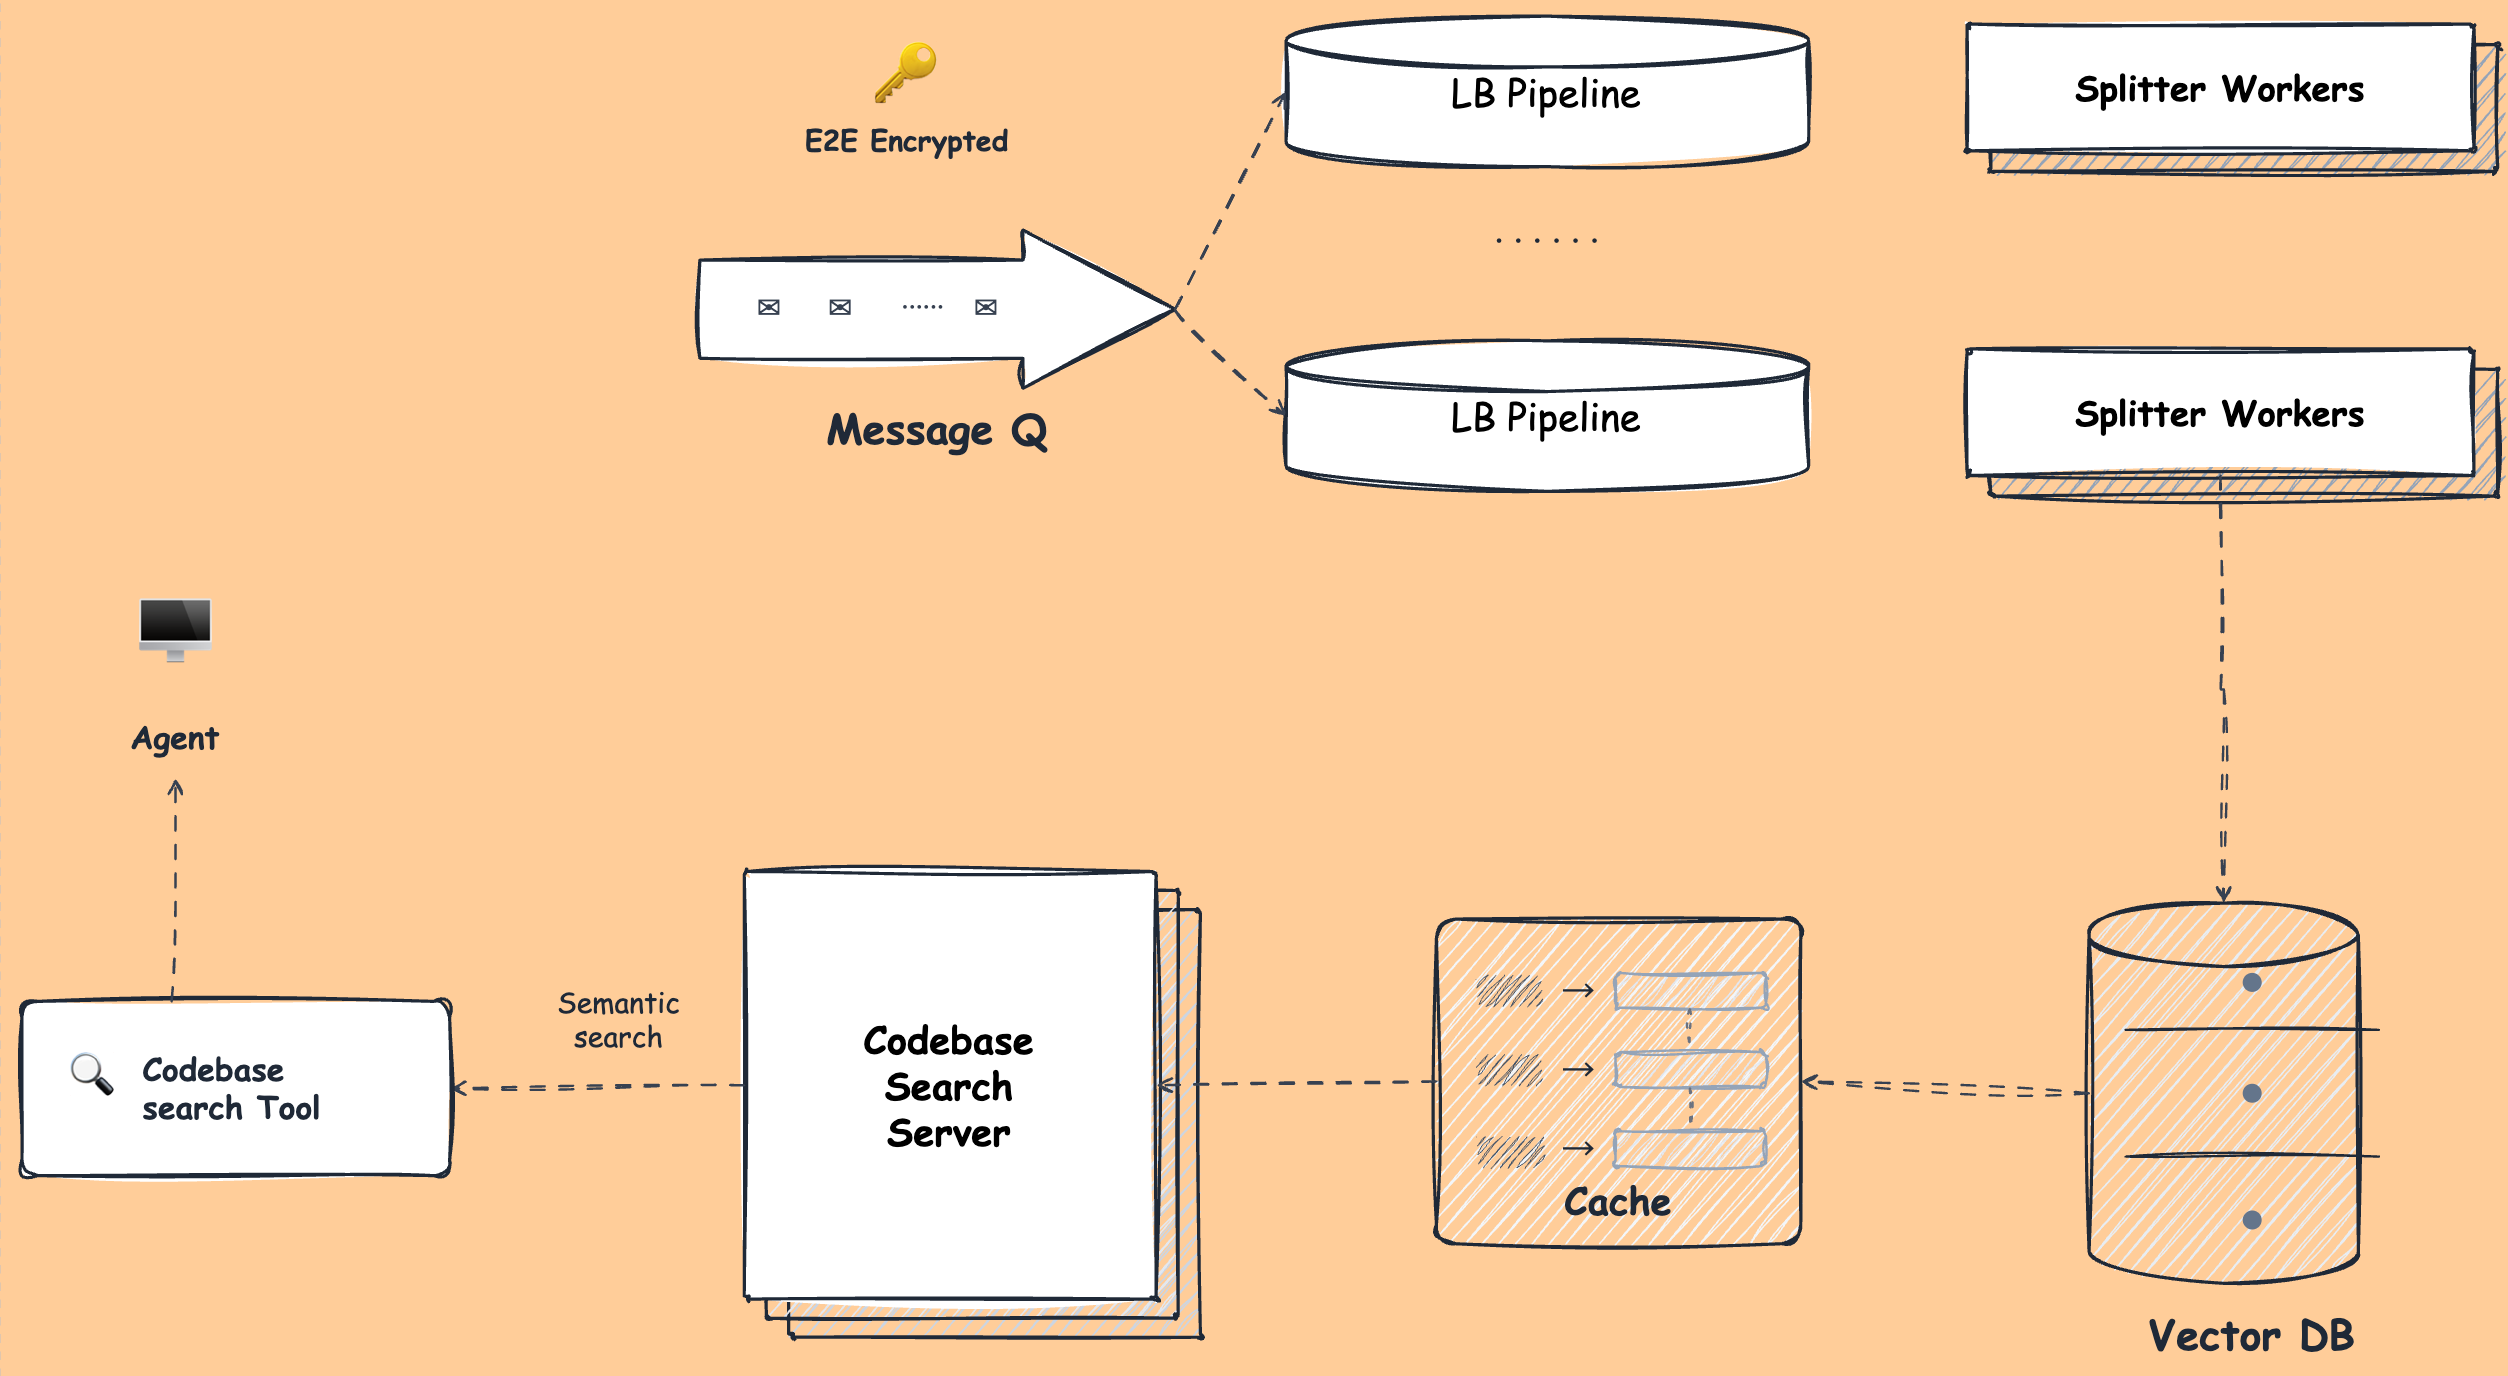
服务端部署了高性能向量索引服务,存储代码片段及文档的向量数据。代码和领域知识上训练的专属 AI 模型,生成的向量能更好捕获语义关系,而不仅是表面相似性。服务器能高效处理索引请求,几秒内完成新增或修改文件的索引。
向量搜索架构图:
3.2 代码图谱和代码库知识
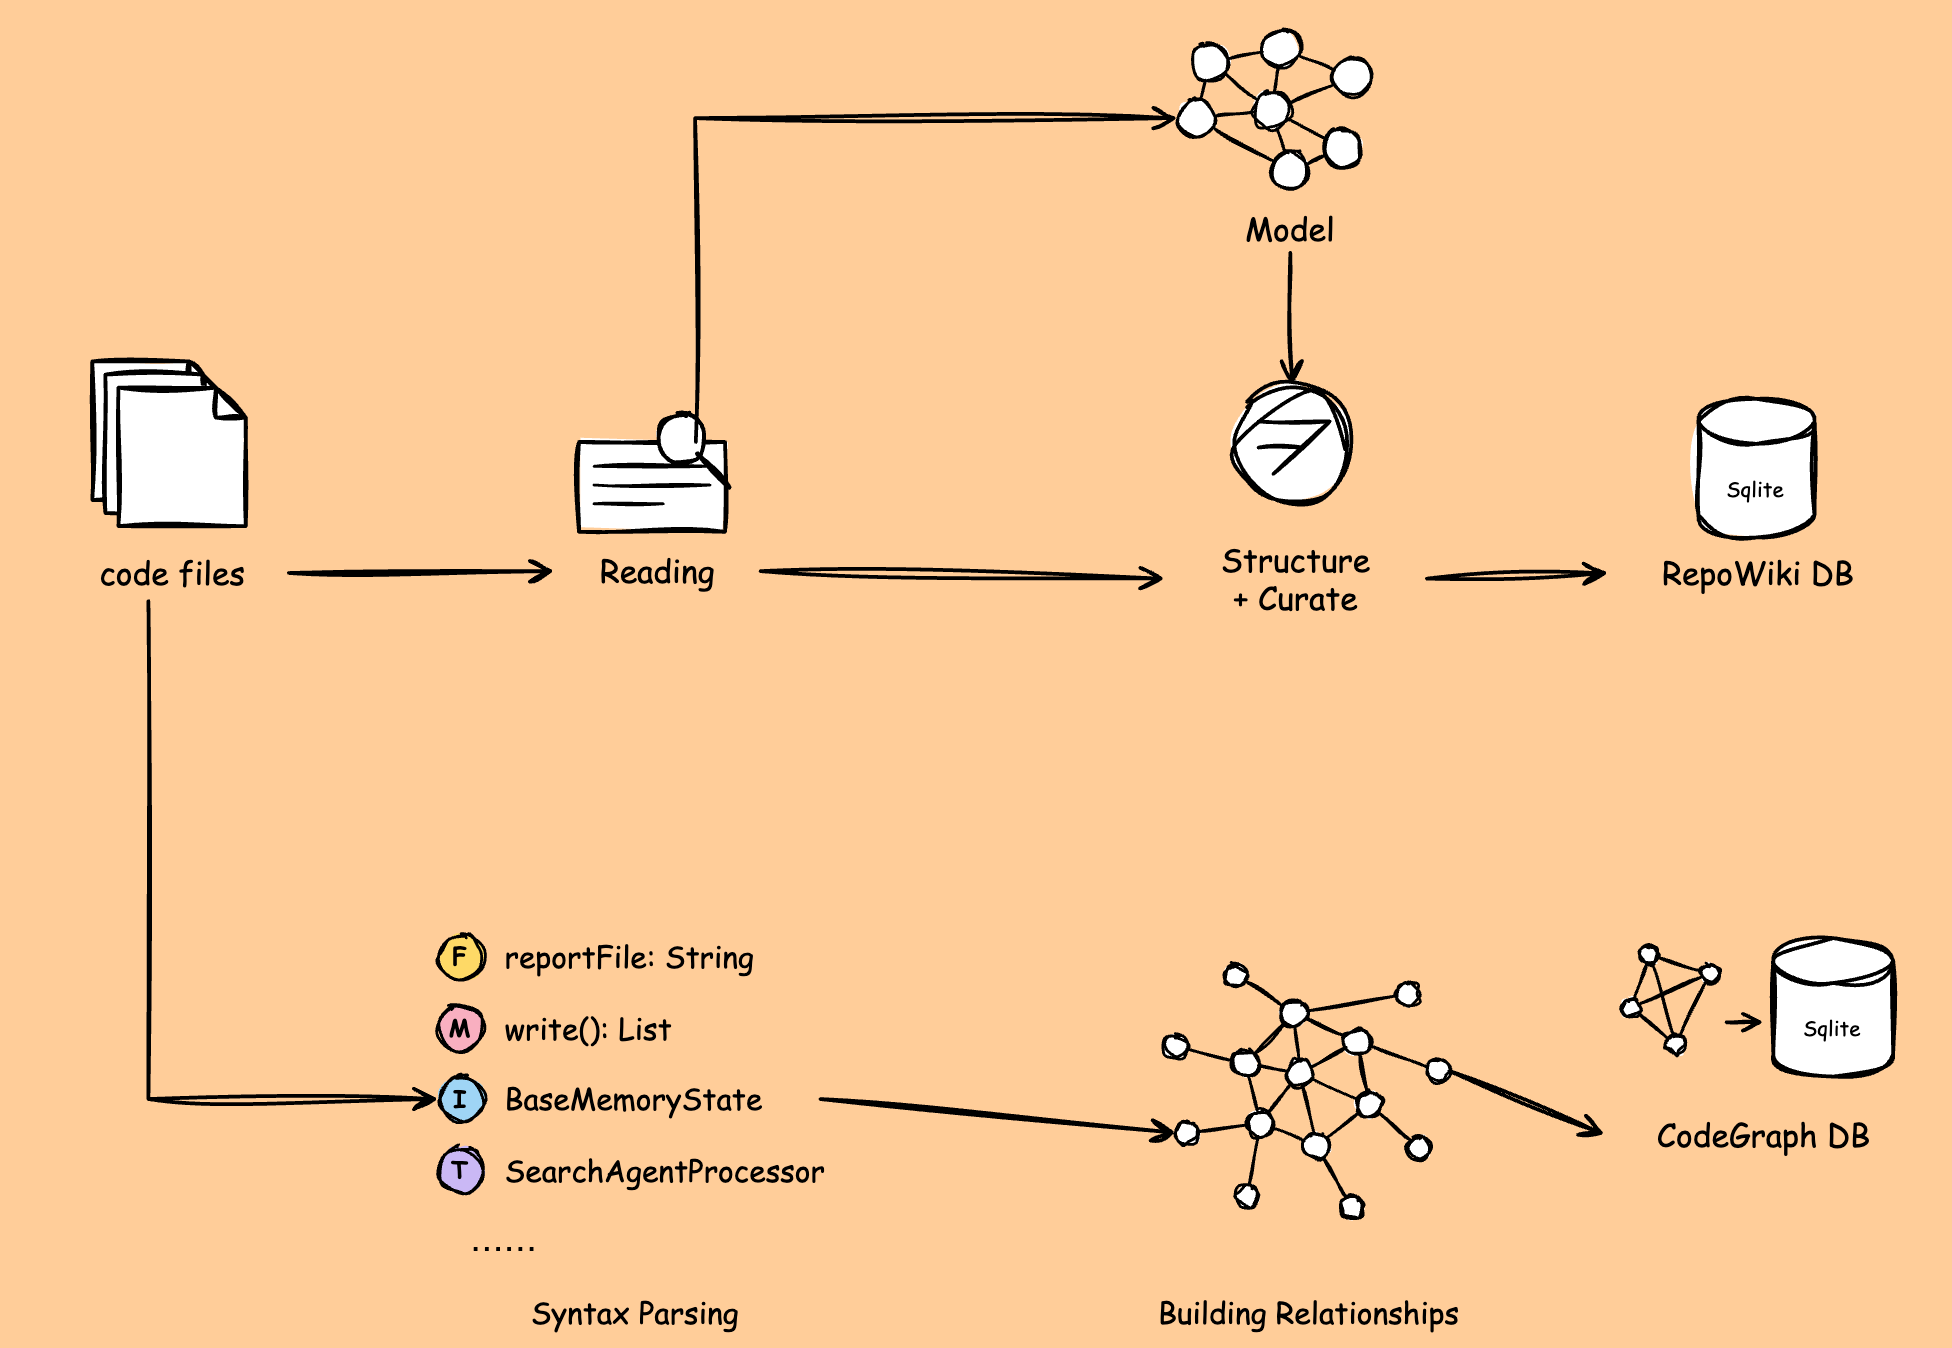
- 客户端构建代码图谱表示函数、类、模块及之间关系(如调用图、继承关系、跨语言链接)。能实现超低延迟查询代码符号关系
- 通过Repo Wiki生成代码库知识。Repo Wiki能更快找到代码库隐性知识
代码图谱示意图
向量搜索 && 图谱检索
用户查询(通过聊天、智能体任务)时,系统执行:
- 使用专属模型计算查询的嵌入向量
- 执行向量搜索,检索前 N 个相似的代码段
- 利用代码图谱基于结构关系扩展或优化候选结果(例如,包括调用检索到的代码片段的函数,或引用它的文档)
- 利用 Repo Wiki 查询相关的功能设计知识及其相关文件
- 综合相似性得分、基于图谱的相关性、Repo Wiki 的知识信息,对最终结果进行排序
这混合方法确保相关但文本不同的代码(如调用点引用的函数定义)能与语义相似的代码段一起出现。使系统将检索结果与开发人员的当前分支和本地更改保持一致。
4 实时更新和个性化
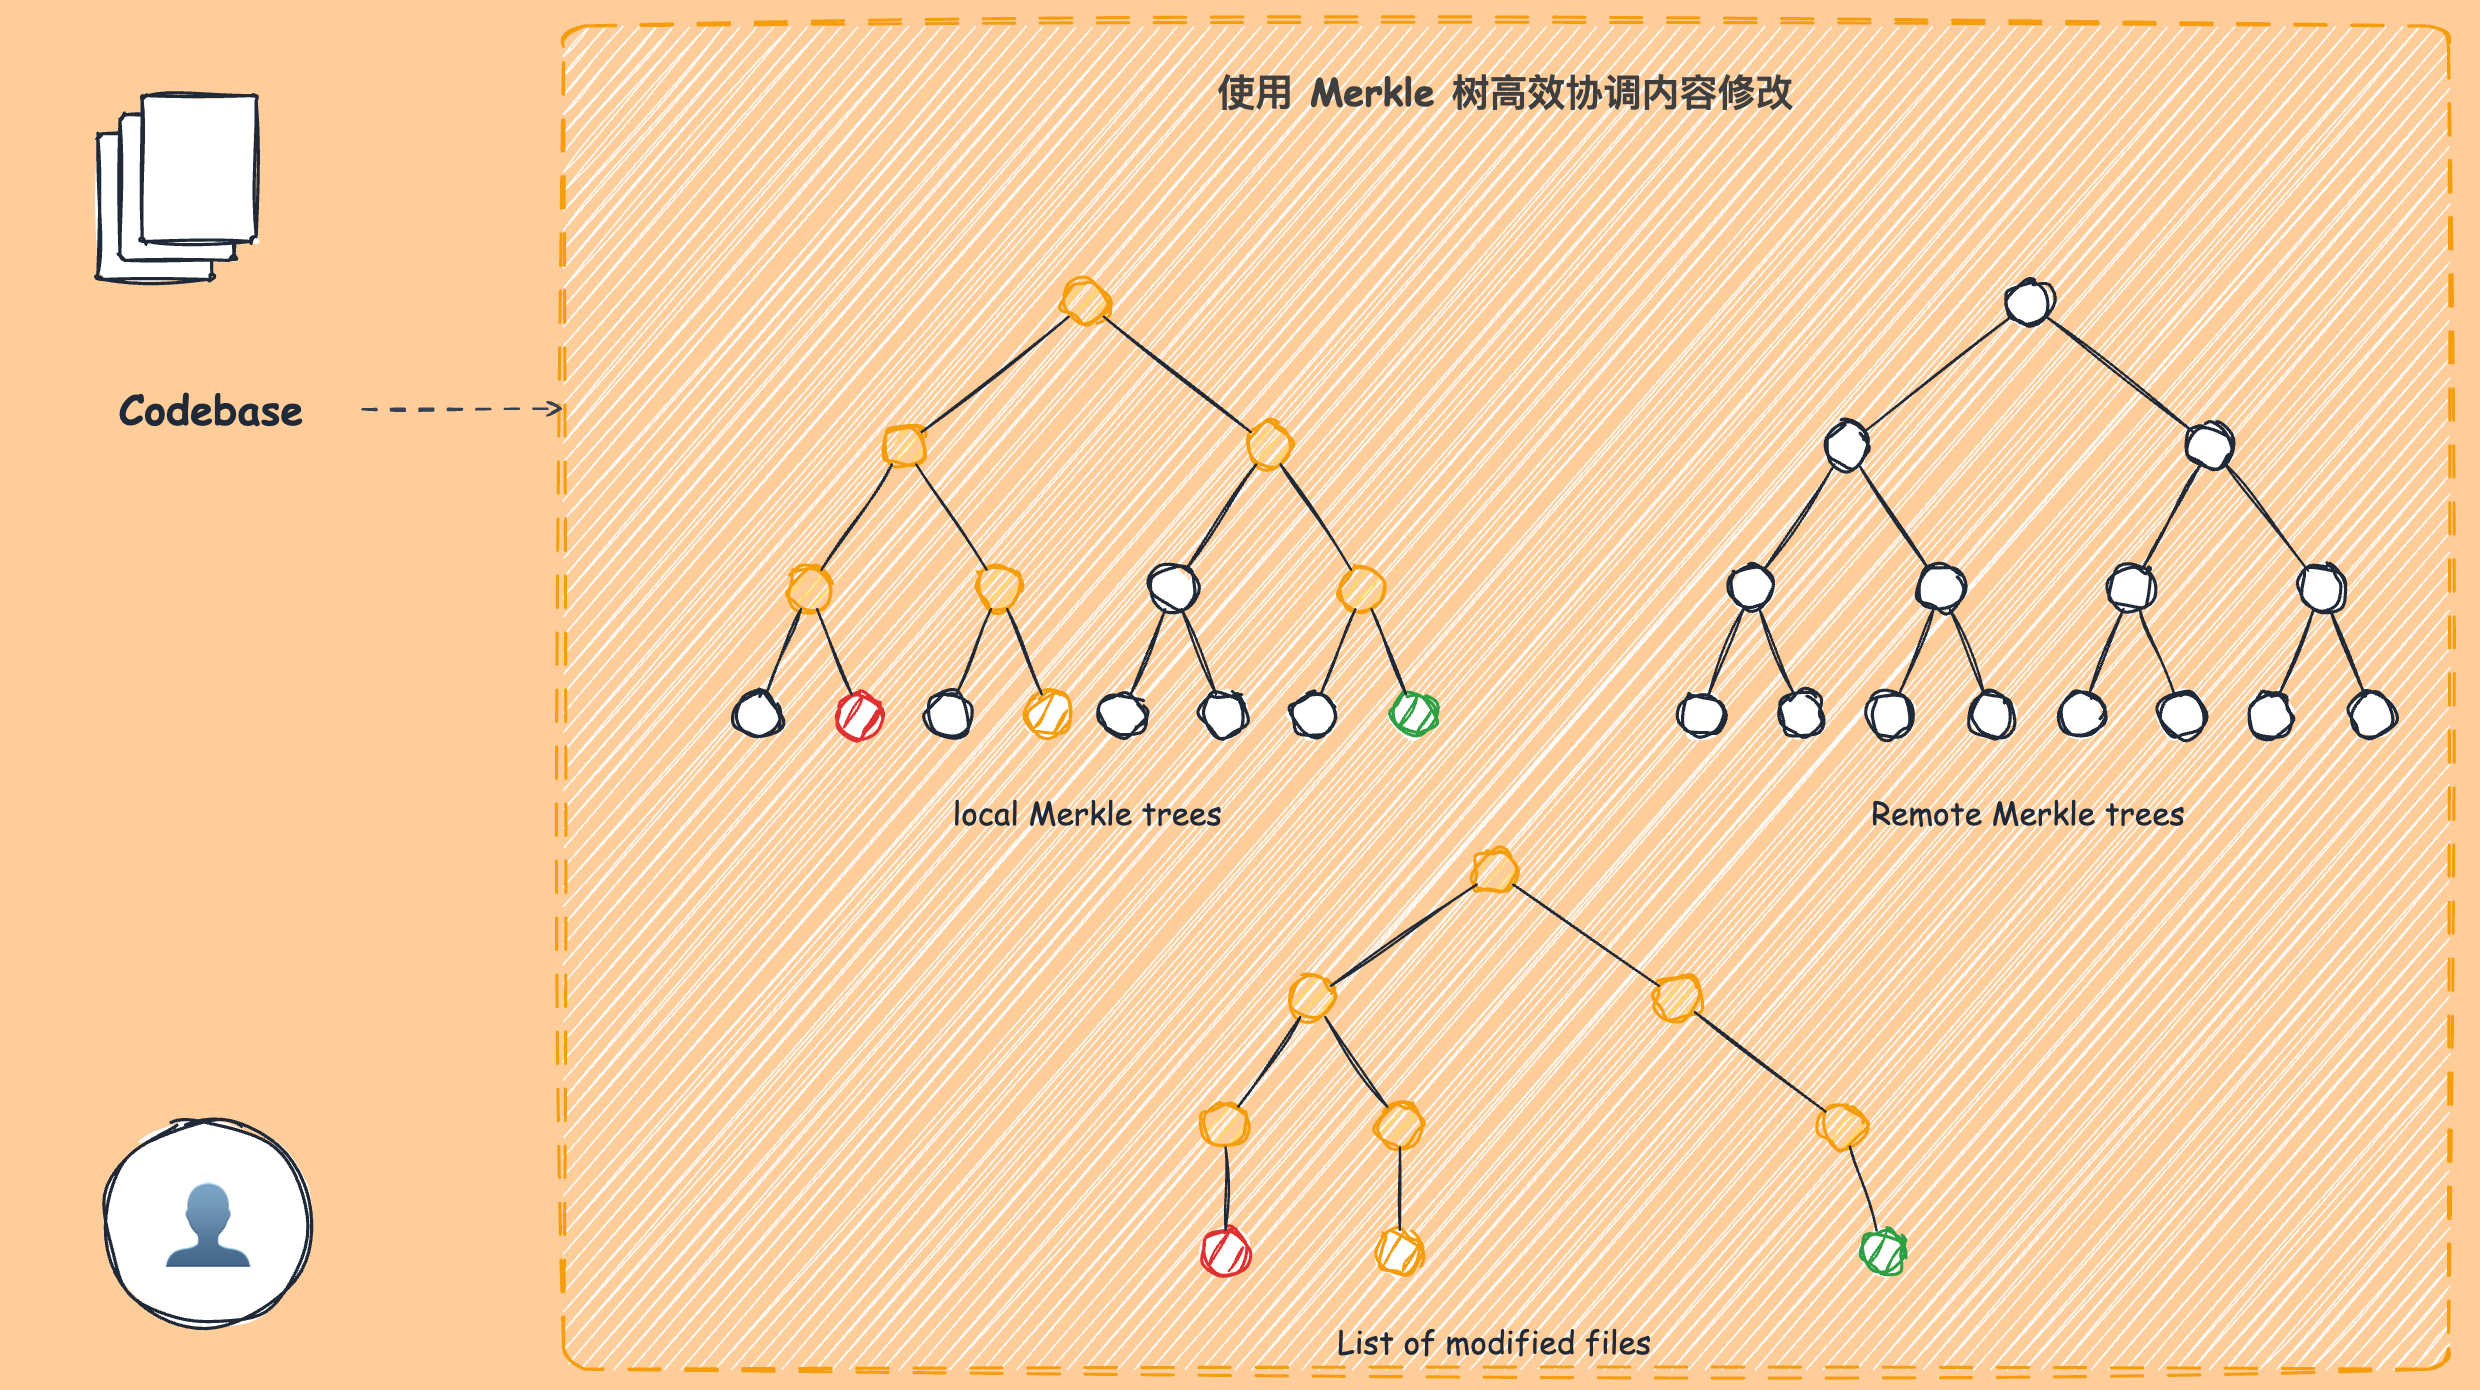
每个开发都有与其当前工作状态相关的个人索引。当你切换分支、编辑文件或执行批量替换操作时,客户端会将更改通知服务器,服务器随即在几秒钟内更新相应的嵌入向量,代码图谱也会同步更新。这种实时同步机制确保建议始终反映代码库的最新状态。
实时更新流程图:
5 性能
系统每秒处理数千个文件,支持水平扩展适应大型代码仓库。
客户端通过缓存代码图谱避免冗余计算,批量更新机制则防止网络拥塞。
6 安全
不存储原始代码内容,只存储其对应的嵌入向量(一组数值表示)。检索任何代码段之前,客户端须通过发送加密哈希来证明拥有文件内容,确保只有授权用户才能访问代码。嵌入在传输和存储时均被加密。
7 应用场景
复杂代码库导航
在大型 Monorepo 中工作时,AI需了解服务如何与下游组件交互。得益于代码图谱和 Repo Wiki,Agent能够理解整个代码库——不仅搜索具有相似名称的定义,还能找到与该函数相关的调用链、配置文件和设计文档。
故障响应和调试
故障发生时,你需快速识别受故障组件影响的所有代码路径。这混合检索系统就能呈现相关代码模块、测试用例和运维手册(Runbook),比通用搜索更快完成问题分析和诊断。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 0
 0
- 0


 已为社区贡献34条内容

所有评论(0)