【无标题】项目拆解(二):模型输出是‘野‘的——三层兜底+重分析,把AI变成可靠零件
项目拆解(二):模型输出是"野"的——三层兜底+重分析,把AI变成可靠零件
研发效能智能助手 · 第 2 个项目第 2 篇 | 上篇拆架构,这篇拆容错
上一篇把 AI 代码归档系统的骨架拆完了:FastAPI 四层结构、裸调 Ollama、Prompt 设计、SQLite 归档。评论区很多人在问同一个问题:“你那个模型返回的 JSON 要是坏了怎么办?模型崩了怎么办?”
问得好。这才是 AI 工程和调 API 玩具的分水岭。
这篇就把系统里最"见功夫"的部分全拆开:错误兜底的三层设计 + 重分析机制。所有代码都是项目里真实跑着的,每个坑都是真机踩出来的。
一、先说透:大模型是系统里最不可靠的零件
做传统后端的人有个习惯:相信自己的代码。写 json.loads 就觉得一定会成功,调接口就觉得一定会返回。
做 AI 工程,第一课就是把这种自信戒掉。大模型有三大"野":
- 会挂:Ollama 没启动、显存不够、机器卡死、请求超时
- 会疯:让它输出 JSON,它给你
json ...包起来,或者直接输出一句"好的,我来分析一下:" - 会骗:字段该是数组给你字符串,该是数字给你"五十",该有风险给你空
任何一个"野"没兜住,用户看到的就是白屏、报错、或者更糟——假结果。
所以这个系统从设计第一天就定了规矩:大模型只负责"提内容",工程负责"保可靠"。围绕一次分析,三层兜底,层层设卡。
二、错误全景图:一次分析要过四道鬼门关
用户点一下"让 AI 分析并存档",背后是这样的链路:
前端点击 → POST /api/analyze → 拼Prompt → 调Ollama → 解析JSON → 校验字段 → 入库 → 渲染上屏
每一段都可能挂。我们把故障点全部列出来,逐个设计对策:
| 环节 | 会挂成什么样 | 兜底层级 |
|---|---|---|
| 调 Ollama | 连不上 / 超时 / HTTP 500 | 第一层:调用层 |
| JSON 解析 | 多字了 / 用代码块包了 / 结构不对 | 第二层:解析层 |
| 字段校验 | 类型错 / 缺字段 | 第二层:解析层 |
| 前端渲染 | 空数组 / 带空格空串 / 空指针 | 第三层:展示层 |
下面一层一层拆。
三、第一层兜底:调用层,把技术错误翻译成人话
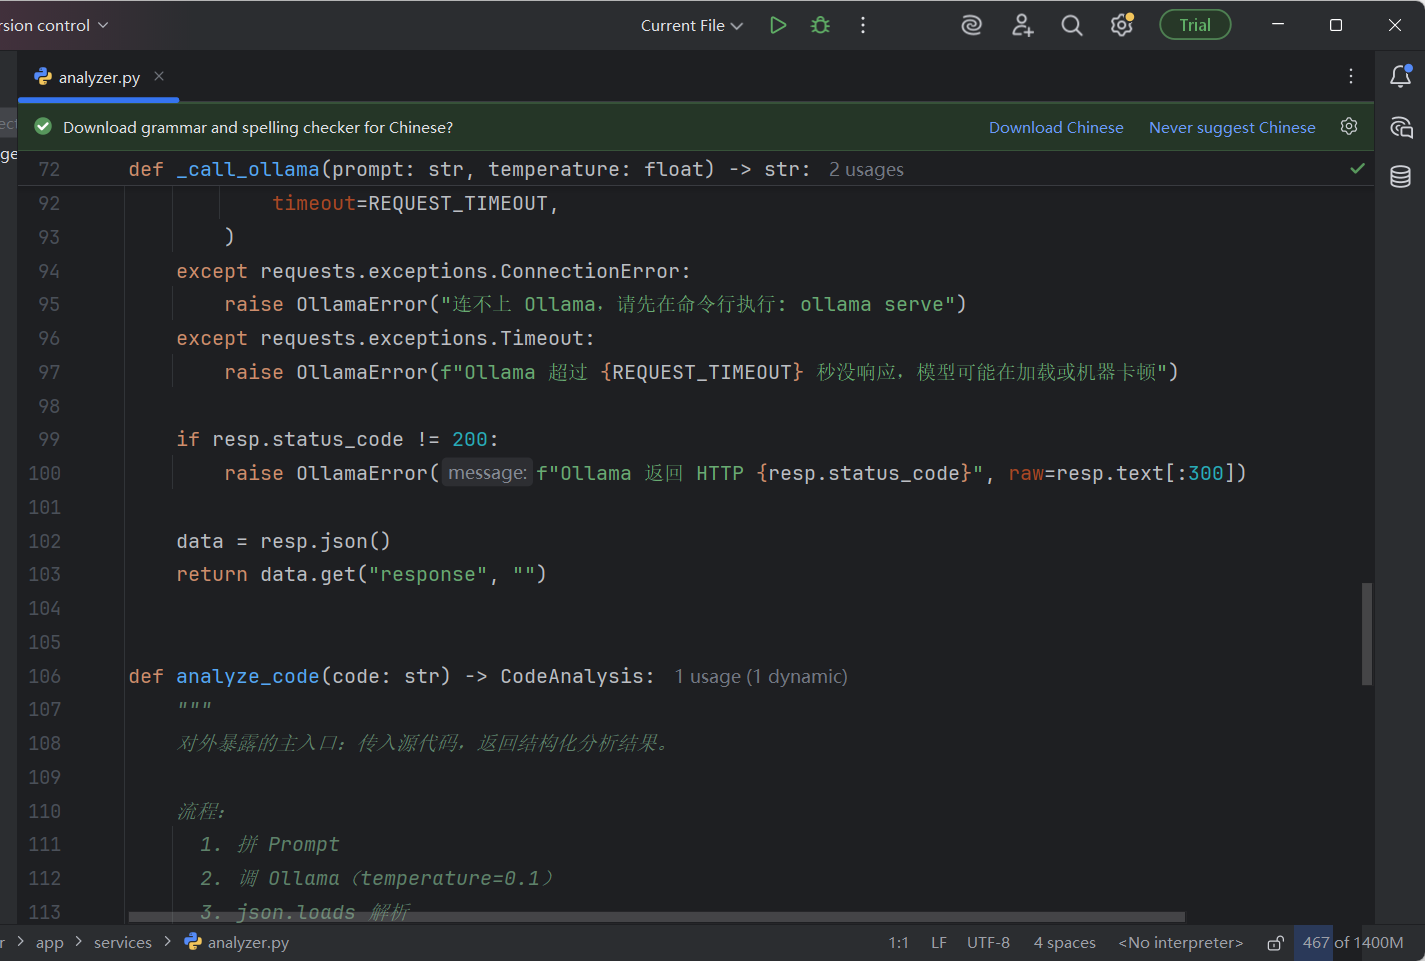
直接看代码(图1是 analyzer.py 的异常处理):
try:
    resp = requests.post(
        f"{OLLAMA_BASE_URL}/api/generate",
        json=payload,
        timeout=REQUEST_TIMEOUT,   # 120秒,7b首次加载要冷启动
    )
except requests.exceptions.ConnectionError:
    raise OllamaError("连不上 Ollama,请先在命令行执行: ollama serve")
except requests.exceptions.Timeout:
    raise OllamaError(f"Ollama 超过 {REQUEST_TIMEOUT} 秒没响应,模型可能在加载或机器卡顿")

if resp.status_code != 200:
    raise OllamaError(f"Ollama 返回 HTTP {resp.status_code}", raw=resp.text[:300])
三个设计细节,面试都能讲:
1. 超时给 120 秒,不是随便拍的。 7b 模型在 4GB 显存上首次加载要冷启动,第一次请求慢得离谱。120 秒是实测出来的上限,后面改成了"真实倒计时"给用户看(见第五层),用户就不焦虑了。
2. 异常翻译成"人话"。 ConnectionError 对用户没有意义,但"连不上 Ollama,请先在命令行执行 ollama serve"是可执行的指令。AI 工程的产品化,就是让错误提示可行动。
3. 业务异常要带原始报文。 OllamaError 里存了 raw=resp.text[:300]——前端只看到一句中文,但日志里能查到模型到底返回了什么。排查问题全靠这个尾巴。
这里有个反直觉的设计:底层异常一律翻译成业务异常抛出去,不在调用层 try 到底。翻译是职责,抛出是态度——路由层统一捕获,转成 502,前端统一渲染。错误处理最忌讳"每层都 try 一下,最后用户看到一脸懵"。
四、第二层兜底:解析层,JSON 坏了先别慌,降噪重试一次
第一层兜住了"调不通",但模型可能调通了却胡说八道。format=json 只是让 Ollama 用 JSON schema 解码,不保证 7b 一定输出合法 JSON。实测它会干这些事:
- 在 JSON 外面包 ```````json ````代码块
- 输出"好的,我分析如下:"再跟 JSON
- 字段名改了(
language写成Language) - 直接整个 JSON 语法错误
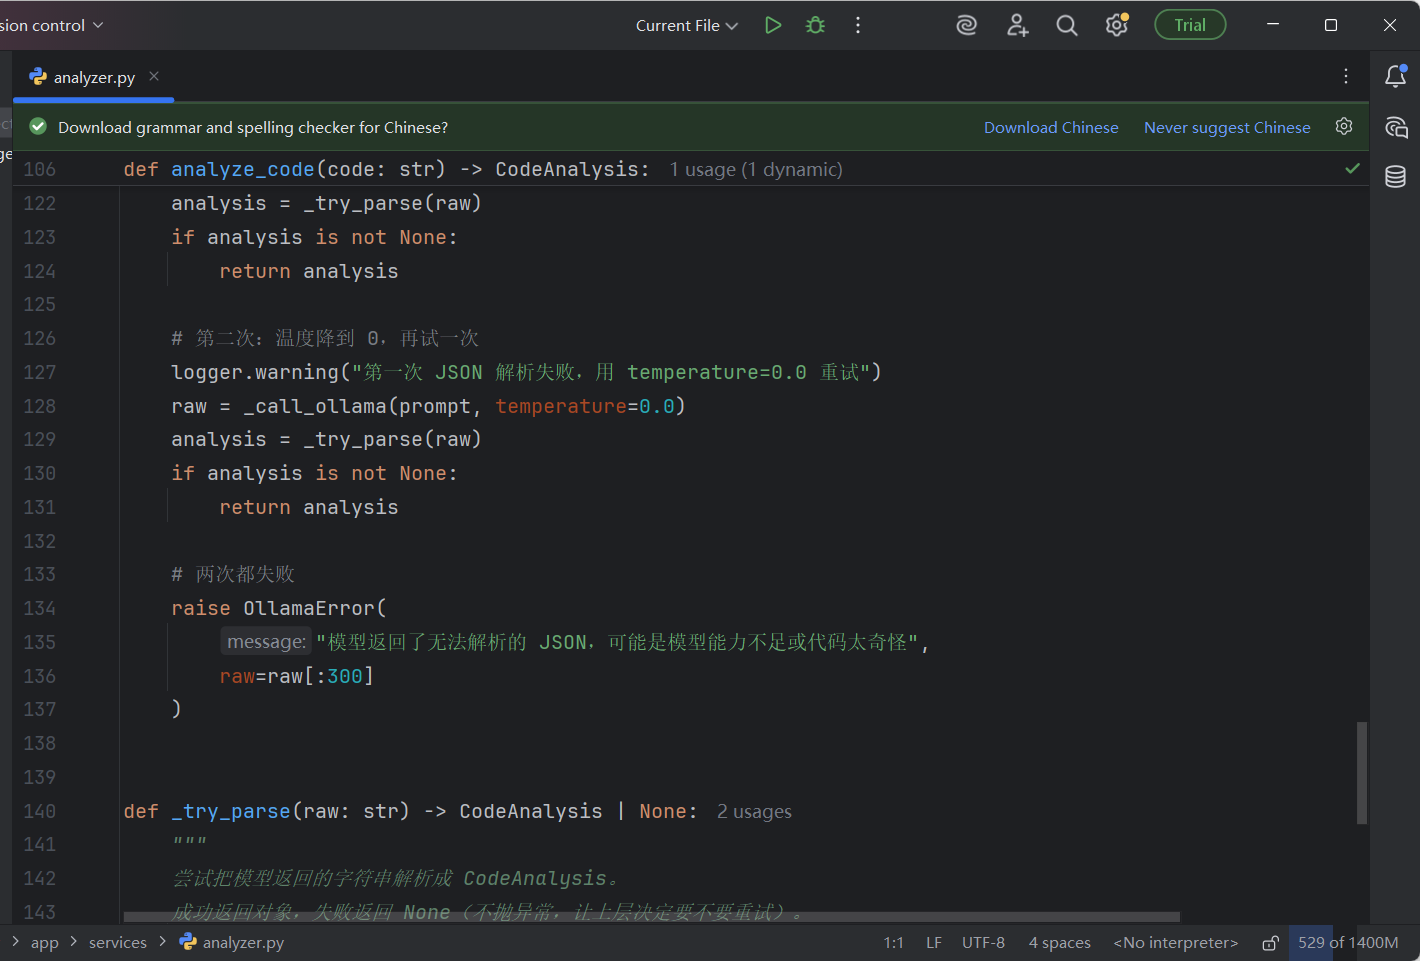
解析层设计(图2是完整重试机制):
# 第一次:正常温度,先试
raw = _call_ollama(prompt, temperature=0.1)
analysis = _try_parse(raw)
if analysis is not None:
    return analysis

# 第二次:温度降到 0,再试一次
logger.warning("第一次 JSON 解析失败,用 temperature=0.0 重试")
raw = _call_ollama(prompt, temperature=0.0)
analysis = _try_parse(raw)
if analysis is not None:
    return analysis

# 两次都失败,才认输
raise OllamaError("模型返回了无法解析的 JSON,可能是模型能力不足或代码太奇怪", raw=raw[:300])
核心逻辑是 _try_parse——解析失败返回 None 而不是抛异常,让上层决定要不要重试:
def _try_parse(raw: str) -> CodeAnalysis | None:
    raw = raw.strip()
    # 防御:有些模型还是会用 ```json ... ```包一下,剥掉
    if raw.startswith("```"):
        raw = raw.strip("`")
        if raw.lower().startswith("json"):
            raw = raw[4:].strip()
    try:
        data = json.loads(raw)
        return CodeAnalysis(**data)
    except (json.JSONDecodeError, ValueError) as e:
        logger.warning("JSON 解析失败: %s; 原文前200字: %s", e, raw[:200])
        return None
三个关键点:
1. 先剥代码块再解析。 7b 实测经常用 ```````json ````包输出——这是它训练语料的习惯。strip("")+ 去json` 字样,一次剥干净。这层防御让"输出格式不完美"从失败变成成功。
2. 重试时温度降到 0.0。 第一次用 0.1 是想让模型"活一点"别太机械,但解析失败说明它已经疯了一次,重试就必须把随机性压到最低——temperature=0.0 让输出退化成确定性,通常第二次就老实了。实测重试成功率挺高,用户几乎感觉不到这次重试。
3. 两次失败才认输,且带上原文。 不无限重试(浪费算力、拖死用户体验),两次是实测出来的平衡点。认输时把 raw[:300] 塞进异常——开发者看到"模型返回了无法解析的 JSON"能立刻去日志翻原文,而不是瞎猜。
五、第三层兜底:展示层,模型输出的最后一道清洗
前两层都过了,数据入库了,最后一步是上屏。但这里还有坑——模型在"无风险"时会返回什么?
真机实测:它返回了 [""],甚至 [" "](带空格的空串)。前端直接渲染,用户看到一个红色的空警告框,吓一跳。
修复代码(index.html 里真实跑着的):
(a.risks||[]).map(t=>t&&t.trim()).filter(Boolean).length
  ? a.risks.map(t=>`<span class="risk">${esc(t)}</span>`).join("")
  : '<span style="color:#34c759;">无,这段代码挺干净</span>'
注意细节:先 t.trim() 再 filter(Boolean)。只 filter(Boolean) 挡不住 [" "](带空格的字符串是真值),必须先清空格再过滤。这是真机踩出来的:第一次只写了 filter(Boolean),第二天用户截图说"为什么没有风险还弹红框",一查是 [" "]。
同一行的另一个细节:空的时候显示绿字"无,这段代码挺干净"。空数组不展示空容器,而是展示"无风险"的正面反馈——这种小细节决定了产品是"能用"还是"好用"。
六、展示层的另一个细节:真实倒计时,不骗用户
用户点了"分析",本地 7b 要跑 10-30 秒。进度条要不要?不要——因为我们自己都不知道还要多久,预估个假进度条,用户一眼看穿更糟。
方案是真实计时器(index.html):
const startTs = Date.now();
let timer = setInterval(() => {
  const sec = Math.round((Date.now() - startTs) / 1000);
  $("result").innerHTML = `AI 分析中... 已用时 ${sec} 秒(本地 7b 模型稍慢,请稍候)`;
}, 1000);
每秒更新"已用时 X 秒"——数字是真实流逝的时间,不是拍脑袋的预估。用户体验:知道系统没死,知道大概要多久。同时分析期间按钮禁用($("btn").disabled = true),防止用户手滑重复提交把 Ollama 打爆。结果一到,finally 里停计时器、恢复按钮。
小功能,但"等待"是所有 AI 产品最容易被吐槽的环节,值得较真。
七、重分析机制:一个"不覆盖"的设计取舍
系统里有已归档的片段。用户经常想:“这段代码当时分析漏了个风险,能不能重新分析?” 这就是重分析需求。
最初的设计方案是"原地覆盖":重分析 → 更新同一条记录。但细想有两个问题:
- 历史被抹掉了。如果新分析反而更差(小模型不稳定),旧结果找不回来
- 无迹可循。看不到"上次怎么判的、这次怎么判的",没法对比模型进步
所以最终做了**“回填式重分析”**:点击列表里的片段 → 右侧展示结果 + 左侧自动回填代码 → 用户改不改都行 → 再点"让 AI 分析并存档" → 生成一条新记录。
交互上它就像"基于旧代码再分析一次",但数据上每次都留痕。旧记录还在列表里,新分析也入库了,两个结果摆在一起天然可对比。等以后模型换大版本,还能批量重跑一遍旧片段,看模型进步了多少——这是"覆盖式"永远给不了的价值。
顺手一提:点击回填这个动作还顺带实现了"查看详情"(点列表 → 右侧显示完整分析),一个交互两种用途,前端一行 onclick="showDetail(id)" 就搞定。
八、真机实测:这些错误场景,你迟早会遇到
最后交个底,这个系统在 4GB 显存 / 16GB 内存的机器上跑出来的真实错误场景:
| 场景 | 现象 | 兜底结果 |
|---|---|---|
| Ollama 没启动就点分析 | ConnectionError | 中文提示"连不上 Ollama,请先执行 ollama serve" |
| 模型首次加载冷启动 | 请求挂起很久 | 120 秒超时兜底,前端真实倒计时安抚 |
| 模型输出被 ```json 包裹 | json.loads 失败 | 剥代码块后解析成功,用户无感知 |
| 模型输出非法 JSON | 第一次解析失败 | temperature=0.0 重试成功,用户无感知 |
| 连续两次都失败 | 重试也失败 | 抛"无法解析的 JSON"+原文前300字进日志 |
无风险时返回 [" "] | 前端渲染空红框 | trim+filter(Boolean) 清洗,显示"无风险"绿字 |
你看,真正的 AI 工程能力,全在这些"用户无感知"的兜底里。用户只看到"结果出来了"或"一句人话报错",背后是三层设计在默默干活。
九、总结:兜底设计三条原则
- 每个不可靠点都必须有失败路径。从调用到解析到渲染,逐个列出故障点,逐个设计兜底,没有"反正不会坏"的侥幸
- 错误必须可读、可行动。技术异常翻译成人话,人话里带执行指令
- 兜底要可观测。重试要打日志、异常要带原文、结果要留痕——出了问题能在日志里还原全程
把这三条做到,你就把"调大模型的 Demo"升级成了"AI 工程"。
这套系统的完整源码(含开发文档、全部注释、可直接运行)在这里:
👉 下载源码:AI代码片段智能归档系统-FastAPI+Ollama本地大模型-完整源码
📦 资源地址:https://download.csdn.net/download/weixin_54679968/93681154
系列第三篇预告:Prompt 工程实战——怎么让 7b 小模型稳定输出 60%-70% 准确率(防照抄、防误报、边界认知全复盘)。关注不迷路。
关键词:FastAPI、Ollama、Qwen2.5、本地大模型、错误兜底、JSON容错、重试机制、Prompt 工程、Java+Python

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐


 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)