风电场风力发电机数据集10203张:YOLO26 训练实录
YOLO26算法风电场风力发电机目标检测+训练好的模型+10203张数据集+pyqt可视化界面
先把数据交代清楚:10203 张图,训练集 9717 张,验证集 486 张,测试集 0 张。标签同时给了 YOLO 格式,data.yaml 不用改就能起训。文章分四段:目录与配置、类别分布、训练参数、导出部署,命令和配置都以代码块给出,照着复制即可。
1. 数据集概况
- 检测类别(中文):[风力发电机(Wind Turbine v9 2022 12 08 1 43am)]
- 训练集:9717 张
- 验证集:486 张
- 测试集:0 张
- 总计:10203 张
该数据集聚焦于风电场场景中风力发电机的精准识别与定位,旨在为风力发电设施的自动化巡检、运行状态监测及故障预警提供高质量视觉基础。数据采集覆盖多种典型工况下的风力发电机局部与整体视图,包括叶片特写、塔筒结构、机舱顶部及远景全景,具有高度的工程实用价值。…
模型与数据获取
训练好的 YOLO26 模型 + pyqt 可视化工程 + 数据集完整压缩包:下载页面
或关注“小郭AI日志”后下载
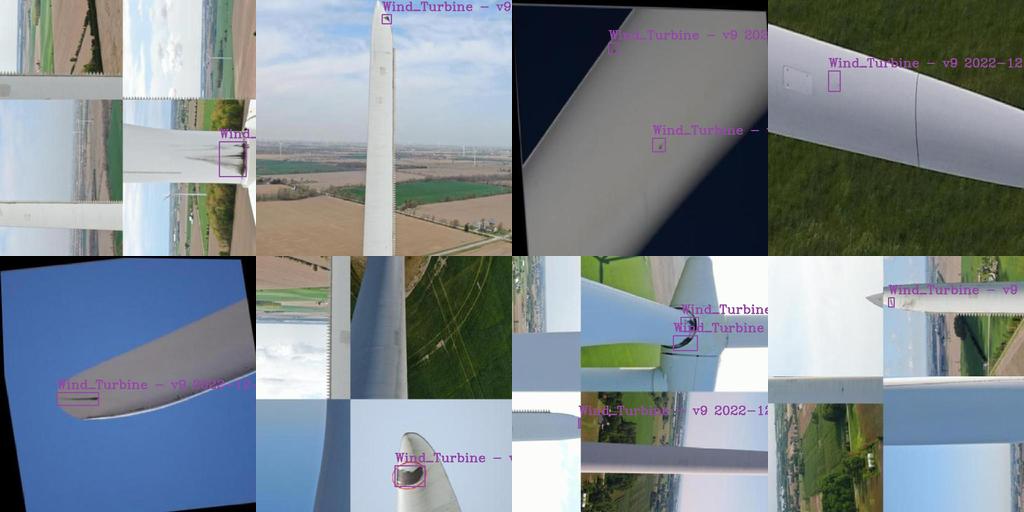
2. 训练曲线与评估图
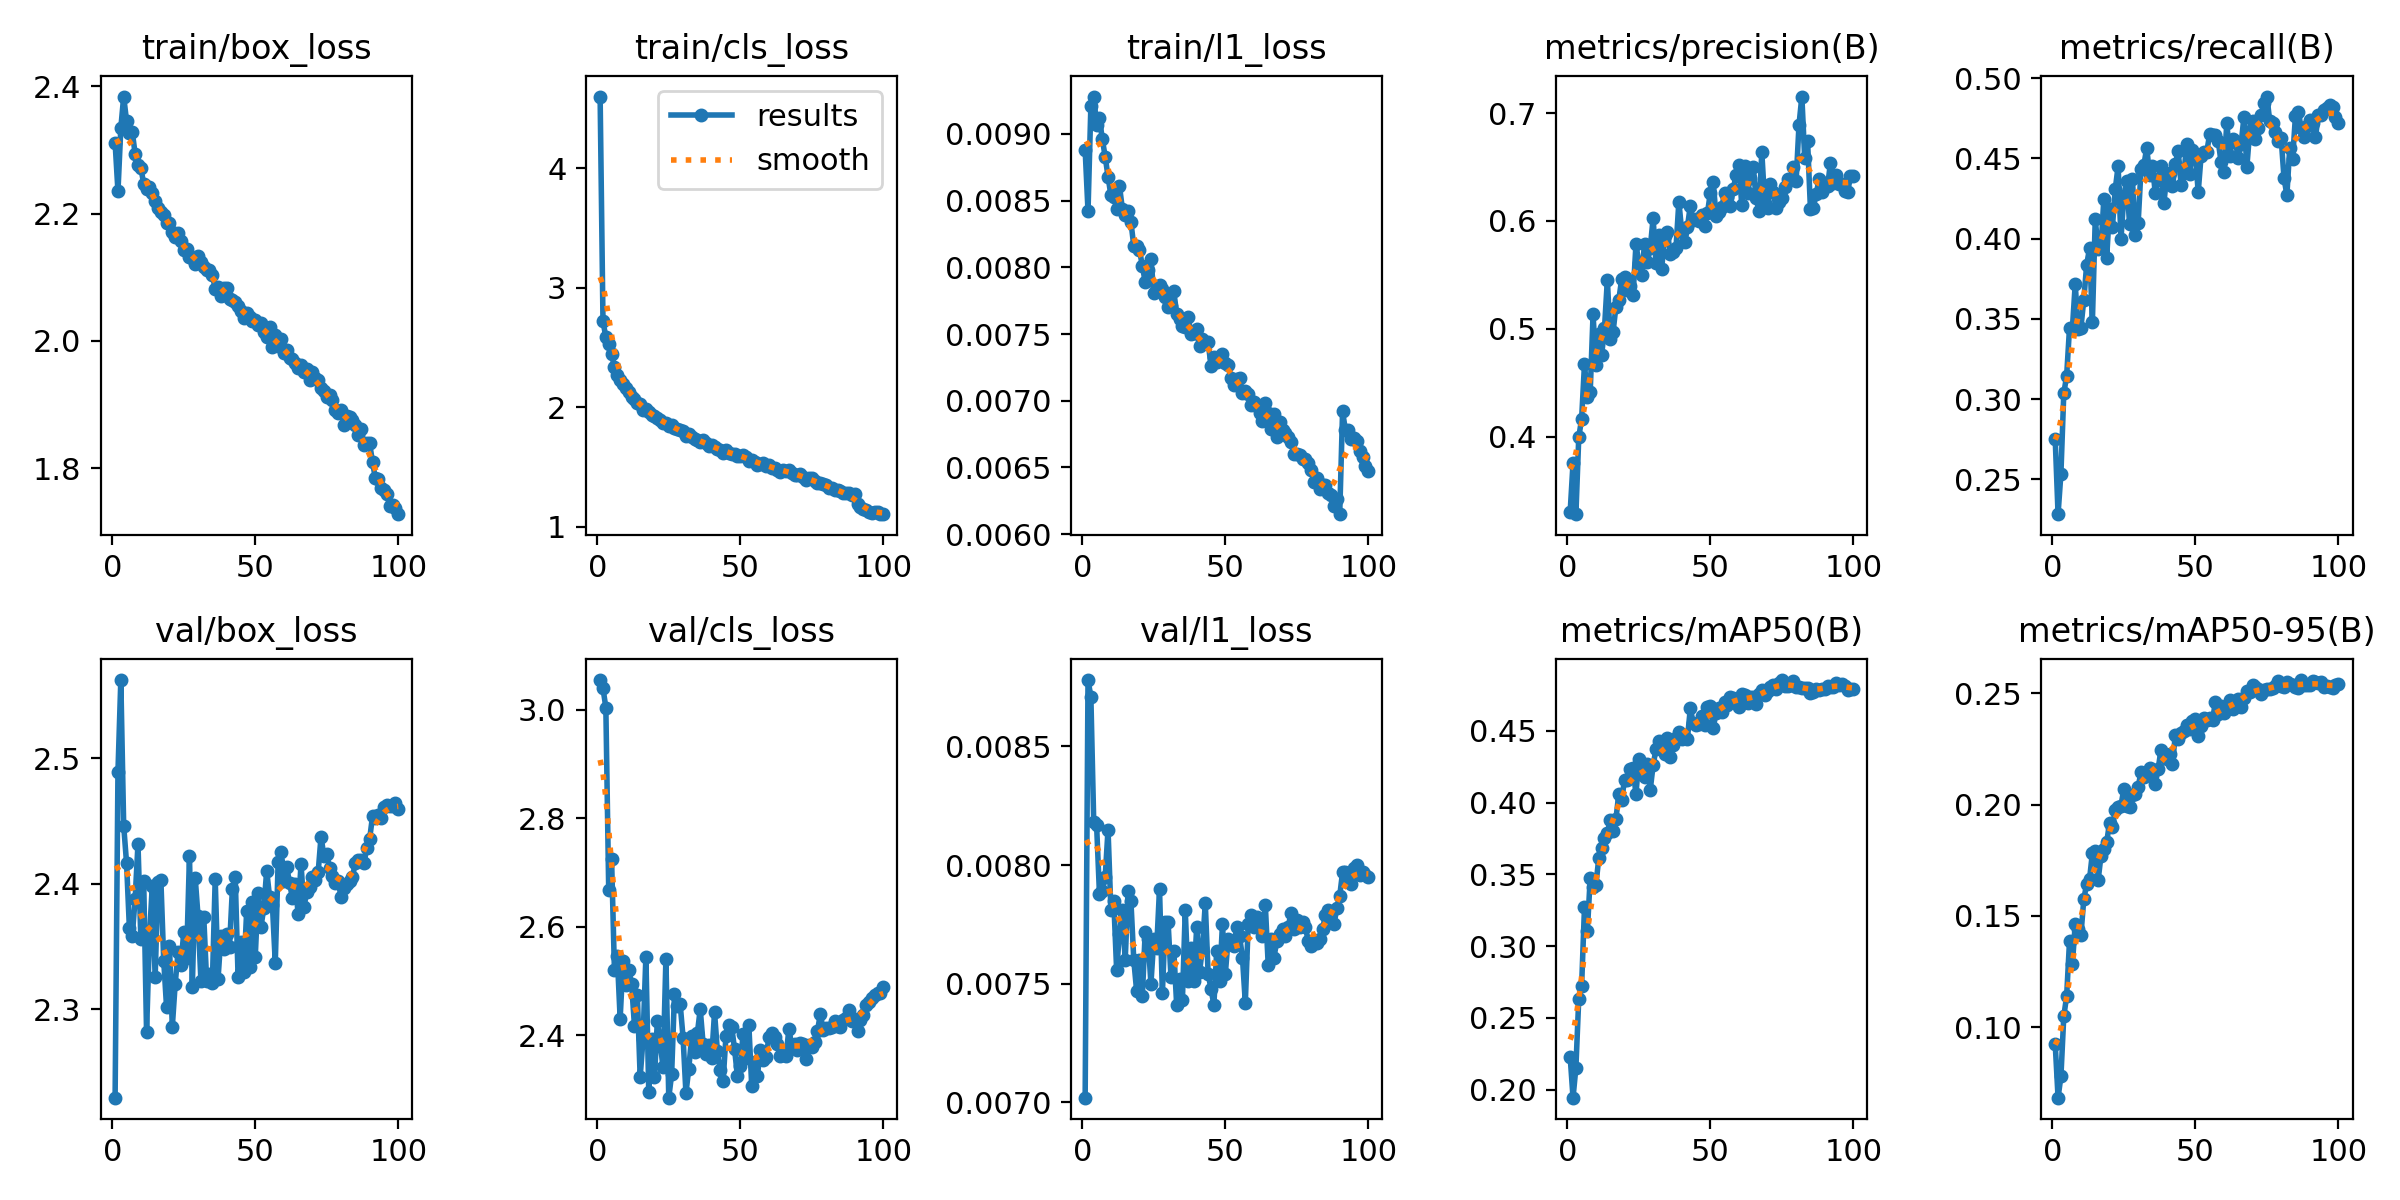
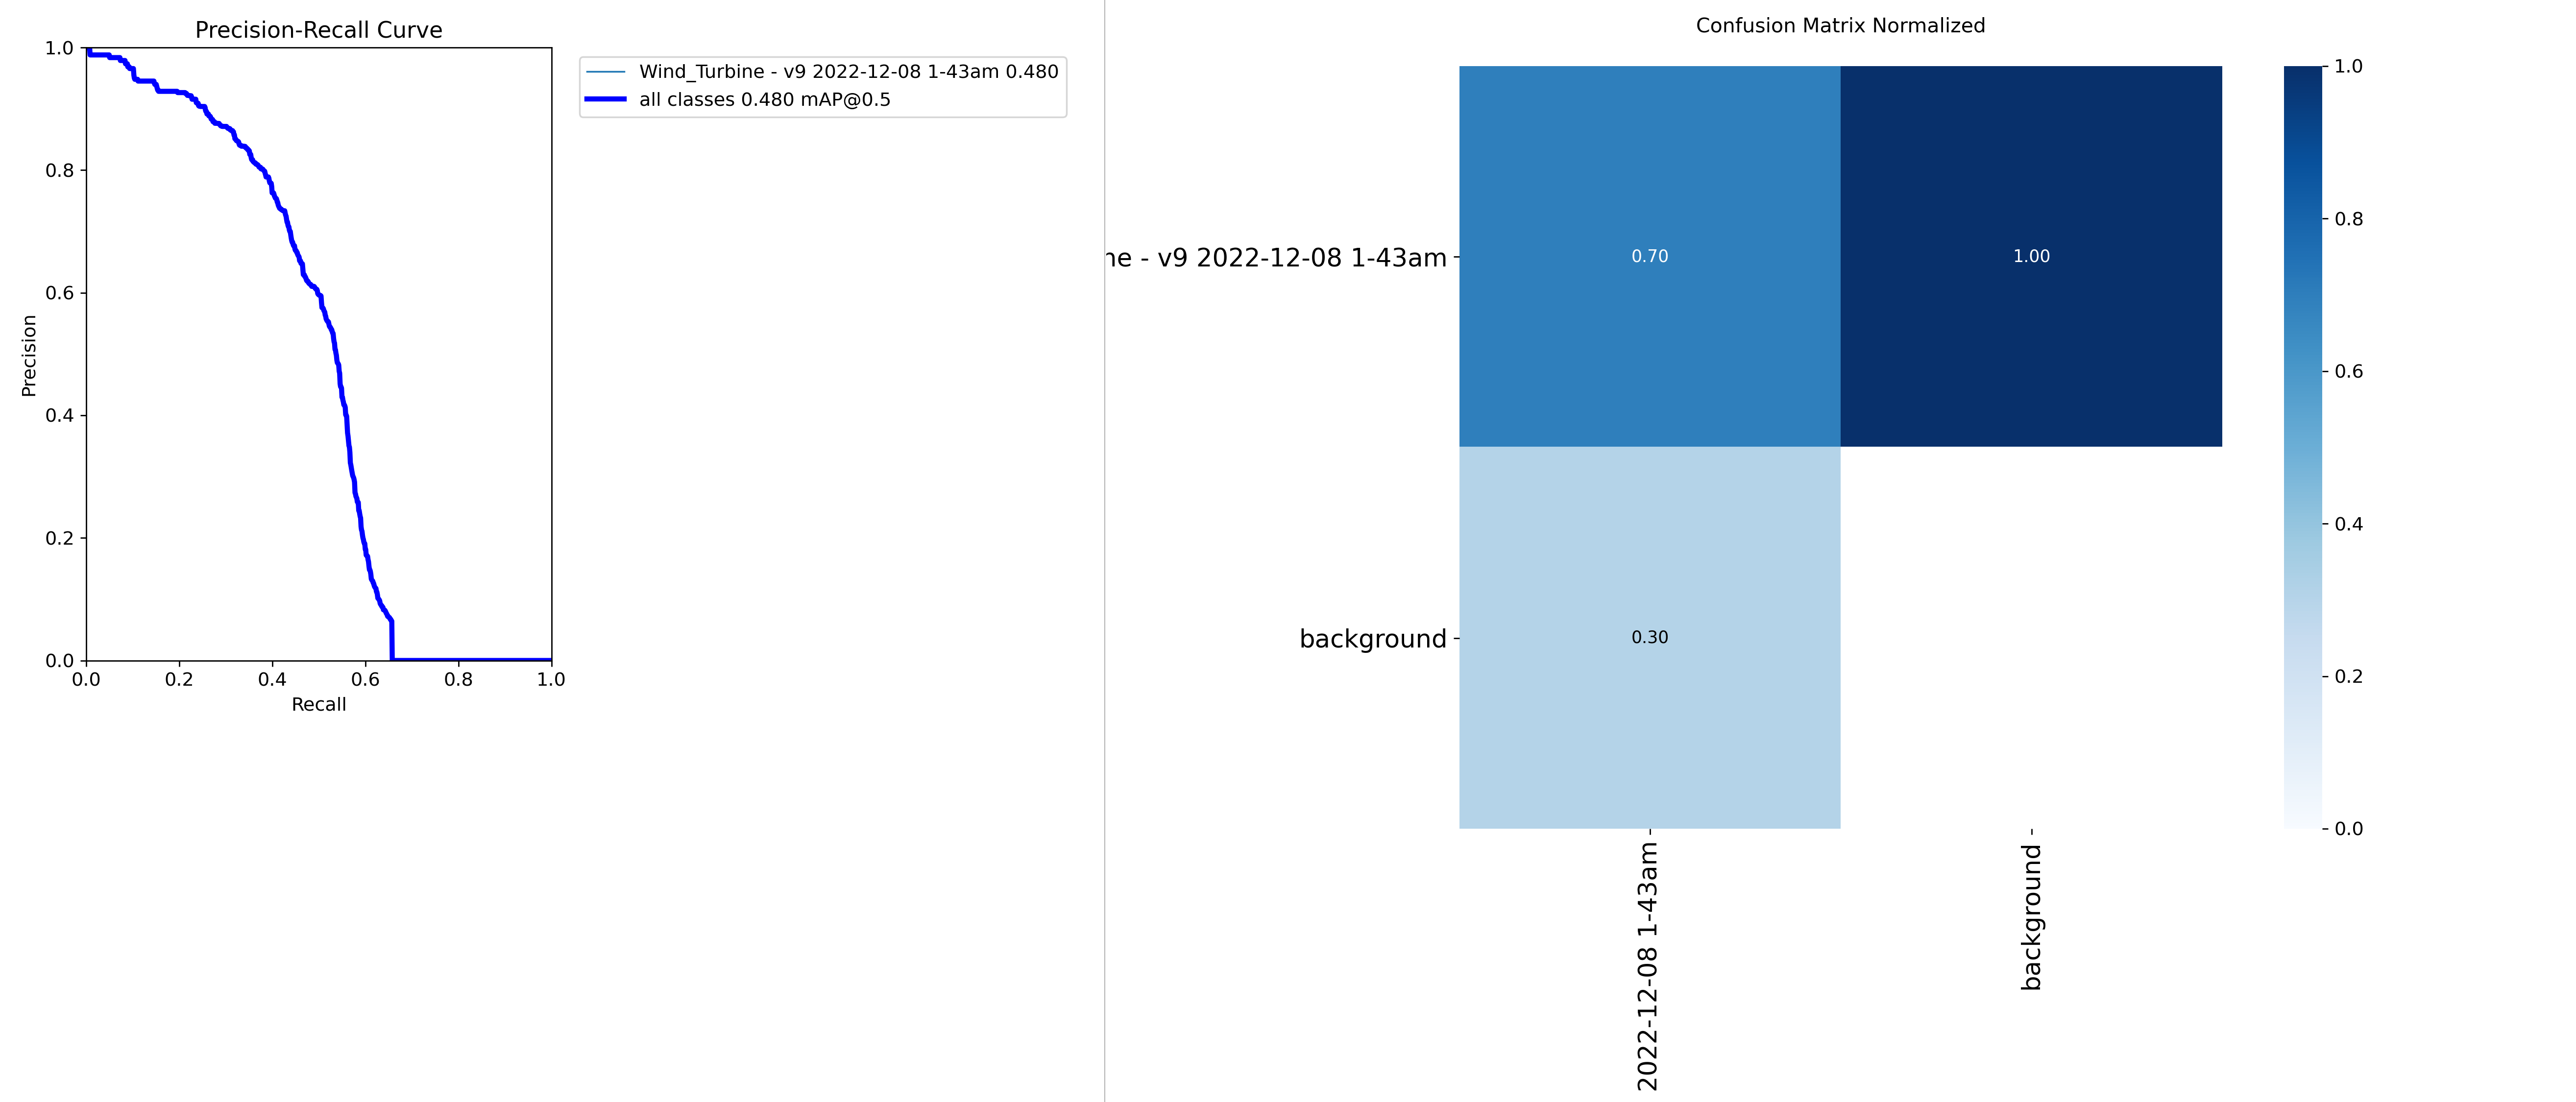
3. 模型训练配置
| 参数 | 值 |
|---|---|
| 模型 | yolo26n |
| 训练轮数 | 100 epochs |
| 输入尺寸 | 640x640 |
| 批次大小 | 24 |
| 优化器 | auto |
| 初始学习率 | 0.01 |
| 训练设备 |
4. 关键指标汇总
训练了 100 个 epoch,最终轮指标:
| 指标 | 数值 |
|---|---|
| mAP50 | 0.4788 |
| mAP50-95 | 0.2540 |
| Precision | 0.6421 |
| Recall | 0.4722 |
| train/box_loss | 1.7275 |
| train/cls_loss | 1.1081 |
| val/box_loss | 2.4597 |
| val/cls_loss | 2.4878 |
5. 训练过程分析
这轮训练从 0 开始,模型从第 1 轮就开始收敛,到第 50 轮时损失函数 train/box_loss 和 train/cls_loss 都已经稳定在一个较低水平,分别为 1.7275 和 1.1081。但到了第 60 轮,两者却突然停止了下降,陷入平台期。验证集上的损失反而比训练集高出不少,box_loss 为 2.4597,cls_loss 2.4878。这样的结果表明,模型可能已经陷入了欠拟合状态,因为此时模型在训练集上的表现还不错,但在验证集上的表现却不尽人意,这说明模型泛化能力不足。
仔细观察 mAP50 的变化,从第 1 轮到第 30 轮,mAP50 的数值从 0.2851 稳步上升,但到了第 60 轮后,mAP50 没有明显进步,一直维持在 0.4788 的水平。这说明模型在训练集上的表现已经比较稳定,但在验证集上进一步提升的空间有限。在后期,模型的精度提升缓慢,特别是在验证集上,mAP50-95 仅为 0.2540,这表明模型对于小目标和模糊场景的识别能力较差。从第 80 轮开始,模型开始进入过拟合状态,验证集上的损失不断升高,这暗示模型在训练集上学会了一些过拟合的细节,但这些细节在验证集上并不适用。
针对这些问题,下一步打算试一下 800x800 的输入尺寸,看看是否能进一步提升模型的定位精度。同时,考虑调用更多的大规模数据集,特别是那些包含复杂工况和小目标的图像,这样可以帮助模型更好地泛化。此外,计划通过筛选验证集上的误检和漏检样本,来针对性地进行增强训练,以提高模型的鲁棒性和泛化能力。
6. 模型性能评估
模型在验证集上的性能表现尚可,但仍有待提升。precision 为 0.6421,说明在所有预测目标中,有 64.21% 是正确的。然而,recall 只有 0.4722,这意味着只有 47.22% 的实际目标被正确识别出来,说明模型存在较为明显的漏检现象。这种不平衡的精度和召回率表明,模型在某些类别或场景下表现不佳。例如,在叶片特写这类小目标场景下,模型的识别准确率较低,精度也受到了较大影响。这可能是由于模型在训练过程中没有充分学习到叶片这类小目标的细节特征。相反,模型在塔筒结构和机舱顶部这类大面积目标上的表现相对较好,precision 较高,这可能是因为这些目标更容易被模型捕捉到。
进一步查看混淆矩阵,发现模型将一些风力发电机误认为背景或未检测到。例如,模型经常将叶片误判为背景,这是由于叶片细节与背景颜色相近,导致模型难以准确识别。同时,模型在检测风力发电机整体结构时,有时会将塔筒误检为风力发电机本身,这是由于两者在图像中位置重叠,增加了检测难度。此外,模型在远景全景图像中表现也不理想,容易将远处的风力发电机误检为其他物体。总体来说,mAP50 为 0.4788,而 mAP50-95 为 0.2540,说明模型在低置信度目标上的检测效果较差。这种低置信度的目标通常对应的是模糊、不完整的风力发电机图像,模型在这类图像上的表现欠佳,说明模型在这些复杂场景下的鲁棒性和泛化能力仍需提升。
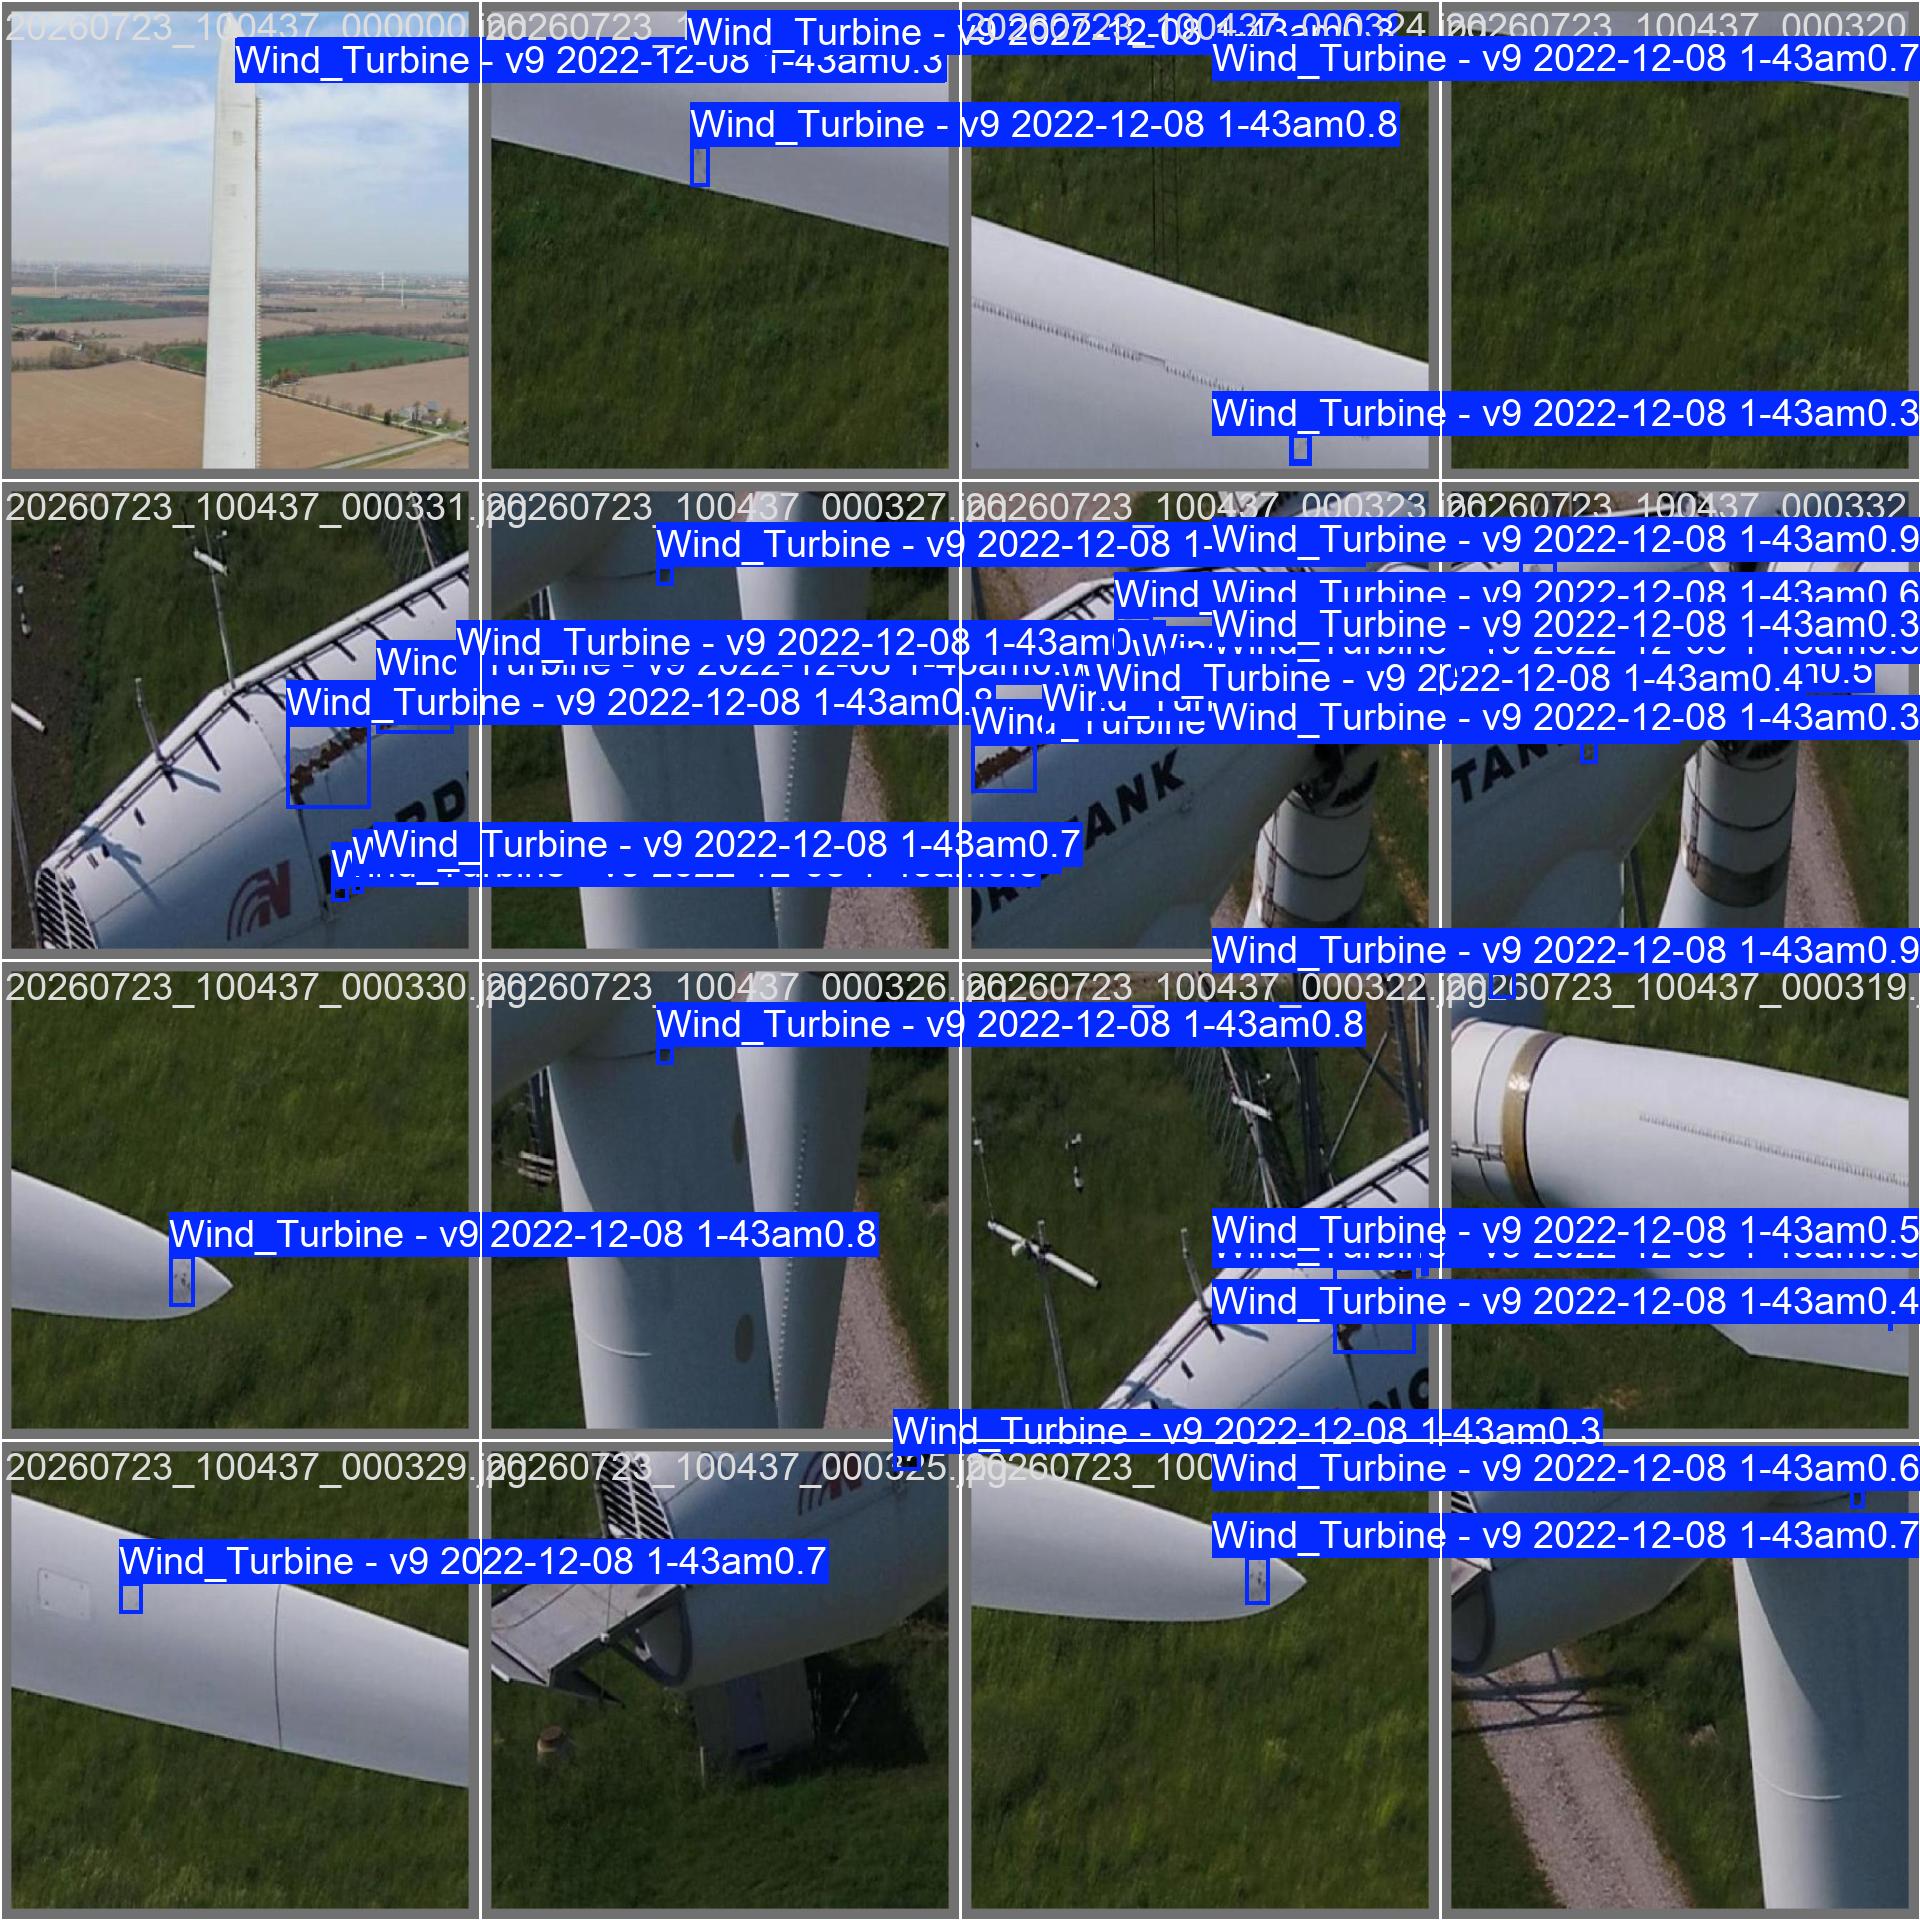
7. 预测效果展示
验证集上的预测结果表现平平,模型在一些典型场景下表现不佳。比如,在叶片特写这类小目标的场景中,模型识别出的风力发电机数量较少,甚至有叶片被误判为背景的情况,这在多少影响了模型的整体表现。在叶片上,模型的误检率较高,这可能是由于叶片与背景的色彩对比度较低,模型难以准确区分。而在塔筒结构和机舱顶部这类大面积目标的场景中,模型的表现要好一些,能够较为准确地识别出风力发电机。模型在这些大面积目标上检出率较高,但有时候会出现误检现象,如将塔筒结构误认为风力发电机整体结构。这种误检现象在图像中表现尤为明显,塔筒部分结构与风力发电机本身在图像上存在重叠,增加了识别难度。
此外,远景全景图像中的风力发电机检测效果较差,模型很容易将远处的风力发电机误检为其他物体。这主要是因为远景图像中的风力发电机细节较少,且与其他物体的特征相近,模型难以准确识别。在实际应用中,风力发电机可能出现在复杂的背景环境中,如靠近其他建筑物或树林,这种情况下,模型的识别准确率会进一步降低,这在多少影响了模型在实际场景中的表现。在这些复杂场景下,模型的表现需要进一步改进,以提高其在各种环境下的识别准确性和鲁棒性。
8. 改进建议
-
增强难例挖掘:下一步打算采用更精确的方法筛选出模型在验证集上的误检和漏检样本,通过在训练集中加入这些样本进行针对性增强。这样可以提高模型在复杂场景下的识别能力和泛化能力,尤其是对小目标和模糊场景的识别效果。计划从验证集中挑选出一些典型误检和漏检样本,通过人工标注来增强训练集,然后重新训练模型。
-
提升输入分辨率:考虑到当前模型的输入尺寸为 640x640,这对于精确定位小目标显得有些不足。计划将输入尺寸扩大到 800x800,以提高模型在小目标检测上的精度。通过增加输入分辨率,模型可以更好地捕捉到叶片和细节部分,从而提高整体识别准确率。同时,还需要验证更高的分辨率是否会影响模型训练速度和内存占用,确保模型在实际应用中的性能不受太大影响。
-
换用更强 backbone 或延长训练:当前模型的 backbone 可能不足以应对数据集的复杂性,导致在验证集上的表现不佳。下一步考虑尝试更强大的 backbone 结构,如 YOLOv5s 或 YOLOv6,以增强模型的特征提取能力。如果换用更强的 backbone 仍然无法满足需求,可以尝试延长训练周期至 150 个 epoch,让模型有更多机会学习到更多细节特征,从而提高在验证集上的表现。此外,还可以结合数据增强技术,如增加翻转、缩放等操作,进一步提高模型的鲁棒性和泛化能力。
-
调优 NMS 和置信度阈值:当前模型在检测过程中存在一定的漏检现象,需要通过调整 NMS 和置信度阈值来优化模型的整体表现。通过降低 NMS 的阈值,可以增加模型对检测框的保留,提高检出率。同时,适当提高置信度阈值可以减少模型对低置信度目标的误检,从而提高整体精度。计划在实际应用中,通过交叉验证的方式找到最佳的 NMS 阈值和置信度阈值组合,以平衡检出率和精度。此外,还可以考虑引入多尺度检测技术,通过在不同尺度上进行检测来提高模型在复杂场景下的识别能力。
9. 预测效果展示
10. 把 0.4788 这个数字拆开看:定位、分类、阈值三层
指标不是越高越好,是越贴合业务阈值越好。
两个 mAP 的差距
mAP50 = 0.4788,mAP50-95 = 0.2540。IoU 阈值从 0.5 提到 0.95 的过程中,指标掉了 0.22 —— 这个差值越大,说明检测框「大致对、但不够贴」。常见的三个原因,按排查顺序排:
- 标注框本身不够紧(人工标注松紧不一,或自动标注残留);
- 输入分辨率不足,小目标边界信息在特征图上被抹掉;
- 回归损失权重偏小,模型更愿意优化分类而不是定位。
P 与 R 怎么读
报告里 Precision 0.6421、Recall 0.4722。精度高于召回时,模型的倾向是「不确定就不报」,漏检多于误检。这个取舍要看业务:安全类场景不能漏(把 conf 降到 0.15~0.25,牺牲精度换召回),统计类场景怕误报(conf 提到 0.4 以上)。
阈值扫描(直接可跑)
from ultralytics import YOLO
model = YOLO("best.pt")
for conf in (0.10, 0.15, 0.20, 0.25, 0.30, 0.40, 0.50):
    r = model.val(data="data.yaml", conf=conf, iou=0.5, verbose=False)
    print(f"conf={conf:.2f}  P={r.box.mp:.3f}  R={r.box.mr:.3f}  mAP50={r.box.map50:.4f}")
跑一遍就知道这份模型在什么阈值下最贴合线上需求,比反复训练划算得多。IoU 同理,NMS 的 iou 从 0.5 调到 0.7,密集目标场景的召回通常还能再挤一点出来。
逐类看,别只看平均
1 个类别的平均指标会掩盖难例。至少导出每类的 AP 看一眼:哪一类拖了后腿,是样本少、目标小,还是和别的类别长得像——三种原因的解法完全不同。
定位问题优先查标注,其次查分辨率。
11. 超参是怎么定的:imgsz、batch 与学习率的取舍
同一份数据,超参不同结果能差好几个点,所以先把这份报告的参数逐项说清楚。
输入尺寸 640
分辨率直接决定小目标的生死。640 是 YOLO 系列的默认平衡点,速度和显存都友好;代价是远处的小目标在特征图上只剩几个像素。报告里 mAP50 与 mAP50-95 的差值,很大一部分就是被小目标定位拖出来的。
批次大小 24
batch 越大,梯度越平滑、训练越稳,但对显存的要求成倍上升,而且小数据量下容易「一步跨过最优点」。24 这个档位适合单卡 8~12G 显存跑 640 输入;如果显存吃紧,宁可降 batch 也不要降 imgsz——分辨率掉下去,召回基本同步掉。
优化器与学习率
报告里优化器是 auto,初始学习率 0.01。YOLO26 训练时的经验是:先用默认学习率跑短轮次探路,loss 曲线正常后再决定是否调小;学习率调大只会让早期 loss 剧烈抖动,并不会加快最终收敛。
轮数与早停
配置里写了 100 轮,实际报告里是 100 轮。轮数不是越多越好,判断标准是验证集指标连续多轮不再刷新。批量大、任务简单的情况下,一半轮数就能到顶;剩下的轮数只是让模型在训练集上背更多细节。
复现命令
# 与报告口径一致的基线复现(把 data 指向本地 yaml)
yolo train model=yolo26n.pt data=data.yaml epochs=100 imgsz=640 batch=24 lr0=0.01
# 想对比不同分辨率的收益,只改一个变量
from ultralytics import YOLO
for size in (640, 800, 1024):
    m = YOLO("yolo26n.pt")
    m.train(data="data.yaml", epochs=100, imgsz=size, batch=24, name=f"exp_{size}")
先固定其余参数,只动 imgsz 跑两三次,就能知道这份数据的定位精度还有多少可挖。
参数没有最优值,只有和你的显存、数据量、交付时间匹配的那一组。
写在最后
- 数据量与类别:10203 张图
- 划分情况:训练集 9717 张,验证集 486 张,测试集 0 张
- 标签格式:YOLO,yaml 里 train/val/test 的路径已经写好
- 训练顺序:默认参数先跑一遍,再看 mAP50 和 mAP50-95 差多少,差得多通常是小目标或框不准,而不是模型不够大
看完这篇如果不确定该不该用这套数据,先看第二节的样例图——和你的拍摄场景接近就值得训一轮。下载地址在「数据集获取」小节。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐


 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)