Python回归预测进阶-目标变量对数化处理
当我们做回归建模时,目标变量(被预测的指标,比如房价 SalePrice)不符合正态分布时,通常会选择 对数化(log transform),原因主要有以下几个方面:
1. 让分布更接近正态分布
-
很多现实中的数值(房价、收入、销售额、人口规模等)往往是 右偏分布(long tail):
-
大多数值比较小
-
少数值特别大(“豪宅”、“超级富豪”、“爆款商品”)
-
-
右偏分布不利于建模,因为模型容易受极端值(outliers)的影响。
-
对数化之后,大的值被“压缩”,小的值被“拉伸”,分布更对称,接近正态。
📌 举例:
房价从 50,000 到 750,000,不取 log 时模型预测误差主要集中在高价房;取 log 后,价格区间压缩到 log(50k)≈10.8 到 log(750k)≈13.5,极端值影响减弱。
2. 稳定方差(homoscedasticity)
-
线性回归和很多机器学习模型默认 误差项具有方差齐性(homoscedasticity)。
-
如果目标变量右偏,通常 高价区的方差比低价区大,导致模型预测时误差不均衡。
-
对数化能让不同区间的误差更均匀,有助于提升模型拟合效果。
3. 提高模型的解释性
-
取对数后,回归系数的含义变成了 “比例/百分比变化” 而不是绝对变化。
-
这更符合经济学、金融学等领域的习惯。
-
比如:
log(SalePrice)的变化 0.1 对应房价增加约 10%,而不是增加固定的几千美元。
-
4. 提升模型的拟合和泛化能力
-
对数化减少了极端值的影响 → 模型不会过于“追逐”豪宅那类少数点 → 泛化能力更好。
-
在 Kaggle 的 房价预测比赛 里,几乎所有优秀方案都会对目标 SalePrice 做对数化。
2、具体示例
OK,回归我们的项目内容:
首先,我们来验证一下我们的销售价格是否需要对数化:
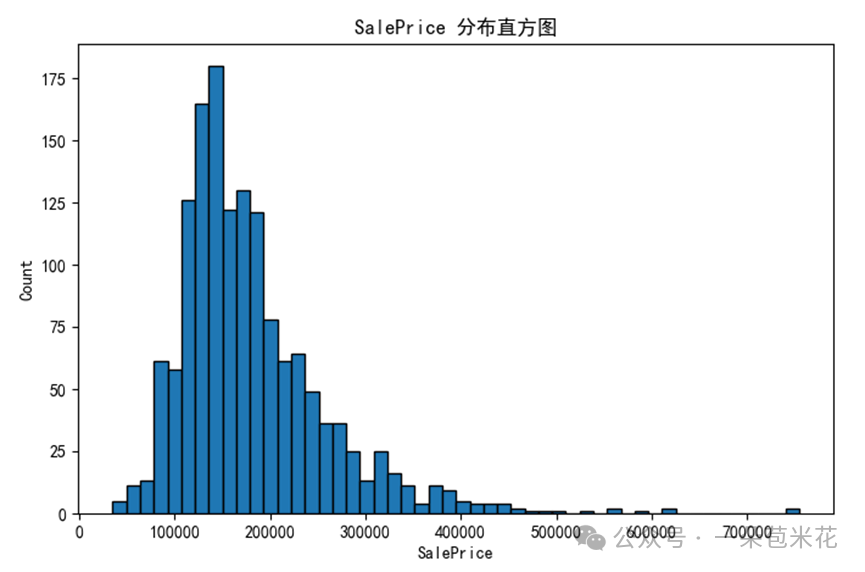
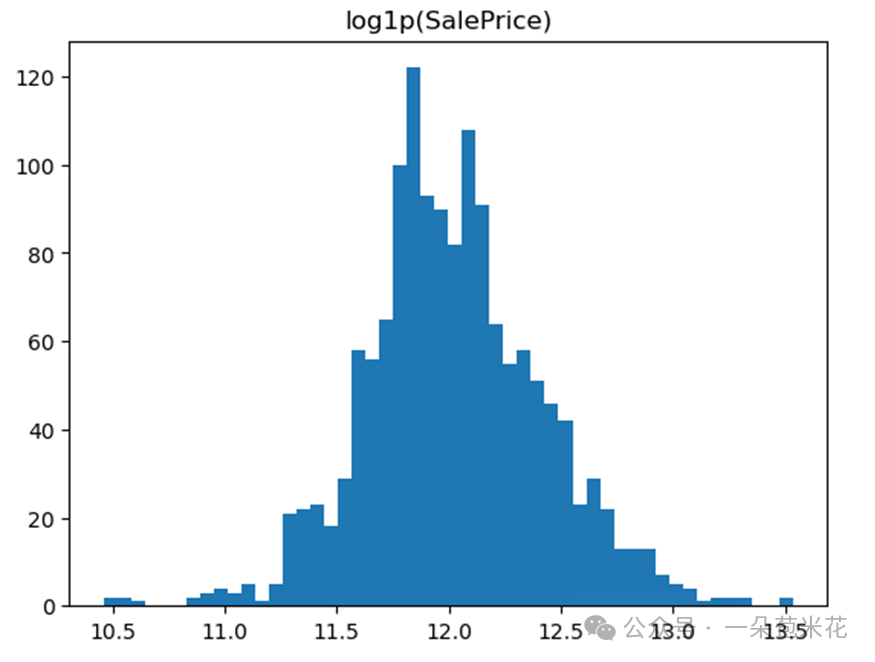
上面分别是原始数据和对数化处理后的“销售价格”直方图。结论如下:
📊 1. 原始分布的特征
右偏分布(Right-skewed):
从第1张直方图可以看出,大多数房价集中在 10万 ~ 20万之间,但有一部分高价房(40万以上,甚至 70万+),拉长了尾部。
长尾效应:
少数高价房对数据的均值影响很大,导致平均值明显高于中位数。
不满足正态性:
原始的 SalePrice 并不符合正态分布,而很多统计建模和机器学习算法(如线性回归)往往假设残差接近正态分布。
📊 2. log1p(SalePrice) 分布的特征
接近正态分布:
经过 log1p 转换后,数据变得对称,类似钟形曲线,更符合正态性。
减少极值影响:
对数变换压缩了高价房的影响,缓解了长尾效应。
有利于建模:
-
-
回归模型中,目标值服从近似正态分布,残差也会更接近正态,有助于提升模型表现。
-
在机器学习中,对数变换后的目标值往往能让模型更稳定,提升预测精度。
-
📌总结
-
原始 SalePrice:右偏、长尾、不适合直接建模。
- log1p(SalePrice):近似正态,更适合作为回归模型的目标变量
3、其他验证正态分布的方法
ps:这篇文章作为回归预测建模的一个小部分内容来展开讨论,所以示例数据接入见另外一篇文章:《Python回归预测建模(可复现,附全部代码、注释及示例数据集,House Prices+LightGBM+模型可解释性)》。找不到的小伙伴可以通过微信公众号私信我~
其他部分见微信公众号文章:

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 28
 0
- 0


 已为社区贡献2条内容

所有评论(0)