【论文阅读】Agent 记忆机制(73):MemGAS——让长期对话记忆按问题选择粒度并关联证据
文章目录
前言
长期对话 Agent 的难点,已经不只是“记忆能不能存下来”,而是:当答案散落在不同日期、不同话题的对话里,系统能不能把它们重新找齐。此前 Agent Memory 系列讨论过把交互写成可检索记忆、建立记忆之间的联系、在需要时回看历史。本文把视角进一步收窄到一个经常被默认、却直接决定检索上限的选择:一段对话究竟应该按多大颗粒度被记住与检索?
假设用户先说“我在 Coursera 完成了三门课”,一周后又说“我在 edX 完成了两门课”,随后问“我总共完成了几门在线课程?”只找回第一个会话,答案是 3;只找回第二个会话,答案是 2。粗粒度的 session 能保留上下文,却可能夹带大量无关内容;细粒度的 turn 易于精确匹配,却可能切断跨轮联系;摘要和关键词便于发现主题,又可能丢失数字、时间等细节。
MemGAS 的唯一核心增量是:不再预先固定记忆粒度,而是把同一段对话表示为多粒度记忆,在写入时建立跨粒度关联,在查询时按不同粒度的匹配确定性动态分配权重,并沿关联图补齐证据。 GMM 建边、熵路由、PPR 扩散与 LLM 过滤,都是为这个“关联与选择”的主线服务,而不是四项彼此独立的贡献。
零、论文基本信息
- 论文名称:From Single to Multi-Granularity: Toward Long-Term Memory Association and Selection of Conversational Agents
- 发表平台:ICLR 2026
- 代码仓库:ICLR2026_MemGAS
- 作者:Derong Xu, Yi Wen, Pengyue Jia, Yingyi Zhang, Wenlin Zhang, Yichao Wang, Huifeng Guo, Ruiming Tang, Xiangyu Zhao, Enhong Chen, Tong Xu
一、背景与问题:为什么单一粒度不够
传统外部记忆方案常把对话切成固定大小的片段,编码成向量,收到问题时取最相似的 Top- K K K。这种流程隐含两个假设:第一,一个检索单元能同时适合事实查询、偏好查询、时间推理等任务;第二,相关证据会各自与问题足够相似,因此无需借助证据之间的关系。多会话问题恰恰同时挑战了这两个假设。
论文的 Figure 1 用“3 门 Coursera 课程 + 2 门 edX 课程”说明部分召回的代价。图中单一粒度的 Recall@3 分别为 session 44.26、turn 44.68、summary 41.06、keyword 35.11;图示的“按问题选合适粒度”达到 62.98。这里的关键不是“某种粒度永远最好”,而是不同问题要求的信息形态不同。数字和日期往往需要原始 turn;跨会话主题连接可能先由摘要或关键词触发,再回到原话核实。
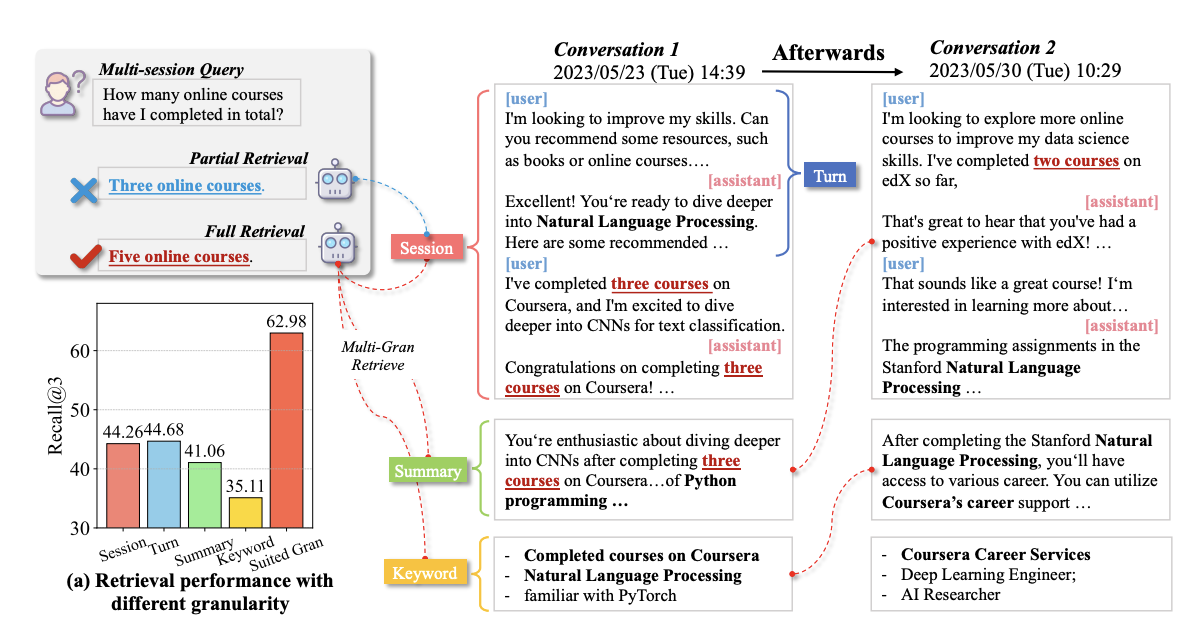
Figure 1:跨会话问题示例。只有同时找回两个会话,才能把 3 门与 2 门课程合并为正确答案 5 门。
这也解释了本文与“多存几份摘要”的区别。多视图存储只是增加候选表达;MemGAS 还要回答两件事:新记忆与哪些旧记忆相连,以及当前问题应更信任哪种视图。
二、相关工作:MemGAS 卡在什么位置
长上下文直接输入原始历史最省去记忆建模,但输入成本随历史长度上升,还可能出现相关信息被大量无关文本淹没。向量记忆则降低读取成本,却容易把跨会话证据拆散。SeCom 用语义一致的片段替代机械切分,改善单片段质量;RAPTOR 用层级摘要覆盖不同抽象层;HippoRAG2 借助结构化关系扩展检索范围;A-Mem 为记忆笔记建立链接。它们分别缓解切分、抽象和关联问题,却未把“同一段对话的 session、turn、摘要、关键词如何共同参与关联与查询路由”作为中心问题。
本文最接近的比较对象其实不是某个固定 baseline,而是“简单多粒度拼接”。附录 Table 5/6 专门设置 Combination:把多粒度信息结合起来,却不使用完整的关联和自适应选择流程。若 MemGAS 仍明显优于 Combination,才能说明收益不只是来自多存几份表示。
三、方法总览:写入与读取两条链路
MemGAS 是外部、非参数化、免训练的对话记忆系统。写入时,一段 session 被拆成原始会话、turn、摘要和关键词四种视图;新视图与历史记忆计算相似度,经 GMM 接受/拒绝划分后形成关联边。读取时,问题在四种粒度上分别形成相关性分布,熵路由给更“确定”的粒度更高权重;加权相似度选出种子,PPR 沿图扩散,再由 LLM 从候选记忆中剔除重复和无关文本,供回答模型使用。
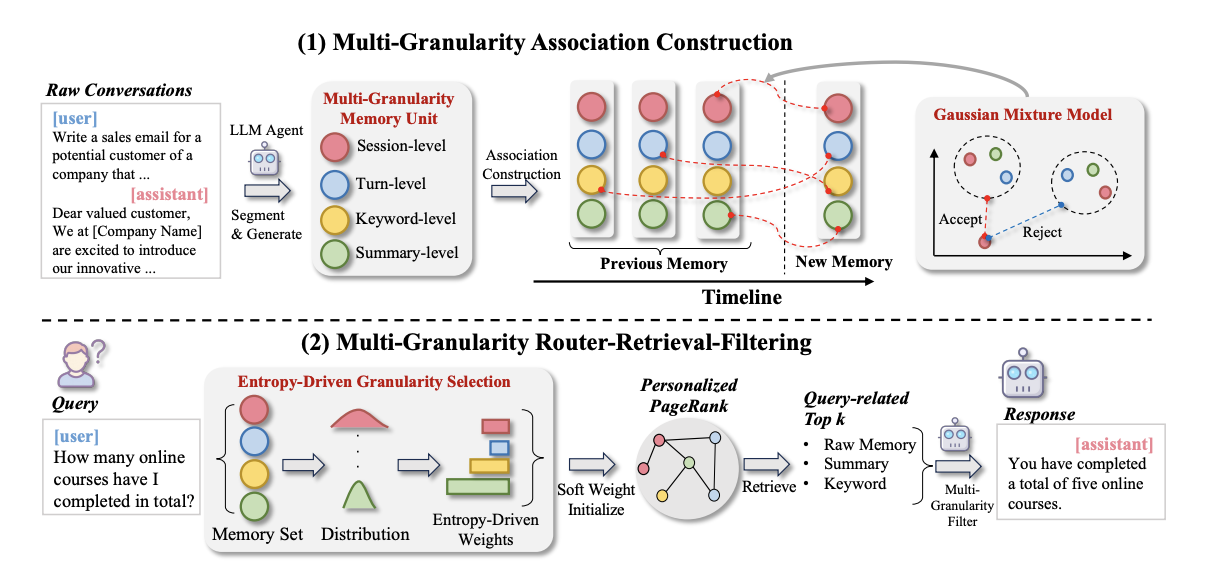
Figure 2:MemGAS 总体框架。上半部分是写入时的多粒度建边,下半部分是查询时的熵路由、PPR 检索与过滤。
有一个容易误读的地方:论文不是让路由器在四种粒度中硬选一个;公式给出的是四个连续权重,最后共同形成候选排序。
四、写入阶段:把一段对话变成可关联的多粒度记忆
1. 四种粒度分别承担什么职责
第 i i i 个会话写为:
S i = { ( u j ( i ) , a j ( i ) ) } j = 1 n i S_i=\{(u_j^{(i)},a_j^{(i)})\}_{j=1}^{n_i} Si={(uj(i),aj(i))}j=1ni
这里 u j ( i ) u_j^{(i)} uj(i)、 a j ( i ) a_j^{(i)} aj(i) 是第 j j j 轮用户和助手发言, n i n_i ni 是该会话的轮数。论文用 LLM 从会话生成摘要 U i U_i Ui 和关键词 K i K_i Ki,再按轮切成 T i T_i Ti:
U i , K i = f L L M ( S i ) , T i = segment ( S i ) U_i,K_i=f_{\mathrm{LLM}}(S_i),\qquad T_i=\operatorname{segment}(S_i) Ui,Ki=fLLM(Si),Ti=segment(Si)
最终记忆单元是:
M i = { S i , T i , U i , K i } M_i=\{S_i,T_i,U_i,K_i\} Mi={Si,Ti,Ui,Ki}
Session 保留事件完整上下文;turn 保留局部事实、精确数字和时间;summary 把跨轮主题压缩成可快速匹配的语义表达;keyword 则提供较短的实体或主题锚点。它们不是四份等价副本。例如“已经完成三门课”若在摘要中被写成“正在学习 NLP”,摘要虽然能连上学习主题,却未必还能回答数量问题。因此正确流程应允许摘要帮助发现候选,再以原始对话核实答案。
附录 Figure 13/14 给出摘要与关键词生成实例:工业节能设备的销售邮件被提炼为“压力罐、空压机、节能”等词;古董茶具对话则被概括为保存、取回和护理需求。这说明抽象视图确实能聚拢主题,但也提醒我们:摘要的质量由生成模型决定,并非无损索引。
2. GMM 如何建立历史关联
新记忆进入时,系统用 Contriever 编码新旧记忆各粒度的表示,计算相似度,再以 Gaussian Mixture Model(高斯混合模型,GMM)把候选关系划为“接受”和“拒绝”两类。接受集里的历史记忆与新记忆建边;拒绝集不建立即时连接。论文明确说每种粒度可作为节点参与关联,因此图里连的不只是完整 session,也包括较细或较抽象的记忆视图。
仍以上述课程例子说明:后一次 edX 会话可能与前一次 Coursera 会话在原文措辞上不同,却共享“完成在线课程”的摘要/关键词语义。跨粒度的连接给检索提供了一条从当前命中的片段走向另一个历史片段的路径。但这里建立的是语义相关边,不是逻辑推理边;“相关”不等于“可加总”,最后仍要检查两个会话是否都陈述“已完成”,而非“计划完成”。
论文没有在主方法中给出可复算的 GMM 后验阈值、混合分量拟合细节或长期增量更新复杂度,因此不能把它描述成已经具备严格的冲突消解或事实更新机制。附录的指数型错连概率论证建立在相关/无关相似度可分等假设下,是条件性的解释,不等同于现实对话里错误边必然很少。
五、读取阶段:由问题决定粒度,再沿图补证据
1. 熵路由:用分布“尖锐程度”衡量匹配确定性
对问题 q q q,系统在粒度 g ∈ { S , T , U , K } g\in\{S,T,U,K\} g∈{S,T,U,K} 上计算其与各个记忆项的余弦相似度。把该粒度内的分数经过 softmax:
p i g = exp ( sim ( q , M i g ) / λ ) ∑ j = 1 n exp ( sim ( q , M j g ) / λ ) , H g = − ∑ i = 1 n p i g log p i g p_i^g=\frac{\exp(\operatorname{sim}(q,M_i^g)/\lambda)}{\sum_{j=1}^{n}\exp(\operatorname{sim}(q,M_j^g)/\lambda)},\qquad H_g=-\sum_{i=1}^{n}p_i^g\log p_i^g pig=∑j=1nexp(sim(q,Mjg)/λ)exp(sim(q,Mig)/λ),Hg=−i=1∑npiglogpig
λ \lambda λ 是温度,控制分布的尖锐程度; H g H_g Hg 是该粒度的 Shannon 熵。如果问题在 turn 层只明显匹配少数对话, p T p^T pT 较集中、 H T H_T HT 较小;如果很多摘要都泛泛地谈到“学习”,摘要层分布更平, H U H_U HU 较大。论文据此做逆熵归一化:
w g = 1 / H g ∑ g ′ = 1 G 1 / H g ′ w_g=\frac{1/H_g}{\sum_{g'=1}^{G}1/H_{g'}} wg=∑g′=1G1/Hg′1/Hg
低熵粒度权重大,高熵粒度权重小。它是置信度启发式,不是可验证的正确性概率:一个错误的唯一匹配同样可能很“尖锐”。另外,如果不同粒度的候选数量不同,未归一化的熵会受候选规模影响;论文没有系统证明这种情况下四种熵可直接比较。这是工程复现时需要监控的边界。
2. 加权种子与 PPR:为什么只看相似度还不够
每个记忆节点先得到加权直接相关分数:
score i = ∑ g = 1 G w g sim ( q , M i g ) \operatorname{score}_i=\sum_{g=1}^{G}w_g\operatorname{sim}(q,M_i^g) scorei=g=1∑Gwgsim(q,Mig)
据此选取 Top- α \alpha α 个节点作为种子,再在写入阶段形成的关联图上执行 Personalized PageRank(PPR),按传播后的得分取 Top- K K K。直观地说,初始相似度负责“找到入口”,关联图负责“顺着入口找到同一问题的其他证据”。课程问题若先命中 edX 会话,图传播就有机会把较早的 Coursera 会话带进候选集。
这也引入反面风险:如果 GMM 错连了两个只是表面主题相近的会话,PPR 会扩散噪声;如果种子本来就没碰到正确主题,图也无法凭空找到它。图关联是一种补召回机制,不是事实真实性校验。
3. LLM 过滤:把召回的候选变成可回答上下文
最终 Top- K K K 候选并不原样交给回答模型。附录 Figure 9 的过滤提示要求保留与问题直接有关的原始 token,删除无关 turn、冗余摘要和关键词;再由 Figure 10 的提示生成答案。这个步骤针对的是多粒度表示天然带来的信息重复,以及图传播可能带入的邻居噪声。
附录的 Patagonia 案例呈现一个典型选择:多个候选都谈“可持续”,但只有部分会话真正提到目标公司。过滤器应该留下具有明确实体证据的片段,而非把所有同主题内容一起塞给生成器。值得注意的是,附录 Figure 15/16 的“After Filter”文字与各自问题/答案存在互换迹象;这两个示例可用于理解意图,不能作为逐字可复现的正确性证据。
六、实验设置:比较范围与评价口径
论文在四个公开基准上评估,任务不需要训练,使用全部 QA 对。LoCoMo 有 10 段长对话、平均 27.2 个 session;Long-MT-Bench+ 有 11 段对话、平均 4.9 个 session;LongMemEval-s 与 -m 各 500 个对话/问题,分别平均 50.2 和 501.9 个 session。尤其 -m 的平均历史约 101.9 万 token,超过直接输入模型上下文的容量。
数据集 LoCoMo Long-MT-Bench+ LongMemEval-s LongMemEval-m 对话数 10 11 500 500 平均 session 数 27.2 4.9 50.2 501.9 平均历史 token 数 20,078.9 19,194.8 103,137.4 1,019,116.7 \begin{array}{l|rrrr} \text{数据集} & \text{LoCoMo} & \text{Long-MT-Bench+} & \text{LongMemEval-s} & \text{LongMemEval-m}\\\hline \text{对话数} & 10 & 11 & 500 & 500\\ \text{平均 session 数} & 27.2 & 4.9 & 50.2 & 501.9\\ \text{平均历史 token 数} & 20{,}078.9 & 19{,}194.8 & 103{,}137.4 & 1{,}019{,}116.7 \end{array} 数据集对话数平均 session 数平均历史 token 数LoCoMo1027.220,078.9Long-MT-Bench+114.919,194.8LongMemEval-s50050.2103,137.4LongMemEval-m500501.91,019,116.7
Table 4:附录数据集规模。LongMemEval-m 的历史长度使“全部历史直接输入”不可行,也使跨会话召回更加重要。
共同设置是 GPT-4o-mini-2024-07-18 进行记忆生成与回答,温度为 0;使用 Contriever 作为主要编码器;通常比较 Top-3 检索。QA 用 F1、BLEU-4、ROUGE、BERTScore 和 GPT-4o-as-Judge;检索用 Recall@ K K K 与 NDCG@ K K K。比较对象涵盖 Full History、MPNet、Contriever、MPC、RecurSum、SeCom、HippoRAG2、RAPTOR、A-Mem。Long-MT-Bench+ 没有检索真值,因而不参与检索表;RAPTOR、A-Mem 的检索结果难以按相同单元判定,HippoRAG2 等在 LongMemEval-m 上因运行成本未列出。故不同表格的“最优”并非总是在相同的完整基线集合上产生。
七、主实验:它究竟赢在哪里,哪里没有赢
1. QA:多会话数据提升明显,但不是所有指标都第一
下面保留 Table 1 最关键的裁判分、F1、平均输入 token 和延迟;原表还报告 BLEU-4、ROUGE-1/2/L 与 BERTScore。各项指标数值是原论文表格值,不是相对提升百分比。
数据集 方法 GPT4o-J ↑ F1 ↑ 平均 token ↓ 延迟(s) ↓ LongMemEval-s Full History 50.60 11.48 103,137 9.39 Contriever 55.40 13.78 8,286 1.85 SeCom 56.00 12.95 2,741 1.67 HippoRAG2 57.60 14.73 8,530 4.51 MemGAS 60.20 20.38 8,829 2.55 LongMemEval-m Full History 12.20 5.70 128,000 12.88 Contriever 42.80 11.88 8,467 1.92 SeCom 42.80 11.33 2,821 1.63 MemGAS 45.40 16.85 8,852 2.45 LoCoMo Contriever 40.33 15.66 2,348 1.24 SeCom 44.21 13.79 1,021 1.02 HippoRAG2 45.62 16.66 2,991 3.56 MemGAS 41.07 17.66 2,825 1.88 Long-MT-Bench+ Full History 67.44 36.07 19,194 4.72 SeCom 64.58 36.68 4,714 2.68 A-Mem 65.73 36.82 13,735 3.95 MemGAS 69.44 41.49 12,873 3.85 \begin{array}{ll|rrrr} \text{数据集} & \text{方法} & \text{GPT4o-J}\uparrow & \text{F1}\uparrow & \text{平均 token}\downarrow & \text{延迟(s)}\downarrow\\\hline \text{LongMemEval-s}&\text{Full History}&50.60&11.48&103{,}137&9.39\\ &\text{Contriever}&55.40&13.78&8{,}286&1.85\\ &\text{SeCom}&56.00&12.95&2{,}741&1.67\\ &\text{HippoRAG2}&57.60&14.73&8{,}530&4.51\\ &\text{MemGAS}&\mathbf{60.20}&\mathbf{20.38}&8{,}829&2.55\\\hline \text{LongMemEval-m}&\text{Full History}&12.20&5.70&128{,}000&12.88\\ &\text{Contriever}&42.80&11.88&8{,}467&1.92\\ &\text{SeCom}&42.80&11.33&2{,}821&1.63\\ &\text{MemGAS}&\mathbf{45.40}&\mathbf{16.85}&8{,}852&2.45\\\hline \text{LoCoMo}&\text{Contriever}&40.33&15.66&2{,}348&1.24\\ &\text{SeCom}&44.21&13.79&1{,}021&1.02\\ &\text{HippoRAG2}&\mathbf{45.62}&16.66&2{,}991&3.56\\ &\text{MemGAS}&41.07&\mathbf{17.66}&2{,}825&1.88\\\hline \text{Long-MT-Bench+}&\text{Full History}&67.44&36.07&19{,}194&4.72\\ &\text{SeCom}&64.58&36.68&4{,}714&2.68\\ &\text{A-Mem}&65.73&36.82&13{,}735&3.95\\ &\text{MemGAS}&\mathbf{69.44}&\mathbf{41.49}&12{,}873&3.85 \end{array} 数据集LongMemEval-sLongMemEval-mLoCoMoLong-MT-Bench+方法Full HistoryContrieverSeComHippoRAG2MemGASFull HistoryContrieverSeComMemGASContrieverSeComHippoRAG2MemGASFull HistorySeComA-MemMemGASGPT4o-J↑50.6055.4056.0057.6060.2012.2042.8042.8045.4040.3344.2145.6241.0767.4464.5865.7369.44F1↑11.4813.7812.9514.7320.385.7011.8811.3316.8515.6613.7916.6617.6636.0736.6836.8241.49平均 token↓103,1378,2862,7418,5308,829128,0008,4672,8218,8522,3481,0212,9912,82519,1944,71413,73512,873延迟(s)↓9.391.851.674.512.5512.881.921.632.451.241.023.561.884.722.683.953.85
Table 1:四个数据集的 QA 结果节选。MemGAS 在所列四组的 F1 均最高,但 LoCoMo 的 GPT-4o 裁判分不及 HippoRAG2 和 SeCom。
LongMemEval-s 上,MemGAS 的 F1 为 20.38,相比 Contriever 的 13.78 高 6.60 点;裁判分从 55.40 到 60.20。LongMemEval-m 上,F1 从 11.88 到 16.85,表明历史更长时,多粒度关联确有价值。但它并非零成本提升:-s 输入 8,829 token,高于 SeCom 的 2,741;延迟 2.55 秒,也高于 Contriever 的 1.85 秒。
最值得保留的反例是 LoCoMo:MemGAS 的 F1=17.66 优于 HippoRAG2 的 16.66;但 GPT4o-J=41.07,低于 HippoRAG2 的 45.62 和 SeCom 的 44.21。F1 衡量词面重合,裁判分强调是否包含完整正确答案;两者不一致说明不能简单说“LoCoMo 全面最好”。附录 Table 5 又把 LoCoMo 的 MemGAS 裁判分写为 40.08,与正文 Table 1 的 41.07 不同;本文以正文主表为主,不把差异悄悄抹平。
2. 检索:跨会话证据更容易找齐
数据集 方法 Recall@3 Recall@5 Recall@10 LongMemEval-s Contriever 71.06 81.28 90.00 HippoRAG2 75.53 84.68 91.28 MemGAS 78.51 88.94 94.47 LongMemEval-m Contriever 44.26 53.40 65.96 SeCom 44.26 55.32 66.60 MemGAS 51.06 63.62 77.02 LoCoMo Contriever 49.90 58.26 71.80 HippoRAG2 56.60 65.06 78.05 MemGAS 57.30 67.32 81.82 \begin{array}{ll|rrr} \text{数据集}&\text{方法}&\text{Recall@3}&\text{Recall@5}&\text{Recall@10}\\\hline \text{LongMemEval-s}&\text{Contriever}&71.06&81.28&90.00\\ &\text{HippoRAG2}&75.53&84.68&91.28\\ &\text{MemGAS}&\mathbf{78.51}&\mathbf{88.94}&\mathbf{94.47}\\\hline \text{LongMemEval-m}&\text{Contriever}&44.26&53.40&65.96\\ &\text{SeCom}&44.26&55.32&66.60\\ &\text{MemGAS}&\mathbf{51.06}&\mathbf{63.62}&\mathbf{77.02}\\\hline \text{LoCoMo}&\text{Contriever}&49.90&58.26&71.80\\ &\text{HippoRAG2}&56.60&65.06&78.05\\ &\text{MemGAS}&\mathbf{57.30}&\mathbf{67.32}&\mathbf{81.82} \end{array} 数据集LongMemEval-sLongMemEval-mLoCoMo方法ContrieverHippoRAG2MemGASContrieverSeComMemGASContrieverHippoRAG2MemGASRecall@371.0675.5378.5144.2644.2651.0649.9056.6057.30Recall@581.2884.6888.9453.4055.3263.6258.2665.0667.32Recall@1090.0091.2894.4765.9666.6077.0271.8078.0581.82
Table 2:检索召回率节选。MemGAS 在三组检索数据上的 Recall@3/5/10 均高于所列基线。
LongMemEval-m 的 Recall@3 从 Contriever 的 44.26 提升至 51.06,Recall@10 从 65.96 提升至 77.02,较符合本文“分散信息需要关联”的问题设定。LoCoMo 的 Recall@3 只比 HippoRAG2 高 0.70 点,提升较小;这与上面裁判分落后共同提醒我们:更高检索召回并不自动等于更高最终答案正确率。
3. 多粒度不是简单拼接
附录 Table 5 的 LongMemEval-s:单独 session F1=13.78,turn=14.94,简单 Combination=14.59,而完整 MemGAS=20.38。Long-MT-Bench+:turn=36.67,Combination=37.16,MemGAS=41.49。附录 Table 6 的 LongMemEval-s Recall@3:session 71.06、turn 73.62、Combination 76.17、MemGAS 78.51。简单合并确实帮助召回,但路由、关联与过滤还带来额外收益。反过来说,Combination 在 LongMemEval-m 的 GPT4o-J=46.40,略高于 MemGAS 的 45.40;完整系统同样不是所有评价轴上的绝对赢家。
八、消融、参数、成本与失败案例
1. 消融:哪一步最影响结果
LongMemEval-s GPT4o-J F1 Recall@3 QA 延迟(s) MemGAS 60.20 20.38 78.51 2.5538 w/o GMM 57.20 19.49 76.38 2.5506 w/o PPR 56.60 19.76 75.96 2.5449 w/o MA 56.80 17.69 74.89 2.5418 w/o Router 56.60 18.88 75.53 2.5471 w/o All 55.40 13.78 71.06 2.5343 \begin{array}{l|rrrr} \text{LongMemEval-s}&\text{GPT4o-J}&\text{F1}&\text{Recall@3}&\text{QA 延迟(s)}\\\hline \text{MemGAS}&60.20&20.38&78.51&2.5538\\ \text{w/o GMM}&57.20&19.49&76.38&2.5506\\ \text{w/o PPR}&56.60&19.76&75.96&2.5449\\ \text{w/o MA}&56.80&17.69&74.89&2.5418\\ \text{w/o Router}&56.60&18.88&75.53&2.5471\\ \text{w/o All}&55.40&13.78&71.06&2.5343 \end{array} LongMemEval-sMemGASw/o GMMw/o PPRw/o MAw/o Routerw/o AllGPT4o-J60.2057.2056.6056.8056.6055.40F120.3819.4919.7617.6918.8813.78Recall@378.5176.3875.9674.8975.5371.06QA 延迟(s)2.55382.55062.54492.54182.54712.5343
Table 3:LongMemEval-s 消融实验节选。去掉全部模块时 F1 下降 6.60 点、Recall@3 下降 7.45 点。
其中 MA 指 Memory Association,去掉 MA 等价于同时不使用 GMM 和 PPR。单独去掉 GMM 后 F1 从 20.38 到 19.49,去掉 PPR 到 19.76,去掉 Router 到 18.88;去掉整个关联链路则到 17.69。这说明关联和查询适配都有效,且联合收益比某一个单点改动更大。论文表中检索阶段延迟从 w/o All 的约 0.0117 秒增至 0.0239 秒,模块自身开销较小;但不应把这与包含 LLM 处理的端到端 2.55 秒混为一谈。
2. 问题类型与 Top- K K K:什么情况下更有用
Figure 3 把 LongMemEval-s 的 F1 按知识更新、用户单会话、偏好、助手单会话、多会话、时间推理分开。图上 MemGAS 在多会话与时间推理方向表现突出,符合图传播补齐远处证据的直觉。附录 Table 7 再显示路由在 LongMemEval-m 上各类问题的 Recall@3,例如 multi-session 为 33.88,而理想的逐题最优粒度选择为 43.80;temporal-reasoning 分别为 41.73 和 51.96。路由明显优于多数固定粒度,但离 oracle 仍有距离。
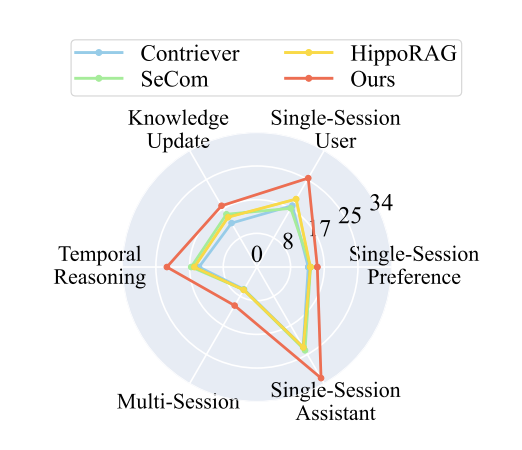
Figure 3:不同问题类型的 F1。多会话与时间推理是多粒度关联最有解释力的应用场景。
Figure 4 考察 Top- K K K 从 1、3、5 到 10。LoCoMo 随 K K K 增大继续受益;LongMemEval-s 的 MemGAS 曲线在较小 K K K 先升后降,说明检索结果增加到一定程度后,额外噪声可能抵消召回收益。因此“把 K K K 调大”不能替代更好的粒度路由和过滤。
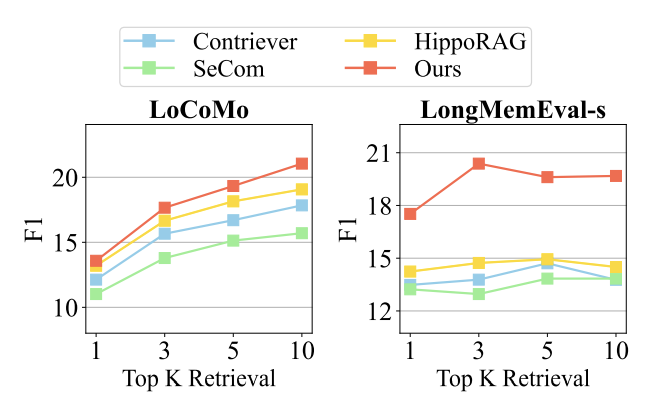
Figure 4:不同 Top- K K K 下的 F1。LongMemEval-s 出现更长上下文反而降低回答质量的现象。
附录 Figure 6 的敏感性分析显示,种子数 α \alpha α 在约 15 时较好,熵温度 λ \lambda λ 在约 0.2 时较好。这些是论文实验中的适用值,不是其他模型或数据集上的通用常数。
3. 效率:记忆构建省输入,不等于使用时最省
附录 Table 8 报告 LongMemEval-s 全语料记忆构建 token:MemGAS 输入 52.9M、输出 5.2M;HippoRAG2 输入 111.1M、输出 10.9M;SeCom 输入 106.2M、输出 71.1M;RAPTOR 输入 62.6M、输出 0.73M。MemGAS 在这些方法里输入较少,但输出并非最低——RAPTOR 的 0.73M 更低。附录 Table 9 的额外摘要与关键词约 3.14M + 2.09M token、16.2 + 10.8 MB RAM,相对原始记忆 266MB 约增加 10%。这些数字说明表示冗余有成本,但存储增加相对可控。
同 token 比较的附录 Table 10 在第一组 8,000 输入 token 下,MemGAS 的 GPT4o-J 为 59.8,高于 SeCom 57.8 和 HippoRAG2 57.4,延迟 2.42 秒;第二组的 MemGAS 为 60.3、3.15 秒。论文叙述说两组阈值是 8,000 与 16,000,但原表两组均标作“8,000”。第二组究竟应标多少,不能仅凭文字擅自改写表格。总体看,MemGAS 是效果/开销折中,不是“全流程最便宜”的方法。
4. 失败类型与案例:证据找不回、找回也答不对
附录 Figure 7 的错误分解中,LongMemEval-m 有 40.6% 属于“检索错误 + 生成错误”,LongMemEval-s 为 18.6%;LongMemEval-s 另有 52.6% 属于“检索正确 + 生成正确”。这说明长历史下最大的剩余难点仍是有效证据召回。论文还提到对没有相关证据的问题回答“未提到相关信息”,以减少编造,但该图并不能单独证明拒答校准充分。
附录 Figure 12 的三个案例很直观:在线课程总数 5、番茄 5 株加黄瓜 3 株共 8 株、从 4 月 11 日到 4 月 20 日是 9 天。MemGAS 在这三个展示案例中找到并整合了分散数字或时间锚点,其他基线常只找到一部分或直接要求用户补充。不过它们是挑选出的定性例子,不能代表所有问题类型的成功率;系统性的结论仍应看 Table 1/2 和错误分布。
九、与既有 Agent Memory 方法横向比较
如果把一套 Agent Memory 系统拆成“写入什么、如何组织、何时回看、怎样更新”四个问题,MemGAS 最集中回答的是同一记忆如何以多个粒度参与组织和回看。
| 方法 | 主要关注点 | 与 MemGAS 的关键差别 |
|---|---|---|
| A-Mem | 将经历整理为笔记并建立可演化链接 | 更强调笔记内容和链接演化;MemGAS 明确把同一会话的多粒度视图及查询时粒度权重纳入检索。本文把 A-Mem 列为实验基线。 |
| MAGMA | 结构化的 Agent 记忆组织与跨记忆关系 | 可从“关系表达和可追溯组织”角度对读;MemGAS 的实验更聚焦多粒度检索选择,不应据此推断它已解决更广泛的关系管理问题。 |
| CoM | 对记忆形成、整合与调用过程的建模 | 与本文都反对孤立记忆片段;MemGAS 具体落实为四粒度表示、GMM 建边与熵路由。 |
| ReMemR1 | 记忆更新时主动回访历史,缓解边读边记的信息损失 | ReMemR1 重点在“能否回看并修正旧记忆”;MemGAS 重点在“问题到来时该用什么粒度并沿哪些关联扩展”。两者可以互补。 |
| Mem²Evolve | 记忆随任务反馈演化的思路 | MemGAS 有增量建边,但未把长期反馈驱动的记忆自我修正作为主要实验对象。 |
这张对照是为了定位设计问题,而不是宣称本文对上述方法做了同条件实验;论文正式比较的是 Table 1/2 中列出的基线。尤其不能把“能建关联”直接等同于“能处理事实冲突、时效或遗忘”。
十、工程启发:怎样迁移到其他 Agent
以下是基于论文机制的工程推演,不是本文在 Coding Agent、Tool Agent 或 Multi-Agent 上验证过的实验结果。
对 Coding Agent,一个开发过程可同时保留“整个任务会话、单次代码修改、任务摘要、符号/文件名关键词”四层表示。用户问“为什么上周改了重试逻辑”时,摘要帮助定位相关任务,单次 diff 和测试结果负责事实核验;跨会话边连接当时的 bug、修复和后续回归。但代码记忆需要版本号、提交哈希等确定性约束,不能只靠语义近似建边。
对 Tool Agent,可把完整工具任务、单次调用及返回、最终总结、资源标识符分层存储。用户问“上次导出失败的原因”时,可先命中总结,再沿关联找到具体错误码和参数。需要给工具输出标记来源与时间,避免过期结果被图传播放大。
对 Multi-Agent,共享任务的计划、单个 Agent 的局部观察、协作摘要和实体索引可构成不同粒度。路由能帮助查询选择“看全局进度还是局部执行证据”。不过跨 Agent 建边必须加权限和可信度边界;本文没有证明其方法能安全地处理不同 Agent 的相互矛盾报告。
一个实际落地顺序是:先保留原始证据和结构化元数据,再生成摘要/关键词;对新增记忆建立可审计的关系边;查询时记录各粒度得分、权重、种子和最终证据;最后让生成器只基于被保留下来的原文回答。这样即使路由或图传播出错,也能追踪是哪一步丢失或污染了证据。
十一、局限性与我的理解
第一,“低熵=可靠”不是普遍成立。当关键词恰好与一个错误会话高度相似时,路由可能给它很高权重;不同粒度候选数量不同还可能带来不可比的熵。更稳妥的扩展是把熵与相似度间隔、证据来源、时间和校准置信度结合,而不只看分布尖锐程度。
第二,关联图会积累错边。GMM 的 accept/reject 机制有助于控制噪声,却没有展示真实长期写入场景下的边质量、删除、去重、冲突更新和用户纠错。附录理论保证依赖分布可分假设;实际对话中的同名实体、话题转移与前后说法变化可能让假设失效。
第三,实验范围以 QA/检索为主。没有检验长期个性化行为是否改善、跨天事实更新是否正确、隐私信息是否被不当传播,也没有报告多轮在线部署中的累计构建成本。四个 benchmark 能证明这套设计对长历史问答有帮助,却不足以证明“通用 Agent Memory”问题已经解决。
第四,论文材料本身存在需要保留的数值与案例差异:正文/附录 LoCoMo 裁判分不一致,Table 10 的 token 档位重复标注,Figure 15/16 的过滤后文本与案例问题疑似互换。这些不否定主表趋势,但提醒复现时应优先核对代码与原始日志,不能把每个附录示例都当成已经无歧义的证据。
我认为本文最值得借鉴的并非“任何记忆都要存成四份”,而是一个更一般的设计原则:记忆的物理存储粒度、关联粒度和查询使用粒度不必相同。 原文用于核实,抽象视图用于发现,图用于把分散证据带回同一候选集,过滤用于控制带回后的噪声。只要这四步的来源链可追踪,多粒度才真正提升了可靠性;否则,多视图也可能只是把一次记错放大成四份相似的错误。
十二、总结
MemGAS 把长期对话记忆从“固定片段的相似度检索”推进到“多粒度表示、增量关联和按问题自适应选择”:它在四组 QA 实验中的 F1 领先,并在三组可评价检索任务中提升召回;但它并非所有裁判分或成本指标都最优,也尚未解决记忆冲突、时效与长期在线维护。一句话概括:它让 Agent 不只记得更多,而是尝试在回答具体问题时,选对记忆的观察尺度,并找齐彼此相关的证据。
参考资料

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)