测开转Agent开发:收藏这份路线图,抢占2026年新风口!
本文探讨了测开工程师转型Agent开发的优势与可行性。文章指出,Agent开发的核心是让系统按预期运行,与测开底层逻辑一致,只是对象从API和UI转向大模型和工具链。测开工程师具备接口测试、自动化测试、数据构造等核心能力,可直接应用于Agent开发。文章还提供了Agent开发的技术栈、实操路线图,建议测开工程师抓住这一转型机会,提升自身竞争力。
上周和一个老朋友吃饭。
他做了6年测开,去年年底被裁,今年3月入职了一家AI创业公司,title变成了“Agent开发工程师”,薪资翻了将近一倍。
我问他:“测开转Agent开发,跨度大不大?”
他说了一句话让我印象很深:
“Agent开发和测开,底层逻辑是一样的——都是让系统按照预期运行。只不过以前被测的是API和UI,现在被测的是大模型和工具链。”
这句话点醒了我。
如果你现在正处在测开的瓶颈期——薪资见顶、技术栈固化、每天在重复造轮子——Agent开发可能是你2026年最值得押注的转型方向。
01 为什么是Agent开发?
先说一个事实。
2025年到2026年,国内AI行业最大的变化不是模型本身,而是Agent从概念走向了落地。
以前大家聊AI,聊的是“哪个模型更强”。现在企业聊AI,聊的是“怎么让AI真正干活”。
于是Agent出现了。
- 客服Agent:代替人工处理80%的咨询
- 运维Agent:自动排查线上故障
- 测试Agent:自动生成用例、执行回归、分析结果
- 数据分析Agent:自然语言查数据库、自动出报表
每一个Agent的背后,都需要有人来做一件事:把大模型和业务系统连接起来。
这个人不是纯算法工程师(算法在搞模型训练),也不是纯后端开发(后端在搞业务CRUD)。
这个人需要懂AI、懂工程、懂业务、懂测试——这不就是测开最擅长的领域吗?
02 测开转Agent开发,有什么天然优势?
很多人觉得转Agent开发要从零学起,其实不是。
测开的核心能力,和Agent开发高度重合:
| 测开能力 | Agent开发中的应用 |
|---|---|
| 接口测试 | Agent调用外部工具,本质就是接口调用,需要验证入参、出参、异常 |
| 自动化测试 | Agent的多轮交互、状态流转,就是一套复杂的自动化流程 |
| 数据构造 | Agent的Prompt模板、Few-shot示例,本质上就是测试数据 |
| CI/CD集成 | Agent上线前的回归验证、灰度发布,就是测试流程的延伸 |
| 异常场景设计 | Agent最容易出问题的就是边界情况,这正是测开最擅长的 |
| 日志分析 | Agent的推理过程、工具调用链路,需要像排查测试失败一样去排查 |
说白了,Agent就是一个“会说话、会思考、会调用工具”的被测对象。
你以前测的是接口和UI,现在测的是Agent的行为。方法论没有变,只是对象变了。
03 Agent开发的核心技术栈
要转Agent开发,你需要掌握以下技术栈。我按优先级排列:
第一梯队:必须掌握
LLM基础知识
- 什么是大模型、Token、上下文窗口
- Prompt Engineering基础(System Prompt、Few-shot、Chain-of-Thought)
- 常见的模型能力边界(幻觉、长上下文衰减、指令遵循)
Agent框架
- LangChain:最流行的Agent编排框架,掌握Chain、Tool、Memory、Agent四大核心概念
- LangGraph:比LangChain更灵活的图状Agent编排,适合复杂多步任务
- AutoGen:微软出品,适合多Agent协作场景
- Coze/Dify:低代码Agent平台,适合快速验证想法
工具调用(Function Calling)
- 如何定义工具的Schema
- 如何让模型正确选择工具
- 如何处理工具调用失败的回退逻辑
第二梯队:进阶掌握
RAG(检索增强生成)
- Embedding模型的选择
- 向量数据库(Milvus、Chroma、Pinecone)
- 文档分割策略、检索策略
记忆机制
- 短期记忆(Conversation Buffer)
- 长期记忆(向量存储 + 摘要)
- 持久化记忆(将Agent状态写入数据库)
多Agent协作
- 主从模式:一个Master Agent调度多个Worker Agent
- 辩论模式:多个Agent相互质疑,提升决策质量
- 管道模式:一个Agent的输出作为下一个Agent的输入
第三梯队:高阶能力
Agent评测
- 如何构建评测数据集
- 自动化评测指标(成功率、耗时、成本、幻觉率)
- 回归测试体系的搭建
Agent安全
- Prompt注入防护
- 工具调用的权限控制
- 敏感信息的脱敏与审计
Agent可观测性
- Trace链路追踪(LangSmith、Arize)
- 日志分析与错误归因
- 成本监控与优化
04 测开转Agent开发的实操路线图
第一阶段:打好基础(1-2个月)
目标:理解Agent的基本原理,能搭建一个简单的单Agent应用
具体行动:
- 学习Prompt Engineering
- 花一周时间,系统地学一下怎么写好的System Prompt
- 练习:给ChatGPT写一个“测试用例生成助手”的Prompt,让它能按照你指定的格式生成测试用例
- 上手LangChain
- 跟着官方教程跑一遍Quickstart
- 重点理解:Chain(链)、Tool(工具)、Memory(记忆)、Agent(智能体)
- 动手:写一个最简单的Agent,给它一个“查询天气”的工具,让它能根据用户的问题调用这个工具
- 了解Function Calling
- 学习OpenAI的Function Calling文档
- 理解:tools参数怎么传、模型怎么决定调用哪个工具、工具返回的结果怎么喂回给模型
- 动手:写一个Agent,让它能调用“获取用户信息”和“发送邮件”两个工具
推荐资源:
- LangChain官方文档(中文版也很完善)
- DeepLearning.AI的《LangChain for LLM Application Development》
- OpenAI Cookbook中的Function Calling示例
第二阶段:深入实践(2-3个月)
目标:能独立完成一个中等复杂度的Agent项目
具体行动:
- 做一个完整的Agent项目
- 选一个你熟悉的业务场景(比如:测试数据生成Agent、Bug分析Agent、接口测试Agent)
- 从0到1搭建:定义工具 → 编写Prompt → 实现Agent逻辑 → 添加记忆 → 部署上线
- 掌握RAG
- 学习向量数据库的基本概念
- 动手:做一个“公司知识库问答Agent”,让它能根据内部文档回答员工的问题
- 学习Agent评测
- 设计一套评测指标:成功率、平均耗时、工具调用准确率
- 搭建自动化评测流水线:每天跑一批测试用例,自动生成评测报告
推荐项目:
- 测试用例生成Agent:输入需求文档,输出测试用例
- Bug分析Agent:输入Bug描述,输出根因分析和修复建议
- API测试Agent:输入API文档,自动生成并执行测试脚本
第三阶段:更加专业(3-6个月)
目标:能设计复杂的多Agent系统,具备Agent生产环境的运维能力
具体行动:
- 学习LangGraph
- 理解图状Agent编排的核心概念
- 动手:用LangGraph实现一个“测试流程编排Agent”,让它能根据测试需求自动编排测试计划、执行测试、生成报告
- 掌握多Agent协作
- 学习AutoGen的多Agent模式
- 动手:搭建一个“测试团队Agent”——一个Test Manager Agent分配任务,多个Tester Agent并行执行,一个Reporter Agent汇总结果
- Agent生产化
- 学习Agent的可观测性:接入LangSmith进行Trace追踪
- 学习Agent的安全防护:防止Prompt注入、限制工具调用权限
- 学习Agent的成本优化:减少不必要的模型调用、合理设置缓存
推荐资源:
- LangGraph官方教程
- AutoGen官方文档
- LangSmith的使用指南
一定要做一个完整的项目,哪怕是自己业余时间做的。
2024年,大家都在讨论“AI会不会取代测试工程师”。
2025年,大家发现AI没有取代测试,而是创造了一个新岗位——Agent开发。
2026年,这个窗口正在快速收窄。等到所有人都意识到这是个机会的时候,门槛就已经高了。
测开转Agent开发,不是转行,是升级。
你的测试思维、工程能力、对异常场景的敏感度,都是别人不具备的优势。
现在开始,刚刚好。
大模型的知识又多又杂,到底怎么学?
做这行久了,被问最多的问题就一个:大模型的知识又多又杂,我到底先学啥?翻了一堆资料,看啥都像重点,结果啥都没学进去。今天把我自己一路摸出来的顺序捋一遍,零基础、应届生、转行的都适用。跟着走,至少方向不乱、不瞎忙,学完拿得出手。
第一阶段(10天):初阶应用
这一阶段就一个目标:把大模型真正"玩明白",不是只会聊天那种,而是能调教它、能用代码把大模型和业务接起来。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
这阶段正式进实战,目标很实在:做出两个能拿出手的东西——一个私有知识库,一个 agent 对话机器人。
-
为什么要做 RAG
-
搭建一个简单的 ChatPDF
-
检索的基础概念
-
什么是向量表示(Embeddings)
-
向量数据库与向量检索
-
基于向量检索的 RAG
-
搭建 RAG 系统的扩展知识
-
混合检索与 RAG-Fusion 简介
-
向量模型本地部署
-
…
走完这 30 天,Python 或 JavaScript 背景的基本能独立做一套 RAG 应用,简历上也敢写"大模型应用开发"了。
第三阶段(约20天):动手微调
学到这,你已经开始 “造” 模型了 —— 通过微调,搞出垂直领域的专用小模型。
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你从 “只会用” 变成 “能造” 的 AI 小子。那么你还想往下探索吗?
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
第四阶段(20天):商业闭环,部署落地
技术学完,落地才算数。这阶段带你搞明白大模型怎么真正跑起来、用起来。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
想要入坑大模型的朋友,给大家准备了一份2026 年最新 AI 大模型全套学习资料:
1、大模型系统化学习路线
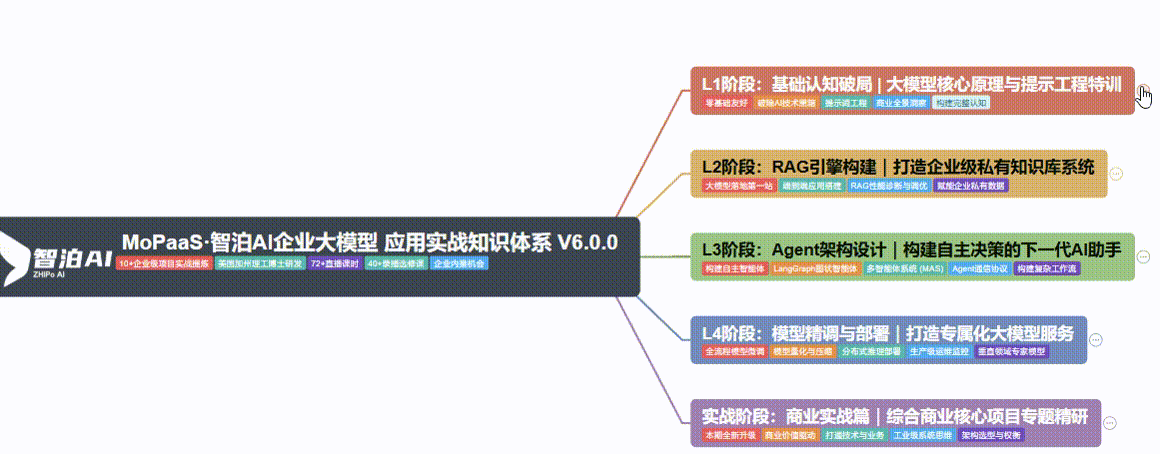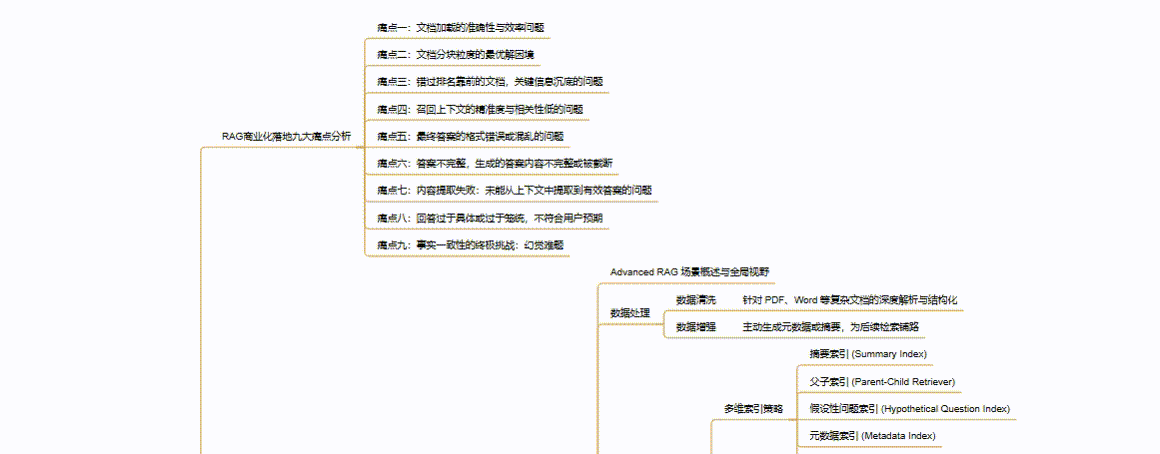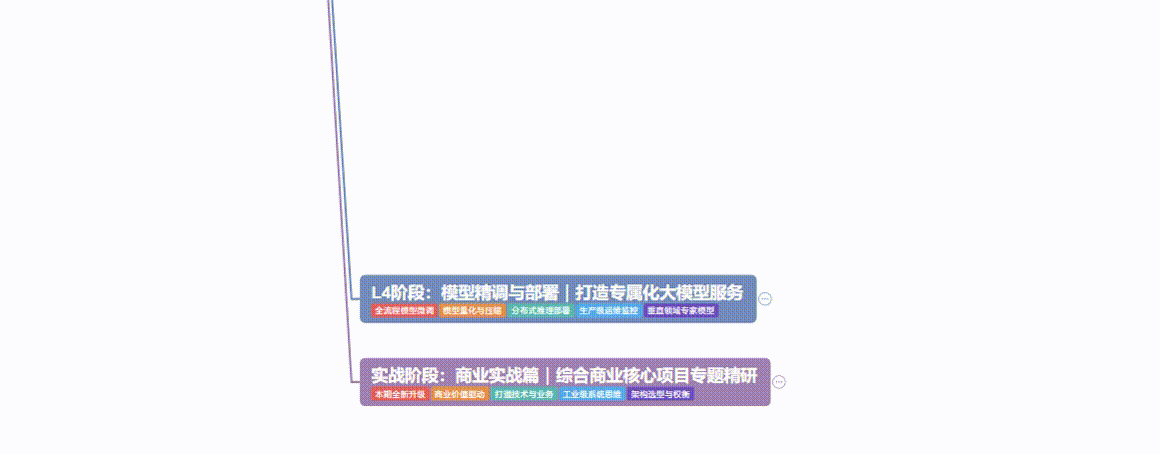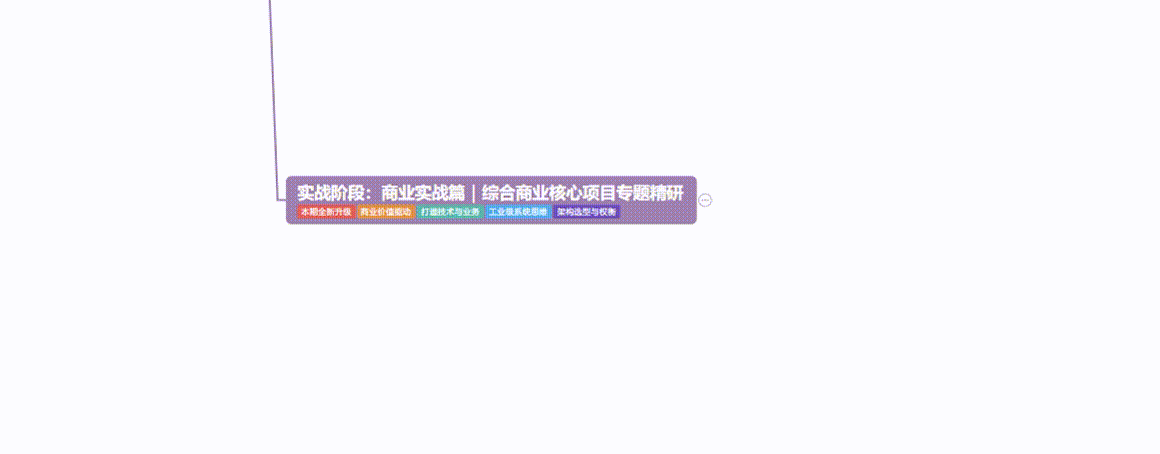
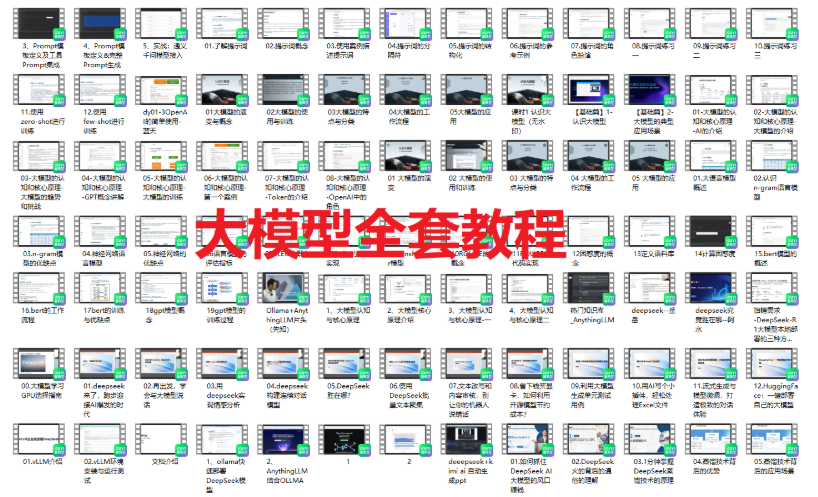
2、大模型学习视频教程
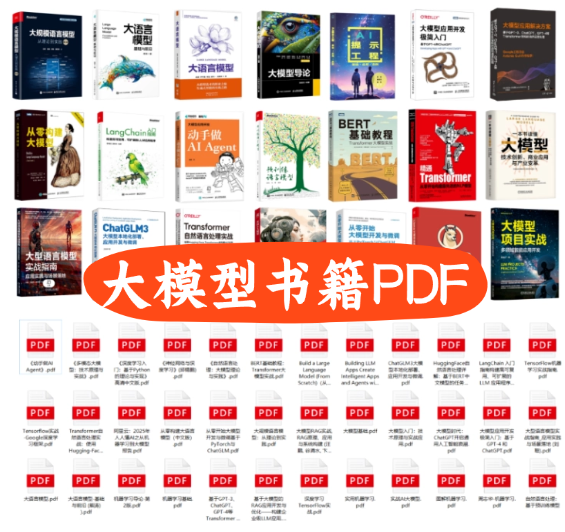
3、大模型学习书籍&电子文档
4、AI大模型最新行业报告
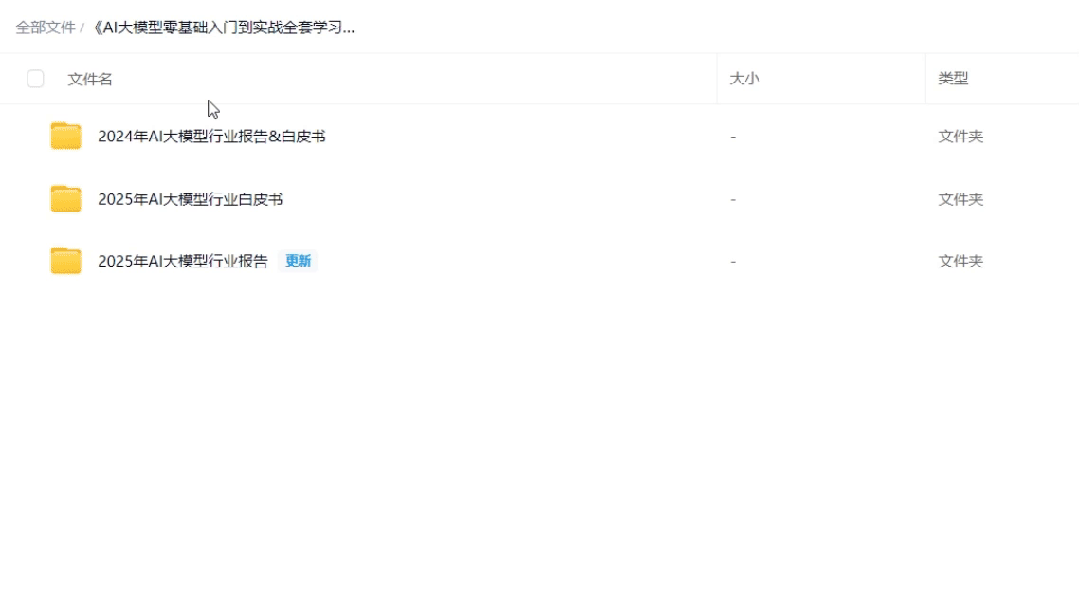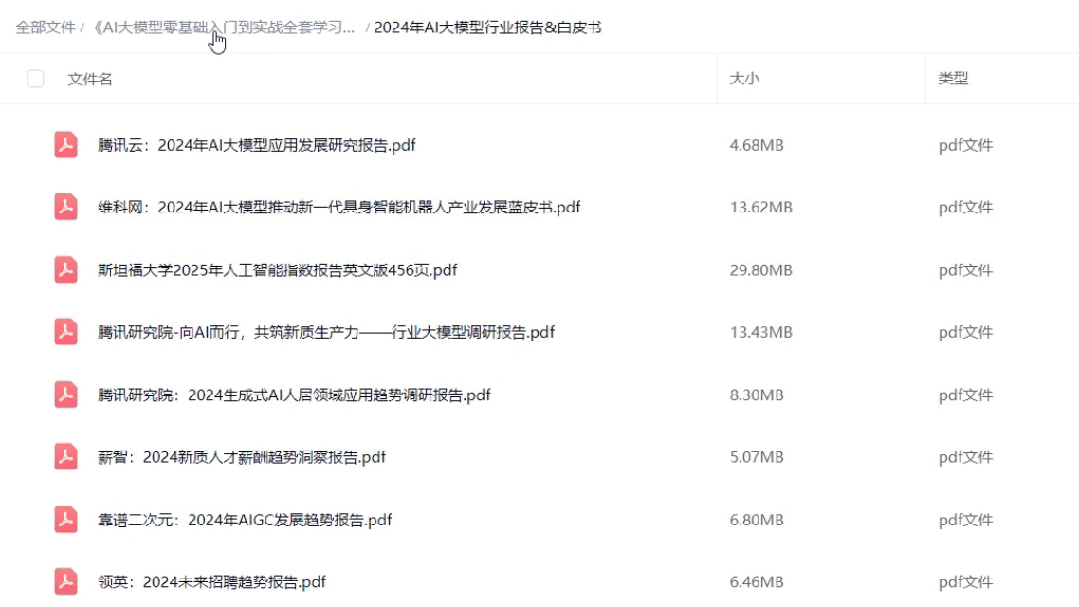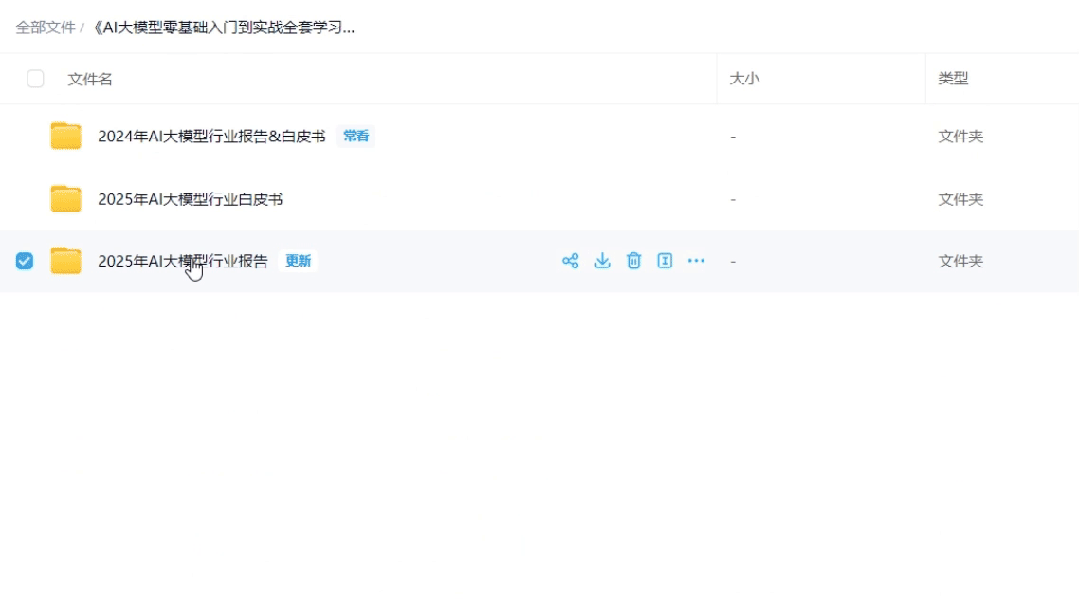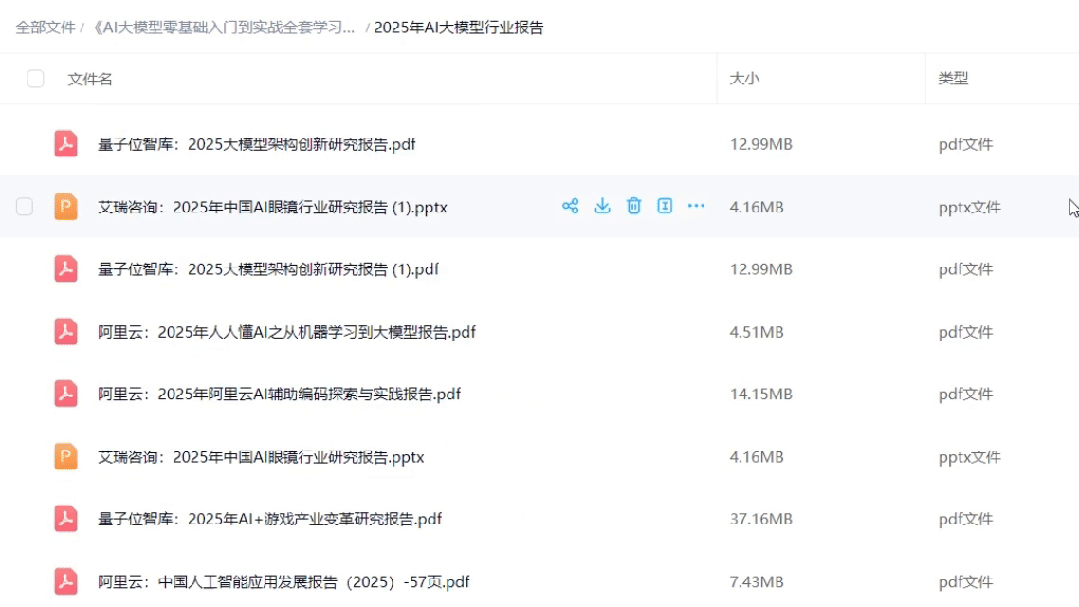
5、大模型项目实战&配套源码
6、2026大模型大厂面试真题
7、为什么要学习大模型?
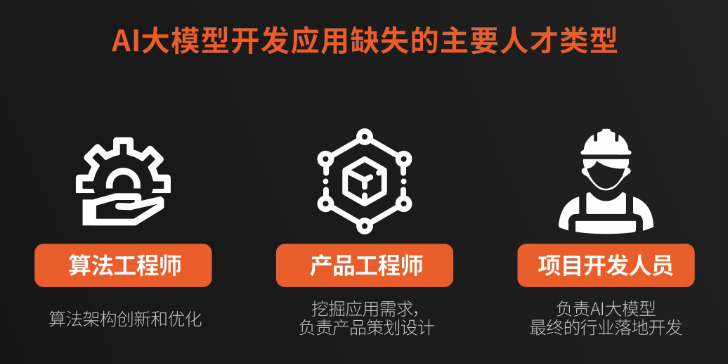
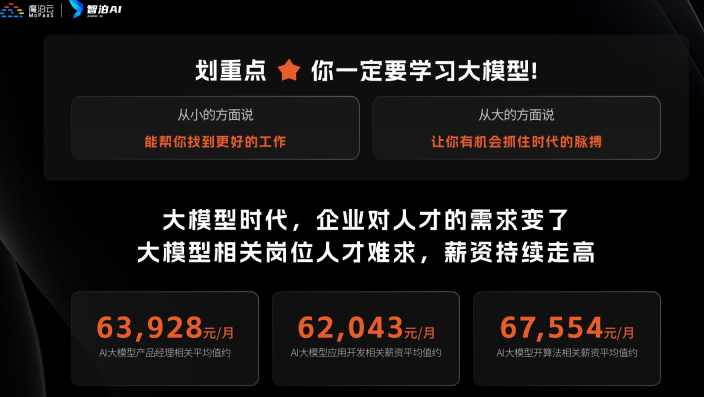
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。
8、适合谁学?
- 传统后端 / Java / 前端开发,想转型 AI 应用
- 大学生、应届生,想拿更好的 offer
- 产品经理、运营,想武装职业竞争力
- 技术负责人,想给团队落地提效
学习是反人性的,但回报是真金白银。技术会更新,赛道会切换,但只要你先动手,机会就永远站在你这边。
9、这些资料真的有用吗?
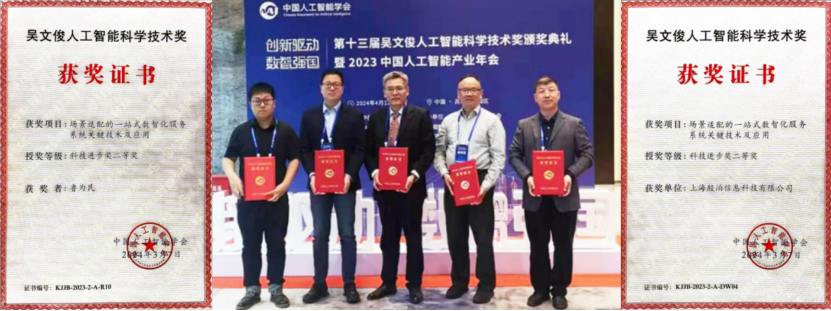
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
好了,就写到这。路线是死的,人是活的,卡住了随时来问我。觉得有用就点个收藏,别让它进收藏夹吃灰——动起来比啥都强。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 0
 0
- 0


 已为社区贡献582条内容

所有评论(0)