让AI越用越懂你:长期记忆不只是存聊天记录
AI Agent 的记忆到底存哪?六层记忆地图 + 存储选型表
导读:Agent 刚记住你就「重启失忆」?问题不在模型,在状态存在哪。本文用一张六层记忆地图 + 存储选型表,讲清 Redis、向量索引、关系库各自适合放什么,末尾附可直接用于项目评审的决策清单。
文章目录
引子:Agent 为什么「重启就失忆」
「Agent 刚记住你的偏好,服务一重启,它又像第一次见面。」这是做 Agent 应用最常被问到的问题之一。
根因不在模型,而在状态管理:模型本身不替应用持久化状态。每次调用能看到什么,取决于应用重新装进上下文的数据。因此有人说:把所有聊天记录塞进向量数据库,不就有记忆了吗?
这是最常见的误区。聊天记录、运行检查点、长期记忆和业务事实,读写方式完全不同,塞进同一个库只会一起变难用。
本文用一张六层记忆地图,讲清 Redis 类键值存储、向量索引、关系库各自适合放什么,并用 AWS 的一表方案做案例,最后给出可直接用于项目评审的决策清单。
一、先拆名词:Agent 到底有几层「记忆」
| 层级 | 内容 | 特征 |
|---|---|---|
| 1 当前上下文 | 本次调用看到的消息、工具结果和指令 | 受上下文窗口限制 |
| 2 会话状态 | 当前轮次、已选商品、未填完的参数 | 与 thread ID 绑定 |
| 3 检查点 | 工作流执行到哪一步、下一步节点、中间结果 | 用于恢复、重放、人工审批 |
| 4 对话与工具轨迹 | 原始对话与工具调用记录 | 服务审计、分析和复盘 |
| 5 跨会话长期记忆 | 用户偏好、已确认目标、长期约束 | 跨会话、需治理 |
| 6 业务事实 | 订单、余额、库存、权限 | 权威数据源,必须实时查询 |
核心区分是:短期记忆是线程级状态(thread-level),长期记忆是跨会话的用户或应用数据(cross-session)。检查点是工作流状态快照,不等于长期语义记忆。
二、一次正常调用,这几类数据怎么协同
以一次真实对话为例,执行顺序大致是:
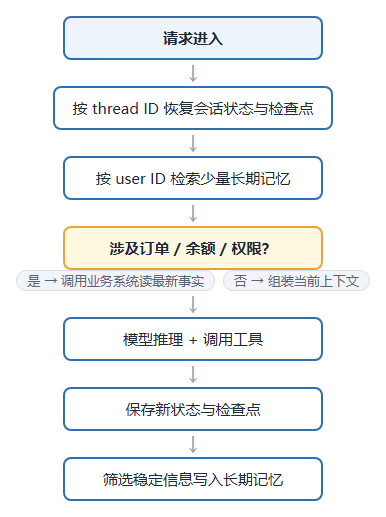
- 请求进入后,先按 thread ID 恢复会话状态和最近检查点;
- 再按 user ID 检索少量相关长期记忆(如座位偏好、历史目标);
- 若涉及订单、权限或余额,调用业务系统读取最新事实;
- 应用把必要信息组装进当前上下文,模型推理并调用工具;
- 执行完成后保存新的状态和检查点。
注意:只有经过筛选的稳定信息才进入长期记忆,不是每一句聊天都值得永久保存。
用流程图表示一次调用的完整链路:
伪代码示意(非官方 SDK 代码):
# 一次 Agent 调用的状态组装(示意)
thread = restore_state(thread_id)           # 会话状态 + 检查点
memories = search_memory(user_id, limit=8)  # 长期记忆(限定租户/用户/类型/时间)
facts = query_business(order, balance)      # 业务事实:实时查权威系统
ctx = assemble(thread, memories, facts, tool_results)
reply = model.invoke(ctx)
save_state(thread_id, reply, checkpoint)
三、存储分工:先看访问模式,别先看产品名
选型的依据不是「Redis 就是缓存」「向量库就是记忆」,而是数据的访问模式:
| 数据类型 | 访问特征 | 推荐存储 |
|---|---|---|
| 会话缓存 | 高频、短生命周期 | 低延迟键值存储(可设过期时间) |
| 检查点 | 需恢复、查历史、有事务约束 | 关系库(持久数据库) |
| 长期记忆 | 语义召回 + 可治理 | 记录库保存元数据 + 向量索引做语义候选 |
| 业务事实 | 实时、强一致 | 留在权威交易库,受控工具实时查询 |
同一种数据库可以承担多个角色,但这些角色的表结构、生命周期和权限不能混在一起。分层不等于分系统:记录库和向量索引可以是同一套数据库里的两种能力,省掉的正是同步和一致性这两笔账。
四、为什么不能全塞进向量库:四条边界
- 相似不等于正确:检索到偏好是有帮助,检索到过期余额就可能直接造成错误。
- 向量相似度不表达事务一致性,也不保证刚写入的数据立刻可见。
- 旧记忆需要失效或降权:用户纠正偏好后,只追加向量会让冲突信息同时被召回。
- 删除权和租户隔离必须落实到原始记录、向量索引、缓存和备份,而不是只删一条文本。举例:金仓 KingbaseES 的「敏感数据销毁」会在 DROP/TRUNCATE 时对数据页做多次 0/1 覆写擦除,把删除落实到存储层。
更准确的说法是:向量索引是长期记忆的检索入口,不是所有记忆的唯一事实源。
五、长期记忆的治理链路:写入、召回、删除
一条长期记忆从聊天里写进去、再被找回来,要经过两道关口:
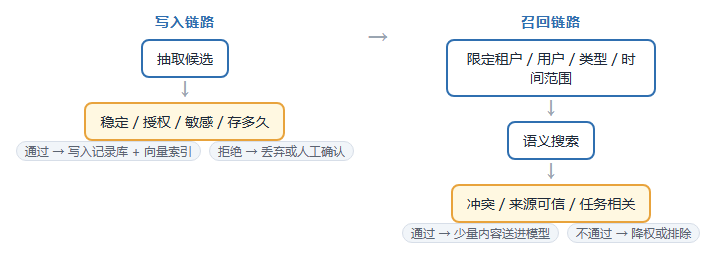
写入时:先抽取候选,再判断是否稳定、是否获得授权、是否含敏感信息、保存多久。合格记录至少带上租户、用户、来源、时间、类型、置信度、版本和过期策略:
{
  "tenant_id": "t-001",
  "user_id": "u-2026",
  "source": "chat:session-9f2c",
  "created_at": "2026-10-09T10:00:00Z",
  "type": "preference",
  "content": "用户偏好靠窗座位",
  "confidence": 0.92,
  "version": 3,
  "expires_at": "2026-12-31T00:00:00Z",
  "deleted": false
}
召回时:先限定租户、用户、记忆类型和时间范围,再做语义搜索,不能跨所有数据裸搜。候选结果还要检查新旧冲突、可信来源和当前任务相关性,最后只把少量必要内容送进模型。
还要防记忆投毒:网页或工具结果里的恶意文字,不能未经审核就变成长期指令。
六、案例:AWS 的一张 DynamoDB 表,收益和限制
AWS 为 Strands Agents 提供了开源后端 strands-dynamodb-storage,把 Strands SDK 自带的统一 Storage 接口落到一张 DynamoDB 表上:会话快照、长期记忆、转录和超大工具结果放不同命名空间。
- 小对象直接读写 DynamoDB;超过 400 KB 的大值转存 S3,表里保留指针;
- 长期记忆可增加向量索引,通过语义搜索召回,同时按租户分区限制搜索范围。
但一张表不等于问题解决。官方说明很清楚:
- 向量索引最终一致,维度和距离函数创建后不可修改,过期删除也可能延迟生效;
- 按租户分区只是缩小查询范围,不是权限边界——有检索权限就能搜到别的分区,租户隔离仍要靠 IAM 和应用层。
统一存储省掉的是部署和同步链路;数据分类、权限、成本、遗忘与纠错,仍然要由应用设计。
七、落地决策顺序:可直接用于项目评审
设计 Agent 记忆层时,按这个顺序问:
先问数据是什么:临时状态、恢复点、长期偏好,还是业务事实?
再看四个指标:
- 需要多快读写?
- 是否必须强一致?
- 是否要语义召回?
- 能否按用户彻底删除?
答案回到上面的分工表:什么数据,进什么库。会话缓存优先考虑 Redis 类键值存储;持久检查点选能稳定恢复和查询的数据库;长期记忆用可治理的记录库加语义索引;业务事实永远回到权威系统实时读取。
Agent 记忆设计的重点,不是记得越多,而是知道什么该记、存多久、何时相信、怎样删除。 把记忆分层之后,数据库选型才会从产品争论,变成可以验证的工程问题。
八、国产化视角:融合数据库的同一条路
对不少行业,Agent 记忆还有一个前置条件:数据能否留在本地、自主可控。
国产数据库也走这条路:金仓 KingbaseES 原生支持高维向量存储与检索,记录库、向量索引和业务事实可在同一引擎内完成——不用在业务库之外再部署一套向量数据库,也不用跨系统同步。Agent 长期记忆天然是中小规模(每用户数百至数千条),正好落在融合架构的舒适区。
讨论:你的 Agent 现在把会话状态、长期记忆和业务数据放在一起了吗?最先遇到的问题是遗忘、串租户,还是旧记忆召回?欢迎评论区交流。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)