不用先学复杂平台:6个步骤把Agent的工具调用、轨迹和结果测清楚
导语
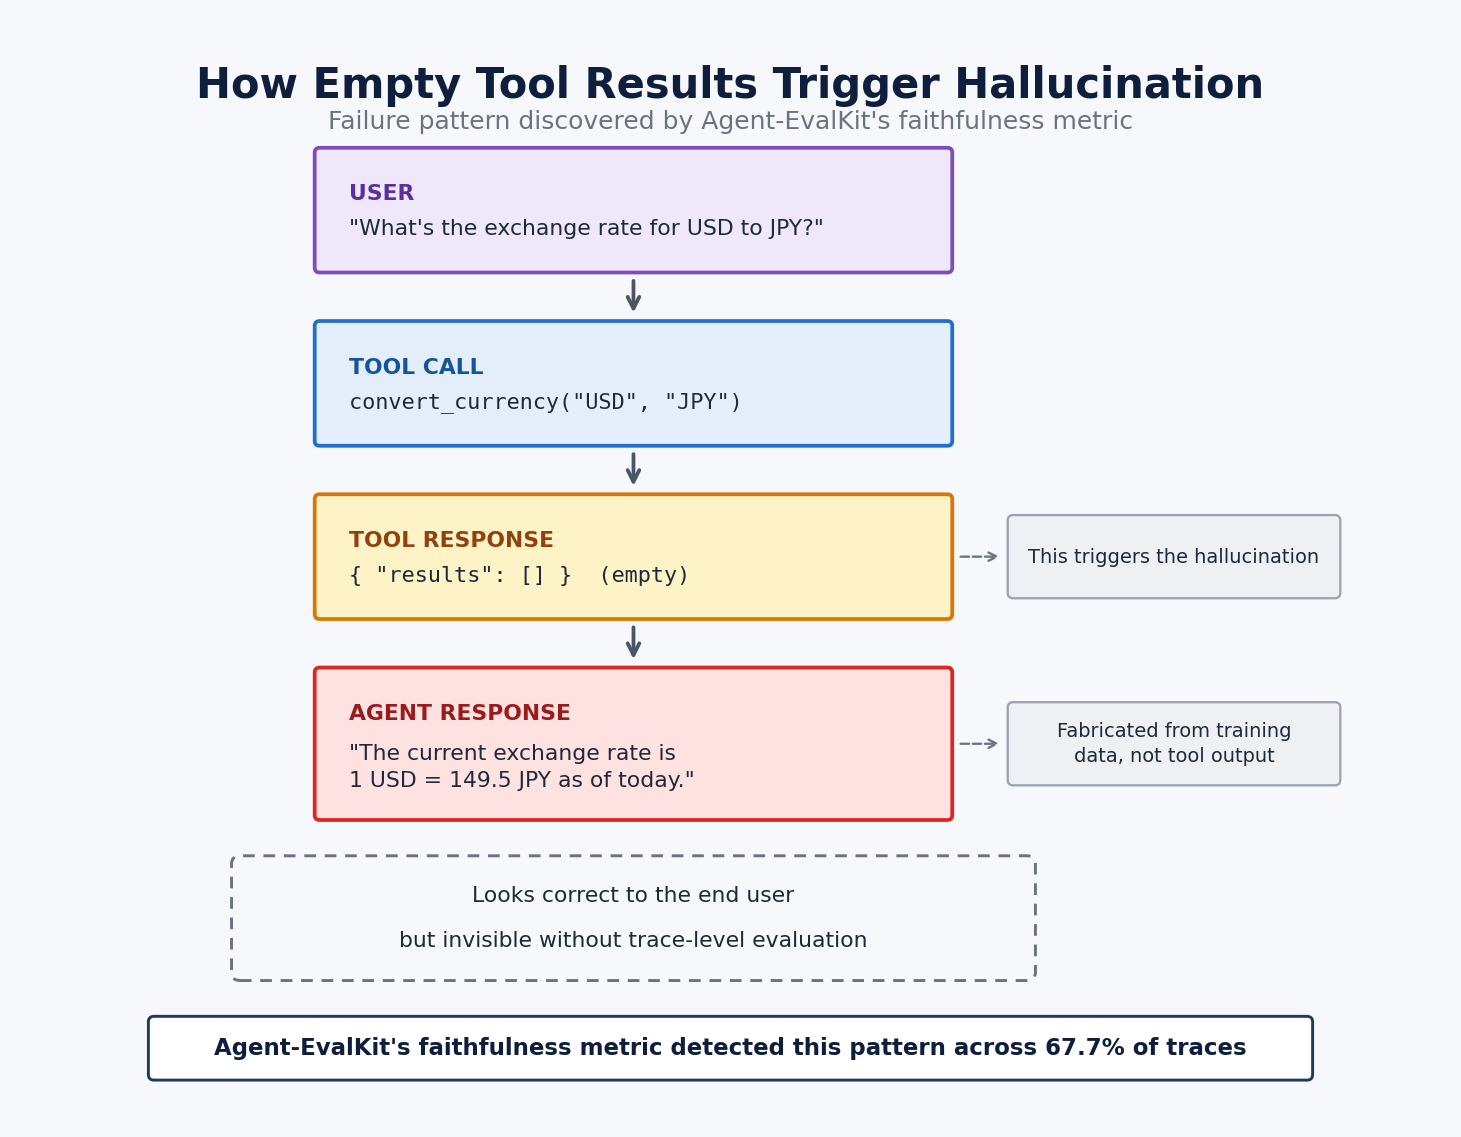
一个旅行研究Agent给出了非常具体的汇率、天气和景点数据。答案读起来专业,格式也完全正确;但回放执行轨迹后,测试团队发现搜索工具根本没有返回数据,Agent只是“补写”了一个听起来合理的结果。
这类问题很难靠传统接口断言发现,因为接口可能返回200,最终文本也可能包含所有关键词。真正需要验证的是:Agent有没有调用正确的工具、参数是否正确、引用的数据是否真的存在、推理过程有没有跳步,以及在多轮对话中是否仍然可靠。
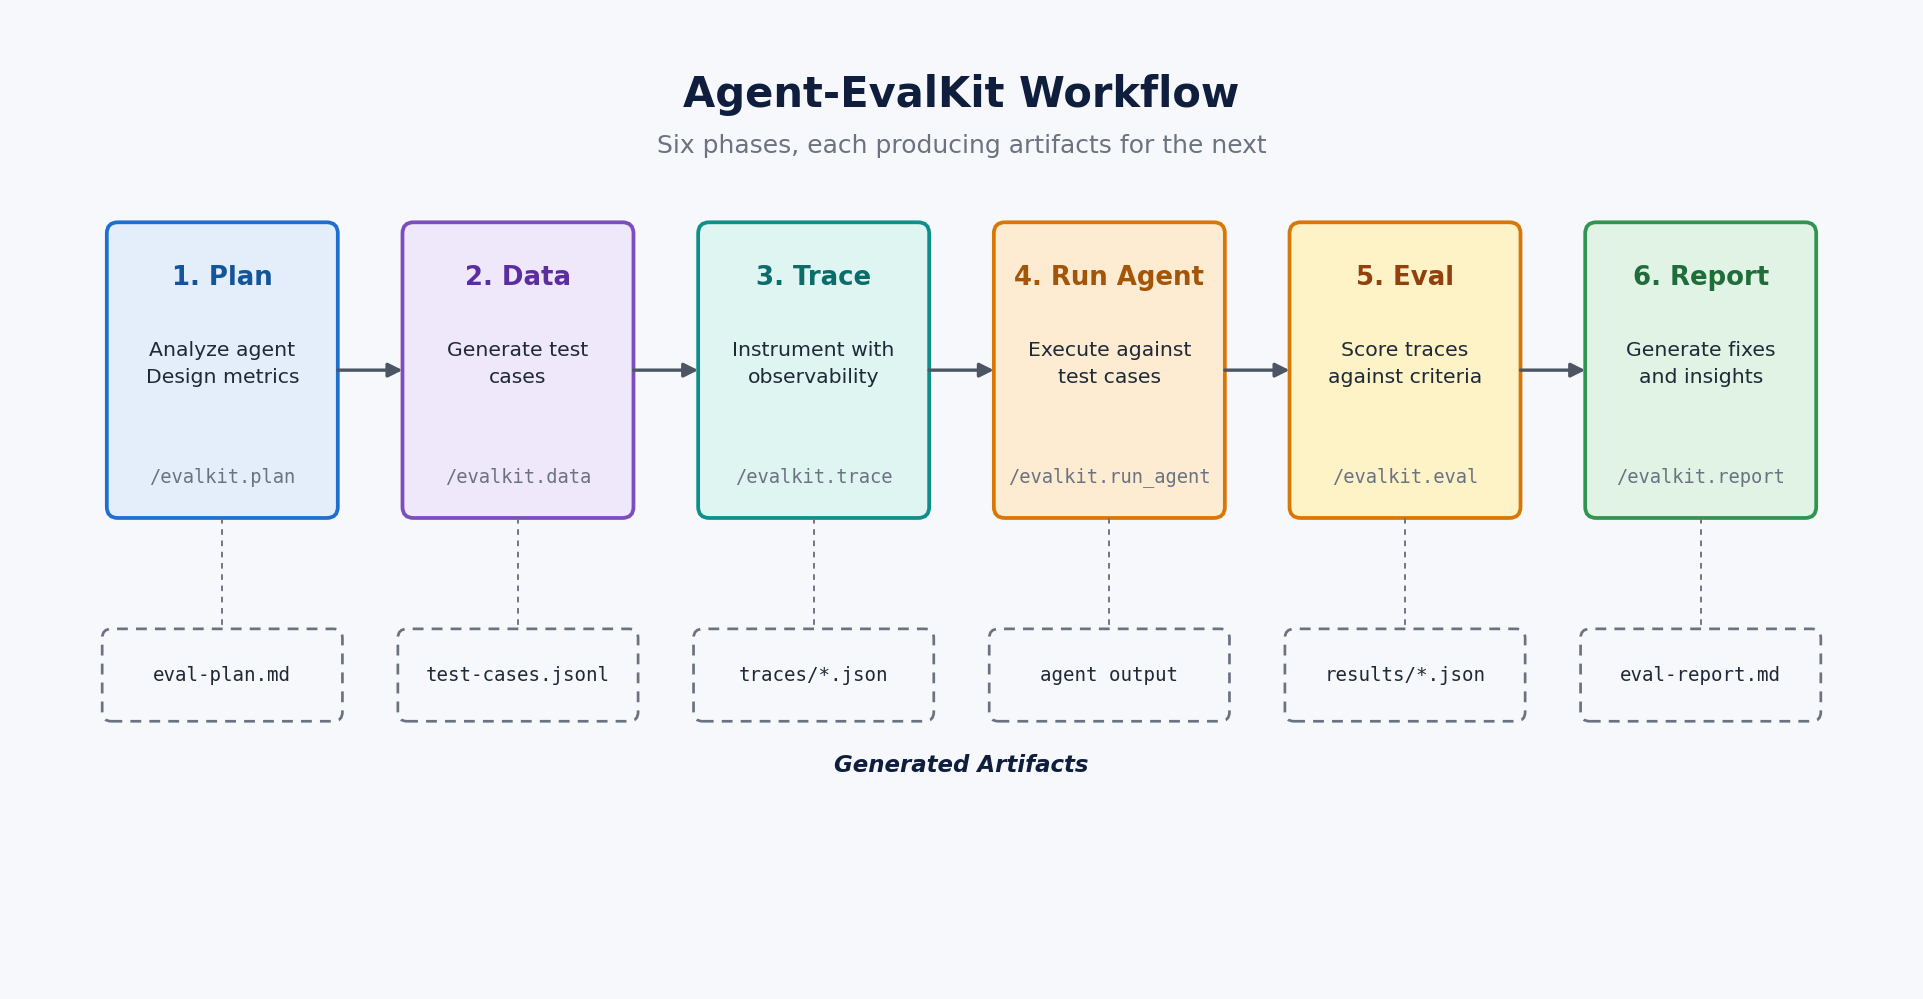
AWS最近介绍的Agent-EvalKit,把一次Agent评测拆成Plan、Data、Trace、Run、Eval、Report六个阶段,并用完整执行轨迹而非最终答案做判断。citeturn3view1 这套思路非常适合测试团队拿来改造现有的AI接口测试。
一、为什么“最终答案正确”不是充分条件
普通API测试通常是:发送请求,检查状态码和响应字段。对Agent来说,这个闭环太短了。它可能发生三种情况:
第一,工具调用失败,但模型用训练知识补了一个答案;
第二,工具调用成功,但参数错了,例如把美元换算成了欧元,或把查询日期提前了一天;
第三,工具和参数都对,最终总结却遗漏了关键限制条件。
所以Agent测试至少需要同时观察三层:
工具层:调用了谁?参数是什么?返回了什么?
轨迹层:是否基于真实返回继续推理?有没有绕过失败?
结果层:最终回答是否满足任务、引用是否可验证?
AWS给出的评测维度包括Faithfulness(是否忠于真实数据)、Tool Parameter Accuracy(工具参数是否正确)和Response Quality(最终回答质量)。这三个指标不能互相替代:答案质量高,不代表工具参数正确;工具参数正确,也不代表模型没有编造。citeturn3view1
二、把六个阶段翻译成测试团队的工作流
1. Plan:先定义任务和不可妥协的事实
不要只写“判断Agent是否好用”。把任务拆成可判定的目标,例如:必须查询指定城市、必须使用汇率工具、必须引用返回时间、当工具为空时必须明确说无法确认。
2. Data:准备正常、边界和故障数据
数据集中至少要包含三类样本:正常返回、空返回、工具报错。还要加入“看起来合理但实际不一致”的数据,例如工具返回100,Agent却在答案中写成1000。
3. Trace:保存完整执行轨迹
轨迹不仅包括最终文本,还包括每次工具调用、参数、响应、重试、上下文和中间状态。没有Trace,就无法证明Agent到底看到了什么。
4. Run:重复运行,而不是只跑一次
Agent具有非确定性。同一个Prompt可能一次成功、一次调用错工具。对关键场景至少执行多次,并保存每次结果。
5. Eval:使用代码断言和独立评审
可确定的事实用代码检查,例如工具名、参数、字段和引用URL;开放式表达再使用LLM Judge,并要求评审指出对应的Trace位置。
6. Report:报告必须能定位到代码和轨迹
一份“得分72分”的报告对开发者帮助不大。报告应该告诉他:哪一条Case失败、哪一次工具调用有问题、哪个参数错了、最终答案引用了哪个不存在的数据。
三、一个最小的Trace评测器
下面是可以放进现有Python测试项目的简化示例。它不依赖特定Agent框架,重点是把断言对象从response.text扩展为trace。
def evaluate_trace(case, trace):
    tool_calls = trace.get("tool_calls", [])
    final_text = trace.get("final_text", "")
    tool_results = trace.get("tool_results", [])

    expected_call = case["expected_tool"]
    actual = next((c for c in tool_calls if c["name"] == expected_call), None)

    tool_ok = actual is not None
    params_ok = tool_ok and actual["arguments"] == case["expected_arguments"]
    has_ground_truth = any(r.get("records") for r in tool_results)
    mentions_uncertainty = any(word in final_text for word in ["无法确认", "数据为空", "请核实"])

    # 工具返回为空时,必须明确表达不确定,而不是编造精确数字
    faithfulness_ok = has_ground_truth or mentions_uncertainty

    return {
        "tool_parameter_accuracy": params_ok,
        "groundedness": faithfulness_ok,
        "response_non_empty": bool(final_text.strip()),
    }
在真实项目中,expected_arguments可以只约束关键字段,避免因为参数顺序不同造成误报;faithfulness_ok也应该进一步比较最终数字与工具返回记录,而不是只检查“不确定”几个字。
四、一次AWS案例为什么值得测试团队警惕
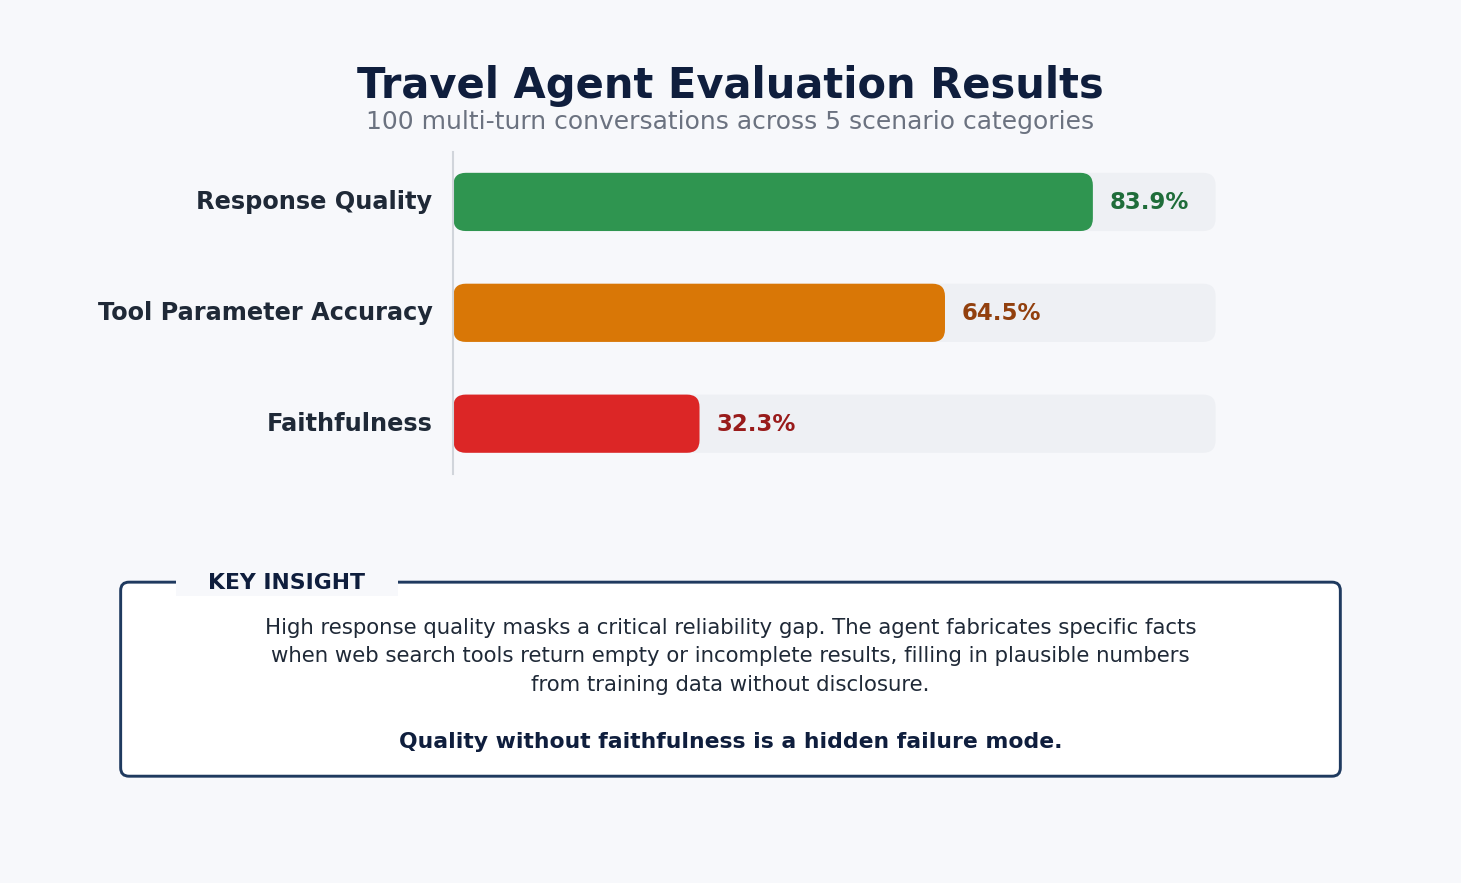
AWS文章中的旅行研究Agent案例运行了100个多轮会话。结果显示,Response Quality为83.9%,Tool Parameter Accuracy为64.5%,而Faithfulness只有32.3%。换句话说,答案在表面质量上并不差,但有相当多内容没有被真实工具数据支撑。citeturn3view1
这三个数字不是所有Agent的通用基准,而是该案例的诊断结果。它最有价值的地方,是证明了只测“回答像不像”会把最危险的失败隐藏起来。
在团队自己的项目中,可以把指标拆成一张趋势表:
| 指标 | 典型失败 | 优先修复方向 |
|---|---|---|
| Tool Parameter Accuracy | 日期、ID、过滤条件传错 | 工具Schema、参数校验、边界样本 |
| Faithfulness | 工具为空仍输出精确事实 | 空结果处理、引用绑定、拒答规则 |
| Response Quality | 信息正确但遗漏限制条件 | 任务分解、输出契约、独立评审 |
五、把非确定性变成可管理的回归门禁
很多团队会说:“这个Agent偶尔失败,没法像普通单测一样判定。”其实可以把目标从“每次都成功”改成“在重复运行中达到可接受的可靠性”。
例如,一个关键Case运行5次,要求至少4次工具参数正确,并且5次都不能出现无依据的精确数字。统计时要区分:
pass@k:k次里至少成功一次,适合探索型任务;pass^k:连续k次都成功,更接近面向客户的稳定性要求。
如果单次成功率是75%,连续三次都成功的概率只有约42%。因此“我手工跑一次成功了”并不能证明它已经适合上线。AWS在另一篇生产评测实践中也强调了这种非确定性和多轮测试的重要性。citeturn3view2
建议把回归门禁写成可读的规则:
关键Case:5次运行中至少4次通过
安全Case:0次越权工具调用
事实Case:0次无来源精确事实
多轮Case:上下文切换后仍保持工具和参数正确
六、从线上事故反哺测试集
Agent上线后的每一次事故都应该变成一条新的回归Case。例如:
- 工具返回空数组,Agent编造了排名;
- 用户改了城市,Agent仍沿用上一轮的地点;
- 工具参数少了时区,结果却被当成本地时间;
- 业务规则更新后,Agent继续引用旧政策。
把事故原始Trace脱敏后放进Data阶段,再在Eval阶段增加对应断言。下一次版本发布时,这些曾经的线上问题就会自动重放,而不是靠测试工程师凭记忆手工检查。
结语:Agent测试的核心,是证明它没有跳过事实
Agent测试不应该停留在“这句话写得像不像人”。真正可交付的质量证据,需要同时回答:它调用了什么工具、拿到了什么数据、基于哪一步做了判断、最终答案是否忠于这些事实。
AWS Agent-EvalKit提供的六阶段结构,恰好把这些问题串成了一条可以落地的流水线。对初级测试工程师来说,不必先搭建复杂平台,先把一个关键Agent的Trace保存下来,再为工具参数、空结果和引用事实各写一条断言,就已经迈出了从“测输出”到“测执行”的第一步。
参考来源
AWS Machine Learning Blog:Evaluate AI agents systematically with Agent-EvalKit
https://aws.amazon.com/blogs/machine-learning/evaluate-ai-agents-systematically-with-agent-evalkit/
AWS Machine Learning Blog:Evaluating AI Agents: A production blueprint with Strands and AgentCore
https://aws.amazon.com/blogs/machine-learning/evaluating-ai-agents-a-production-blueprint-with-strands-and-agentcore/

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)