大模型第三期:10分钟入门深度学习神经网络
预告:
明日更新最新技术AgentSkills,有兴趣的麻烦点点关注哦
一、神经网络概念
1、定义
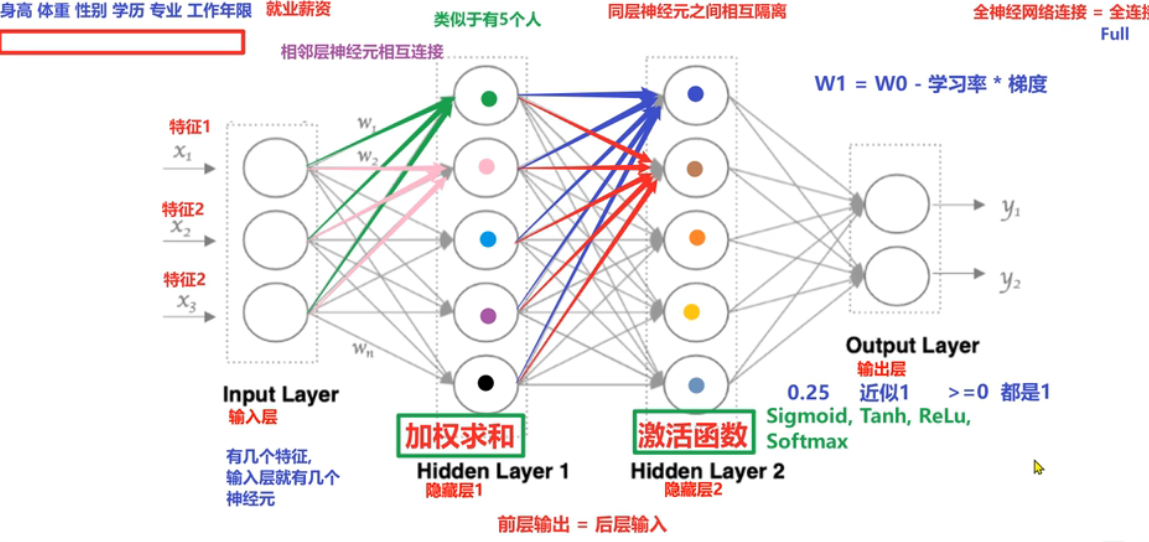
神经网络就是模仿人脑神经网络对数据进行加工处理的模型
2、组成
输入层+隐藏层+输出层
-
样本数据输入必须是二维形式,nidim=2
-
样本几个特征,输入层就有几个神经元
-
同层神经元相互隔离, 第N层每个神经元会和N-1层所有神经元连接,每个连接都有权重值
-
隐藏层每层神经元数量一般前面多一些,后面少一些
-
输入层输出层各一层,隐藏层数量可任意设置
-
网络层数一般指的是输出层+隐藏层层数
二、激活函数
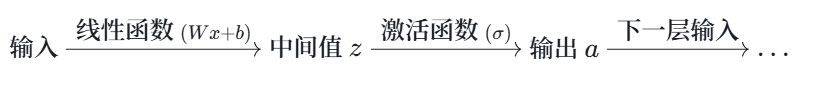
在隐藏层和输出层中,使用线性和非线性函数共同组成每层的处理逻辑,以此来拟合现实世界各种复杂关系,其中非线性函数也被称为激活函数:
隐藏层激活函数的选择:ReLu>tahn>sigmoid
输出层:二分类用sigmoid,多分类用softmax
1)sigmoid函数-二分类
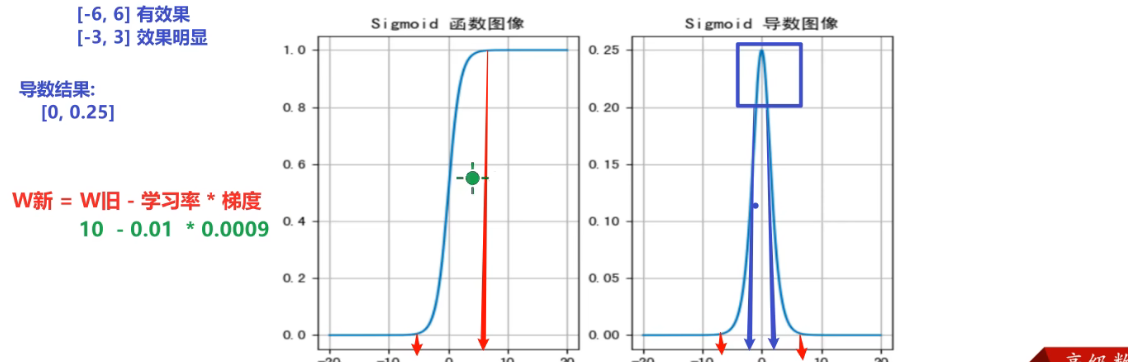
函数 : f(x) = 1/(1+e^-x) --> 范围【0,1】
求导 : f'(x) = f(x)(1-f(x)) --> 范围【0,0.25】
适用场景:
主要用于二分类的输出层,且适用浅层网络
加权求和结果数据在【-6,6】明显,【-3,3】之间效果最好
缺点 :网络层超过5层,会导致梯度消失问题,0.25^9太小了,权重计算没有变化
2)tanh函数---(sigmoid函数的改进版)
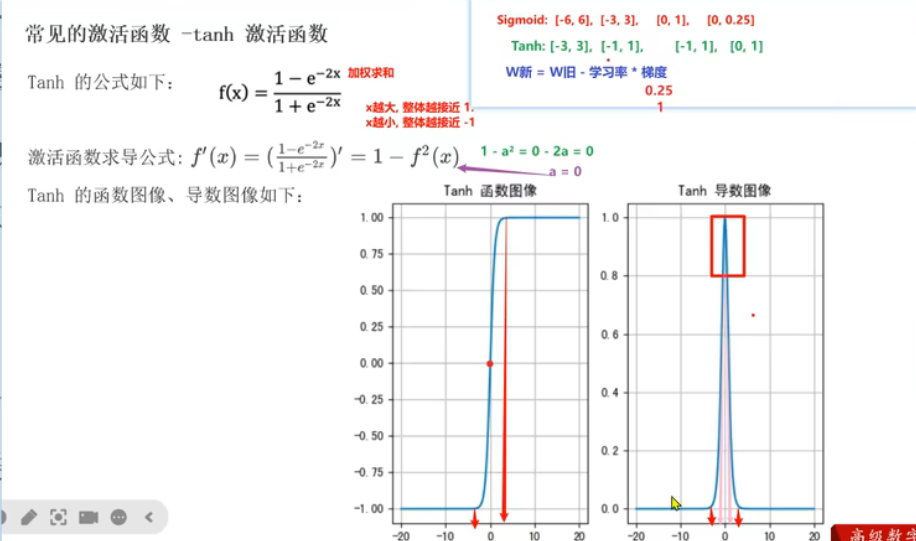
函数在(-1,1),导数在(0,1)间
缺点:仍然存在梯度消失问题
优点:梯度比sigmoid大,收敛速度比sigmoid快,迭代次数少
适用场景:
主要用于隐藏层,适用浅层网络
加权求和结果数据在【-3,3】明显,【-1,1】之间效果最好
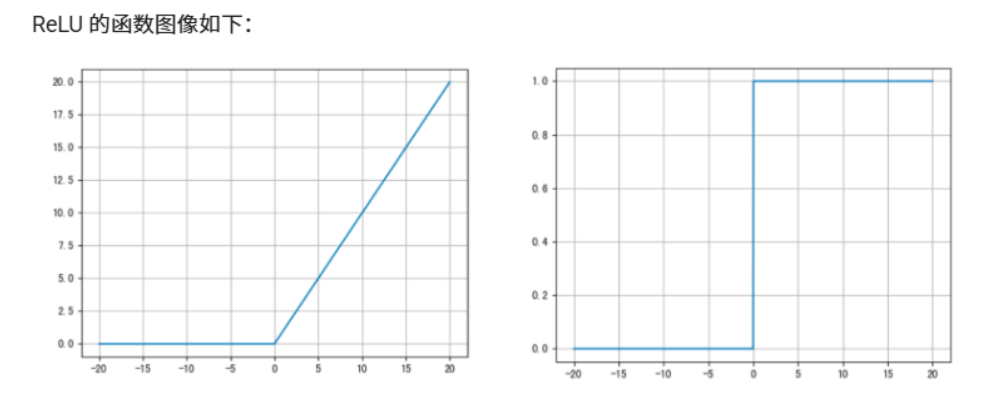
3)ReLu 激活函数【最常用】
函数 : f(x) = max(0,x)
导数范围:0或者1
优点:样本大于0时,梯度恒为1,解决了梯度消失的问题
缺点:样本小于0时,梯度为0,不会再变化,会造成神经元死亡
适用场景:主要用于隐藏层,且适用深层神经网络
为什么会造成神经元死亡?
1-初始化权重太小导致z无限接近0,计算式出现波动落入负值区域
2-学习率太大,梯度跨步太大,导致权重落入负值
3-权重设置了负值,z<0直接死亡
解决神经元死亡的ReLU变体:LeakyReLU,PRelu
LeakyReLU (x<0,0.01x,x)在小于0的区域添加一个0.01的导数,缓解权重不更新的问题
进阶-PReLU (x<0,ax,x)在小于0的区域自定义值
4)softmax 多分类
作用:将多分类的结映射为概率的形式展现,概率和为1,选取概率最大的值作为结果
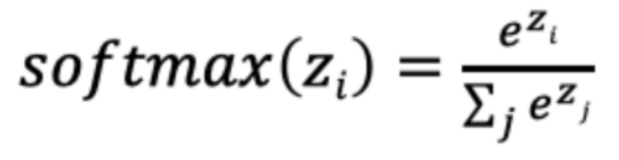
适用场景:主要用于输出层的多分类
简单记忆就是隐藏层用Relu及其变体,输出层二分类用sigmoid,多分类用softmax
三、权重初始化
为了提高模型收敛速度,防止梯度消失或爆炸,对参数进行人为初始化设置,有很多初始化方法,但是都不实用用,我们只需要掌握均匀分布、正态分布、Kaiming/HE初始化、Xavier初始化方法即可。
基础初始化方法
1)均匀分布初始化torch.nn.init.uniform_()
权重从区间随机取值,默认(0,1)
适用场景:线性简单模型或者改进
2)正态分布初始化/标准化:torch. nn.init.normal_()
权重从均值为0,标准差为1的高斯分布采样,再缩放为最小的值
Kaiming/HE初始化 - 何凯明提出
1)正态分布的Kaiming- nn.init.kaiming_normal_()
在【0-std】抽取样本,std = sqrt(2/fan_in)
2)均匀分布的Kaiming- nn.init.kaiming_uniform_()
在 [-limit,limit] 抽取样本,limit是 sqrt(6 / fan_in)
Xavier初始化/Glorot初始化
1)正态分布的Xavier:nn.init.xavier_normal_()
2)均匀分布的Xavier:nn.init.xavier_uniform_()
如何选择
深层的一定要用kaiming和xavier,浅层的话都可以
四、损失函数
定义:比较输出和真实值的差异
别名:损失函数、代价函数、目标函数、误差函数
1、分类损失
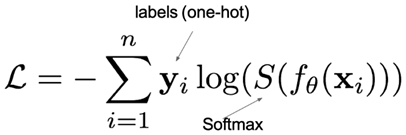
1)多分类交叉熵损失函数 nn.CrossEntropyLoss() ,适用于softmax损失
2)二分类交叉熵损失 nn.BCELoss() , 适用于 sigmoid损失
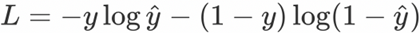
2、回归损失
1)MAE损失-nn.L1Loss()平均绝对值误差损失函数
Mean absolute loss(MAE)也被称为L1 Loss,以绝对误差作为距离
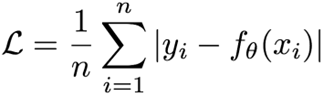
2)MSE损失 -nn.MSELoss() 均方误差函数
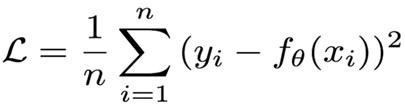
Mean Squared Loss/ Quadratic Loss也被称为L2 loss,或欧氏距离,它以误差的平方和的均值作为距离
3)平滑L1损失函数Smooth L1
顾名思义,这是平滑后的L1Loss也就是MAE
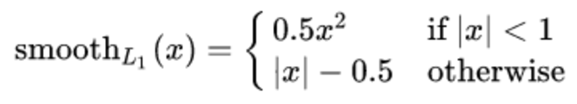
解决了L1Loss梯度不连续问题、L2Loss梯度爆炸问题
应用场景:既想在误差小时有稳定的梯度(像MSE),又想在误差大时对异常值不敏感(像MAE)
五、网络优化方法
1、梯度下降算法
寻找使损失函数最小化的方法。从数学上的角度来看,梯度的方向是函数增长速度最快的方向,那么梯度的反方向就是函数减少最快的方向
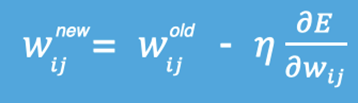
BGD批量梯度下降:每次用全部数据更新,计算慢但是稳定
SGD随机梯度下降:每次用一个样本更新,速度快,噪声大
Mini-Batch SGD小批量梯度下降,最常用,前两者折中,训练样本数/批次更新
实际上torch.optim.SGD指的是Mini-Batch SGD
在torch.optim.SGD,可以通过调整 batch_size 来控制使用多少样本,实现哪种算法
2、梯度下降优化器
梯度下降过程中存在如下问题:
- 平坦区域梯度下降很慢,接近0,神经元接近死亡,模型收敛速度慢
- 鞍点区域,梯度为0,模型可能误认为极值点
- 局部最小值:模型很难察觉是不是全局最优值
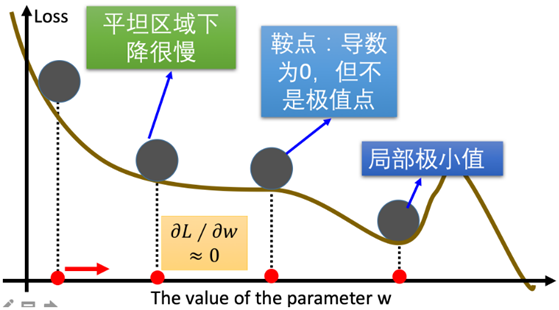
基于以上问题设置了梯度优化器,缓解三个错误区域的频率
1)指数加权平均算法
距离越远的数字对平均数计算的贡献就越小(权重较小),距离越近则对平均数的计算贡献就越大(权重越大)
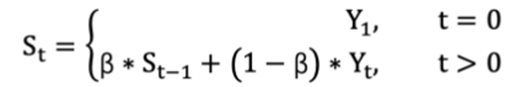
2)动量算法
-
Dt = β * St-1 + (1- β) * Wt
-
Dt-1上次加权梯度 Dt本次加权梯度 Wt本次样本的梯度 β自定义权重
作用:Momentum 使用移动加权平均,平滑了梯度的变化,使得前进方向更加平缓,有利于加快训练过程
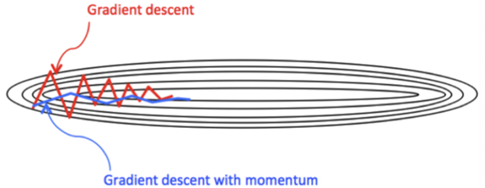
optimzer = torch.optim.SGD(model.parameters(),lr=0.1,momentum=0.9)
momentum默认是0
3)Adagrad
学习率会“自动适应”不同参数的梯度规模
以前梯度总和大,学习率就调小,以前梯度总和小,学习率就调大
4)RMSPorp:“移动平均”替代累积,防止Adagrad的学习率过快衰减
optimzer = torch.optim.RMSprop(model.parameters(),lr=0.1,alpha=0.9)
5)Adam自适应矩估计:
将 Momentum 和 RMSProp 算法结合在一起。
1.修正梯度: 使⽤梯度的指数加权平均
2.修正学习率: 使⽤梯度平⽅的指数加权平均。
optimizer = optim.Adam(params=[w], lr=0.1, betas=(0.9, 0.999))
3、学习率调度器
1)等间隔学习率衰减
scheduler_lr = optim.lr_scheduler.StepLR(optimizer, step_size=50, gamma=0.5)
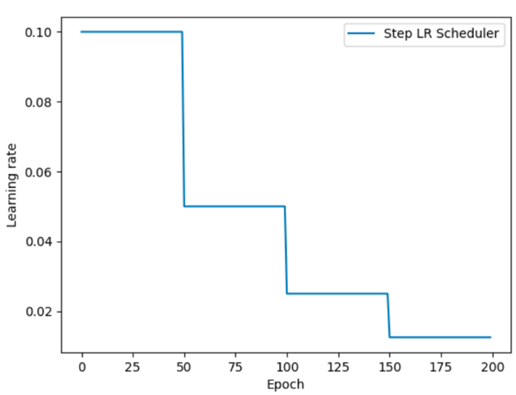
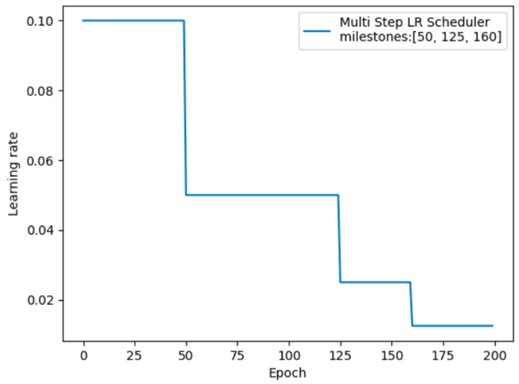
2)指定间隔衰减学习率
指定具体轮次、下降比例milestones = [50, 125, 160]
scheduler_lr = optim.lr_scheduler.MultiStepLR(optimizer, milestones=milestones, gamma=0.5)
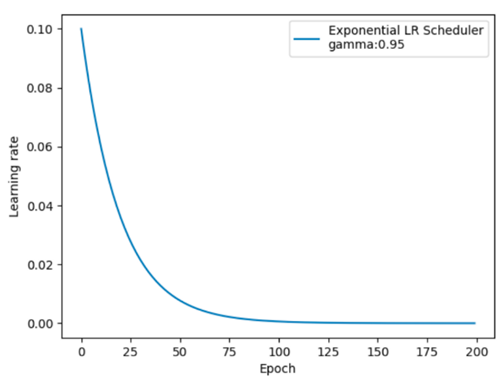
指数衰减学习率
scheduler_lr = optim.lr_scheduler.ExponentialLR(optimizer, gamma=0.95)
六、正则化方法
1、概念
防止模型过拟合(训练集好、测试集差)提高模型泛化能力的方法
2、Dropout正则化
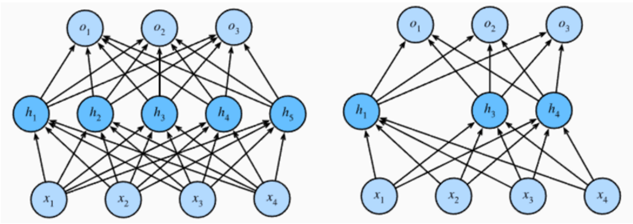
随机失活机制:训练时,让每个神经元以概率 p随机“死亡”
丢弃概率 p的经验值:一般在0.2-0.5,简单模型第低、复杂模型容易过拟合,丢弃概率要高;
数值缩放与模式切换:训练时存活的神经元放大信号,测试时没有随机失活要再缩小信号
dropout = nn.Dropout(p=0.4)
d1 = dropout(output)
3、批量归一化
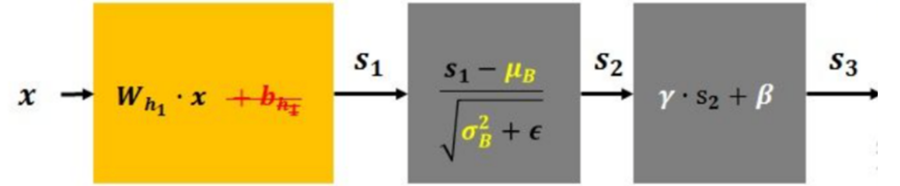
γ 和 β 是可学习的参数,它相当于对标准化后的值做了一个线性变换,γ 为系数,β 为偏置;
eps 通常指为 1e-5,避免分母为 0。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 23
 0
- 0


 已为社区贡献3条内容

所有评论(0)