强化学习学习笔记
<1>强化学习基本概念
智能体可以根据不同的状态(state)做出不同行动(action),而这些不同的行动所构成的集合叫作行动空间。智能体在s1状态下做出a1动作转移到s2状态就叫作状态转移(状态转移函数P)。而不同的状态下的价值是不一样的,有些state不好,我们不想到达这种state,有些state又是我们想要到达的,那如何来衡量状态的好坏呢?我们可以给每一个状态给与一个反馈(reward)。当一个机器人采取某个action到达某个状态后,完成了状态转移所获得的及时反馈(一个奖励)就叫作reward function(奖励函数R)。
我们还需要一些数学基本概念:
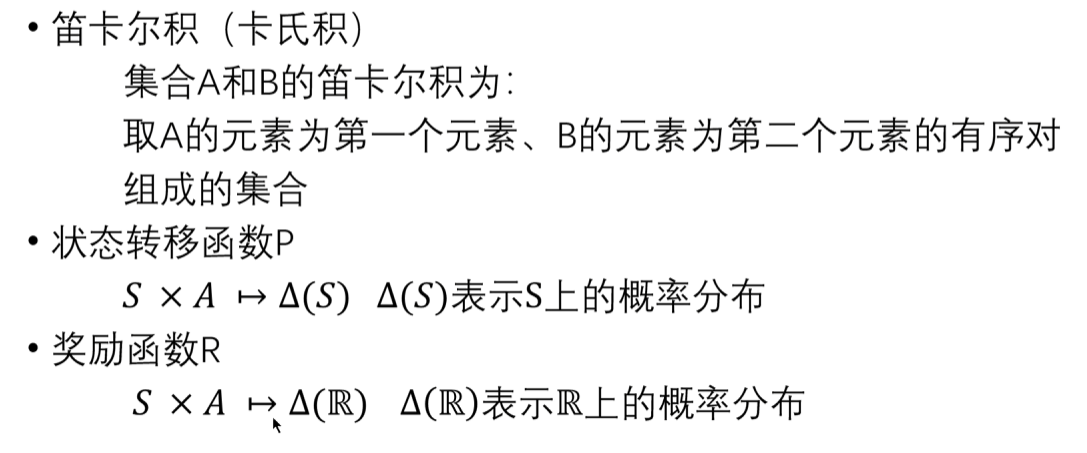
我们的状态如何转移和奖励能有多大都取决于当前状态S和动作A的笛卡尔积,映射成为一个概率,由这个概率分布来决定。
而强化学习算法大体可以分为两种,基于价值,基于策略。强化学习是与环境env进行交互,得到当前state下最优的一个action或者是动作策略,这个action或是动作策略又会使得state变化也就是状态转移。
(1)DQN算法(基于价值)
原理:将state与action构成的Q表不再以表格形式去查询,而是转换为神经网络,将它看作一个黑盒子,输入state后我就能得到action。用一个平衡杆游戏例子进行说明。
(一)单模型
1.定义游戏环境
class MyWrapper(gym.Wrapper):
    def __init__(self, env):
        env = gym.make('CartPole-v1',render_mode='rgb_array')
        super().__init__(env)
        self.env = env
        self.step_n=0
    def reset(self):
        state,_ = self.env.reset()
        self.step_n=0
        return state
    def step(self, action):
        state,reward,terminated,truncated,info = self.env.step(action)
        over = terminated or truncated
        self.step_n+=1
        if self.step_n>200:
            over = True
        if over and self.step_n<200:
            reward-=1000
        return state,reward,over
    def show(self):
        plt.figure(figsize=(3,3))
        plt.imshow(self.env.render())
        plt.show()
2.定义神经网络
平衡车游戏:4个状态输入,中间两层含64个神经元的神经网络,输出2个action对于的Q值即做这个动作的价值,要么左要么右。
model = torch.nn.Sequential(
    torch.nn.Linear(4,64),
    torch.nn.ReLU(),
    torch.nn.Linear(64,64),
    torch.nn.ReLU(),
    torch.nn.Linear(64,2)
)
3.play函数
#玩一局游戏并记录数据,在data_pool里面我们才会使用到play函数
def play(env,show=False):
    data=[]
    reward_sum = 0
    state = env.reset()
    over = False
    while not over:
        action = model(torch.FloatTensor(state).reshape(1,4)).argmax().item()
        next_state,reward,over = env.step(action)
        data.append((state,action,reward,next_state,over))
        reward_sum += reward
        state = next_state
    return data,reward_sum
4.数据池data Pool
class Pool(MyWrapper):
    def __init__(self):
        self.pool = []
    def __len__(self):
        return len(self.pool)
    def __getitem__(self,idx):
        return self.pool[idx]
    def update(self):
        old_len = len(self.pool)
        while len(self.pool)-old_len<200:
            data=play(self.env)[0]
            self.pool.extend(data)
            self.pool.append(play(self.env)[0])
        self.pool = self.pool[-2_0000:]
    def sample(self):
        data = random.sample(self.pool,64)

        state = torch.FloatTensor(i[0] for i in data).reshape(-1,4)
        action = torch.FloatTensor(i[0] for i in data).reshape(-1,1)
        reward = torch.FloatTensor(i[0] for i in data).reshape(-1,1)
        next_state = torch.FloatTensor(i[0] for i in data).reshape(-1,4)
        over = torch.FloatTensor(i[0] for i in data).reshape(-1,1)
        return state,action,reward,next_state,over
5.训练
def train(pool):
    model.train()
    optimizer = torch.optim.Adam(model.parameters(),lr=2e-4)
    loss_fn = torch.nn.MSELoss()
    #更新N数据
    for epoch in range(1000):
        pool.update()#玩一千局游戏
        for i in range(200):#两百次一组,分五组
            state,action,reward,next_state,over = pool.sample()
            value = model(state).gather(1,action)
            with torch.no_grad():
                target = model_delay(next_state)
            target = target.max(1)[0].reshape(-1,1)
            target = target*0.99*(1-over)+reward

            loss = loss_fn(value,target)
            loss.backward()
            optimizer.step()
            optimizer.zero_grad()
(二)还可以使用双模型DQN:
因为如果只有单模型的话会造成对价值高估,因为只有一个模型来算,所有的参数又都是它自己算出来的,target只要高,value就高,value高,target又会高,左脚踩右脚。所以引入双模型,第二个模型只是第一个模型的延迟更新。
多的部分:
model = torch.nn.Sequential(
    torch.nn.Linear(4,64),
    torch.nn.ReLU(),
    torch.nn.Linear(64,64),
    torch.nn.ReLU(),
    torch.nn.Linear(64,2)
)
model_delay = torch.nn.Sequential(
    torch.nn.Linear(4, 64),
    torch.nn.ReLU(),
    torch.nn.Linear(64, 64),
    torch.nn.ReLU(),
    torch.nn.Linear(64, 2)
)
#复制参数
model_delay.load_state_dict(model.state_dict())
def train(pool):
    model.train()
    optimizer = torch.optim.Adam(model.parameters(),lr=2e-4)
    loss_fn = torch.nn.MSELoss()
    #更新N数据
    for epoch in range(1000):
        pool.update()#玩一千局游戏
        for i in range(200):#两百次一组,分五组
            state,action,reward,next_state,over = pool.sample()
            value = model(state).gather(1,action)
            with torch.no_grad():
                target = model_delay(next_state)
            target = target.max(1)[0].reshape(-1,1)
            target = target*0.99*(1-over)+reward

            loss = loss_fn(value,target)
            loss.backward()
            optimizer.step()
            optimizer.zero_grad()
    if (epoch+1)%5==0:
        model_delay.load_state_dict(model.state_dict())
区别:会话处使用model_delay以及延迟更新model_delay
(三)DQN改进:加权数据池
在更新动作池中添加了一个维护概率表,普通的版本在采样时对所有的数据都一视同仁;而这样加了一个概率表之后每次采样每个数据(state,action,reward,next_state,over)的时候就会有所选择,相当于给每条数据加了一个权重:
class Pool(MyWrapper):
    def __init__(self):
        self.pool = []
    def __len__(self):
        return len(self.pool)
    def __getitem__(self,idx):
        return self.pool[idx]
    def update(self):
        old_len = len(self.pool)
        while len(self.pool)-old_len<200:
            data=play(self.env)[0]
            self.pool.extend(data)
            #此处只是维护概率表
            self.prob.extend([1,0]*len(data))#每次插入数据的时候都把所有数据的概率初始化为1.0,prob就是个列表,这些都是老的数据的权重,新数据的概率在train中实现
            self.pool.append(play(self.env)[0])
        self.pool = self.pool[-2_0000:]
    def sample(self):
        idx = torch.randperm(len(self.prob).clamp(0.1,1.0).multinomial(
            num_samples=64,replacement=False
        )#这里生成概率权重
        data = random.sample(self.pool,64)

        state = torch.FloatTensor(i[0] for i in data).reshape(-1,4)
        action = torch.FloatTensor(i[0] for i in data).reshape(-1,1)
        reward = torch.FloatTensor(i[0] for i in data).reshape(-1,1)
        next_state = torch.FloatTensor(i[0] for i in data).reshape(-1,4)
        over = torch.FloatTensor(i[0] for i in data).reshape(-1,1)
        return state,action,reward,next_state,over
在train中添加新数据的概率:在计算loss时根据概率进行缩放以及根据loss调整权重
def train(pool):
    model.train()
    optimizer = torch.optim.Adam(model.parameters(),lr=2e-4)
    loss_fn = torch.nn.MSELoss()
    #更新N数据
    for epoch in range(1000):
        pool.update()#玩一千局游戏
        for i in range(200):#两百次一组,分五组
            state,action,reward,next_state,over = pool.sample()
            value = model(state).gather(1,action)
            with torch.no_grad():
                target = model_delay(next_state)
            target = target.max(1)[0].reshape(-1,1)
            target = target*0.99*(1-over)+reward
            #根据概率缩放loss
            r = torch.FloatTensor([pool.prob[i] for i in pool.idx])#把概率取出来
            r = (1-r).clamp(0.1,1.0).reshape(-1,1)#clamp让概率限制在0.1~1.0中,太小的数据把他提到最小值,太大的数据把他降到最大值
            (loss*r).mean(0).backward()#这里的loss加了权重之后自然也要改,mean计算算数平均数
            loss.backward()
            optimizer.step()
            optimizer.zero_grad()
        #根据loss调整权重
        for i,j in zip(pool.idx.tolist(),
                           loss.abs().sigmoid().flatten().tolist()):
                pool.prob[i]=j
    if (epoch+1)%5==0:
        model_delay.load_state_dict(model.state_dict())
(四)DQN改进:Double DQN
原理:使用原模型model计算动作action,使用model_delay计算target,缓解自举(也就是高估价值)
with torch.no_grad():
    action = model(next_state).argmax(1,keepdim=True)
    target = model_delay(next_state).gather(1,action)
Dueling DQN和Noise DQN都是在原有的基础上改神经网络模型,希望得到优化,一个减少计算量,一个增加随机性
(五)DQN改进:Dueling DQN
使用一个不同的神经网络模型来计算Q值(action之后的所有价值和)
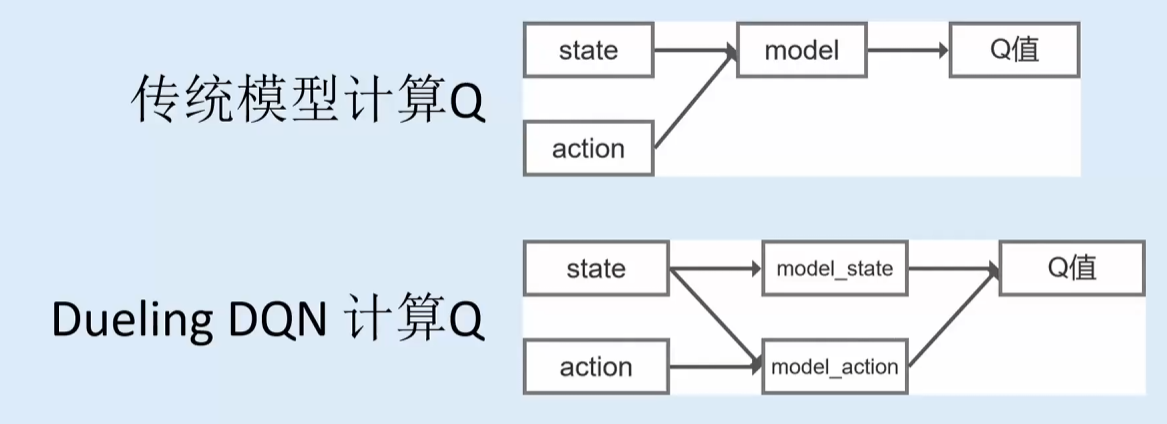
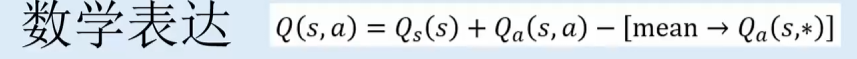
传统Q函数使用一个神经网络计算,Dueling DQN使用两个模型:model_state只评估当前这个状态下的价值;model_action评估在这个状态下做这个动作的价值,每个model的工作量更小,目标更明确。
传统会计算每个状态下做每个动作的价值(绝对价值),而Dueling DQN只会计算某一个状态下做每个动作的价值也就是找出这个动作比其他动作是好还是不好(相对价值)
class Model(torch.nn.Module):
    def __init__(self):
        super().__init__()

        self.fc = torch.nn.Sequential(
            torch.nn.Linear(4, 64),
            torch.nn.ReLU(),
            torch.nn.Linear(64, 64),
            torch.nn.ReLU(),
        )#两个model前面部分是一样的
        self.fc_action = torch.nn.Linear(64, 2)#输出两个action的Q值
        self.fc_state = torch.nn.Linear(64, 1)#输出一个state
       def forward(self, state):#前向传播计算Q值
           state = self.fc(state)
           value_state = self.fc_state(state)
           value_action = self.fc_action(action)
           return value_state+value_action-value_action.mean(1, keepdim=True)
(六)Noise DQN
添加探索性,不希望面对同一个状态时只用以前的动作,避免死板。
与Dueling DQN一样,都是改模型,这里添加了随机性,更改了网络中的W,b参数
class Model(torch.nn.Module):
    def __init__(self):
        super().__init__()

        self.fc = torch.nn.Sequential(
            torch.nn.Linear(4, 64),
            torch.nn.ReLU(),
            torch.nn.Linear(64, 64),
            torch.nn.ReLU(),
        )
        #输出层参数的均值和标准差
        self.weght_mean= torch.nn.Parameter(torch.randn(64,2))
        self.weght_std= torch.nn.Parameter(torch.randn(64,2))
        self.bias_mean= torch.nn.Parameter(torch.randn(2))
        self.bias_std= torch.nn.Parameter(torch.randn(2))

       def forward(self, state):
           state = self.fc(state)
           weight = self.weght_mean + torch.randn(64,2)*self.bias_std
           bias = self.bias_mean + torch.randn(2)*self.bias_std
           #运行时不要随机,只是在训练时随机
           if not self.training:
               weight = self.weght_mean
               bias = self.bias_mean
           return state.matmul(weight),bias#matmul是矩阵乘法
值。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 5
 0
- 0


 已为社区贡献2条内容

所有评论(0)