【大模型应用】软著材料文件生成助手
🚀 从0到1打造桌面应用:软著自动生成工具
前言:作为一个经常需要申请软件著作作品的开发者,你是否也曾为繁琐的文档整理工作而烦恼?今天我将分享一个基于Python开发的桌面应用软著自动生成工具,它能够智能扫描代码、自动生成符合软著申请要求的标准化文档。本文将详细解析从架构设计到技术实现的完整过程。
📋 目录
项目背景与需求分析
💡 痛点发现
在软件开发过程中,申请软件著作权是一个常见但耗时的工作。传统方式需要:
- 手动整理65页代码文档
- 撰写软件特点说明书
- 准备用户操作手册
- 确保格式符合规范要求
这个过程通常需要2-3天的工作时间,而且容易出错。于是我开始思考:能否用自动化工具来解决这个问题?
🎯 需求定义
经过分析,我确定了以下核心需求:
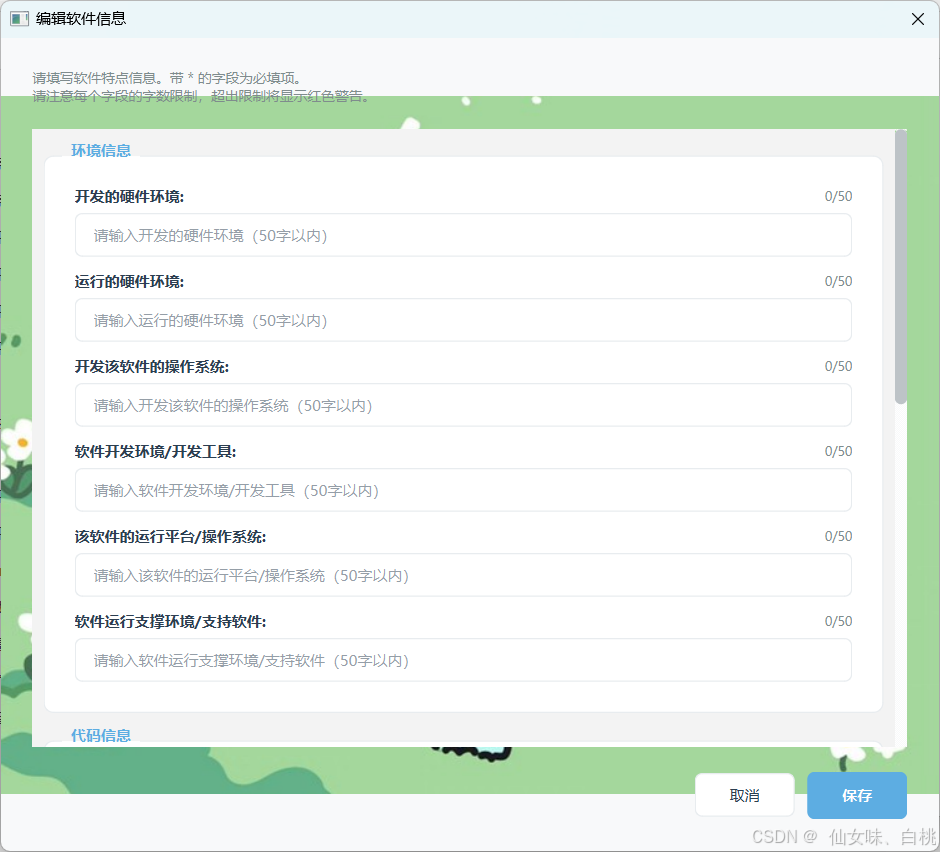
- 智能代码扫描:自动识别项目中的核心代码文件
- 多语言支持:支持前端、后端、配置文件等多种文件类型
- AI内容生成:基于项目内容自动生成技术描述
- 标准化格式:严格按照软著申请要求生成文档
- 用户友好界面:提供简单易用的图形界面
技术选型与架构设计
🔧 技术栈选择
经过综合评估,我选择了以下技术栈:
前端UI框架:PySide6 (Qt for Python)
AI集成框架:LangChain + 大模型API
文档处理:python-docx
编程语言:Python 3.8+
选择理由:
- PySide6:现代化、跨平台、UI组件丰富
- LangChain:AI集成的标准框架,支持多种模型
- python-docx:Word文档处理的成熟解决方案
🏗️ 架构设计
采用分层架构模式,将系统分为四个层次:
┌─────────────────────────────────────┐
│           UI层 (表示层)              │
│  ┌─────────┐ ┌─────────┐ ┌─────────┐ │
│  │主窗口   │ │配置对话框│ │进度对话框│ │
│  └─────────┘ └─────────┘ └─────────┘ │
├─────────────────────────────────────┤
│         业务逻辑层 (Business)        │
│  ┌─────────┐ ┌─────────┐ ┌─────────┐ │
│  │代码扫描 │ │AI生成   │ │文档生成 │ │
│  └─────────┘ └─────────┘ └─────────┘ │
├─────────────────────────────────────┤
│         数据访问层 (Data)            │
│  ┌─────────┐ ┌─────────┐ ┌─────────┐ │
│  │文件操作 │ │Word处理 │ │配置管理 │ │
│  └─────────┘ └─────────┘ └─────────┘ │
├─────────────────────────────────────┤
│         模型层 (Models)              │
│  ┌─────────┐ ┌─────────┐ ┌─────────┐ │
│  │数据模型 │ │配置模型 │ │异常定义 │ │
│  └─────────┘ └─────────┘ └─────────┘ │
└─────────────────────────────────────┘
核心模块实现解析
📁 代码扫描模块
EnhancedCodeScanner 是系统的核心模块之一,负责智能识别和分类代码文件。
关键实现
class EnhancedCodeScanner:
    def __init__(self):
        # 支持的编程语言分类
        self.frontend_extensions = {'.html', '.css', '.js', '.jsx', '.ts', '.tsx', '.vue'}
        self.backend_extensions = {'.py', '.java', '.cs', '.go', '.php', '.cpp', '.c'}
        self.config_extensions = {'.json', '.yaml', '.yml', '.xml', '.ini', '.conf'}

        # 需要过滤的目录
        self.excluded_dirs = {
            'node_modules', '.git', 'venv', 'env', '__pycache__',
            'dist', 'build', 'target', 'bin', 'obj'
        }

    def scan_project(self, project_path: str) -> List[CodeFile]:
        """递归扫描项目目录"""
        code_files = []

        for root, dirs, files in os.walk(project_path):
            # 过滤不需要的目录
            dirs[:] = [d for d in dirs if not self._should_exclude_dir(d)]

            for file in files:
                if self._is_code_file(file):
                    file_path = os.path.join(root, file)
                    code_file = self._analyze_file(file_path, project_path)
                    if code_file:
                        code_files.append(code_file)

        return code_files
核心特性:
- 支持35+种编程语言识别
- 智能过滤第三方库和构建产物
- 自动分类:前端、后端、配置文件
- 文件大小限制(避免处理过大的二进制文件)
📊 代码统计分析模块
CodeStatisticsAnalyzer 负责对扫描到的代码进行统计分析:
class CodeStatisticsAnalyzer:
    def analyze_statistics(self, code_files: List[CodeFile]) -> CodeStatistics:
        stats = CodeStatistics()

        for code_file in code_files:
            # 统计有效代码行数(排除空行和注释)
            effective_lines = self._count_effective_lines(code_file.content)
            code_file.lines_count = effective_lines

            # 按语言分类统计
            language = code_file.language
            stats.language_stats[language] = stats.language_stats.get(language, 0) + effective_lines

            # 前后端分类统计
            if self._is_frontend_language(language):
                stats.frontend_lines += effective_lines
            else:
                stats.backend_lines += effective_lines

        stats.total_lines = sum(stats.language_stats.values())
        return stats
统计维度:
- 总代码行数
- 各语言代码行数及占比
- 前端/后端代码分布
- 文件数量统计
📝 文档生成模块
DocumentGeneratorWorkflow 是整个系统的协调器,负责异步执行文档生成任务:
class DocumentGeneratorWorkflow(QThread):
    # 信号定义
    progress_updated = Signal(int, str)
    generation_completed = Signal(dict)
    generation_failed = Signal(str)

    def run(self):
        try:
            # 1. 扫描代码文件
            self.progress_updated.emit(10, "正在扫描项目文件...")
            code_files = self.scanner.scan_project(self.project_path)

            # 2. 分析代码统计
            self.progress_updated.emit(20, "正在分析代码统计...")
            statistics = self.analyzer.analyze_statistics(code_files)

            # 3. 生成AI内容
            self.progress_updated.emit(30, "正在生成AI技术描述...")
            ai_content = self.ai_generator.generate_content(self.software_info, statistics)

            # 4. 生成Word文档
            self.progress_updated.emit(60, "正在生成代码文档...")
            doc_path = self.doc_generator.generate_document(code_files, self.software_info)

            self.progress_updated.emit(100, "文档生成完成!")
            self.generation_completed.emit({
                'document_path': doc_path,
                'statistics': statistics,
                'ai_content': ai_content
            })

        except Exception as e:
            self.generation_failed.emit(f"生成过程中出现错误:{str(e)}")
关键特性:
- 异步执行,避免阻塞UI界面
- 实时进度更新
- 完善的错误处理机制
- 信号槽机制实现松耦合
AI智能生成功能实现
🤖 LangChain集成
使用LangChain框架集成大语言模型,实现智能内容生成:
class AIContentGenerator:
    def __init__(self, api_key: str, base_url: str = None):
        self.llm = ChatOpenAI(
            model="gpt-3.5-turbo",
            openai_api_key=api_key,
            openai_api_base=base_url,
            temperature=0.7
        )

    def generate_content(self, software_info: SoftwareDetails, statistics: CodeStatistics):
        prompt = self._build_prompt(software_info, statistics)

        try:
            response = self.llm.invoke(prompt)
            return self._parse_ai_response(response.content)
        except Exception as e:
            logger.error(f"AI生成失败: {e}")
            return self._get_fallback_content(software_info)

    def _build_prompt(self, software_info: SoftwareDetails, statistics: CodeStatistics):
        """构建专业的软著申请提示词"""
        prompt = f"""
        请基于以下信息,为软件著作权申请生成专业的技术描述:

        软件名称:{software_info.software_name}
        软件版本:{software_info.version_number}
        开发语言:{', '.join(statistics.language_stats.keys())}
        代码行数:{statistics.total_lines}行
        前端代码:{statistics.frontend_lines}行 ({statistics.frontend_ratio:.1f}%)
        后端代码:{statistics.backend_lines}行 ({statistics.backend_ratio:.1f}%)

        请生成以下内容:
        1. 软件主要功能和技术特点(200-300字)
        2. 技术架构和创新点(150-200字)
        3. 应用场景和价值(100-150字)

        要求:专业、准确、符合软著申请标准。
        """
        return prompt
🎯 智能识别技术栈
系统能够基于文件扩展名和代码内容自动识别项目的技术栈:
def identify_tech_stack(self, code_files: List[CodeFile]) -> Dict[str, List[str]]:
    """识别项目使用的技术栈"""
    tech_stack = {
        'frontend': [],
        'backend': [],
        'database': [],
        'frameworks': [],
        'tools': []
    }

    # 分析文件内容识别框架
    for code_file in code_files:
        content = code_file.content.lower()

        if code_file.language == 'JavaScript':
            if 'react' in content or 'jsx' in content:
                tech_stack['frontend'].append('React')
            elif 'vue' in content:
                tech_stack['frontend'].append('Vue.js')
            elif 'angular' in content:
                tech_stack['frontend'].append('Angular')

        elif code_file.language == 'Python':
            if 'django' in content:
                tech_stack['backend'].append('Django')
            elif 'flask' in content:
                tech_stack['backend'].append('Flask')
            elif 'fastapi' in content:
                tech_stack['backend'].append('FastAPI')

    return tech_stack
用户界面设计实践
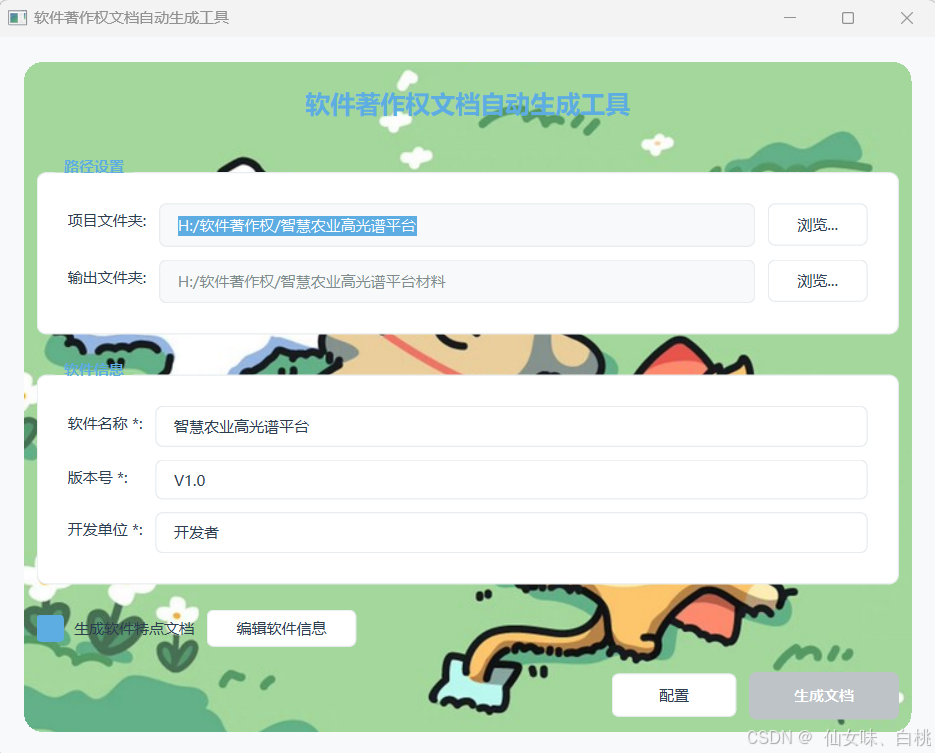
🎨 小清新风格设计
采用现代化的设计语言,打造清新舒适的用户界面:
颜色系统
COLORS = {
    'primary': '#5DADE2',      # 清新蓝
    'secondary': '#48C9B0',    # 薄荷绿
    'success': '#58D68D',      # 清新绿
    'warning': '#F39C12',      # 温暖橙
    'danger': '#E74C3C',       # 活力红
    'dark': '#2C3E50',         # 深灰蓝
    'light': '#ECF0F1',        # 浅灰
}
主界面布局
class MainWindow(QMainWindow):
    def __init__(self):
        super().__init__()
        self.setup_ui()
        self.apply_styles()

    def setup_ui(self):
        """设置主界面布局"""
        central_widget = QWidget()
        self.setCentralWidget(central_widget)

        # 主布局
        main_layout = QVBoxLayout(central_widget)
        main_layout.setSpacing(20)
        main_layout.setContentsMargins(30, 30, 30, 30)

        # 标题区域
        title_widget = self.create_title_section()
        main_layout.addWidget(title_widget)

        # 功能卡片区域
        cards_widget = self.create_function_cards()
        main_layout.addWidget(cards_widget)

        # 底部信息区域
        footer_widget = self.create_footer_section()
        main_layout.addWidget(footer_widget)
界面特色:
- 卡片式设计,层次分明
- 渐变色按钮,视觉效果出色
- 自定义背景图片支持
- 响应式布局,适配不同屏幕
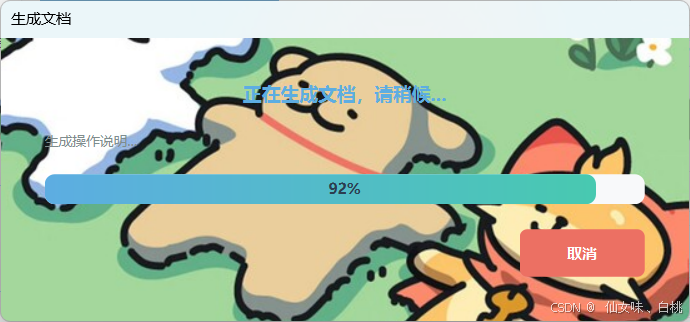
📊 实时进度显示
使用渐变色进度条实时显示文档生成进度:
class ProgressDialog(QDialog):
    def __init__(self):
        super().__init__()
        self.setup_ui()

    def setup_ui(self):
        """设置进度对话框"""
        layout = QVBoxLayout(self)

        # 进度条
        self.progress_bar = QProgressBar()
        self.progress_bar.setFixedHeight(25)
        self.progress_bar.setTextVisible(True)
        self.progress_bar.setStyleSheet("""
            QProgressBar {
                border: none;
                border-radius: 12px;
                background-color: #E8F6F3;
            }
            QProgressBar::chunk {
                border-radius: 12px;
                background: qlineargradient(x1:0, y1:0, x2:1, y2:0,
                    stop:0 #48C9B0, stop:1 #5DADE2);
            }
        """)

        # 状态标签
        self.status_label = QLabel("准备开始...")
        self.status_label.setAlignment(Qt.AlignCenter)

        layout.addWidget(self.status_label)
        layout.addWidget(self.progress_bar)

        # 取消按钮
        cancel_btn = ModernButton("取消任务", "danger")
        cancel_btn.clicked.connect(self.reject)
        layout.addWidget(cancel_btn)
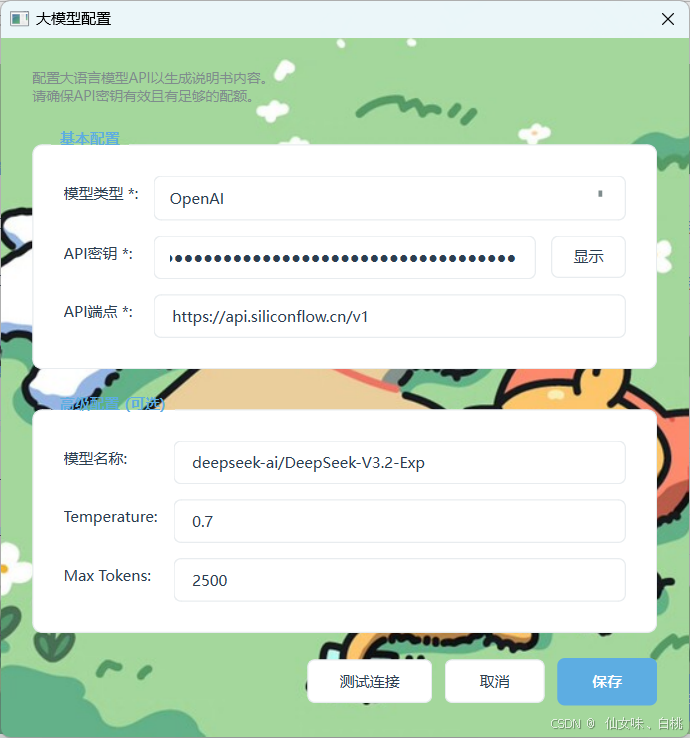
⚙️ 配置管理界面
提供直观的API配置界面,支持多种大模型服务:
class ConfigDialog(QDialog):
    def __init__(self, config_manager: ConfigManager):
        super().__init__()
        self.config_manager = config_manager
        self.setup_ui()
        self.load_current_config()

    def setup_ui(self):
        """设置配置界面"""
        layout = QVBoxLayout(self)

        # API配置区域
        api_group = QGroupBox("API配置")
        api_layout = QFormLayout(api_group)

        # API密钥输入
        self.api_key_input = QLineEdit()
        self.api_key_input.setEchoMode(QLineEdit.Password)
        self.api_key_input.setPlaceholderText("请输入API密钥")

        # API地址输入
        self.api_base_input = QLineEdit()
        self.api_base_input.setPlaceholderText("例如:https://api.openai.com/v1")

        # 模型选择
        self.model_combo = QComboBox()
        self.model_combo.addItems([
            "gpt-3.5-turbo",
            "gpt-4",
            "gpt-4-turbo-preview",
            "claude-3-sonnet",
            "通义千问",
            "文心一言"
        ])

        api_layout.addRow("API密钥:", self.api_key_input)
        api_layout.addRow("API地址:", self.api_base_input)
        api_layout.addRow("模型选择:", self.model_combo)

        layout.addWidget(api_group)

        # 测试按钮
        test_btn = ModernButton("测试连接", "secondary")
        test_btn.clicked.connect(self.test_api_connection)
        layout.addWidget(test_btn)
性能优化与稳定性保障
🚀 性能优化策略
1. 内存管理
class CodeFile:
    """代码文件数据模型,支持延迟加载"""
    def __init__(self, file_path: str, relative_path: str):
        self.file_path = file_path
        self.relative_path = relative_path
        self._content = None  # 延迟加载文件内容

    @property
    def content(self) -> str:
        """延迟加载文件内容,节省内存"""
        if self._content is None:
            try:
                with open(self.file_path, 'r', encoding='utf-8') as f:
                    self._content = f.read()
            except UnicodeDecodeError:
                # 尝试其他编码
                with open(self.file_path, 'r', encoding='gbk') as f:
                    self._content = f.read()
        return self._content
2. 异步处理
使用QThread实现异步任务处理,避免界面冻结:
def start_document_generation(self):
    """开始文档生成任务"""
    # 获取用户输入
    project_path = self.project_input.text()
    software_info = self.get_software_info()

    # 创建工作线程
    self.workflow = DocumentGeneratorWorkflow(
        project_path=project_path,
        software_info=software_info
    )

    # 连接信号
    self.workflow.progress_updated.connect(self.update_progress)
    self.workflow.generation_completed.connect(self.on_generation_completed)
    self.workflow.generation_failed.connect(self.on_generation_failed)

    # 显示进度对话框
    self.progress_dialog = ProgressDialog()
    self.progress_dialog.canceled.connect(self.workflow.terminate)

    # 启动工作线程
    self.workflow.start()
    self.progress_dialog.exec_()
3. 缓存机制
实现智能缓存,避免重复计算:
class CachedStatisticsAnalyzer:
    def __init__(self):
        self._cache = {}
        self._cache_ttl = 3600  # 缓存1小时

    def analyze_statistics(self, code_files: List[CodeFile]) -> CodeStatistics:
        """带缓存的统计分析"""
        cache_key = self._generate_cache_key(code_files)

        # 检查缓存
        if cache_key in self._cache:
            cached_time, cached_result = self._cache[cache_key]
            if time.time() - cached_time < self._cache_ttl:
                logger.info("使用缓存的统计结果")
                return cached_result

        # 计算结果
        result = self._compute_statistics(code_files)

        # 存入缓存
        self._cache[cache_key] = (time.time(), result)

        return result
🛡️ 稳定性保障
1. 异常处理
class DocumentGeneratorWorkflow(QThread):
    def run(self):
        try:
            # 核心逻辑执行
            result = self._execute_workflow()
            self.generation_completed.emit(result)

        except FileNotFoundError as e:
            error_msg = f"文件未找到:{str(e)}"
            logger.error(error_msg)
            self.generation_failed.emit(error_msg)

        except PermissionError as e:
            error_msg = f"权限不足:{str(e)}"
            logger.error(error_msg)
            self.generation_failed.emit(error_msg)

        except Exception as e:
            error_msg = f"未知错误:{str(e)}"
            logger.exception(error_msg)
            self.generation_failed.emit(error_msg)

        finally:
            # 清理资源
            self._cleanup_resources()
2. 日志系统
实现完善的日志记录系统:
class Logger:
    """单例日志管理器"""
    _instance = None

    def __new__(cls):
        if cls._instance is None:
            cls._instance = super().__new__(cls)
            cls._instance._initialized = False
        return cls._instance

    def __init__(self):
        if self._initialized:
            return

        # 创建日志目录
        log_dir = os.path.join(os.path.expanduser("~"), "Kiro文档", "logs")
        os.makedirs(log_dir, exist_ok=True)

        # 配置日志文件
        log_file = os.path.join(log_dir, f"kiro_{datetime.now().strftime('%Y%m%d')}.log")

        # 设置日志格式
        logging.basicConfig(
            level=logging.INFO,
            format='%(asctime)s - %(name)s - %(levelname)s - %(message)s',
            handlers=[
                RotatingFileHandler(
                    log_file,
                    maxBytes=10*1024*1024,  # 10MB
                    backupCount=5,
                    encoding='utf-8'
                ),
                StreamHandler()  # 同时输出到控制台
            ]
        )

        self._initialized = True

    @staticmethod
    def get_logger(name: str) -> logging.Logger:
        return logging.getLogger(name)
3. 配置验证
class ConfigValidator:
    @staticmethod
    def validate_config(config: dict) -> Tuple[bool, List[str]]:
        """验证配置有效性"""
        errors = []

        # 验证必需字段
        required_fields = ['api_key', 'model']
        for field in required_fields:
            if not config.get(field):
                errors.append(f"缺少必需字段:{field}")

        # 验证API密钥格式
        api_key = config.get('api_key', '')
        if len(api_key) < 10:
            errors.append("API密钥格式不正确")

        # 验证URL格式
        api_base = config.get('api_base', '')
        if api_base and not api_base.startswith(('http://', 'https://')):
            errors.append("API地址格式不正确")

        return len(errors) == 0, errors
开发总结与未来展望
📈 项目成果
技术指标:
- 代码量:8000+行Python代码
- 模块数量:27个核心模块文件
- 支持语言:35+种编程语言
- 文档生成时间:从2-3天缩短到5-10分钟
🔧 技术难点与解决方案
1. 多语言代码解析
难点:不同编程语言的注释规则和语法特点差异很大
解决方案:
- 建立语言特征库,定义每种语言的注释规则
- 使用正则表达式和状态机进行词法分析
- 针对特殊语言编写专门的解析器
2. Word文档格式控制
难点:精确控制文档页数达到65页要求
解决方案:
- 动态调整字体大小、行间距、页边距
- 智能分页,避免代码块被截断
- 实现页眉页脚自动化设置
3. AI内容质量保障
难点:确保AI生成的内容符合软著申请的专业要求
解决方案:
- 精心设计提示词模板
- 多轮迭代优化生成效果
- 提供手动编辑和修改功能
🤝项目下载
项目地址:https://github.com/masskx
贡献方式:
- 提交Bug报告和功能建议
- 贡献代码和新功能
- 完善文档和测试
- 分享使用经验
如果这篇文章对你有帮助,欢迎点赞、收藏和转发!有相关问题也可以在评论区讨论交流。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 17
 0
- 0


 已为社区贡献2条内容

所有评论(0)