在 bisheng 平台搭建「主-子智能体」协同:弱模型适配、执行效率与问题记录
在 bisheng 平台搭建「主-子智能体」协同:弱模型适配、执行效率与问题记录
关键词:多智能体编排 / 低能力模型适配 / 确定性引擎化 / 长文本落盘 / ReAct 协议陷阱 / 失败可见性
场景:在bisheng平台搭建多智能体协同(专家智能体 → 逻辑流图智能体 → 部署方案智能体 → 部署流图智能体 ),并跑通"总智能体规划主导 + 子智能体执行"。核心关注点:
- 把"智能"从模型手里拿回到引擎手里——模型只做判断,确定性工作(模块绑定、XML 生成、校验、上传、重试、状态缓存)全部沉淀到 Java 引擎,通过 MCP 工具暴露。用代码来做确定性工作,既能减小模型负担,加快响应速度,同时也减少token的消耗。
- 把长文本赶出聊天链路——所有大 payload(IR、部署方案、图 XML)走"工具参数 + 服务端状态 + 落盘文件",聊天里只传一行路径;
- 适配 ReAct 协议的硬约束——平台强制每轮输出单个 JSON blob,且工具调用与 FinalAnswer 的
action_input类型不同;这两条一旦踩错,就是"500 崩溃/解析失败/死循环重试"。最终形态):专家(总)只澄清、取标准模板 IR、原样转发需求全文、驱动确认 → 三个"执行> 员"子智能体各调自己的引擎工具(参数子自己查参数清单)→ 聊天全程只有"单行回显行"与文件 路径 → 部署方案定稿为
deploy.json,上传只读该定稿。这套结构在弱模型上连跑通过,崩溃面被设计性地清零。
Bisheng多智能体协同配置
目标平台 Bisheng 是内网部署的助手/工作流平台(支持 内置/API/MCP工具集成)。实测得到的能力边界:助手/流水线不能直接调助手/流水线 , 必须绕道发布为 API ,在助手/流水线中接入API 工具调用。助手绑定工具 :内置 / API / MCP / 技能 助手可拿 MCP 工具,也可调平台 API。以下为API工具配置的截图。
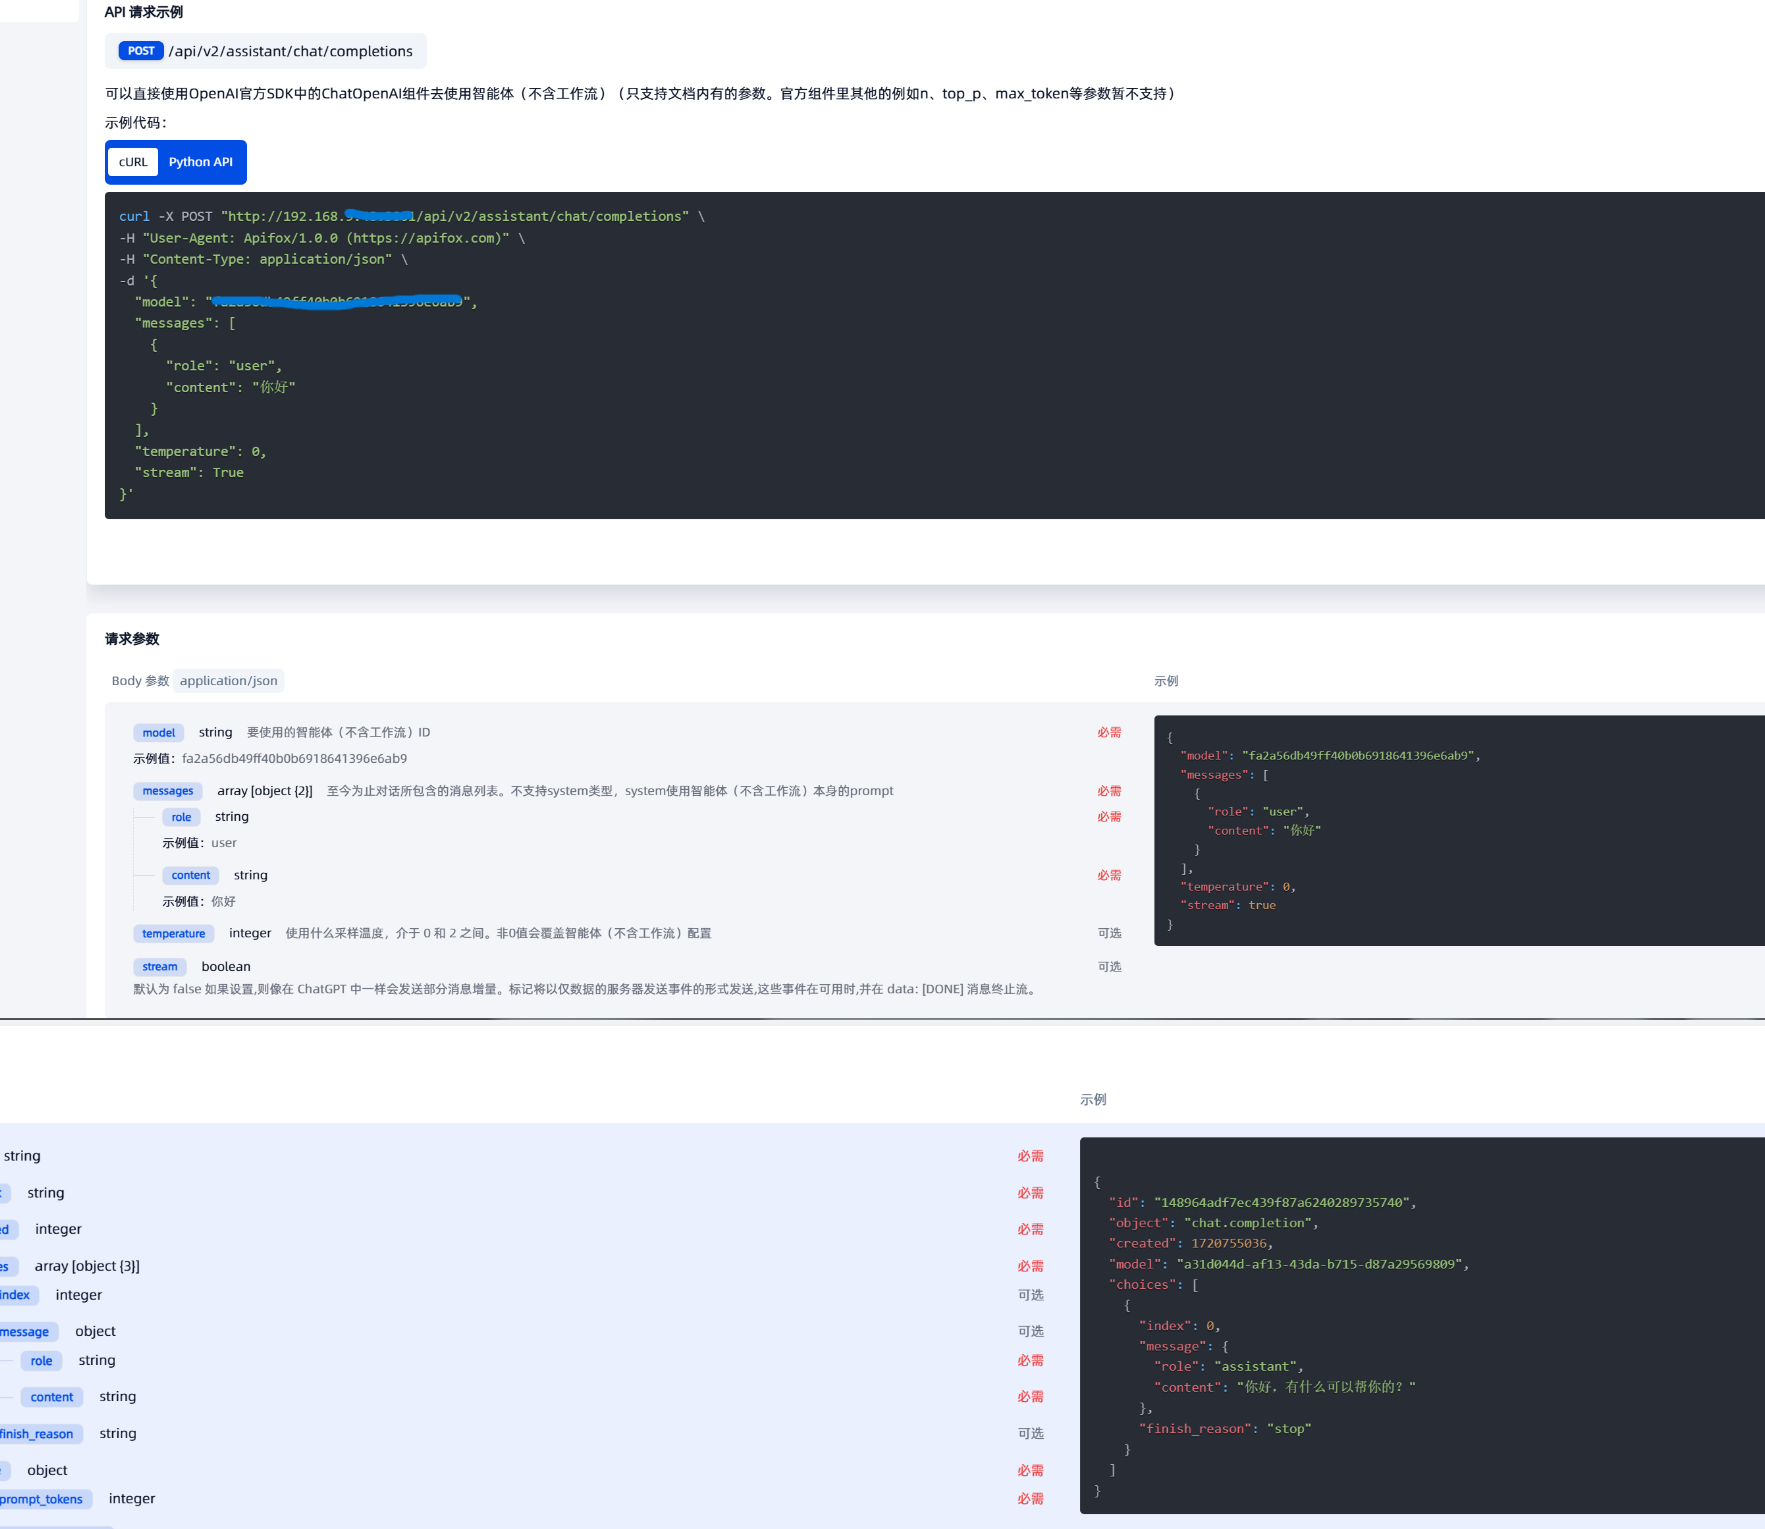
将以上API转为openAPI格式,并添加在bisheng的API工具中。
openapi: 3.0.0
info:
  title: 智能体对话 API
  description: 调用指定的智能体(不含工作流)进行对话补全
  version: 1.0.0
servers:
  - url: http://127.0.0.1:8888
    description: 本地开发服务器

paths:
  /api/v2/assistant/chat/completions:
    post:
      operationId: create_chat_completion
      summary: 发起对话补全请求
      description: 向指定智能体发送消息并获取回复。支持流式和非流式。
      requestBody:
        required: true
        content:
          application/json:
            schema:
              type: object
              required:
                - model
                - messages
              properties:
                model:
                  type: string
                  description: 智能体 ID
                  example: "94995227d55248f4a44f0670466a49f9"
                messages:
                  type: array
                  description: 对话消息列表(不支持 system 角色)
                  items:
                    type: object
                    required:
                      - role
                      - content
                    properties:
                      role:
                        type: string
                        enum: [user, assistant]
                        example: "user"
                      content:
                        type: string
                        example: "你好"
                temperature:
                  type: number
                  minimum: 0
                  maximum: 2
                  description: 采样温度,非0值覆盖智能体配置
                  example: 0
                stream:
                  type: boolean
                  description: 是否启用流式响应(SSE)
                  default: false
                  example: true
            example:
              model: "94995227d55248f4a44f0670466a49f9"
              messages:
                - role: "user"
                  content: "你好"
              temperature: 0
              stream: true
      responses:
        '200':
          description: 成功响应
          content:
            application/json:
              schema:
                type: object
                required:
                  - id
                  - object
                  - created
                  - choices
                  - usage
                properties:
                  id:
                    type: string
                  object:
                    type: string
                  created:
                    type: integer
                  choices:
                    type: array
                    items:
                      type: object
                      properties:
                        index:
                          type: integer
                        message:
                          type: object
                          properties:
                            role:
                              type: string
                            content:
                              type: string
                        finish_reason:
                          type: string
                  usage:
                    type: object
                    properties:
                      prompt_tokens:
                        type: integer
                      completion_tokens:
                        type: integer
                      total_tokens:
                        type: integer
              example:
                id: "chatcmpl-123"
                object: "chat.completion"
                created: 1677654321
                choices:
                  - index: 0
                    message:
                      role: "assistant"
                      content: "您好!有什么可以帮您?"
                    finish_reason: "stop"
                usage:
                  prompt_tokens: 10
                  completion_tokens: 15
                  total_tokens: 25
            text/event-stream:
              schema:
                type: string
                description: "流式响应,数据格式为 `data: {JSON对象}\\n\\n`,最后以 `data: [DONE]` 结束"
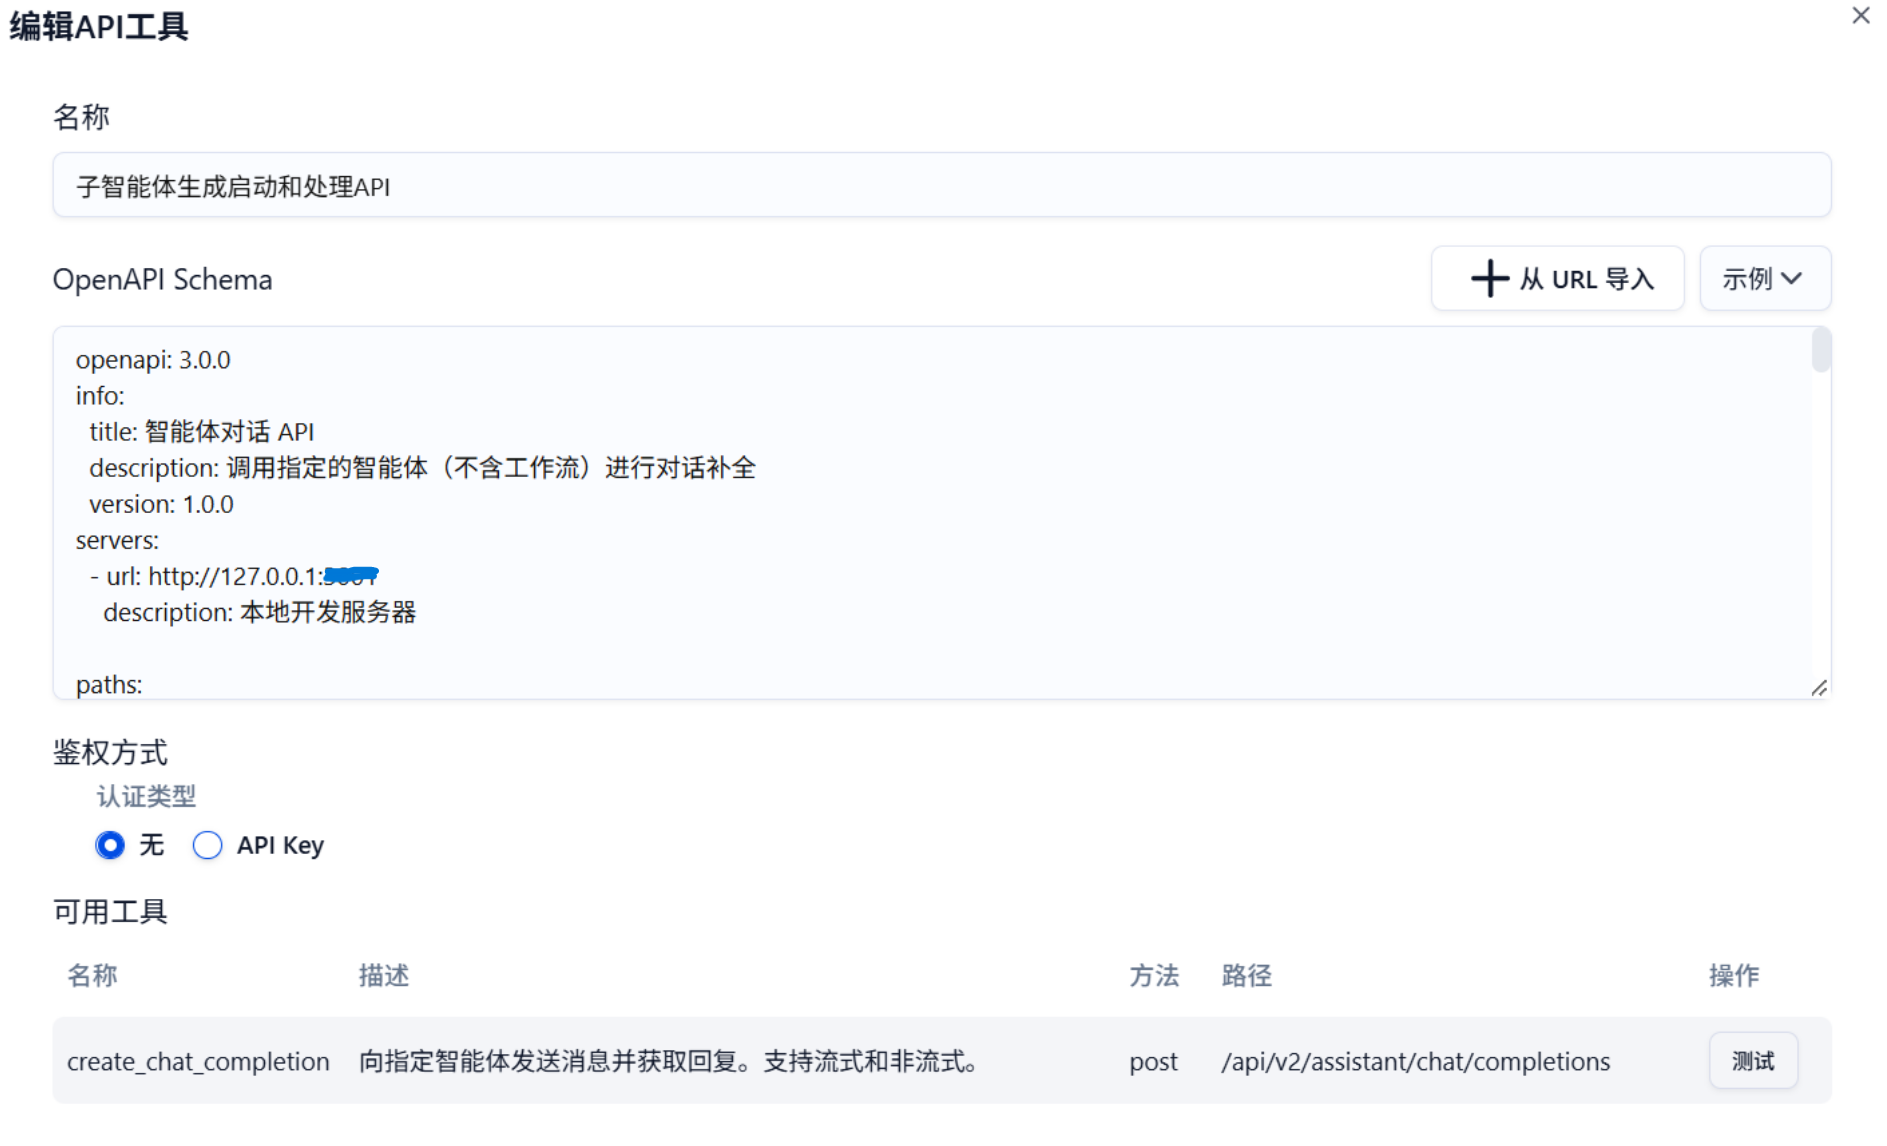
通过“构建->工具->API工具->创建API工具”。信息填入后,点击“保存”,可以看到可用工具。
设计思路:五条原则
1. 分层:认知编排层 × 确定性执行层
┌─ 认知编排层(Bisheng 助手)─────────────────────────────┐
│  专家(总): 澄清 → 取模块目录 → 出 IR 方案 → 委派 → 确认 → 总结 │
│  子智能体  : 逻辑流图执行 / 参数配置执行 / 代码生成执行          │
└──────────────────────────┬────────────────────────────┘
                           │ MCP(HTTP+SSE)
┌─ 确定性执行层(Coder 引擎)──────────────────────────┐
│  create_project / upload_logic_graph / prepare_deployment / upload_flow_graph │
│  绑定·布局·XML·校验·上传重试·状态缓存·产物落盘                    │
└───────────────────────────────────────────────────────┘
原则:判断给模型,事实给引擎;模型永远不生产"机器要解析的结构",引擎永远不做"需要理解需求的事"。
2. 角色分工与工具纪律
| 角色 | 层级 | 工具 | 职责 |
|---|---|---|---|
| 专家 Agent | 总 | get_chain_template(标准链 IR)+ get_modules(仅自定义需求)+ 一个 create_chat_completion(model 选子智能体) | 澄清、取标准模板 IR、原样转发需求全文、依次委派、展示确认、总结 |
| 逻辑流图子 | 子 | createProject、upload_logic_graph | 建工程 + 把总下发的 IR 原样上传 |
| 参数配置子 | 子 | getProjectParams(只读自查)、prepare_deployment(定稿) | 自查本流程参数清单 → 从需求全文抽取参数与设备 → 定稿落盘 |
| 代码生成子 | 子 | upload_flow_graph | 按已定稿快照上传部署流图 |
纪律要点:执行顺序只能由总按协议驱动,子智能体之间无法越权乱序。
3 委派通道:一个工具 + model 参数
平台侧实际给到总智能体的是一个 create_chat_completion(**kwargs) 工具(参数 model/messages/stream),model 就是子智能体的 ID。因此"三个子智能体"在工具视角是同一个工具的三次调用:
{"action": "<create_chat_completion>",
 "action_input": {"model": "{{LOGIC_AGENT_ID}}",
   "messages": [{"role": "user", "content": "创建工程并上传逻辑流图。IR 如下…\n【IR】{…}"}],
   "stream": false}}
4 数据传递:三个安全通道(都不走聊天文本)+ 一行回显行
- 工具参数——IR、paramOverrides、deployment、projectName 只出现在工具调用的参数里(模型传结构化参数远比在文本里嵌套 JSON 可靠);
- 引擎服务端状态——步骤2 缓存 IR(
state.ir)、步骤3 固化部署定稿快照(state.deploy),后续步骤零回传; - 落盘文件——部署方案写
deploy.json(权威)/deploy.txt(人读),图 XML 写logic.xml/deploy.xml;聊天里只传一行绝对路径; - 回显行(第二版新增)——每个工具返回文本的最后一行固定为
回显: 成功|工程名 proj-x|…,由引擎生成并做 JSON 安全化(单行、无 ASCII 双引号、无反斜杠);子智能体的最终回答就是照抄这一行,不需要概括、不需要转义、不需要正则提工程名。
5 协议:外壳 / 内容两层 + 单一 JSON 外壳
- 外壳(平台的 ReAct 协议):每轮只能是单个 JSON
{"action": … , "action_input": …},JSON 之外不写一个字; - 内容(
action_input的值):Final Answer 时必须是非空单行字符串;禁止换行、禁止 ASCII 双引号、禁止 JSON 对象/数组/布尔/空内容、禁止回显 IR/XML/方案全文; - 类型铁律:工具调用
action_input= JSON 对象,Final Answeraction_input= 字符串; - 只有 4 个时机允许
Final Answer:①澄清提问 ②请用户确认部署方案 ③报错停止 ④最终总结。
弱模型适配:把"智能"从模型手里拿回来
弱模型的失败模式很固定:长输出漂移、结构不守规矩、多步推理中途忘目标。对策不是"教它变强",而是减少它需要做的事。且做的事情简单。模型的每一次输出要么是一个工具调用,要么是一句短话/一行路径——没有中间态,没有长文本,没有结构嵌套。
| # | 法则 | 落地做法 |
|---|---|---|
| 1 | 确定性下沉 | 布局/绑定/XML/校验/上传/重试全在引擎;模型只做"选哪个模板、给什么参数" |
| 2 | 预置模板,禁止自由发挥 | 标准链直接调 getChainTemplate(引擎按本机模块库生成单行 IR);弱模型只负责复制这一行(第一版的中文骨架已被证明命中不了模块库,见 P9) |
| 3 | 单步原子化指令 | 子智能体 prompt 退化为"执行员":调工具 → 抄一行 → 结束 |
| 4 | 只抄一行,不总结 | 每个工具返回的末行是引擎生成的回显行;子智能体最终回复 = 照抄该行,禁止回显长方案/XML 代码块 |
| 5 | 长文本落盘 | deploy.json/deploy.txt/deploy.xml/logic.xml;聊天只传路径,模型零转义负担 |
| 6 | 输出格式铁律 | 每轮单 JSON;工具调用 action_input = 对象,Final Answer action_input = 字符串(这条踩过坑,见 §5-P4) |
| 7 | 枚举状态机边界 | 明确"只有 4 个时机能结束回合",其余一律继续调工具,消除"该不该停下"的摇摆 |
| 8 | 错误即停 + 有界重试 | 工具返回"错误:"→ 原文转述并停止;服务异常最多重试 1 次(防死循环) |
| 9 | 参数名写死 | 引擎工具用驼峰 projectName/ir/paramOverrides,prompt 逐字给出,杜绝 project_name 类漂移 |
加快执行效率:为什么这样设计更快
| 优化点 | 做法 | 收益 |
|---|---|---|
| 引擎化批处理 | 一次 upload_logic_graph 调用完成"绑定→布局→XML→校验→上传→失败重试" | 原本需要多轮 LLM 决策的动作变成 1 次工具往返 |
| 服务端状态缓存 | projectName → IR 缓存在引擎;步骤 3/4 直接读 | 每步少一次大 payload 传输与解析 |
| 零 IR 回传 | 子智能体只回"工程名 + 节点数",不需要把 IR 交还总智能体 | 省 token、省延迟、少一次复制出错机会 |
| 单回合连续工具调用 | ReAct 循环内可连续调多个工具,只在确认/总结时结束回合 | 免去"中间结论 → 用户 → 再说继续"的往返 |
| 落盘替代搬运 | 部署方案/XML 走文件,聊天只传路径 | 上下文长度骤降,长文本解析失败风险归零 |
| 模板化 | 固定 IR 骨架 + 固定委派 JSON 模板 | 弱模型 0 推理即可产出合法结构 |
| 不做无意义的并行 | 该流水线本质是强状态串行(每步依赖上一步 projectName/IR),不硬拆并行 | 避免为"多智能体"而引入不一致 |
| 复用既有能力 | 引擎与工具零重写,MCP 直连 | 迁移成本集中在编排层 |
一个容易忽略的效率点:把"顺序"放进协议而不是放进模型推理。顺序由提示词状态机固定,模型每次只需要知道"现在是第几步、下一步是什么",不需要重新规划整条链路。
在“确定性交给java侧,决策性交给模型(而不是由大模型来生成XML)”+ “大文件落盘(而不是在聊天中转发)“+ ” 输出格式强要求"的原则下整个流水线的速度提升了80%,同时流水线执行失败率也近乎为0。
遇到的问题
P1|子智能体最终回答是 JSON 对象 → 平台 500
现象:子智能体任务全部成功(取模块、出 IR、建工程、上传逻辑图),但收尾即报
pydantic ValidationError: 2 validation errors for AIMessage; content.str input_value=True/False;对外表现为总智能体收到"invoke tool failed",并死循环重试同一调用。
根因:平台源码 assistant_agent.py::react_run:
output = result['agent_outcome'].return_values['output']      # {'ok': True, 'project_name': ...}
if isinstance(output, dict):
    output = list(output.values())[0]                        # ← 取第一个值 = True(ok 键排第一)
inputs.append(AIMessage(content=output))                      # content 必须是 str/list
旧契约要求子智能体最终回答一段 {"ok": true, …} JSON;模型在 ReAct 的 json-blob 协议里把对象嵌进 action_input,平台解析后 output 是 dict,取首值恰好是布尔 ok → AIMessage(content=True) → 崩溃。
对策:
- 纯文本汇报协议:子智能体最终回答只能是字符串(短句或单行路径/错误原文)——崩溃分支不可达;
- 总智能体补规则:服务异常/空返回 → 报告并停止,同一任务最多重试 1 次(防死循环)。
验证:子智能体独立跑真实任务,最终回复为 1-2 句中文,服务端无 ValidationError。
P2|参数名漂移:project_name vs projectName
现象:upload_logic_graph 首次调用返回错误:缺少 projectName(来自 create_project 工具返回)。;模型自行纠正后成功。
根因:引擎 MCP 工具 schema 用驼峰 projectName/ir,而提示词里写的是"契约字段" project_name,模型照抄了契约名当工具参数名。
对策:prompt 里逐字写死驼峰参数名;明确"project_name 只是你与总智能体之间的文本字段名,不是工具参数名"。
验证:全流程日志中不再出现"缺少 projectName"。
P3|长文本经模型搬运 → Could not parse LLM output
现象:委派到"代码生成"前,专家在"展示部署方案"环节整轮崩溃:
JSONAgentOutputParser: Could not parse LLM output: 部署方案全文如下(请确认…)…(大段全文)
根因:平台要求每轮输出都是 JSON blob;提示词要求专家"把部署方案全文一字不改转给用户",长文本让弱模型放弃了 JSON 外壳,直接吐正文 → 解析失败。
对策(本次的核心工程改动):
- 引擎侧:
prepareDeployment落盘deploy.txt,返回末尾追加一行部署方案产物: <绝对路径>(此前 ir/logic/deploy.xml 已落盘,唯独部署方案没落盘); - 提示词侧:参数子只回显最后一行路径;专家确认环节改成一句话 + 文件路径(用户打开文件看全文);四个 prompt 统一加"输出格式铁律"。
验证:prepare_deployment 后服务器上 deploy.txt 存在且为全文;弱模型连跑 2 次无 OutputParserException。
P4|工具调用 action_input 写成字符串 → arun() takes 1 positional argument but 2 were given
现象:专家委派子智能体时报 OpenApiTools.arun() takes 1 positional argument but 2 were given;模型自查后把 action_input 改成对象,重试成功。
根因:上一版"输出格式铁律"写了"action_input 是字符串"——这条只适用于 Final Answer;工具调用必须传 JSON 对象(dict),键即工具入参名。
对策:
- 铁律改写为:工具调用
action_input= JSON 对象(附委派模板),Final Answeraction_input= 字符串; - 三个子智能体 prompt 同步补上"调用工具时 action_input 用对象"。
验证:日志中不再出现 arun() 位置参数错误。
P5|无参数MCP工具集成到助手,上线提示KeyError: ‘properties’
现象:"无参 MCP 工具"在助手里添加/解析时报错,后台出现错误
File “/venv_bisheng_site/langchain_core/tools/base.py”, line 555, in args return json_schema[“properties”] -> {‘type’: ‘object’} KeyError: ‘properties’
根因:无参MCP工具方法的 schema 里缺 properties 字段有关
对策:
private static JsonObject normalizeSchema(JsonObject raw) {
    JsonObject schema = raw == null ? new JsonObject()
            : JsonParser.parseString(raw.toString()).getAsJsonObject();
    if (!schema.has("type"))       schema.addProperty("type", "object");
    if (!schema.has("properties") || !schema.get("properties").isJsonObject())
                                   schema.add("properties", new JsonObject());
    if (!schema.has("required")   || !schema.get("required").isJsonArray())
                                   schema.add("required", new JsonArray());
    return schema;
}
验证:重新发布程序,并刷新bishegn mcp server。
反思与展望
- 确定性是第一公民:把"机器能算的"从模型手里拿走,是弱模型时代最划算的投资——它同时买到稳定性、速度与可验收性;
- 长文本不该出现在聊天中:凡是大 payload,一律走文件/状态/工具参数;聊天只承载"意图"与"路径";
- 协议要顺着平台的骨架长:ReAct 的 JSON blob、
action_input的类型差异、每轮单动作——这些不是"提示词技巧",而是必须写进协议的一等约束; - 多智能体的价值在职责隔离,不在并行:这条流水线本质是强状态串行,拆角色的收益来自"小 prompt、可单独调试、可替换模型",而非并发;
- "谁来写最后一个字"决定稳定性:凡是模型最终要输出的文本,只要它能在引擎侧被确定性地生成,就不要让模型去"概括"——回显行是这条原则的极致形态:模型只抄,不写;
一句话总结:不让模型变强,而是让工程不再依赖模型变强。
愿你我都能在各自的领域里不断成长,勇敢追求梦想,同时也保持对世界的好奇与善意!

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)