对于循环神经网络(RNN)的一些理解
前言:
在学完word2vec之后便进入了RNN的学习,感觉初次接触很难理解,但是进过我反复查阅资料,发现也并没有想象的难,对于如何搞明白RNN我认为需要的不仅是理解能力还需要有想象力,不过我相信大家一定能够理解的。(水字数。。。。
一、RNN的背景
循环神经网络(RNN, Recurrent Neural Network)是深度学习领域中处理序列数据的重要模型。它的背景来源于对序列数据建模的需求,特别是在时间序列分析、自然语言处理(NLP)、语音识别等任务中。
1、RNN出现之前
在RNN出现之前,序列数据的建模主要依赖于传统的统计方法,例如:
- 马尔可夫模型:假设当前状态只依赖于前一个状态,无法捕捉长距离依赖。
- 隐马尔可夫模型(HMM):引入隐状态,但对复杂非线性关系的建模能力有限。
- N-gram模型:在自然语言处理中用于语言建模,但无法捕捉长距离上下文。
这些方法的局限在于:
- 难以处理长距离依赖(long-range dependencies)。
- 无法很好地建模复杂的非线性关系。
2、RNN的提出
RNN的提出是为了解决序列数据建模中的长期依赖问题。它的核心思想是:
- 通过 隐状态(hidden state) 在不同时刻之间传递信息。
- 将前一时刻的隐状态作为当前时刻的输入,从而捕捉序列中的时间依赖性。
RNN的特点:
- 参数共享:在不同时间步上使用相同的权重矩阵,减少了模型参数数量。
- 循环结构:通过循环连接处理任意长度的序列。
- 灵活性:适用于各种序列数据任务,如时间序列预测、文本生成、语音识别等。
那么问题来了,什么叫隐状态(hidden state)?和隐层 (Hidden Layer) 有什么区别?
RNN 中的隐状态某种程度上相当于隐层的作用,但它是一个更动态和序列化的概念。
-
隐层 (Hidden Layer):
在普通的前馈神经网络 (Feedforward Neural Network) 中,隐层是网络中的中间层,负责提取输入数据的抽象特征。每一层的输出是固定的,不会随时间变化。
在 RNN 中,隐层也可以理解为一个固定的结构,但它的输出会随时间动态更新,即隐状态。 -
隐状态 (Hidden State):
隐状态是 RNN 隐层在每一时刻的输出,它不仅仅是当前时刻的特征表示,还包含了历史时刻的上下文信息。因此,隐状态是动态的,会随着序列的推进而更新。可以把隐状态看作是 RNN 隐层在时间上的扩展:
- 静态视角:隐层是网络的一个结构组成部分。
- 动态视角:隐状态是隐层在每一时刻的具体表现。
隐状态如何体现隐层的作用
-
特征提取:
和前馈神经网络中的隐层类似,RNN 的隐状态也是通过非线性激活函数提取输入数据的抽象特征。 -
序列信息传递:
区别在于,RNN 的隐状态不仅依赖于当前输入,还依赖于前一时刻的隐状态
。这种机制使得隐状态能够捕捉序列中的时间依赖关系。
用公式表示隐层的输出(下文详细介绍这个公式的推导):
其中:
-
是当前时刻的隐状态,
-
是一个非线性激活函数(通常为tanh或ReLU),
-
是权重和偏置参数。
二、如何理解RNN以及其数学推导
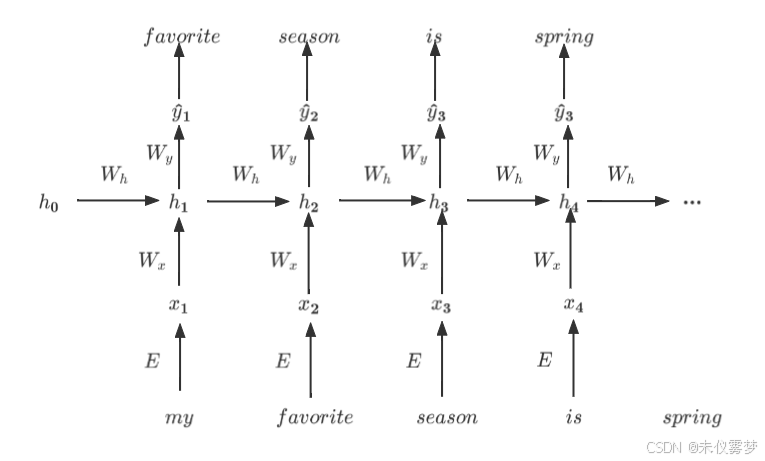
1、RNN的基本结构
RNN的每个时间步有一个输入
,一个隐藏状态
,以及一个输出
。RNN的核心思想是隐藏状态
会从上一个时间步的隐藏状态
和当前输入
中更新。
全流程如图:
2、RNN的前向传播
RNN的前向传播过程可以描述为以下几个步骤
2.1 输入层到隐藏层的计算
在时间步 ,RNN通过结合当前输入
和上一个时间步的隐藏状态
来计算新的隐藏状态
。公式如下:
其中:
-
-
-
那么这个公式怎么来的呢?接下来一步一步介绍
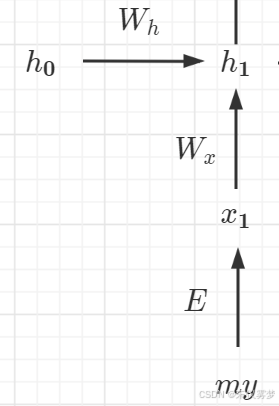
2.1、 :当前时间步的信息
是当前时间步的输入数据,如:
(在它转化为
之前是一串
编码,还经过了
层的处理,才成为了
时网络接收到的新信息。
是一个权重矩阵,它将输入
,RNN将当前输入转换为适合隐藏状态的形式。
- 意义:这一部分表示当前输入对隐藏状态的贡献,它引入了新的信息到网络中。
2.2、 : 上一时间步的信息
是上一个时间步的隐藏状态(
及之前的所有历史信息。
是一个权重矩阵,它将前一个隐藏状态
,RNN将历史信息传递到当前时间步。
- 意义:这一部分表示过去信息对当前隐藏状态的影响,它允许网络“记住”之前时间步的信息。
2.3、 相加的意义:结合当前与过去的信息
- 通过将
和
- 这个相加操作的意义是:
- 当前输入
- 历史信息
- 通过结合两者,RNN能够在当前时间步做出更“智能”的决策。
- 当前输入
2.4 、激活函数 :引入非线性
- 相加的结果通过一个激活函数
或
)进行非线性变换:
- 激活函数的作用是引入非线性,使RNN能够捕捉更复杂的模式。
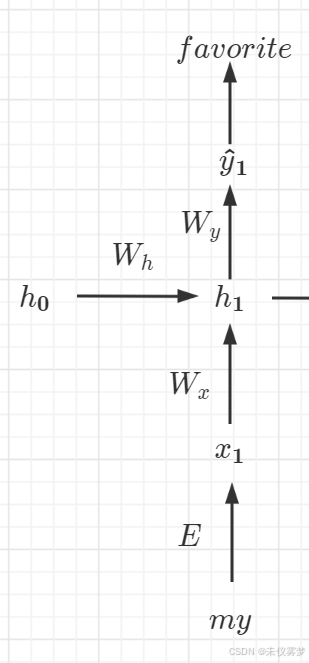
2.5、隐藏层到输出层的计算
RNN的输出 可以通过隐藏状态
来计算:
其中:
-
是隐藏状态到输出层的权重矩阵。
-
是输出层的偏置项。
函数用于将输出转换为概率分布(通常用于分类任务)。
就是预测值,如下图,通过
3. RNN的反向传播(BPTT)
交叉熵损失衡量预测分布与真实分布
之间的差异。对于一个时间步
,交叉熵损失为:
其中:
-
是类别数。
-
是真实标签的
-
是预测概率分布的第
个元素。
对于整个序列,总损失函数为所有时间步损失的总和:
3.1、损失函数的梯度计算
我们需要计算损失 对 RNN 参数
的梯度。以下是关键步骤:
3.1.1、损失对输出 的梯度
对于单个时间步,交叉熵损失对
的梯度为:
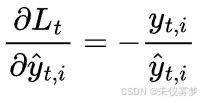
由于是 one-hot 编码,设真实标签对应的类别为
,则:
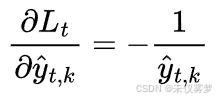
3.1.2、损失对隐藏状态  的梯度
损失对隐藏状态的梯度通过链式法则计算:
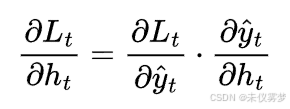
其中:
是
层对隐藏状态的梯度。假设
,则:
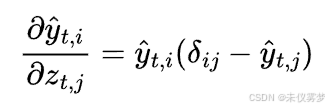
其中 是 Kronecker delta。 其作用与指示函数类似。
3.1.3、损失对参数 和 的梯度
损失对输出层参数 和
的梯度为:
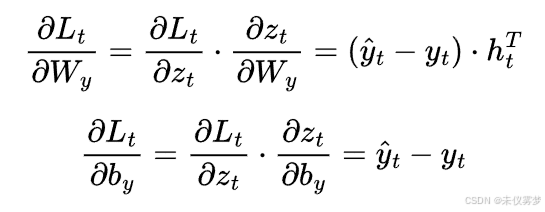
3.1.4损失对隐藏层参数  的梯度
隐藏层的梯度需要通过时间反向传播。我们从最后一个时间步开始,逐步计算梯度。
定义一个中间变量 ,表示损失对隐藏状态
的梯度:
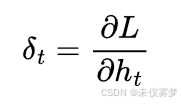
将拆分为两部分:
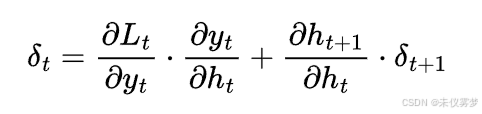
其中:
需要计算隐藏状态对前一时刻隐藏状态的梯度。
对于激活函数 ,有:
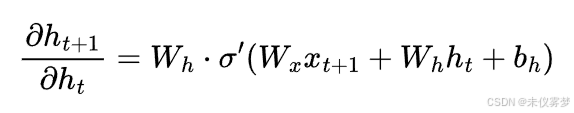
其中 是激活函数的导数。
通过递归计算,可以得到所有时间步的隐藏状态梯度。
最后,损失对参数的梯度为:
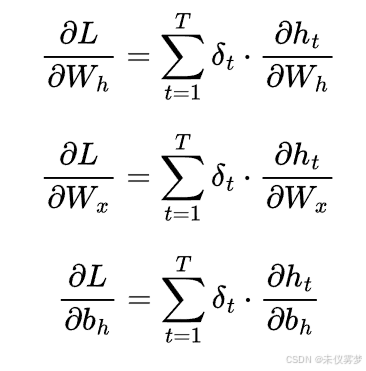
发现BPTT要写的东西太多了,过段时间我会写一篇更加详细的%%%%

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 15
 0
- 0


 已为社区贡献1条内容

所有评论(0)