前端工程师必备:轻松掌握大模型开发,收藏这份学习指南!
本文阐述了前端工程师在Agent开发中的独特优势,指出前端技能如组件化、事件驱动等与Agent开发核心技能高度契合。文章强调前端工程师无需转行学习Python或机器学习,通过现有技能平移即可掌握Agent开发。作者以自身经验出发,分享了用TypeScript和Node.js进行Agent开发的五层学习路径,旨在帮助前端工程师系统性地入门并实践Agent开发,最终实现从“给AI擦屁股”到独立构建完整Agent系统的转变。
前端工程师可能是最被低估的 Agent 开发者。你已有的工程化思维、组件抽象能力、对异步事件循环的理解——全是 Agent 开发的核心技能。
● ● ●
上个月有个前端同事跟我说:“我现在上班主要就是在给 AI 擦屁股。”
他说这话的时候表情很复杂——一半自嘲,一半真焦虑。他们组接了一个 AI 功能,需求是"让用户用自然语言查订单"。听起来简单,实际上 LLM 经常吐 JSON 漏字段、有时候拒绝回答、偶尔还凭空编一个订单号出来。他的日常工作变成了"写正则修 LLM 的输出"。
我说你这不是在擦屁股,你是在干 Agent 工程师的活儿——只是你自己不知道。
他愣了两秒:“啥是 Agent 工程师?”
这大概就是我想写这个系列的原因。Agent 开发这事儿吧,看起来像是搞 AI 的人的事。但你仔细看就会发现,过去一年冒出来的那些 Agent 框架——Vercel AI SDK、LangChain.js、MCP——它们的核心抽象全是前端玩剩下的东西。
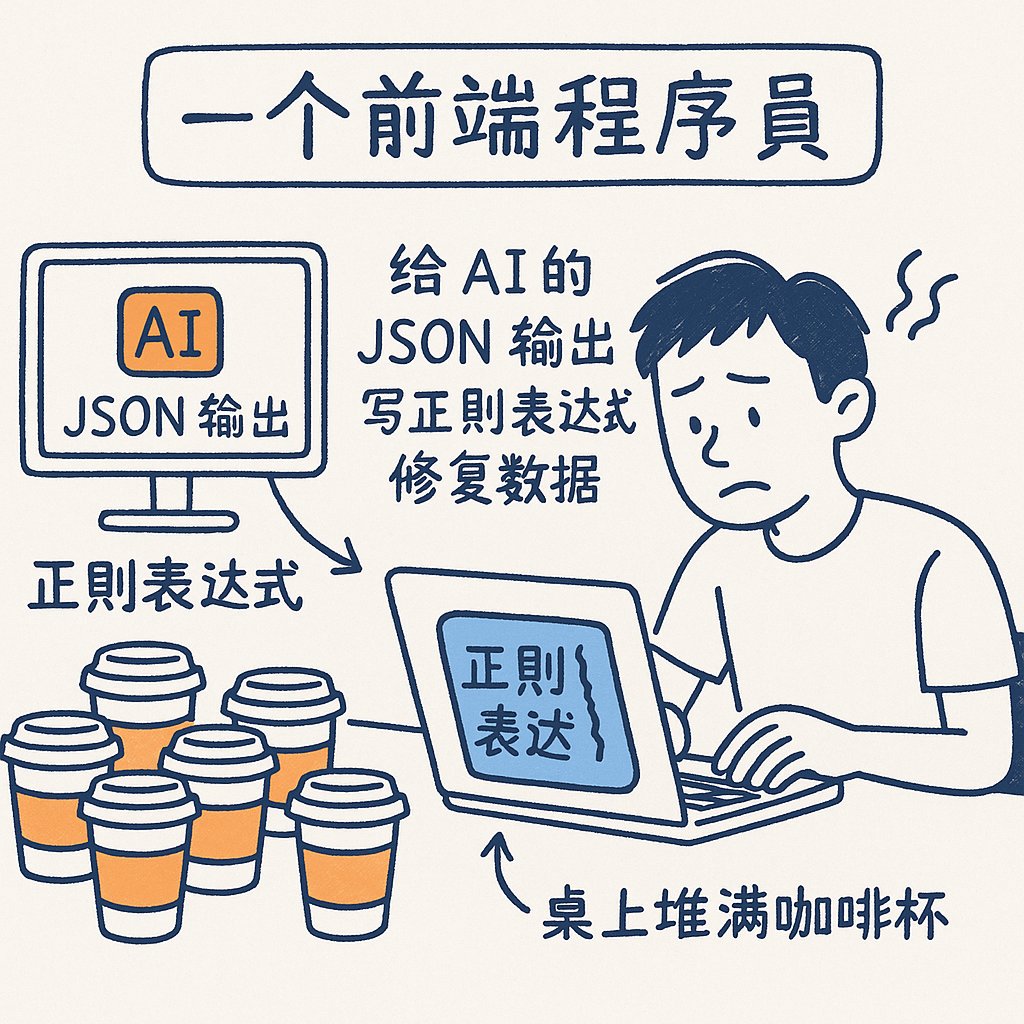
组件化、事件驱动、状态管理、异步编排。换个皮你就认不出来了?
● ● ●
你现在的工作方式,已经是对 Agent 的朴素模仿
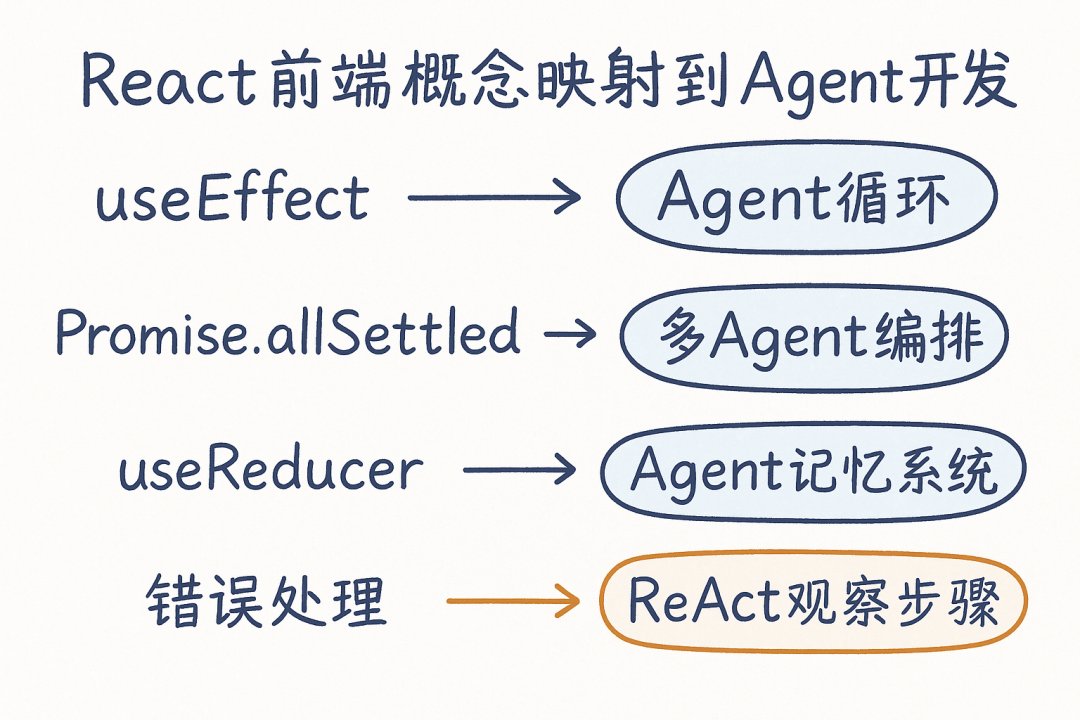
React 的 useEffect,你每天至少写十次。它的本质是什么?状态变化 → 触发副作用 → 副作用可能引起状态再变化。这就是一个最朴素的 思考-行动-观察 循环。
区别只在于,useEffect 的"思考"是你自己写的逻辑,Agent 的"思考"是 LLM 在决定下一步调用哪个工具。
再往下想,你在业务代码里写过的东西:
-
Promise.allSettled—— 这就是 多 Agent 并行编排 的底层 API,只是你之前等的是接口返回,Agent 等的是工具调用结果。
-
组件的
state+useReducer—— 这就是 Agent 的 短期记忆。localStorage和IndexedDB就是 长期记忆。你没发现是因为没人告诉你这俩是一回事,不是你不会。 -
if (response.ok) { 渲染数据 } else { 展示错误页 }—— 你每年写几百次的错误分支,LLM 调用工具失败,根据错误信息决定下一步——跟你根据 API 返回码决定显示什么,是同一个逻辑。
我说句实话:这些东西你不是不会,是换了一身 AI 的行头你就怂了。
● ● ●
这 12 篇文章要干什么
我不想写那种"从零到一教你做大模型应用"的教程——那玩意儿市面上已经够多了。大部分都不教你写代码,教你的也是 Python。
这个系列全部用 TypeScript,Node.js 运行时,你现有的前端工具链直接拿来用。
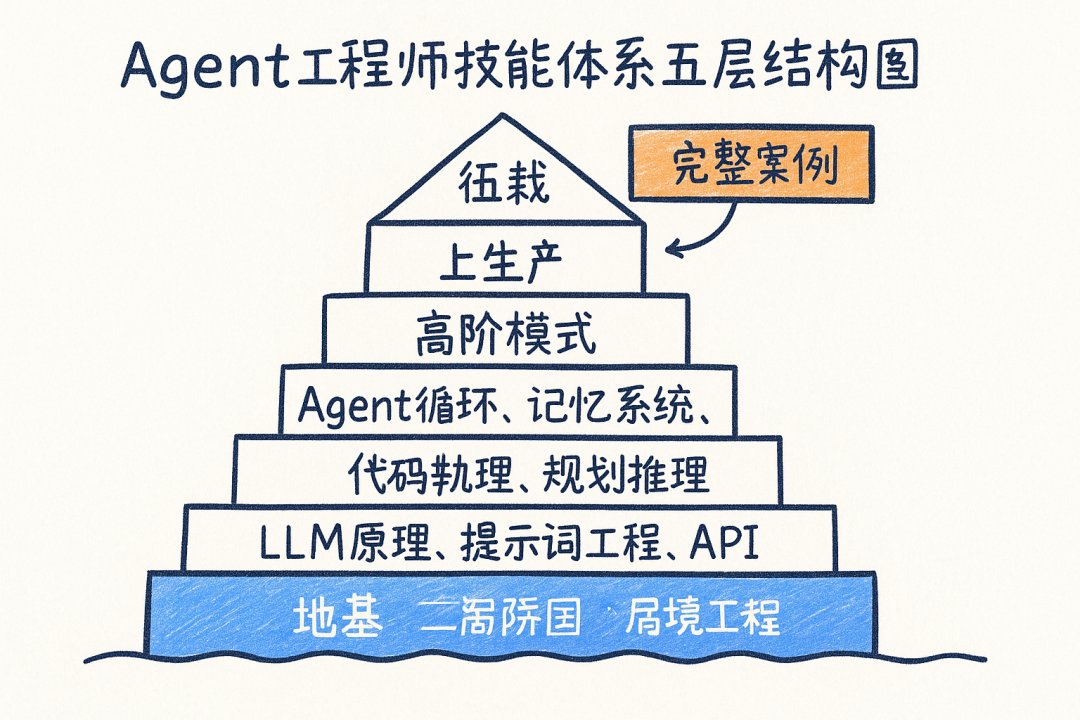
整个系列分 五层,我捋一遍你能大概知道在学什么:
第一层:地基(3 篇)。LLM 最少必要知识、提示词的工程化、Tool Use 和 Streaming 的 API 细节。这一层的作用是让你跟 AI 模型打交道的时候不会被坑——比如为什么有时候改了 temperature 输出反而变差了。
第二层:Agent 核心能力(3 篇)。Agent 循环的手写实现、记忆系统的分层设计、从 Function Calling 到 MCP 的演进。这三篇写完之后,你可以手写一个 不依赖任何框架 的 Agent。
第三层:高阶模式(3 篇)。多 Agent 协作、代码生成与执行沙箱、规划与推理。注意,每一篇都会告诉你"这个模式什么时候不该用"——我见过太多人拿着锤子找钉子。
第四层:上生产(2 篇)。Eval 体系和安全护栏。这两篇可能最功利但也最值钱——直接决定了你的 Agent 能不能从 demo 走到上线。
第五层:实战(1 篇)。200 行 TS 写一个 Minimal Agent Framework,串联前面所有知识点。
● ● ●
为什么是前端工程师,不是后端
我说一句得罪人的话:这两年我看到的 Agent 项目,产品体验做得最好的那些,多数是前端出身的人负责的。
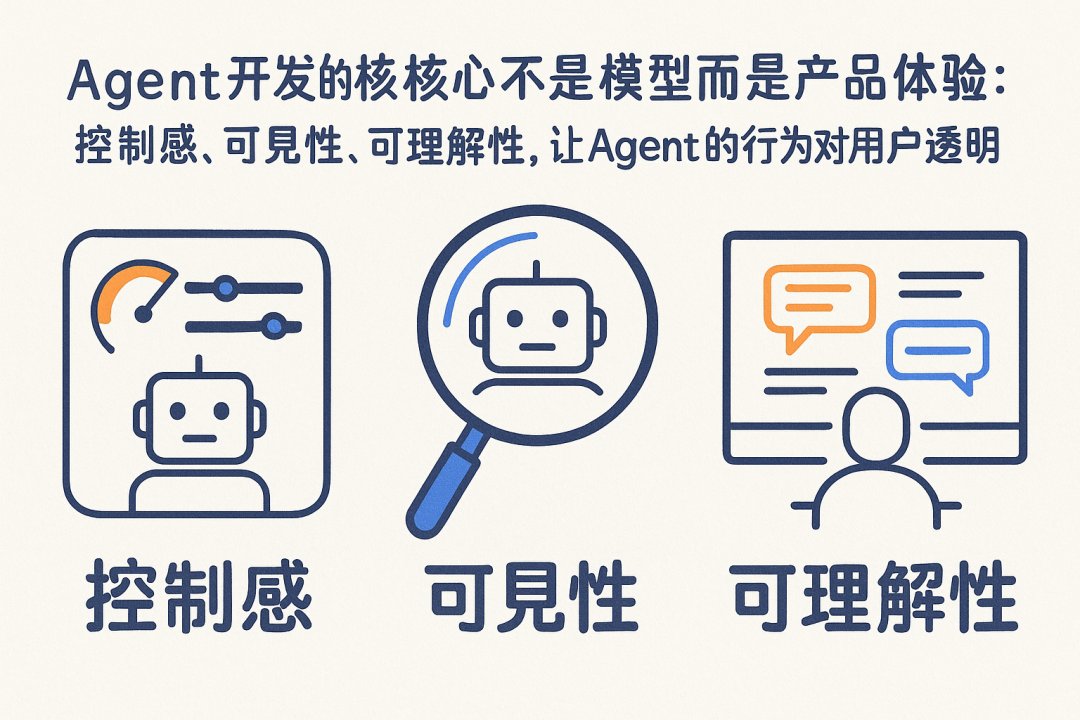
原因是 Agent 的难点根本不是模型能力——模型越来越强,这已经快成 commodity 了。真正的难点在于:怎么让 Agent 的行为对用户来说是可控的、可见的、可理解的。
这不就是前端一直在做的事吗?
你这么多年积累的 用户体验意识 —— loading 态怎么展示、错误怎么让用户知道、操作有没有反馈——这些东西在 Agent 时代不但不会贬值,反而更值钱。后端同学考虑的是"这个数据对不对",你想的是"用户看到这个会不会懵",后者往往决定一个 AI 产品能不能用。
我觉得我不太需要说服你 Agent 开发有前途——你刷 LinkedIn 和朋友圈的时候已经感觉到了。我需要告诉你的是:你不用转行去学 Python,不用从头学机器学习,你手头这些技能平移一下就是 Agent 开发的核心能力。
我说得好像挺有道理是吧?写到这里我自己停了一下,想了一个问题:我是不是把这事儿说得太容易了?
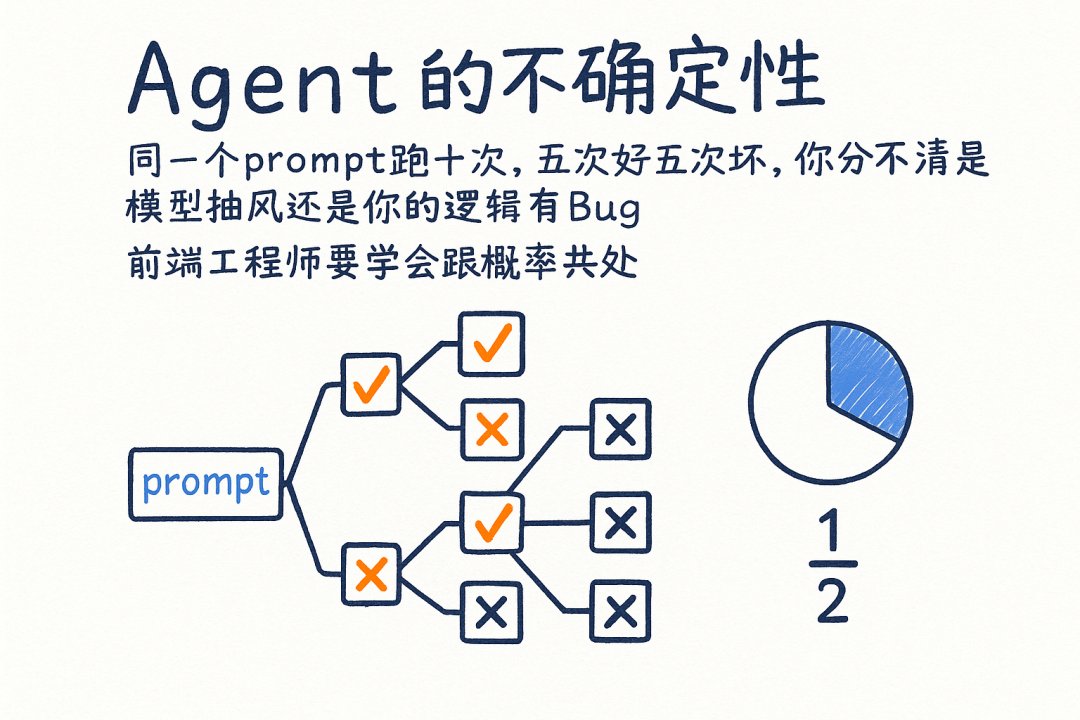
仔细想想,前端转 Agent 开发确实有它的舒适区——你对异步、状态、交互的理解全都用得上。但也有一些东西在你舒适区之外。Agent 的调试比前端调试痛苦得多。前端你改了代码刷新浏览器就能看到结果。Agent 呢?你改了一行 prompt,跑了十次,五次好五次坏,你分不清是模型抽风还是你的逻辑有 Bug。这种 不确定性 对前端工程师来说可能是最难受的——我们习惯了 determinate 的系统,一个输入对应一个输出。Agent 不是一个 determinate 系统,你得学会跟概率共处。
好,吐槽完了。说回正题。
● ● ●
上面说得好像挺乐观,但我也得说实话:前端转 Agent 开发有一个很隐蔽的坑——你对后端和基础设施的陌生感会被放大。
Agent 不是跑在浏览器里的。它跑在服务器上、跑在 CI 流水线里、跑在 Docker 容器里。你需要跟文件系统打交道、跟进程打交道、跟网络权限打交道。这些东西前端开发环境帮你屏蔽了,Agent 开发环境不惯着你。
我自己踩过的坑:第一次写 MCP Server 的时候,我连 fs 模块的 existsSync 跟 access 有什么区别都想了半天——不是不会,是太久没写 Node.js 服务端了。
所以这个系列也不会故意绕开这些。每一篇该装 Docker 的时候装 Docker,该写 Shell 脚本的时候写 Shell 脚本。我不骗你说"只需要你现有的知识就够了",但我可以保证:每引入一个陌生的概念,我都会用一个你已经熟悉的概念做桥接。
● ● ●
写在最后
说回开头那个同事。上周他跟我说,他把那个"给 AI 擦屁股"的活儿重写了——不再是修 LLM 的输出,而是建了一套完整的 Agent 循环:模型调用 → 结果校验 → 自动重试 → 人工介入。跑了一周,他的 on-call 减少了七成。
他说:“原来这玩意儿是有工程化方法的,不是我之前想的那样——写 prompt → 祈祷它工作 → 不行再写一条 prompt。”
我说对啊,这就是为什么它叫 Agent 工程,不叫 Agent 许愿。
大模型的知识又多又杂,到底怎么学?
做这行久了,被问最多的问题就一个:大模型的知识又多又杂,我到底先学啥?翻了一堆资料,看啥都像重点,结果啥都没学进去。今天把我自己一路摸出来的顺序捋一遍,零基础、应届生、转行的都适用。跟着走,至少方向不乱、不瞎忙,学完拿得出手。
第一阶段(10天):初阶应用
这一阶段就一个目标:把大模型真正"玩明白",不是只会聊天那种,而是能调教它、能用代码把大模型和业务接起来。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
这阶段正式进实战,目标很实在:做出两个能拿出手的东西——一个私有知识库,一个 agent 对话机器人。
-
为什么要做 RAG
-
搭建一个简单的 ChatPDF
-
检索的基础概念
-
什么是向量表示(Embeddings)
-
向量数据库与向量检索
-
基于向量检索的 RAG
-
搭建 RAG 系统的扩展知识
-
混合检索与 RAG-Fusion 简介
-
向量模型本地部署
-
…
走完这 30 天,Python 或 JavaScript 背景的基本能独立做一套 RAG 应用,简历上也敢写"大模型应用开发"了。
第三阶段(约20天):动手微调
学到这,你已经开始 “造” 模型了 —— 通过微调,搞出垂直领域的专用小模型。
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你从 “只会用” 变成 “能造” 的 AI 小子。那么你还想往下探索吗?
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
第四阶段(20天):商业闭环,部署落地
技术学完,落地才算数。这阶段带你搞明白大模型怎么真正跑起来、用起来。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
想要入坑大模型的朋友,给大家准备了一份2026 年最新 AI 大模型全套学习资料:
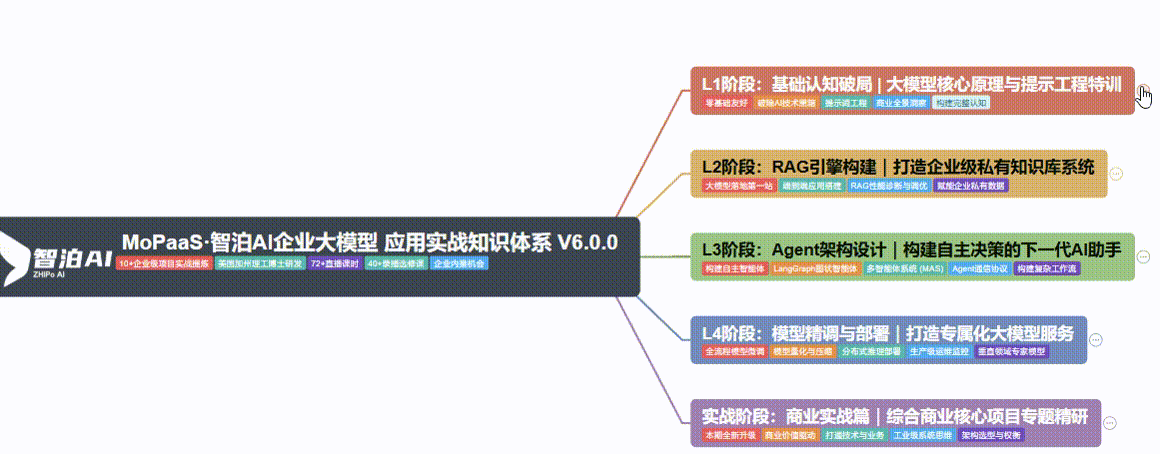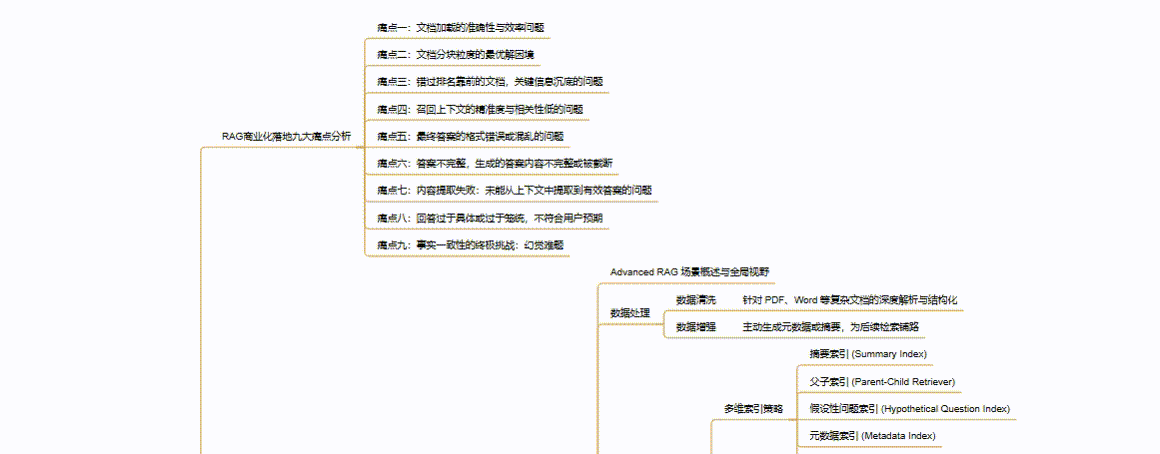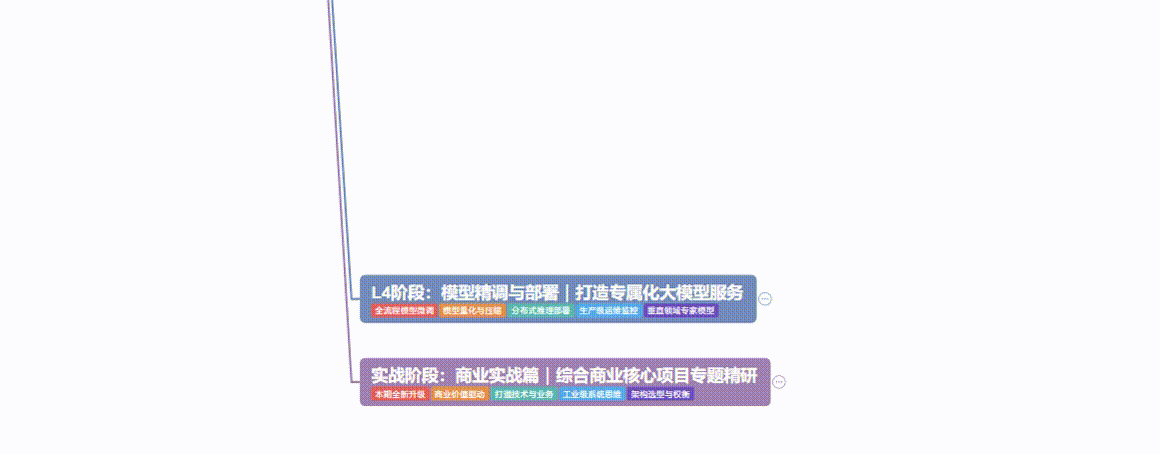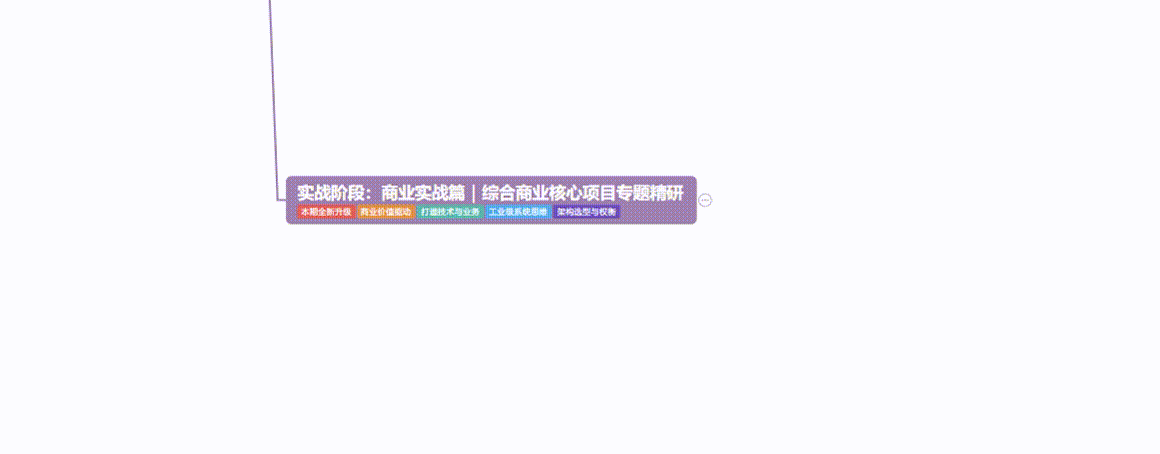
1、大模型系统化学习路线
2、大模型学习视频教程
3、大模型学习书籍&电子文档
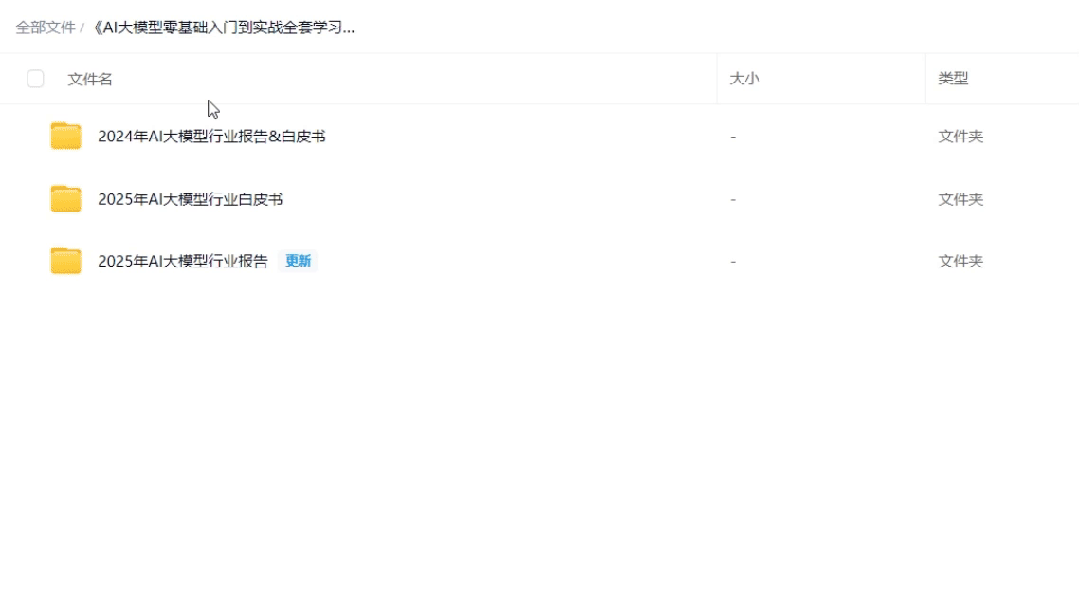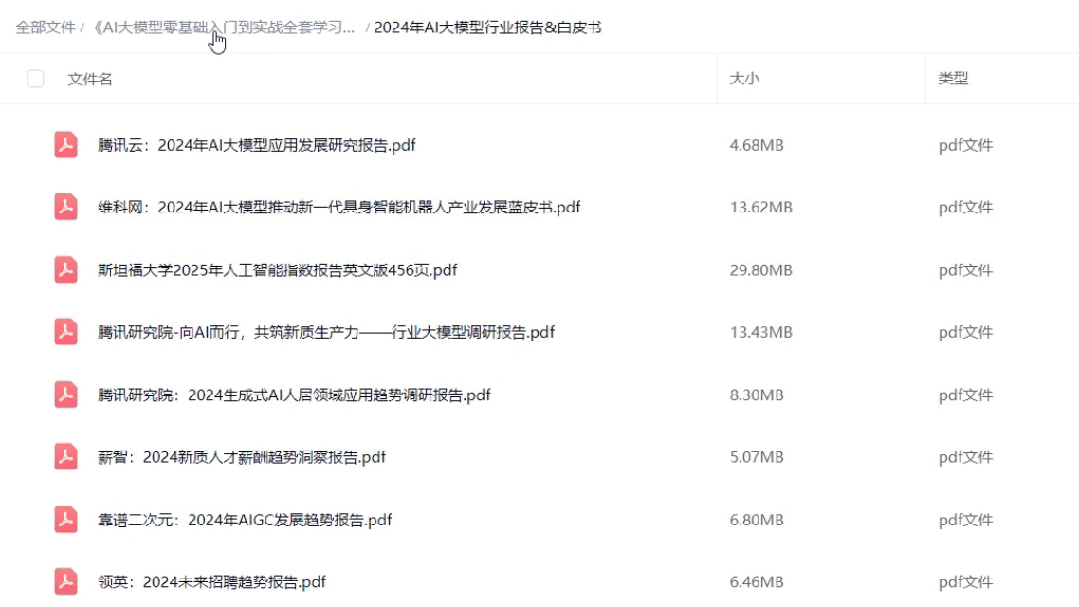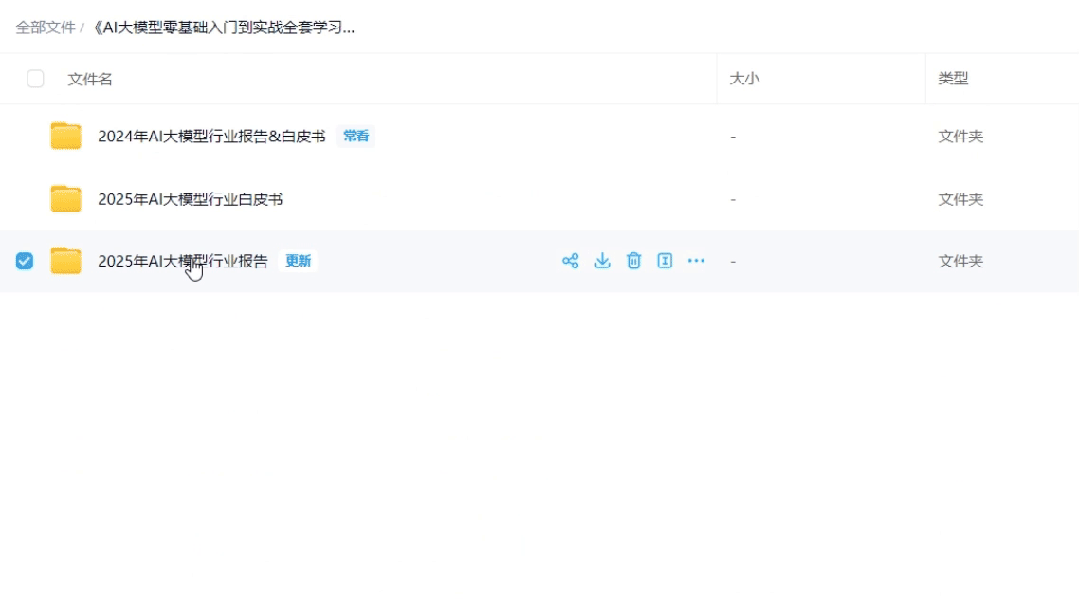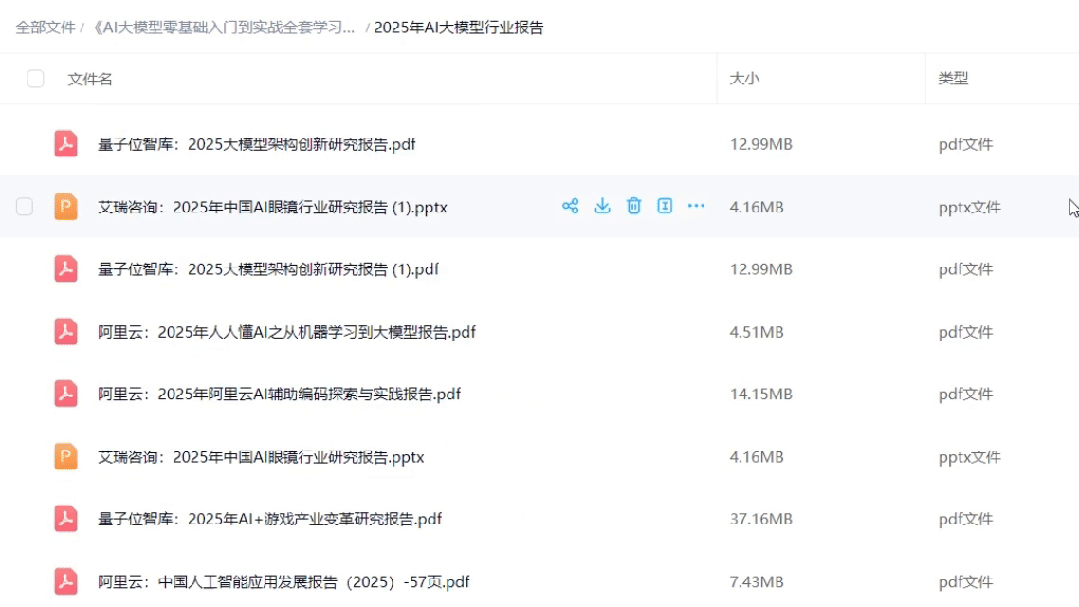
4、AI大模型最新行业报告
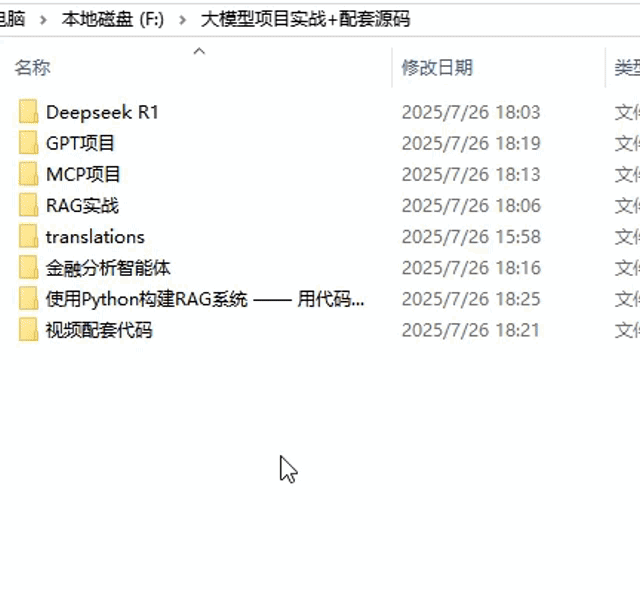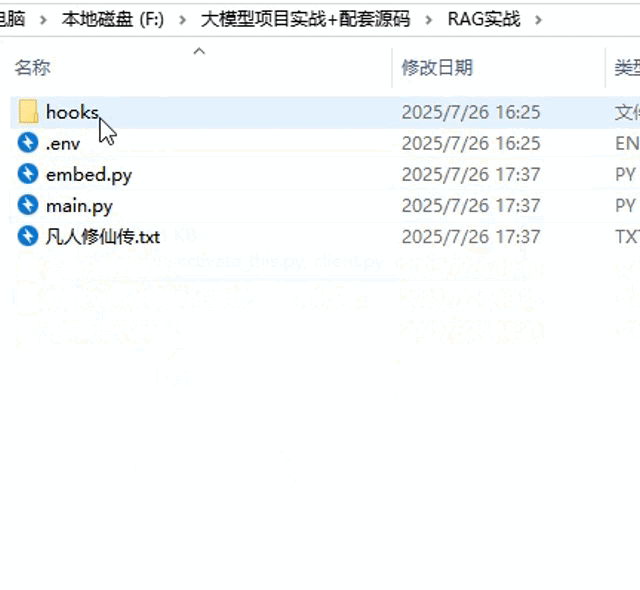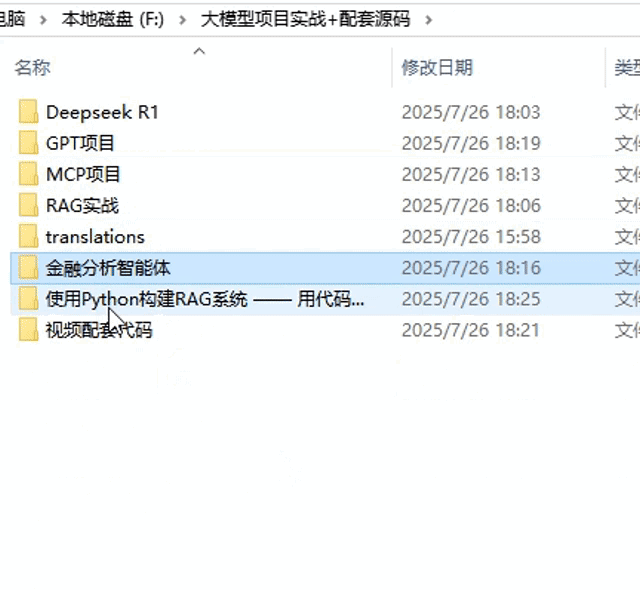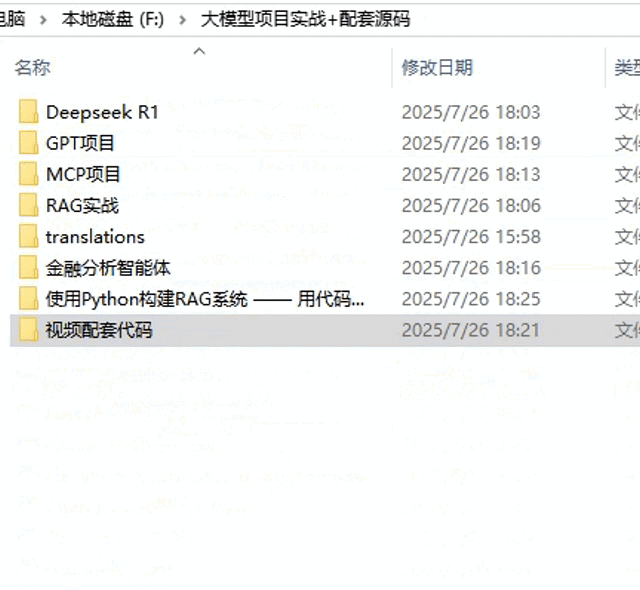
5、大模型项目实战&配套源码
6、2026大模型大厂面试真题
7、为什么要学习大模型?
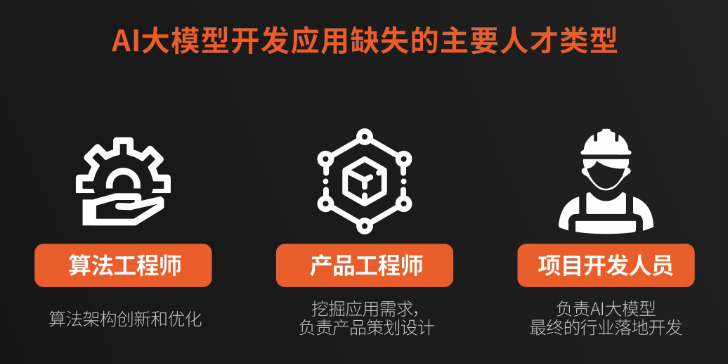
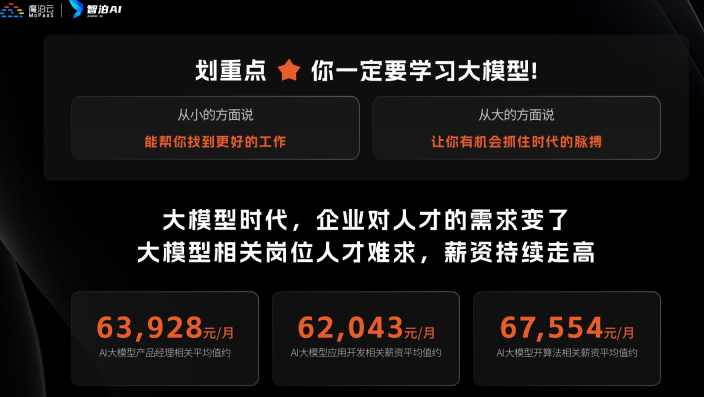
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。
8、适合谁学?
- 传统后端 / Java / 前端开发,想转型 AI 应用
- 大学生、应届生,想拿更好的 offer
- 产品经理、运营,想武装职业竞争力
- 技术负责人,想给团队落地提效
学习是反人性的,但回报是真金白银。技术会更新,赛道会切换,但只要你先动手,机会就永远站在你这边。
9、这些资料真的有用吗?
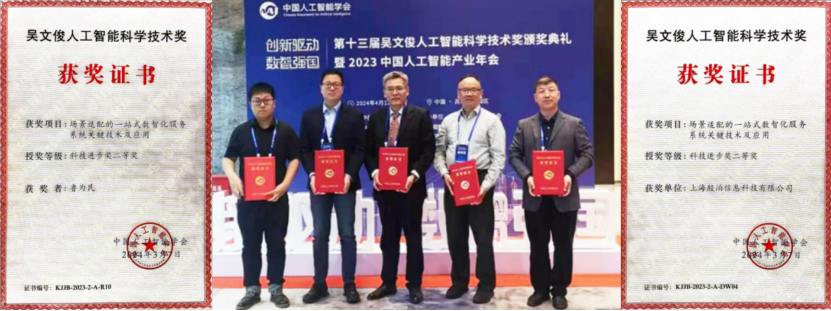
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
好了,就写到这。路线是死的,人是活的,卡住了随时来问我。觉得有用就点个收藏,别让它进收藏夹吃灰——动起来比啥都强。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 0
 0
- 0


 已为社区贡献514条内容

所有评论(0)