Milvus向量数据库
Milvus
一、什么是 Milvus?
Milvus 是开源、云原生分布式向量数据库,由 Zilliz 公司主导开发,专门用来存储、管理海量向量数据,并做向量相似度检索。
1.1 向量是什么?
传统数据库(MySQL、PostgreSQL)擅长精确关键词匹配:输入“苹果”,查找包含苹果两个字的记录。
但是大模型、图片、音频需要语义匹配:比如搜“一只趴在草地上的橘猫”,要找到内容相似的图片,文字关键词匹配做不到。
于是用 Embedding(嵌入模型),把文本/图片/音频转换成一串浮点数数组,这串数组就叫向量。
例:
[0.12,0.45,-0.71,……],常见维度:768、1024、1536。
向量之间的距离越小,代表语义/内容越相似。
1.2 Milvus 解决什么问题?
如果向量只有几百条,用 Python 直接循环计算距离就能检索。
当向量达到百万、千万、亿级别,暴力全量计算速度极慢。Milvus 的核心目标:在海量向量中,毫秒级找到最相似的向量。
典型应用场景
- RAG 知识库
- 图片检索、以图搜图
- 音频检索、视频内容检索
- 推荐系统、相似商品匹配
- 人脸、指纹等特征检索
一句话总结:MySQL 查关键词,Milvus 查“长得像”的数据。
1.3 Milvus 版本选型
- Milvus Lite:轻量单机版本,嵌入式,无需单独启动服务,适合本地调试、demo、Jupyter 实验,新手首选。
- Milvus Standalone(单机版):Docker 一键部署,适合测试、小规模业务。
- Milvus Cluster(分布式集群):多节点部署,支持水平扩容,生产环境承载亿级向量数据。
二、Milvus 核心概念(类比 MySQL,新手最好理解)
| Milvus概念 | MySQL类比 | 说明 |
|---|---|---|
| Database(数据库) | Database | 数据库实例,用来隔离多套业务 |
| Collection(集合) | Table 数据表 | 存放向量和标量元数据,同一个Collection里向量维度必须相同 |
| Entity(实体) | Row 一行记录 | 一条完整数据,包含主键、向量、文本/数字等元数据 |
| Field(字段) | Column 列 | 两种:标量字段(数字、字符串、主键)、向量字段(FLOAT_VECTOR) |
| Partition(分区) | 表分区 | Collection 的子集,检索时限定分区,减少扫描范围,加速查询 |
| Shard(分片) | 水平分表 | 数据物理分片,分布式集群用来负载均衡 |
| Segment(数据段) | 存储块 | Milvus内部最小存储单元。插入的数据先写到Growing Segment,满了之后密封成Sealed Segment,再构建索引 |
| Index(向量索引) | 索引 | 向量检索的核心,加速相似度搜索 |
重点:向量必须建索引才能高性能检索;标量字段也可以建索引,用来做过滤(where条件)。
三、Milvus 整体架构
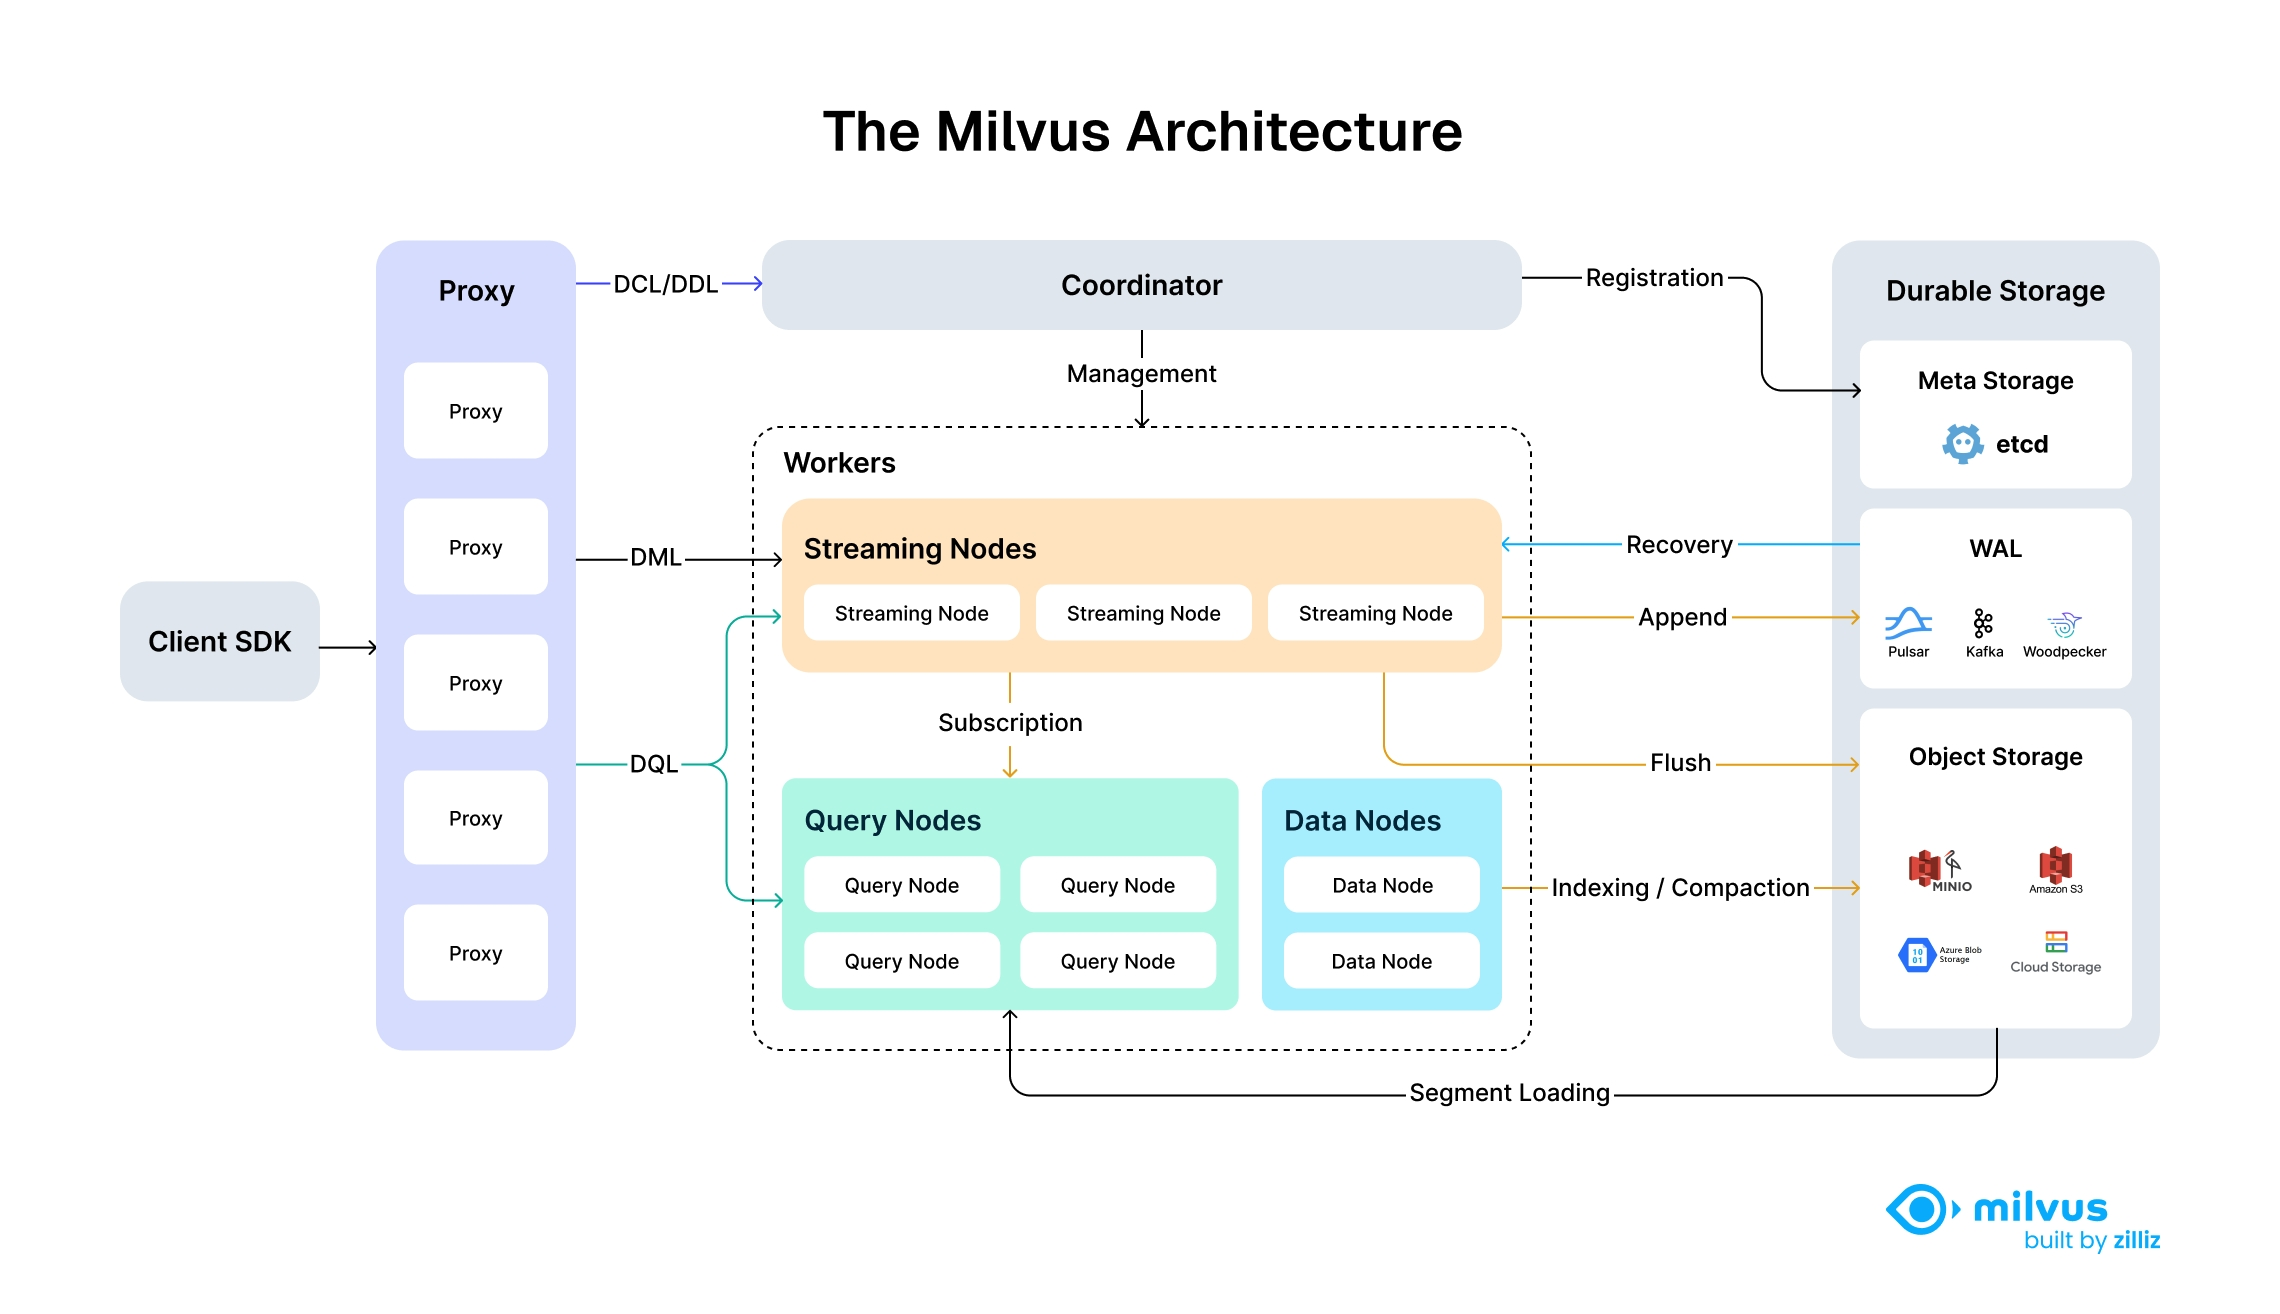
Milvus 整体分为四层:接入层、协调服务层、工作节点层、存储层,是存储计算分离的云原生架构,各个组件可以独立扩缩容。
1. 接入层:Proxy 代理节点
- 无状态网关,接收客户端SDK请求(pymilvus)
- 负责协议解析、权限校验、请求路由、负载均衡
- 对外暴露 19530 端口,是用户唯一访问入口。
2. 协调服务层:Coordinator(集群大脑)
- RootCoord:全局总控,管理Database、Collection、DDL(建表删表),维护集群拓扑
- DataCoord:管理数据写入、Segment生命周期、索引任务调度
- QueryCoord:管理查询任务,调度QueryNode加载Segment、查询负载均衡
3. 工作节点(Worker Nodes)
- QueryNode 查询节点:加载密封好的Segment和索引,处理向量检索、标量查询。可以横向扩容应对查询压力。
- DataNode 数据节点:消费消息队列,把写入的数据持久化、合并Segment、触发索引构建。
- IndexNode 索引节点:专门离线构建向量索引,大索引任务单独剥离,不影响查询。
- StreamingNode:处理增量实时写入的Growing Segment,支持实时数据查询、WAL日志恢复(v2.6+新组件)
4. 存储层(三类存储,完全解耦)
- 元数据存储 etcd:保存集群配置、collection schema、节点信息、索引元信息。etcd是分布式KV,只存少量元数据,不存向量原始数据。
- 消息队列 Log Broker(Pulsar/RocksDB):WAL预写日志,接收写入请求,保证写入可靠、支持故障回放。单机版内置RocksDB,集群使用Pulsar。
- 对象存储 Object Storage:MinIO、S3、OSS、COS。所有原始向量数据、索引文件最终持久化在这里。查询时才加载到QueryNode内存,节省服务器本地磁盘。
架构亮点:计算节点无状态;数据全部存在对象存储。节点宕机,只需要在其他节点重新加载数据即可,天然支持弹性伸缩。
四、Milvus 底层原理
4.1 数据写入流程
- SDK发送insert请求到Proxy
- Proxy转发给RootCoord校验schema,路由写入对应的shard
- 写入请求发送到消息队列(WAL日志,保证不丢数据),返回客户端写入成功
- DataNode消费消息,写入Growing Segment(可写入、可查询,没有索引)
- Growing Segment数据量达到阈值,自动密封,变成Sealed Segment,不再接受新增写入
- DataCoord调度IndexNode,给Sealed Segment构建向量索引
- 索引构建完成后,通知QueryCoord,QueryNode可以加载这个Segment,提供高速向量检索。
关键:新增实时数据(Growing Segment)没有索引,检索会走暴力扫描;密封后的Segment带索引,检索速度快。所以Milvus新写入数据检索会慢一点,密封建索引之后提速。
4.2 向量相似度计算方式(MetricType)
向量检索第一步:定义怎么判断两个向量是否相似,Milvus支持常用距离公式:
COSINE余弦相似度:RAG文本向量最常用,适合Embedding模型输出,值越接近1越相似L2欧氏距离:距离越小越相似,多用于图片特征向量IP内积:归一化向量场景,等价余弦
4.3 ANNS近似最近邻检索 & 索引类型
向量检索绝大多数使用 ANNS 近似最近邻算法:牺牲一点点召回精度,换取百倍检索速度。不需要遍历全部向量,只搜索候选子集。
Milvus内置Knowhere引擎,封装了Faiss、HNSWlib等检索库,提供多种索引:
- HNSW(图索引)
- 优点:内存充足时,检索速度极快,召回率高;RAG首选
- 缺点:占用内存大,构建索引慢
- 适用:百万~千万级向量,内存充裕的在线业务
- IVF_FLAT(倒排索引)
- 原理:先把向量聚类成nlist个聚类中心;检索时只搜索nprobe个最接近的聚类,不用扫全量
- 优点:内存占用比HNSW小;可控性强
- 缺点:召回略低于HNSW,调参nlist/nprobe影响效果
- AUTOINDEX(新手推荐)
- Milvus自动根据数据规模选择最合适索引,不用手动区分HNSW/IVF,快速开发demo首选。
其他:IVF_SQ8/IVF_PQ(量化压缩,节省内存,损失精度)、DiskANN(支持超大向量,索引放磁盘,内存占用低)。
4.4 混合检索(Hybrid Search)
Milvus不仅可以向量检索,还支持向量相似度 + 标量过滤。
示例:检索相似文档,并且只筛选create_time>170000000、category="AI"的数据。
expr='category == "AI"',先过滤标量,再在剩下数据里做向量检索。这是RAG非常实用的能力。
五、Milvus 上手实战(Python MilvusClient,Milvus Lite)
Milvus Lite不需要单独启动Docker,一行pip安装,适合新手快速跑通。
5.1 环境安装
pip install pymilvus
5.2 完整最小Demo
from pymilvus import MilvusClient
import numpy as np

# 1. 初始化Milvus Lite客户端,本地文件存储
client = MilvusClient("milvus_demo.db")

# 集合名称
coll_name = "demo_rag"
# 向量维度,常用embedding模型如bge是768维
dim = 768

# 如果集合已存在,先删除
if client.has_collection(coll_name):
    client.drop_collection(coll_name)

# 2. 创建集合,AUTOINDEX自动创建索引
client.create_collection(
    collection_name=coll_name,
    dimension=dim,
    metric_type="COSINE",
    auto_id=True
)

# 3. 准备模拟数据:生成随机向量 + 文本元数据
num_data = 5
vectors = np.random.rand(num_data, dim).tolist()
data = [
    {"vector": vectors[i], "text": f"文档内容{i}", "category": "tech"}
    for i in range(num_data)
]

# 4. 插入数据
res = client.insert(collection_name=coll_name, data=data)
print("插入结果:", res)

# 5. 向量检索,用一条查询向量找Top3相似
query_vector = np.random.rand(1, dim).tolist()
search_res = client.search(
    collection_name=coll_name,
    data=query_vector,
    limit=3, # 返回前3条最相似
    output_fields=["text", "category"], # 返回的元数据字段
    # 标量过滤示例:expr='category == "tech"'
)

# 打印检索结果
for hits in search_res:
    for hit in hits:
        print(f"ID:{hit['id']}, 相似度:{hit['distance']}, 文本:{hit['entity']['text']}")

# 6. 清理(可选)
# client.drop_collection(coll_name)
5.3 部署方式(生产测试)
- Milvus Lite:本地开发、Demo,如上代码。
- 单机Standalone:Docker部署,适合测试环境,官方一键docker-compose。
- 分布式Cluster:K8s部署,生产承载亿级向量,需要MinIO、etcd、Pulsar组件。
配套可视化工具 Attu,网页UI查看集合、数据、索引、监控,调试非常方便。
六、常用运维&调优基础
- 维度固定:同一个Collection内向量维度必须一致,不能一半768一半1536。
- 索引不是实时生效:新插入数据是Growing Segment,无索引,检索性能差;等待密封构建索引。
- 召回率和速度取舍:ANNS索引没有100%召回。调参可以提升召回,但检索延迟上升。
- 内存规划:HNSW索引非常吃内存;向量数量巨大优先DiskANN或者IVF_PQ量化。
- 分区Partition Key:多租户场景,按用户id做partition key,检索直接跳过无关分区,大幅提速。
- 不要频繁删除:Milvus删除是逻辑删除,产生碎片(类似数据库vacuum),大量删改需要compaction合并Segment。
七、Milvus 优缺点总结
✅ 优点
- 原生向量数据库,专为相似度检索设计,不是在普通数据库上加向量插件
- 云原生分布式,支持水平扩容,亿级向量毫秒检索
- 支持混合检索:向量检索 + 标量过滤,完美适配RAG
- 丰富索引,支持GPU加速、磁盘索引
- SDK完善:Python、Java、Go,生态成熟,LangChain、LlamaIndex原生集成
❌ 缺点
- 资源开销高,HNSW索引消耗大量内存
- 不适合高频大量更新场景,向量更偏向读多写少
- 学习成本:索引参数、compaction、shard、partition等概念较多
八、Milvus 在RAG中的完整链路
文档 → 文本切分 → Embedding模型转向量 → 存入Milvus
用户提问 → 问题转向量 → Milvus向量检索,召回相似文档片段 → 把文档和问题一起送入大模型 → 生成答案。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)