CSI 从 v1.0 到 v1.11:AI 训练工作负载的存储架构该怎么落地
AI 训练任务对存储的要求,和传统 Web 服务几乎是两个物种。一个典型的分布式训练作业,可能在几秒钟内拉起几十个 Pod,每个 Pod 同时以高吞吐读取几万个小文件,训练中途还要周期性写 checkpoint,单文件动辄十几 GB。这些行为叠加在一起,会把集群里原本"够用"的存储方案压得很难看。
更麻烦的是,这些需求并不是静态的。数据预处理阶段希望共享读写、训练阶段希望本地缓存、推理阶段希望低延迟挂载、模型归档又希望走对象存储。一个集群里要同时容纳这些形态,靠早期 CSI 驱动的能力是不够的。
我把 CSI 这几年的版本演进重新过了一遍,整理出哪些能力真正解决了 AI 工作负载的痛点,哪些只是规范层面好看,落地还有距离。下面按"能力 → 场景 → 落地方式"的顺序展开。
CSI 到底在演进什么
CSI(Container Storage Interface)在 Kubernetes 1.13 进入 GA,之后规范独立于 Kubernetes 发布,目前由 CSI 社区维护,版本号从 1.0 一路走到 1.11(我写这篇文章时能查到的最新规范版本是 1.11,具体请以 csi-spec 仓库 README 为准)。它本质是一份 gRPC 接口定义,规定存储厂商要实现哪些方法、Kubelet 和外部组件会怎么调用。
早期 CSI 的痛点很集中:所有逻辑塞在同一个二进制里,升级驱动要动 DaemonSet,Sidecar 和驱动耦合,快照、扩容、卷健康这些能力要么没有,要么各家自己造轮子。后来社区把职责拆开,形成了今天大家熟悉的这一组 Sidecar:
| 组件 | 职责 | 对应的 CSI 能力 |
|---|---|---|
| external-provisioner | 监听 PVC,调用 CreateVolume | Controller 侧 |
| external-attacher | 处理 VolumeAttachment,调用 ControllerPublish | Controller 侧 |
| external-resizer | 处理扩容请求 | Controller 侧 |
| external-snapshotter | 处理 VolumeSnapshot | Controller 侧 |
| external-health-monitor | 上报卷健康 | Node 侧 + Controller 侧 |
| node-driver-registrar | 向 Kubelet 注册驱动 | Node 侧 |
| livenessprobe | 健康探测 | 通用 |
这个拆分对 AI 场景的意义在哪?在于能力可以独立升级。比如你需要快照能力,只要升级 external-snapshotter 和驱动对快照接口的实现,不需要动整个存储 DaemonSet。对一个跑着几十个训练作业的生产集群,这一点很关键。
规范演进中,几个对 AI 负载影响较大的节点:
- CSI 1.1 引入 VolumeSnapshot 相关接口(ControllerCreateSnapshot 等),让快照从"厂商私有 CRD"变成标准能力。
- CSI 1.3 加入 VolumeGroupSnapshot,可以一次性对多个卷做一致性快照。这个对分布式训练非常关键——参数服务器 + 多个 worker 的卷状态必须一致,否则恢复后数据错位。
- CSI 1.5 之后 强化了 VolumeHealth,节点侧能上报卷异常,配合 Pod 事件做自动迁移。
- CSI 1.9 / 1.10 附近 对拓扑、可访问性、单节点多卷并发做了细化。
【关键结论】AI 训练场景真正需要关注的是 CSI 1.3 以后的版本,因为 VolumeGroupSnapshot 之前,多卷一致性快照基本只能靠厂商自定义方案。
训练场景:为什么默认的 ReadWriteOnce 不够用
Kubernetes 的 PV 访问模式里,ReadWriteOnce(RWO)只能被单个节点挂载。对单机训练没问题,但分布式训练里,多个 worker 通常分布在不同节点,都要读同一份数据集。
很多人第一反应是用 ReadWriteMany(RWX),让所有 worker 挂同一个卷。这在 NFS 或 CephFS 上确实可行,但有个隐藏代价:共享文件系统的元数据操作在几十个 Pod 并发时会成为瓶颈。我见过一些场景,模型加载卡在 open() 上,原因是 NFS 的 attribute cache 被打爆。
实际生产中更常见的做法是分层:
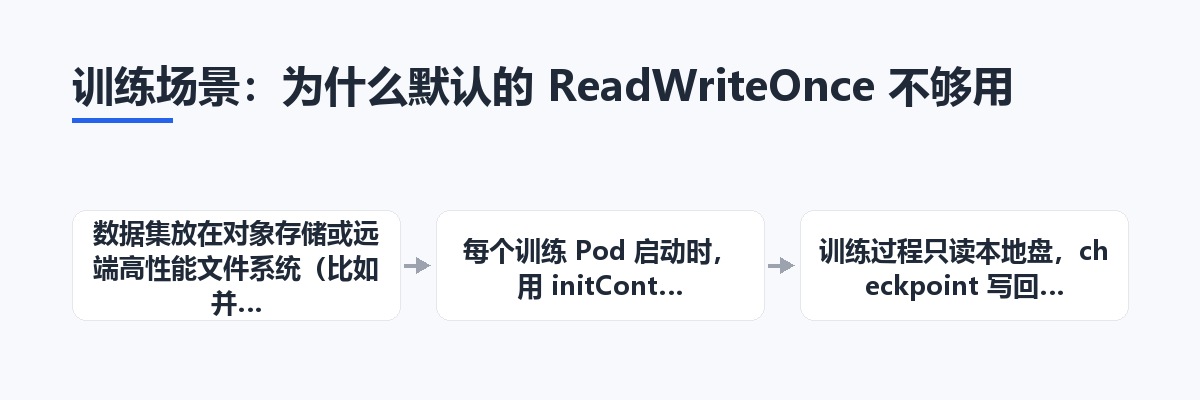
- 数据集放在对象存储或远端高性能文件系统(比如并行文件系统)。
- 每个训练 Pod 启动时,用 initContainer 把需要的分片拉到本地 NVMe。
- 训练过程只读本地盘,checkpoint 写回共享存储。
这个模式在 Kubeflow、Volcano、PyTorch Operator 里都有对应的实现思路。下面是一个简化的 initContainer 拉数据示例:
apiVersion: v1
kind: Pod
metadata:
  name: train-worker
spec:
  initContainers:
    - name: fetch-shard
      image: python:3.11-slim
      command:
        - python
        - -c
        - |
          import os, shutil
          src = "/remote/dataset/shard-${SHARD_ID}"
          dst = "/local-cache/shard"
          os.makedirs(dst, exist_ok=True)
          for name in os.listdir(src):
              shutil.copy2(os.path.join(src, name), dst)
          print("copy done:", len(os.listdir(dst)), "files")
      env:
        - name: SHARD_ID
          valueFrom:
            fieldRef:
              fieldPath: metadata.labels['shard-id']
      volumeMounts:
        - name: remote
          mountPath: /remote
        - name: local-cache
          mountPath: /local-cache
  containers:
    - name: trainer
      image: pytorch/pytorch:2.3.0-cuda12.1-cudnn8-runtime
      command: ["python", "-m", "torch.distributed.run", "--nproc_per_node=8", "train.py"]
      volumeMounts:
        - name: local-cache
          mountPath: /data
  volumes:
    - name: remote
      persistentVolumeClaim:
        claimName: dataset-rwx
    - name: local-cache
      emptyDir:
        medium: ""
这里 emptyDir 用的是默认介质,落在节点磁盘上。如果节点有 NVMe,可以配合 local 类型的 PV 或者 hostPath 直接挂裸盘,但要自己处理调度和清理。emptyDir.medium: Memory 虽然快,但受 Pod 内存 limit 限制,几十 GB 数据集基本放不下。
【注意】emptyDir 的生命周期跟 Pod 绑定,Pod 重启数据就没了。训练任务如果频繁抢占重调度(比如用 Volcano gang scheduling),这个方案会反复拉数据。建议给数据集分片做本地缓存目录 + 一致性 hash 命名,重启后能命中一部分。
VolumeGroupSnapshot:分布式训练的救星还是半成品
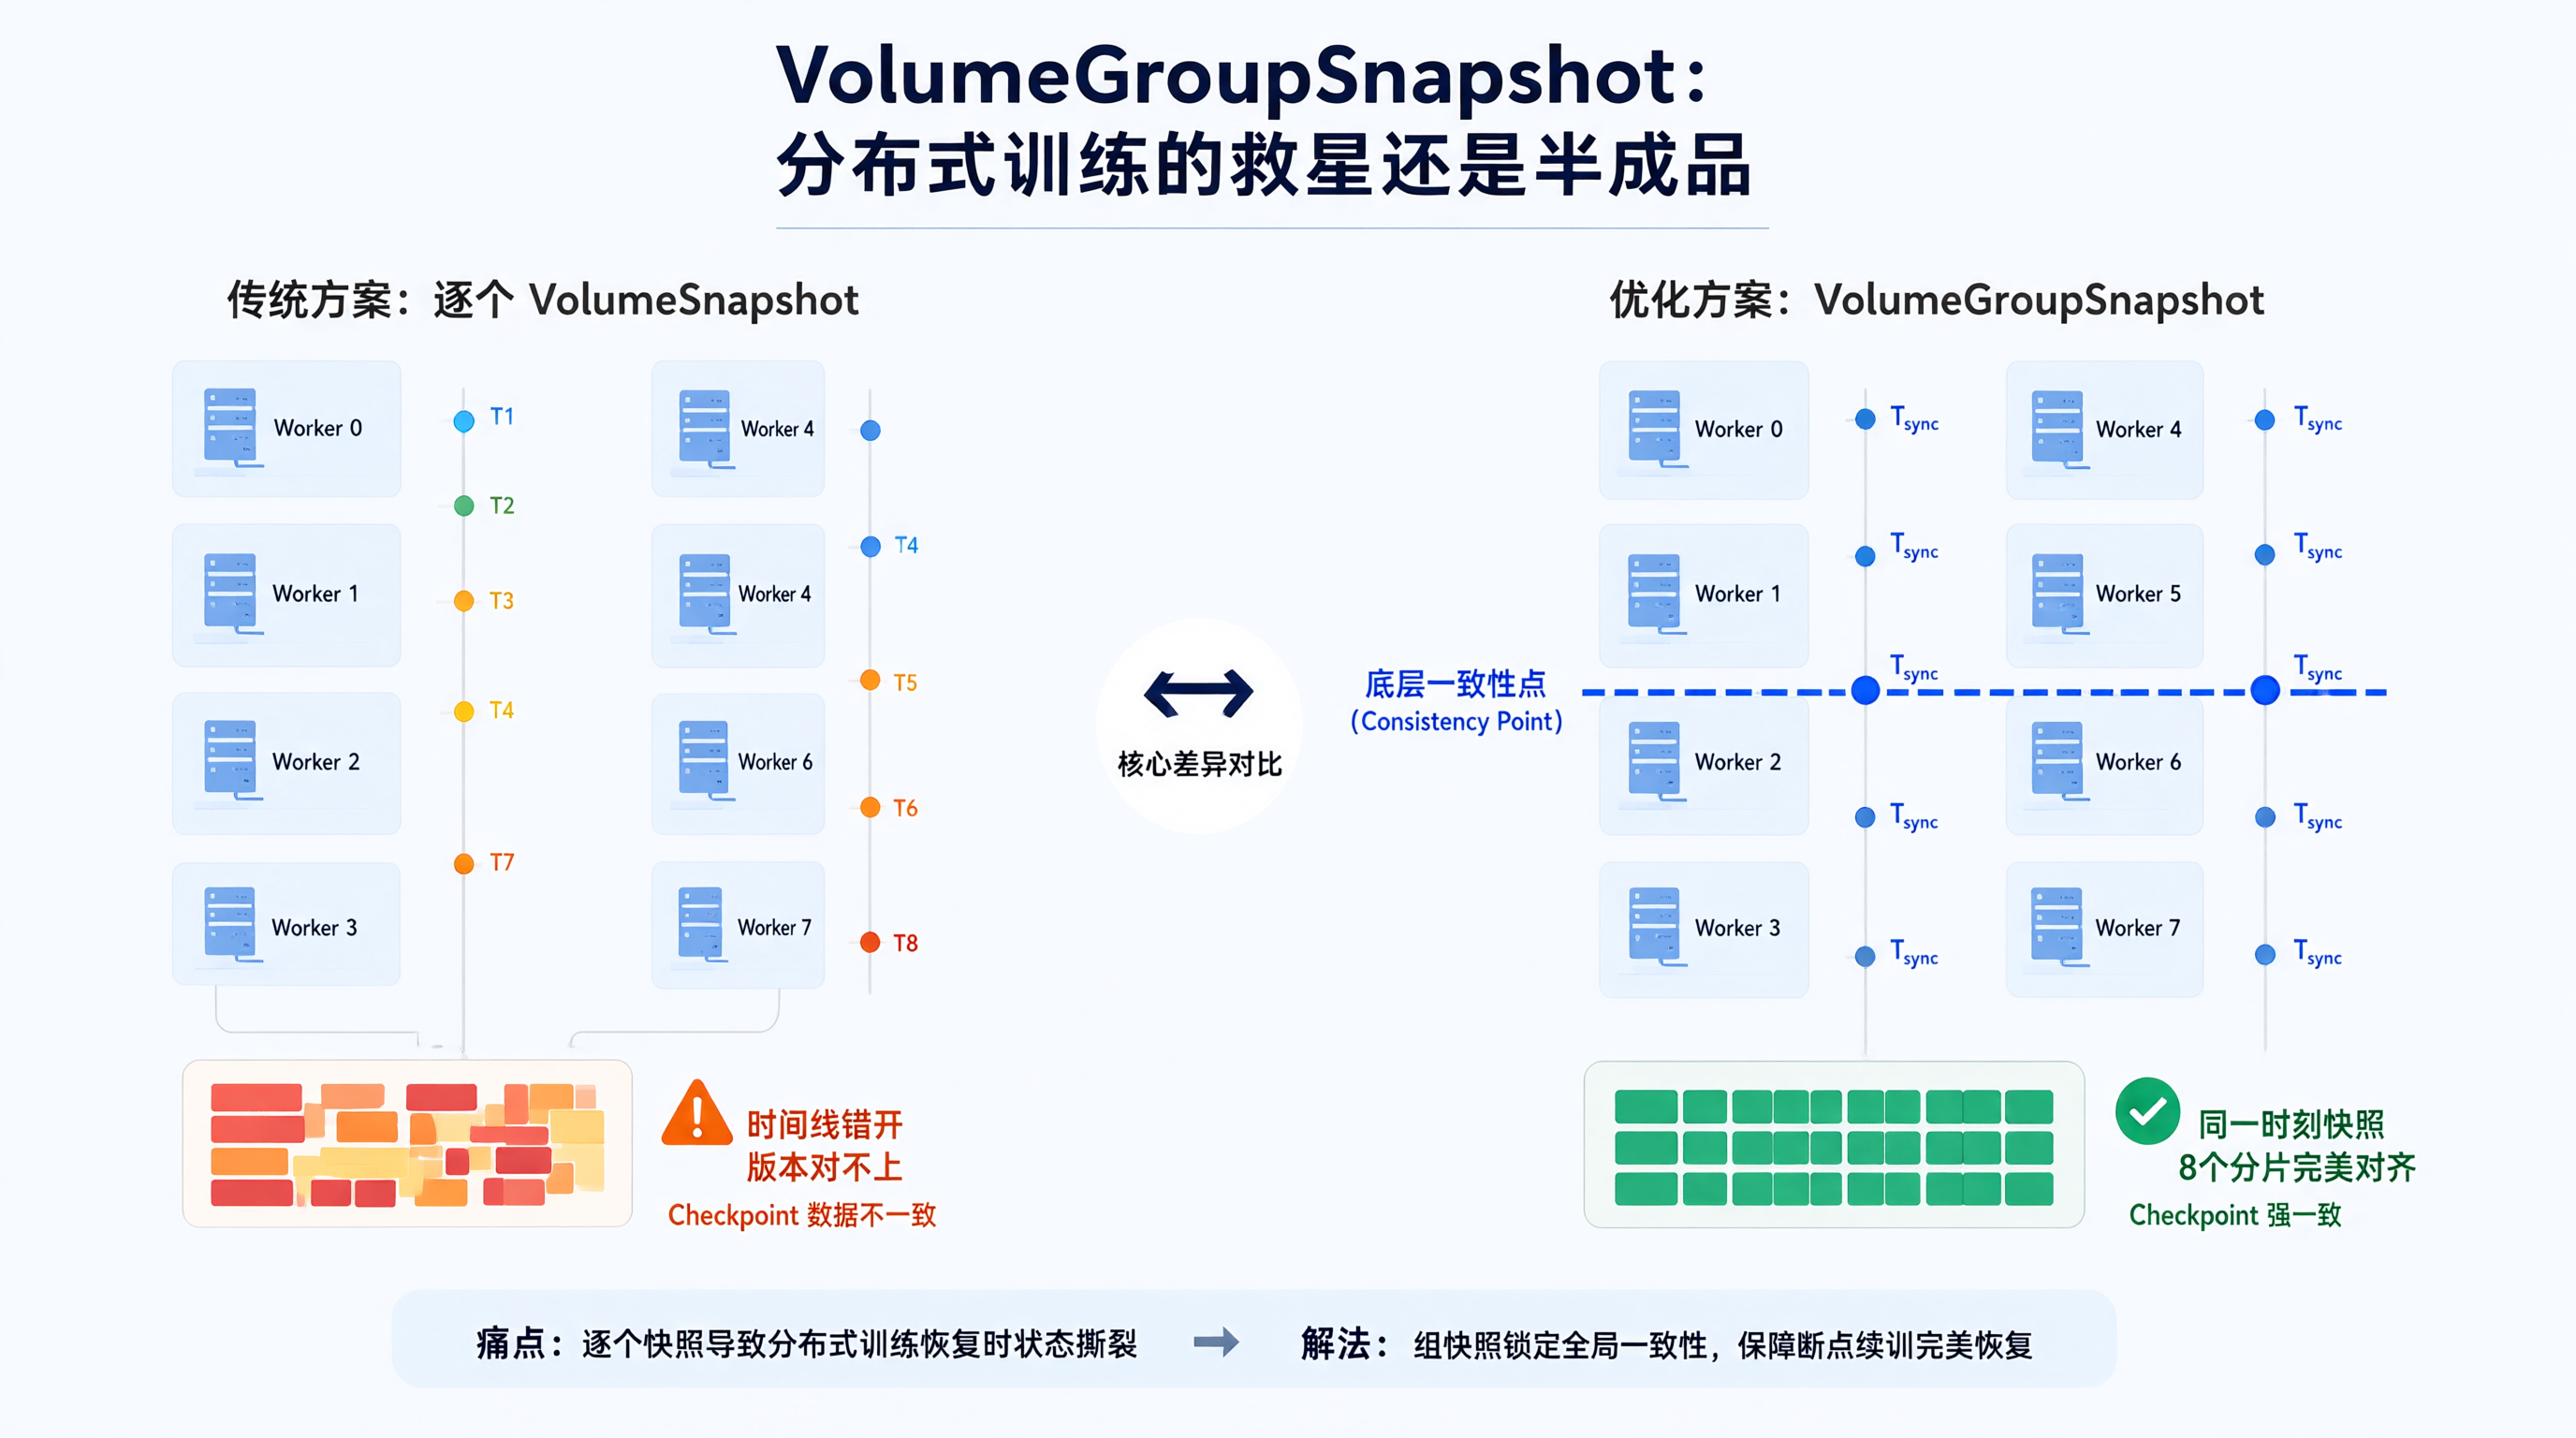
前面提到 CSI 1.3 引入 VolumeGroupSnapshot,这是我认为对 AI 训练影响最大的一个能力。设想一个 8 worker 的作业,每个 worker 写自己的 checkpoint 分片,如果只用 VolumeSnapshot 逐个拍,拍完第一个和拍完第八个之间可能隔了几十秒,恢复时参数版本对不上,训练直接崩。
VolumeGroupSnapshot 通过一个 GroupSnapshotClass 和一组 PVC 列表,让驱动在底层做一致性点。规范里定义了 CreateVolumeGroupSnapshot、DeleteVolumeGroupSnapshot、GetVolumeGroupSnapshot 三个 Controller 接口,以及对应的 CRD。
一个典型的 VolumeGroupSnapshotClass 长这样(具体字段以你用的驱动文档为准,这里只是结构示意):
apiVersion: groupsnapshot.storage.k8s.io/v1alpha1
kind: VolumeGroupSnapshotClass
metadata:
  name: csi-group-snapclass
driver: your.csi.driver
deletionPolicy: Delete
parameters:
  # 驱动相关参数,各家不同
  consistencyLevel: "application"
对应的请求:
apiVersion: groupsnapshot.storage.k8s.io/v1alpha1
kind: VolumeGroupSnapshot
metadata:
  name: train-ckpt-group
spec:
  volumeGroupSnapshotClassName: csi-group-snapclass
  source:
    selector:
      matchLabels:
        app: train-ckpt
但这里我要说清楚:VolumeGroupSnapshot 在 Kubernetes 上游仍处于 alpha 阶段,对应的 CRD 属于 groupsnapshot.storage.k8s.io/v1alpha1,feature gate 和 API 版本可能随版本变化,生产使用前要确认你的集群版本和存储驱动是否支持。 我没有在 1.30 以上的集群实测过所有驱动的行为,这一点我没有验证。
实际能不能用,取决于两件事:
- 你的 CSI 驱动是否实现了 Group 接口。Ceph CSI、部分企业存储驱动已经支持,但开源社区覆盖度不齐。
- 你的存储后端是否真的能保证跨卷一致性点。有些驱动只是把单卷快照循环调用了一遍,并没有真正的一致点,这种情况下 GroupSnapshot 只是"接口统一",语义上并不比逐个拍强。
判断方法很简单:看驱动的 release notes 里有没有提 “consistency group” 或 “atomic snapshot”,而不是只看它实现了哪个接口。
推理场景:低延迟挂载和拓扑感知
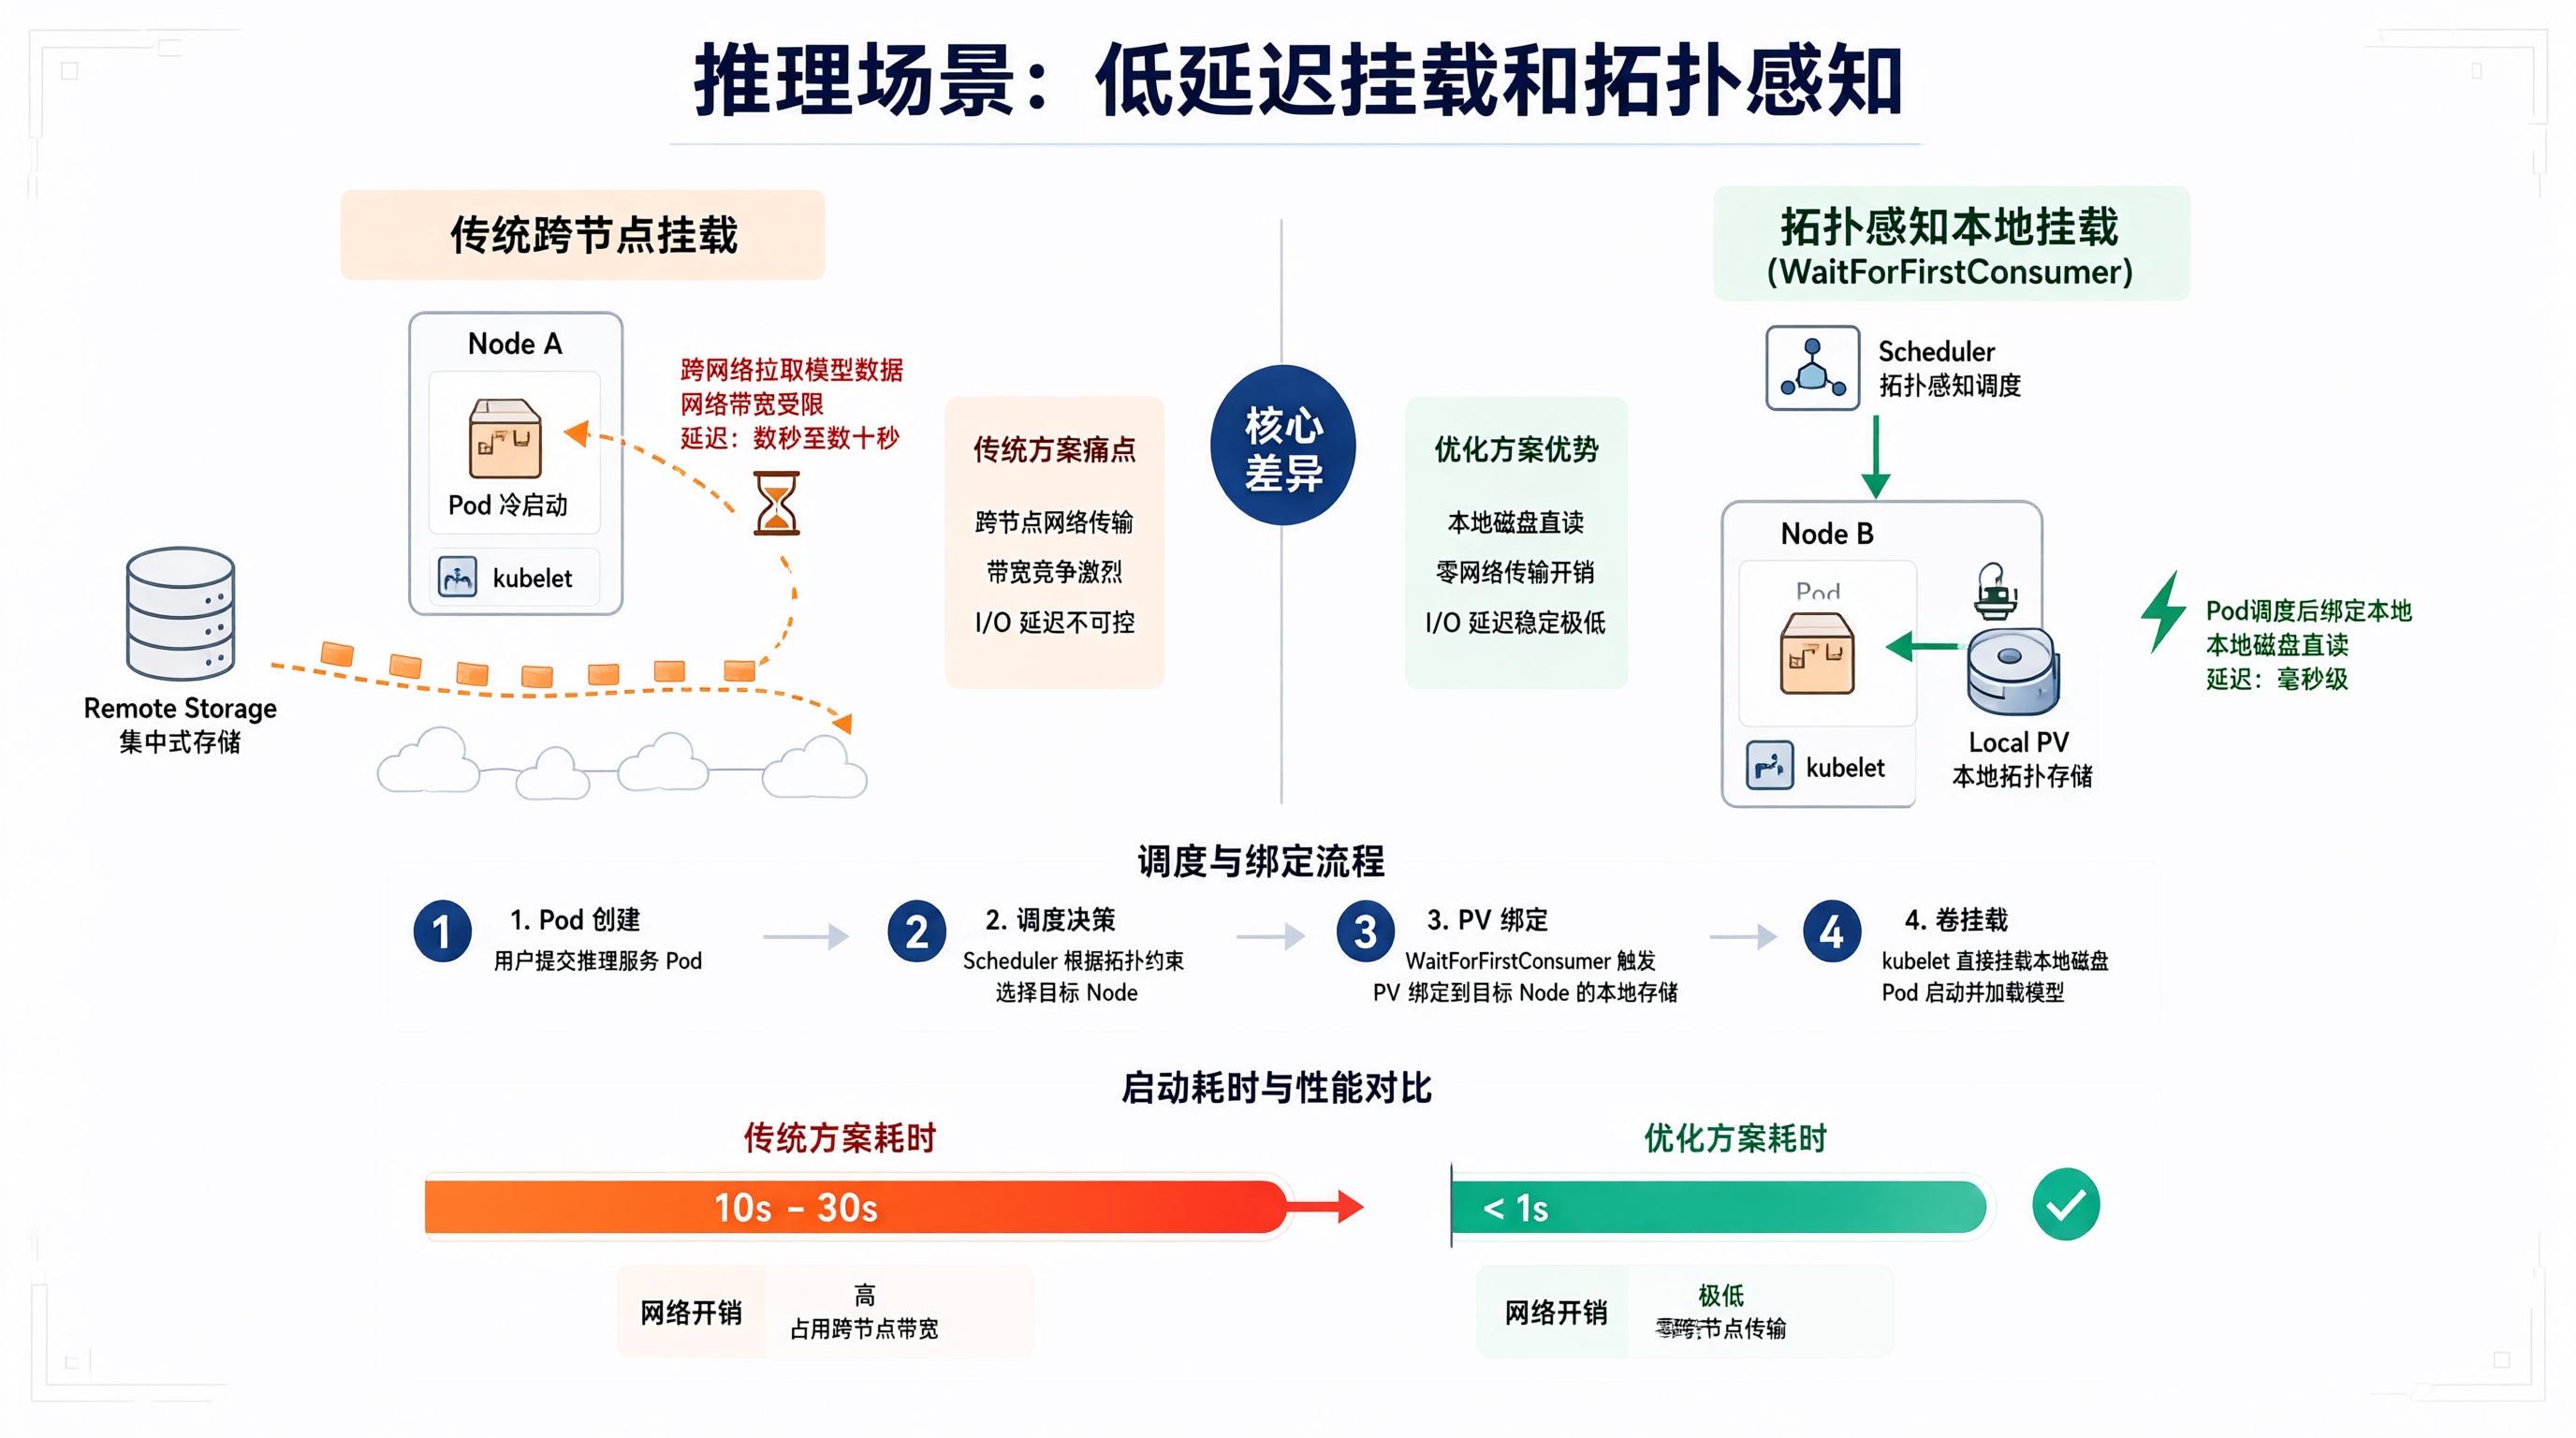
推理和训练的需求差别很大。模型文件通常是几个 GB 到几十 GB,加载一次后长期驻留内存。这时候存储的核心指标不是吞吐,而是首次挂载延迟和节点亲和性。
如果模型卷是通过网络文件系统挂载的,Pod 冷启动时可能要等几秒到几十秒。这在弹性扩缩容场景下非常难受。Kubernetes 的 volumeBindingMode: WaitForFirstConsumer 可以让 PV 在 Pod 调度后再绑定,避免跨节点拉数据,但前提是存储后端支持拓扑感知。
一个拓扑感知的 StorageClass:
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: local-nvme
provisioner: your.csi.driver
volumeBindingMode: WaitForFirstConsumer
allowedTopologies:
  - matchLabelExpressions:
      - key: topology.kubernetes.io/zone
        values: ["zone-a", "zone-b"]
reclaimPolicy: Retain
WaitForFirstConsumer 的效果是:PVC 不会立即绑定,等到有 Pod 使用它时,调度器把节点信息传给 provisioner,provisioner 在该节点所在拓扑域创建卷。这避免了"卷在 zone-a,Pod 调度到 zone-b"的跨区流量。
【踩坑提醒】WaitForFirstConsumer 和 ReadWriteMany 组合时,很多驱动的行为不一致。有些驱动在 RWX 下会忽略拓扑约束,直接创建全局可访问的卷。如果你的推理服务依赖本地 NVMe 的低延迟,得确认驱动在 RWX 下是否还遵守拓扑。
推理场景还有一点容易被忽略:模型卷通常是只读的。用 ReadOnlyMany(ROX)或者挂载时加 readOnly: true,可以让存储后端做更多优化,也避免误写。这个细节在 CSI 规范里没有强制,但大多数驱动都会对只读挂载做缓存优化。
并行文件系统与对象存储网关的取舍
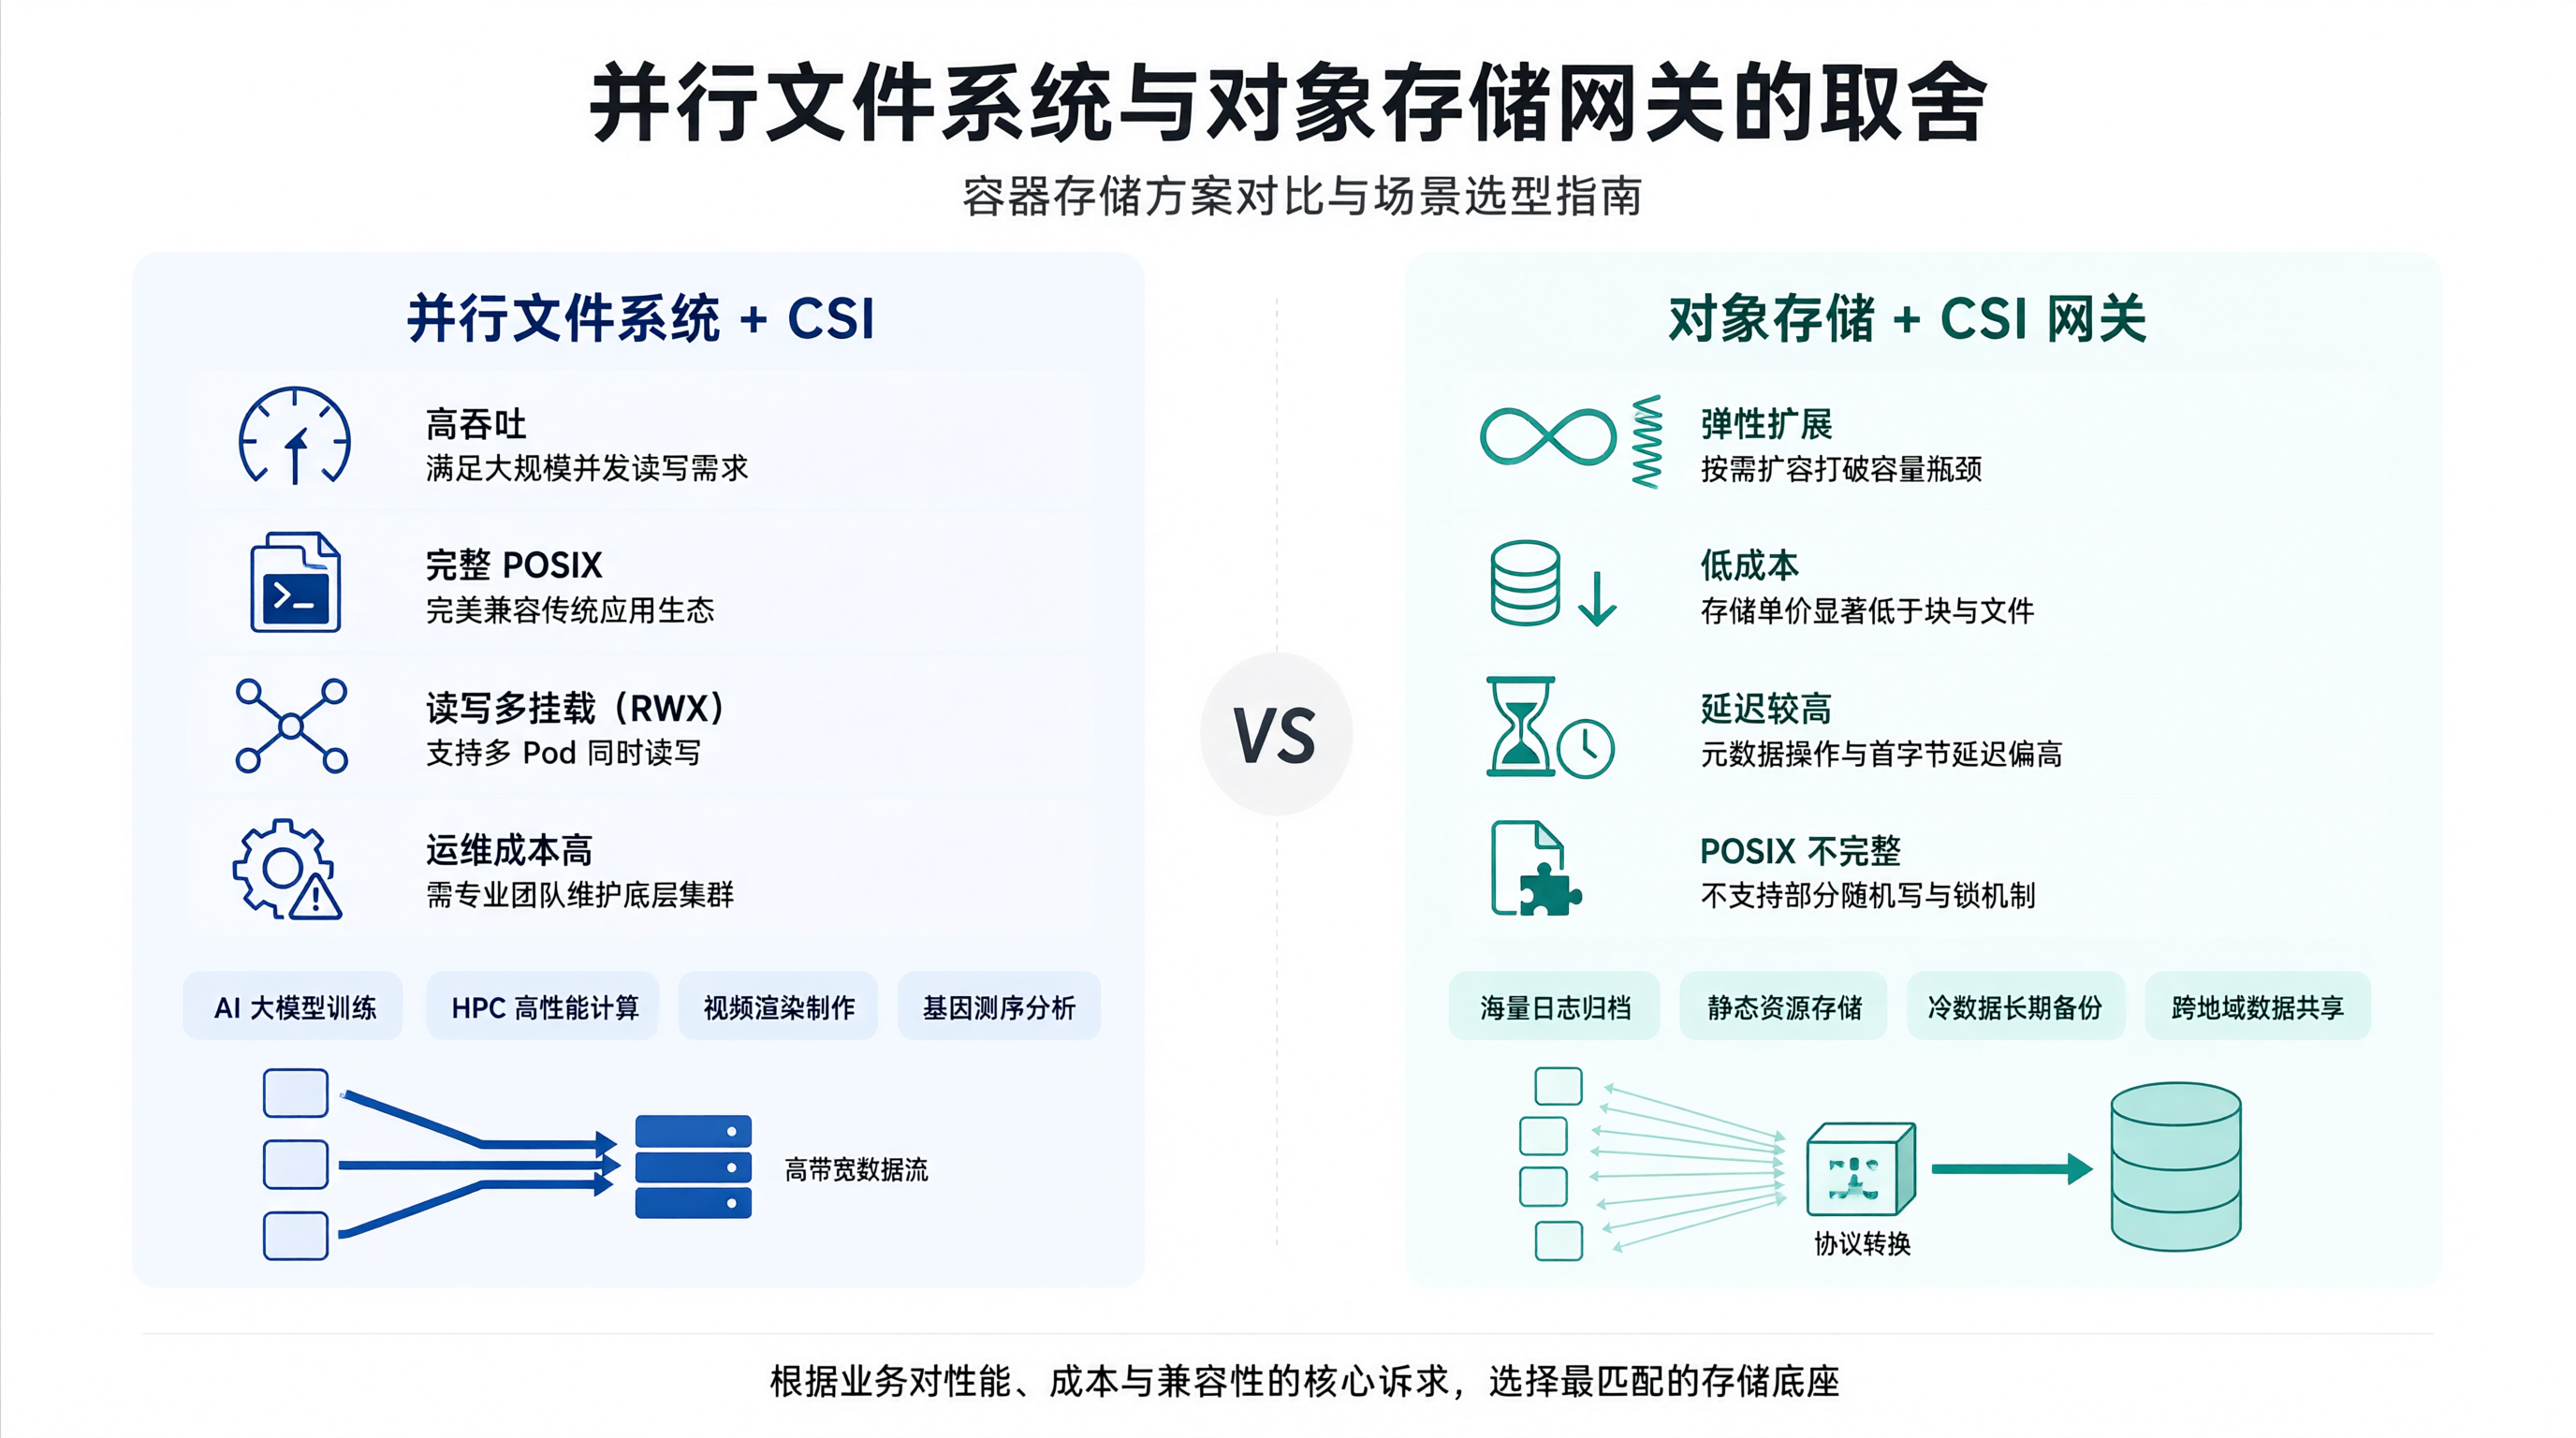
说到高性能,绕不开并行文件系统(Lustre、GPFS、WekaFS、JuiceFS 等)。它们和 CSI 的关系是:CSI 只是挂载入口,真正的性能来自后端。
| 方案 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| 并行文件系统 + CSI | 高吞吐、POSIX 语义、支持 RWX | 部署运维成本高、需要专用网络 | 大规模训练、数据预处理 |
| 对象存储 + CSI 网关 | 弹性、成本低、容量近乎无限 | 延迟高、POSIX 语义不完整 | 数据集归档、模型仓库 |
| 本地 NVMe + CSI | 延迟最低、带宽最高 | 容量受限、数据不共享 | 推理、缓存层 |
| 分布式块存储 + CSI | 一致性快照、支持 GroupSnapshot | 元数据操作弱、不适合海量小文件 | checkpoint、数据库 |
实际架构里,这几种通常是组合使用。我梳理过的一个思路是:
- 数据集冷存:对象存储
- 数据集热存:并行文件系统
- 训练缓存:本地 NVMe
- checkpoint:分布式块存储 + VolumeGroupSnapshot
- 模型仓库:对象存储 + 只读挂载
这套组合的问题在于数据要在层之间搬运,搬运逻辑容易写成一次性脚本,缺乏可观测性。我的建议是把搬运逻辑做成独立的 Job 或者 Operator,状态写到 CRD 里,而不是塞在 initContainer 里。
Python 侧怎么配合存储架构
存储架构最终要落到代码里。AI 训练代码对存储的感知,主要集中在三个地方:数据加载、checkpoint 写入、日志/指标上报。
数据加载层面,PyTorch 的 DataLoader 如果直接从网络文件系统读,num_workers 一开大就会打爆元数据。一个常见的优化是先把数据映射到本地,再用 DataLoader:
# 需要 Python 3.10+ 和 torch 2.3 及以上
import os
import torch
from torch.utils.data import Dataset, DataLoader
from pathlib import Path

class LocalShardDataset(Dataset):
    def __init__(self, cache_dir: str):
        self.files = sorted(Path(cache_dir).rglob("*.bin"))
        if not self.files:
            raise RuntimeError(f"no shard found in {cache_dir}")

    def __len__(self):
        return len(self.files)

    def __getitem__(self, idx):
        # 本地文件,直接 mmap 读取,避免走网络
        return torch.load(self.files[idx], map_location="cpu")

def build_loader(cache_dir: str, batch_size: int = 64) -> DataLoader:
    ds = LocalShardDataset(cache_dir)
    return DataLoader(
        ds,
        batch_size=batch_size,
        num_workers=min(8, os.cpu_count() or 1),
        pin_memory=True,
        persistent_workers=True,
        prefetch_factor=4,
    )
这里几个参数值得说明:persistent_workers=True 让 worker 进程在 epoch 之间复用,避免反复 fork;prefetch_factor=4 是每个 worker 预取 4 个 batch,配合本地盘能压住 IO 抖动;pin_memory=True 让数据在送入 GPU 前锁页,减少 H2D 拷贝开销。这些参数在官方文档里都有,但组合效果和存储层强相关——如果你的数据还在 NFS 上,num_workers 越大反而越慢。
checkpoint 写入这块,建议先写本地再异步搬到共享存储。直接写网络文件系统,训练进程会阻塞在 fsync 上:
import os
import shutil
import threading
from pathlib import Path

def save_checkpoint(state: dict, local_path: str, remote_path: str) -> None:
    local = Path(local_path)
    local.parent.mkdir(parents=True, exist_ok=True)
    # 先落本地,确保训练不阻塞
    torch.save(state, local)  # noqa: F821

    def _upload():
        remote = Path(remote_path)
        remote.parent.mkdir(parents=True, exist_ok=True)
        shutil.copy2(local, remote)

    threading.Thread(target=_upload, daemon=True).start()
【注意】这个异步上传线程是 daemon,训练进程退出时可能来不及上传完。生产里更稳妥的是用队列 + 独立进程,或者干脆让 checkpoint 落到本地 PV,由外部 sidecar 负责搬运。异步线程只是示意,不要直接抄进生产代码。
一些我还没验证清楚的地方
写到这里,有几个问题我确实没有实测结论,明确列出来避免误导:
- VolumeGroupSnapshot 在不同 CSI 驱动上的实际一致性语义。规范定义了接口,但驱动实现差异很大。我只确认了它在上游是 alpha,没有验证过 Ceph CSI、Longhorn 等具体驱动的行为。
WaitForFirstConsumer与 RWX 组合的拓扑遵守情况。理论上调度器会传拓扑,但驱动是否遵守,取决于实现。我没有逐一测试。- CSI 1.11 相对 1.10 的破坏性变更清单。规范演进很快,我只关注了几个和 AI 负载相关的接口,没有完整比对 changelog。
这些点如果要做生产选型,建议直接看目标驱动的 release notes 和 issue tracker,不要只看 CSI 规范。
落地时的判断顺序
如果让我给一个落地顺序,大概是:
- 先明确工作负载类型(训练 / 推理 / 数据预处理),确定核心指标是吞吐、延迟还是容量。
- 再确认 CSI 驱动是否支持对应能力(RWX、拓扑感知、GroupSnapshot),拿真实负载压测。
- 最后才考虑组合方案(本地缓存 + 共享存储 + 对象归档),因为组合的复杂度远高于单点能力。
存储架构这件事,没有银弹。CSI 提供了标准接口,但接口背后的语义一致性、性能特征、运维成本,还是要一个个场景去验证。规范能帮你少踩接口层面的坑,语义层面的坑,得自己趟。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)