别再死磕提示词了,AI项目真正的差距在RAG和Agent工程化
RAG, Agent, LangChain, 向量数据库, AI工程化,迪飞特科技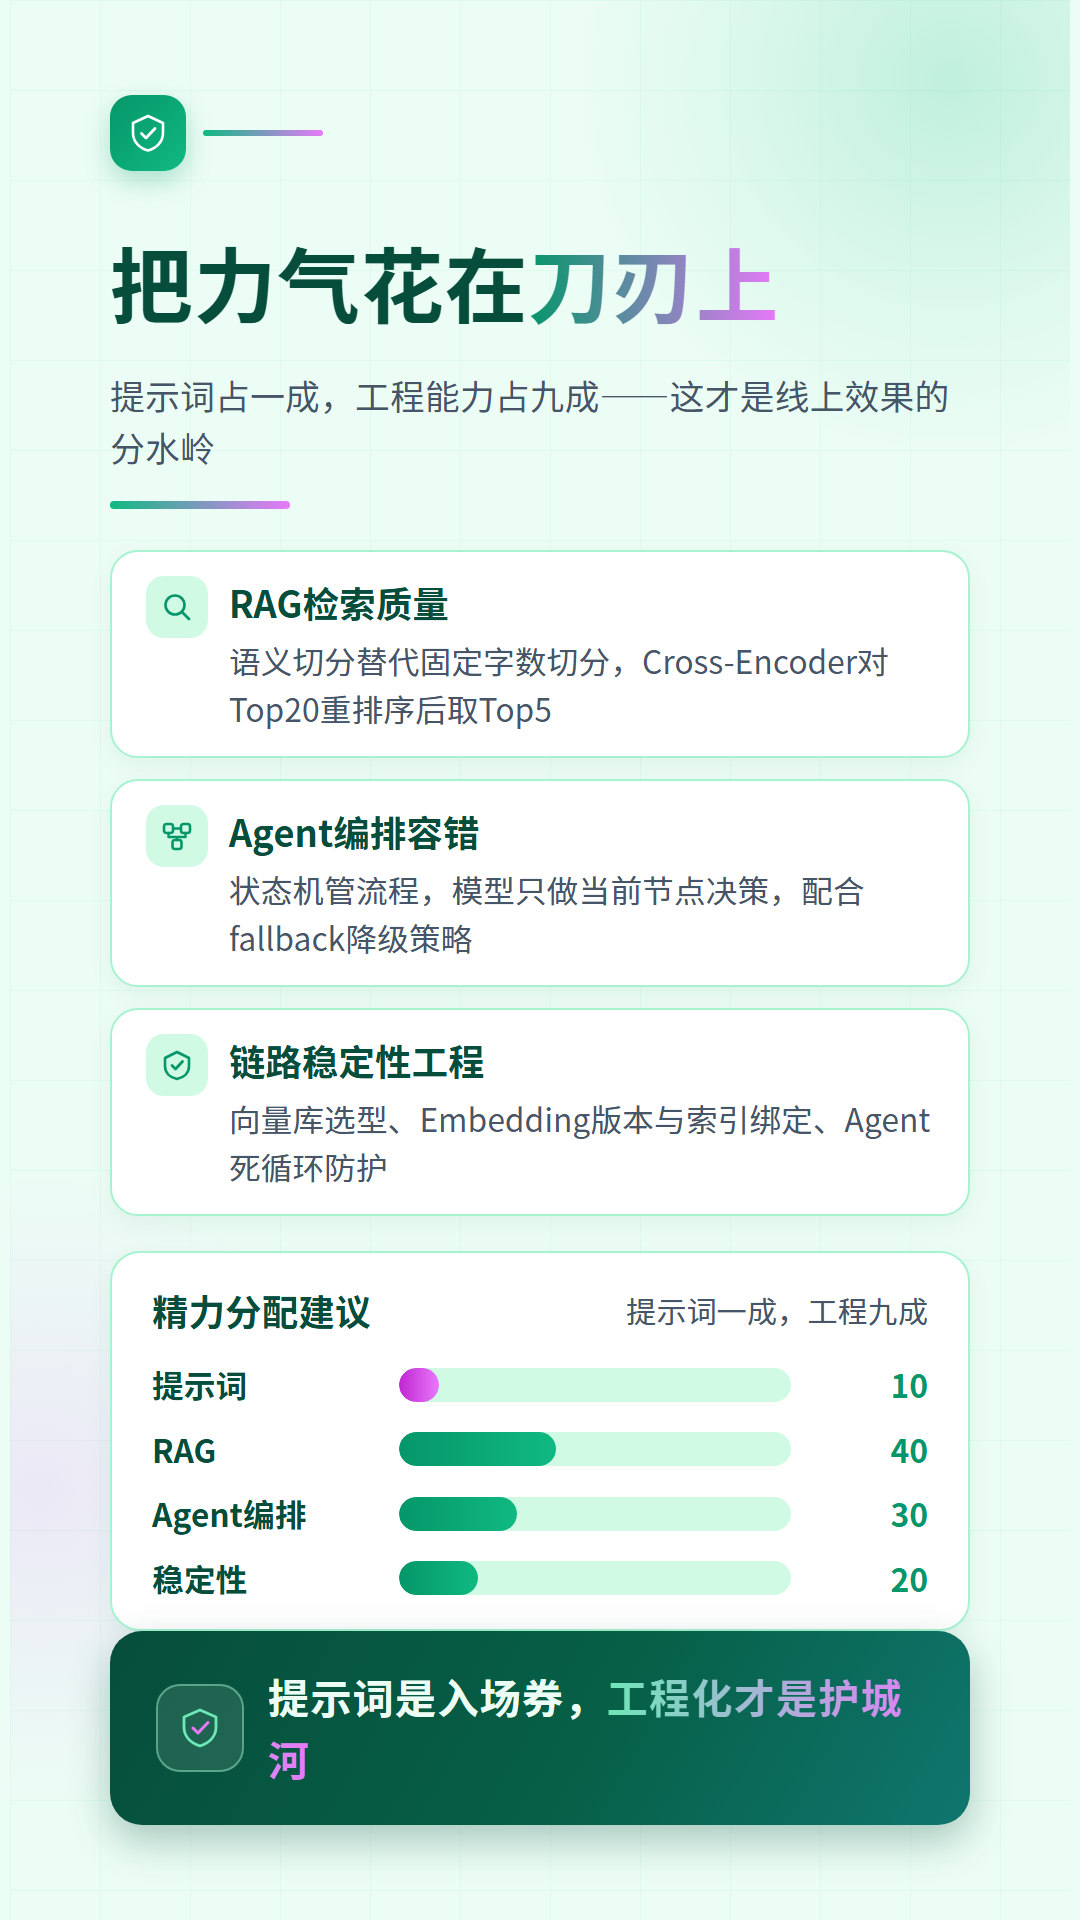
前言
如果你正在做AI应用,却总觉得效果不如别人,问题大概率不在提示词上。这篇文章适合已经跑通Demo、但线上效果拉胯的开发者。看完你能搞清楚:为什么提示词调优的收益会快速衰减,以及RAG、Agent编排、链路稳定性这三块工程能力到底该怎么落地。
问题背景
去年下半年我陪一个做法律咨询的客户改他们的AI问答系统。团队三个人,花了差不多两个月时间,把提示词改了得有上百版。System Prompt从300字写到2000字,加了角色设定、输出格式约束、few-shot示例,甚至把“你是资深律师”这种话术都试了个遍。
结果呢?Demo阶段确实惊艳,一到真实用户手里就崩。
有个用户问“劳动合同到期不续签,公司要不要赔钱”,模型答得头头是道。换个人问“我合同下个月到期,公司说不续了,我能拿多少”,模型就开始胡扯,把N+1和2N混在一起说。
这不是提示词的问题。是检索没做好,知识库里的法条和案例根本没被正确召回。
说白了,提示词是入场券,不是护城河。现在随便一个开发者,看两篇教程就能写出像样的Prompt。但RAG的召回质量、Agent的任务拆解、整条链路的容错,这些才是真正拉开差距的地方。
原理:为什么提示词的天花板很低
先讲个反直觉的事。
大模型的上下文窗口是有限的,而且注意力机制对长文本的衰减很明显。你往Prompt里塞2000字的规则,模型真正“记住”的可能只有前几百字。更麻烦的是,规则之间会打架。你写了“回答要简洁”,又写了“要详细解释法律依据”,模型就懵了。
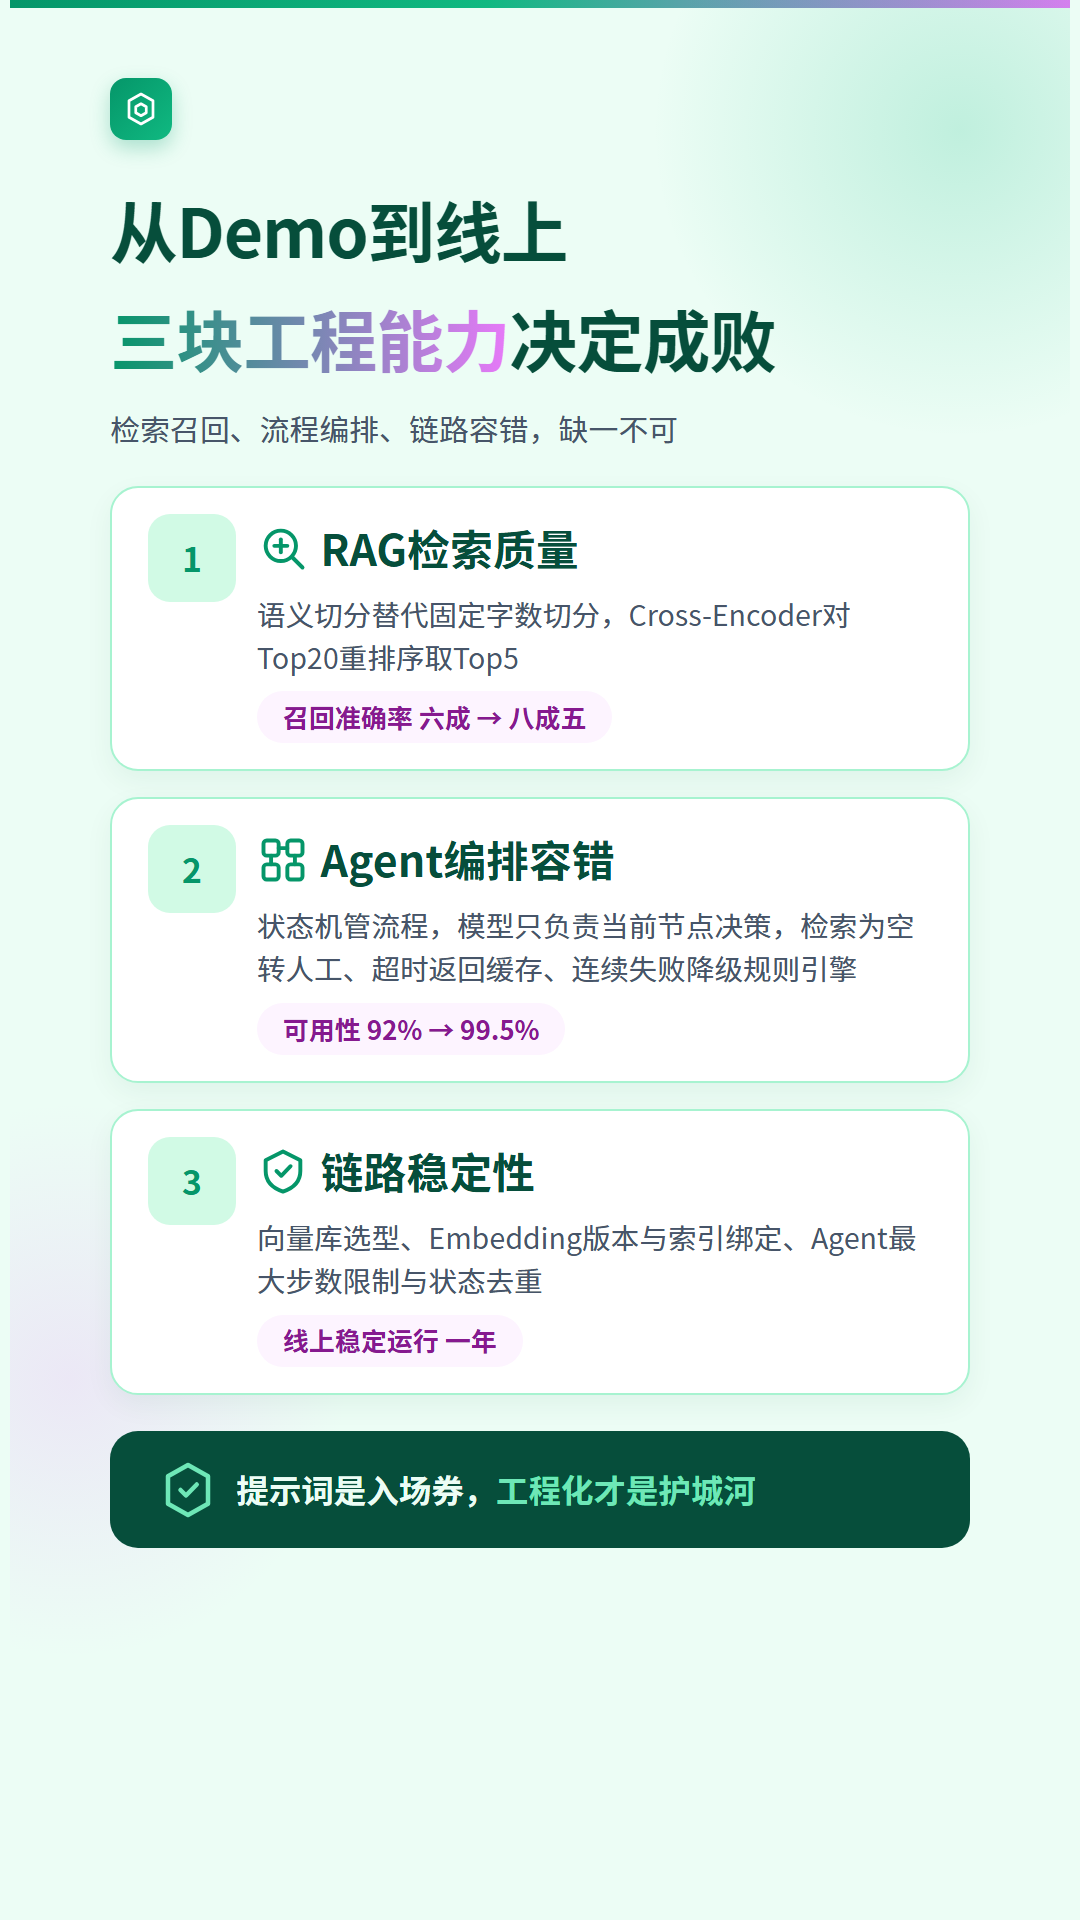
RAG解决的是知识问题。模型本身不知道你们公司的内部文档,不知道最新的政策变化,这些必须靠检索注入。
Agent解决的是流程问题。一个复杂任务,比如“帮我分析这份合同的风险点”,不是一次生成能搞定的。需要拆成:读取合同→识别条款类型→检索相关法条→比对风险→生成报告。每一步都可能出错,需要编排和重试。
链路稳定性解决的是工程问题。线上环境不是实验室,API会超时,向量库会抖动,用户会输入乱七八糟的东西。没有降级和兜底,系统就是纸糊的。
这三块,提示词一个都替代不了。
实操:RAG检索质量怎么提
先看一个最基础的RAG链路,很多人卡在第一步。
from langchain.embeddings import OpenAIEmbeddings
from langchain.vectorstores import Chroma
from langchain.text_splitter import RecursiveCharacterTextSplitter

# 文档切分——这里坑最多
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,
    chunk_overlap=50,
    separators=["\n\n", "\n", "。", "!", "?"]
)

chunks = text_splitter.split_documents(docs)

# 向量化
embeddings = OpenAIEmbeddings()
vectorstore = Chroma.from_documents(chunks, embeddings)

# 检索
retriever = vectorstore.as_retriever(
    search_type="similarity",
    search_kwargs={"k": 4}
)
这段代码能跑,但效果一般。问题出在切分策略上。
法律文档按500字切,经常把一条完整的法条切成两半。用户问“试用期最长多久”,召回的是半截条文,模型只能瞎编。
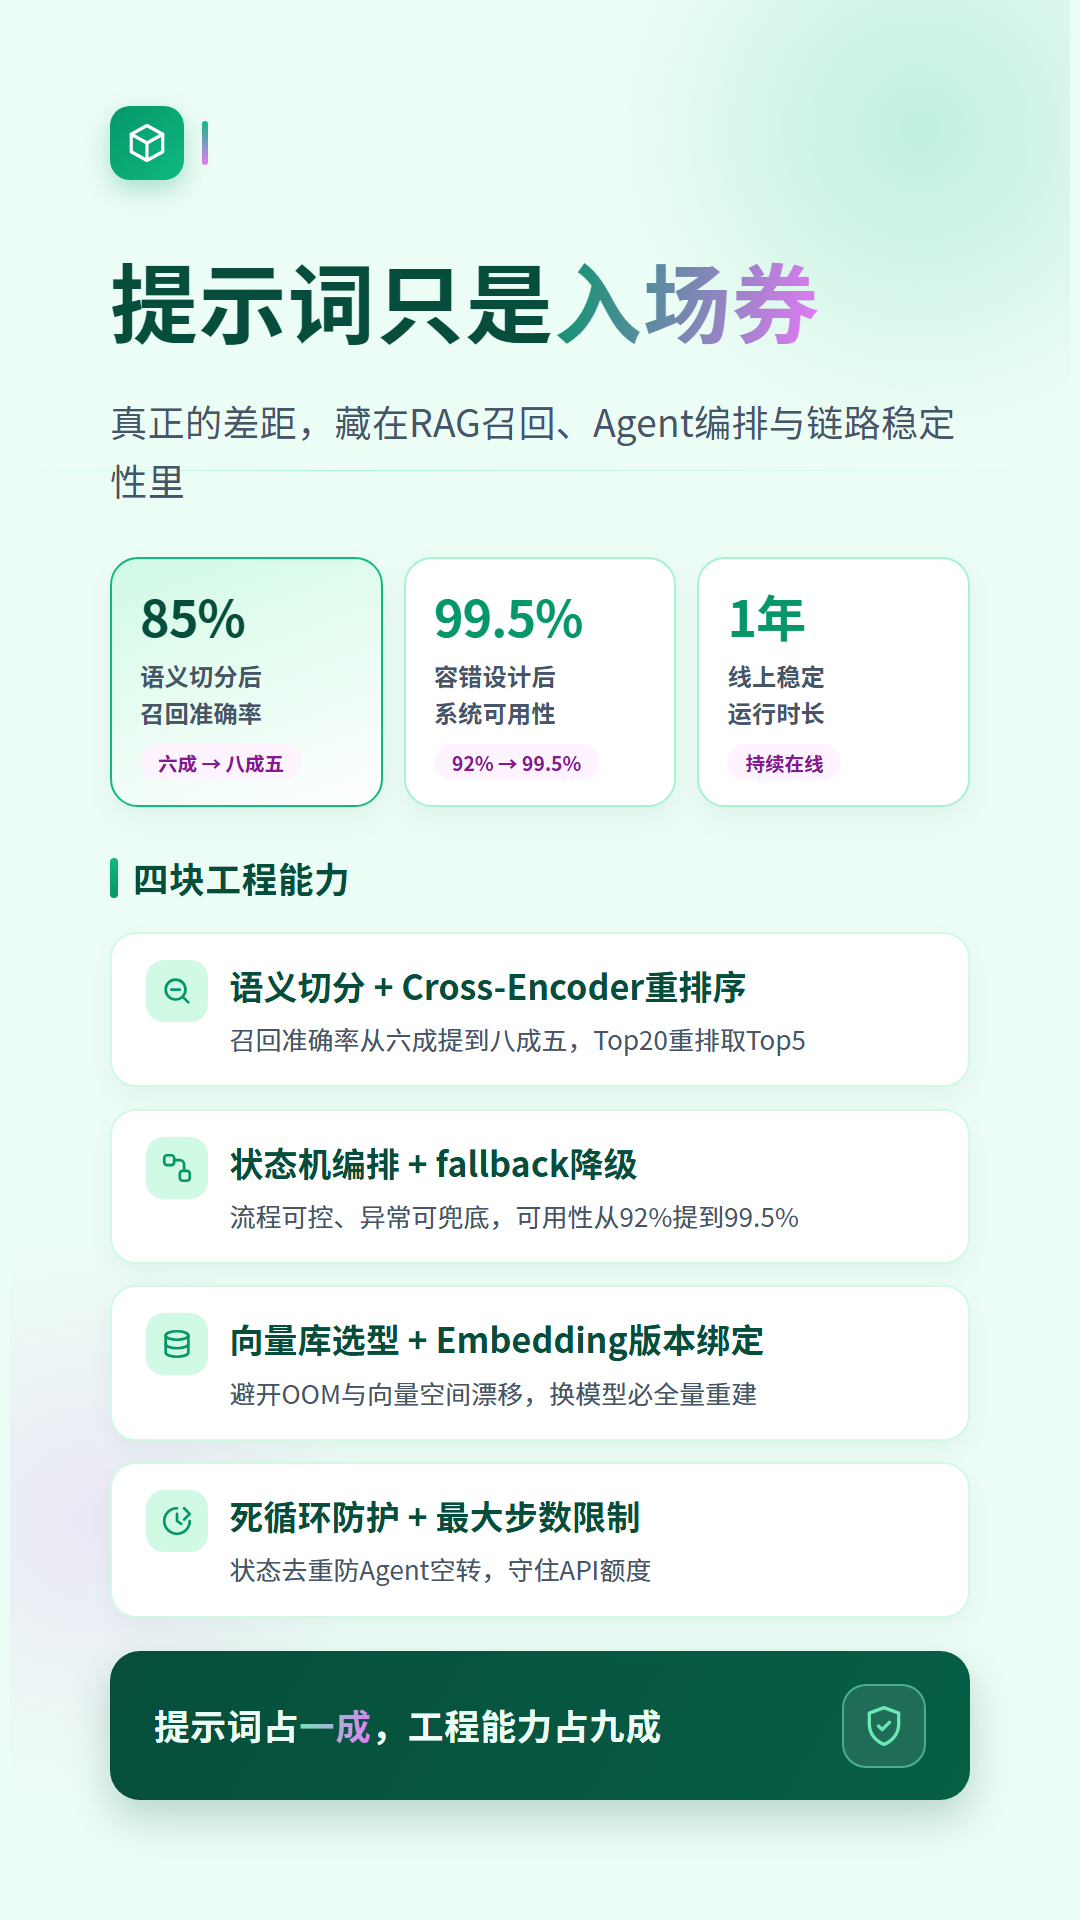
我们后来改成了按语义切分,用模型判断段落边界。成本高一点,但召回准确率从大概六成提到了八成五。
还有个细节:检索回来的内容要重排序。向量相似度高不代表内容相关。我们加了一层Cross-Encoder做rerank,把Top20重新打分,取Top5。这一步让最终答案的准确率又涨了一截。
from sentence_transformers import CrossEncoder

reranker = CrossEncoder('BAAI/bge-reranker-base')

def rerank(query, docs, top_k=5):
    pairs = [[query, doc.page_content] for doc in docs]
    scores = reranker.predict(pairs)
    ranked = sorted(zip(docs, scores), key=lambda x: x[1], reverse=True)
    return [doc for doc, _ in ranked[:top_k]]
别小看这几十行代码。很多团队连rerank都没做,直接拿向量相似度当相关性,效果能好才怪。
实操:Agent编排的容错设计
Agent这块,我见过太多团队把流程写死在一个大Prompt里,让模型自己决定下一步。
这是灾难的开始。
模型会跳步,会重复调用工具,会在该结束的时候继续瞎跑。我们现在的做法是:用状态机管流程,模型只负责当前节点的决策。
from enum import Enum

class State(Enum):
    EXTRACT = "extract"
    RETRIEVE = "retrieve"
    ANALYZE = "analyze"
    GENERATE = "generate"
    DONE = "done"

class AgentPipeline:
    def __init__(self):
        self.state = State.EXTRACT
        self.max_retries = 3

    def run(self, user_input):
        context = {"input": user_input}

        while self.state != State.DONE:
            try:
                if self.state == State.EXTRACT:
                    context["entities"] = self.extract(user_input)
                    self.state = State.RETRIEVE

                elif self.state == State.RETRIEVE:
                    context["docs"] = self.retrieve(context["entities"])
                    if not context["docs"]:
                        return "抱歉,没有找到相关信息"
                    self.state = State.ANALYZE

                elif self.state == State.ANALYZE:
                    context["analysis"] = self.analyze(context)
                    self.state = State.GENERATE

                elif self.state == State.GENERATE:
                    context["answer"] = self.generate(context)
                    self.state = State.DONE

            except Exception as e:
                self.max_retries -= 1
                if self.max_retries <= 0:
                    return self.fallback(context)
                continue

        return context["answer"]
关键在fallback。检索不到怎么办?模型调用超时怎么办?这些必须提前想好。
我们的策略是:检索为空就转人工,模型超时就返回缓存答案,连续失败三次直接降级到规则引擎。
听起来很土,但线上跑了一年,可用性从92%提到了99.5%。
踩坑:那些年我们交过的学费
第一个坑:向量库选型。
一开始图省事用了内存版FAISS,数据量一上来就OOM。后来换Milvus,又遇到索引构建慢的问题。最后用了PGVector,虽然性能不是最强,但跟现有Postgres集成,运维成本低。
选型没有银弹,看团队情况。
第二个坑:Embedding模型换版本。
有次手贱升级了Embedding模型,没重新索引,检索结果全乱。用户问A,召回B。排查了两天才发现是向量空间变了。
现在我们的规矩是:Embedding模型版本和索引版本绑定,换模型必须全量重建。
第三个坑:Agent死循环。
有个做电商的客户,Agent在“查询订单→确认状态→查询订单”之间循环了上百次,把API额度跑光了。后来加了最大步数限制和状态去重,才解决。
这些坑,提示词调优一个都避不开。
总结
提示词重要吗?重要。但它只是起点。
真正决定AI项目效果的,是检索能不能召回正确的内容,是Agent能不能稳定地拆解和执行任务,是整条链路在异常情况下能不能优雅降级。
我们团队现在的精力分配大概是:提示词占一成,RAG占四成,Agent编排占三成,稳定性占两成。
这个比例不一定适合所有人,但方向应该没错。
如果你还在死磕提示词,建议停下来看看检索日志和链路监控。问题大概率不在那几百字的Prompt里。
有想法欢迎评论区聊。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)