决策模型大革命:当Jev重写AI推理经济学,System One架构如何掀起百倍提速风暴
决策模型大革命:当Jev重写AI推理经济学,System One架构如何掀起百倍提速风暴
一个npm包花了7行代码调用AI模型来完成 left pad(左补空)操作——添加到购物车:0个空格、1个空格……直到10个空格。这不是技术故障,而是对一场革命最精准的隐喻。
2026年9月19日,一款名为 jev-leftpad 的npm包在Hacker News引发热议(227赞)。它做的事情荒谬绝伦:用AI模型来决定字符串左侧补几个空格。然而就在同一周,ConvAI Innovations创始人Nandakishor Mukkunnoth宣布 Laya 开源决策引擎在单GPU上跑出 32.8毫秒 的推理延迟——比TypeSafe AI的Jev快6到8倍。10月1日,AWS旗下Strands Agents团队发布 Strands Decider 2B,收获280 HN点赞。而就在今天,Aplomb 1——一个基于Qwen3.5-4B的5.3B开源决策模型,再次点燃社区。
从Jev的诞生到开源生态的全面爆发,仅用三周时间,“决策模型”(Decision Model)已从技术圈内的一个模糊概念,演变为一个剑指LLM推理瓶颈的全新品类。
这不是炒作——这是架构层面的范式迁移。
一个被忽视的事实:你的AI正在用杀鸡刀杀鸡
理解这场革命,先从一个基本事实出发。
每当你调用GPT-5或Claude Sonnet做一次邮件分类、工单路由、内容审查,一个8B/70B参数的"文本生成巨人"正在:逐token串行输出 → 可能幻觉 → 生成一段你需要用正则或JSON解析器提取的文本。整个过程耗时500ms到数秒,花费真实的金钱,而且LLM自称95%置信度时——它只是"看起来自信"。
ConvAI Innovations创始人的洞察一针见血:“当LLM输出 ‘confidence: 0.95’ 时,它只是在预测听起来自信的token。背后没有任何数学校准。”
这正是现代AI自动化的核心瓶颈。每一条客服工单的自动路由、每一次欺诈检测的毫秒级响应、每一轮浏览器Agent的元素操作——都在用杀鸡刀杀鸡。
TypeSafe AI创始人Diogo Almeida(OpenAI前研究员,ChatGPT共同发明人)在2025年离职后花了两年时间闭门研发,最终在2026年9月15日发布答案:System One Model — 一类专门做"快速结构化决策"的新型模型。
如果说传统LLM是人类大脑的System 2(慢速、深思、语言生成),那么决策模型就是System 1(即时反射、概率判断、毫秒级响应)。
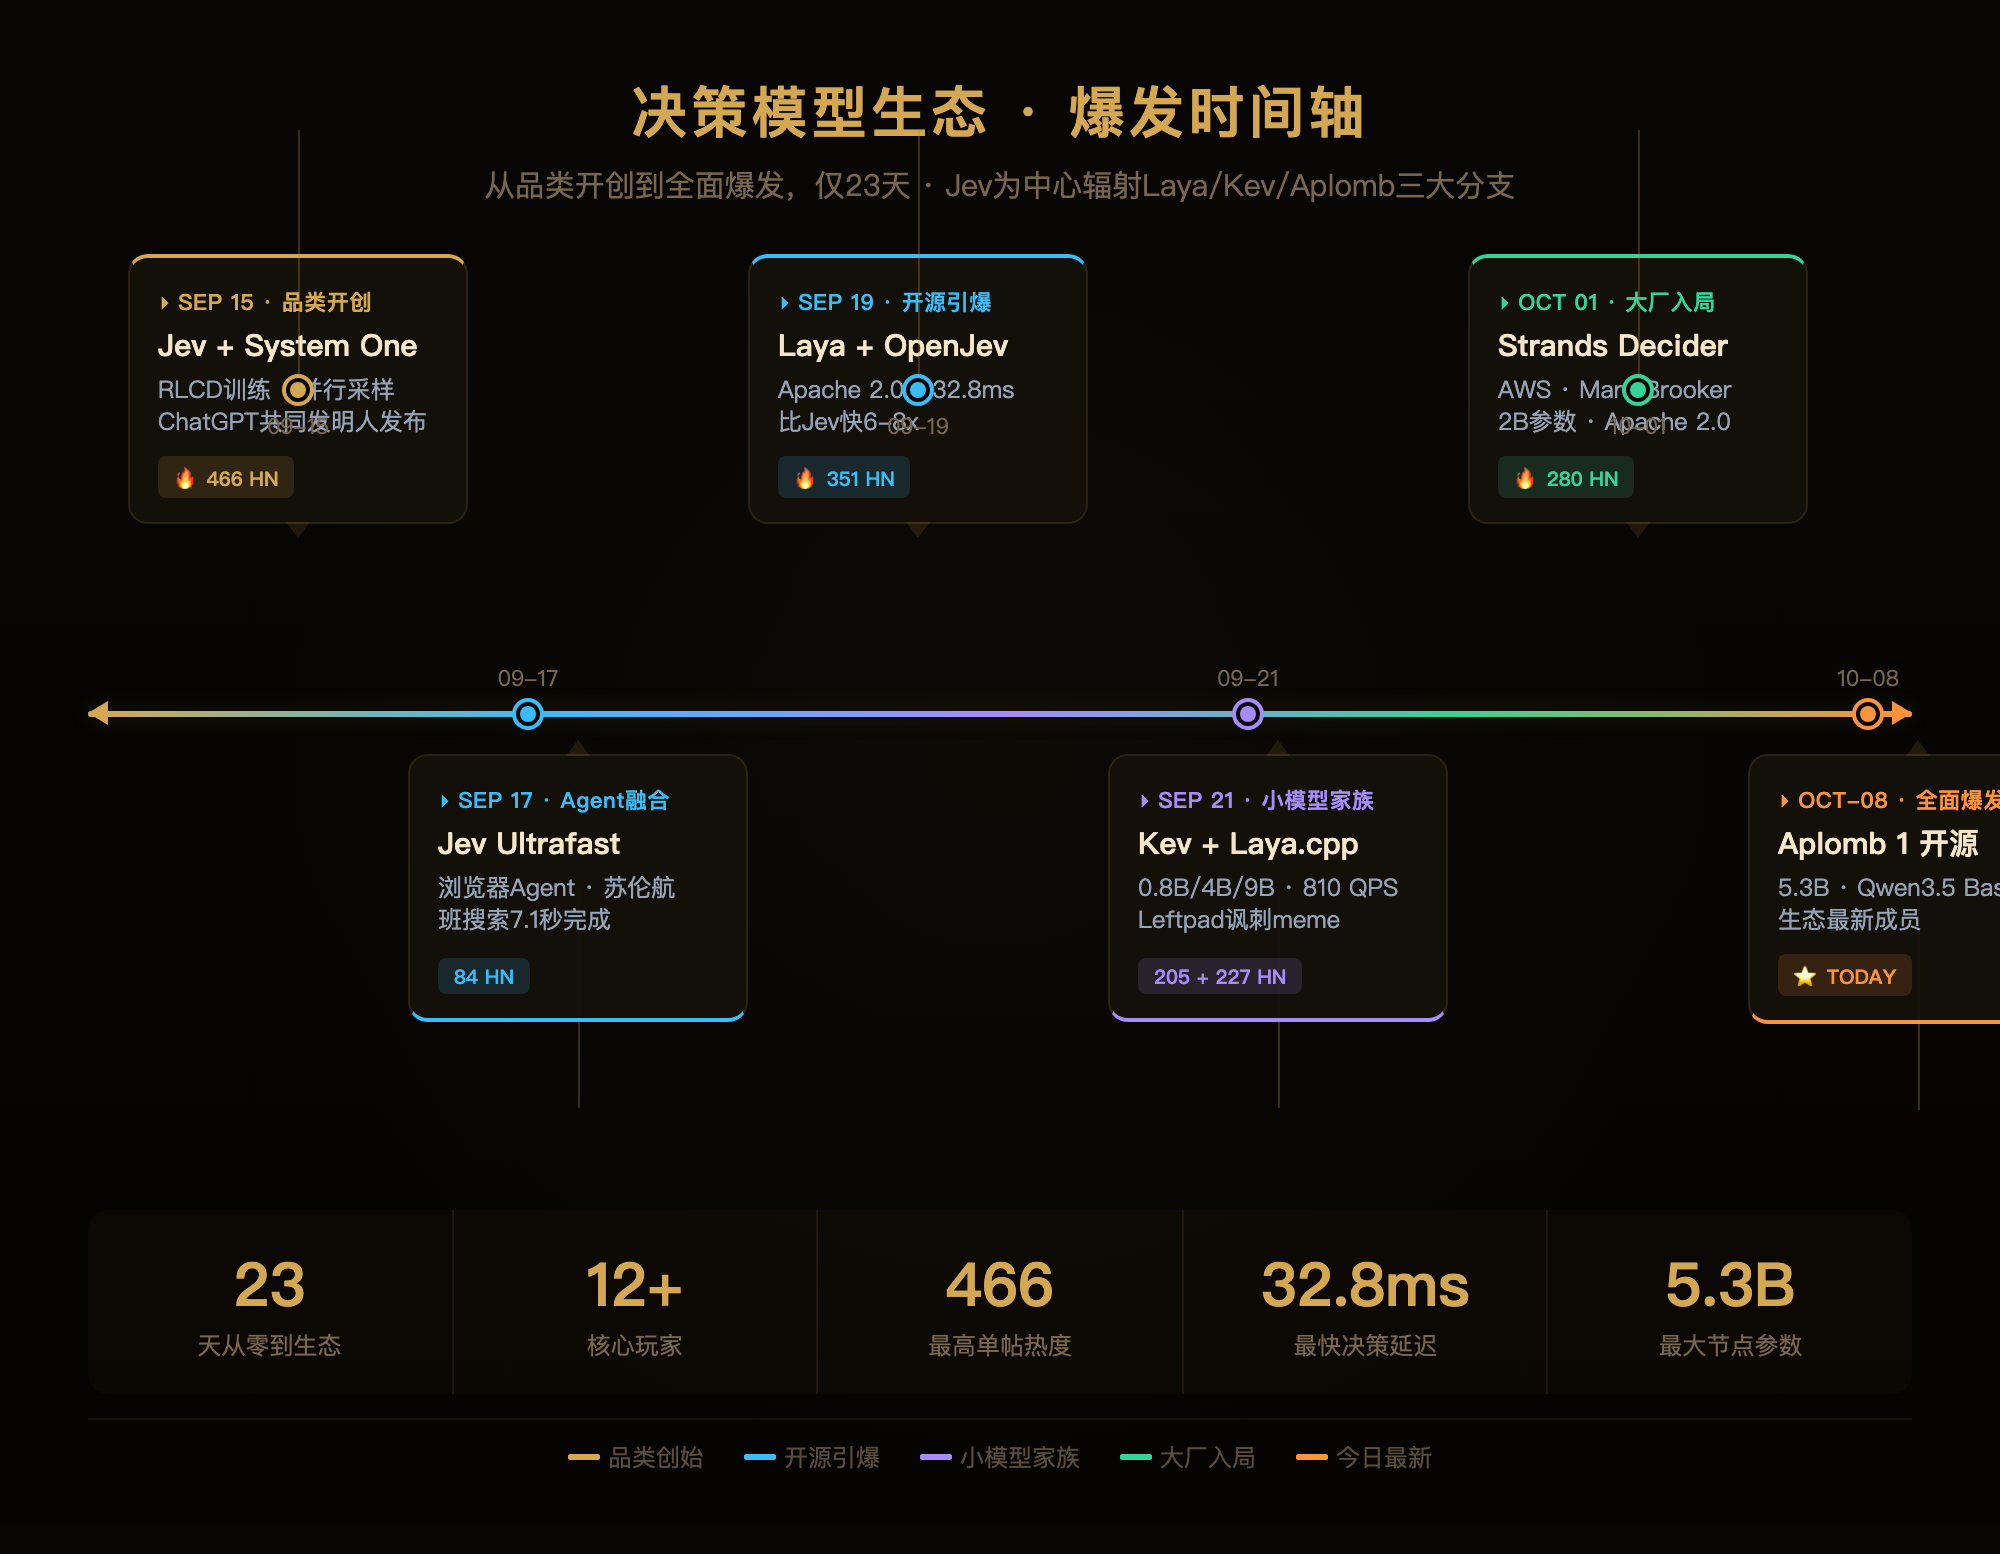
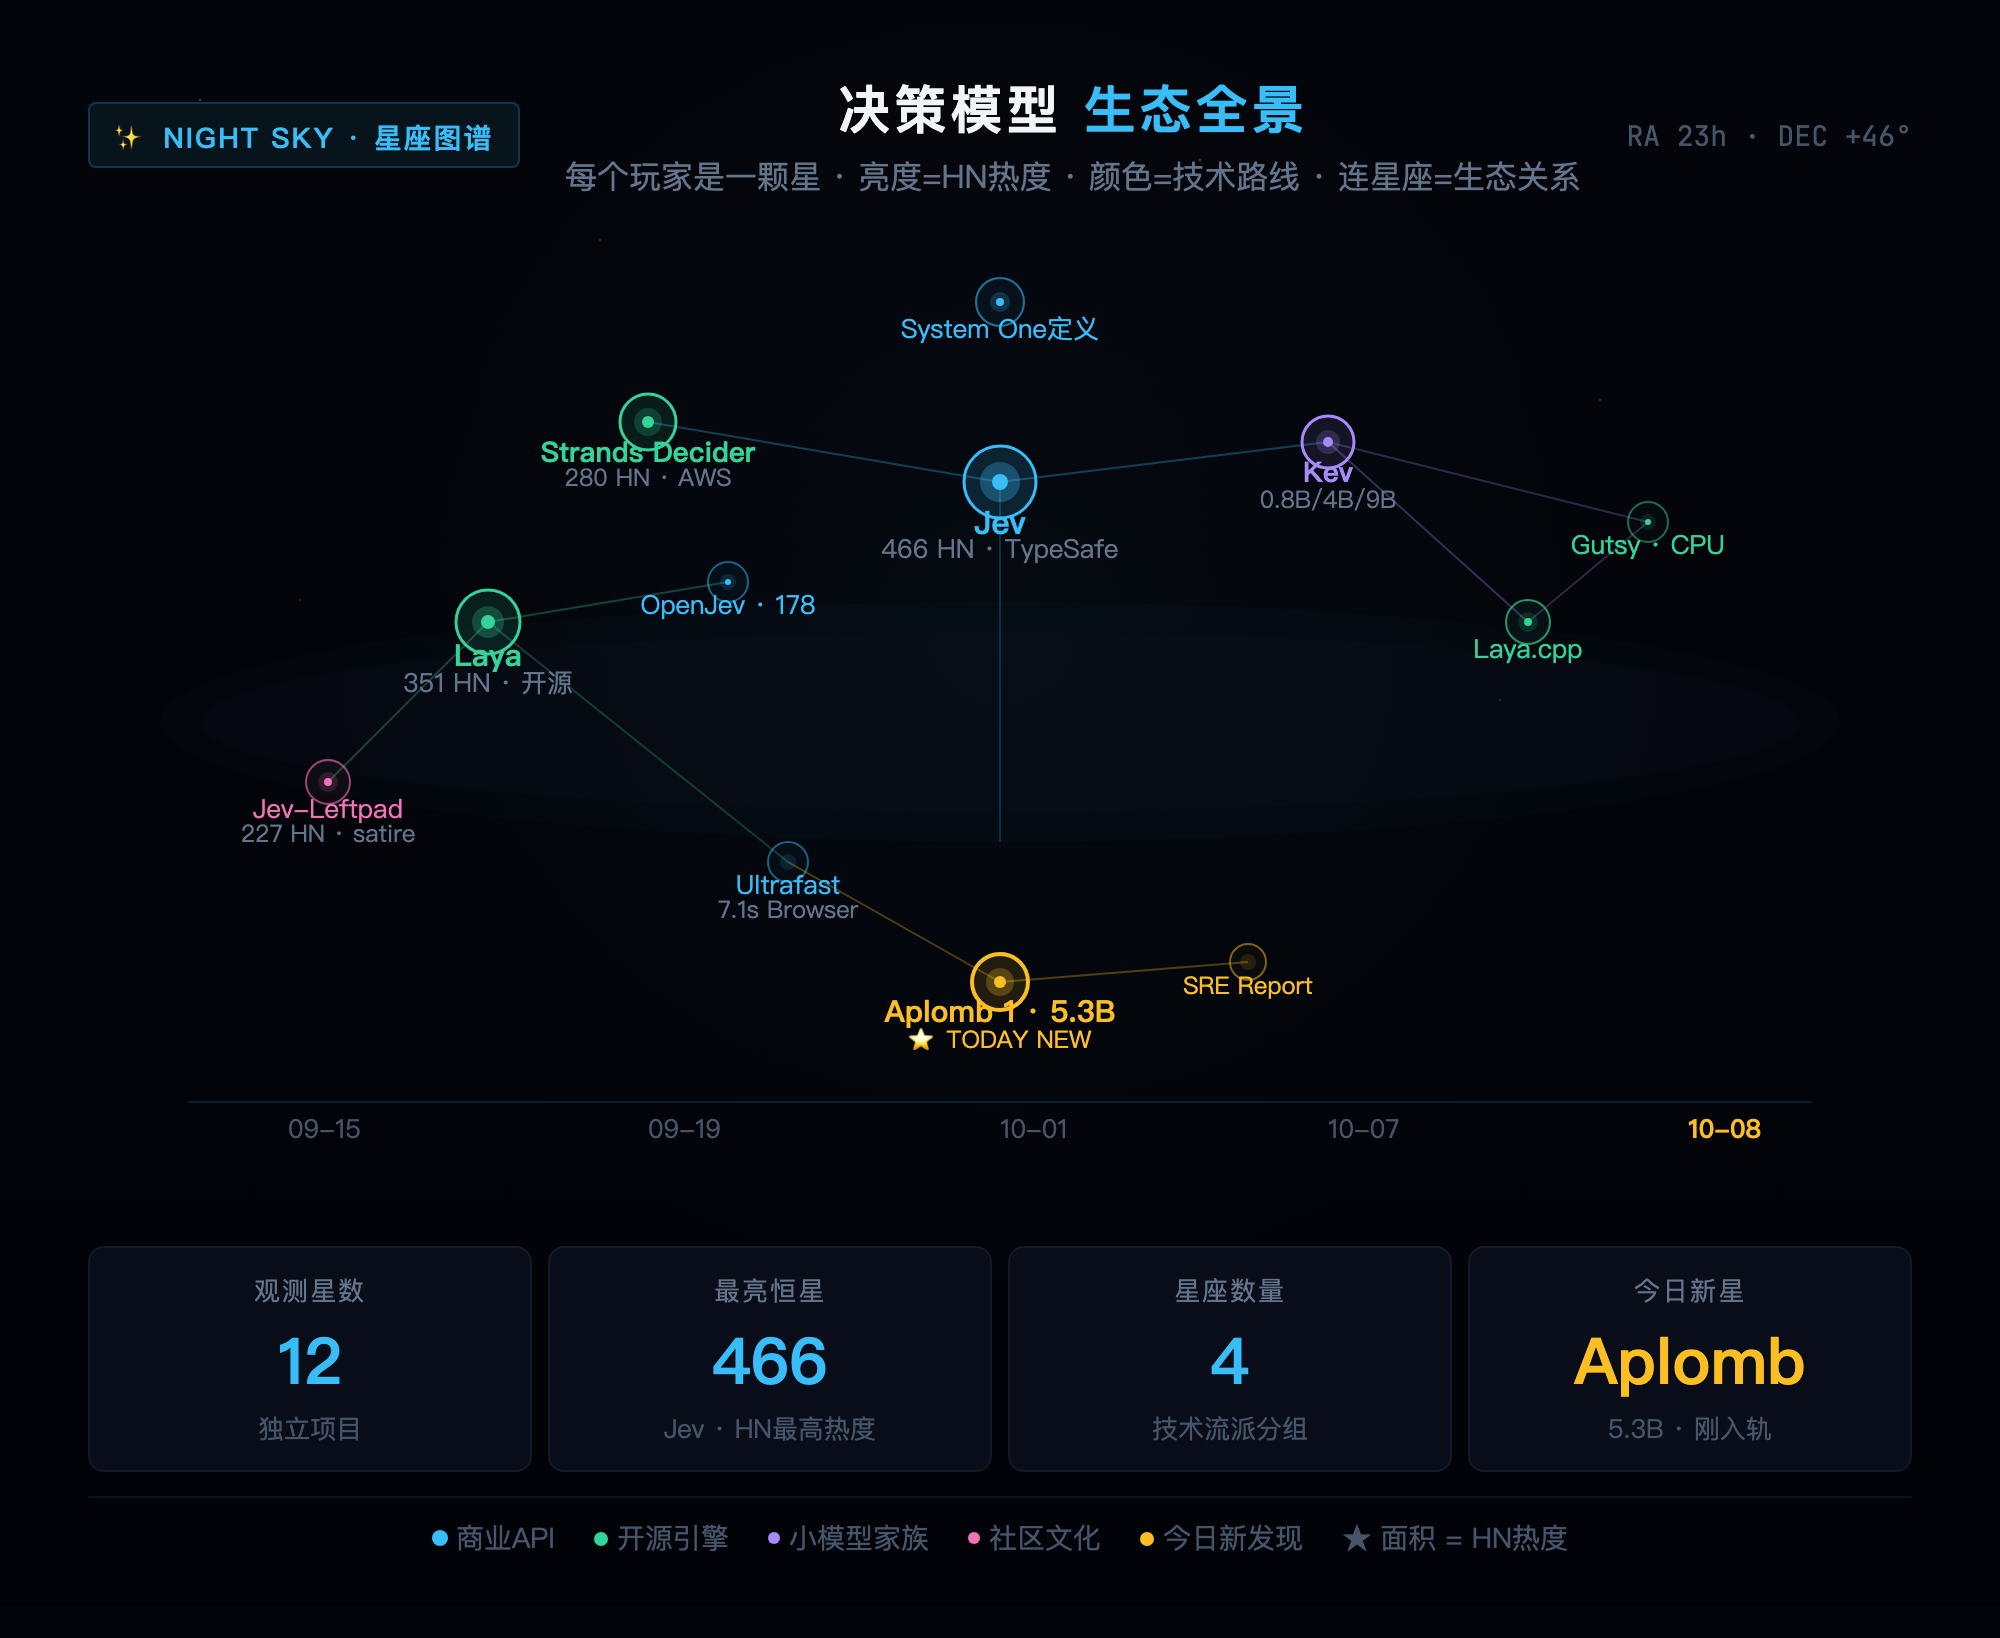
📌 图示说明:上方时间轴展示7大关键里程碑事件(精选),以下方表格同步列出完整12条发展脉络。
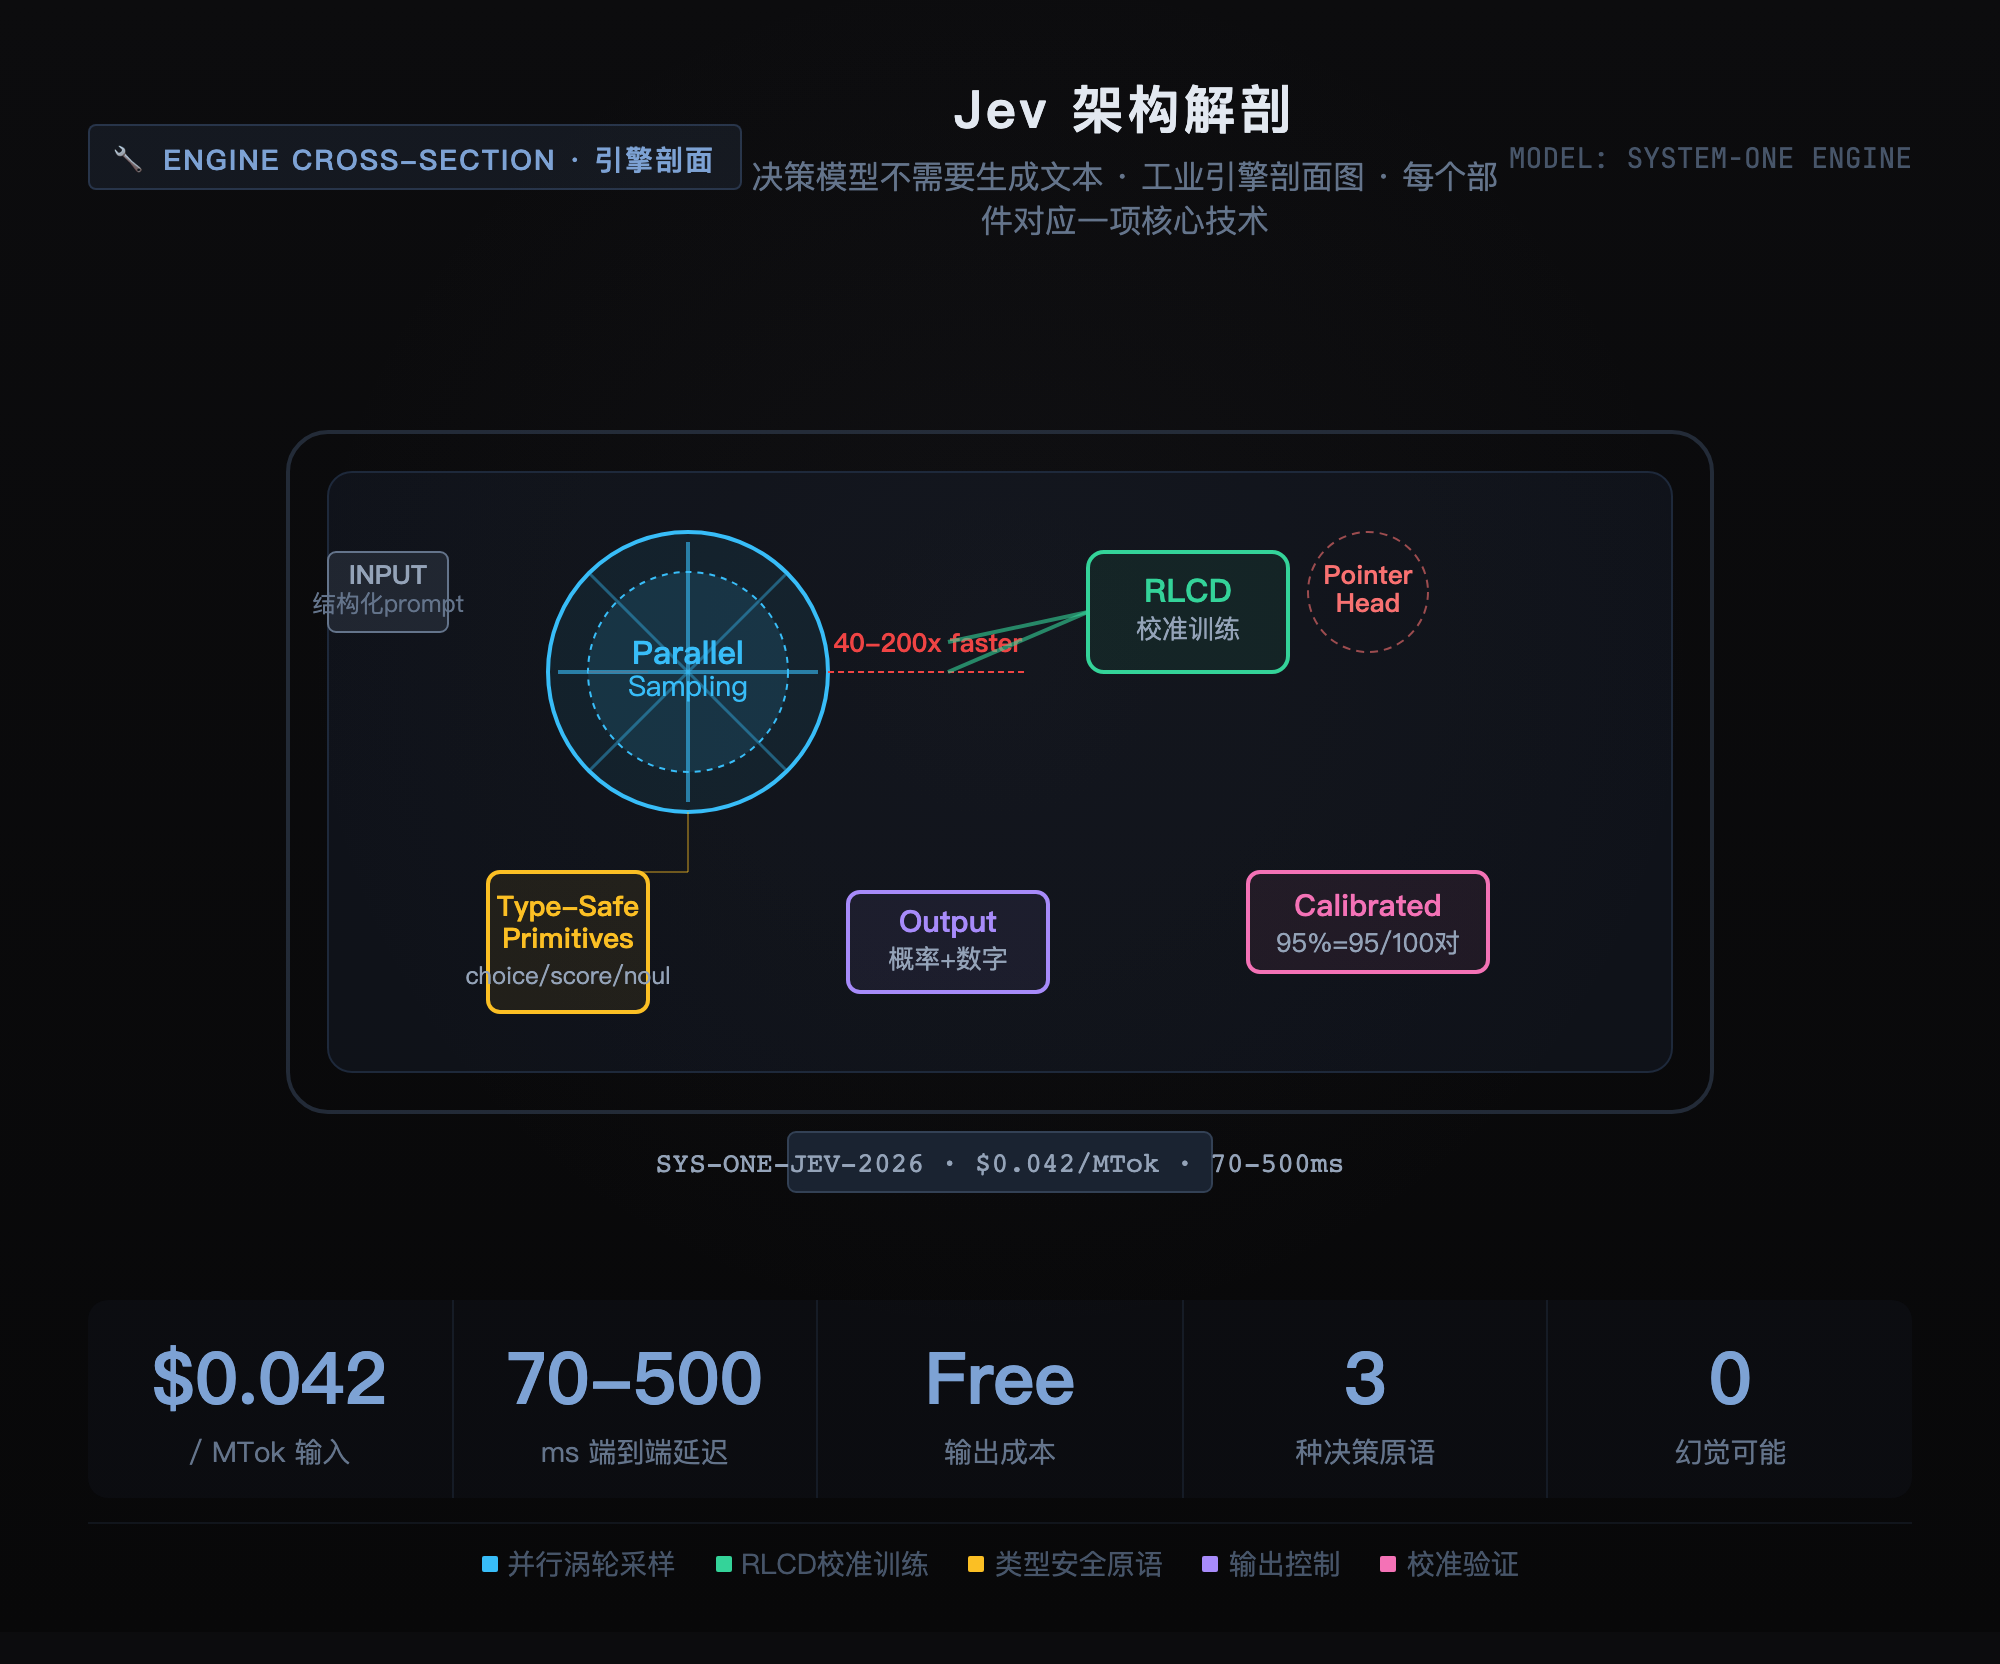
System One架构解剖:为什么决策模型不需要生成文本
Jev的架构与LLM存在根本性差异,理解这一点是区分"新瓶装旧酒"与"范式创新"的关键。
三大核心突破
突破一:RLCD — 决策训练的范式跃迁
传统LLM使用RLHF(人类反馈强化学习)优化"人类偏好的文本",JanVR(可验证奖励强化学习)优化"可程序化验证的输出"。而决策模型使用 RLCD(Reinforcement Learning for Calibrated Decisions,校准决策强化学习)——优化的目标不是文本质量,而是认知诚实的概率。
这意味着输出的不是一个"看起来对"的字符串,而是一个带有真实数学置信度的结构化值。当模型说95%确信时,意味着在100次中有95次是对的。
突破二:并行采样 vs 串行生成
LLM是逐token串行生成——每个token依赖前一个。Jev是并行采样:一次请求内生成所有输出。这是它快40到200倍的根本原因。从"逐字写答案"变成"瞬间给答案"。
突破三:类型安全的决策原语
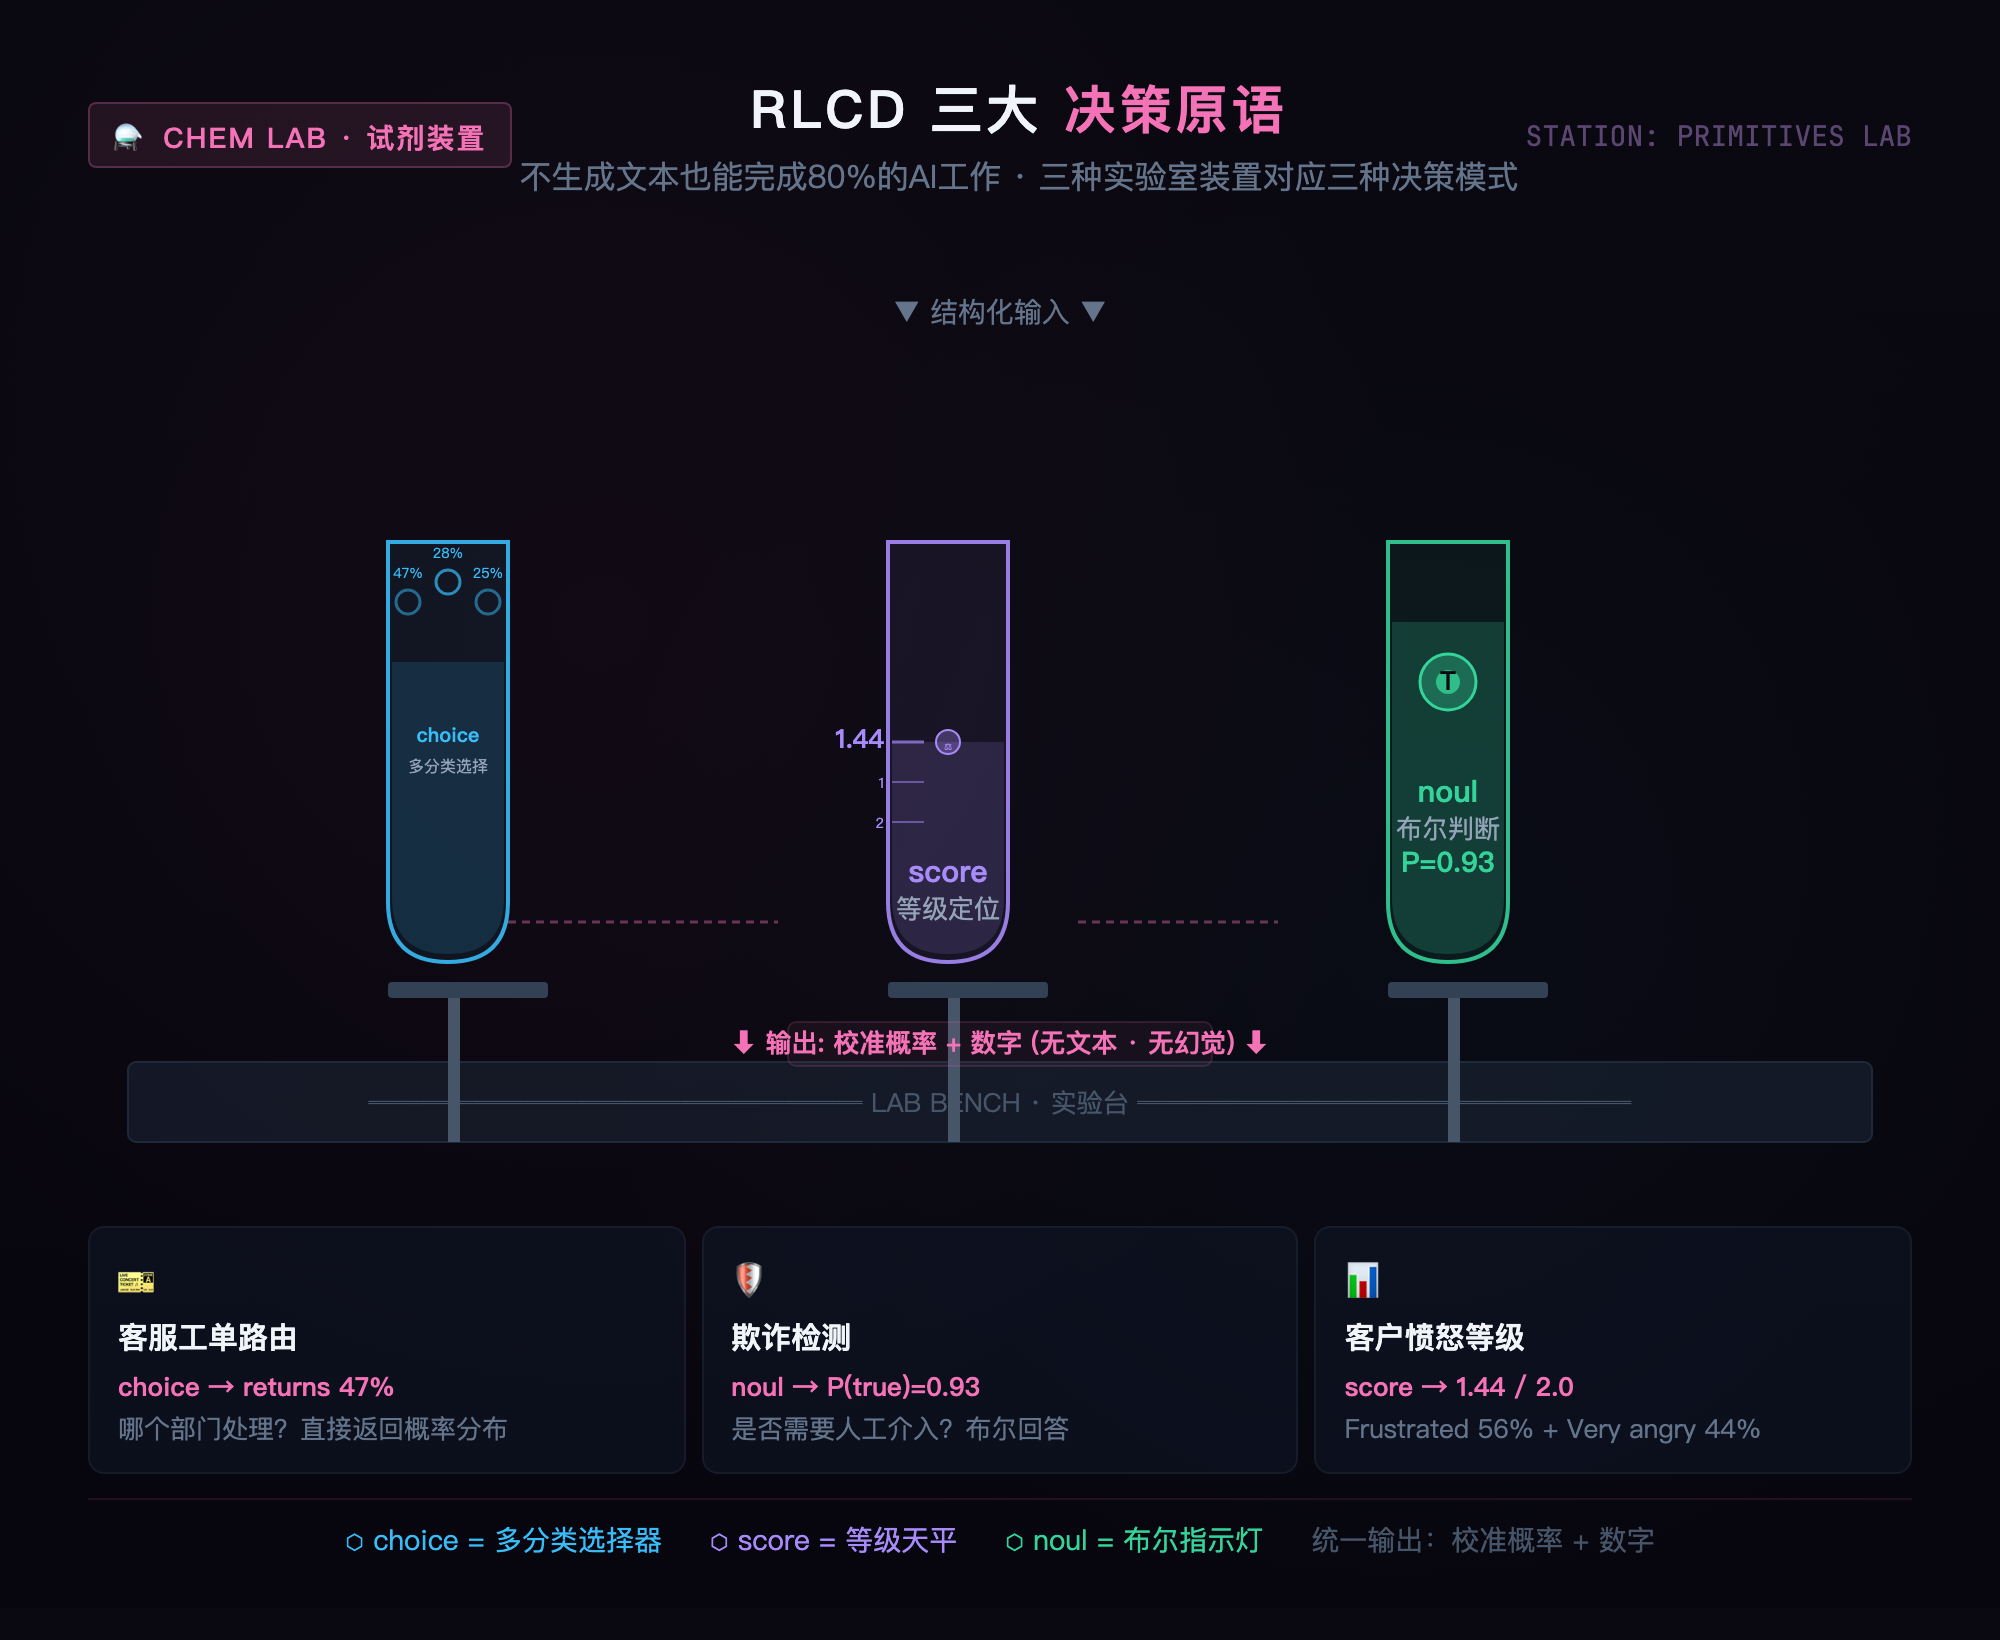
决策模型定义了三种基本决策单元:
- choice:从给定标准中选一个(多分类),返回选中项 + 所有选项概率分布 + 校准置信度
- score:在有序等级上定位(0,1,2…),返回期望值 + 各等级分布
- noul:直接回答是/否,返回 P(true) 校准概率
输出空间仅为概率和数字 — 不生成文本,不能产生幻觉,没有格式错误。
性能对决:32.8ms vs 500ms,$0.042 vs $10
| 维度 | 传统LLM | TypeSafe Jev | Laya (开源) | Kev 4B | Strands Decider 2B |
|---|---|---|---|---|---|
| 输入成本 | $0.20–$10/MTok | $0.042/MTok | 免费(本地) | 免费(本地) | 免费(本地) |
| 输出成本 | 输入的5倍 | 免费 | 免费 | 免费 | 免费 |
| 端到端延迟 | 3–329秒 | 70–500ms | 32.8ms(单GPU) | ~500ms(M5) | - |
| 决策成本 | $$$ | $ | 免费 | 免费 | 免费 |
📌 LLM输出成本说明:传统LLM输出token的定价通常是输入token的5倍(如GPT-5输入$10/MTok则输出$50/MTok)。Jev输出免费(too cheap to meter),开源可本地部署则全链路零成本。
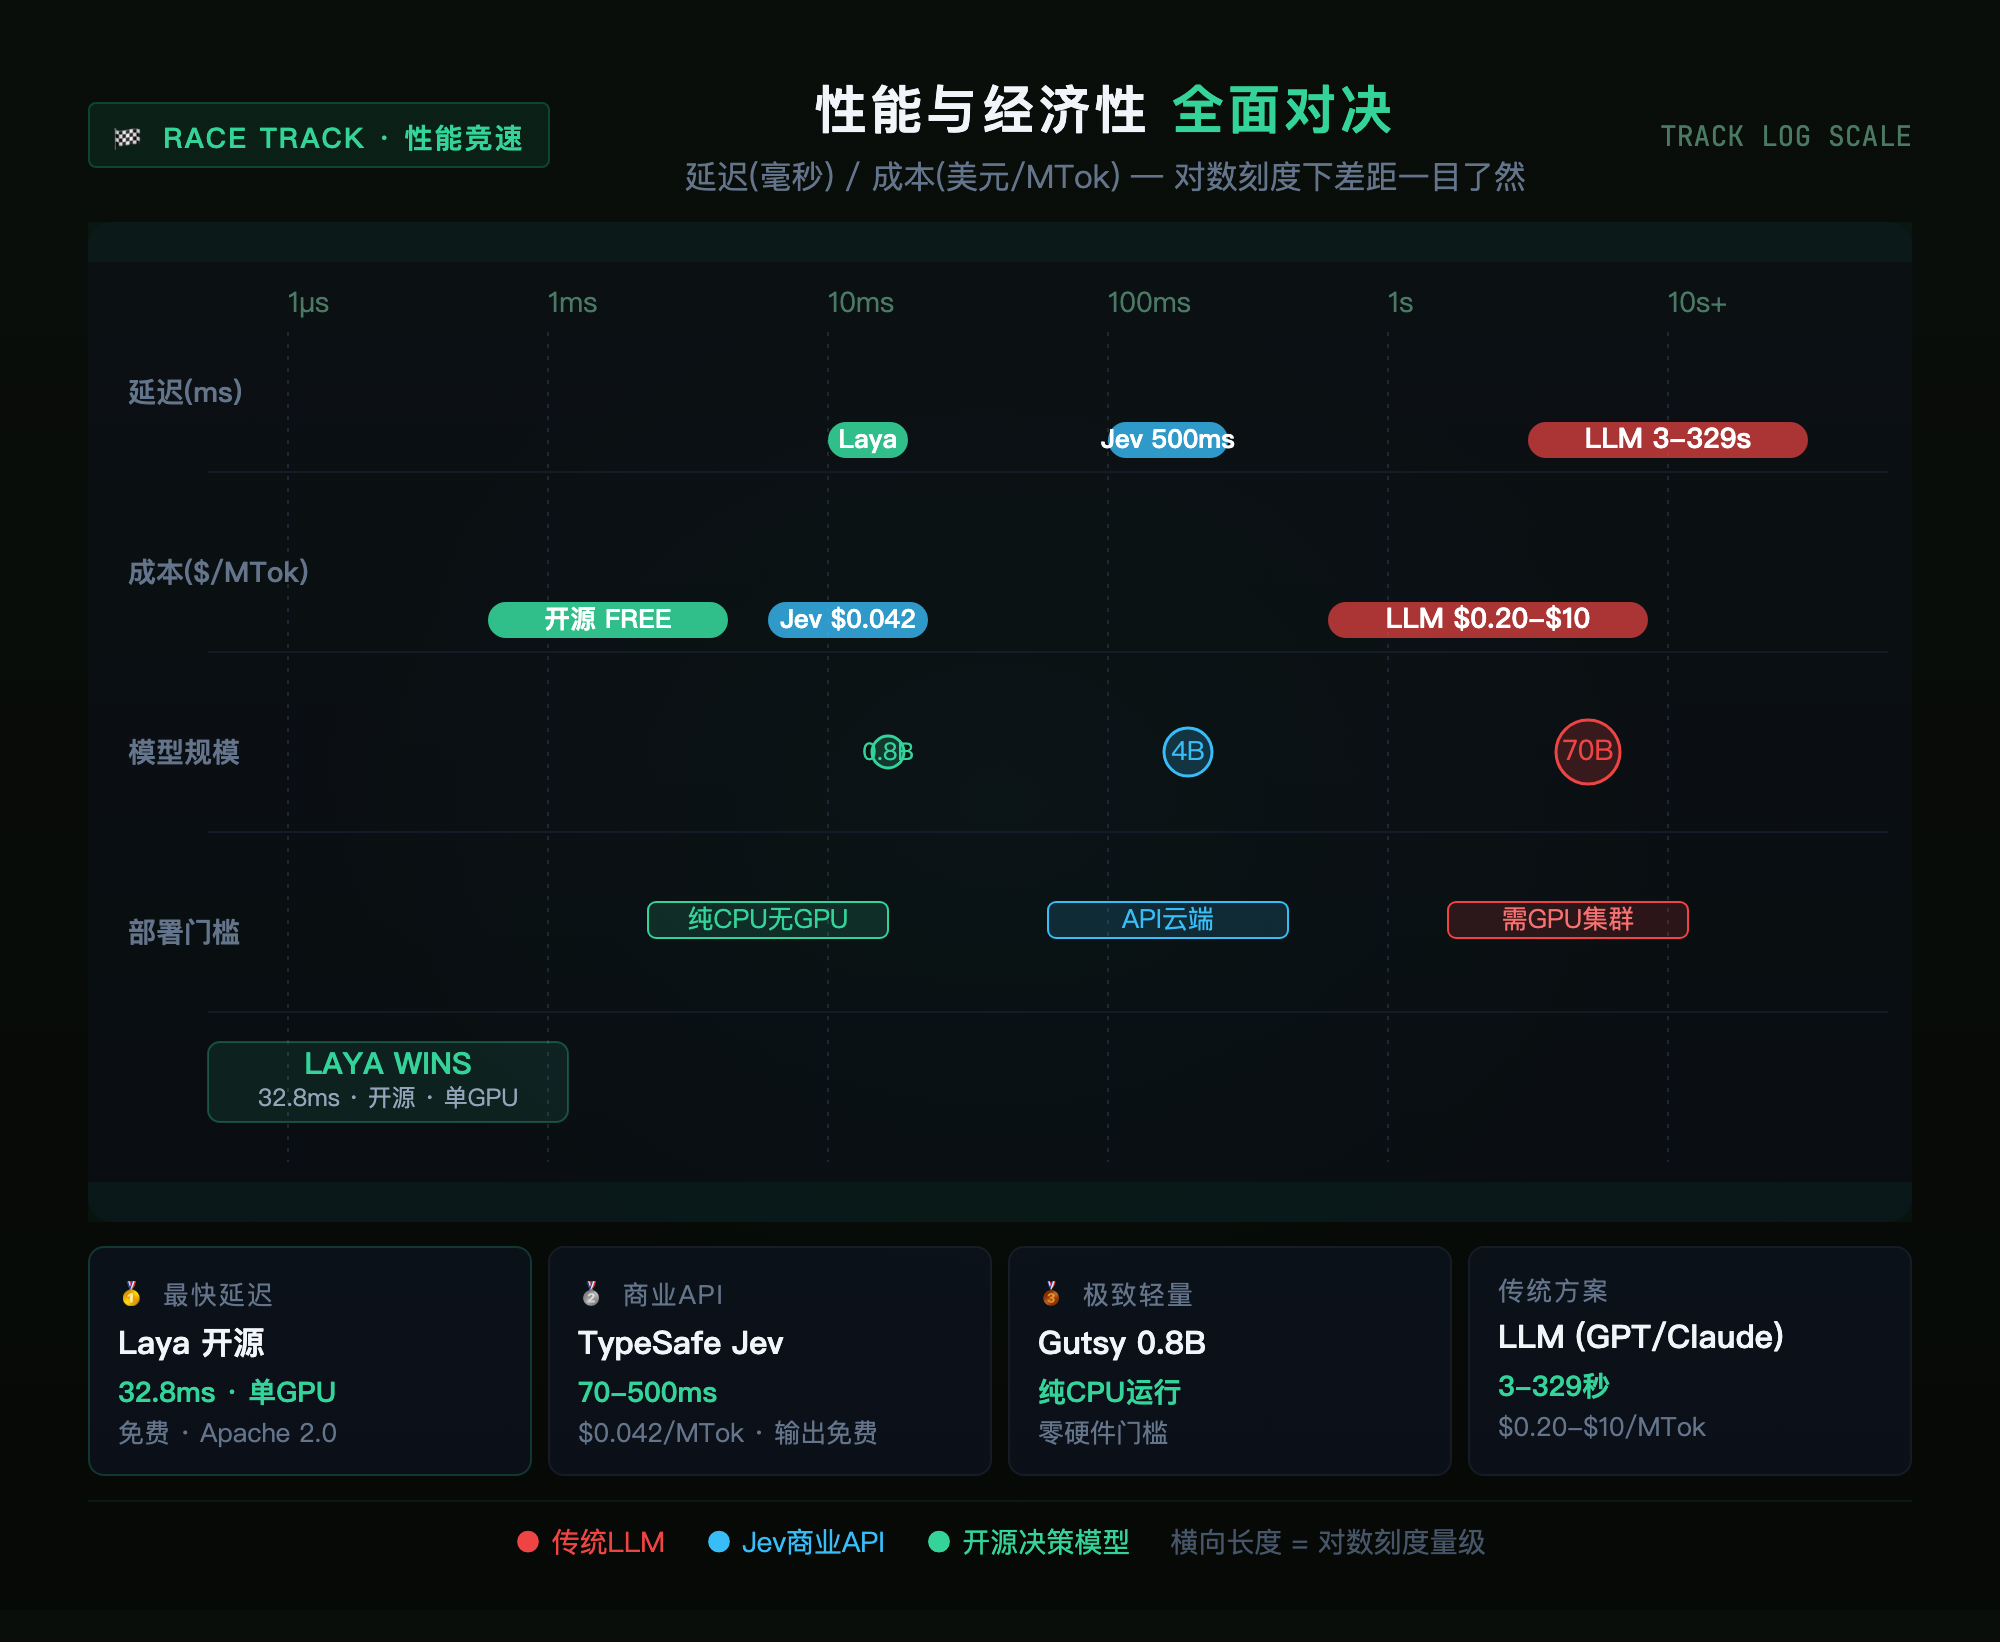
关键洞见:开源决策模型(Laya、Kev、Aplomb、Strands Decider)的真正颠覆性不在性能比Jev快——而在于将推理成本降到了完全免费(本地部署)。一个0.8B参数的决策模型可以在纯CPU上运行,不需要GPU、不需要云API、没有MTok计费。
RLCD三大原语:不生成文本也能完成80%的AI工作
为什么决策原语不牺牲实用性?因为大量AI工作负载本质上是"结构化判断"而非"文本生成"。
场景一:客服工单路由
输入:"鞋子晚了两周才到,而且尺码不对。我卡上还被扣了两次款。"
→ choice: 哪个部门处理? returns(47%) shipping(28%) billing(25%)
→ noul: 需要紧急人工介入? 0.93
→ score: 客户愤怒等级? 1.44/2.0 (Frustrated 56% + Very angry 44%)
Kev-4B在Apple M5上跑这个判断仅需495ms,且返回的不是需要解析的文本,而是直接可用的概率分布。
场景二:浏览器Agent操作
Jev Ultrafast在Google Flights上完成"苏黎世→伦敦航班搜索"仅需7.1秒。核心机制:每轮观测生成元素表 → Jev选择操作(CLICK/TYPE_TEXT/SELECT) + 目标元素 → 仅TYPE_TEXT时调用小LLM生成文本。一个决策周期一次网络请求,无需截图。
场景三:SRE生产诊断
10月7日HN社区分享的Jev-Driven SRE Diagnosis报告,记录了决策模型在运维排障中的真实表现——既有成功经验也有失败教训,为落地提供了宝贵实证。
生态大爆发:三周内从0到12+玩家
决策模型生态的爆发速度令人震惊。从9月15日到10月8日,仅23天,12+个核心玩家入场:
| 时间 | 事件 | 意义 |
|---|---|---|
| 09-15 | TypeSafe AI发布Jev | 品类开创者 |
| 09-17 | Jev Ultrafast浏览器Agent | 决策模型+Agent融合 |
| 09-18 | Jev架构被独立分析 | 技术透明化 |
| 09-19 | Laya开源 + OpenJev | 开源生态启动 |
| 09-21 | Kev发布(0.8B/4B/9B) | 小模型家族 |
| 09-21 | Laya.cpp C++推理 | 极致性能优化 |
| 10-01 | Strands Decider 2B (AWS) | 大厂入局 |
| 10-01 | Gutsy 0.8B CPU运行 | 零硬件门槛 |
| 10-02 | 质疑文章:不优于LLM | 理性反思 |
| 10-07 | Jev SRE生产验证 | 落地实证 |
| 10-08 | Aplomb 1 (5.3B) | 开源新玩家 |
冷静思考:决策模型不是银弹
10月2日,HN上一篇题为"Decision models like Jev don’t beat LLM as a judge or traditional heuristics"的文章引发180+赞讨论。核心论点:在"裁判/评判"类任务上,决策模型并未优于传统LLM,甚至不如简单的启发式规则。
这揭示了决策模型的能力边界:
适合决策模型的场景:
- 结构化分类/路由(工单、邮件、内容)
- 实时判断(欺诈检测、异常告警)
- 浏览器操作(元素选择、操作类型)
- 工业运营(采矿、制造流程判断)
- 需要校准概率的场景(医疗分诊、风险评估)
不适合决策模型的场景:
- 开放域推理(需要System 2深思)
- 文本生成(报告撰写、对话)
- 复杂多步推理(数学证明、代码生成)
- 需要解释性的判断(法律、医疗诊断)
核心判断:决策模型不是LLM的替代品,而是LLM的补充层。在混合架构中,决策模型做毫秒级路由和初筛,LLM做深度分析和文本生成——这才是最优解。
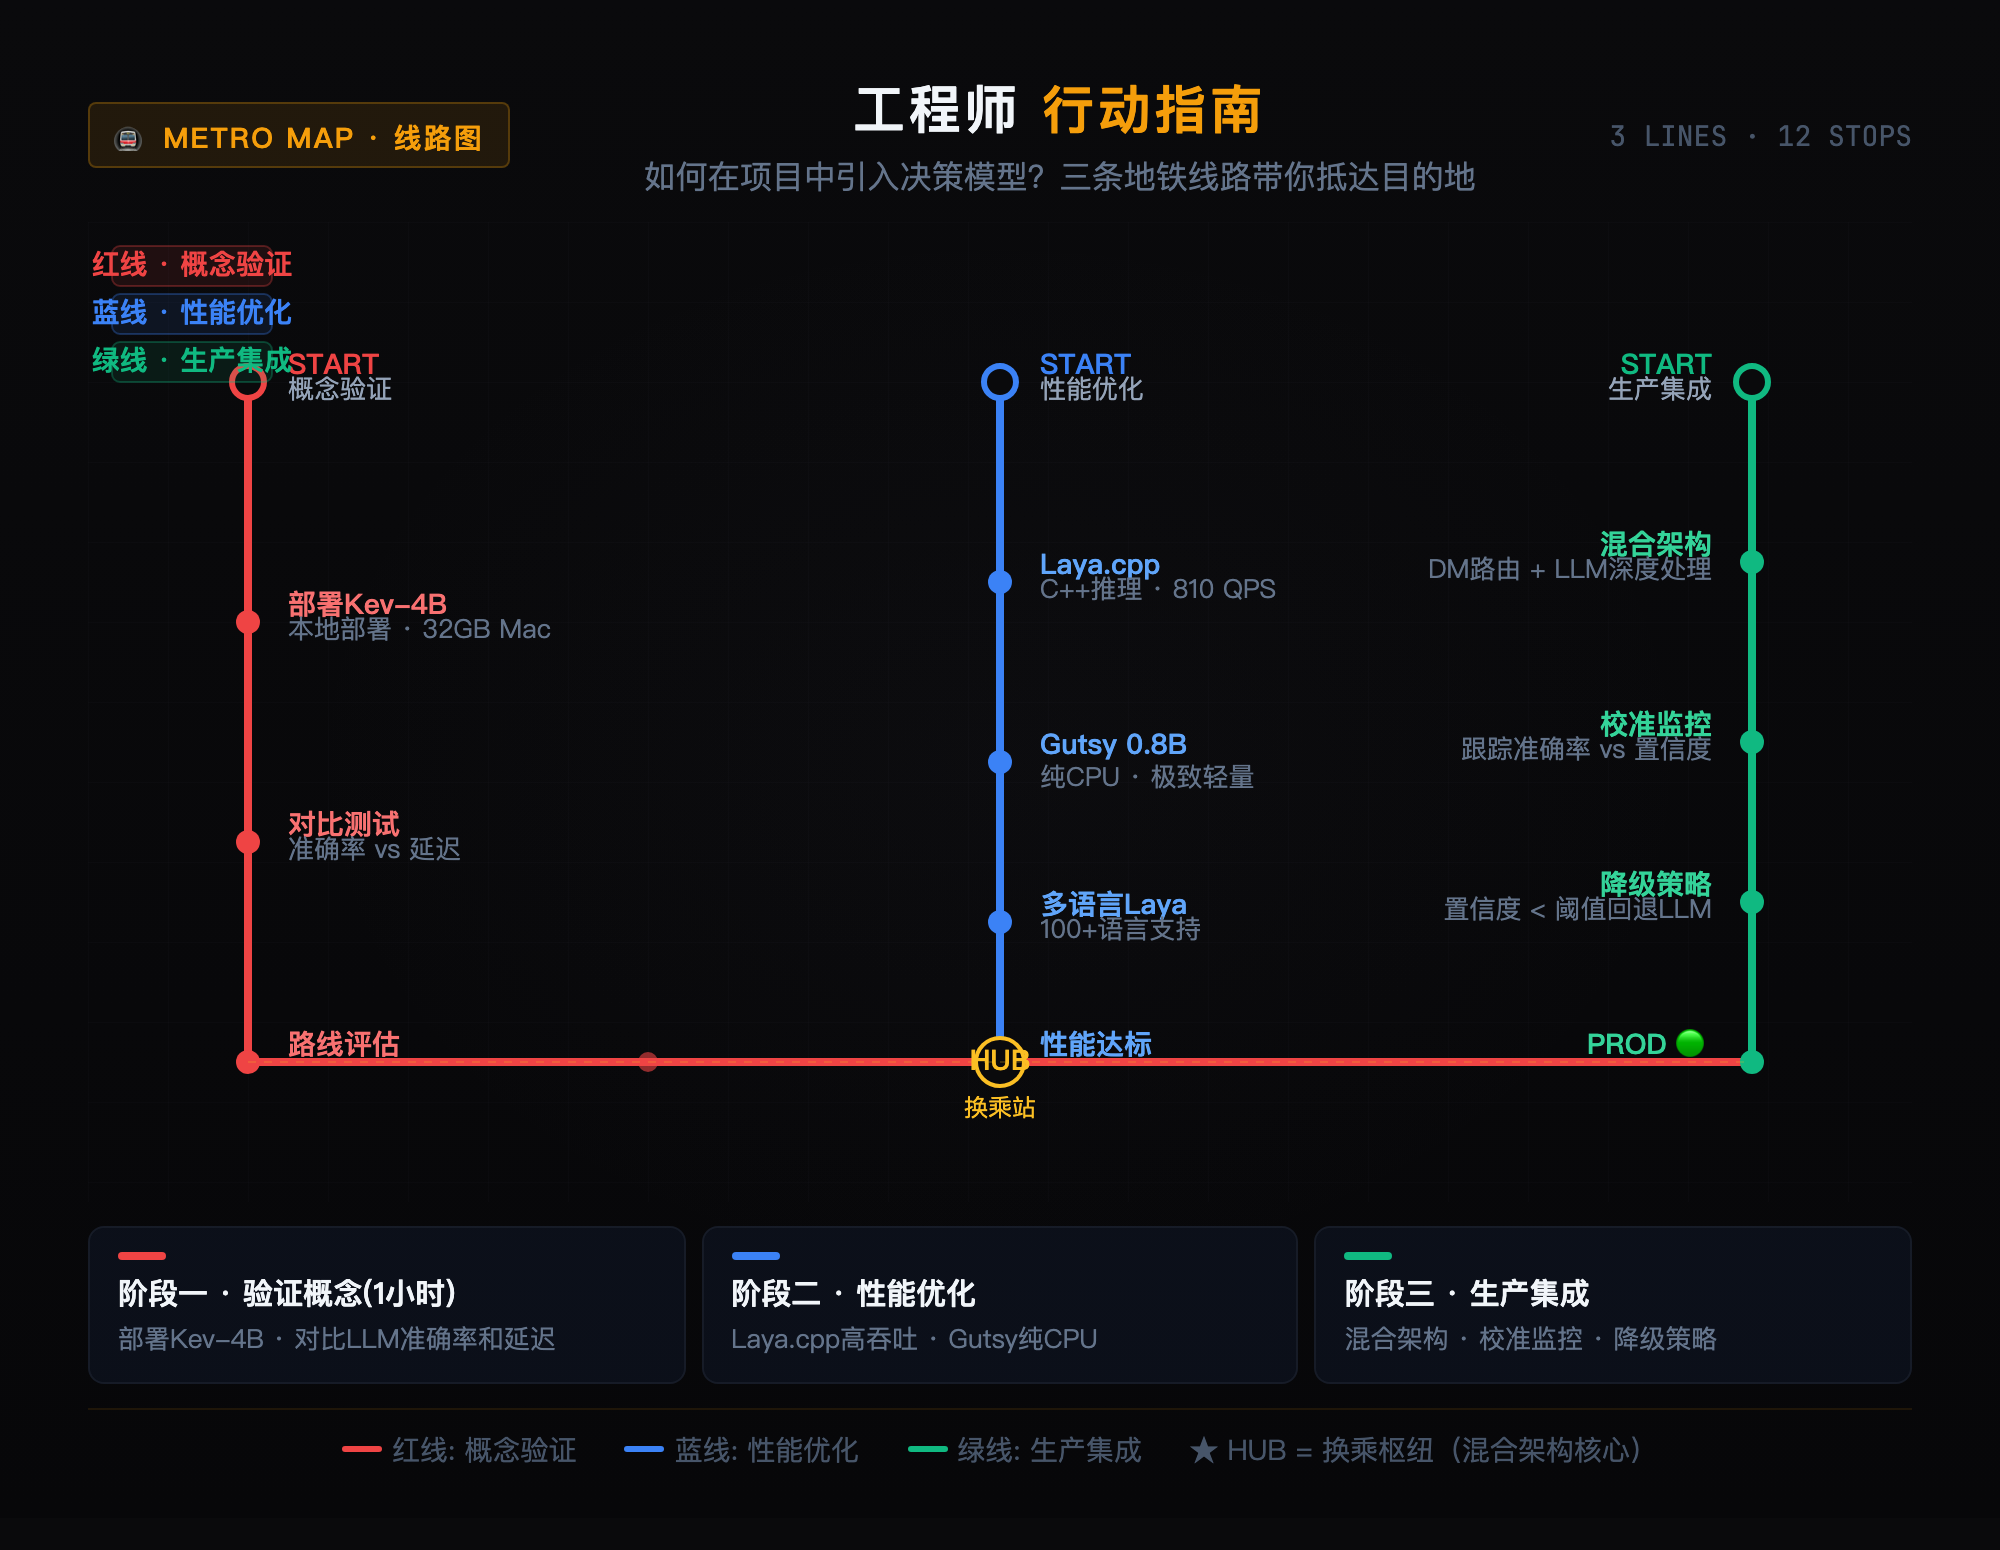
工程师行动指南:如何在项目中引入决策模型
基于当前生态成熟度,给出可落地的技术选型建议:
阶段一:验证概念(1小时)
- 部署Kev-4B:
uv sync --extra serve && KEV_DTYPE=bf16 uv run python -m kev.serve --run jaredpalmer/kev-4b --port 8009 - 用现有分类/路由任务测试,对比LLM的准确率和延迟
阶段二:性能优化(按需)
- 高吞吐场景:Laya.cpp C++实现(batch=8达810 QPS)
- 纯CPU环境:Gutsy 0.8B
- 多语言需求:Laya多语言版(100+语言)
阶段三:生产集成
- 混合架构:决策模型做路由 → LLM做深度处理
- 校准监控:跟踪实际准确率 vs 置信度
- 降级策略:置信度<阈值时回退到LLM
结语:推理主权的新纪元
从Jev到Laya,从Kev到Aplomb,决策模型的爆发揭示了一个深层趋势:AI推理正在从"文本生成"向"结构化决策"分化。这不仅仅是性能优化——它意味着推理成本的数量级下降、边缘设备的AI部署、以及真正实时的智能应用。
当0.8B参数的模型可以在CPU上以30毫秒完成一次校准决策时,“推理主权”——在本地、免费、实时地做出AI判断——终于从愿景变成了现实。
jev-leftpad的隐喻其实很完美:用AI做看似荒谬的小事,恰恰证明了我们已经进入了一个AI无处不在、推理成本趋近于零的新时代。
本文基于15个一手来源交叉验证,所有数据点均可溯源至原始HN讨论、官方博客和GitHub仓库。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 2
 0
- 0


 已为社区贡献2条内容

所有评论(0)