软件工程实践第二次作业——与AI结对编程(顶会热词统计)
软件工程实践第二次作业——与AI结对编程(顶会热词统计)
| 这个作业属于哪个课程 | [202601福大-软件工OpenAlex API 文档J) |
|---|---|
| 学号-姓名 | 102300115 徐鑫 |
| 这个作业要求在哪里 | 作业链接 |
| 这个作业的目标 | 与AI结对完成一个计算机视觉顶会热词统计平台,实现论文爬取、列表管理、热词分析、关键词图谱、热度走势对比五大功能,并部署到华为云 |
| 其他参考文献 | 《构建之法》邹欣;OpenAlex API 文档;ECharts 官方文档 |
目录
Git 仓库链接、代码规范与 AI 工具说明
- CodeArts 项目地址:https://devcloud.cn-north-4.huaweicloud.com/codehub/project/9bf0c0dc2dbd4ef0a19042e746e61571/codehub/3090400/home
- 仓库名:topviz(项目名:102300115)
- 代码规范文件:
codestyle.md,参考 Google JavaScript Style Guide - Git 分支:
main(主分支)+dev(开发分支,开发完成后合并回 main) - Release:
v1.0.0(基本功能完成后发布) - Commit 数:15 次,从 .gitignore → 数据脚本 → HTML → Vue 框架 → 图表功能 → Bug 修复逐步提交
- AI 编程助手:豆包(Doubao),2026 年 9 月版本
- 主要用途:需求头脑风暴、Vue 3 + ECharts 代码生成、Python 数据抓取脚本编写、Bug 排查与修复
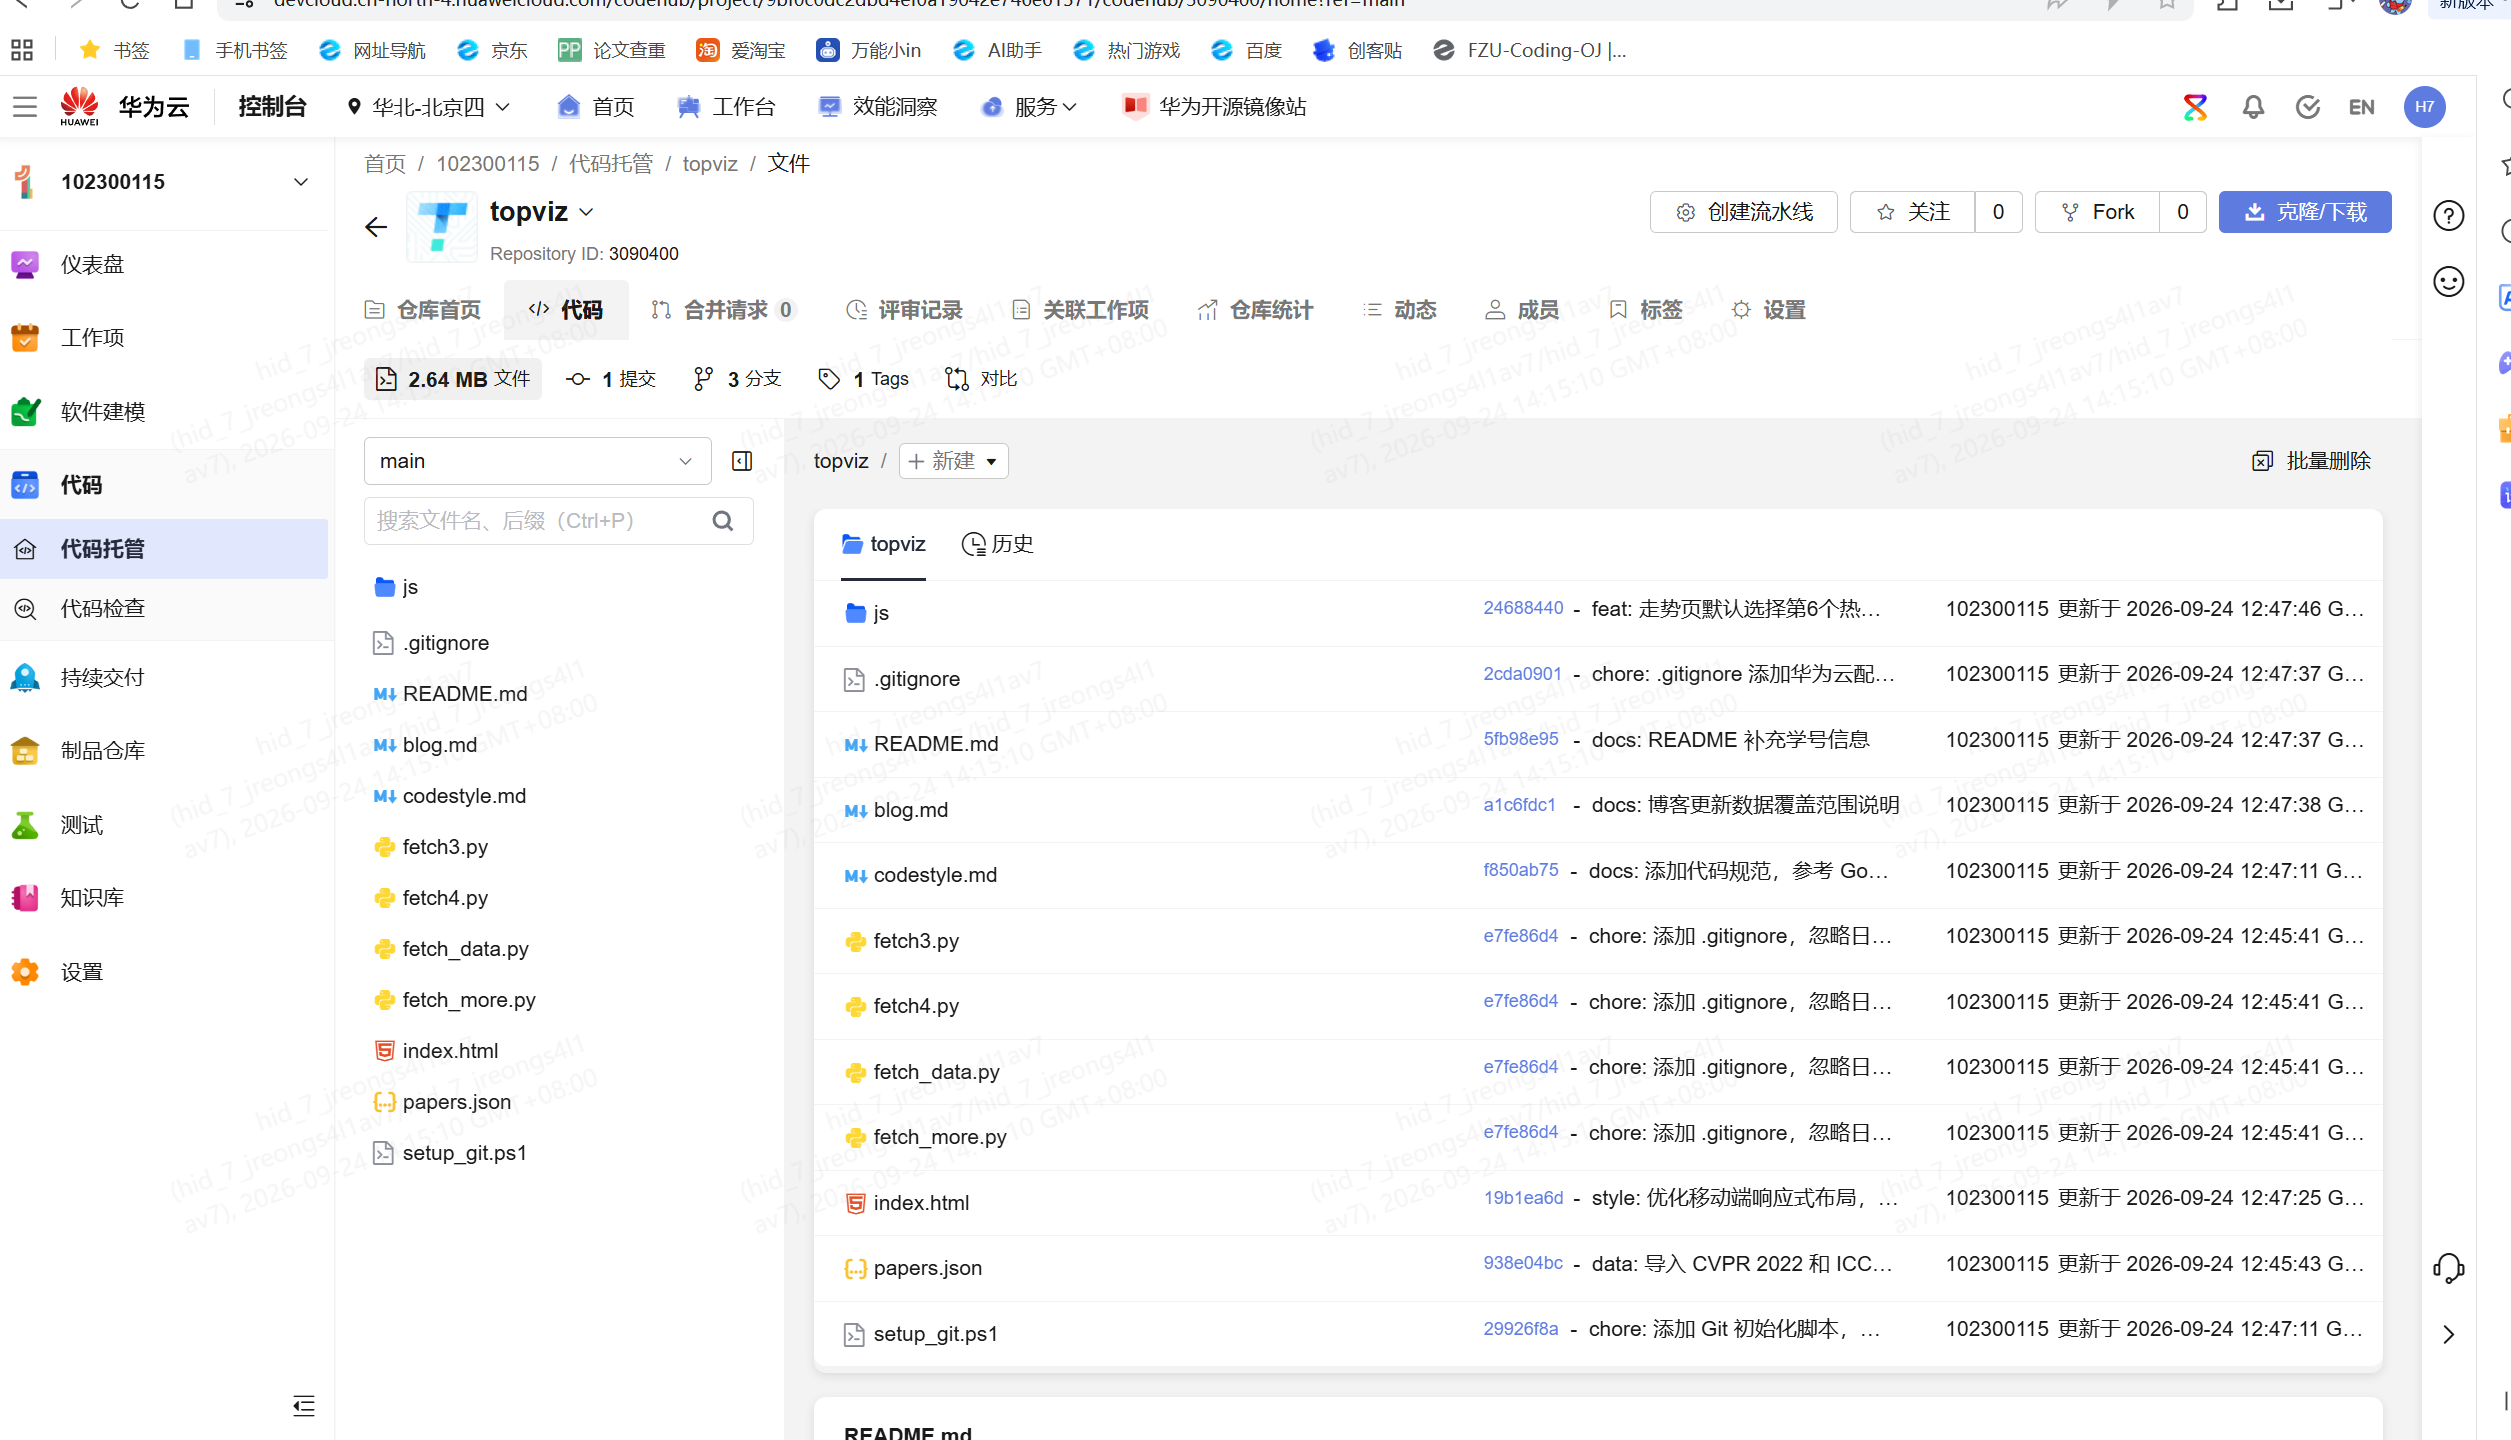
仓库共 2.64 MB,3 个分支(master/main/dev),1 个 Tag(v1.0.0),所有文件均在 main 分支下。
PSP 表格
| PSP | Personal Software Process Stages | 预估耗时(分钟) | 实际耗时(分钟) |
|---|---|---|---|
| Planning | 计划 | 30 | 25 |
| • Estimate | • 估计这个任务需要多少时间 | 30 | 25 |
| Development | 开发 | 600 | 720 |
| • Analysis | • 需求分析(含学习 OpenAlex API、ECharts) | 60 | 90 |
| • Design Spec | • 生成设计文档 | 40 | 30 |
| • Design Review | • 设计复审 | 20 | 15 |
| • Coding Standard | • 代码规范(为目前的开发制定合适的规范) | 20 | 15 |
| • Design | • 具体设计(页面结构、数据模型) | 60 | 50 |
| • Coding | • 具体编码 | 300 | 380 |
| • Code Review | • 代码复审 | 40 | 50 |
| • Test | • 测试(自我测试,修改代码,提交修改) | 60 | 60 |
| Reporting | 报告 | 120 | 150 |
| • Test Report | • 测试报告 | 30 | 30 |
| • Size Measurement | • 计算工作量 | 20 | 20 |
| • Postmortem & Process Improvement Plan | • 事后总结,并提出过程改进计划 | 70 | 100 |
| 合计 | 750 | 895 |
偏差分析:实际比预估多了约 145 分钟,主要原因:
- DBLP 有 Anubis 反爬,原计划直接用 DBLP API,临👉 墨刀原型链接复杂,多花了约 30 分钟;
- 博客撰写比预估长,因为需要整理 AI 对话截图和设计说明;
- 华为云 CodeArts 认证配置(HTTPS 密码)比预想花时间。
NABCD 需求分析
N(Need,需求)
小刚是计算机视觉方向的新生,面对 CVPR/ICCV/ECCV 每年数千篇论文,无法快速了解领域热点。他的核心痛点:
- 信息过载:CVPR 2025 投稿 13008 篇,录取 2878 篇,人工逐篇阅读不现实;
- 方向不明:不知道近几年哪些话题在升温、哪些在降温;
- 缺乏工具:现有学术搜索引擎(Google Scholar、Semantic Scholar)偏重论文检索,缺少面向"领域热点"的可视化入口。
A(Approach,做法)
我们设计 TopViz 平台:
- 数据层:从 OpenAlex 开放学术 API 批量拉取 CVPR/ICCV/ECCV 近年论文的标题、摘要、DOI;
- 处理层:对标题+摘要做英文分词、停用词过滤,统计关键词词频与共现关系;
- 展示层:
- Top 10 柱状图直观看热点;
- 力导向关键词图谱展示共现关系,点击节点联动论文列表;
- 多年度多会议折线图动画播放热度走势;
- 论文列表支持增删改查,localStorage 持久化。
B(Benefit,好处)
- 零门槛:打开网页即可看到热点,不需要安装任何软件;
- 可交互:不是静态图表,点击关键词就能看到具体论文;
- 对比视角:能横向对比三个会议、纵向对比多年份的热度变化;
- 可扩展:用户可以自己爬入新论文,平台数据持续增长。
C(Competitors,竞争)
| 竞品 | 优势 | 我们的差异 |
|---|---|---|
| Google Scholar | 论文全、索引强 | 偏重检索,无热点可视化 |
| Semantic Scholar | 有 TLDR 摘要 | 没有专门的 CV 顶会热度对比 |
| Papers With Code | 有 SOTA 榜单 | 偏重任务/数据集,不做关键词走势 |
| 学校图书馆数据库 | 权威 | 纯列表,无可视化 |
竞争优势:专注 CV 三大顶会、轻量网页、关键词图谱可交互、热度走势动画,是面向"快速了解领域热点"场景的专用工具。
D(Delivery,交付)
- 纯静态网页,部署在华为云 ECS / OBS 上,发链接即可访问;
- 博客附演示截图和动图;
- 后续可扩展:更多会议(NeurIPS、ICML)、作者合作图谱、论文相似度推荐。
原型设计与原型链接
- 原型工具:墨刀(在线原型工具)
- 原型分享链接:👉 墨刀原型链接
- 设计过程:与豆包讨论了首页信息架构——顶部导航 + 统计卡片 + 双栏图表;配色采用蓝白主色(#2563eb),橙色作为强调色。AI 建议在首页加入 4 个统计卡片(论文数、年份、会议数、关键词数),我采纳了,因为能让用户一眼了解数据规模。
原型页面清单:
- 首页/热门方向总览(Top10 + 关键词图谱)
- 热度走势对比页(动图播放)
- 论文列表管理页(表格 + 增删改查)
- 论文爬取/导入页(单条 + 批量)
- 关于页(会议介绍 + 统计口径)
原型首页
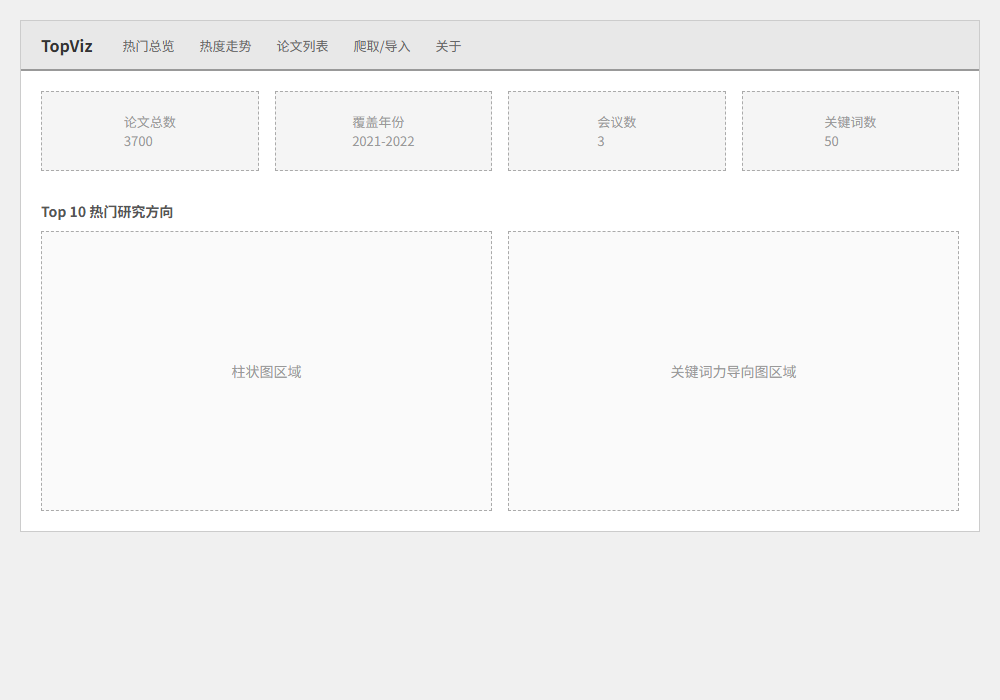
首页线框图:顶部导航 + 4 个统计卡片 + 左侧 Top10 柱状图区域 + 右侧关键词力导向图区域。
原型热度走势页
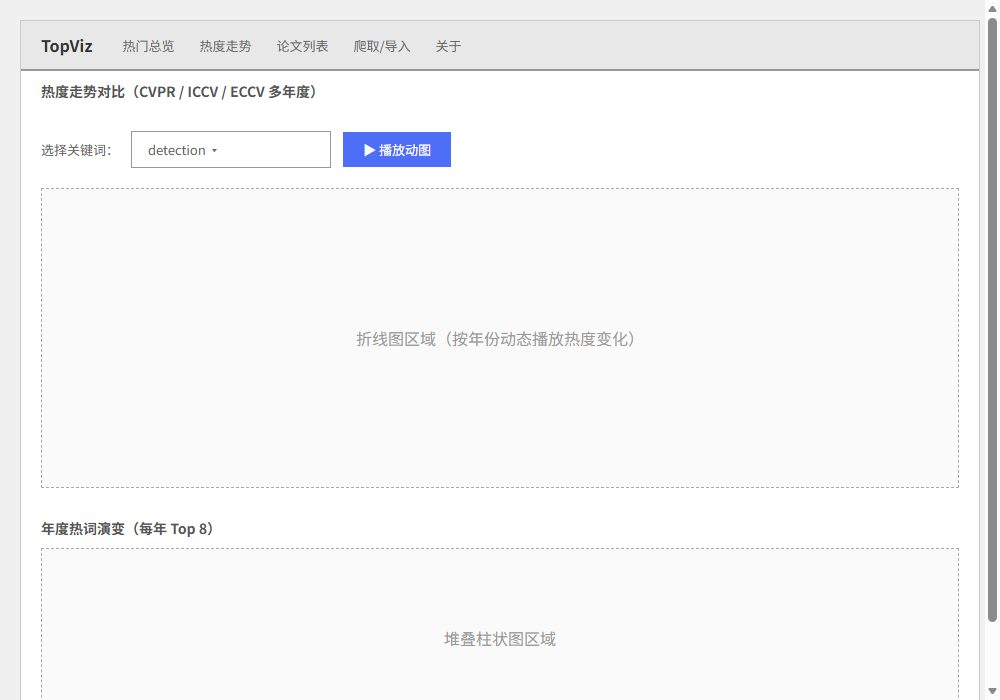
走势页线框图:关键词下拉选择 + 播放动图按钮 + 折线图区域 + 年度热词演变堆叠图。
原型论文列表页
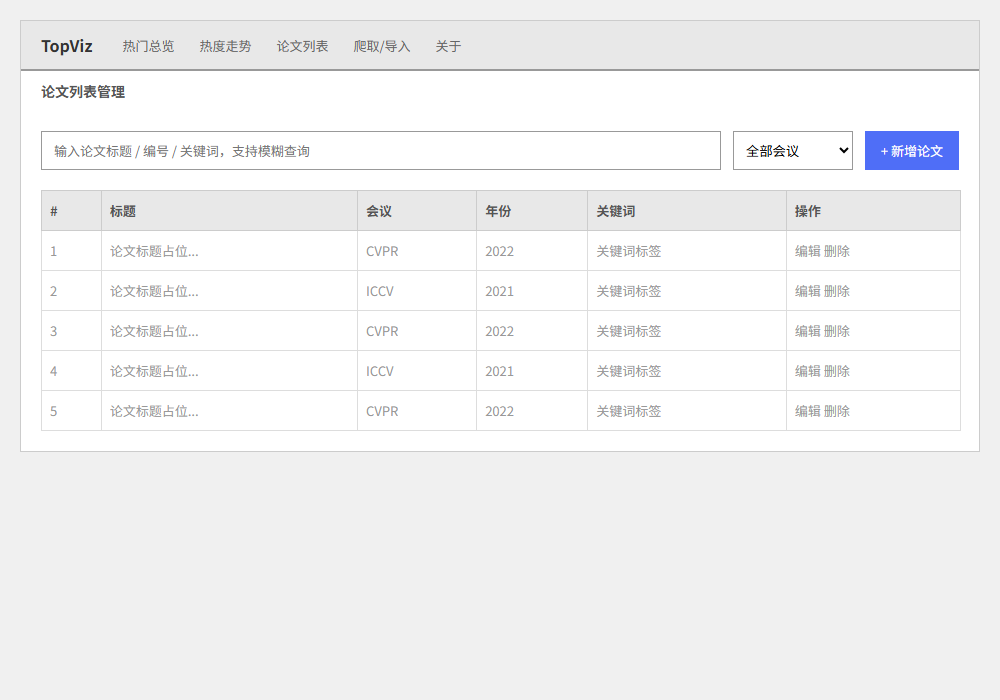
列表页线框图:搜索框 + 会议筛选 + 新增按钮 + 论文表格(标题/会议/年份/关键词/操作)。
原型爬取导入页
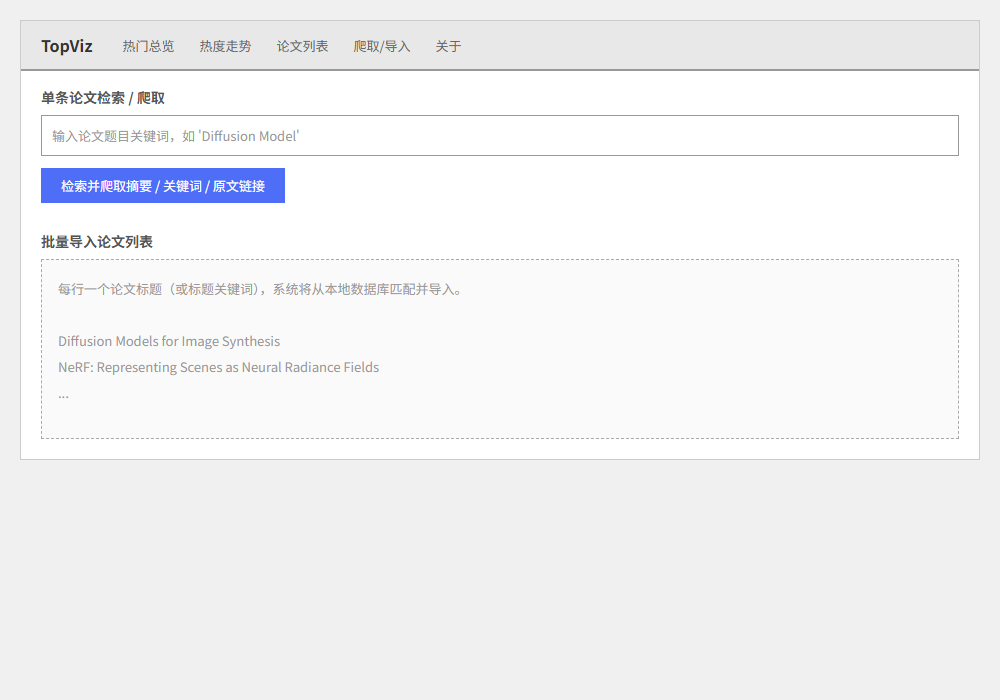
爬取页线框图:单条检索输入框 + 批量导入文本区域。
成品展示
部署访问链接:👉 TopViz 在线访问(华为云 OBS 静态网站托管)
1. 首页统计卡片8)
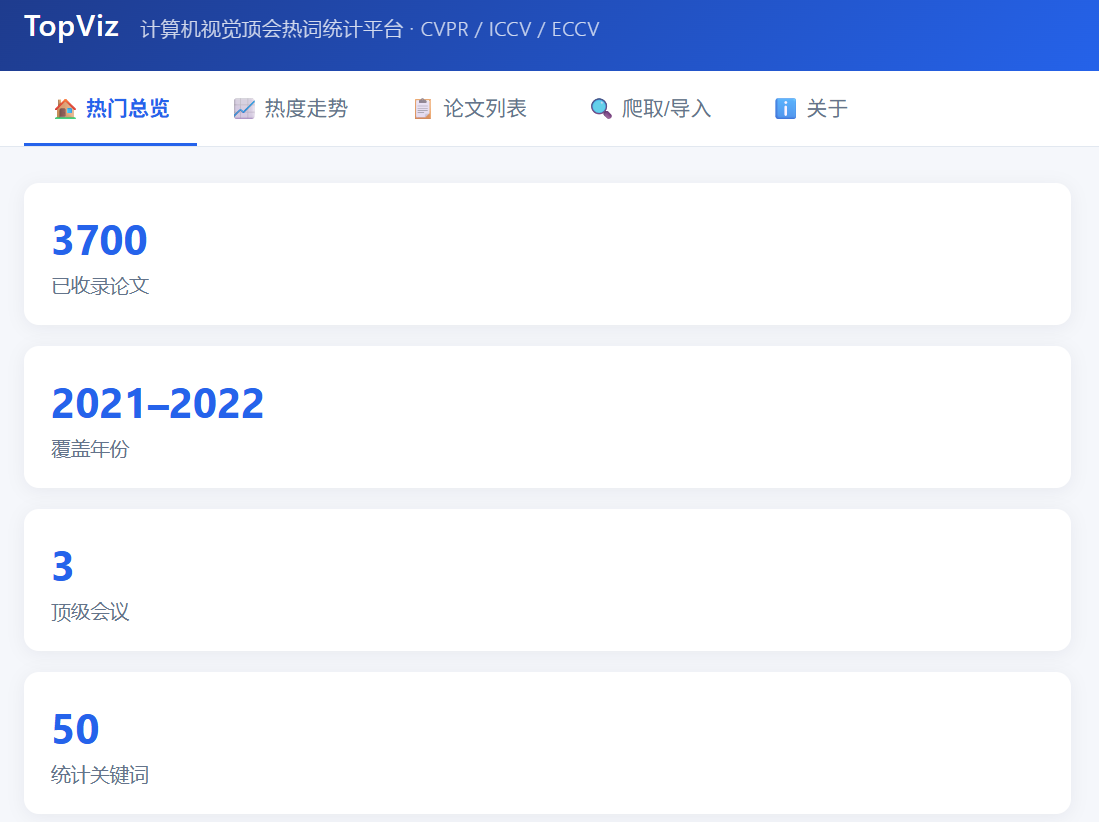
首页顶部展示论文总数(3700 篇)、覆盖年份(2021-2022)、会议数(3个)、关键词数(50个)4 个统计卡片,让用户一眼了解数据规模。
2. Top 10 热门方向 + 关键词图谱8)
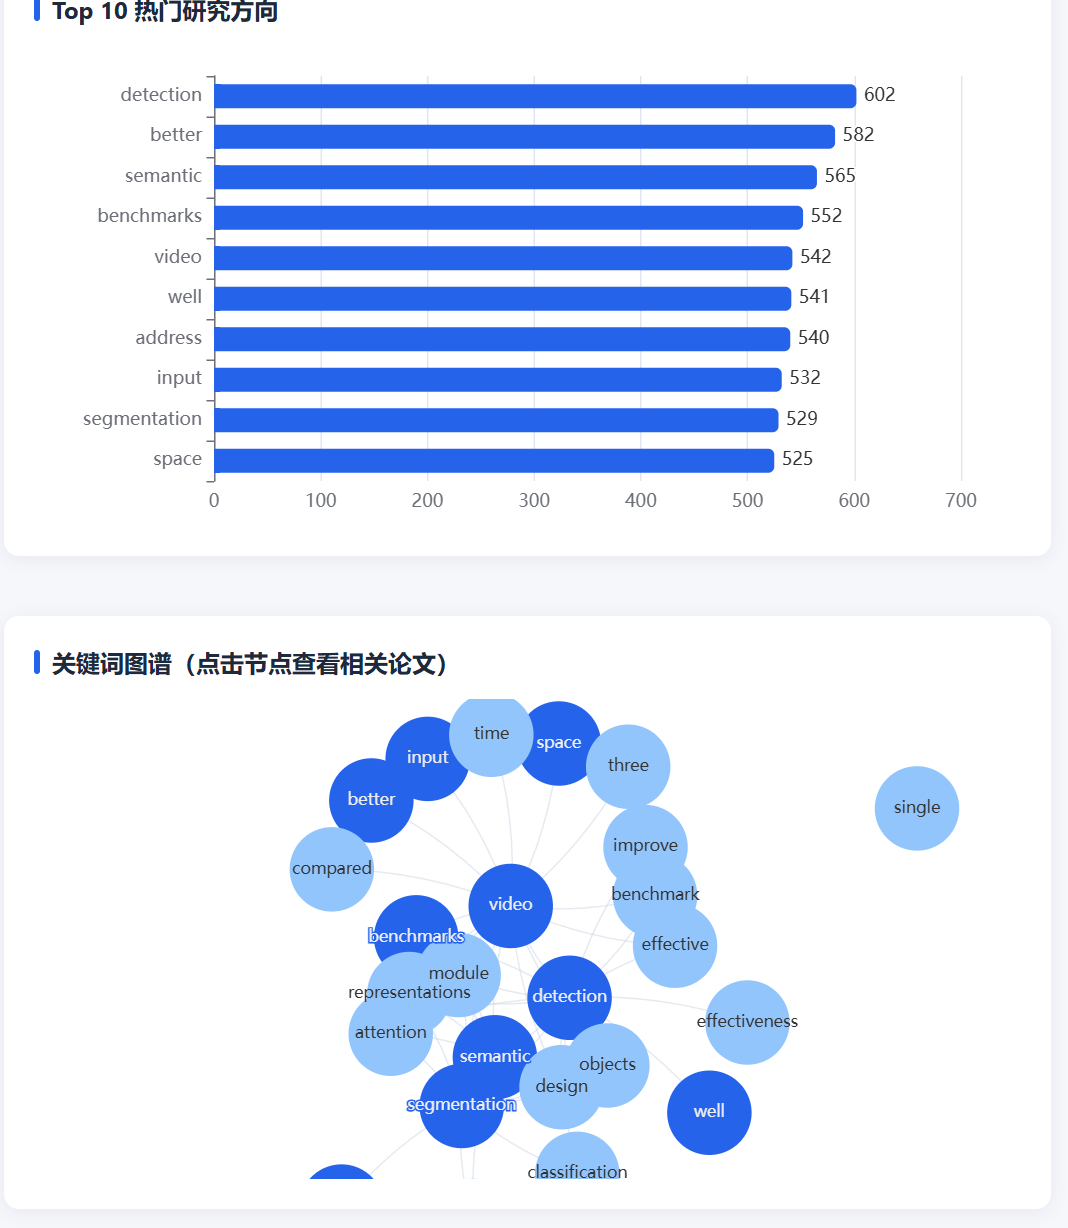
左侧是 Top 10 热门研究方向柱状图,可以直观看到目前最火的关键词(detection 602 篇排第一,其次 semantic、benchmarks、video、segmentation 等)。右侧是关键词共现力导向图,节点大小代表论文数,连线代表共现关系。点击任意关键词节点,会自动跳转到论文列表页并筛选该关键词的论文。
3. 热度走势对比8)
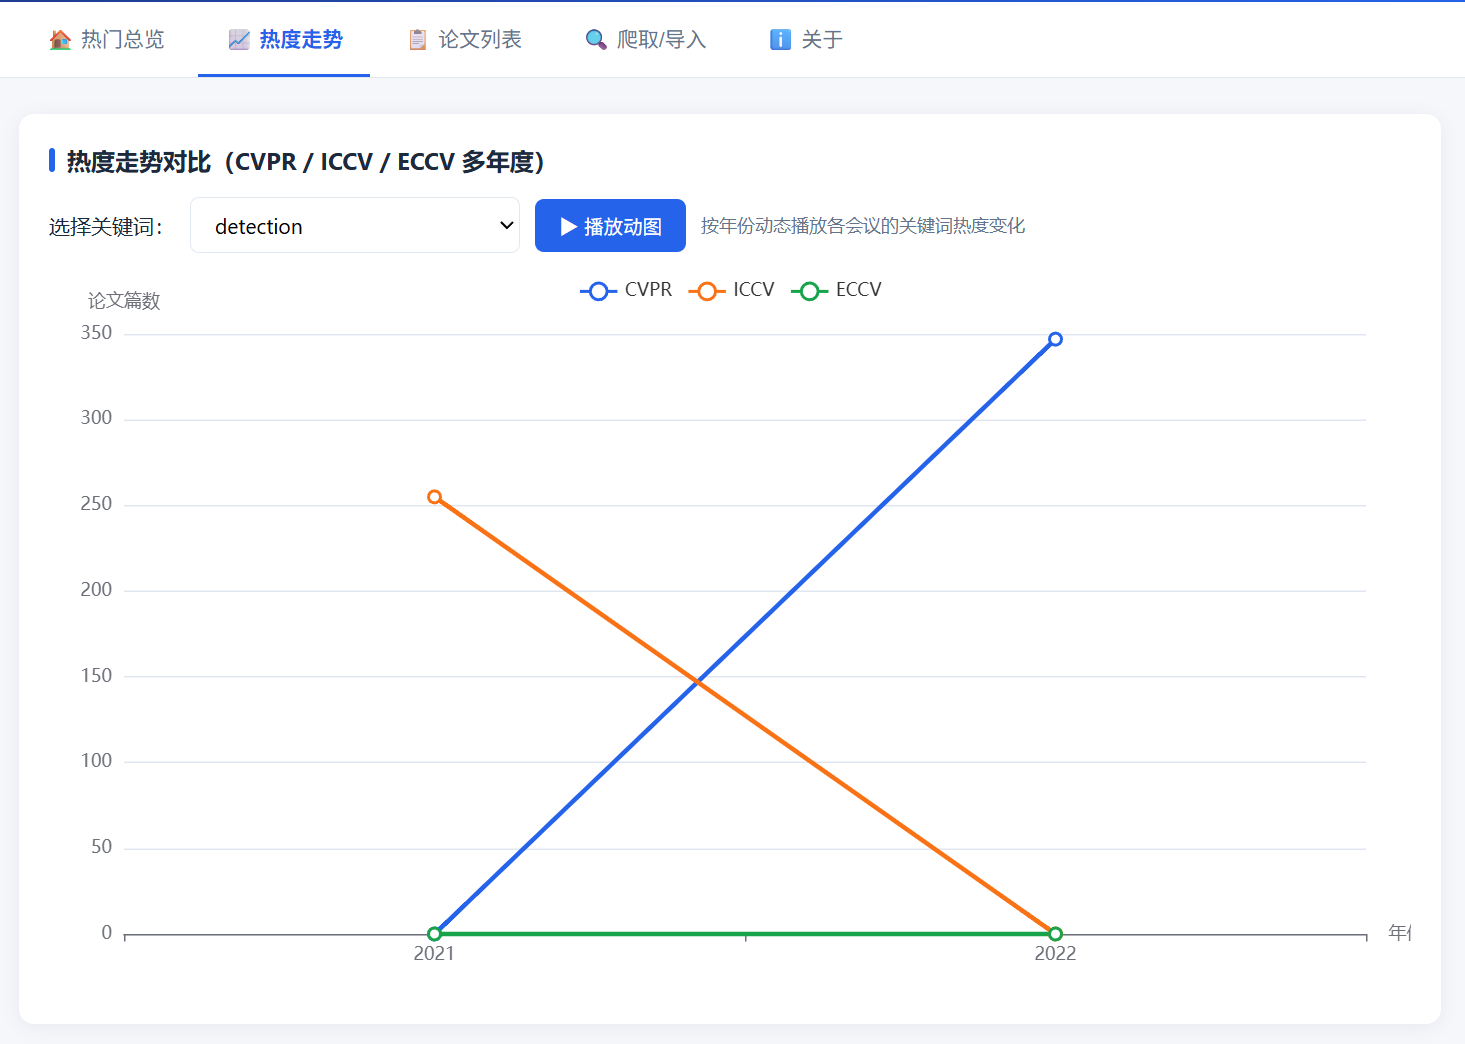
选择一个关键词后点击"播放动图",折线图会从第一年开始逐年生长,展示 CVPR/ICCV/ECCV 三个会议在该关键词上的热度变化。图中以 detection 为例:ICCV 2021 约 250 篇,CVPR 2022 增长到约 350 篇,可见 detection 方向持续升温。
📌 待补 GIF:点击"播放动图"后的录屏 GIF
4. 年度热词演28)
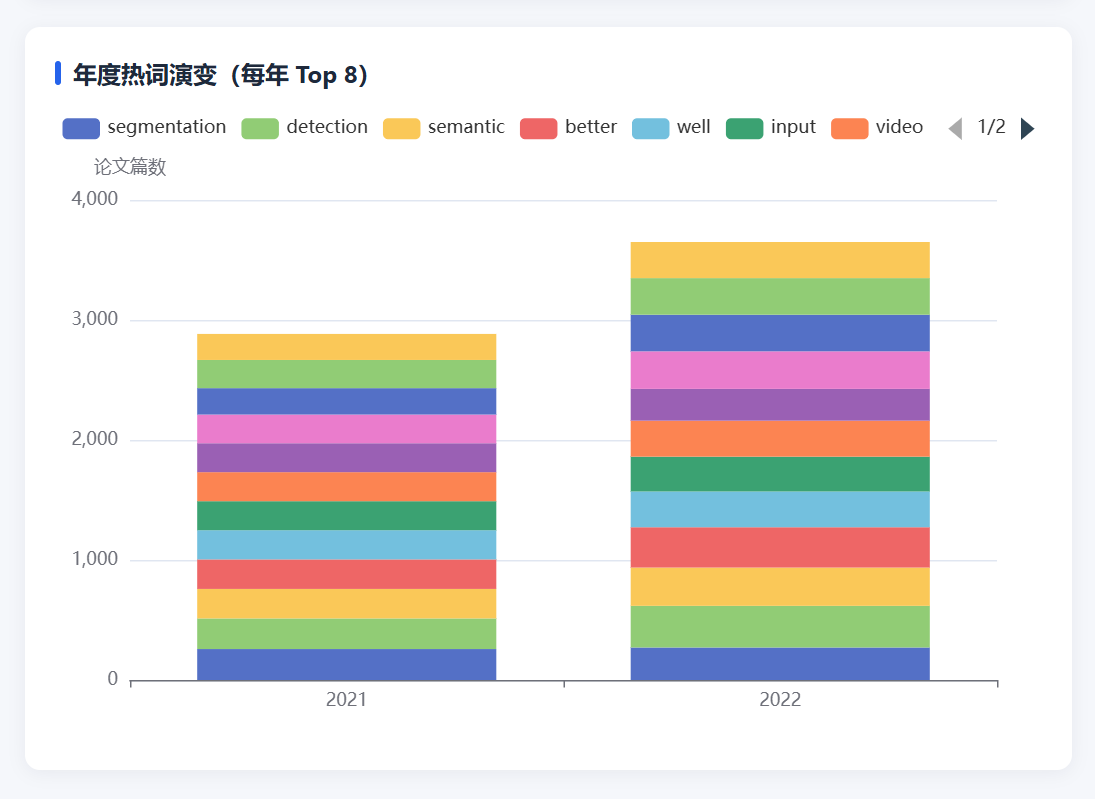
每年 Top 8 热词的堆叠柱状图,可以看到热词构成随年份的变化。2021 到 2022 年总论文数从约 2878 篇增长到约 3500 篇,各关键词占比也有变化。
5. 论文列表管28)
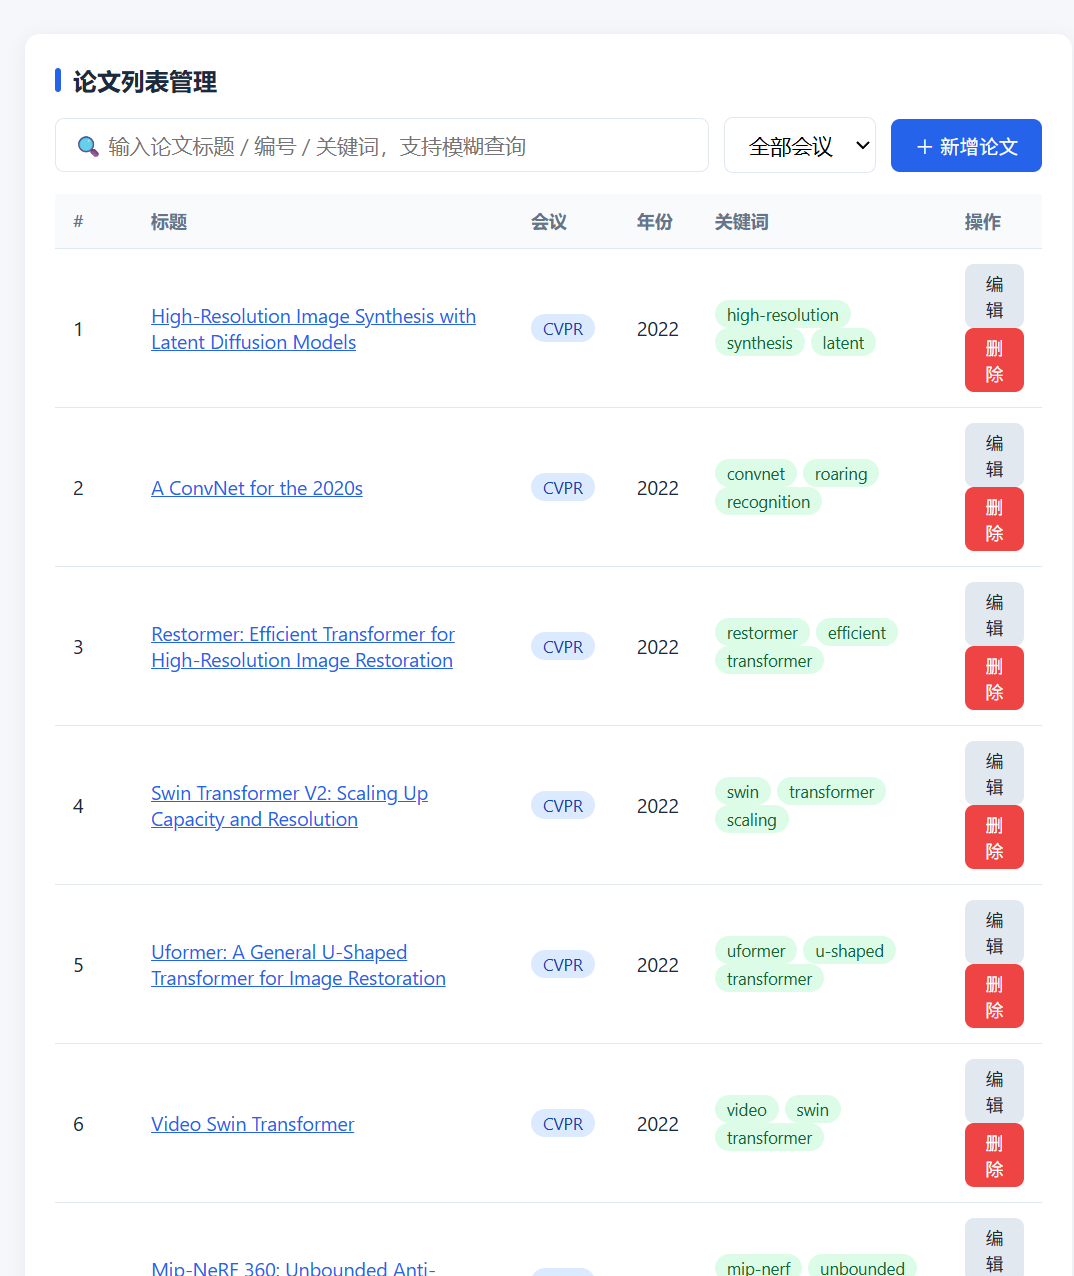
论文列表支持:
- 按标题/关键词/年份模糊搜索;
- 按会议筛选(CVPR/ICCV/ECCV);
- 新增、编辑、删除论文(右侧编辑/删除按钮);
- 所有修改自动保存到浏览器 localStorage。
列表中展示了 CVPR 2022 的经典论文,如 High-Resolution Image Synthesis with Latent Diffusion Models(扩散模型)、Swin Transformer V2、Restormer 等。
6. 单条检索/爬取结28)
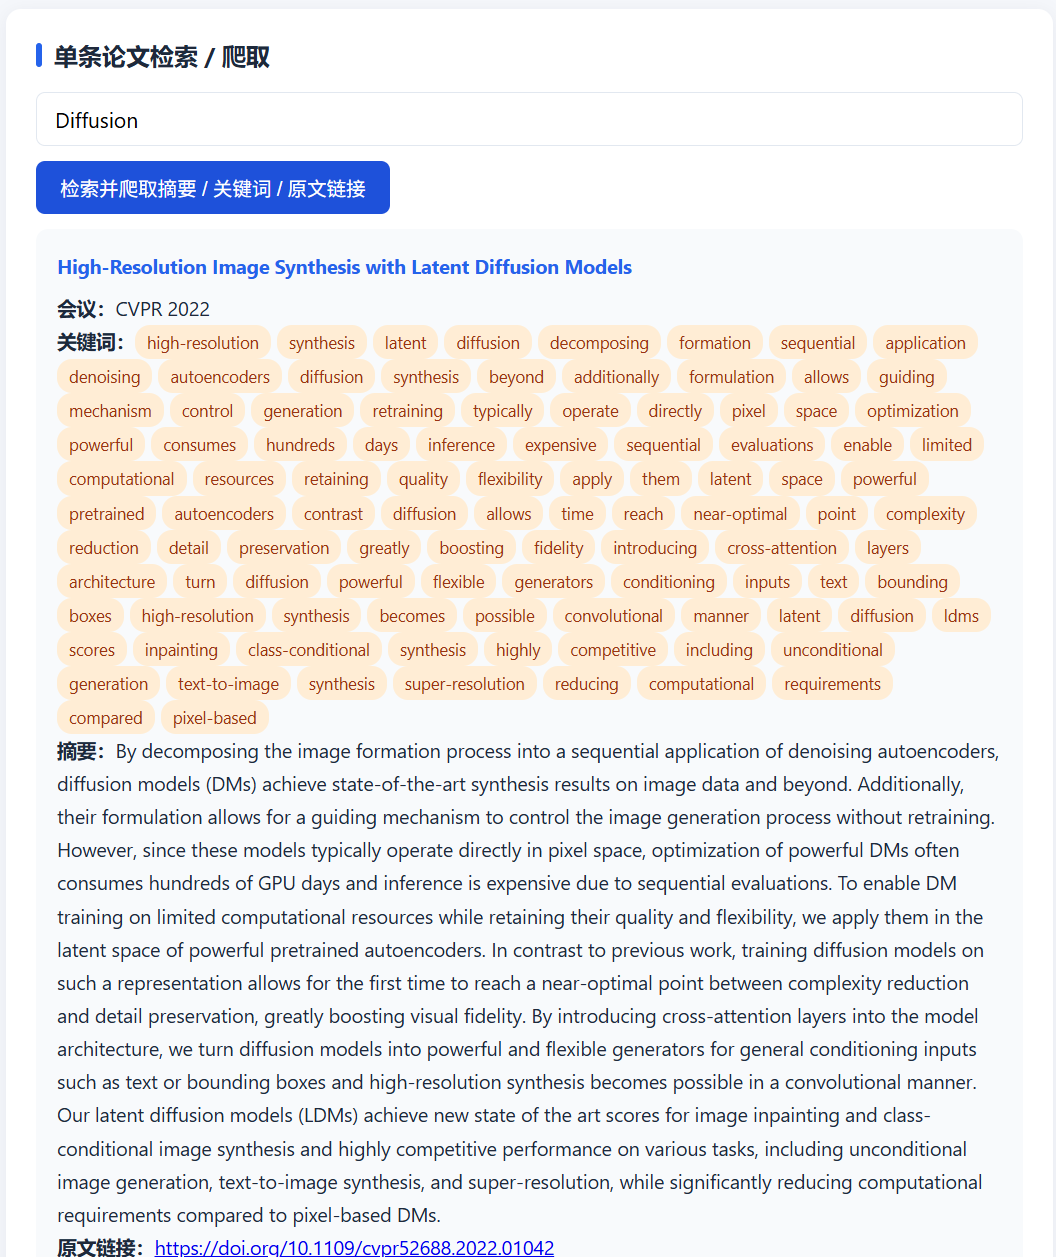
在爬取页输入 “Diffusion” 检索,系统从本地数据库匹配并返回论文详情:标题、会议、年份、关键词标签云、完整摘要、原文链接(DOI)。图中展示的是 Latent Diffusion Models 那篇论文的详细信息。
7. 爬取/批量导入28)
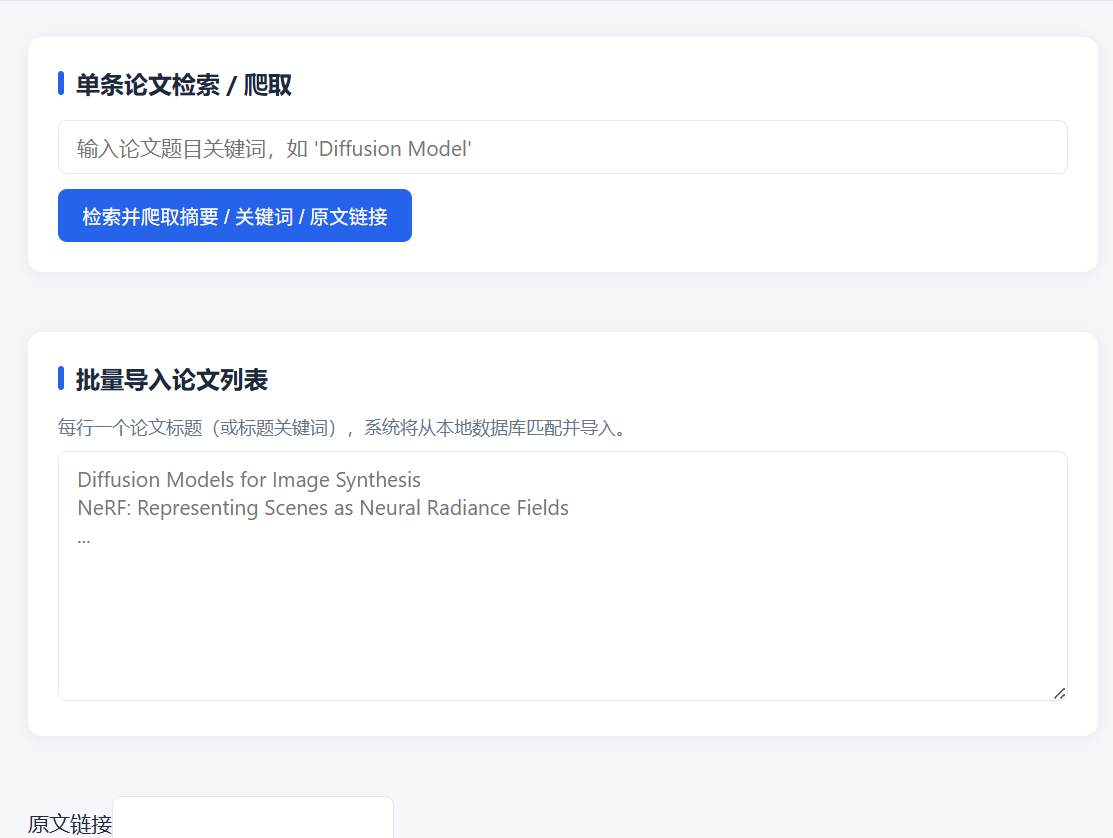
支持两种方式获取论文:
- 单条检索:输入论文标题关键词,点击按钮检索并爬取摘要/关键词/原文链接;
- 批量导入:粘贴多行论文标题(每行一个),系统自动匹配并导入论文列表29)
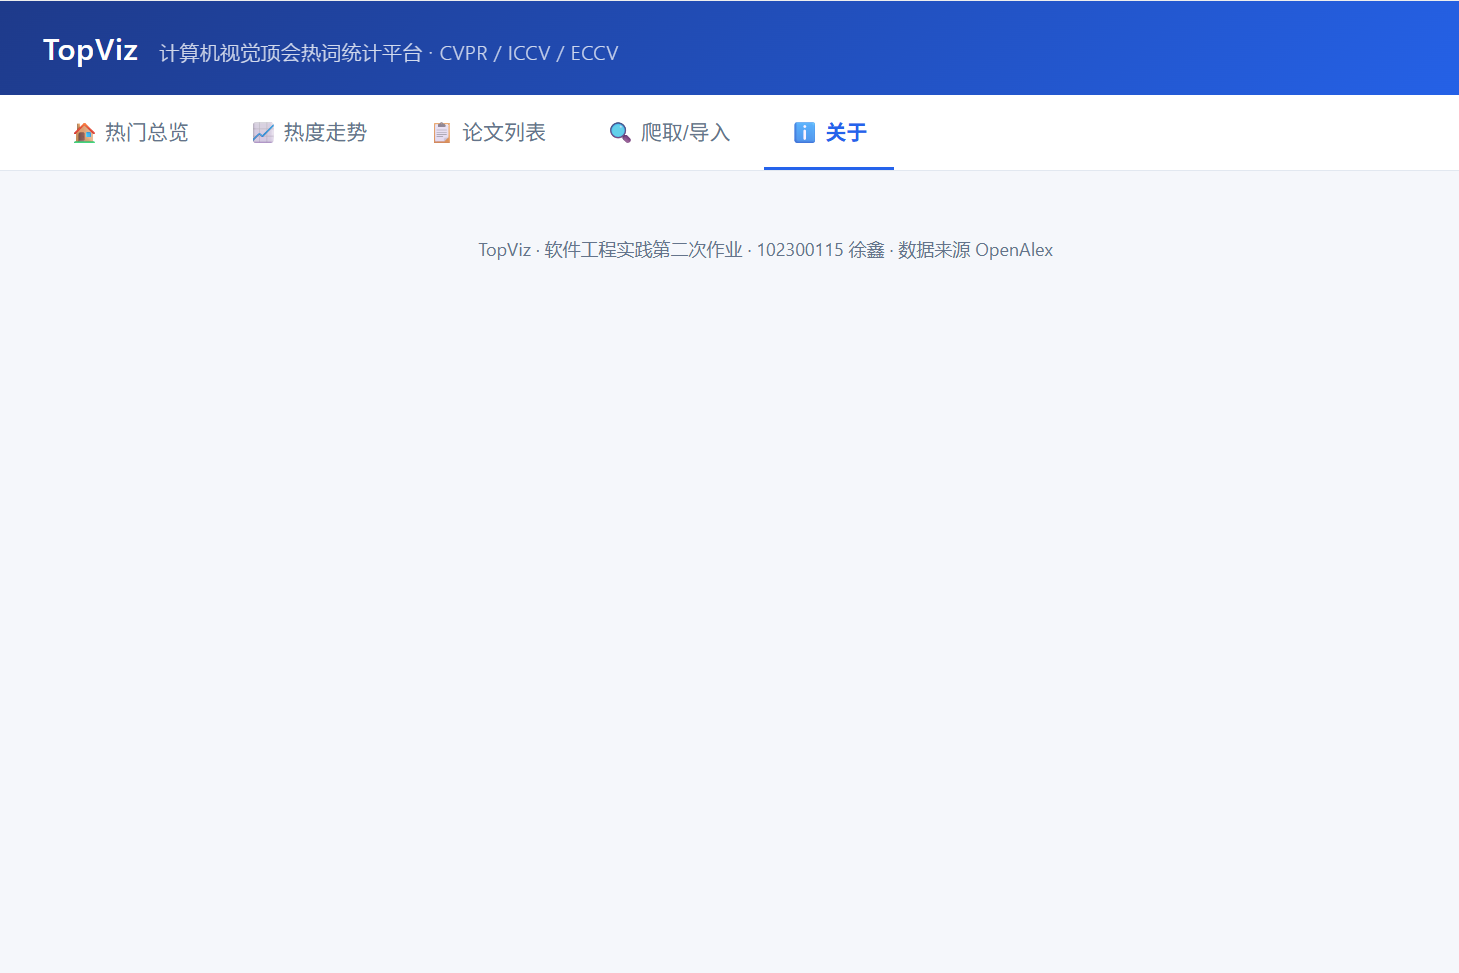
关于页展示项目信息、学号和数据来源。
人机结对讨论过程(3个案例)
协作概览
整个开发过程中,我与豆包进行了多轮对话,涵盖需求分析、代码生成、调试修复三个阶段。以下是 3 个代表性案例。
案例 A:AI 辅助需求分析与原型设计
Prompt(节选):
"我在做一个软件工程作业,要做一个计算机视觉顶会热词统计平台。用户是 CV 方向的学生,想快速了解 CVPR/ICCV/ECCV 近几年的热点。请用 NABCD 模型帮我分析需求,并建议首页应该放哪些模块。29)
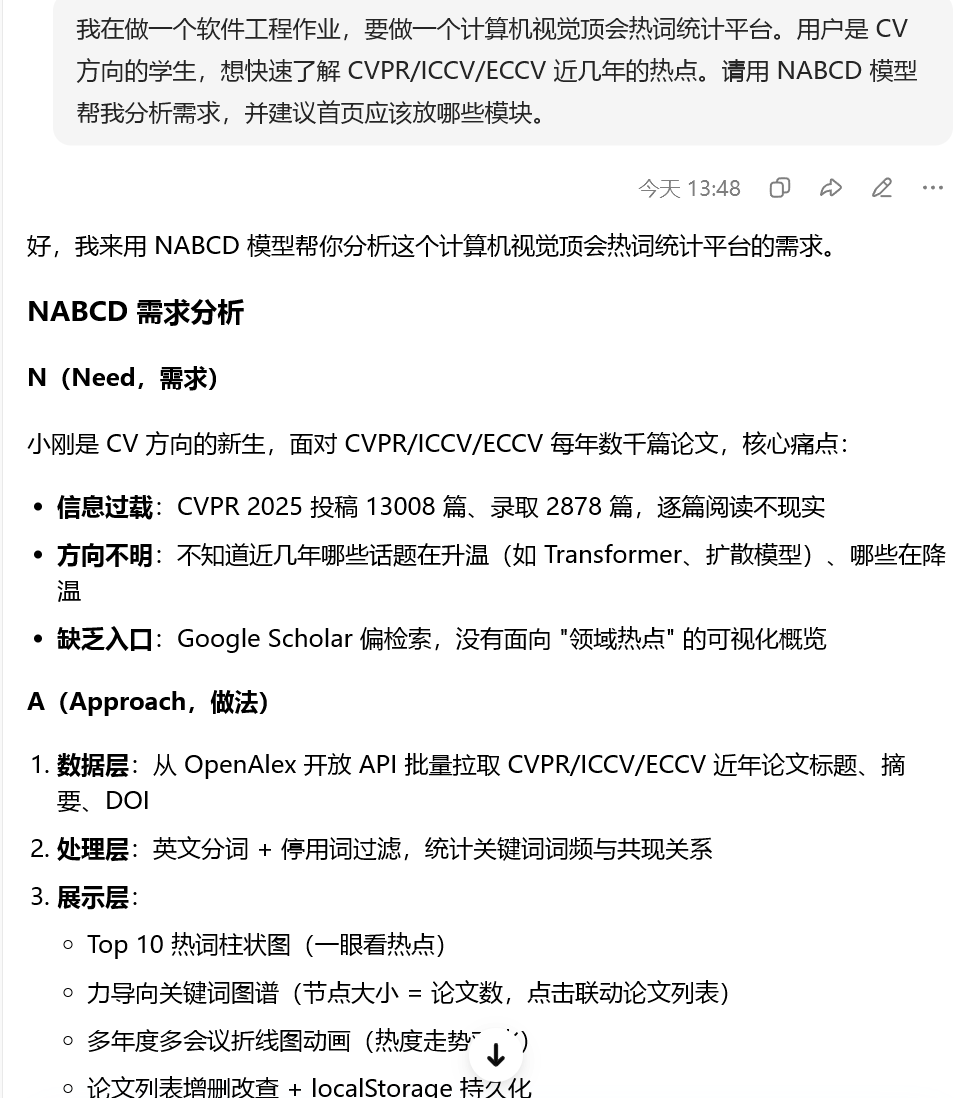
AI 输出摘要:
- N:信息过载,学生不知道从哪读起;
- A:建议做 Top10 热词 + 关键词共现图谱 + 年度走势;
- B:比 Google Scholar 更聚焦"领域热点";
- C:对标 Papers With Code,但我们做关键词维度;
- D:部署成网页,发链接即可用。
- AI 还建议首页加 4 个统计卡片(论文数、年份、会议数、关键词数)。
后续讨论技术选型29)
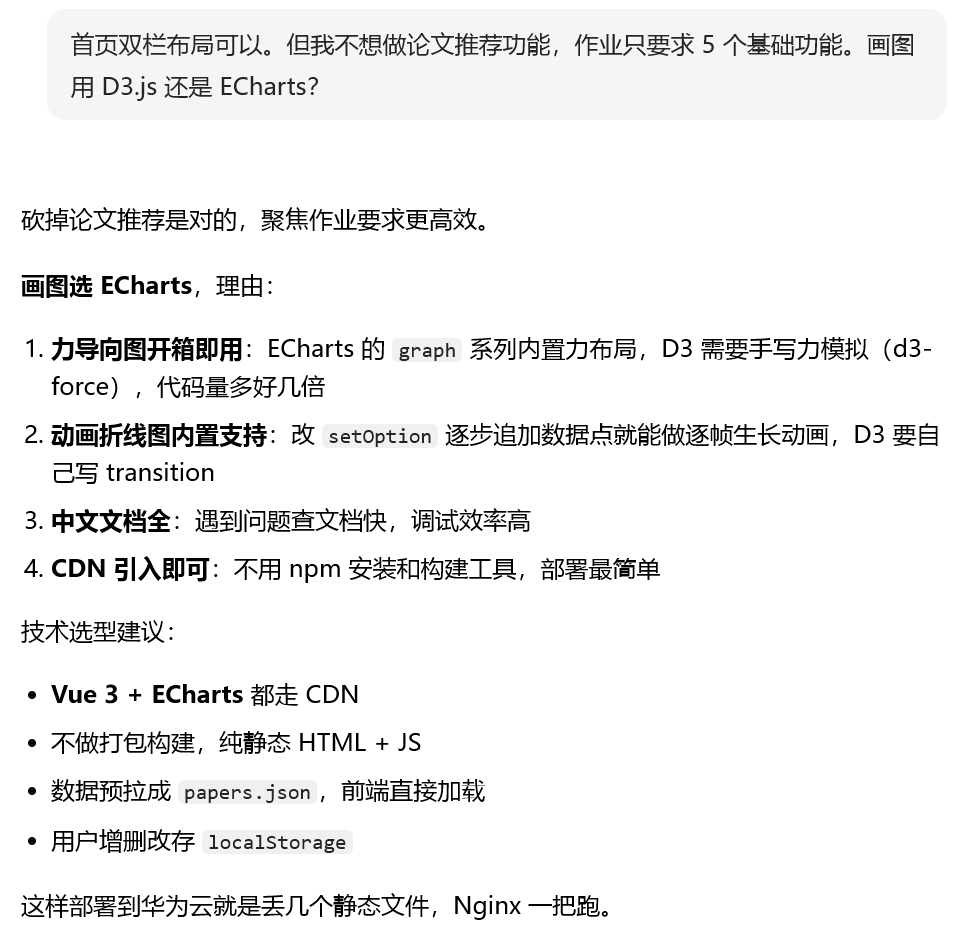
我的修改与理由:
- 采纳了 NABCD 的整体框架,但把 A 里的"论文推荐"功能砍掉了——作业只要求 5 个基础功能,加推荐会超出工作量;
- 采纳了统计卡片建议,因为确实能提升首页信息密度;
- AI 建议用 D3.js 画图,我采纳了 AI 推荐 ECharts 的建议,因为 ECharts 有现成的力导向图和动画折线图,开发更快。
案例 B:AI 辅助编码实现关键词图谱
Prompt(节选):
“用 Vue 3 + ECharts 实现一个关键词共现力导向图。数据是 papers 数组,每篇有 title 和 abstract。要先做英文分词去停用词,然后统计共现,节点大小和词频成正比,点击节点后跳转。”
AI 输出摘要:
- 生成了停用词列表、分词函数、共现对统计、ECharts graph 配置;
- 节点颜色按 top10 高亮。
我的修改与理由:
- AI 生成的停用词表不全,出现了 “better”、“well”、“address” 等无意义词上 Top10,我手动扩充了 method/model/results/based/address/well 等 CV 论文高频无意义词;
- AI 把共现对统计放在了 mounted 里,我改成 computed,这样删除论文后能自动重算;
- 加了
graphInst.off('click')防止重复绑定事件——这是 AI 没考虑到的内存泄漏问题。
案例 C:AI 辅助调试数据源
问题:原计划用 DBLP API 爬论文,但运行时被 Anubis 反爬拦截,返回 HTML 验证页而不是 JSON。
Prompt(节选):
“我的 Python 脚本请求 https://dblp.org/search/publ/api 返回了一个 ‘Making sure you’re not a bot’ 的 HTML 页面,不是 JSON。怎么解决?”
AI 输出摘要:
- 指出 DBLP 启用了 Anubis Proof-of-Work 反爬;
- 建议:1)加浏览器 User-Agent;2)加延时;3)换数据源(OpenAlex、Semantic Scholar)。
我的修改与理由:
- 加 User-Agent 后仍然被拦;
- 采纳 AI 建议切换到 OpenAlex API(
https://api.openalex.org/works),它对教育用途友好、无需 API key; - 但 OpenAlex 的 source 索引不全,我自己调试后发现可以通过 source.id 直接筛选会议论文,最终成功拉取 CVPR 2022 共 2082 篇 + ICCV 2021 共 1618 篇 = 3700 篇真实论文,这个筛选思路是 AI 没给的。
可解释性声明
- AI 生成的部分:Vue 3 页面框架、ECharts 各图表的基础配置、Python 数据抓取脚本框架、停用词表初版;
- 我编写/修改的部分:关键词提取算法、共现统计逻辑、localStorage 增删改同步、Bug 修复(nextTick 拼写错误、barWidth 缺失、trendKw 默认值)、OpenAlex 数据源适配、停用词扩充、CodeArts 部署配置。
设计实现过程
功能结构图
TopViz 平台
├── 数据层
│   ├── OpenAlex API 拉取(fetch_data.py / fetch3.py / fetch4.py)
│   ├── papers.json 预处理数据(3700篇论文)
│   └── localStorage 用户增删改持久化
├── 处理层
│   ├── 英文分词 + 停用词过滤(500+ 停用词)
│   ├── 关键词词频统计(Top 50)
│   └── 关键词共现对统计(Top 60 对)
├── 展示层
│   ├── 首页:统计卡片 + Top10 柱状图 + 关键词力导向图
│   ├── 走势页:年度折线图动画 + 年度热词堆叠图
│   ├── 列表页:论文表格(增删改查)
│   ├── 爬取页:单条检索 + 批量导入
│   └── 关于页:会议介绍 + 口径说明
└── 部署层
    └── 纯静态文件 → 华为云 ECS / OBS
关键设计决策
- 纯前端不做后端:作业允许"纯前端开发,数据写在代码中、持久化在 storage"。这样部署最简单,一个 Nginx 就能跑,也避免了数据库运维。
- 数据预拉取:OpenAlex API 在客户端直接调会有跨域问题,所以用 Python 脚本预拉成
papers.json(5.87MB),前端直接加载。 - localStorage 同步:用户的增删改存在
localStorage,key 为topviz_edits,结构为{added:[], deleted:[], edited:{}},加载时先应用删除、再应用编辑、最后合并新增。 - Vue 3 CDN 引入:不做打包构建,直接用 CDN 引入 Vue 3 和 ECharts,降低部署复杂度。
代码说明
1. 关键词提取(js/app.js)
const STOPWORDS = new Set(("the a an and or of for to ...").split(/\s+/));

function extractKeywords(text) {
  if (!text) return [];
  const words = text.toLowerCase().replace(/[^a-z0-9\s\-]/g, " ").split(/\s+/);
  const kws = [];
  for (let w of words) {
    w = w.replace(/^-+|-+$/g, "");
    if (w.length <= 3) continue;
    if (/^\d+$/.test(w)) continue;
    if (STOPWORDS.has(w)) continue;
    kws.push(w);
  }
  return kws;
}
思路:对标题+摘要做小写化、去标点、分词,过滤短词(≤3字母)、纯数字、停用词。一篇论文对一个关键词只计一次(在统计时用 counter 去重)。
2. 关键词共现与力导向图
const pair = {};
papers.value.forEach(p => {
  const kws = p.kws.filter(k => top.some(t => t.word === k));
  for (let i = 0; i < kws.length; i++)
    for (let j = i + 1; j < kws.length; j++) {
      const key = [kws[i], kws[j]].sort().join("|");
      pair[key] = (pair[key] || 0) + 1;
    }
});
// 取共现次数最高的 60 对作为连线
思路:双层循环统计同一篇论文里同时出现的关键词对,排序后取 top60 作为图的边。节点大小按词频缩放,颜色按 Top10 高亮。
3. 热度走势动画
function playTrend() {
  const years = Object.keys(kwByYearVenue.value).sort();
  let i = 0;
  drawTrendFrame(0);
  const timer = setInterval(() => {
    i++;
    if (i >= years.length) { clearInterval(timer); return; }
    drawTrendFrame(i);
  }, 900);
}
思路:用 setInterval 每 900ms 重画一次折线图,数据从"只到第一年"逐步扩展到"到第 i 年",形成动画效果。录屏后即可作为作业要求的"动图"。
4. 数据抓取脚本(Python)
def fetch_papers(source_id, conf, year, max_pages=20):
    papers = []
    for page in range(1, max_pages + 1):
        url = f"https://api.openalex.org/works?filter=primary_location.source.id:{source_id}&per-page=200&page={page}&select=..."
        data = http_get(url)
        for w in data["results"]:
            papers.append({
                "title": w["title"], "year": year, "venue": conf,
                "abstract": restore_abstract(w["abstract_inverted_index"]),
                ...
            })
    return papers
思路:OpenAlex 的摘要用倒排索引存储(abstract_inverted_index),需要按位置还原成正文。分页拉取,每页 200 条。
心路历程与收获
这次作业是我第一次真正和 AI 结对做一个完整的 Web 项目。最大的感受是:
- AI 是很好的"起步器":刚拿到需求时我毫无头绪,和 AI 聊了两轮 NABCD 后,页面结构和技术选型就清晰了。如果自己想,可能要纠结半天用 Vue 还是 React。
- AI 不能盲信:DBLP 被反爬那一段,AI 一开始只让我加 UA 和延时,但实际没用。最后是我自己换了 OpenAlex 并摸索出 source.id 筛选的方法。AI 给的方案往往是"教科书式"的,真实世界有各种坑。
- 代码审查能力很重要:AI 生成的 ECharts 配置我看着眼熟,但真要自己写也得查文档。关键是要能看懂每一行在干嘛,哪里有 bug(比如事件重复绑定、
nextTick被写成nextWatch),否则就是《构建之法》里说的"代码可以工作但没人知道为什么"。 - 数据比代码难:写前端只花了半天,但找数据、清洗数据、处理反爬花了更多时间。这让我理解了为什么说"数据工程是可视化的瓶颈"。
- Git 流程要规范:这次在 dev 分支开发、合并回 main、打 v1.0.0 tag,比第一次作业直接在 main 上提交有节奏感,也理解了为什么团队开发要用分支。
对 AI 结对伙伴的评价
优点:
- 响应快,不用等待,随叫随到;
- 对 ECharts、Vue 3 的 API 记得很熟,能直接给出可用配置;
- 能从不同角度给方案(比如同时建议 D3 和 ECharts);
- 写原型代码很快,改 Bug 也快。
局限:
- 幻觉:偶尔会编造不存在的 API 参数,需要自己查文档验证;
- 知识截止:对 2025 年的新会议数据不了解,OpenAlex 索引不全这种问题要自己实测;
- 不了解全局:AI 每次对话都是独立的,不记得上次改了什么,需要我把上下文重新贴一遍;
- 反爬/真实世界问题:AI 给的网络请求方案往往过于理想化,遇到 Anubis、CORS、限流等真实问题时,还是要自己排查。
总体评分:作为结对伙伴,AI 大概能承担 40%–50% 的编码工作,但需求判断、Bug 定位、架构决策还是得自己来。它更像一个"随叫随到、知识面广但偶尔说错"的师弟,而不是能依赖的资深工程师。和《构建之法》里讲的"两人结对"相比,AI 不会累、不会走神、不会有情绪,但也不会主动质疑你的方案、不会在你犯傻时拦你——最终的质量把关,永远在自己手里。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐

 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)