【论文阅读】Agent 记忆机制(50):PACE——按下一步预测价值动态分配历史记忆粒度
文章目录
- 前言
- 零、论文基本信息
- 一、问题:Long-Horizon Agent 为什么会被 Context 卡死?
- 二、为什么传统方案不够?
- 三、PACE 的核心洞察:Context Management = Next Step Prediction
- 四、PACE 整体架构
- 五、External Memory Store:压缩不等于删除
- 六、每个 Chunk 同时保存四种分辨率
- 七、为什么需要 Multi-Granularity?
- 八、最近两步为什么始终 Full?
- 九、Key Embedding
- 十、Predictive Attention
- 十一、Relative Weight
- 十二、Compression Pressure
- 十三、动态阈值
- 十四、四级 Adaptive Context Extraction
- 十五、最终 Context
- 十六、Glimpse:压缩错了怎么办?
- 十七、异步 Summary Generation
- 十八、复杂度
- 十九、实验设置
- 二十、主实验
- 二十一、关键结果
- 二十二、跨语言表现
- 二十三、有没有“没赢”的结果?
- 二十四、消融实验
- 二十五、最重要的是 Multi-Granularity
- 二十六、Low-Temperature Softmax 的作用
- 二十七、Pressure 不是装饰
- 二十八、Glimpse 的贡献
- 二十九、Figure 2:上下文增长
- 三十、任务越难优势越大
- 三十一、Ultra-Long Horizon Stress Test
- 三十二、4897 步不是默认最优配置
- 三十三、λ 的倒 U 型关系
- 三十四、Latency
- 三十五、真正的核心增量
- 三十六、与 HiAgent 的区别
- 三十七、与 Chain-of-Memory 的区别
- 三十八、与 ReMemR1 的区别
- 三十九、与 MAGMA 的区别
- 四十、与 APC / Mem²Evolve 的区别
- 四十一、对 Coding Agent 的启发
- 四十二、对 Tool Agent 的启发
- 四十三、一个更通用的抽象:Context 是有限资源
- 四十四、我的理解:Memory Importance 应该是动态的
- 四十五、Compression 应该可逆
- 四十六、局限性
- 四十七、可以怎样继续扩展?
- 四十八、放到整个 Agent Memory 系列里怎么看?
- 四十九、与最近几篇论文放在一起的理解
- 五十、总结
- 参考资料
前言
前面已经阅读了 A-MEM、MemoryOS、Nemori、MAGMA、HiAgent、Agentic Plan Caching、3DLLM-Mem、Mem²Evolve、Chain-of-Memory、ReMemR1 等不同方向的 Agent Memory 工作。
这些论文虽然都在讨论“记忆”,但解决的问题已经逐渐分化:
Mem0 / A-MEM
↓
长期记忆应该怎样增删改、怎样建立关联?

MemoryOS / Nemori
↓
长期记忆应该怎样分层、什么时候形成 Episode?

MAGMA
↓
语义 / 时间 / 因果 / 实体关系怎样组织和检索?

HiAgent
↓
Long-Horizon Task 中持续增长的 Working Memory 怎样压缩?

Chain-of-Memory
↓
检索出来的 Memory 怎样进一步组织成可推理的证据链?

ReMemR1
↓
已经被压缩的历史能不能在需要时重新回访?

Agentic Plan Caching / Mem²Evolve
↓
历史经验怎样进一步变成可复用计划或能力资产?
今天这篇 PACE: Predictive Adaptive Context Extraction for Long-Horizon LLM Agents 更接近 HiAgent、Context-Folding 和 ReMemR1 所处的:
Working Memory / Context Management
方向。
但它提出的问题非常具体:
一个 Long-Horizon Agent 运行几百、几千步以后,到底应该把哪些历史内容以“完整形式”留在当前 Context,又应该把哪些内容压缩成摘要,甚至只留下一个占位符?
传统方案通常在两个极端之间选择。
第一种是 Full History / ReAct,信息几乎不丢,但历史越来越长,Context Token 近线性增长,最终撞上 Context Window。
第二种是 Step-wise Summarization,虽然 Token 少了,但当前看起来“不重要”的信息,可能在几十步以后突然变得重要。
PACE 的核心思路是:
不要提前固定“什么历史值得保留”,而是在每一个 Agent Step 都重新预测:对于“下一步动作”而言,每段历史到底有多重要。
作者借用了 Transformer Attention 的直觉:
当前任务状态
↓
预测每个历史 Chunk 对下一步 Action 的相关性
↓
高相关:Full Text
中高相关:Detailed Summary
中低相关:Brief Summary
低相关:Placeholder
而且随着历史越来越长、Token Budget 越来越紧,系统会自动提高压缩门槛。
如果用一句话概括 PACE 的核心增量:
PACE 将 Long-Horizon Agent 的上下文管理重新表述为 Next Step Prediction:根据每段历史对“下一步动作”的预测相关性,动态选择 Full / Detailed / Brief / Placeholder 四级表示,并随着任务长度和 Context Budget 压力自动增强压缩,从而让有限 Context 始终优先保留当前真正有用的历史信息。
零、论文基本信息
- 论文名称:PACE: Predictive Adaptive Context Extraction for Long-Horizon LLM Agents
- 发表平台:ACL 2026 Main Conference,Long Papers
- 代码与数据:PACE-B000
- 作者信息:Lei Wei、Xiao Peng、TT、Guannan Zhang、Chenhao Jiang、Hongyu Li、Lanbo Lin、Yuanwu Xu、Jiayao Liu、Kesu Wang、Bin Wang;作者来自 Alibaba International Digital Commerce Group 与 Peking University
一、问题:Long-Horizon Agent 为什么会被 Context 卡死?
以 Web Agent 为例,一次复杂任务可能持续:
Search → Visit → Read → Reason → Search → Visit → Python → ...
每一步都会产生 Thought、Action、Observation 和 Tool Result。
完整历史:
H t = { ( a 1 , o 1 ) , ( a 2 , o 2 ) , … , ( a t − 1 , o t − 1 ) } H_t=\{(a_1,o_1),(a_2,o_2),\ldots,(a_{t-1},o_{t-1})\} Ht={(a1,o1),(a2,o2),…,(at−1,ot−1)}
传统 ReAct:
a t = π ( o t , H t ) a_t=\pi(o_t,H_t) at=π(ot,Ht)
但 ∣ H t ∣ |H_t| ∣Ht∣ 会随 t t t 增长。
论文希望构造压缩上下文:
∣ C t ∣ ≪ ∣ H t ∣ |C_t|\ll|H_t| ∣Ct∣≪∣Ht∣
同时:
P e r f o r m a n c e ( π ( o t , C t ) ) ≥ P e r f o r m a n c e ( π ( o t , H t ) ) Performance(\pi(o_t,C_t))\geq Performance(\pi(o_t,H_t)) Performance(π(ot,Ct))≥Performance(π(ot,Ht))
这意味着压缩不仅要省 Token,还希望通过过滤噪声提高决策质量。
二、为什么传统方案不够?
1. ReAct:全部保留
优势是信息完整,缺点是 Context 近线性增长,最终只能截断。
2. Summary Agent:统一压缩
持续累积摘要虽然控制 Token,但容易提前丢失未来才会变重要的细节。
3. Folding Agent:主动折叠
AgentFold / Context-Folding 更灵活,但通常要求模型额外学习 fold 行为,把任务求解与 Context Management 绑定。
PACE 希望 Context Manager 尽量与主 Agent 解耦。
三、PACE 的核心洞察:Context Management = Next Step Prediction
为了理解 PACE,最应该先看 Figure 1。
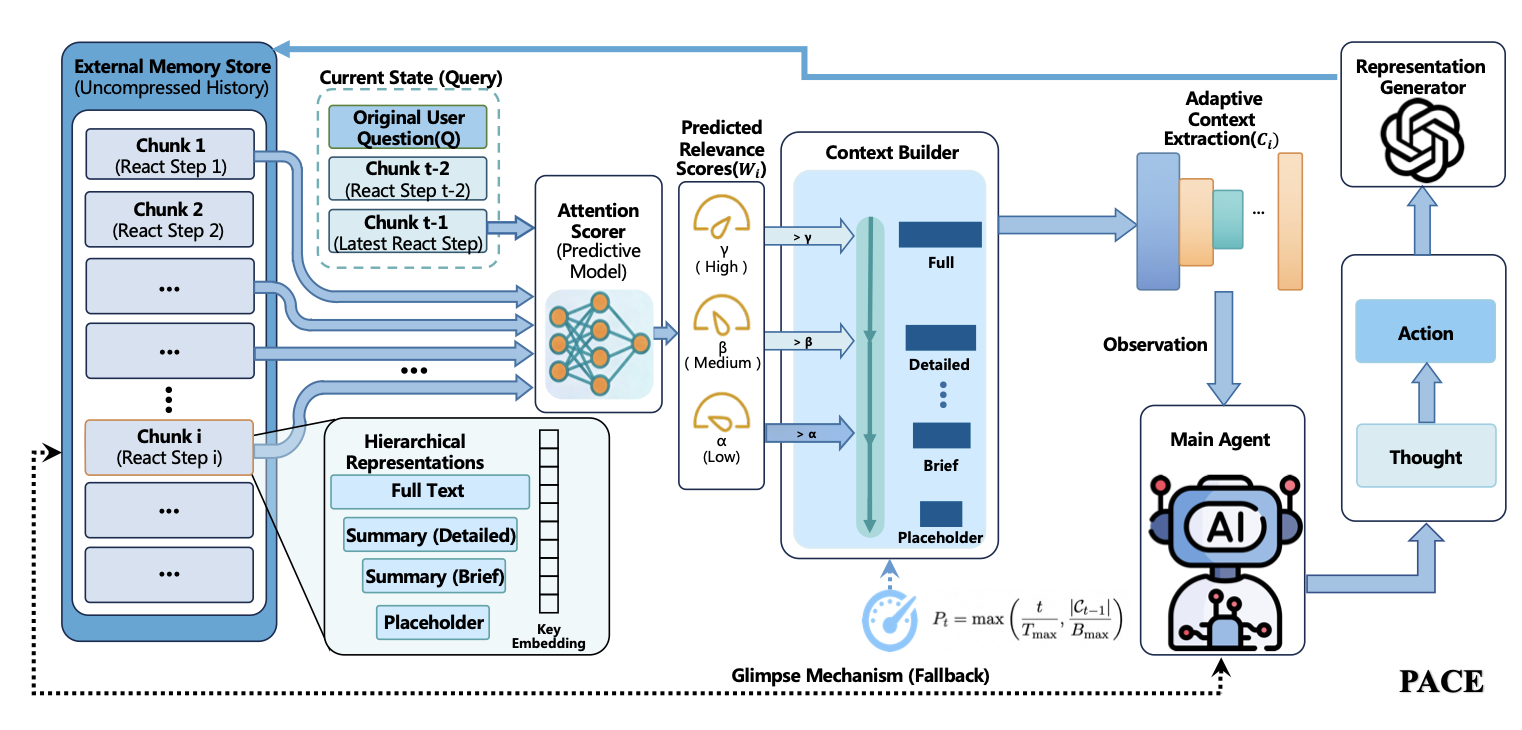
图源:Wei et al., 2026,Figure 1:An overview of our PACE framework.
External Memory Store 保存完整历史;Attention Scorer 根据当前 State 预测每个历史 Chunk 对下一步 Action 的相关性;Context Builder 再结合 Compression Pressure,为不同 Chunk 分配 Full / Detailed / Brief / Placeholder 四种粒度。
Transformer:
Query → Attention → Next Token
PACE:
Current State → Predictive Attention → Next Action Context
因此它问的是:
“这条历史对于我马上要做的下一步动作有多重要?”
四、PACE 整体架构
PACE 包括五个组件:
PACE
├── Main Agent
├── External Memory Store
├── Representation Generator
├── Attention Scorer
└── Context Builder
完整流程:
Step t Action/Observation
↓
写入 External Memory
↓
计算并缓存 Key Embedding
↓
异步生成 Detailed / Brief Summary
↓
进入 Step t+1
↓
Original Query + 最近 N 个完整 Step
↓
Current State Query
↓
Attention Scorer
↓
为旧 Chunk 打分
↓
结合 Compression Pressure
↓
选择不同表示粒度
↓
Adaptive Context
↓
Main Agent
另有 Glimpse 作为压缩错误时的恢复机制。
五、External Memory Store:压缩不等于删除
PACE 永远保留完整历史:
M t = { C h u n k 1 , … , C h u n k t − 1 } M_t=\{Chunk_1,\ldots,Chunk_{t-1}\} Mt={Chunk1,…,Chunkt−1}
所以:
External Memory = Long-Term Raw Storage
Current Context = Working Memory View
Full → Summary → Placeholder 只是当前视图降低分辨率,不是永久删除。
六、每个 Chunk 同时保存四种分辨率
每个 Chunk:
C h u n k i = { i d i , t y p e i , t i , R f u l l ( i ) , R d e t a i l e d ( i ) , R b r i e f ( i ) , R p h ( i ) , k i } Chunk_i=\{id_i,type_i,t_i,R^{(i)}_{full},R^{(i)}_{detailed},R^{(i)}_{brief},R^{(i)}_{ph},k_i\} Chunki={idi,typei,ti,Rfull(i),Rdetailed(i),Rbrief(i),Rph(i),ki}
四种表示:
Full
Detailed Summary
Brief Summary
Placeholder
这就像一张图片同时保存 4K / 1080P / 360P / Thumbnail。
PACE 不只决定“保留还是删除”,而决定:
当前这一轮应该用哪种分辨率查看这段历史。
七、为什么需要 Multi-Granularity?
例如:
Chunk 12:Company A Revenue = 12.7B
Chunk 36:Company B 投资者关系页面
Chunk 41:无关新闻
Chunk 97:最终任务要求比较 Revenue
到 Step 98:
Chunk 12 → Full
Chunk 36 → Detailed
Chunk 41 → Placeholder
Chunk 97 → Full
因此同一个 Context 内不同历史可以拥有不同信息密度。
八、最近两步为什么始终 Full?
论文设置:
N = 2 N=2 N=2
Current State:
R t = Q ⊕ ⨁ j = t − N t − 1 R f u l l ( j ) R_t=Q\oplus\bigoplus_{j=t-N}^{t-1}R^{(j)}_{full} Rt=Q⊕j=t−N⨁t−1Rfull(j)
然后:
q t = E n c ( T r u n c a t e ( R t , L m a x ) ) q_t=Enc(Truncate(R_t,L_{max})) qt=Enc(Truncate(Rt,Lmax))
所以相关性判断不仅看原始用户 Query,还看最近发生了什么。
九、Key Embedding
每个旧 Chunk:
k i = E n c ( T r u n c a t e ( R f u l l ( i ) , L m a x ) ) k_i=Enc(Truncate(R^{(i)}_{full},L_{max})) ki=Enc(Truncate(Rfull(i),Lmax))
Key 来自 Full Text,不是 Summary,避免摘要信息损失影响检索。
Key 在 Chunk 创建时计算一次并缓存。
十、Predictive Attention
旧 Chunk 相关性:
s i = cos ( q t , k i ) s_i=\cos(q_t,k_i) si=cos(qt,ki)
然后使用低温 Softmax:
w i = exp ( s i / τ ) ∑ j = 1 M exp ( s j / τ ) w_i=\frac{\exp(s_i/\tau)}{\sum_{j=1}^{M}\exp(s_j/\tau)} wi=∑j=1Mexp(sj/τ)exp(si/τ)
论文设:
τ = 0.3 \tau=0.3 τ=0.3
低温使分布更尖锐,明确拉开真正重要和不重要的历史。
十一、Relative Weight
因为 Softmax 总和为 1,历史越多每个权重绝对值越小,所以定义:
w ~ i = M ⋅ w i \tilde{w}_i=M\cdot w_i w~i=M⋅wi
于是平均值约为 1。 w ~ i > 1 \tilde{w}_i>1 w~i>1 可以理解为该 Chunk 相关性高于历史平均水平。
十二、Compression Pressure
论文定义:
P t = max ( t T m a x , ∣ C t − 1 ∣ B m a x ) P_t=\max\left(\frac{t}{T_{max}},\frac{|C_{t-1}|}{B_{max}}\right) Pt=max(Tmaxt,Bmax∣Ct−1∣)
其中 B m a x = 128 K B_{max}=128K Bmax=128K。
它同时考虑 Task Progress Pressure 和 Context Budget Pressure;任意一个危险,就增强压缩。
十三、动态阈值
基础阈值:
( α 0 , β 0 , γ 0 ) = ( 0.4 , 0.8 , 1.5 ) (\alpha_0,\beta_0,\gamma_0)=(0.4,0.8,1.5) (α0,β0,γ0)=(0.4,0.8,1.5)
动态调整:
α t = α 0 ( 1 + λ P t ) \alpha_t=\alpha_0(1+\lambda P_t) αt=α0(1+λPt)
β t , γ t \beta_t,\gamma_t βt,γt 同理,默认 λ = 0.5 \lambda=0.5 λ=0.5。
Pressure 越高,越难保留 Full / Detailed。
十四、四级 Adaptive Context Extraction
S e l e c t ( C h u n k i ) = { R f u l l ( i ) , w ~ i > γ t R d e t a i l e d ( i ) , β t < w ~ i ≤ γ t R b r i e f ( i ) , α t < w ~ i ≤ β t R p h ( i ) , w ~ i ≤ α t Select(Chunk_i)= \begin{cases} R^{(i)}_{full}, & \tilde w_i>\gamma_t\\ R^{(i)}_{detailed}, & \beta_t<\tilde w_i\le\gamma_t\\ R^{(i)}_{brief}, & \alpha_t<\tilde w_i\le\beta_t\\ R^{(i)}_{ph}, & \tilde w_i\le\alpha_t \end{cases} Select(Chunki)=⎩ ⎨ ⎧Rfull(i),Rdetailed(i),Rbrief(i),Rph(i),w~i>γtβt<w~i≤γtαt<w~i≤βtw~i≤αt
即:
非常相关 → Full
较相关 → Detailed
弱相关 → Brief
几乎无关 → Placeholder
这是 PACE 最核心的机制。
十五、最终 Context
C t = S y s ⊕ Q ⊕ ( ⨁ i = 1 M S e l i ) ⊕ ( ⨁ j = t − N t − 1 R f u l l ( j ) ) C_t=Sys\oplus Q\oplus\left(\bigoplus_{i=1}^{M}Sel_i\right)\oplus\left(\bigoplus_{j=t-N}^{t-1}R^{(j)}_{full}\right) Ct=Sys⊕Q⊕(i=1⨁MSeli)⊕ j=t−N⨁t−1Rfull(j)
所以 Main Agent 实际看到 System Prompt + Original Query + 自适应表示后的旧历史 + 最近两步完整历史。
十六、Glimpse:压缩错了怎么办?
如果某个历史只保留极简摘要,但 Agent 需要细节,可调用:
glimpse(chunk_id)
恢复 R f u l l R_{full} Rfull。每步最多 3 个 Glimpse,形成“自动压缩 + 按需恢复”。
十七、异步 Summary Generation
Detailed / Brief Summary 由 Gemini 2.5 Flash-Lite 异步生成,主 Agent 不等待 Summary。若 Summary 尚未生成,则按预算回退到 Full 或 Placeholder。
十八、复杂度
历史数 M = t − N − 1 M=t-N-1 M=t−N−1,Attention Scoring、Softmax 与 Threshold Selection 每步均为 O ( M ) O(M) O(M)。
十九、实验设置
六个 Benchmark:
| Benchmark | 能力 |
|---|---|
| BrowseComp | 复杂组合式 Web Browsing |
| BrowseComp-ZH | 中文 Web Browsing |
| WideSearch | 大范围信息搜索 |
| GAIA | 多步推理与工具使用 |
| xbench-DeepResearch | Deep Research |
| WebWalkerQA | Web Navigation QA |
四个 Backbone:
WebSailor-32B
tongyi-deepresearch-30B
DeepSeek-V3.1-671B
Claude-4-Sonnet
Baseline:ReAct、Summary Agent、Folding Agent。
二十、主实验

表源:Wei et al., 2026,Table 1:Performance comparison of context management methods across six benchmarks.
四种 Backbone、六个 Benchmark 中,PACE 都取得该模型下最佳结果。
| Model | Method | BrowseComp | BrowseComp-ZH | WideSearch | GAIA | xbench-DR | WebWalkerQA |
|---|---|---|---|---|---|---|---|
| WebSailor-32B | ReAct | 7.3 | 20.7 | 43.2 | 46.7 | 58.0 | 52.3 |
| Summary | 10.5 | 25.5 | 47.6 | 53.5 | 63.0 | 57.8 | |
| Folding | 11.3 | 26.8 | 49.5 | 55.1 | 65.0 | 60.2 | |
| PACE | 13.2 | 29.3 | 52.8 | 59.1 | 68.0 | 63.5 | |
| DeepSeek-V3.1-671B | ReAct | 25.8 | 44.3 | 54.8 | 58.3 | 66.0 | 56.4 |
| Summary | 30.0 | 49.2 | 59.3 | 63.0 | 71.0 | 61.2 | |
| Folding | 31.6 | 50.9 | 61.2 | 65.4 | 73.0 | 62.8 | |
| PACE | 35.1 | 54.8 | 65.7 | 69.3 | 74.0 | 66.5 | |
| tongyi-deepresearch-30B | ReAct | 38.2 | 41.6 | 52.7 | 64.6 | 69.0 | 66.8 |
| Summary | 43.4 | 46.7 | 57.8 | 70.1 | 75.0 | 72.2 | |
| Folding | 44.8 | 47.2 | 60.1 | 72.4 | 77.0 | 74.6 | |
| PACE | 47.6 | 51.2 | 64.2 | 74.0 | 81.0 | 78.1 | |
| Claude-4-Sonnet | ReAct | 11.4 | 27.2 | 58.4 | 65.2 | 62.0 | 57.9 |
| Summary | 12.2 | 29.1 | 62.0 | 68.5 | 65.0 | 61.7 | |
| Folding | 14.5 | 28.3 | 64.0 | 70.1 | 69.0 | 60.9 | |
| PACE | 17.8 | 32.6 | 67.0 | 76.4 | 72.0 | 65.8 |
二十一、关键结果
tongyi-deepresearch-30B + xbench-DeepResearch:
Folding:77.0
PACE:81.0
+4.0 个百分点
Claude-4-Sonnet + GAIA:
Folding:70.1
PACE:76.4
+6.3 个百分点
说明即使 Main Agent 已经很强,Context Management 仍可能限制模型真实能力。
二十二、跨语言表现
DeepSeek + BrowseComp-ZH:
50.9 → 54.8
tongyi-deepresearch:
47.2 → 51.2
方法在中文和英文任务上都有效。
二十三、有没有“没赢”的结果?
主实验 Table 1 中,PACE 在全部 4×6 个 Backbone–Benchmark 组合中都是最高,因此不存在同配置 Baseline 超过 PACE 的情况。
但这不意味着“压得越狠越好”。后续 λ 实验显示,更 aggressive 的压缩能延长 Session,却会降低标准任务成功率。
二十四、消融实验

表源:Wei et al., 2026,Table 2:Ablation study showing the contribution of each PACE component.
去掉 Multi-Granularity 后下降最大,说明“相关性决定信息粒度”才是核心,而不是单纯 Dense Retrieval。
| Configuration | BrowseComp | BrowseComp-ZH | WideSearch | GAIA |
|---|---|---|---|---|
| PACE Full | 47.6 | 51.2 | 64.2 | 74.0 |
| w/o Multi-gran. | 42.3 | 45.5 | 55.9 | 68.5 |
| w/o Pressure | 43.9 | 46.4 | 58.4 | 70.9 |
| w/o Softmax | 43.1 | 46.0 | 56.7 | 69.3 |
| w/o Glimpse | 44.2 | 47.5 | 59.3 | 71.7 |
| Folding Agent | 44.8 | 47.2 | 60.1 | 72.4 |
二十五、最重要的是 Multi-Granularity
去掉它:
BrowseComp:-5.3
BrowseComp-ZH:-5.7
WideSearch:-8.3
GAIA:-5.5
因此 PACE 不是“给历史做 BGE 打分”,而是:
Score → Granularity Allocation
二十六、Low-Temperature Softmax 的作用
w/o Softmax:
WideSearch:64.2 → 56.7
GAIA:74.0 → 69.3
说明过于平滑的权重无法形成有效 Selective Compression。
二十七、Pressure 不是装饰
固定阈值:
GAIA:74.0 → 70.9
BrowseComp-ZH:51.2 → 46.4
意味着第 20 步和第 200 步不能用同一 Compression Policy。
二十八、Glimpse 的贡献
去掉 Glimpse 的下降约为 2.3~4.9 个百分点。贡献相对最小,但提供 Recoverability。
二十九、Figure 2:上下文增长
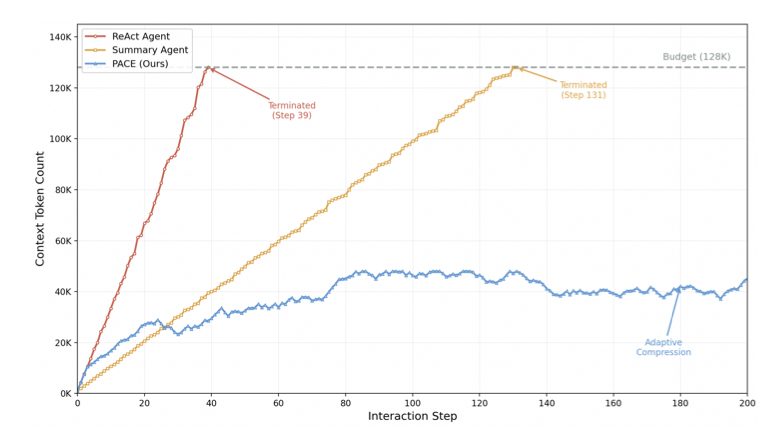
图源:Wei et al., 2026,Figure 2:Context token usage over interaction steps on GAIA Level 3 tasks (128K budget).
ReAct 和 Summary 持续上涨直至撞上 128K;PACE 在约 20 步后进入受控增长状态。
ReAct:Step 39 → 128K → Terminate
Summary:Step 131 → 128K → Terminate
PACE:Step 200 → 45.1K → 仍可继续
PACE:
Step 20:27.1K
Step 200:45.1K
Interaction 10×,Context 仅 1.7×。
在 Step 39:
ReAct:128K
PACE:28.5K
减少约 78%。
Step 131:
Summary:128K
PACE:48K
减少约 63%。
三十、任务越难优势越大

表源:Wei et al., 2026,Table 3:Success Rate (%) across GAIA difficulty levels.
PACE 在简单 Level 1 上优势有限,但随着 Long-Horizon Planning 和 Multi-Tool Coordination 增强,优势明显扩大。
Claude-4-Sonnet:
| Method | Level 1 | Level 2 | Level 3 |
|---|---|---|---|
| ReAct | 83.3 | 59.1 | 42.1 |
| Summary | 83.3 | 63.6 | 47.4 |
| Folding | 85.7 | 63.6 | 52.6 |
| PACE | 88.1 | 71.2 | 63.2 |
相对 Folding:
Level 1:+2.4
Level 2:+7.6
Level 3:+10.6
相对 ReAct 的 Level 3:+21.1 个百分点。
三十一、Ultra-Long Horizon Stress Test
作者把 GAIA Level 2 + Level 3 所有问题拼成连续 Meta-Task,使用 Gemini 2.5 Pro 和 256K Context Budget。
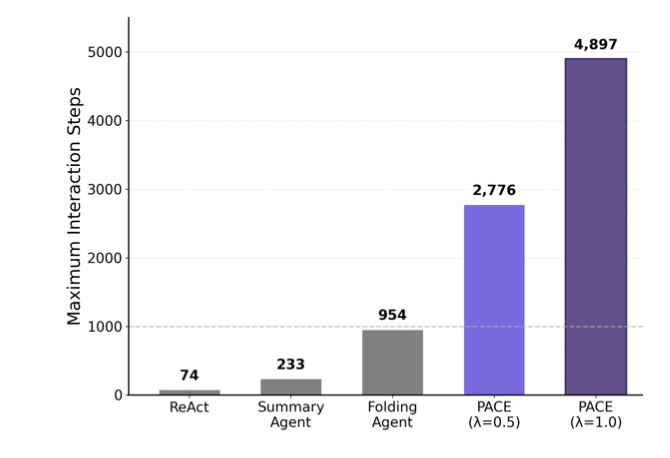
图源:Wei et al., 2026,Figure 3:Operational longevity comparison in the ultra-long-horizon stress test (256K context budget).
该图验证的是连续 Session 在 Context 被耗尽前可维持的最大 Interaction Steps。
结果:
ReAct:74
Summary:233
Folding:954
PACE λ=0.5:2776
PACE λ=1.0:4897
重新计算:
4897 / 74 ≈ 66.2×
4897 / 954 ≈ 5.1×
2776 / 954 ≈ 2.9×
2776 / 74 ≈ 37.5×
均与论文报告一致。
三十二、4897 步不是默认最优配置
主实验默认 λ = 0.5 \lambda=0.5 λ=0.5,Stress Test 的 4897 步使用 λ = 1.0 \lambda=1.0 λ=1.0。
但正常 GAIA:
λ=0.5:74.0
λ=1.0:71.7
所以更强压缩换来更长寿命,却损失 Accuracy。这体现的是 Performance–Longevity Trade-off。
三十三、λ 的倒 U 型关系
| λ | BrowseComp | BrowseComp-ZH | WideSearch | GAIA | xbench-DR | WebWalkerQA |
|---|---|---|---|---|---|---|
| 0.0 | 42.8 | 46.1 | 58.9 | 70.9 | 76.0 | 73.5 |
| 0.3 | 45.5 | 49.0 | 62.1 | 72.4 | 79.0 | 76.1 |
| 0.5 | 47.6 | 51.2 | 64.2 | 74.0 | 81.0 | 78.1 |
| 0.7 | 46.2 | 49.5 | 62.6 | 73.2 | 79.0 | 76.6 |
| 1.0 | 44.3 | 47.6 | 60.5 | 71.7 | 78.0 | 74.8 |
太小压缩不够,太大信息丢失,0.5 是总体最佳平衡。
三十四、Latency
Appendix Table 4:
| Method | Avg. Latency |
|---|---|
| ReAct | 47.63 s/step |
| Summary | 56.71 s/step |
| PACE | 48.08 s/step |
PACE 比 ReAct 只多 0.45 s/step,约 0.9%;Summary 比 ReAct 高约 19.1%。原因是 PACE 的摘要异步生成,而 Scoring 主要是本地向量计算。
三十五、真正的核心增量
如果只写:
BGE-M3 + Summary + Threshold + Glimpse
会把论文写偏。
真正的变化是:
Static Importance
↓
Predictive Relevance
以及:
Retrieve / Drop
↓
Full / Detailed / Brief / Placeholder
因此更准确的定位是:
Predictive Working-Memory Allocation。
三十六、与 HiAgent 的区别
HiAgent:
Subgoal Boundary
↓
已完成子目标 Summary
当前子目标 Full
是 Structure-Driven Compression。
PACE:
Next-Step Relevance
↓
动态决定每条历史 Granularity
是 Prediction-Driven Compression。
三十七、与 Chain-of-Memory 的区别
CoM:
Top-K → Memory Chain
关注证据组织。
PACE:
History → Granularity Allocation
关注 Context Budget 如何分配。
两者可以组合:PACE 先决定看多详细,CoM 再决定证据怎样成链。
三十八、与 ReMemR1 的区别
ReMemR1 让历史可回访;PACE 每一步主动重建最合适的 Context,并用 Glimpse 兜底。
PACE:Proactive Context Reconstruction
ReMemR1:Reactive Memory Revisiting
三十九、与 MAGMA 的区别
MAGMA:
Semantic / Temporal / Causal / Entity
↓
Relation-Aware Retrieval
PACE:
Semantic Relevance + Current State
↓
Granularity-Aware Context Curation
四十、与 APC / Mem²Evolve 的区别
APC 保存 Plan Template,用于跨任务 Procedure Reuse;Mem²Evolve 保存 Asset + Experience,用于 Capability Evolution。
PACE 不解决跨任务学习,而解决同一条 Long-Horizon Trajectory 中当前 Working Context 应该长什么样。
所以它更适合归类为:
Working Memory / Context Policy。
四十一、对 Coding Agent 的启发
Coding Agent 的长历史可能包含:
用户需求
grep
cat
文件内容
代码修改
pytest
报错
重新修改
git diff
...
当前正在修 tests/test_auth.py 时,可以动态分配:
早期 auth.py 源码 → Full
无关 README → Placeholder
login() 修改 → Detailed
最近 AssertionError → Full
npm install 日志 → Brief
这比“全部留下”或“统一摘要”都更符合当前 Debug Goal。
四十二、对 Tool Agent 的启发
很多 Memory 系统只有:
Retrieve? Yes / No
PACE 提醒我们,Memory 可以有:
Full
Detailed
Brief
Pointer
多级显示粒度。
实际系统可以为一条 Tool Trace 同时保存:
{
  "raw": "...",
  "detailed": "...",
  "brief": "...",
  "pointer": "...",
  "embedding": "..."
}
再根据 Current Goal 动态选择。
四十三、一个更通用的抽象:Context 是有限资源
设 Token Budget 为 B B B,历史 Memory 为 m 1 , … , m n m_1,\ldots,m_n m1,…,mn,每条 Memory 可以选择:
g i ∈ { f u l l , d e t a i l e d , b r i e f , p o i n t e r } g_i\in\{full,detailed,brief,pointer\} gi∈{full,detailed,brief,pointer}
问题可以抽象为:
max ∑ i U t i l i t y ( m i , g i ∣ s t a t e t ) \max \sum_i Utility(m_i,g_i\mid state_t) maxi∑Utility(mi,gi∣statet)
满足:
∑ i C o s t ( g i ) ≤ B \sum_i Cost(g_i)\le B i∑Cost(gi)≤B
PACE 用 Predictive Relevance + Threshold + Pressure 实现了一个轻量近似解。
这个公式不是论文原公式,而是我认为更适合工程理解的一层抽象。
四十四、我的理解:Memory Importance 应该是动态的
传统系统常写:
Memory A importance = 0.9
Memory B importance = 0.3
PACE 说明更合理的是:
I m p o r t a n c e ( m , t ) Importance(m,t) Importance(m,t)
因为同一段历史可能:
Step 20:几乎没用
Step 100:突然成为关键证据
Step 150:再次失去作用
Memory 的价值依赖 Current State,而不是一个永久固定的分数。
四十五、Compression 应该可逆
PACE 的原则可以概括成:
Compress the View, not the Source。
原始 Memory 永远留在 External Store;Working Context 可以压缩。一旦 Prediction 错误:
Glimpse → Full
这和 ReMemR1、HiAgent 的 Detail Recovery 可以统一为:
长期 Memory Compression 最好是可恢复的,而不是不可逆删除。
四十六、局限性
1. Semantic Similarity 不等于真正的 Next-Step Utility
Attention Scorer 依赖 Semantic Similarity,但真正的依赖可能来自:
Causal
Temporal
Tool Dependency
Constraint
Negation
因此论文所谓 Predictive Attention,严格来说仍然是 Semantic Relevance Proxy。
2. Summary Model 固定
Detailed / Brief 都由固定 Gemini 2.5 Flash-Lite 生成。
Coding Agent 可能更需要保留 Error Code / Function Name,Research Agent 更需要 Citation / Date / Source。未来更合理的是 Task-Aware Summary Generator。
3. External Memory 仍会增长
PACE 控制的是 Current Context,不是 External Storage。
真正 Lifelong Agent 仍然需要:
Merge
Archive
Eviction
Deduplication
Versioning
4. O(M) 最终也会变大
如果 M = 100000 M=100000 M=100000,每一步扫描全部 Key 仍然有成本。未来可以考虑 ANN Index 或 Hierarchical Retrieval。
5. 4897 步不是一个自然单任务的 4897 步因果推理
Stress Test 是把 GAIA Level 2 + Level 3 多个问题串成一个 Meta-Task。
所以更准确的表述是:
PACE 在 256K Context Budget 下维持了 4897 次连续 Agent Interaction。
而不是“完成一个自然的 4897-step reasoning task”。
6. Aggressive Compression 有成功率代价
λ = 1.0 \lambda=1.0 λ=1.0 显著拉长寿命,却降低标准任务成功率。
真实系统必须权衡:
Accuracy
vs
Longevity
四十七、可以怎样继续扩展?
1. Relation-Aware Attention
把 Semantic Similarity 扩展为:
Semantic
+
Temporal
+
Causal
+
Tool Dependency
可以吸收 MAGMA 的思想。
2. Learned Granularity Policy
当前依赖阈值规则。未来可以直接学习:
某个 State 下,每条 Memory 应该分配多少 Token。
3. Uncertainty-Aware Glimpse
根据 Scorer Uncertainty 或 Summary Confidence 自动决定是否恢复 Full。
4. Task Boundary + Predictive Granularity
结合 HiAgent / Nemori 的 Subgoal / Episode Boundary 与 PACE 的 Granularity Policy。
四十八、放到整个 Agent Memory 系列里怎么看?
                         Agent Memory
                              │
      ┌───────────────────────┼───────────────────────┐
      ↓                       ↓                       ↓
 Long-Term Memory        Working Memory         Experience Memory
      │                       │                       │
      ↓                       ↓                       ↓
Mem0 / A-MEM             HiAgent / PACE          APC / Mem²Evolve
MAGMA / Nemori           ReMemR1
      │                       │
      ↓                       ↓
“过去存什么?”           “现在看什么?”
PACE 最明确的位置是:
Working Memory / Context Management。
它回答:
External Memory 已经很多
↓
当前这一轮到底应该看哪些?
↓
每条应该看多详细?
四十九、与最近几篇论文放在一起的理解
Long-Horizon Context Management 可以进一步拆成四个问题:
1. Boundary
什么时候应该压缩?
→ HiAgent / Nemori

2. Retrieval
应该找回哪些历史?
→ MAGMA / CoM / ReMemR1

3. Granularity
找回以后应该保留多详细?
→ PACE

4. Recovery
压缩错了以后能不能恢复?
→ ReMemR1 / PACE Glimpse
PACE 最独特的就是第三项:
Granularity Policy。
五十、总结
PACE 解决 Long-Horizon Agent 中非常实际的系统问题:
如何在有限 Context Window 中持续保留“下一步真正需要”的历史信息?
传统 ReAct 全量保留导致 Overflow;Summary 统一压缩导致重要细节过早丢失;Folding 更灵活但通常需要额外学习 Context Management Policy。
PACE 将问题重新定义为:
Next Step Prediction。
完整流程:
历史 Action-Observation
↓
External Memory Store
↓
每个 Chunk 保存 Full / Detailed / Brief / Placeholder
↓
当前 Query + 最近两步
↓
Query Embedding
↓
与历史 Cached Key Embedding 比较
↓
Low-Temperature Softmax
↓
Relative Relevance Weight
↓
Task Progress + Context Budget
↓
Compression Pressure
↓
动态提高 α / β / γ
↓
每个历史 Chunk 选择不同粒度
↓
Adaptive Context
↓
Main Agent
如果压缩过度:
glimpse(chunk_id) → Full History
实验中,PACE 在 6 个 Benchmark × 4 个 Backbone 的所有主实验组合中都取得最佳结果。
消融表明 Multi-Granularity Representation 是最重要模块,去掉后下降 5.3~8.3 个百分点。
Context Growth 实验:
ReAct:39 steps → 128K
Summary:131 steps → 128K
PACE:200 steps → 45.1K
Ultra-Long-Horizon Stress Test:
ReAct:74
Summary:233
Folding:954
PACE λ=0.5:2776
PACE λ=1.0:4897
最大达到 66.2× ReAct、5.1× Folding 的连续 Session Operational Longevity。
但 λ = 1.0 \lambda=1.0 λ=1.0 会牺牲标准任务成功率,因此真正问题仍是信息保真与运行寿命之间的动态权衡。
从 Agent Memory 的角度,这篇论文最值得记住的不是“Context Compression”,而是:
同一条 Memory 不应该始终拥有固定的信息粒度。它在当前 Working Context 中应该占用多少 Token,应当取决于它对当前 Agent State 和下一步行为的即时价值。
如果用一句话概括 PACE:
PACE 将 Long-Horizon Agent 的上下文管理从“统一保留或统一压缩历史”升级为“按下一步预测价值动态分配记忆分辨率”:重要历史保留 Full Detail,次要历史逐级压成 Detailed / Brief / Placeholder,并随 Context Pressure 自动增强压缩,在必要时再通过 Glimpse 恢复原始细节,从而用有限 Context 支撑数千步 Agent 运行。
参考资料
- Wei L, Peng X, TT, et al. PACE: Predictive Adaptive Context Extraction for Long-Horizon LLM Agents. ACL, 2026.
- PACE Code & Data

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐

 19
 0
- 0


 已为社区贡献2条内容

所有评论(0)