fetch+readablestream(Streamable)流式输出
流程图
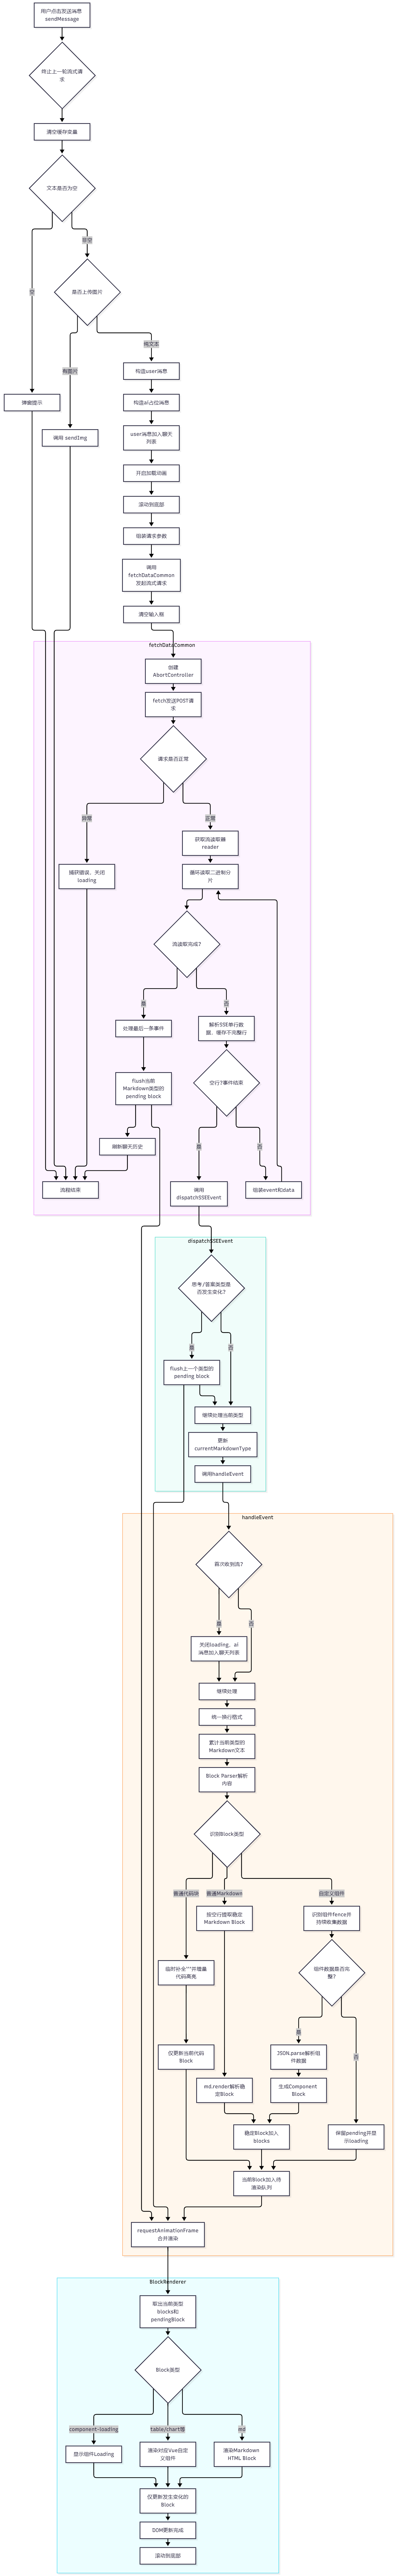
代码
data字段
// ================================
// data 中增加md文本
// ================================
data() {
  return {
    transcript: "",
    isThinking: false,
    renderTimer: null,
    chats: [],
    historyId: "",
    uploadImgUrl: "",
    textarea: "",
    textareaHeight: 3,
    return {
    // ================================
    // 两种 SSE 类型分别维护自己的 Block 状态
    // ================================
    markdownStates: {
      思考: {
        // 当前还没有被解析成稳定 Block 的原始 Markdown
        source: "",

        // 已经确认不会再变化的 Block
        // 每个 Block 只解析一次
        blocks: [],

        // 当前正在生成的 Block
        // 可能是 md,也可能是 component-loading
        pendingBlock: null,
      },

      答案: {
        source: "",
        blocks: [],
        pendingBlock: null,
      },
    },

    // ================================
    // RAF 调度
    // ================================
    renderRafId: null,

    // 哪些类型需要重新渲染
    pendingRenderTypes: new Set(),

    // ================================
    // 当前 SSE 请求
    // ================================
    streamAbortController: null,

    // 当前正在接收:
    // 思考 / 答案
    currentMarkdownType: null,
  };
}
组件注册
import TableBlock from "@/components/chat/TableBlock.vue";
import ChartBlock from "@/components/chat/ChartBlock.vue";

// ================================
// 自定义 AI Block 类型
//
// ```table
// {...}
// ```
//
// 会进入这里,而不是走 Markdown
// ================================
const COMPONENT_REGISTRY = {
  table: TableBlock,
  chart: ChartBlock,
};
sendMessage发送消息
sendMessage() {
  // ===== 新增:终止上一条还在跑的流式请求 =====
  if (this.streamAbortController) {
    this.streamAbortController.abort();
    this.streamAbortController = null;
  }
  // 清理上一轮定时器
  clearTimeout(this.renderTimer);
  this.renderTimer = null;

  // 重置流式缓存变量
  this.transcript = "";
  this.answerBuffer = "";
  this.thinkingBuffer = "";
  this.thinkingCompleteMarkdown = "";
  this.answerCompleteMarkdown = "";
  this.isForceRendering = false;

  let id = this.chats.length;
  if (this.isTextEmpty) {
    this.$message.error("还没说呢");
    return;
  } else {
    if (this.uploadImgUrl !== "") {
      this.sendImg();
    } else {
      let message = {
        id: id,
        type: "user",
        avatar: this.$store.state.avatarImageUrl,
        thinking: "",
        answer: "",
        content: this.textarea,
        imgUrl: "",
        modules: [],
      };

      const aiMessage = {
        id: id + 1,
        type: "assistant",
        avatar:
          "https://oss-mtc.oss-cn-hangzhou.aliyuncs.com/2c927a761478a4a4248706b534bac146.gif",
        // ================================
        // 思考区域
        // ================================
        thinkingBlocks: [],

        // 当前正在生成的思考 Block
        thinkingPending: null,

        // ================================
        // 答案区域
        // ================================
        answerBlocks: [],

        // 当前正在生成的答案 Block
        answerPending: null,
        content: "",
        imgUrl: "",
        modules: [],
      };

      this.chats.push(message);
      this.isThinking = true;
      this.$nextTick(() => {
        const chatContainer = this.$refs.cultureBox;
        if (chatContainer) {
          chatContainer.scrollTop = chatContainer.scrollHeight;
        }
      });

      const url = `${this.$baseUrl}agent/chat`;
      const chatAto = {
        message: message.content,
        historyId: this.historyId,
      };

      this.fetchData2(url, chatAto, aiMessage);

      setTimeout(() => {
        this.getHistoryId();
      }, 500);

      this.textarea = "";
      this.transcript = "";
      this.textareaHeight = 3;
      this.uploadImgUrl = "";
    }
  }
},
fetchData2包装请求
async fetchData2(url, data, aiMessage) {
  return this.fetchDataCommon(url, data, aiMessage, {
    "Content-Type": "application/json",
  });
},
fetchDataCommon发送请求
// ================================
// fetchDataCommon
// ================================
async fetchDataCommon(url, data, aiMessage, headers) {
  let isStreamComplete = false;
  let reader = null;

  const abortController = new AbortController();

  this.streamAbortController = abortController;

  try {
    const response = await fetch(url, {
      method: "POST",

      headers: {
        ...headers,
        token: `${this.$store.state.token}`,
      },

      body:
        typeof data === "object" && !(data instanceof FormData)
          ? JSON.stringify(data)
          : data,

      signal: abortController.signal,
    });

    if (!response.ok) {
      throw new Error(`HTTP error! status: ${response.status}`);
    }

    if (!response.body) {
      throw new Error("当前环境不支持 ReadableStream");
    }

    reader = response.body.getReader();

    const decoder = new TextDecoder("utf-8");

    // SSE 行缓冲
    let buffer = "";

    // 当前 SSE event
    let currentEvent = {
      name: null,
      data: [],
    };

    while (true) {
      const { done, value } = await reader.read();

      // ================================
      // 整个 HTTP Stream 结束
      // 注意:不是一个 SSE event 结束
      // ================================
      if (done) {
        buffer += decoder.decode();

        const lines = buffer.split(/\r?\n/);

        buffer = "";

        for (const line of lines) {
          this.handleSSELine(
            line,
            currentEvent,
            aiMessage
          );
        }

        // 如果最后一个 event 没有空行结束
        // 这里也要主动 dispatch
        if (currentEvent.name) {
          this.dispatchSSEEvent(
            currentEvent,
            aiMessage
          );

          currentEvent = {
            name: null,
            data: [],
          };
        }

        isStreamComplete = true;

        break;
      }

      // ================================
      // 将二进制数据解码成字符串
      // ================================
      buffer += decoder.decode(value, {
        stream: true,
      });

      const lines = buffer.split(/\r?\n/);

      // 最后一项可能是不完整的一行
      // 留到下一次 read
      buffer = lines.pop();

      for (const line of lines) {
        this.handleSSELine(
          line,
          currentEvent,
          aiMessage
        );
      }
    }
  } catch (error) {
    if (error.name === "AbortError") {
      console.log("流式请求被手动终止");
    } else {
      console.error("请求出错:", error);

      this.$message.error(
        "回答异常中断,请稍后重试!"
      );
    }

    this.isThinking = false;
    this.streamAbortController = null;
  } finally {
    if (reader) {
      try {
        reader.releaseLock();
      } catch (e) {
        console.warn("释放 reader 失败:", e);
      }

      reader = null;
    }

    // ================================
    // 整个 SSE Stream 完成
    // 只 flush 当前最后一个类型
    // ================================
    if (isStreamComplete) {
      if (this.currentMarkdownType) {
        this.flushMarkdown(
          this.currentMarkdownType
        );
      }

      this.isThinking = false;
      this.streamAbortController = null;

      // 当前请求结束
      this.currentMarkdownType = null;

      this.$nextTick(() => {
        this.getHistory();
      });
    }
  }
},
handleSSELine处理SSE每行数据
// ================================
// SSE 解析
// ================================
handleSSELine(line, currentEvent, aiMessage) {
  // 空行代表一个 SSE event 结束
  if (line === "") {
    if (currentEvent.name) {
      this.dispatchSSEEvent(
        currentEvent,
        aiMessage
      );
    }

    currentEvent.name = null;
    currentEvent.data = [];

    return;
  }

  // event: 思考
  if (line.startsWith("event:")) {
    currentEvent.name = line
      .slice(6)
      .trim();

    return;
  }

  // data: xxx
  //
  // 一个 SSE event 可以存在多个 data 行
  if (line.startsWith("data:")) {
    currentEvent.data.push(
      line
        .slice(5)
        .replace(/^ /, "")
    );
  }
},
dispatchSSEEvent分发事件
dispatchSSEEvent(currentEvent, aiMessage) {
  const data = currentEvent.data.join("\n");

  if (!data) {
    return;
  }

  const nextType = currentEvent.name;

  // 只处理我们关心的 Markdown 类型
  if (
    nextType !== "思考" &&
    nextType !== "答案"
  ) {
    return;
  }

  /**
   * Markdown 类型发生切换:
   *
   * 思考
   *  ↓
   * 答案
   *
   * 说明“思考”已经结束。
   *
   * 此时不能等整个 SSE 流结束,
   * 应该立即把“思考”最后还没有形成稳定 block
   * 的 pendingMarkdown 提交掉。
   */
  if (
    this.currentMarkdownType &&
    this.currentMarkdownType !== nextType
  ) {
    this.flushMarkdown(
      this.currentMarkdownType
    );
  }

  // 更新当前 Markdown 类型
  this.currentMarkdownType = nextType;

  this.handleEvent(
    {
      name: nextType,
      data,
    },
    aiMessage
  );
},
handleEvent处理分片,增量解析
// ================================
// SSE Event → Block Parser
// ================================
handleEvent(event, aiMessage) {
  // ================================
  // 第一次收到 AI 数据
  // 关闭 loading,并把 AI 消息加入聊天列表
  // ================================
  if (this.isThinking) {
    this.isThinking = false;

    this.chats.push(aiMessage);
  }

  if (
    event.name !== "思考" &&
    event.name !== "答案"
  ) {
    return;
  }

  const state =
    this.markdownStates[event.name];

  if (!state) {
    return;
  }

  // ================================
  // SSE 数据可能携带转义换行
  // ================================
  const normalizedData = event.data
    .replace(/\\n/g, "\n")
    .replace(/\r\n/g, "\n")
    .replace(/\r/g, "\n");

  // ================================
  // 累计当前还未形成稳定 Block 的文本
  // ================================
  state.source += normalizedData;

  // ================================
  // 尝试提取稳定 Block
  // ================================
  this.extractStableBlocks(
    event.name
  );

  // ================================
  // 当前类型需要更新
  // ================================
  this.pendingRenderTypes.add(
    event.name
  );

  // ================================
  // RAF 合并更新
  // ================================
  this.scheduleMarkdownRender();
},
extractStableBlocks划分动静态块
// ================================
// 提取稳定 Block
//
// source:
//
//   已完成 Block
//   已完成 Block
//   当前正在生成 Block
//
// 只把前面的稳定 Block 固化。
// ================================
extractStableBlocks(type) {
  const state =
    this.markdownStates[type];

  const markdown = state.source;

  if (!markdown) {
    return;
  }

  const result =
    this.parseBlocks(markdown);

  // ================================
  // 把已经确定不会再变化的 Block
  // 放入 blocks[]
  // ================================
  if (result.stable.length > 0) {
    state.blocks.push(
      ...result.stable
    );
  }

  // ================================
  // 剩余部分继续等待
  // ================================
  state.source = result.pending;

  // 当前 pending block
  state.pendingBlock =
    result.pendingBlock;
},
parseBlocks解析块
这里同时处理:
- 普通 Markdown
- 普通代码块
- 自定义组件
// ================================
// Block Parser
//
// 返回:
//
// stable:
//   已经可以永久固化的 Block
//
// pending:
//   当前还不能确定结束的原始文本
//
// pendingBlock:
//   当前正在展示的 Block
// ================================
parseBlocks(markdown) {
  const lines = markdown.split("\n");

  const stable = [];

  let current = [];

  let inFence = false;
  let fenceChar = null;
  let fenceLength = 0;
  let fenceLang = "";

  for (let i = 0; i < lines.length; i++) {
    const line = lines[i];

    // ================================
    // 当前正在 fenced block 中
    // ================================
    if (inFence) {
      current.push(line);

      const closeMatch =
        this.matchClosingFence(
          line,
          fenceChar,
          fenceLength
        );

      if (closeMatch) {
        // ================================
        // 当前 fence 完整结束
        // ================================
        const blockText =
          current.join("\n");

        // 自定义组件
        if (
          COMPONENT_REGISTRY[fenceLang]
        ) {
          const componentBlock =
            this.parseComponentBlock(
              fenceLang,
              blockText
            );

          if (componentBlock) {
            stable.push(
              componentBlock
            );
          } else {
            // JSON 非法
            stable.push({
              type: "component-error",
              component: fenceLang,
              data: {
                raw: this.extractFenceBody(
                  blockText
                ),
              },
            });
          }
        } else {
          // ================================
          // 普通 Markdown 代码块
          //
          // 仍然交给 md.render()
          // ================================
          stable.push({
            type: "md",
            html: this.md.render(
              blockText
            ),
          });
        }

        current = [];

        inFence = false;
        fenceChar = null;
        fenceLength = 0;
        fenceLang = "";

        continue;
      }

      // 当前还在代码块里
      continue;
    }

    // ================================
    // 当前不在 fence 中
    //
    // 检测 ```javascript
    // 检测 ```table
    // ================================
    const openMatch =
      this.matchOpeningFence(line);

    if (openMatch) {
      // 先处理 fence 前面的普通 Markdown
      if (current.length > 0) {
        const text =
          current.join("\n");

        // 当前行之前如果已经遇到空行,
        // 前面的内容已经可以作为稳定 Block。
        if (text.trim()) {
          stable.push({
            type: "md",
            html: this.md.render(text),
          });
        }

        current = [];
      }

      inFence = true;

      fenceChar =
        openMatch.char;

      fenceLength =
        openMatch.length;

      fenceLang =
        openMatch.lang;

      current.push(line);

      continue;
    }

    // ================================
    // 普通 Markdown
    // ================================
    current.push(line);

    // ================================
    // 空行作为 Markdown Block 边界
    // ================================
    if (line.trim() === "") {
      const blockText =
        current.join("\n");

      if (blockText.trim()) {
        stable.push({
          type: "md",
          html: this.md.render(
            blockText
          ),
        });
      }

      current = [];
    }
  }

  // ================================
  // 还有未完成内容
  // ================================
  const pending =
    current.join("\n");

  // ================================
  // 当前 pending block 的展示形式
  // ================================
  let pendingBlock = null;

  if (pending.trim()) {
    if (inFence) {
      // ================================
      // 自定义组件:
      //
      // 数据还没有完整结束,
      // 暂时只显示 loading。
      // ================================
      if (
        COMPONENT_REGISTRY[fenceLang]
      ) {
        pendingBlock = {
          type: "component-loading",
          component: fenceLang,
        };
      } else {
        // ================================
        // 普通代码块:
        //
        // 临时补全 ```
        // 让 Markdown parser 可以正常
        // 进行代码高亮。
        // ================================
        const temporaryMarkdown =
          this.closeTemporaryFence(
            pending,
            fenceChar
          );

        pendingBlock = {
          type: "md",
          html: this.md.render(
            temporaryMarkdown
          ),
        };
      }
    } else {
      // ================================
      // 普通 Markdown pending block
      // ================================
      pendingBlock = {
        type: "md",
        html: this.md.render(
          pending
        ),
      };
    }
  }

  return {
    stable,
    pending,
    pendingBlock,
  };
},
matchOpeningFence识别围栏
// ================================
// 匹配 ```javascript
// 匹配 ```table
// 匹配 ~~~javascript
// ================================
matchOpeningFence(line) {
  const match =
    /^ {0,3}(`{3,}|~{3,})([a-zA-Z0-9_-]*)[ \t]*$/
      .exec(line);

  if (!match) {
    return null;
  }

  return {
    char: match[1][0],
    length: match[1].length,
    lang: match[2] || "",
  };
},
matchClosingFence判断围栏是否结束
// ================================
// 判断当前行是否关闭 fenced block
// ================================
matchClosingFence(
  line,
  fenceChar,
  fenceLength
) {
  const escapedChar =
    fenceChar === "`"
      ? "`"
      : "~";

  const regex = new RegExp(
    `^ {0,3}${escapedChar}{${fenceLength},}[ \\t]*$`
  );

  return regex.test(line);
},
closeTemporaryFence临时补全代码块
// ================================
// 普通代码块尚未收到结束 fence 时
// 临时补一个 ```
//
// 注意:这里只是用于本次 render,
// 不会修改真实 source。
// ================================
closeTemporaryFence(
  text,
  fenceChar
) {
  const fence =
    fenceChar === "~"
      ? "~~~"
      : "```";

  return `${text}\n${fence}`;
},
splitStableMarkdown对md分块
// ================================
// 解析自定义组件 Block
//
// ```table
// {
//   "columns": [...],
//   "rows": [...]
// }
// ```
// ================================
parseComponentBlock(
  componentName,
  blockText
) {
  const body =
    this.extractFenceBody(
      blockText
    );

  try {
    const data =
      JSON.parse(body);

    return {
      type: componentName,
      data,
    };
  } catch (error) {
    console.error(
      `组件 ${componentName} JSON 解析失败:`,
      error
    );

    return null;
  }
},
parseComponentBlock解析自定义组件
// ================================
// RAF 调度
//
// 不再:
// setTimeout(renderMarkdown, 100)
//
// 也不再:
// shouldForceRender()
//
// 所有 Markdown 更新统一进入一个 RAF。
// ================================

scheduleMarkdownRender() {
  if (this.renderRafId !== null) {
    return;
  }

  this.renderRafId = requestAnimationFrame(() => {
    this.renderRafId = null;

    const types = Array.from(
      this.pendingRenderTypes
    );

    this.pendingRenderTypes.clear();

    for (const type of types) {
      this.renderMarkdown(type);
    }
  });
},
extractFenceBody提取围栏中间的数据
// ================================
// 去掉:
//
// ```table
//
// 和:
//
// ```
//
// 只保留中间 JSON
// ================================
extractFenceBody(blockText) {
  const lines =
    blockText.split("\n");

  if (lines.length <= 2) {
    return "";
  }

  // 第一行:```table
  // 最后一行:```
  return lines
    .slice(1, -1)
    .join("\n")
    .trim();
},
scheduleMarkdownRender帧节流
// ================================
// RAF 调度
//
// 一个浏览器帧内收到多次 SSE 数据时,
// 不进行多次 Vue 更新。
//
// 最终一个 frame 最多更新一次。
// ================================
scheduleMarkdownRender() {
  if (this.renderRafId !== null) {
    return;
  }

  this.renderRafId =
    requestAnimationFrame(() => {
      this.renderRafId = null;

      const types =
        Array.from(
          this.pendingRenderTypes
        );

      this.pendingRenderTypes.clear();

      for (const type of types) {
        this.renderMarkdown(type);
      }
    });
},
renderMarkdown增量渲染md
实际md转html在parseBlocks里做的
// ================================
// Block 增量渲染
// ================================
renderMarkdown(type) {
  const state =
    this.markdownStates[type];

  if (!state) {
    return;
  }

  const chatKey =
    this.getChatBlocksKey(type);

  const pendingKey =
    this.getChatPendingKey(type);

  const lastAiMsg =
    this.chats[
      this.chats.length - 1
    ];

  if (!lastAiMsg) {
    return;
  }

  // ================================
  // 已经稳定的 Block
  //
  // 这里直接复用,不重新 md.render()
  // ================================
  const blocks =
    state.blocks;

  // ================================
  // Vue 2 中建议使用 $set,
  // 确保响应式更新
  // ================================
  this.$set(
    lastAiMsg,
    chatKey,
    blocks
  );

  // ================================
  // 当前正在生成的 Block
  //
  // 只有这个 Block 会持续变化
  // ================================
  this.$set(
    lastAiMsg,
    pendingKey,
    state.pendingBlock
  );

  // DOM 更新以后滚动
  this.$nextTick(() => {
    this.scrollToBottom();
  });
},
flushMarkdown兜底渲染最后的pending区
// ================================
// 流结束 / 思考切换到答案时
// 提交当前最后一个 Block
// ================================
flushMarkdown(type) {
  const state =
    this.markdownStates[type];

  if (!state) {
    return;
  }

  const source =
    state.source;

  // 没有 pending 内容
  if (!source.trim()) {
    state.source = "";
    state.pendingBlock = null;

    return;
  }

  try {
    const result =
      this.parseFinalBlock(source);

    if (result) {
      state.blocks.push(result);
    }
  } catch (error) {
    console.error(
      "最终 Block 渲染错误:",
      error
    );
  }

  // ================================
  // 清空 pending
  // ================================
  state.source = "";
  state.pendingBlock = null;

  // ================================
  // 通知 RAF 更新
  // ================================
  this.pendingRenderTypes.add(type);

  this.scheduleMarkdownRender();
},
parseFinalBlock解析最后的块
// ================================
// 最终 flush
//
// 不再要求必须出现空行。
// ================================
parseFinalBlock(text) {
  if (!text || !text.trim()) {
    return null;
  }

  // ================================
  // 如果是完整自定义组件
  // ================================
  const componentMatch =
    /^ {0,3}`{3,}([a-zA-Z0-9_-]*)[ \t]*\n([\s\S]*?)\n`{3,}[ \t]*$/
      .exec(text);

  if (componentMatch) {
    const lang =
      componentMatch[1];

    if (
      COMPONENT_REGISTRY[lang]
    ) {
      try {
        return {
          type: lang,
          data: JSON.parse(
            componentMatch[2]
          ),
        };
      } catch (error) {
        return {
          type: "component-error",
          component: lang,
          data: {
            raw: componentMatch[2],
          },
        };
      }
    }
  }

  // ================================
  // 普通 Markdown / 普通代码块
  //
  // 如果代码块没有结束 fence,
  // 临时补一个。
  // ================================
  const openingFence =
    this.matchOpeningFence(
      text.split("\n")[0]
    );

  if (openingFence) {
    const temporaryMarkdown =
      this.closeTemporaryFence(
        text,
        openingFence.char
      );

    return {
      type: "md",
      html: this.md.render(
        temporaryMarkdown
      ),
    };
  }

  return {
    type: "md",
    html: this.md.render(text),
  };
},
工具函数
scrollToBottom() {
  this.$nextTick(() => {
    const chatContainer = this.$refs.cultureBox;
    if (chatContainer) {
      chatContainer.scrollTop = chatContainer.scrollHeight;
    }
  });
},

// ================================
// 请求开始前重置
// ================================
resetMarkdownState() {
  this.markdownStates = {
    思考: {
      source: "",
      blocks: [],
      pendingBlock: null,
    },

    答案: {
      source: "",
      blocks: [],
      pendingBlock: null,
    },
  };

  this.pendingRenderTypes.clear();

  this.currentMarkdownType = null;

  if (
    this.renderRafId !== null
  ) {
    cancelAnimationFrame(
      this.renderRafId
    );

    this.renderRafId = null;
  }
},


// ================================
// 思考 / 答案 → blocks 字段
// ================================
getChatBlocksKey(type) {
  return type === "思考"
    ? "thinkingBlocks"
    : "answerBlocks";
},

// ================================
// 思考 / 答案 → pending 字段
// ================================
getChatPendingKey(type) {
  return type === "思考"
    ? "thinkingPending"
    : "answerPending";
},

// ================================
  // 根据 Block type 获取 Vue 组件
  // ================================
  getBlockComponent(type) {
    return COMPONENT_REGISTRY[type] || null;
  },


getBufferKey(type) {
  return type === "思考" ? "thinkingBuffer" : "answerBuffer";
},

getCompleteMarkdownKey(type) {
  return type === "思考"
    ? "thinkingCompleteMarkdown"
    : "answerCompleteMarkdown";
},

getChatKey(type) {
  return type === "思考" ? "thinking" : "answer";
},
模板渲染
<!-- ================================ -->
<!-- 思考区域 -->
<!-- ================================ -->
<div class="thinking-content">
  <template
    v-for="(block, index) in message.thinkingBlocks"
  >
    <!-- Markdown -->
    <div
      v-if="block.type === 'md'"
      :key="'thinking-md-' + index"
      class="markdown-block"
      v-html="block.html"
    />

    <!-- 自定义组件 -->
    <component
      v-else-if="getBlockComponent(block.type)"
      :key="'thinking-component-' + index"
      :is="getBlockComponent(block.type)"
      :data="block.data"
    />

    <!-- JSON 解析失败 -->
    <div
      v-else-if="block.type === 'component-error'"
      :key="'thinking-error-' + index"
      class="component-error"
    >
      组件数据解析失败
    </div>
  </template>

  <!-- 当前正在生成的 Block -->
  <div
    v-if="message.thinkingPending"
    class="markdown-pending"
  >
    <!-- Markdown -->
    <div
      v-if="message.thinkingPending.type === 'md'"
      v-html="message.thinkingPending.html"
    />

    <!-- 自定义组件 loading -->
    <div
      v-else-if="
        message.thinkingPending.type ===
        'component-loading'
      "
    >
      正在生成 {{ message.thinkingPending.component }}...
    </div>
  </div>
</div>
<!-- ================================ -->
<!-- 答案区域 -->
<!-- ================================ -->
<div class="answer-content">
  <template
    v-for="(block, index) in message.answerBlocks"
  >
    <!-- Markdown Block -->
    <div
      v-if="block.type === 'md'"
      :key="'answer-md-' + index"
      class="markdown-block"
      v-html="block.html"
    />

    <!-- 自定义组件 -->
    <component
      v-else-if="getBlockComponent(block.type)"
      :key="'answer-component-' + index"
      :is="getBlockComponent(block.type)"
      :data="block.data"
    />

    <!-- 组件 JSON 错误 -->
    <div
      v-else-if="block.type === 'component-error'"
      :key="'answer-error-' + index"
      class="component-error"
    >
      组件数据解析失败
    </div>
  </template>

  <!-- 当前 pending Block -->
  <div
    v-if="message.answerPending"
    class="markdown-pending"
  >
    <!-- 普通 Markdown -->
    <div
      v-if="message.answerPending.type === 'md'"
      v-html="message.answerPending.html"
    />

    <!-- 自定义组件 -->
    <div
      v-else-if="
        message.answerPending.type ===
        'component-loading'
      "
    >
      正在生成
      {{ message.answerPending.component }}...
    </div>
  </div>
</div>
面试问题
1.为什么用fetch不用axios
浏览器环境,传统 axios 默认适配器(XHR)不支持真正的 ReadableStream 流式逐块接收;fetch 原生基于 Streams 标准,response.body 直接返回 ReadableStream,所以 AI Streamable / SSE 流式对话大家首选 fetch
⚠️ 补充:Node.js 里 axios 很早就支持
responseType: 'stream';axios 1.x 新版本浏览器端可以切换adapter: 'fetch'适配器,间接支持流,但并不是主流方案
fetch(浏览器原生) 底层标准:WHATWG Fetch API,原生绑定 ReadableStream
const res = await fetch(url);//只等响应头到达,不会等全部返回
const reader = res.body.getReader(); // ✅ 原生可读流,收到一块就能读一块
- 数据分片到达,立刻读取,不需要等后端返回全部内容
- 搭配
AbortController原生支持随时中断流式请求(停止 AI 生成) - 完全适配 OpenAI / 各类大模型 SSE(event:xxx data:xxx)流式协议
axios 默认浏览器适配器(XMLHttpRequest) XHR 规范里 responseType 合法值不包含 stream,只能是:arraybuffer / blob / document / json / text
- XHR 会缓存完整响应,等后端全部传输完毕,你才能拿到完整字符串
onDownloadProgress只能拿到进度数字,不能直接拿到每一块原始二进制分片,只能拿到累积拼接后的文本,不是真正流式- 如果你强行用 onDownloadProgress 模拟 SSE,要自己维护 buffer,容易出现中文截断、分包错乱,不稳定
误区澄清:axios 能不能做流式
- Node.js 服务端:axios 原生支持
responseType: 'stream',可用 - 浏览器 axios ≥1.x:切换 fetch 适配器
axios({
  method:"POST",
  url:"/stream",
  adapter:"fetch", // 关键:底层切到fetch
  responseType:"stream"
})
缺点:
- 很多老项目还是 axios 0.x,没有 fetch 适配器
- 全局 axios 拦截器、baseURL、超时、token 处理,切换适配器后行为容易不一致,踩坑多
- 社区示例、大模型官方 SDK(OpenAI)全部是 fetch 实现,遇到问题资料少
❌ 绝对不能:直接用普通 axios.post 接收 SSE
// ❌ 错误写法,会等待全部输出完成后一次性返回
axios.post('/agent/chat', data).then(res=>{})
为什么行业里 Streamable、AI 流式对话统一用 fetch?
- 标准原生,无额外依赖,不用引入 axios
- 精准控制流生命周期:AbortController 随时终止生成(停止回答)
- 直接操作二进制 Uint8Array + TextDecoder,完美处理中文不截断
- 所有大模型流式接口规范(SSE chunked)原生适配
- 不存在适配器兼容问题,跨框架(Vue/React/ 原生 JS)写法统一
2.流式输出为什么不用 EventSource,选择 fetch + ReadableStream?
后端返回 SSE 协议 chunked 流式响应,前端用
fetch获取response.bodyReadableStream,手动解析 event/data。 没有用浏览器自带EventSource,原因:
- EventSource 只支持 GET 请求,我们要传复杂 JSON 请求体,必须 POST;
- EventSource 设置请求头、携带 token 比较麻烦;
- 需要
AbortController灵活中断请求,切换会话、发送下一条消息时终止上一条流,防止乱数据;- 自己解析流逻辑可控,可以区分多事件类型(
event:思考/event:答案)。
补充:EventSource 适合简单 GET 订阅,POST 场景基本都会手动读 ReadableStream。
3.SSE 的协议格式是什么?空行的作用?
event:思考
data:xxx思考片段

event:答案
data:xxx回答片段
event:声明事件名称;data:是数据载荷;\n\n(连续换行空行)代表一条事件结束,浏览器 / 我们代码收到空行,就把当前缓存的 event+data 当作一条完整事件去处理。
这就是代码里
if(line.trim()==="")触发 handleEvent 的原因。
4.ReadableStream、reader.read () 返回值是什么?
参考答案 const {done, value} = await reader.read()
done:布尔,true 代表流传输全部结束;value:Uint8Array二进制字节数组;
TCP 会分片,一次 read 不一定拿到完整一条业务数据,必须本地 buffer 缓存不完整的行。
5.TextDecoder 的 {stream:true} 参数是干嘛的?不加会出现什么问题?
TextDecoder 把 Uint8Array 二进制字节 → 转成 UTF‑8(或其他编码)字符串
reader.read() 返回的 value 类型是 Uint8Array(原始二进制数组),不能直接当成字符串使用,必须解码。
参考答案 decoder.decode(value, {stream:true})
stream:true:流式解码,多字节字符(中文、emoji)被 TCP 分片截断时,把残缺字节缓存,下一块数据到来再完成解码。- 不加
stream:true:遇到被切割的中文,直接乱码、出现问号。
6.AbortController 在这个项目做什么?为什么一定要加?
参考答案 用于中断 fetch 请求。 场景:用户快速连续发消息、切换对话,上一个 AI 流还在返回,如果不 abort,旧流还会继续执行 handleEvent,往当前聊天列表乱写入旧思考 / 答案,造成消息错乱。
发送新消息时调用
abort(),流循环会抛出AbortError,需要区分这个错误,不要给用户弹异常报错。
7.解释代码里那个 buffer 变量作用?为什么要 buffer = lines.pop()?
参考答案 网络 TCP 层会把服务端返回的字符串任意切割分片,分片边界不一定刚好在换行符上。 例如: 服务端输出:event:答案\ndata:abc123\n\n 网络分片切成两段:event:答案\ndata:abc 和 123\n\n。
buffer.split('\n')按换行切割所有行;lines.pop()取出数组最后一项,这一项大概率是不完整的半行,放回 buffer,留给下一次reader.read()拼接;- lines 数组剩下的都是完整行,循环解析。
如果不做这个缓存,会丢数据、解析错乱。
8.为什么要帧节流渲染,同时还要有 shouldForceRender 强制渲染逻辑?
参考答案
数据到达频率远高于屏幕刷新率
避免布局抖动和重复重排(如果有改变布局)
保护主线程,维持交互响应,渲染任务过密会挤占输入处理,导致滚动不跟手、按钮点不动
渲染速度需要与消费速度匹配,如果渲染端处理不过来,而数据还在源源不断到达,缓冲区会持续膨胀,内存上涨、延迟累积,最后要么卡死要么崩溃
视觉上更稳定、更自然,不加节流时,文字可能一瞬间蹦出一大段,又突然停顿,节奏忽快忽慢。按帧节流后,更新被均匀分配到每一帧,视觉上更接近“平滑输出”,阅读体验更好。对动画、视频类流式渲染,节流还能避免帧时间抖动造成的画面撕裂或抖动。
合并更新,减少无效工作
一帧内到达的多个 token,完全可以合并成一次状态更新、一次 DOM 操作、一次绘制。节流器通常配合“脏标记 + 下一帧统一提交”的模式,把 N 次更新压缩成 1 次,开销从 O(N) 降到 O(1) 量级。
9.每次 renderMarkdown 都渲染完整 completeMarkdown,长对话会有什么性能问题?怎么优化?
高频面试坑点! 参考答案 问题: AI 输出几千字,每次流片段过来,
marked.render(完整大字符串),markdown 全量解析,字符串越长 CPU 开销越大,页面卡顿。
优化方案:
- 增量渲染:只解析新增 buffer 片段,append HTML,不再全量渲染整篇;
缺点:要自己处理 markdown 块闭合,要防范 XSS。
10.SSE、WebSocket、fetch+ReadableStream 三者对比,选型场景
| 方案 | 方向 | 底层 | 适用场景 |
|---|---|---|---|
| fetch+ReadableStream | 单向:一次请求,持续接收 | HTTP Chunked | AI 问答,提问一次,流式返回回答 |
| SSE(EventSource) | 单向,服务端推送 | HTTP | 消息通知,只收不发,限制 GET |
| WebSocket | 双向收发 | TCP | 聊天、实时协作,客户端也需要频繁发消息 |
重点:fetch+stream 不能双向长连接,请求体一次性发送,只能接收流式响应。客户端不能持续发送数据。
11.会遇到什么异常边界情况?
- 网络中断,流中途断掉;
- TCP 分片刚好切在中文中间,依赖 TextDecoder stream:true;
- 用户疯狂点发送,上一条流没结束,没有 abort 造成消息错乱;
- SSE 事件 data 多行,data 会拼接多行内容;
- 后端返回不规范,缺少
\n\n结束符; - markdown 解析报错,要 try catch 包裹渲染逻辑。
12.如果后端要同时返回思考和答案,有哪些方案?你们项目是 event 区分,还有别的方案吗?
- SSE
event:思考/event:答案(你们项目方案) - 同一个 event,data 返回 JSON,字段 type 区分
think/answer
{"type":"think","content":"xxx"}
{"type":"answer","content":"xxx"}
- 字符串标记前缀
[think]:xxx
评价:event 区分可读性最好;JSON 方案兼容性最强。
SSE 原生 event: 本身没有浏览器兼容性硬缺陷,但在你这种 fetch + ReadableStream 手动解析的场景下,不是兼容性问题,而是【协议解析复杂度】和【后端框架适配问题】;如果用原生 EventSource,event 完全稳定。
真正容易踩坑的不是浏览器支不支持 event,而是:有些后端框架 / 网关不规范输出 SSE 流,以及手动解析代码容易写错。
1. event 本身浏览器兼容性
event: xxx 是标准 SSE 协议(W3C),所有现代浏览器都支持,不存在浏览器不识别 event: 的情况。
- Chrome / Edge / Firefox / Safari 全支持
- 移动端浏览器也没问题
❗ 注意:兼容性坑不在解析 event 字段,而在你自己手写流解析逻辑。
2. event 方案的实际短板
短板 1:SSE 事件必须用 \n\n 分割,对后端输出格式强约束
event:think
data:思考内容

event:answer
data:回答内容
必须双换行作为一条事件结束标记。 如果后端少换行、或者网关 /nginx 转义、日志插入额外换行,你的手动解析逻辑直接错乱。
对比 JSON 方案:单条 data 里直接
{"type":"think","content":"xxx"},只要 JSON 字符串完整就能解析,换行干扰容错更强。
短板 2:一条事件的 data 支持多行,解析逻辑更复杂
SSE 标准:data: 可以多行,连续多个data:行会自动拼接,直到空行。
event:think
data:第一行思考
data:第二行思考
手写解析器必须合并多行 data,很多人写的简易解析器没处理多行 data,直接 bug。 而JSON 方案天然单行一条对象,处理简单。
短板 3:部分老旧网关、代理、中间件对 SSE event 支持差
有些代理、老的 BFF 框架,会忽略 / 过滤event:前缀,只透传 data 字段。
这个不是浏览器问题,是中间件兼容问题,生产环境容易踩暗坑。
| 方案 | 优点 | 缺点 | 适合场景 |
|---|---|---|---|
| ✅ SSE event 区分(event:think /event:answer) | 语义标准清晰,协议原生设计,data 载荷干净 | 后端输出格式要求严格;手写解析要处理多行 data、双换行;部分代理容易出问题 | 前后端自主可控、新服务,规范度高 |
| ✅ 同 event,data 返回 JSON 带 type | 兼容性最强,容错高,解析简单,不受 event 字段影响 | data 里要序列化 JSON,多一点序列化开销 | 通用首选,对接复杂网关 / 第三方模型接口 |
✅ 字符串前缀标记 [think]:xxx | 实现最简单,后端不用遵守 SSE 完整规范 | 内容本身如果包含[think]:会解析错误,内容转义麻烦 | 快速原型、内部测试,不推荐线上 |
1、说说 SSE 和 fetch+ReadableStream 实现流式输出本质区别?
主答案
- SSE 只能 GET,浏览器内置自动重连、
last‑event‑id、事件解析,响应头固定text/event-stream,无法携带 JSON 请求体,鉴权只能放在 Header/Cookie。 - fetch+ReadableStream 支持 POST,可以传递复杂 JSON 载荷;拿到原始二进制流,没有浏览器自动解析、自动重连、断点机制,前端手动读取、解码、处理粘包断流。
- 旧双请求 SSE 分为两次请求:第一次 POST 获取会话 ID,第二次 GET 建立 SSE 长连接,多一次网络往返,会话 ID 存在泄露风险。
追问 1:SSE 为什么限制 GET?能不能 POST SSE? 标准 SSE 由浏览器EventSource发起,API 只支持 GET,原生不支持 POST。 变通方案:请求体放 Cookie/Header,或者自己用 fetch 手动解析text/event‑stream流(不再使用 EventSource),但失去浏览器自带重连。严格意义原生 EventSource 无法 POST。
追问 2:ReadableStream 是浏览器原生 API 吗,兼容情况? 是标准 Web API,现代浏览器全部支持;IE 完全不支持。 注意:部分老旧移动端、WebView 存在 bug;fetch 返回 body 为 null 就是不支持流,需要降级为普通轮询。
追问 3:两种方案断线行为有什么不同,谁更容易产生重复消息?
- SSE:浏览器自动重试,携带 last-event-id,后端依靠 id 断点续推,容易出现重复推送;
- ReadableStream:断流后直接终止,浏览器不会重试,不会自动补发消息,重复消息由业务自己控制; 缺点:断了就停,没有原生断点。
追问 4:什么时候选 SSE,什么时候选 fetch 流式?
- SSE:简单推送、无需复杂 POST 参数、需要浏览器自动重连,监控消息、通知推送;
- fetch+ReadableStream:AI 对话、大上下文、复杂请求体、可控取消、单次鉴权,需要灵活控制流生命周期。
2、简单描述 fetch+ReadableStream 完整数据流流程
主答案
- fetch 发起 POST,传递 prompt / 上下文;后端设置
Transfer‑Encoding: chunked,不设置 Content‑Length; - 获取
response.body得到 ReadableStream; getReader()创建读取器,TextDecoder解码二进制;- 循环
reader.read(),拿到二进制块,解码拼接; - 维护缓冲区处理跨块截断,逐段渲染打字机效果;
- done=true 代表流正常结束;捕获网络异常、手动取消。
追问 1:为什么不能写 Content‑Length? Chunked 分块传输含义:响应总长度未知,边生成边下发。一旦填写 Content‑Length,网关 / 浏览器会等待接收完整长度后再交付给前端,流式直接失效。
追问 2:chunk 边界不一定是完整句子 / 完整 JSON,遇到跨块截断如何处理? 后端使用分隔符(换行符\nndjson);前端维护 buffer。新 chunk 追加到 buffer,按分隔符切割,完整消息取出渲染,剩余不完整字符串留在 buffer 等待下一次接收。
追问 3:TextDecoder 和直接 new String 有什么区别?多字节中文会不会乱码? TextDecoder专门处理 UTF‑8 二进制流,支持流式解码{stream:true},跨块中文不会截断乱码; new String(value)直接把 Uint8Array 转字符串,多字节字符被切分时会产生乱码,不适合流式二进制分段解析。
3、如何主动中断流式请求?如何避免内存泄漏
主答案 使用AbortController,signal 传入 fetch。调用abort()终止请求。 内存泄漏要点:组件卸载、切换对话、发起新请求时必须 abort 旧流;读取完成 / 取消后执行reader.releaseLock()释放锁;避免已销毁组件继续执行回调更新 DOM。
追问 1:abort 之后后端还在继续生成 token 怎么办?前端只是停止接收,后端无法感知?怎么优化? 前端 abort 只能关闭浏览器接收通道,后端不会收到停止指令,仍然继续消耗算力生成内容。 优化:
- 增加一条独立取消接口,abort 同时调用 cancel 通知后端停止生成;
- 设置后端超时,长时间无客户端消费自动中断任务;
- 使用会话唯一标识绑定任务。
追问 2:如果已经拿到 reader,不 releaseLock 会有什么后果? 流读取锁一直占用,该 ReadableStream 无法再次获取 reader;流资源不能释放,造成内存占用持续增加。
追问 3:多个并发流式请求,如何区分取消哪一条? 每条请求单独创建 AbortController,保存到 Map <会话 ID, controller>;取消指定会话,取出对应 controller 执行 abort,互不干扰。
4、对比双请求 SSE 方案,fetch POST 流式安全性提升在哪?缺点是什么
主答案 ✅安全优势
- 单次请求鉴权,不需要下发 sessionId 给第二条长连接,减少 ID 日志劫持、泄露风险;
- 参数放在 POST body,不在 URL 上,URL 会被网关、代理日志记录,敏感内容更安全;
- 完全可控取消,没有浏览器静默自动重连带来的会话复用隐患。
- ❌缺点
- 无原生自动重连;
- 没有 last‑event‑id,断点续传需要自研;
- 原始字节流(res.body,二进制Uint8Array),粘包(用/n分行)、解析(TextDeCode解码再md解析)、异常处理全部手写。
追问 1:如果我需要断点续传,前端要保存哪些信息?
记录 2 类数据:
- 当前会话 id;
- 已成功接收并渲染的字符偏移量(输出到第几个字,纯文字输出用这个) / 消息序号(有多个event用这个); 断连重试时把偏移随 POST 请求传给后端,后端从偏移位置继续推送增量内容。
追问 2:网络抖动中途断流,怎么从上次输出位置继续拉取增量? 前端保存偏移,断线后触发重试请求带上偏移;后端读取偏移,跳过已下发内容,返回后续 chunk;重试增加最大次数,防止死循环。
追问 3:双请求 SSE 方案存在哪些安全漏洞?
- 鉴权 sessionId 通过响应返回,日志、抓包容易捕获;
- SSE 是 GET,id 拼接在 URL,大量中间代理保存 URL 日志;
- 浏览器自动重连,id 过期后仍反复重试,产生无效请求;
- 两次请求,链路更长,攻击面更大。
追问 4:为什么放post的body就更安全?
POST Body 并不是抓包看不见,HTTPS 下中间人同样抓不到,但本机 / 服务端抓包依然可以看到内容;它的优势不是 “防抓包”,而是减少【日志持久泄露】的渠道,风险种类和 URL 参数不一样,是相对更安全,不是绝对安全
1、先理清 3 种泄露途径(关键区分)
途径 1:URL 参数(双请求 SSE 的 sessionId=xxx)
会被大量中间环节永久记录日志
- Nginx/CDN/ 反向代理普遍记录完整 URL 到访问日志;
- 浏览器历史记录、页面跳转 Referer 头会携带 URL;
- 服务器日志长期落盘保存,事后可翻查窃取凭证。
致命问题:凭证会持久保存在各种日志里,抓包只是其中一种泄露方式。
途径 2:POST Body
✅绝大多数代理、Nginx 默认不会记录 POST 请求体到访问日志
抓包(浏览器 F12、服务端深度抓包)确实能看到 body 内容; 但是不会大量、自动、持久写入常规访问日志,消除了最大的泄露源头。
途径 3:Header 中的 Token
和 Body 类似:常规日志一般不打印 Header,泄露渠道远少于 URL。
总结本质差异: URL:多环节自动落日志,泄露面大 Body/Header:抓包可见,但常规日志不保存,泄露渠道更少
2、HTTPS 在这里起到什么作用?
HTTPS 加密整个传输链路:
- 外网中间人无法窃听 URL、Header、Body;
- 但是到达后端的代理 / 服务器会解密 代理可以选择记录 URL(默认开启),默认不记录 Body。 HTTPS 不能解决服务端日志泄露,它只防外网窃听。
3、面试官灵魂追问:既然 F12 能看到 body,凭什么说更安全?
不要说 body 看不见!正确回答:
安全提升点不是躲避抓包。
- URL 参数最大隐患是网关、CDN、浏览器历史、referer 多处持久留存日志;
- POST Body 虽然本地调试抓包可以查看,但主流 web 服务器默认不会把请求体写入访问日志,消除了大范围日志泄露风险;
- SSE 必须 GET,参数只能放 URL;fetch+POST 可以把会话信息、敏感参数放在 body,避开日志泄露这个最大短板;
- 它只能降低泄露概率,不能杜绝本地抓包窃取,不是绝对安全方案。
4、误区纠正(面试踩坑点)
❌错误观点:POST body 传输内容是隐藏的,抓包看不到 ✅正确观点:本地 F12、后端深度抓包依然可见;优势是避免日志持久泄露,不是隐身。
5、延伸:Cookie 又是什么风险?
Cookie 自动随请求携带,带来CSRF 跨站请求伪造; POST Body 里自定义参数不会自动跨站点携带,天然规避 CSRF 风险,这是第二个加分安全点。
5、流式收到的 chunk 出现消息截断、半条数据怎么解决(粘包问题)
主答案 后端采用分隔符(换行符 ndjson)输出;前端维护 buffer 缓冲区。
- 新 chunk 解码追加至 buffer 末尾;
- 根据分隔符切割,取出完整消息交给渲染;
- 剩下不完整片段保留在 buffer,等待下一块数据;
- 流结束后处理 buffer 残留内容。
追问 1:缓冲区无限膨胀怎么限制大小?防止超大流内存溢出 设置 buffer 最大阈值,超出上限清空缓冲区并上报异常,强制重置会话;业务上后端单轮回复不要无限长。
追问 2:后端不提供分隔符,纯文本增量输出,还需要 buffer 吗? 不需要按分隔符切分,直接拼接追加渲染。但依然建议使用 TextDecoder 流式解码避免中文乱码。
追问 3:如果后端偶尔一次性返回全部文本,代码是否兼容? 兼容。一次性返回只是单个大 chunk,buffer 逻辑依然正常执行,不会破坏代码结构,不需要额外分支。
6、浏览器层面,ReadableStream 有哪些坑?
主答案
- 部分反向代理、CDN 网关会缓存全部响应再下发,chunked 失效,流式变成一次性返回;
- fetch 返回 ok=true 只是响应头成功,流中途随时断开,不能依靠 status 判断全程成功;
- TextDecoder 复用实例,不要循环新建;
- reader 释放锁之后不能再次 read,必须重新 getReader;
- POST 跨域触发 OPTIONS 预检,增加首块延迟。
reader清理
情况 1:上一轮正常结束(done=true)
旧流自动解锁,不用手动releaseLock(),直接新开 fetch、新建 reader 没问题。
情况 2:上一轮中途取消 / 网络异常断流(面试重点)
- 如果没有 abort、没有 releaseLock:旧流和 reader 还占用资源,不会自动回收,多次切换对话后累积,造成内存泄漏、浏览器连接数耗尽。
- 不是锁冲突报错(因为每次都是新 Stream),而是资源堆积。
误区:既然每次新建 reader,是不是不用 releaseLock? 不是锁报错问题,是资源泄漏问题。
追问 1:网关缓存 chunk 问题怎么排查、怎么通知后端规避? 排查:抓包查看响应是否分块下发,看Transfer‑Encoding:chunked; 后端方案增加响应头Cache‑Control: no-cache, no-store,通知代理不要缓存响应内容。
网关缓存 chunk【排查步骤】
- 打开 F12 网络面板,查看响应头
- 正常流式:
Transfer‑Encoding: chunked,不存在 Content‑Length; - 网关缓存后:消失
Transfer‑Encoding:chunked,出现Content‑Length,所有内容一次性返回。
现象:前端只收到单个大 chunk,打字机效果消失,一次性渲染全部文本。
- 抓包观察时序(区分是后端慢,还是网关合并块) 看网络 Timeline:
- 真正流式:多条小包陆续到达,间隔几秒持续收到数据;
- 网关缓存:长时间等待,最后一瞬间一次性返回全部数据。
- 分段测试绕过网关定位问题 直接请求后端原始地址(跳过 Nginx/CDN):
- 绕过网关后,流式正常分块返回 → 确定是网关 / CDN 的缓存、缓冲策略导致合并 chunk
- 绕过网关依然一次性返回 → 后端代码问题,没有开启 chunked 输出
- 查看网关日志 Nginx 默认会开启
proxy_buffering代理缓冲,开启之后 Nginx 收集后端所有 chunk,全部接收完成再转发给客户端,直接破坏流式。
追问 2:fetch 拿到 response.ok=true,但是 body 流突然中断,如何区分正常结束和异常断开?
正常结束:reader.read () 返回 done=true;
异常断开:直接抛出网络 Error。 代码捕获 try-catch,区分业务报错、网络中断、手动 abort(AbortError)三种场景。
追问 3:跨域下 CORS 预检会破坏流式体验吗?
OPTIONS 请求增加一次往返,会拉高首块延迟,但不会中断流式,只会做一次预检,不会每个分块都做。
优化:后端设置Access‑Control‑Max‑Age缓存预检请求,减少重复 OPTIONS。
追问 1:我每次对话都新建一个 reader,还会出现 “流被锁定,不能 getReader” 报错吗?
不会。 报错发生在同一个 ReadableStream 多次 getReader。 你每次 fetch 得到全新 Stream,各自的 reader 互不影响,不存在锁冲突。 泄漏≠锁报错,两个问题不要混在一起。
追问 2:既然是新的流,不调用 releaseLock 会怎么样?
正常跑完 done=true:浏览器自动解锁,问题不大。 但是中途 abort 取消、异常断流,没有走到 done=true,锁不会自动释放,引用一直存在,长时间多次切换对话,内存持续上涨。
生产代码 finally 里统一 releaseLock 是工程最佳实践。
finally 内部如果写 return,会覆盖 try /catch 的返回值!
追问 3:断点续传的时候新建 reader 和这个是一回事吗?
是的。断点重试本质就是废弃旧 reader / 旧流,重新 fetch 生成新流、新 reader,不能复用原来的 reader,正好匹配你现在的架构。
7、前端性能与渲染优化(打字机卡顿、频繁 DOM 更新)
主答案
- 小块 chunk 不要立刻渲染,使用 requestAnimationFrame 合并 DOM 更新;
- 长对话搭配虚拟列表,控制 DOM 总量;
- 流处理放在 RAF,避免阻塞主线程;
- 缓存增量文本,批量追加,减少重排重绘;
- 发起新请求前 abort 旧流,多条流并发渲染互相干扰。
追问 1:RAF 节流和简单 setTimeout 防抖区别,哪种更适合流式打字机? RAF 跟随浏览器渲染帧,和页面刷新同步,视觉流畅,适合流式打字机; setTimeout 固定间隔,和渲染周期不同步,容易出现闪烁、掉帧,不推荐。
追问 2:上万条消息,持续流式输出,内存持续上涨如何定位泄漏? Chrome 内存快照排查三点:
- AbortController、reader 没有释放;
- 闭包保存大量历史消息没有销毁;
- DOM 节点堆积(没有虚拟列表)。 配合 Performance 录制查看内存持续增长曲线。
追问 3:WebWorker 能不能消费 ReadableStream?有什么限制? 现代浏览器支持 Worker 中读取 ReadableStream; 限制:主线程传递流实例有浏览器版本兼容坑;Worker 无法直接操作 DOM,只能解析数据后发消息回主线程渲染。
9、生产环境可靠性设计
主答案
- AbortController 及时取消,清理旧请求;
- 前端记录偏移量,断连重试实现断点续传;
- 设置空闲超时,长时间无 chunk 主动 abort 判定卡死;
- 最大重试次数,禁止无限重试;
- 区分网络异常和后端业务错误,流内埋入错误标记;
- 增加断线提示、手动重试按钮。
追问 1:超时时间设多少合适,太短误杀、太长用户等待 首块超时 8~12s;两块 chunk 间隔空闲超时 5~8s;配合后端限流,可根据业务微调。
追问 2:重试的时候如何避免后端重复生成回答? 依靠会话 ID + 接收偏移,后端校验偏移,只返回未推送内容;不要重新完整生成一遍。
追问 3:怎么做埋点统计:首块延迟、断流率、流式失败率? 记录请求发起时间、收到第一个 chunk 时间 = 首块延迟;捕获异常统计断流次数;统计成功结束 / 异常中断数量计算失败率,上报 RUM 监控。
10、对比两种架构选型(业务取舍)
主答案
- 双请求 SSE:GET、简单鉴权、依赖浏览器自动重连,适合消息推送;缺点两次请求,会话 ID 风险,不能 POST body。
- fetch+ReadableStream POST 流式:AI 对话、复杂请求参数、单次鉴权、可控取消;缺点重连、断点需要自研。
追问 1:如果让你重构老项目的双请求 SSE,迁移到 fetch 流式,改造难点在哪?
- 原有会话鉴权逻辑改造,取消单独获取 sessionId 接口;
- 原有自动重连逻辑全部自己实现;
- 兼容旧网关,处理缓存 chunk 导致流式失效;
- 前端增加缓冲区、异常、重试、埋点整套逻辑,代码量上升。
原生 SSE(EventSource)不需要你手动做字节解码、Reader、buffer 粘包处理;浏览器底层已经封装了TextDecoder+ 缓冲区 + 按\n\n切分消息;
但是原生 SSE 不会自动断点续传,不会自动携带 Last‑Event‑Id 完成断点恢复,重连只是简单自动重试,不带断点!(就是如果后端没有传id的话,Last‑Event‑Id 就保存不到信息,就无法续传,只有浏览器只会无脑重新建立连接,后端从头全部重发,等于单纯重试,没有断点。断点续传是前后端配合,浏览器只做一半工作)
EventSource 不会独立完成断点续传;它只提供了断点信息传递通道。缺少后端配合,自动重连仅仅是重试,不能续传。
渲染依然自己写:收到 message 事件后,拿到 data 字符串,自己做 Markdown 解析、页面渲染。
追问 2:有没有方案同时兼顾 SSE 自动重连 + POST 传参? 没有完美原生方案。两种折中:
- fetch 手动解析 text/event‑stream 流,自己实现重连(放弃 EventSource);
- POST 提交参数存入后端临时缓存,返回 key,EventSource GET 携带 key 建立长连接,又回到两次请求,安全优势下降。
11.双请求 SSE 方案不安全在哪
一、先回顾双请求 SSE 流程
1)请求 1:POST /auth 获取会话凭证 sessionId,前端拿到 id; 2)请求 2:用浏览器EventSource发起 GET 长连接,url 拼接?sessionId=xxx建立 SSE 通道。
核心安全病根:鉴权凭证暴露在 URL 中,并且分两次请求,攻击面放大
二、逐条列出安全风险(面试逐条背诵)
1. sessionId 放在 URL 参数,极易泄露(最大问题)
EventSource 只支持 GET,只能把会话 ID 拼在 URL 上。
- 代理服务器、CDN、网关会完整记录访问 URL,日志永久保存 sessionId;
- 抓包、浏览器历史、页面跳转时 URL 被 referer 带走; 攻击者拿到这个 id,不需要 cookie/token,直接伪造 SSE 长连接接收 AI 对话内容。
fetch+ReadableStream 方案:token 放在 Header,对话参数放在 POST body,不在 URL 上,不会被 URL 日志捕获。
2. 两次请求带来时间窗口与劫持风险
第一步 POST 拿到 sessionId 到第二步建立 SSE 存在短暂时间间隙。
- 如果网络抓包截获返回的 sessionId,攻击者可在你建立连接前抢先使用该 id;
- 后端很难做到强绑定:无法保证两条请求来自同一个客户端、同一个浏览器会话。
-
攻击者抓包截获第一步返回的 sessionId,在前端发起第二步 SSE 之前,抢先拿着这个 id 建立 SSE 连接。 后端仅仅校验 id 有效,没有强绑定客户端,攻击者抢占连接,拿到 AI 流式数据。
漏洞根源:鉴权凭证分两次传输,中间有空档,凭证在响应体返回。
fetch 流式:一次 POST,Authorization 头部随同请求一起发送,鉴权和数据流原子化,不存在间隙。
- 它解决的不是防止本机抓包,而是消除【先获取 sessionId、再建立 SSE】带来的攻击窗口期,避免攻击者截获凭证后抢先占用连接;
- 凭证从 URL 参数移到请求头,规避 Nginx、CDN 日志持久存储造成的泄露;
- 鉴权和数据流在一次请求原子完成,不会出现两条请求无法绑定客户端会话的问题;
- 短板依然存在:本机浏览器可直接查看请求头拿到 token,这是前端所有方案共同的局限性,需要后端增加过期时间、IP/UA 指纹、短期令牌等额外防护,前端无法彻底杜绝本地窃取。
- 抓包依然看得见,但是攻击路径变少、泄露渠道变少,消除了一类高危劫持漏洞,安全相对更强,不是绝对安全。
3. 浏览器自动重连放大安全隐患
SSE 断线浏览器自动重试 GET 请求,自动带上原始 URL 里的 sessionId:
- id 过期了还疯狂重试,产生无效请求;
- 一旦 id 泄露,只要页面不关闭,攻击者可以持续复用;
- 前端无法精细控制每一次重连的鉴权、无法主动刷新凭证。 fetch+ReadableStream 断流不会自动重连,重连逻辑由代码手动控制,可以每次带上最新 token。
4. 临时 sessionId 生命周期设计容易踩坑
很多实现为了简单:sessionId 一旦生成长期有效。
- 后端缺少短时过期机制;
- 没有绑定 IP、设备指纹; 泄露之后危害持续很久。 单次 POST 流式一般使用短期 Bearer Token,后端可即时失效。
5. 敏感上下文无法隐藏,只能放 URL 或 Cookie
SSE 不能携带 JSON 请求体,对话上下文、敏感提示词只能:
- 拼 URL(泄露),或者
- 写入 Cookie(存在 CSRF 风险) 而 fetch POST 可以把全部对话上下文放在请求 body 里,不会出现在日志、浏览器历史中。
6. CSRF 风险更高
如果依赖 Cookie 做鉴权,EventSource GET 会自动带上 Cookie。 攻击者构造恶意页面诱导用户访问,自动发起 SSE 长连接读取对话数据。
fetch 可以设置
credentials精细控制,配合 CSRF Token 防御,可控性更强。
三、但是要客观(面试加分,不要全盘否定 SSE)
风险不是 SSE 协议本身漏洞,是「POST 拿 id + EventSource GET 长连接」这种双请求架构带来的工程缺陷
- 如果不用双请求,直接 Header 带 token 建立 SSE,风险会下降;
- SSE 本身适合简单消息推送,只是这套 AI 对话双请求模式不适合高安全场景。
四、面试一句话总结(简短版,直接口述)
双请求 SSE 最大安全隐患是会话 ID 拼接在 URL 中,网关日志、抓包容易窃取;两次请求存在时间窗口,后端难以绑定客户端;浏览器自动重连会反复复用泄露的凭证;敏感对话内容不能放在请求体,只能放 URL 或 Cookie,增大泄露和 CSRF 风险。而 fetch+ReadableStream POST 一次性完成鉴权与流式传输,凭证放 Header、参数在 Body,规避了上面大部分问题。
五、面试官高频追问 + 标准答案
追问 1:如果我把 sessionId 放在 Cookie 里,还会有这些问题吗?
风险减少,但依然存在短板:
- 引入 CSRF;
- Cookie 会自动携带,无法做到单次请求独立鉴权;
- 依然无法传递复杂 JSON 对话上下文。 只能缓解,不能根治双请求架构的缺陷。
追问 2:后端给 sessionId 设置很短过期时间能不能解决?
只能降低危害,不能杜绝泄露。 攻击者只要在有效期内拿到 id 即可劫持;并且频繁过期会导致 SSE 反复断连重连,影响体验。
追问 3:既然双请求 SSE 不安全,为什么很多老项目在用?
早年缺少成熟的 fetch 流式方案,开发简单:EventSource 自带断线重连,不用自己实现重试。代价就是牺牲安全性,适合后台通知、简单推送,不适合携带隐私内容的 AI 对话。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐


 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)