别把大模型网关当普通 API 做!内网隔离环境下的合规生死线
别把大模型网关当普通 API 做!内网隔离环境下的合规生死线
前言
兄弟们,说实话,搞技术这条路真是各种坑。咱们做开发的,说白了就是要不断踩坑、不断成长,这才是技术人的常态。
你在内网环境部署大模型,是不是也踩过坑?
很多团队照搬公网方案,结果被审计通报。
数据没出网,但日志留了痕。
接口通了,但权限乱了。
内网不是法外之地。
相反,它是合规的重灾区。
今天咱们不聊虚的。
就讲怎么在物理隔离的环境里,把大模型中台网关做得既安全又合规。
这是拿真金白银和审计红线换来的经验。
一、 底层原理
1.1 核心机制
内网环境有个特点:断网。
没有外网依赖,所有资源必须本地化。
大模型网关在这里,不只是个转发器。
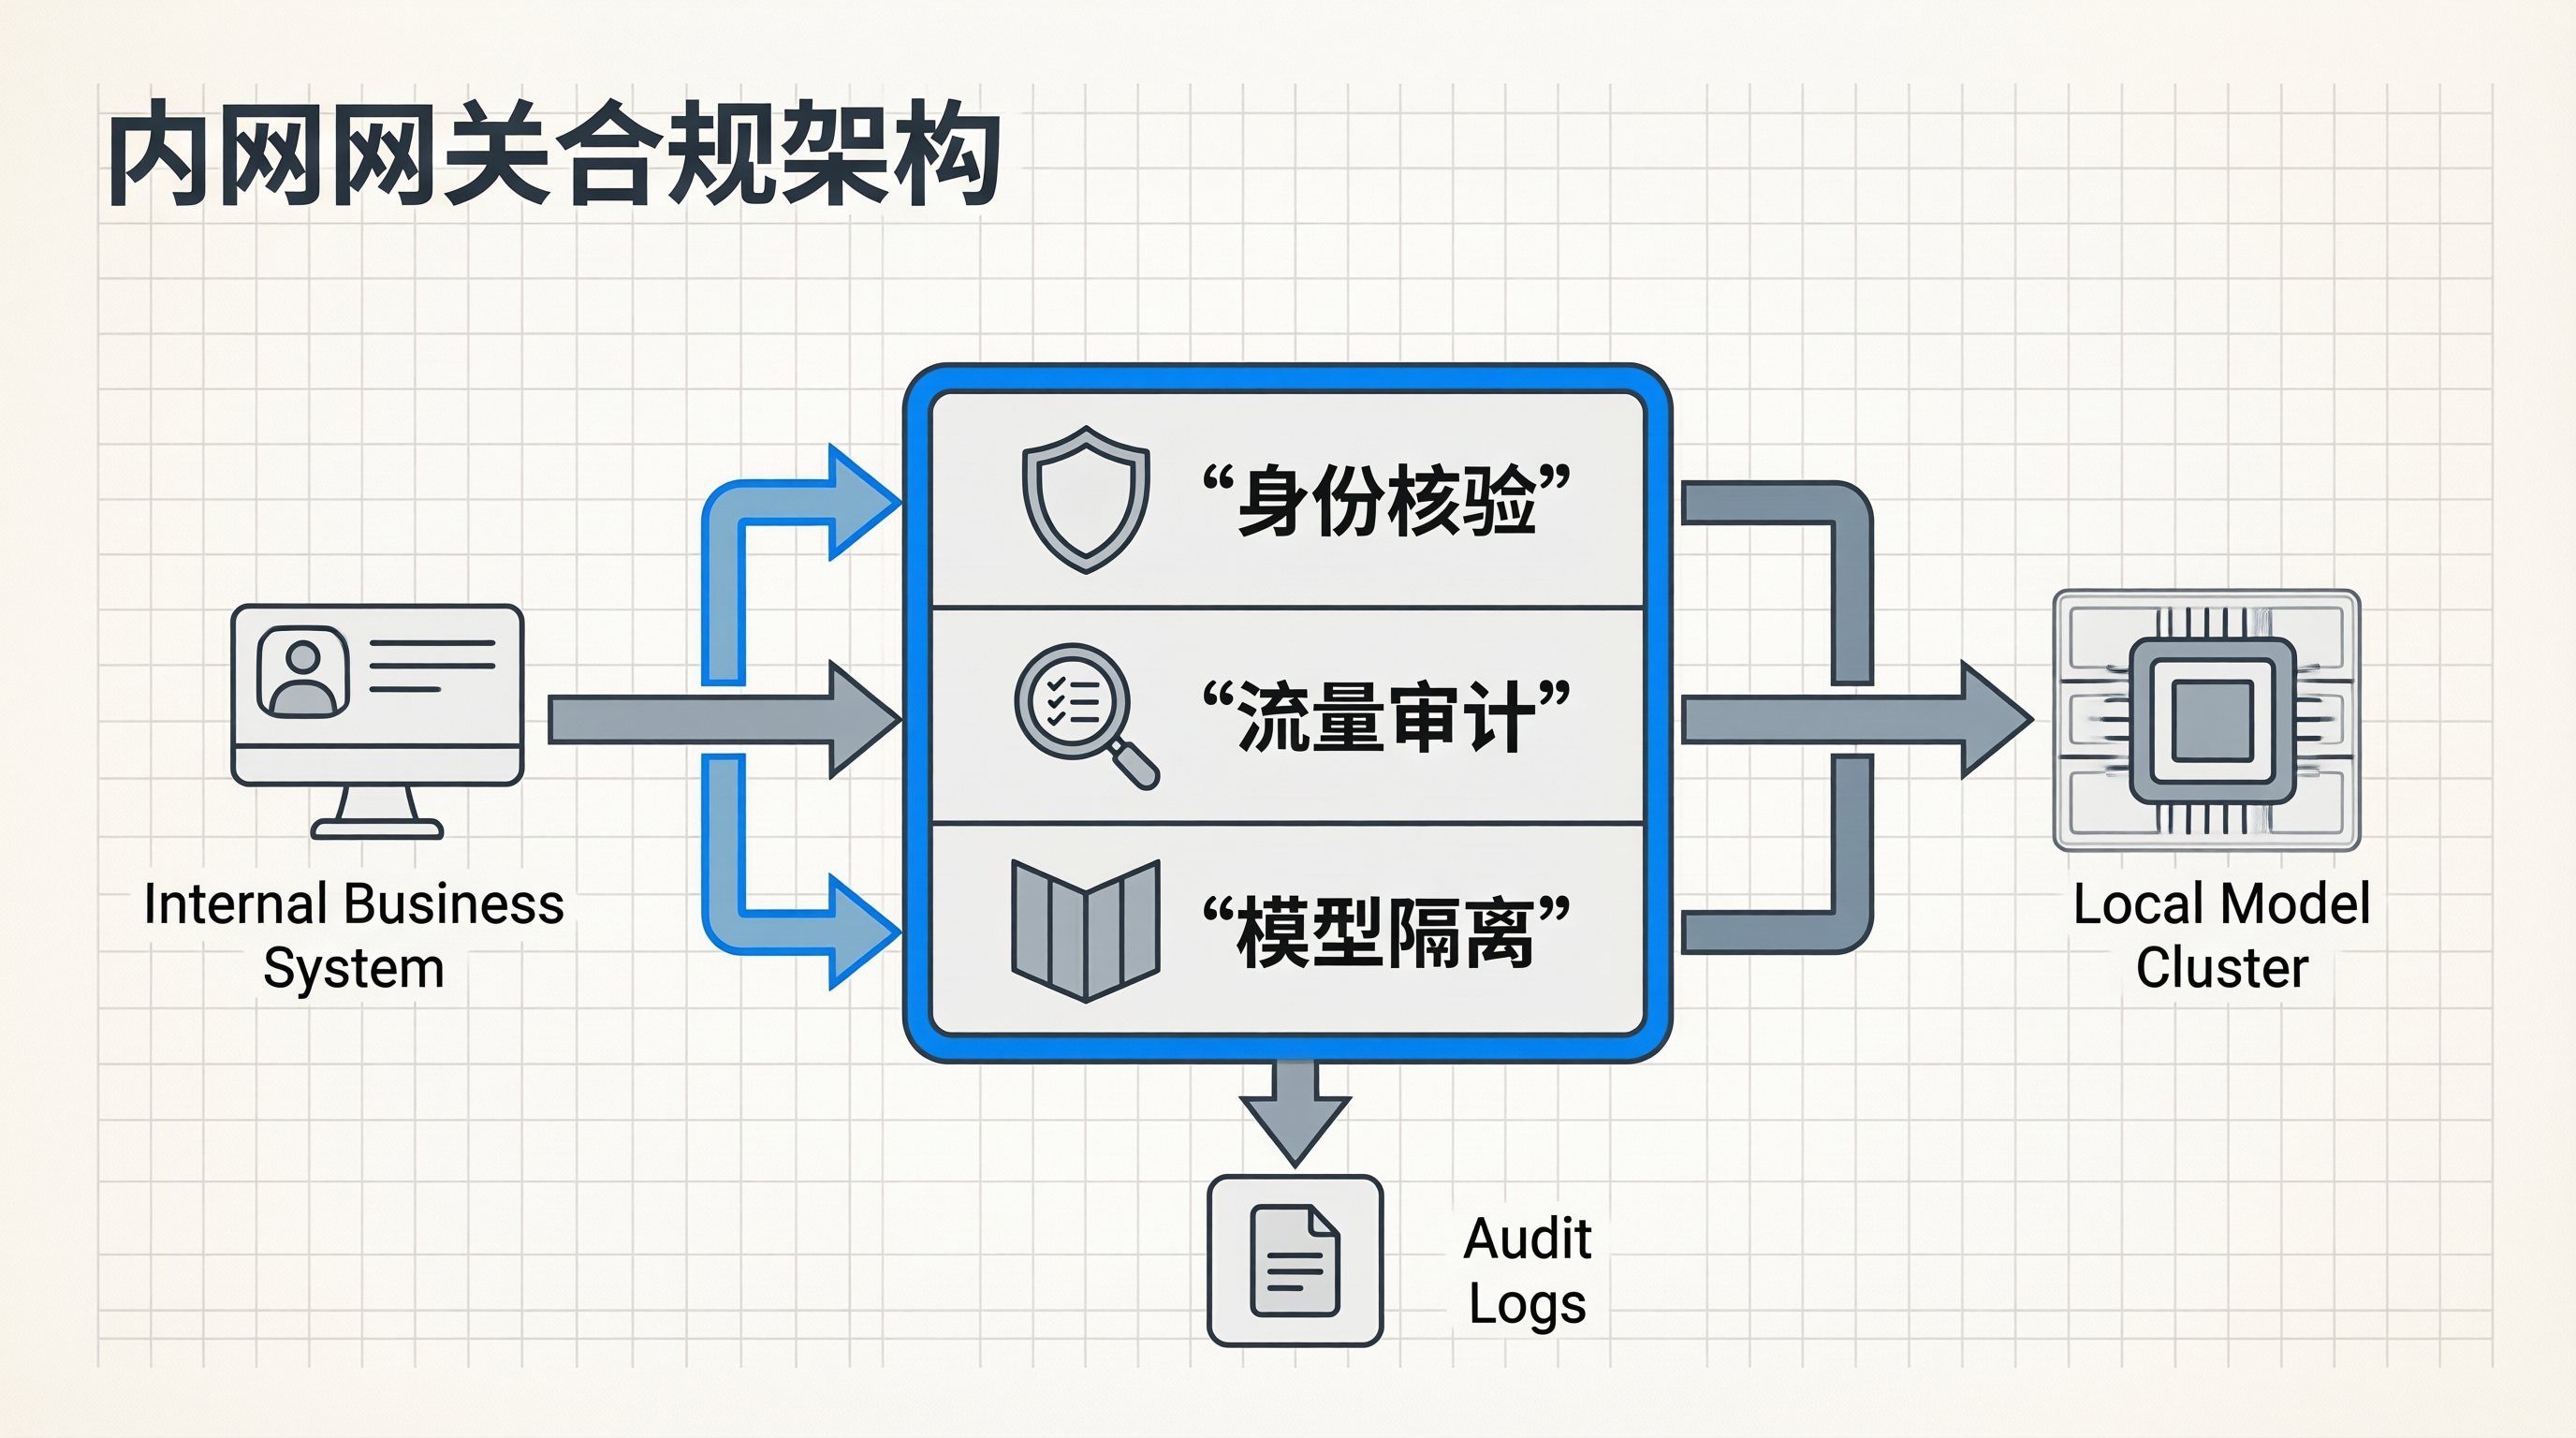
它得是个“内网海关”。
核心机制就三件事:
身份核验、流量审计、模型隔离。
身份核验是看你是谁。
流量审计是看你干了啥。
模型隔离是看你能碰谁。
下图展示了内网网关的流量走向。
所有请求必须经过网关,严禁直连模型服务。
graph TD
    Client["内部业务系统"] --> Gateway["大模型中台网关"]
    Gateway --> Auth["身份鉴权模块"]
    Gateway --> Audit["审计日志中心"]
    Gateway --> RateLimit["流量限流器"]
    Auth --> LocalModel["本地模型集群 A"]
    Auth --> LocalModel2["本地模型集群 B"]
    Audit --> LogServer["离线日志服务器"]

    style Gateway fill:#f9f,stroke:#333,stroke-width:2px
    style LocalModel fill:#bbf,stroke:#333,stroke-width:1px
    style LocalModel2 fill:#bbf,stroke:#333,stroke-width:1px
设计优势很明显。
业务系统不用关心模型在哪。
只管发请求,剩下的交给网关。
模型集群也不用暴露端口。
只接受网关的单向调用。
这就把攻击面缩到了最小。
1.2 与同类方案的对比
很多人喜欢用开源网关直接改。
比如 Kong 或者 Nginx 加 Lua 脚本。
在内网环境,这俩不太够用。
| 方案 | 内网适配度 | 审计能力 | 模型感知 | 推荐指数 |
|---|---|---|---|---|
| 通用 API 网关 | 低 | 弱 | 无 | ⭐⭐ |
| 自研轻量网关 | 中 | 中 | 弱 | ⭐⭐⭐ |
| 企业级中台网关 | 高 | 强 | 强 | ⭐⭐⭐⭐⭐ |
通用网关不懂大模型。
它不知道什么是 Prompt 注入。
也不知道 Token 消耗怎么算。
自研的往往功能不全。
审计日志很难做到不可篡改。
只有企业级中台网关。
才把模型特性吃透了。
二、 快速上手
别整那些复杂的。
先跑通一个最小可运行示例。
假设你本地已经部署了一个 Llama 3 模型。
网关需要配置本地路由。
package com.dali.gateway.config;

import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

// 本地模型路由配置
@Configuration
public class LocalModelConfig {

// 定义本地模型地址
    // 内网环境严禁使用公网 IP
    @Bean
    public String localModelEndpoint() {
        // 指向内网私有 IP 段
        return "http://10.0.0.5:8080/v1/chat/completions";
    }

// 配置超时时间
    // 大模型生成慢,内网延迟也要考虑
    @Bean
    public int requestTimeout() {
        // 单位毫秒,30 秒超时
        return 30000;
    }
}
这代码看着简单。
但有个关键点。
localModelEndpoint 必须写死内网 IP。
千万别写 localhost。
网关和模型往往不在同一台机器。
写 localhost 会导致请求回环,直接超时。
三、 核心 API / 深水区
3.1 核心方法速查
网关暴露给业务方的接口,必须严格管控。
以下是核心 API 盘点。
| 方法名 | 功能描述 | 权限要求 | 审计级别 |
|---|---|---|---|
generateText | 文本生成 | 部门级 | 高 |
uploadContext | 上传上下文 | 项目级 | 中 |
getUsageReport | 获取用量报表 | 管理员 | 高 |
healthCheck | 健康检查 | 公开 | 低 |
注意 uploadContext。
内网环境上传文件,必须扫描病毒。
不能直接透传。
这是很多团队忽略的点。
3.2 生产级配置
异常处理和超时控制是命门。
内网环境一旦卡死,影响面很大。
package com.dali.gateway.service;

import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import org.springframework.stereotype.Service;

@Service
public class ModelInvokeService {

    private static final Logger logger = LoggerFactory.getLogger(ModelInvokeService.class);

public String invokeModel(String prompt, String userId) {
        try {
            // 记录调用开始时间
            long startTime = System.currentTimeMillis();

            // 模拟调用下游模型
            // 实际生产需替换为 HTTP 客户端
            String response = callDownstream(prompt);

            // 计算耗时
            long duration = System.currentTimeMillis() - startTime;

            // 记录审计日志
            // 内网审计要求保留至少 6 个月
            auditLog(userId, prompt, duration, "SUCCESS");

            return response;

        } catch (Exception e) {
            // 捕获所有异常,防止泄露堆栈信息
            logger.error("模型调用失败,用户: {}", userId, e);

            // 记录失败日志
            auditLog(userId, prompt, -1, "FAILED");

            // 返回统一错误码
            return "ERROR_CODE_500";
        }
    }

    private String callDownstream(String prompt) {
        // 这里实现具体的 HTTP 调用逻辑
        return "模拟回复";
    }

private void auditLog(String userId, String prompt, long duration, String status) {
        // 将日志写入不可篡改的存储
        // 比如 WORM 存储或专用日志库
        System.out.println("审计记录: " + userId + " | " + status);
    }
}
代码里有个细节。auditLog 必须异步执行。
不能因为写日志阻塞了主流程。
内网磁盘 IO 往往比较慢。
同步写日志会把接口拖垮。
3.3 高级定制
内网环境有个特殊需求:模型版本灰度。
你不能一次性把旧模型换成新模型。
得按部门切分流量。
public String getModelVersion(String department) {
    // 财务部门用稳定版
    if ("FINANCE".equals(department)) {
        return "MODEL_V1_STABLE";
    }
    // 研发部门用最新版
    if ("R&D".equals(department)) {
        return "MODEL_V2_BETA";
    }
    // 默认走旧版
    return "MODEL_V1_LEGACY";
}
这种逻辑要写在网关层。
业务方无感知。
切换模型时,只改网关配置。
不用重启业务系统。
四、 实战演练
来个真实场景。
某银行内网,要求大模型分析信贷报表。
数据绝对不能出内网。
且所有查询必须留痕。
业务系统发起请求。
网关拦截。
校验用户是否有“信贷分析”权限。
校验 Prompt 里有没有敏感词(如“绕过风控”)。
校验通过后,转发给本地模型。
模型返回结果。
网关对结果进行脱敏(如隐藏卡号中间位)。
最后返回给业务系统。
全程日志写入审计库。
// 模拟银行信贷分析场景
public class CreditAnalysisScenario {

public void run() {
        // 1. 构造请求
        String prompt = "分析以下信贷数据:卡号 6222001234567890,金额 50 万";
        String userId = "张经理";
        String dept = "CREDIT_DEPT";

        // 2. 网关前置处理
        if (!hasPermission(userId, "CREDIT_ANALYSIS")) {
            throw new SecurityException("权限不足");
        }

        // 3. 敏感词过滤
        if (containsSensitiveWord(prompt)) {
            throw new SecurityException("包含敏感指令");
        }

        // 4. 调用模型
        String result = modelService.invokeModel(prompt, userId);

        // 5. 结果脱敏
        String safeResult = maskCardNumber(result);

        // 6. 输出
        System.out.println("分析结果:" + safeResult);
    }

    private boolean hasPermission(String user, String action) {
        return true; // 模拟权限通过
    }

    private boolean containsSensitiveWord(String text) {
        return false; // 模拟无敏感词
    }

private String maskCardNumber(String text) {
        // 正则替换卡号中间位
        return text.replaceAll("(\\d{4})\\d+(\\d{4})", "$1****$2");
    }
}
这个流程里。
脱敏是最容易被忽视的。
模型可能会把训练数据里的卡号吐出来。
网关必须做最后一道防线。
五、 避坑指南与最佳实践
这几年踩过的坑,都在这儿了。
💡 技巧 1:模型权重文件校验
内网传输模型文件,容易被篡改。
部署前必须校验 SHA256 值。
别信厂商给的包,自己算一遍。
⚠️ 警告 2:日志脱敏不彻底
很多团队只脱敏了请求参数。
忘了脱敏响应结果。
大模型生成的内容里可能包含隐私。
网关必须扫描响应体。
✅ 推荐 3:网络策略最小化
网关和模型集群之间,只开必要端口。
比如只开 8080。
其他管理端口全部关闭。
用跳板机做运维审计。
💡 技巧 4:Token 计数本地化
别依赖模型返回的 Token 数。
内网环境可能返回不准。
网关自己实现一个 Token 计数器。
按字符数估算,误差可控。
⚠️ 警告 5:长连接超时
大模型生成慢,HTTP 长连接容易超时。
Nginx 或网关的 proxy_read_timeout 要调大。
不然请求发出去了,连接断了,业务方以为失败了。
六、 综合实战演示
下面是一套精简、闭环的网关核心代码。
包含鉴权、审计、调用、脱敏。
直接参考这个结构去搭。
package com.dali.gateway.core;

import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import org.springframework.stereotype.Component;

// 网关核心处理器
@Component
public class GatewayCoreProcessor {

    private static final Logger logger = LoggerFactory.getLogger(GatewayCoreProcessor.class);

// 处理完整请求链路
    public Response process(Request request) {
        // 1. 身份校验
        User user = authenticate(request.getToken());
        if (user == null) {
            return Response.error("UNAUTHORIZED");
        }

// 2. 审计前置记录
        AuditRecord record = new AuditRecord();
        record.setUserId(user.getId());
        record.setPrompt(request.getPrompt());
        record.setStartTime(System.currentTimeMillis());

try {
            // 3. 内容安全过滤
            if (!securityFilter.check(request.getPrompt())) {
                throw new SecurityException("内容违规");
            }

            // 4. 调用本地模型
            String rawResponse = localModelClient.call(request.getPrompt());

            // 5. 响应脱敏
            String safeResponse = dataMasker.mask(rawResponse);

// 6. 审计后置记录
            record.setResponse(safeResponse);
            record.setStatus("SUCCESS");

            return Response.success(safeResponse);

} catch (Exception e) {
            record.setStatus("FAILED");
            record.setError(e.getMessage());
            logger.error("网关处理异常", e);
            return Response.error("INTERNAL_ERROR");
        } finally {
            // 7. 异步写入审计日志
            auditService.asyncSave(record);
        }
    }

private User authenticate(String token) {
        // 模拟鉴权,内网通常对接 LDAP 或 内部 OAuth2
        return new User("user_001");
    }
}
这段代码逻辑很清晰。
try-finally 结构保证了日志一定落盘。
即使业务报错了,审计记录也得有。
这是合规的底线。
总结
内网部署大模型,安全是第一位的。
网关不是摆设,是守门员。
合规不是口号,是代码逻辑。
记住三点。
流量必须过网关。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 11
 0
- 0


 已为社区贡献11条内容

所有评论(0)