具身智能TL常用算法面经:基础认知与 VLA 框架(一)
01. 具身智能面试博客:基础认知与 VLA 框架
1. 基础概念速查表
| 概念 | 面试里应该怎么说 | 常见坑 |
|---|---|---|
| Embodied AI(具身智能) | 身体约束下的闭环交互智能,动作会改变下一步观测 | 只说“多模态 AI” |
| VLA(Vision-Language-Action,视觉-语言-动作) | 视觉/语言/状态条件下生成机器人动作 | 只把它当 VQA 或规划器 |
| Transformer(基于注意力机制的序列建模架构) | 用 attention(注意力机制)在 token 之间建模关系,是 VLM/VLA 的常见骨架 | 只会背“注意力”,不会讲 token、位置编码和延迟 |
| ViT(Vision Transformer,视觉 Transformer) | 把图像切成 patch token,再用 Transformer 编码 | 不知道 patch token 是什么 |
| VAE(Variational Autoencoder,变分自编码器) | 用 latent variable 表达数据背后的隐变量 | 以为它只用于图像生成 |
| CVAE(Conditional VAE,条件变分自编码器) | 在条件输入下生成目标,ACT 里常用它建模 action chunk 的多种风格 | 不知道为什么能避免平均动作 |
| MAE(Masked Autoencoder,遮挡自编码器) | 自监督重建任务,用来学视觉表征 | 以为它是“某个机器人模型名字” |
| Action Token(动作 token) | 把连续动作离散化成 token,便于接自回归 VLM | 忽略离散误差和延迟 |
| Action Chunk(动作块) | 一次预测未来 K 步动作,提升连贯性和吞吐 | chunk 越长越好是错的 |
| EEF Action(End-Effector Action,末端执行器动作) | 末端执行器位姿/增量,更直观、跨任务友好 | 需要 IK/控制器兜底 |
| Joint Action(关节动作) | 关节位置/速度,更贴近硬件 | 跨机器人迁移较差 |
| 快慢系统 | 慢系统做语义/规划,快系统做连续控制 | 误以为必须两个独立模型 |
| Embodiment(具身形态/本体差异) | 机器人身体形态、自由度、传感器、控制频率等差异 | 只理解成“机器人型号不同” |
| OOD(Out-of-distribution,训练外分布) | 测试样本超出训练分布 | 只把它当“泛化差” |
| BC(Behavior Cloning,行为克隆) | 直接模仿专家动作 | 只会说“监督学习” |
2. Q1:请用你自己的话讲一下,什么是具身智能?它和传统 CV/NLP、机器人控制有什么区别?
2.1 面试官问法
- 你怎么理解 embodied intelligence?
- 为什么说 VLA 不是简单的“视觉模型 + 语言模型 + 控制器”?
- 具身智能和传统机器人算法最大的差别是什么?
如果面试官用英文问,embodied intelligence(具身智能) 强调的是智能体有身体、有传感器、有执行器,并且会在环境中闭环行动。
2.2 考察点
面试官主要看三点:你是否理解“身体和环境交互”是核心;你是否能区分离线感知任务和闭环控制任务;你是否知道机器人学习的瓶颈在数据、泛化、安全和实时性。
2.3 30 秒回答
具身智能是让智能体通过身体、传感器和执行器,在真实或仿真环境中感知、理解、决策并行动的能力。它和传统 CV/NLP 最大的区别是输出不是标签或文本,而是会改变世界状态的动作;和传统控制最大的区别是,它更依赖大规模数据和学习到的语义泛化能力,而不是只依赖手工建模、规划和控制律。
2.4 2-3 分钟展开回答
我会从三个层面理解具身智能。
第一,它是闭环的。CV(Computer Vision,计算机视觉)可以只做识别,NLP(Natural Language Processing,自然语言处理)可以只生成文本,但机器人执行动作后会改变场景,下一帧观测又受上一动作影响,所以要考虑时序反馈、误差累积和安全边界。
第二,它是多模态的。实际系统通常有 RGB/RGB-D、多视角、语言指令、本体状态、力/触觉、历史动作等输入。模型不仅要“看懂”,还要把语义和可执行动作对齐。例如“把杯子放到盘子旁边”不是单纯识别杯子,而是要知道目标物、空间关系、可达性、抓取方式和放置约束。
第三,它是受身体约束的。不同机器人有不同自由度、夹爪、关节限位、控制频率和动力学特性。同一个语言目标在 Franka、xArm、双臂 ALOHA、人形机器人上的动作空间都不一样。因此具身智能不能只看高层语义,还要处理 embodiment(具身形态/本体差异)。
一个好的回答可以落到 VLA(Vision-Language-Action,视觉-语言-动作):Vision(视觉) 提供场景和目标,Language(语言) 提供任务语义,Action(动作) 把语义落到连续或离散控制命令。真正难点在于让 Vision、Language、Action 三者在数据、模型和部署闭环里一致。
2.5 常见追问
- 如果只用 VLM 识别目标,再接传统规划,是不是也算具身智能?
- 为什么机器人数据比互联网图文数据更难规模化?
- “泛化”在具身智能里具体指什么?
2.6 高分追问回答
VLM(Vision-Language Model,视觉语言模型) + 传统规划可以是具身系统的一种实现,但它通常更偏模块化:VLM 负责语义,规划器负责几何和动作,低层控制器负责执行。端到端 VLA 则试图直接从图像、语言和状态预测动作,优势是能从数据里学习一些难以手写的策略,劣势是可解释性、安全验证和 OOD(Out-of-distribution,训练外分布)鲁棒性更难。
泛化不能只说“换物体也能做”。机器人里的泛化至少包括物体泛化、场景泛化、语言泛化、视角泛化、任务组合泛化和 embodiment 泛化。面试时最好结合一个例子,例如模型在训练中见过“拿杯子”和“放碗”,测试时能不能完成“把红色杯子放到碗旁边”,这才体现语义组合和动作泛化。
3. Q2:VLA 是什么意思?Vision、Language、Action 三者怎么串起来?
3.1 面试官问法
- VLA 模型的输入输出是什么?
- Vision-Language-Action 是怎么对齐的?
- RT-2、OpenVLA、π0 这类模型本质上有什么共同点?
3.2 考察点
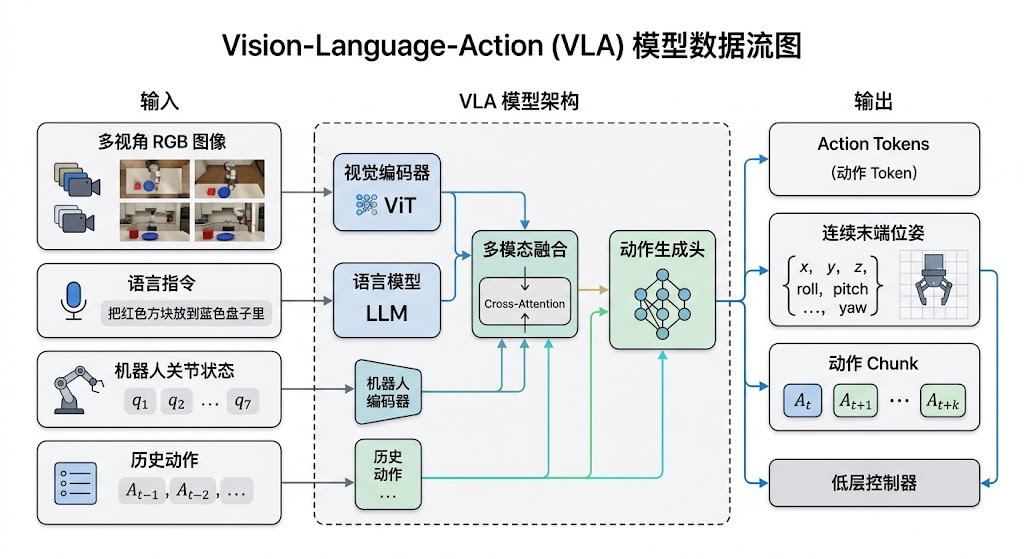
面试官在看你是否能讲清楚 VLA 的数据流,而不是只知道缩写。核心是:视觉和语言形成任务条件,机器人状态提供 embodiment 约束,动作头输出可执行控制。
3.3 30 秒回答
VLA 是 Vision-Language-Action。典型输入是多视角图像、语言指令、机器人当前状态和历史动作;模型先用视觉/语言 backbone(主干网络) 得到任务上下文,再由 action head(动作头) 输出下一步动作或未来一段动作 chunk。不同模型差别主要在动作表示:RT-2/OpenVLA 偏离散 action token,ACT/π0/GR00T/SmolVLA 更偏连续 action chunk 或 flow/diffusion 生成。
3.4 2-3 分钟展开回答
可以把 VLA 拆成四个模块,面试时要强调它不是 VQA,而是条件动作生成系统:
- 视觉编码:把相机图像编码成
token(离散序列单元)或feature(特征向量),常见backbone(主干网络)包括ViT(Vision Transformer,视觉 Transformer)、SigLIP(Sigmoid Loss for Language Image Pre-training,一种图文对齐视觉编码器)、CLIP(Contrastive Language-Image Pre-training,对比式图文预训练模型)、DINOv2(自监督视觉表征模型)或模型自带视觉塔。 - 语言编码:把自然语言任务变成
token embedding(词元向量表示),提供目标、约束和上下文。 - 状态融合:加入
proprioception(本体感知),例如关节角、末端位姿、夹爪开合、历史动作、base velocity(移动底盘速度)。 - 动作生成:输出离散 token、关节/末端连续控制、动作块或
latent action(潜在动作表示)。
RT-2 的代表性做法是把动作离散化成 token,使 VLM 可以像生成文本一样生成机器人动作。π0、GR00T、SmolVLA 则更强调连续动作生成,通常让VLM 负责语义理解,让 flow matching(流匹配,学习从噪声到动作的向量场) 或 diffusion transformer(扩散 Transformer 动作生成器) 这类 action expert 负责生成平滑的连续轨迹。
面试时可以补一句工程视角:VLA 不是输出“最终答案”,而是以一定频率反复输出动作,接到机器人低层控制器。真实部署时还要有安全检查、限幅、碰撞检测、fallback(失败兜底策略) 和动作平滑。
3.5 常见追问
- VLA 的 Action 是低层 torque(扭矩) 还是高层 trajectory(轨迹)?
- 为什么很多模型输出 action chunk,而不是只输出一个动作?
- 如果语言指令有歧义怎么办?
3.6 高分追问回答
**Action 粒度取决于系统设计。**大多数 VLA 不直接输出 torque(关节扭矩),因为 torque 对动力学和控制频率要求太高,安全风险也更大。常见输出是 end-effector delta pose(末端执行器位姿增量)、joint position/velocity(关节位置/速度)、gripper command(夹爪命令),或者未来 K 步动作序列。低层仍由 impedance controller(阻抗控制器)、position controller(位置控制器)、MPC(Model Predictive Control,模型预测控制) 或机器人 SDK 执行。
action chunk(动作块) 的作用是减少有效决策 horizon(时域长度),提高推理效率和动作连贯性。比如 ACT 和 RDT 都会预测一段未来动作。缺点是 chunk 太长会降低对新观测的反应速度,所以部署时常用 temporal ensemble(时间集成,融合多个重叠动作块)、receding horizon(滚动时域,只执行前几步再重规划) 或异步推理来平衡。
语言有歧义时,模型本身可能会猜,这在机器人里危险。工程上应加入澄清机制、任务约束解析、安全规则和低置信度 fallback。例如“拿那个杯子”但画面有多个杯子时,系统应该询问或默认选择最近/最显著目标,并让策略置信度参与决策。
4. Q3:大脑和小脑在具身智能里分别指什么?分层架构和端到端 VLA 各有什么优缺点?
4.1 面试官问法
- 你怎么看快慢系统?
- VLM 负责规划、policy 负责控制,这种架构是不是更合理?
- 端到端 VLA 会不会不可控?
4.2 考察点
这是架构判断题。面试官想看你是否知道系统可以分层,而不是把所有问题都交给一个大模型。
4.3 30 秒回答
“大脑”通常指高层语义理解、任务规划和长时序推理;“小脑”通常指低层连续控制、轨迹生成和快速反馈。分层架构更可控、更容易插入安全规则和传统规划;端到端 VLA 更容易从数据中学习复杂策略和跨任务泛化,但可解释性、实时性和安全验证更难。
4.4 2-3 分钟展开回答
快慢系统可以这样理解,核心是把低频语义推理和高频连续控制解耦:
- 慢系统:理解语言、识别目标、分解任务、选择技能、处理异常。频率可以低一些,几十到几百毫秒甚至秒级。
- 快系统:根据当前视觉/状态输出动作,保持轨迹平滑,处理扰动。频率通常更高,要求稳定和低延迟。
GR00T 这类模型就很适合作为例子:VLM 侧承担理解和推理,动作侧用 Diffusion Transformer 生成连续动作。SmolVLA 也有类似思想:VLM 提供上下文,flow matching action expert 生成动作块。
分层架构的优势是工程可控。你可以把任务规划、感知、动作生成、安全监控、低层控制拆开调试。缺点是模块接口会带来信息损失,例如高层只输出目标位姿,可能丢掉语言中的细粒度约束。
端到端 VLA 的优势是能利用大规模数据学习感知到动作的隐式映射,对复杂接触和非结构化场景有潜力。缺点是很难证明安全,失败时不容易定位是视觉、语言、动作头还是数据分布问题。
实际项目里我更倾向 hybrid(混合式架构):高层用 VLM/VLA 做语义和技能选择,中层用 learned policy(学习得到的策略模型) 生成动作,底层保留传统控制和安全约束。这样既能利用学习泛化,也保留工程兜底。
4.5 常见追问
- 长时序任务该用端到端还是分层?
- learned policy 和传统控制器怎么分工?
- 如果高层规划错了,低层能不能纠正?
4.6 高分追问回答
长时序任务一般不建议纯端到端一步到位。更稳的做法是把任务拆成 subgoal 或 skill,例如“找到杯子、接近、抓取、移动、放置、验证”。高层负责子目标和异常恢复,低层负责每个短技能的闭环执行。这样能降低 horizon,减少误差累积,也方便收集和标注数据。
learned policy(学习得到的策略模型) 不应该绕过低层安全控制。它可以输出期望末端增量、关节位置或轨迹,底层控制器负责限速、限幅、碰撞检查、关节限位和插补。这样即使模型输出有抖动,也不至于直接变成危险 torque。
5. Q4:常见动作表示有哪些?离散 action token、连续轨迹、action chunk 怎么选?
5.1 面试官问法
- RT 系列的离散动作 token 和 π0 的连续动作有什么区别?
- 为什么 ACT/RDT 要做 action chunk?
- 机器人 14 维动作一般是什么?还有其他表示方法吗?
5.2 考察点
这是 VLA 面试核心题。答得好说明你理解 action space,而不是只会讲模型名。
5.3 30 秒回答
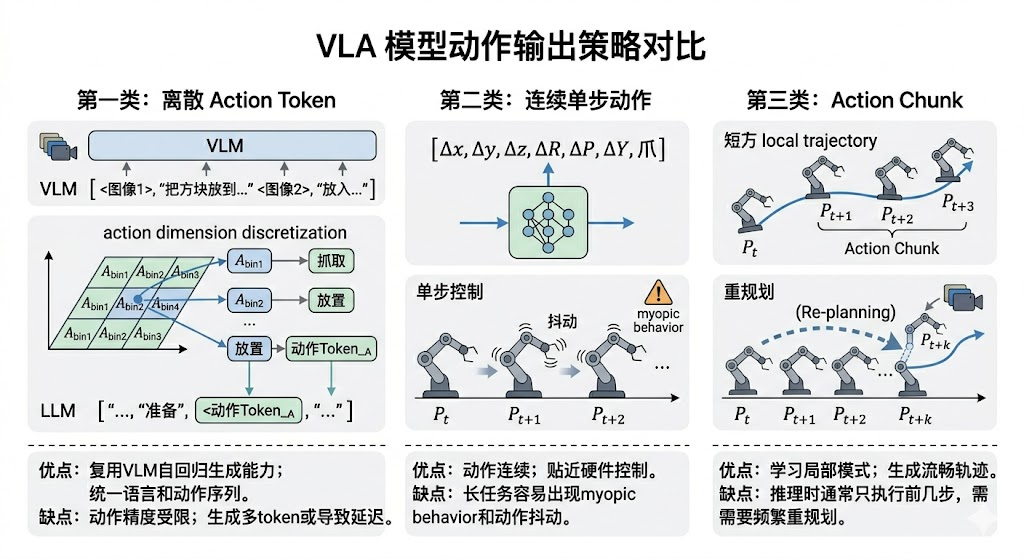
动作表示大致有三类:离散 token、连续单步动作、连续动作块。离散 token 方便接入自回归 VLM,但精度和速度受 tokenization(离散化/token 化) 影响;连续动作更适合机器人控制,可直接表示关节或末端轨迹;action chunk 一次预测未来 K 步,能减少推理频率和长时序误差,但 chunk 太长会降低反应性。
5.4 2-3 分钟展开回答
第一类是离散 action token。RT-2 把动作维度离散化,再映射到语言 token 空间。好处是可以复用 VLM 的自回归生成能力,把语言和动作统一成 token 序列。缺点是动作精度受离散 bin 限制,生成多个 token 也可能带来推理延迟。这个是把动作当成“单词”。要输出一个 7 自由度的动作,可能需要生成 7 个 Token( A 1 , A 2 , … , A 7 A_1, A_2, \dots, A_7 A1,A2,…,A7)。
第二类是连续单步动作。例如输出 delta x, delta y, delta z, delta roll, delta pitch, delta yaw, gripper,或者输出 joint position/velocity。它更贴近控制,但如果只预测一步,长任务里容易出现 myopic behavior 和动作抖动。这种模型会取出一个特定的特征向量(通常是最后一个 token 的输出或专门的 [ACTION] token),通过一个简单的 MLP(多层感知机)直接输出连续向量。模型只预测下一帧
t
+
1
t+1
t+1 的状态。
第三类是 action chunk。ACT、RDT、SmolVLA 等都会输出未来一段动作。chunk 可以看作短 horizon trajectory,让模型学习局部动作模式,比如“伸手抓取”不是单个点,而是一段连续轨迹。推理时通常只执行 chunk 的前几步,再用新观测重规划。在 Transformer 的输出端挂载一个专门的 Action Head(通常是 MLP 或轻量级扩散模型)。Transformer 只跑一次,提取出多模态特征,然后由 Action Head 一次性“喷”出一整个动作块(Chunk)。模型一次预测未来一连串动作轨迹(比如 t + 1 t+1 t+1 到 t + k t+k t+k)。它输出的是一个时空相关的序列
14 维动作常见于双臂或包含夹爪的系统。例如双臂各 7 维末端动作:每只手 3D translation + 3D rotation + gripper,合起来 14 维;也可能是双臂各 6/7 个关节位置,再加夹爪。面试时不能死记,要先说明“具体取决于项目定义”,再讲常见设计。
选择标准:
- 语言/语义推理强、动作精度要求中等:可以考虑离散 token。
- 高频连续控制、接触丰富、精度要求高:连续动作或 diffusion/flow 更合适。
- 长时序、推理开销大、希望动作平滑:action chunk 更合适。
- 跨机器人 embodiment:需要统一
action schema(动作格式/动作规范),或者使用 latent action /adapter(适配器)映射。
5.5 常见追问
- action chunk 增大时,如何平衡推理延迟与控制精度?
- joint space 和 EEF space 怎么选?
- gripper 或灵巧手动作怎么表示?
5.6 高分追问回答
chunk 越大,模型每次推理覆盖的未来越长,推理频率可以降低,动作也可能更连贯。但环境变化时,长 chunk 会让策略反应慢,特别是目标移动、接触状态变化或人机交互场景。实践上可以用 receding horizon:预测 K 步,只执行前 M 步;或者用 temporal ensemble 融合多个重叠 chunk,既保留平滑性,又提高反应性。
EEF space 末端空间更直观,适合抓取、放置、移动物体;joint space 关节空间更贴近硬件,能避免逆解不稳定和奇异点问题,但跨机器人泛化更差。复杂系统里常见做法是模型输出 EEF delta,底层 IK 或控制器转 joint command。
灵巧手通常需要更高维动作,可以输出关节位置、finger synergy(手指协同控制,把多个手指关节绑定成低维协同模式)、grasp primitive(抓取原语,预定义的基础抓取动作) 或 latent action。直接输出所有手指关节会增加数据需求和控制难度,所以很多系统会先用低维夹爪或预定义 grasp mode(抓取模式)。
6. Q5:Transformer、ViT 和 VLA 有什么关系?为什么基础面试经常问它?
6.1 面试官问法
- Transformer 的核心是什么?
- ViT 为什么能处理图像?
- VLA 里 token 数为什么会影响推理延迟?
6.2 考察点
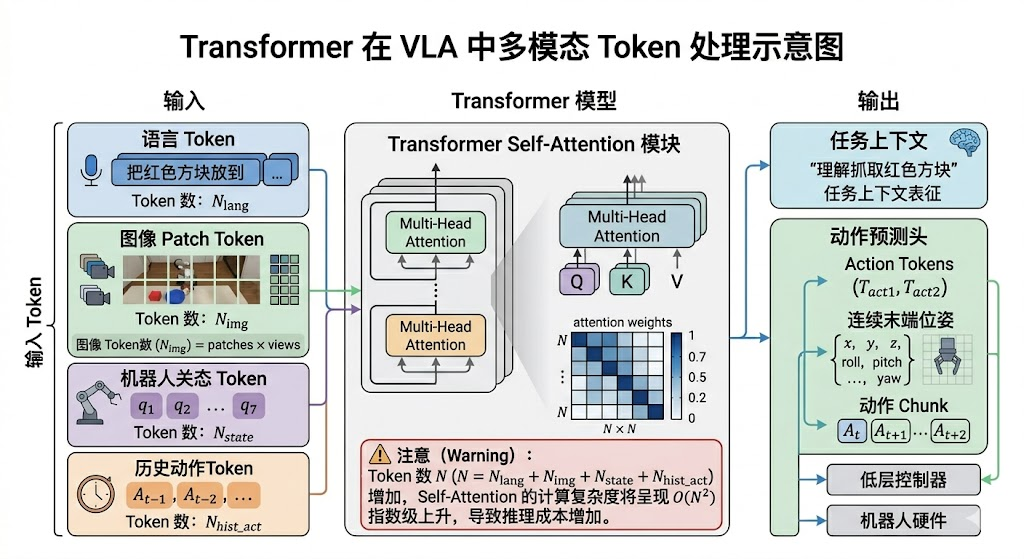
这是基础中的基础。面试官不是要你完整推导 Transformer,而是看你是否知道:VLA 里的图像、语言、历史动作和机器人状态,很多时候都会被整理成 token 序列,然后交给 Transformer 建模关系。
6.3 30 秒回答
**Transformer(基于注意力机制的序列建模架构)用 self-attention(自注意力)在 token 之间建立关系。**语言 token 表示词或子词,图像 token 可以来自 ViT 把图像切成 patch,机器人动作和状态也可以变成时序 token。VLA 里 token 数越多,attention 计算和显存越重,所以多相机、多帧历史、长指令都会影响实时性。
6.4 2-3 分钟展开回答
Transformer 的核心是 self-attention(自注意力)。它会让每个 token 去看其他 token,并根据相关性聚合信息。比如语言里“杯子”和“红色”要对齐,图像里目标物 patch 和语言目标要对齐,动作序列里当前动作要和历史动作保持连续。
ViT(Vision Transformer,视觉 Transformer) 的做法是把图像切成小块,也就是 patch(图像块),每个 patch 变成一个 token,再像处理文本一样送进 Transformer。这样图像也能用 attention 建模全局关系。
VLA 里 Transformer 的特殊点是 token 来源更复杂:
- 语言 token:来自任务指令。
- 图像 token:来自单视角或多视角图像 patch。
- 状态 token:来自关节角、末端位姿、夹爪状态。
- 时间 token:来自历史观测或 action chunk。
所以面试里要补一句工程结论:Transformer 能统一多模态序列,但 token 数会直接影响延迟和显存。 如果多相机高分辨率、长历史窗口全部塞进去,self-attention 的 O(n^2) 成本会让部署变慢。因此需要降采样、视觉 token 压缩、关键帧选择、cross-attention(跨注意力,用一类 token 查询另一类 token) 或分层架构。
6.5 常见追问
- self-attention 为什么是
O(n^2)? - ViT 的 patch size 变大或变小有什么影响?
- 多视角图像是拼 token 还是分别编码?
6.6 高分追问回答
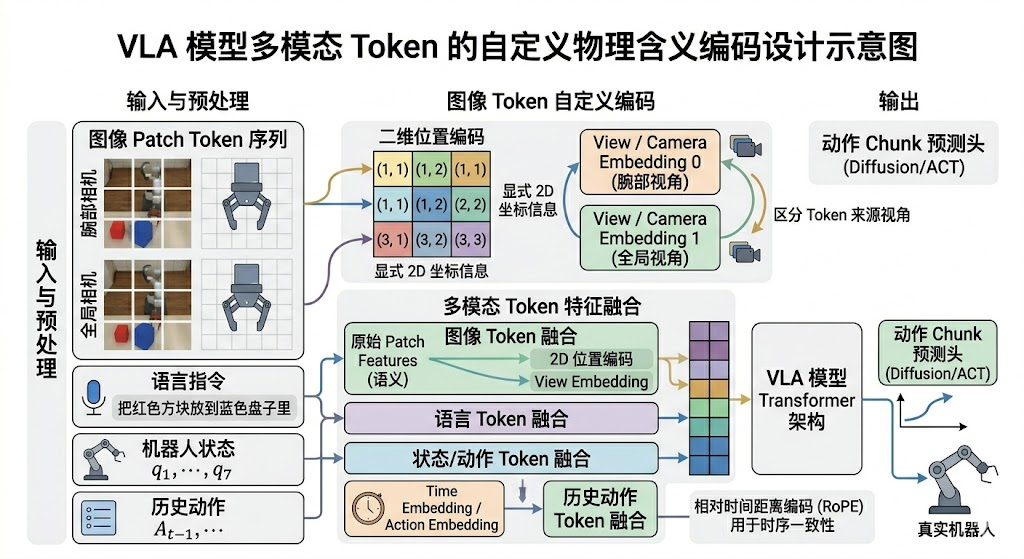
self-attention 要计算每个 token 和每个 token 的相关性,所以会形成 n x n 的注意力矩阵,复杂度随 token 数平方增长。patch size(图像块大小) 越小,细节更多但 token 更多;patch size 越大,速度更快但细节更粗。多视角可以共享 encoder(编码器) 后拼接,也可以分视角编码再融合,但一定要加 view embedding(视角嵌入) 或 camera pose,否则模型可能不知道每个 token 来自哪个相机。
7. Q6:ViT、CLIP/SigLIP/DINOv2 这些视觉编码器在 VLA 里怎么选?
7.1 面试官问法
- VLA 里的视觉 encoder 你会用哪个?
- CLIP、SigLIP、DINOv2、MAE 适合什么场景?
- 多视角是否共享 encoder?如何避免 view collapse?
7.2 考察点
面试官想知道你是否理解视觉表征和机器人控制的差异。机器人不是只做图像分类,它需要空间、接触、目标状态和动作相关特征。
7.3 30 秒回答
CLIP(对比式图文预训练)/SigLIP(Sigmoid Loss 图文预训练)强在图文语义对齐,适合语言条件任务;DINOv2(自监督视觉表征模型)强在视觉表征和局部结构,适合目标、部件和空间关系;MAE(Masked Autoencoder,遮挡自编码器)适合自监督预训练和多视角重建。VLA 里常用预训练视觉塔,再通过机器人数据微调或接 action head。多视角可以共享 encoder,但要保留 view embedding(视角嵌入) / camera pose(相机位姿),否则容易视角混淆。
7.4 2-3 分钟展开回答
CLIP 和 SigLIP 的优势是语义对齐,能把语言指令和图像目标联系起来。例如“拿红色杯子”需要视觉 token 对颜色、类别、语言有对齐能力。SigLIP 在很多新 VLM 中被用作视觉编码器,因为训练目标和扩展性对多模态模型友好。
DINOv2 更偏视觉自监督表征,通常对物体边界、局部结构、dense correspondence(稠密对应关系) 更友好。对于不依赖复杂语言但需要稳定视觉特征的 manipulation(操作/抓取类任务),DINO 类特征可能更有价值。
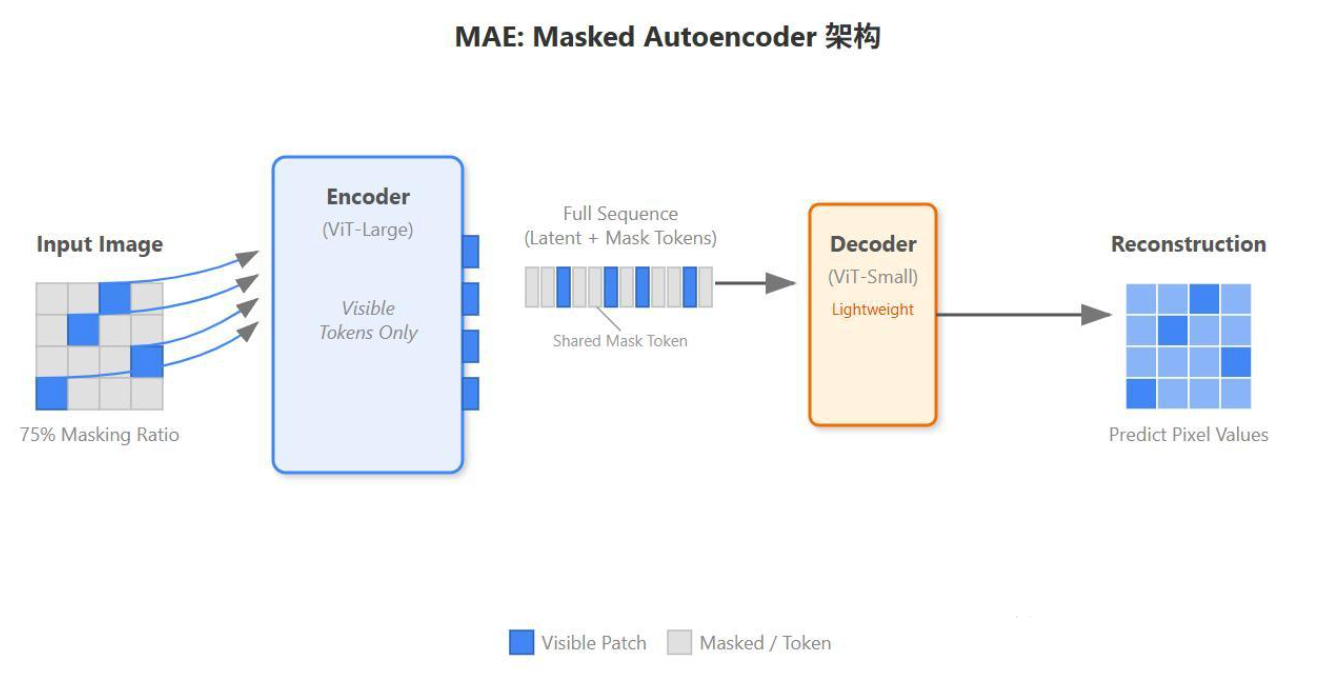
MAE 的价值在于自监督和重建,特别是多视角场景中,可以通过 masked reconstruction(遮挡重建) 学到几何和场景一致性。但 MAE 的表征未必天然和语言对齐,所以通常需要额外对齐或下游微调。经常会在VLA中被用于掩码掉其中一个视角的图像,尝试通过其他视角的图像来重建。来帮助模型建立 3D 几何一致性。
多视角是否共享 encoder 要看数据量和相机差异。如果视角相似或希望参数共享,可以共享 encoder,加 camera embedding(相机嵌入)、view embedding 或外参编码;如果 wrist camera(腕部相机) 和 third-person camera(第三视角相机) 差异很大,可以部分共享或分开编码。避免 view collapse(视角坍塌,模型忽略不同相机差异) 的关键是不要让模型把不同视角当成无差别图像,要显式注入视角身份,并在训练目标中保留每个视角对动作的贡献。
7.5 常见追问
- hard negative mining 在 vision-language 对齐中怎么做?
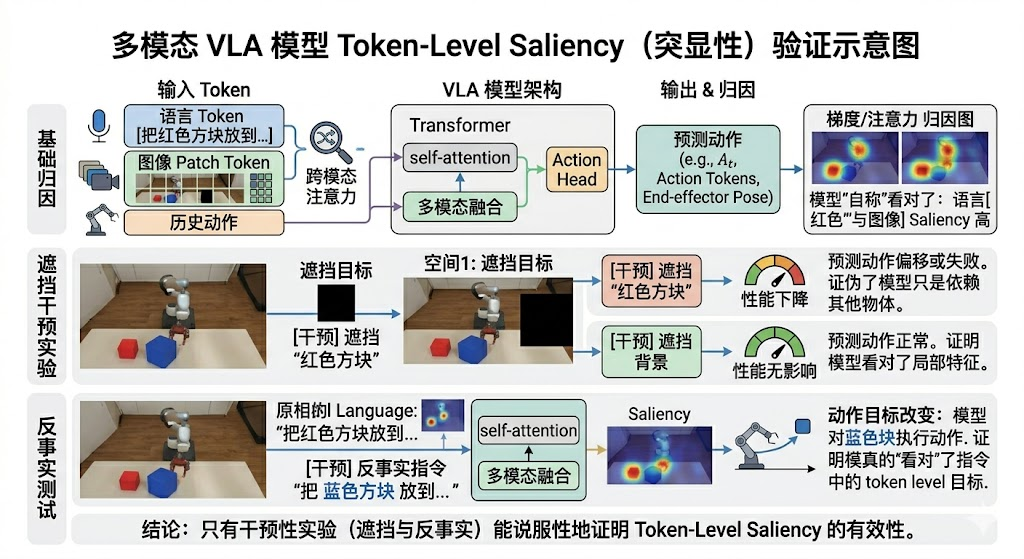
- token-level saliency 怎么证明模型看对了?
- 如果背景变化大怎么办?
7.6 高分追问回答
hard negative mining(困难负样本挖掘) 可以构造语义相近但动作不同的样本,例如“红杯子”和“蓝杯子”同时出现,语言只改颜色,正确动作目标必须变;或者同一场景中目标和 distractor(干扰物) 形状相似。训练时让正样本图文动作对靠近,负样本远离,或者用 contrastive loss(对比损失) / 分类辅助任务增强对齐。
saliency(显著性/关注区域) 可以看 cross-attention(跨模态注意力)、gradient-based attribution(基于梯度的归因)、遮挡实验和 counterfactual test(反事实测试)。真正有说服力的是干预:遮住目标物性能下降,遮住背景影响小;替换语言目标后注意力和动作目标也随之变化。
def compute_gradient_attribution(model, inputs, target_action_idx=0):
    model.zero_grad()

    # 开启特征层梯度检查
    features = model.vision_tower(inputs['pixel_values'])
    features.requires_grad = True

    # 前向传播得到 Action 预测
    outputs = model(inputs)
    action_logits = outputs.action_logits # 假设输出是离散 token

    # 针对预测出的动作计算梯度
    score = action_logits[0, target_action_idx]
    score.backward()

    # 获取特征图及其梯度
    grads = features.grad
    weights = torch.mean(grads, dim=(1, 2), keepdim=True)
    grad_cam = torch.sum(weights * features, dim=0).detach()

    return grad_cam
背景变化大时,不能只靠数据增强。还要保证数据覆盖、视觉预训练、目标显式 grounding(语义落地/把语言目标定位到具体物体)、多视角冗余和失败数据回流。对于部署,可以加入目标检测/分割辅助分支或 safety monitor(安全监控模块)。
8. Q7:Transformer 位置编码、RoPE、KV cache 在 VLA 里有什么用?
8.1 面试官问法
- 介绍绝对位置编码和 RoPE,为什么很多模型采用 RoPE?
- KV cache 的作用是什么?机器人里为什么要关心它?
- 自回归生成动作和非自回归生成动作在推理上有什么差异?
8.2 考察点
这是大模型基础和 VLA 部署的交叉题。答法要同时覆盖原理和机器人实时性。
8.3 30 秒回答
位置编码让 Transformer 知道 token 顺序。absolute positional encoding(绝对位置编码) 给每个位置一个固定或可学习 embedding;RoPE(Rotary Position Embedding,旋转位置编码) 通过旋转方式把相对位置信息注入 query/key,更适合长度外推和相对位置建模。KV cache(键值缓存) 缓存历史 token 的 key/value,避免自回归推理时重复计算。机器人里关心它,是因为动作 token 或语言规划的推理延迟会直接影响控制频率。
8.4 2-3 分钟展开回答
**Transformer 本身对 token 顺序不敏感,所以需要位置编码。**绝对位置编码简单,但如果测试长度超过训练长度,外推可能差。RoPE 把位置信息编码到 query/key(查询/键向量) 的旋转角度里,attention score(注意力分数) 会自然包含相对位置信息,因此在长上下文 LLM/VLM 中很常见。传统的绝对位置编码(如 BERT 的可学习编码)只告诉模型“我是第 3 个词”,而 RoPE 通过将向量在复平面上旋转,使得两个 Token 之间的点积(Attention Score)仅依赖于它们的相对距离
(
n
−
m
)
(n-m)
(n−m)。这样可以让模型不再死记硬背绝对位置,而是学会了“词与词之间的间距关系”,这更符合自然语言的逻辑。
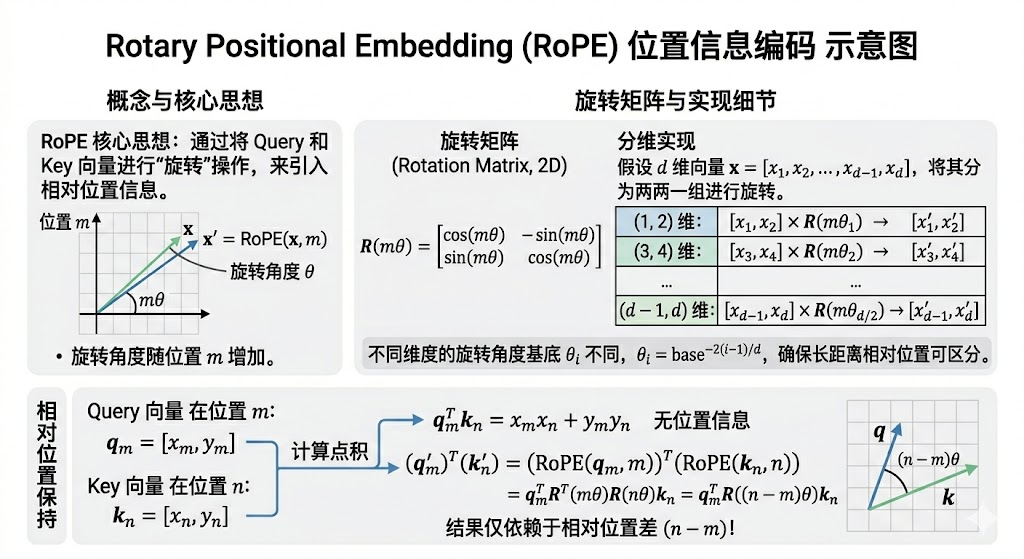
在 VLA 中,位置不只是一维文本位置,还包括图像 patch 位置、时间步位置、动作序列位置和多视角位置。图像 patch 需要二维空间信息,动作 chunk 需要时间顺序,历史观测需要时序位置。因此不能只说“位置编码用于文本”,而要说它帮助模型区分空间和时间结构。
KV cache 主要用于自回归推理。生成第 t 个 token 时,历史 token 的 key/value 不需要重复算,缓存后只算新增 token 。对于 RT-2/OpenVLA 这类 action token 方案,KV cache 能降低动作 token 生成延迟。但对于 diffusion/flow matching action head,生成方式不完全是标准自回归,KV cache 的收益要看 VLM 部分和 action expert 设计。
8.5 常见追问
- 为什么连续动作生成常比自回归 token 更适合实时控制?
- RoPE 对图像 token 是否足够?
- KV cache 会带来什么工程问题?
8.6 高分追问回答
自回归 token 需要逐 token 生成,如果一个动作要多个 token,延迟会叠加;连续动作生成可以一次输出一个 action chunk,更适合低延迟控制。代价是训练目标和动作分布建模更复杂,需要 diffusion、flow matching、CVAE 或回归损失。
RoPE 对文本和一维序列很好,但图像和机器人时序常需要额外设计,例如二维位置编码、view embedding、camera embedding、time embedding。多模态模型里位置编码不是一个统一答案,而是要匹配 token 的物理含义。
KV cache 会占显存,并且多相机高分辨率输入会让上下文 token 很多。部署时要控制图像 token 数、历史窗口长度、batching(批处理) 和 cache 生命周期,否则会影响实时性。
9. Q8:如果面试官问“你会怎么设计一个基础 VLA 系统”,应该怎么答?
9.1 面试官问法
- 从 0 到 1 设计一个语音/语言控制机械臂拿杯子的系统。
- 输入输出怎么定义?数据怎么采?模型怎么训?怎么部署?
- 你会选端到端还是模块化?
9.2 考察点
这是系统设计题。好的回答应该有清晰边界:任务定义、硬件输入、动作空间、数据、模型、训练、部署、安全、评测。
9.3 30 秒回答
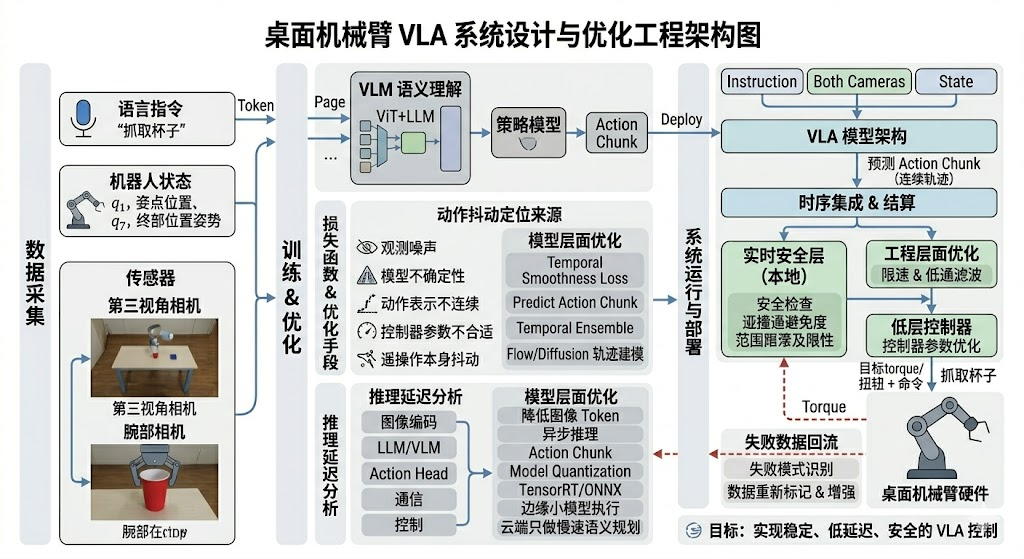
我会先做 hybrid VLA 系统:语言/VLM 负责目标理解和任务条件,策略模型负责输出短 horizon action chunk,底层控制器负责限速、IK(Inverse Kinematics,逆运动学)、碰撞和安全。输入包括多视角 RGB、机器人状态和语言指令;输出是 EEF delta pose(末端执行器位姿增量) + gripper 的动作块。训练先用遥操作数据做 BC/ACT 或 Diffusion/Flow policy,再用真实失败数据闭环迭代。
9.4 2-3 分钟展开回答
第一步定义任务和动作空间。比如桌面拿杯子,输入是 third-person camera、wrist camera、机械臂关节状态、夹爪状态、语言指令。输出可以是 dx, dy, dz, droll, dpitch, dyaw, gripper,每 100ms 输出一次未来 10-20 步 action chunk。
第二步采数据。用遥操作采集不同杯子、不同位置、不同光照、不同背景、成功和部分失败轨迹。每条数据保存时间戳对齐后的图像、状态、动作、语言任务、成功标记。数据质量比盲目堆量更重要,尤其要覆盖起始位姿和干扰物变化。
第三步选模型。起步可以用 ACT,因为训练快、数据需求低、工程闭环快。如果任务多、语言变化多,再考虑 VLA backbone + action expert,例如 OpenVLA/SmolVLA 风格。动作多峰明显或需要平滑轨迹时,可以用 Diffusion Policy 或 flow matching action head。
第四步部署。模型输出动作后不直接裸发给机器人,而是经过安全层:限幅、速度限制、工作空间限制、碰撞检查、夹爪状态机、急停。推理延迟要记录,包括相机采集、预处理、模型推理、通信、低层控制执行。
第五步评测。不能只报训练 loss,要报任务成功率、平均完成时间、碰撞/掉落率、OOD 物体成功率、语言改写成功率、扰动恢复能力和 E2E latency。
9.5 常见追问
- 如果数据只有 50 条 demo 怎么办?
- 如果动作抖动很大怎么办?
- 如果部署时推理太慢怎么办?
9.6 高分追问回答
50 条 demo 时不要一上来训练大 VLA。可以先用 ACT 或 Diffusion Policy 做单任务策略,强数据增强,严格控制任务范围;同时用预训练视觉 encoder 或开源 VLA 做 feature 初始化。评估发现失败模式后,定向补数据比随机加数据有效。
动作抖动要先定位来源:观测噪声、模型不确定性、动作表示不连续、控制器参数不合适、数据里遥操作本身抖动。模型层面可以加 temporal smoothness loss、预测 action chunk、temporal ensemble(时序集成)、flow/diffusion 轨迹建模;工程层面再加限速和低通滤波。不要只说“加滤波”,因为滤波会增加滞后,可能影响接触任务。
推理太慢时先拆 latency(延迟):图像编码、LLM/VLM、action head、通信、控制。优化手段包括降低图像 token、异步推理、action chunk、model quantization(模型量化)、TensorRT/ONNX、边缘小模型执行、云端只做慢速语义规划。实时安全相关计算必须在本地,不能依赖云端。
10. Q9:VLA 常用 benchmark 和 baseline 怎么讲?
10.1 面试官问法
- 你怎么评估一个 VLA 模型好不好?
- 常见 benchmark 有哪些?
- 你怎么证明你的方法比 baseline 好?
10.2 考察点
这是基础题和项目题的连接点。面试官不只想听你知道模型,还想看你是否知道机器人学习不能只看 loss,要看真实任务成功率、泛化和安全指标。
10.3 30 秒回答
VLA 评估要分三层:离线指标、仿真任务、真机任务。 离线可以看 action MSE、negative log likelihood / NLL(负对数似然)、轨迹相似度,但最终要看 task success rate(任务成功率)、完成时间、碰撞/掉落率、OOD 泛化和延迟。常见 benchmark(基准评测) 包括 LIBERO、Meta-World、ManiSkill、RoboCasa、BridgeData、DROID、Open X-Embodiment/RT-X 等,baseline(基线方法) 可以选 BC (行为克隆)、ACT、Diffusion Policy、OpenVLA 或任务内最强策略。
10.4 2-3 分钟展开回答
我会把评估分成四类。
第一类是 imitation learning(模仿学习) 的离线指标,比如 action MSE、BC loss(行为克隆损失)、NLL、轨迹 DTW(Dynamic Time Warping,动态时间规整) 距离。这些指标方便训练过程监控,但不能代表真实成功率,因为机器人动作可能多解,和专家轨迹不完全一致也可能成功。
Action MSE (均方误差)直接衡量模型预测的动作数值(如关节角度、末端位姿)与专家标签之间的欧氏距离。
Negative Log Likelihood / NLL (负对数似然)衡量专家动作在模型预测的概率分布下的可能性。NLL 越小,说明专家动作落在模型预测的高概率区间内。
轨迹相似度 (Trajectory Similarity)通过动态时间规整(DTW)或 Fréchet 距离等算法,衡量预测的 Action Chunk(动作块)序列与专家真实轨迹在整体形状上的匹配程度。
第二类是仿真 benchmark。LIBERO 适合看语言条件和长序列任务泛化;Meta-World 适合多任务 manipulation;ManiSkill 适合仿真操作和强化学习;RoboCasa 更偏家居场景和复杂任务组合。仿真优点是可复现、成本低,缺点是 sim-to-real gap。
第三类是真机 benchmark 或真实数据集评测。DROID、BridgeData、Open X-Embodiment 更适合讨论真实机器人数据、多 embodiment 和场景泛化。但如果只是离线 replay,仍然不能完全代表闭环执行效果。
第四类是部署指标:E2E latency、控制频率、GPU/显存占用、失败恢复次数、安全触发率。这些对真实系统很关键,但论文里不一定充分报告。
对比 baseline 时,不能只选弱 baseline。一个可信实验至少要有:简单 BC、当前主流方法如 ACT/Diffusion Policy、同等数据量下的开源 VLA、消融实验。面试里可以强调:如果我的改进是动作建模,就要固定视觉 backbone 和数据;如果改进是数据策略,就要固定模型结构,否则结论不干净。
10.5 常见追问
- 为什么 action MSE 低但真机成功率不一定高?
- LIBERO 和真实桌面抓取有什么差距?
- 如果你的方法成功率高但延迟也高,怎么判断值不值得?
10.6 高分追问回答
Action MSE 假设专家动作是唯一正确答案,但机器人任务经常是多解的。比如抓杯子可以从左侧接近,也可以从右侧接近,两个轨迹都成功,但 MSE 可能惩罚其中一个。因此生成式策略、CVAE、diffusion/flow 会更关注动作分布,而不是单一均值。
仿真 benchmark 的价值是快速比较算法和做消融,但真实部署还会遇到相机噪声、标定误差、接触不稳定、夹爪磨损、通信延迟和物体材质差异。所以最终要有小规模真机闭环测试。
延迟高不一定不能接受,要看任务频率。如果是高层语言规划,几百毫秒可以接受;如果是接触控制或动态避障,就必须低延迟。面试回答里要把模型推理频率和底层控制频率分开讲。
11. Q10:如果被问“你平时怎么跟进 VLA 技术”,应该怎么答?
11.1 面试官问法
- 你最近关注了哪些具身智能模型?
- π0、GR00T、SmolVLA、OpenVLA 这些工作你怎么看?
- 你如果要更新当前 VLA 架构,会从什么方向考虑?
11.2 考察点
这是技术视野题。面试官想看你是否能从论文名跳到技术趋势,而不是罗列模型。
11.3 30 秒回答
我会按三个维度跟进:动作生成范式、数据规模与数据质量、部署实时性。 模型上从 RT-2/OpenVLA 的 action token,发展到 ACT/Diffusion Policy 的 action chunk,再到 π0/GR00T/SmolVLA 这类 VLM + flow/diffusion action expert。趋势是高层语义用大模型,低层动作用连续生成模型,同时通过异步推理、轻量化和数据闭环提高真机可用性。
11.4 2-3 分钟展开回答
我会把最近的 VLA 进展理解为四条线。
第一条是动作表示从离散 token 走向连续轨迹。RT-2/OpenVLA 的好处是能复用 VLM 自回归框架,但机器人动作天然是连续控制,所以 π0、GR00T、SmolVLA 这类工作更强调 flow matching 或 diffusion action expert。
第二条是模型从单体端到端走向快慢系统。VLM 负责理解语言、目标和场景,action expert 负责连续动作。这样更符合工程分工,也方便替换低层策略或加入安全控制。
第三条是数据从实验室小数据走向跨 embodiment 和社区数据。Open X-Embodiment、DROID、LeRobot 社区数据都说明机器人数据的核心问题不是只有“量”,还有格式统一、任务标注、相机视角、动作 schema 和质量控制。
第四条是部署从离线指标走向实时系统。SmolVLA 这类轻量模型、异步推理、action chunk、边缘小模型都在解决“模型能不能在机器人上跑”的问题。
如果更新一个现有 VLA 架构,我会优先看三点:动作头是否从简单回归升级到 chunked diffusion/flow;数据是否有失败回流和 OOD 覆盖;部署是否支持异步推理和本地安全层。只有在这些基础做扎实后,再考虑更大的 VLM backbone。
11.5 常见误区
- 只说“模型越大越好”。机器人里数据、延迟、控制接口和安全比参数量更容易成为瓶颈。
- 只说“端到端是未来”。真实项目通常需要传统控制、安全层和任务状态机。
- 只引用榜单成功率,不说明任务、数据量、评测协议和硬件差异。
12. Q11:MAE 是什么?为什么多视角表征和关键帧重建会反复问到它?
12.1 面试官问法
- 你说的 MAE 是什么?
- 做 multi-view 表征时,你 mask 的是 patch 还是 token?
- 关键帧重建的帧怎么选?为什么不是随便抽帧?
12.2 考察点
这题看的是你是否把“视觉预训练”讲明白。面试官通常不是要你背 MAE 论文,而是看你是否理解:先遮掉一部分输入,再逼模型重建,模型会学到结构信息、几何信息和上下文依赖。
12.3 30 秒回答
**MAE 是 Masked Autoencoder,一种自监督视觉预训练方法。**做法是把图像里的大部分 patch 遮掉,只让模型根据剩余部分去重建被遮住的内容。机器人里常用它学多视角视觉表征,因为它能逼模型关注空间结构、物体边界和场景一致性。多视角时,patch-level masking 更常见;如果想让模型更关注任务相关区域,也可以做 token-level adaptive masking,优先保留或高权重采样关键区域。
12.4 2-3 分钟展开回答
MAE 不是一个“机器人模型”,而是一类自监督学习目标。它的核心思想很简单:如果模型能从部分图像推断出被遮住的内容,说明它学到了更深层的结构,而不是只记表面纹理。
为什么这对机器人有用?因为机器人看场景时经常遇到遮挡、多视角和局部可见。比如腕部相机可能只看到杯口的一部分,第三视角可能看到整张桌子。MAE 能帮助视觉编码器学到 “物体大概在哪里、边界怎么走、不同视角如何对应”。
在 multi-view 场景里,面试官常追问两点:
mask patch:这是最标准做法。图像先切成 patch,再随机遮掉一部分,让模型重建。token-level adaptive masking:这是更工程化的做法,按任务相关性或不确定性对 token 赋权。比如抓取任务中,目标物附近 patch 更重要,背景墙壁可以少看一点。
如果问关键帧选择,别说“随机抽”。正确回答是根据动作阶段和信息增益选帧。比如接近、抓取、抬起、放置四个阶段,关键帧应该覆盖阶段切换点,而不是等间隔切。一个更稳的做法是用 motion magnitude、视觉变化、夹爪状态变化或 reward 变化打分。
面试里如果你不确定细节,可以这样说:MAE 更适合作为视觉表征预训练,不一定直接决定策略性能,但它会影响后续 VLA 的 grounding 能力、跨视角一致性和下游 sample efficiency(样本效率,用更少数据学到有效策略的能力)。
12.5 常见追问
- 为什么 MAE 不直接等于更好的控制?
- token-level adaptive masking 和 hard negative mining 有什么关系?
- 多视角里如何避免某个视角被忽略?
12.6 高分追问回答
…详情请参照古月居

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 16
 0
- 0


 已为社区贡献166条内容

所有评论(0)