【大模型】4.3采用聚类和T-SNE来可视化
·
一、带逐行详细注释的完整代码
# 注释:该代码的核心功能是先对亚马逊评论的Embedding向量做KMeans聚类(分成3类),
# 再用T-SNE将高维向量降维到2维,最后通过散点图可视化不同聚类类别的分布,
# 核心目的是发现评论的语义聚类规律(无需人工标注,纯数据驱动分类)

# 导入pandas库,用于读取CSV数据集(包含Embedding向量)和数据处理
import pandas as pd
# 导入numpy库,用于数值计算(矩阵构建、维度处理)
import numpy as np
# 导入ast库,用于将字符串格式的Embedding向量转为Python列表
import ast
# 导入matplotlib.pyplot库,用于绘制散点图可视化聚类结果
import matplotlib.pyplot as plt
# 导入matplotlib核心库,用于配置颜色映射
import matplotlib
# 从sklearn的流形学习模块导入TSNE类,用于高维向量降维
from sklearn.manifold import TSNE
# 从sklearn的聚类模块导入KMeans类,用于对Embedding向量做无监督聚类
from sklearn.cluster import KMeans

# 设置matplotlib的字体为“SimHei(黑体)”,解决中文标签显示为方块的问题
plt.rcParams['font.sans-serif'] = ['SimHei']
# 解决负号“-”显示为方块的问题(绘图时坐标轴可能出现负号)
plt.rcParams['axes.unicode_minus'] = False

# 读取第一步生成的包含Embedding向量的CSV文件(路径需与之前一致)
df = pd.read_csv('datas/embedding_output_1k.csv')

# 新增embedding_vec列:将字符串格式的Embedding向量(如"[0.123,0.456,...]")转为Python列表
# ast.literal_eval()是安全的字符串解析方法,避免eval()的安全风险
df['embedding_vec'] = df['embedding'].apply(ast.literal_eval)

# 注释:T-SNE是非线性降维算法,能将1536维高维向量映射到2D/3D空间,方便可视化;
# nunique()用于统计某列不同值的个数,例如[1,1,1]的nunique()为1,确保所有向量维度一致

# 校验所有embedding_vec的长度是否相同(必须一致才能构建矩阵做聚类/降维)
# df['embedding_vec'].apply(len)计算每条向量的长度,nunique()==1表示所有向量维度相同(均为1536)
if df['embedding_vec'].apply(len).nunique() == 1:
    # 将所有Embedding向量列表垂直堆叠为二维numpy矩阵(形状:1000行 × 1536列)
    # 这是sklearn聚类/降维算法的标准输入格式(必须是矩阵而非列表)
    matrix = np.vstack(df['embedding_vec'].values)

    # 初始化KMeans聚类模型实例,配置核心参数
    # 3:聚类数量(将评论分为3类);init='k-means++':智能初始化聚类中心,避免局部最优
    # random_state=43:随机种子,保证每次聚类结果一致(可复现);n_init=10:运行10次KMeans取最优结果
    km = KMeans(3, init='k-means++', random_state=43, n_init=10)
    # 用1536维的Embedding矩阵训练KMeans模型(核心:计算聚类中心,给每条数据分配类别)
    km.fit(matrix)

    # 新增Kmeans_Label列:存放每条评论的聚类标签(0/1/2,对应3个类别)
    # km.labels_是模型训练后生成的类别标签,长度与数据集行数一致
    df['Kmeans_Label'] = km.labels_  # 把所有类别存放到新字段:0,1,2

    # 创建T-SNE降维模型实例,参数与上一节一致
    # n_components=2:降维到2维;perplexity=15:困惑度(控制近邻数量);random_state=42:固定随机种子
    # init='random':随机初始化;learning_rate=200:降维学习率
    tsne = TSNE(n_components=2, perplexity=15, random_state=42, init='random', learning_rate=200)

    # 对1536维的Embedding矩阵执行T-SNE降维,得到2维矩阵(形状:1000行 × 2列)
    matrix_2d = tsne.fit_transform(matrix)

    # 打印降维后的2维矩阵(每行是一条评论的2维坐标,如[5.6, -8.9]),验证降维成功
    print(matrix_2d)

    # ===================== 可视化聚类结果 =====================
    # 定义3种颜色,对应3个聚类类别(0→红,1→绿,2→蓝)
    colors = ["red", "green", "blue"]

    # 提取2维矩阵的第一列作为x轴坐标(所有评论的横向位置)
    x = matrix_2d[:, 0]
    # 提取2维矩阵的第二列作为y轴坐标(所有评论的纵向位置)
    y = matrix_2d[:, 1]

    # 获取聚类标签作为颜色索引(0/1/2直接对应colors列表的索引)
    colors_indices = df['Kmeans_Label'].values

    # 将自定义颜色列表转为matplotlib可识别的颜色映射对象
    color_map = matplotlib.colors.ListedColormap(colors)

    # 绘制散点图:x/y为降维后的坐标,c为聚类标签对应的颜色索引,cmap为颜色映射
    # 每个点代表一条评论,颜色区分聚类类别,位置反映语义相似度(同类别点大概率聚集)
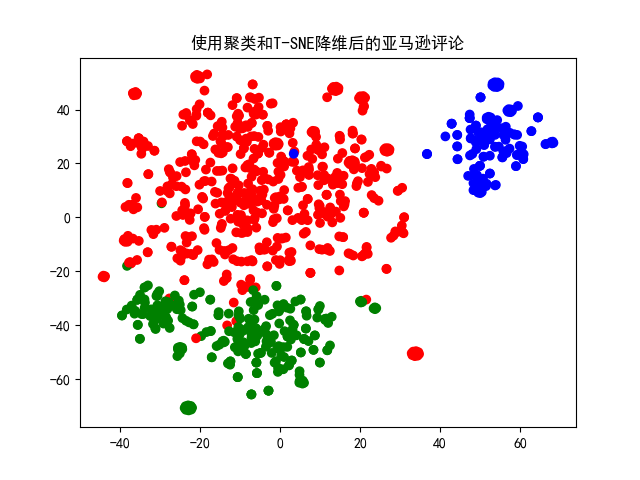
    plt.scatter(x=x, y=y, c=colors_indices, cmap=color_map)

    # 设置图表标题(显示中文需提前配置字体)
    plt.title('使用聚类和T-SNE降维后的亚马逊评论')

    # 显示绘制好的散点图(弹出窗口展示结果)
    plt.show()
二、核心知识点详解
1. 核心概念梳理
| 概念 | 通俗解释 | 关键说明 |
|---|---|---|
| KMeans聚类 | 一种无监督学习算法,将相似的数据自动归为若干类别(“簇”) | 1. 核心逻辑:先指定类别数k(本文k=3),迭代计算k个聚类中心,将每个数据分配到最近的中心所属类别 2. 无监督:无需人工标注“哪些评论是一类”,纯靠Embedding向量的语义相似度分类 3. 关键参数:k(类别数)、init(初始化方式)、n_init(运行次数) |
| 聚类标签(Label) | KMeans模型给每条数据分配的类别编号(本文是0/1/2) | 1. 标签无实际语义(如0不代表“好评”,仅代表“语义相似的一类评论”) 2. 同标签的评论Embedding向量距离更近,语义更相似 |
| T-SNE+KMeans组合 | 先聚类再降维可视化的经典流程 | 1. 为什么先聚类再降维:聚类基于原始高维向量(1536维),结果更准确;降维仅用于可视化 2. 核心价值:用聚类发现隐藏的语义类别,用T-SNE把类别分布直观展示在二维平面 |
| 无监督学习 | 无需人工标注标签的机器学习方法 | 1. 与“有监督学习(如分类、回归)”的区别:无标签、纯靠数据本身的特征聚类 2. 适用场景:探索数据的隐藏规律(如不知道评论有哪些类别,想自动发现) |
2. 所用库的详细说明(新增/重点库)
| 库名/模块 | 核心作用 | 本代码中关键用法 | 补充说明 |
|---|---|---|---|
| sklearn.cluster.KMeans | 实现KMeans聚类算法 | 1. KMeans(3, init='k-means++', random_state=43, n_init=10):创建聚类模型2. km.fit(matrix):用高维矩阵训练模型3. km.labels_:获取每条数据的聚类标签 | 1. init='k-means++':比随机初始化更优,避免聚类中心落在异常点2. n_init=10:运行10次KMeans,选择聚类效果最好的结果(降低局部最优风险)3. 类别数k需手动指定(本文k=3,可根据业务调整为5/8等) |
| numpy | 矩阵操作 | np.vstack():将列表形式的Embedding向量转为二维矩阵 | KMeans和T-SNE均要求输入为numpy矩阵,而非Python列表 |
| ast | 字符串解析 | ast.literal_eval():将字符串向量转为列表 | 读取CSV后Embedding向量默认是字符串,必须转换才能参与数值计算 |
| matplotlib | 可视化 | plt.scatter():绘制聚类结果散点图 | 颜色直接对应聚类标签,直观展示类别分布 |
3. Print函数与绘图说明
(1)Print函数说明
| 代码 | 输出内容 | 作用 |
|---|---|---|
print(matrix_2d) | 二维矩阵(如[[ 3.21 -5.43], [ 1.89 7.65], ...]) | 1. 验证T-SNE降维成功,输出每条评论的2维坐标 2. 可通过矩阵形状( print(matrix_2d.shape))验证是否为(1000,2),确保降维到2维 |
(2)绘图函数与可视化结果说明
| 代码 | 作用 | 预期可视化效果(图例说明) |
|---|---|---|
plt.scatter(x=x, y=y, c=colors_indices, cmap=color_map) | 绘制聚类散点图 |  核心特征: 1. 红色/绿色/蓝色点分别代表3个聚类类别; 2. 同颜色点大概率聚集在一起(说明同类别评论语义相似); 3. 不同颜色点基本分离(说明聚类效果好,类别间语义差异明显); 4. 若某颜色点分散在多个区域,说明k值(3)可能不合适,需调整 |
plt.title('使用聚类和T-SNE降维后的亚马逊评论') | 设置图表标题 | 标题清晰说明可视化的核心方法(聚类+T-SNE)和数据来源(亚马逊评论) |
plt.show() | 显示图表 | 弹出独立窗口展示散点图,可保存/缩放,直观观察聚类分布 |
4. KMeans关键参数解析(小白必懂)
| 参数 | 取值(本文) | 通俗解释 | 为什么这么设置 |
|---|---|---|---|
| n_clusters | 3 | 聚类的类别数(把评论分成3类) | 入门级设置,方便可视化;实际业务中可通过“肘部法则”确定最优k值 |
| init | ‘k-means++’ | 聚类中心的初始化方式 | 避免随机初始化导致聚类中心落在异常点,提升聚类效果 |
| random_state | 43 | 随机种子 | 固定种子后,每次运行代码的聚类结果完全一致,便于复现和调试 |
| n_init | 10 | 运行KMeans的次数 | 运行10次后取最优结果,降低“局部最优解”的风险(单次运行可能结果不好) |
三、总结
- 核心目标:通过KMeans对1536维的评论Embedding向量做无监督聚类(3类),再用T-SNE降维到2维,可视化不同聚类类别的语义分布;
- 关键步骤:读取向量数据→转换向量格式→构建高维矩阵→KMeans聚类(生成标签)→T-SNE降维→绘制颜色区分聚类的散点图;
- 核心注意点:
- KMeans的类别数k需手动指定,实际应用中可通过“肘部法则”选择最优k;
- 先聚类(高维)再降维(可视化)是最优流程,避免降维后聚类导致信息丢失;
- 聚类标签无直接语义,需结合评论文本分析每个类别的实际含义(如0类是“口感相关评论”,1类是“价格相关评论”)。
运行结果
[[ 11.009294   15.715658 ]
 [ 11.535578  -37.481087 ]
 [-35.892113   45.436775 ]
 ...
 [ 49.90143    19.138323 ]
 [-17.05342   -51.86057  ]
 [ -7.1301866 -44.626617 ]]

进程已结束,退出代码为 0

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 12
 0
- 0


 已为社区贡献21条内容

所有评论(0)