大模型第四期:一篇文章带你看清Transformer的真面目
众所周知,“2017年,谷歌颠覆性的提出基于自注意力机制的Transformer架构”,引领自然语言处理的新浪潮,如BERT、GPT系列适用于复杂的语言理解和生成任务。现代社会大模型基本都是基于transformer架构训练而成。
首先记住一句话:
注意力机制抓关联、多层堆叠控深度、残差连接稳训练
基本原理:基于【自注意力机制】,能同时捕获序列中所有位置的关联信息,通过【多头注意力】和【位置编码】解决了RNN的并行性和长程依赖问题,是当前LLMs的基础架构。
其实在我看来,transformer解决了最重要的一件事---解决了RNN串行效率极慢、长程依赖的问题,如果RNN是一个流水线,所有的中间处理过程都依赖前一层的隐藏特征,transformer就是开了一个圆桌会议,通过给所有词位置编码确定顺序,自注意力机制让所有词自主寻找其他词与之的关联度,并发速度快、上下文不容易丢失。
下面从四方面讲解transformer的原理,也就是transformer的四个组成部分
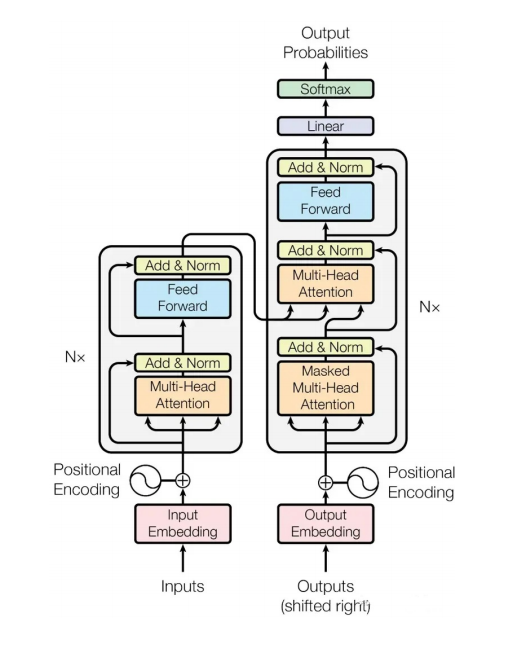
一、输入层:词嵌入+位置编码
1、词嵌入层input embedding:对所有输入的词语转换成高维向量
为什么要转向量呢?简单来说,模型不认识“文字”,必须映射成数字也就是向量让模型识别到每个词的独特特征
转向量前需要做什么?使用分词工具将句子切割成一个个“词组”,当然英语就不需要切词了,每个单词就是一个词语
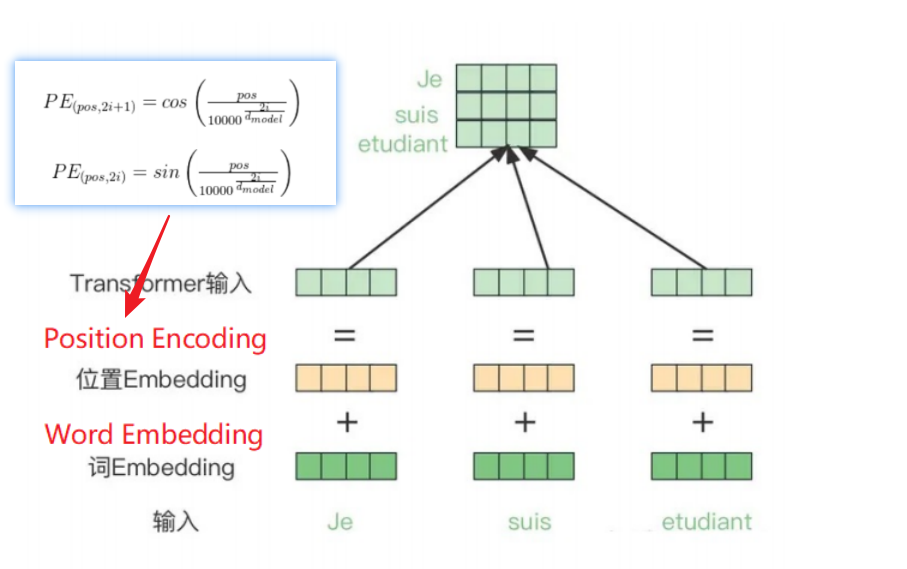
2、位置编码 position embedding
使用正弦余弦公式,为每个词向量加上一个独特的位置信号,偶数位做正弦、奇数位做余弦
为什么要做位置编码?自注意力机制本身不具备感知词序的能力,主要有绝对位置编码(正余弦波、学习参数)和相对位置编码(词间关系)两种思路
为什么使用三角函数做位置编码?1)值在(-1,1)模型训练稳定 ; 2)不受句子长短影响
二、编码器结构(6层堆叠):多头注意力+前馈神经
编码器负责文本理解,代表模型bert
输入部分经过转向量和位置编码后 ,此时输入就是一个携带了位置编码的高维向量了,在论文中此时输入时512维向量。数据直接进入编码器多头注意力部分。
1、多头注意力机制+残差连接add+归一化norm
组成:多头注意力+残差连接+层归一化
流程1:分发任务
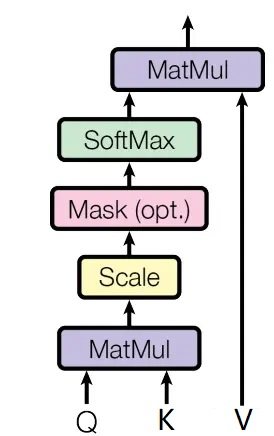
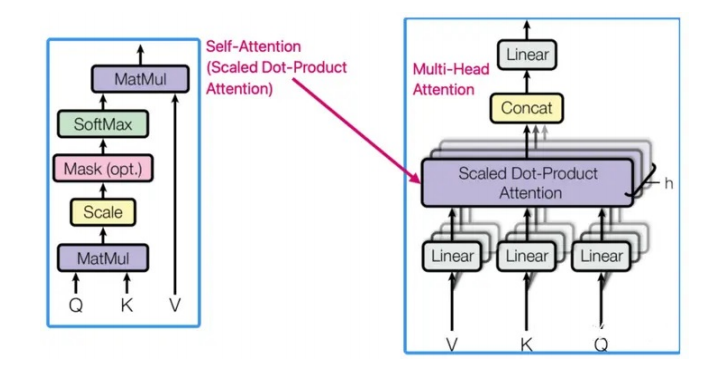
每个多头注意力包括8个自注意力模块,需要将输入的512维向量均匀分成8份进入每个自注意力模块中,每个模块再使用不同权重矩阵相乘生成Query(查询:我想找什么)、Key(键:可匹配的特征)、Value(值:本质信息)3个向量(64维)
如下图所示
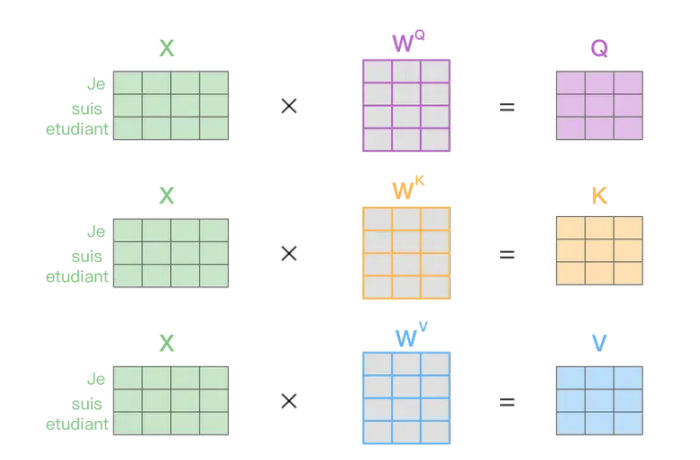
流程2:并行计算
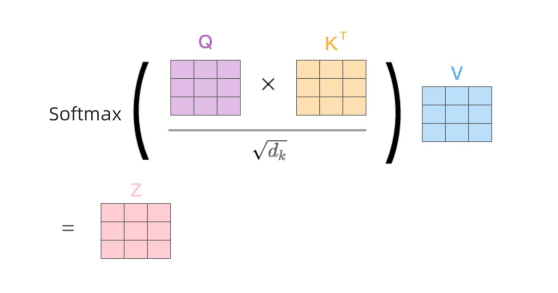
独立计算注意力:计算单词Q 和 所有K的点积,再缩放消除量纲,最后Softmax:将分数归一化为概率分布
加权求和,加上V(实际信息),输出融合位置和关联度的向量
流程3:拼接投影
沿着最后一个维度将8个头的输出矩阵拼接起来和权重相乘,得到512维的向量
流程4:残差链接
将原始向量(词嵌入+位置编码)加在多头注意力层的输出,防止信息变质或丢失
流程5:层归一化
对相加后的结果进行层归一化(均值0方差1),稳定其数据分布,让后续的计算更加平稳
2、前馈神经网络+残差连接add+归一化norm
1)前馈网络引入非线性ReLU激活函数,为模型增加表达力
标准FNN前馈网络:构成是两个全连接网络层,中间添加relu激活函数,
流程:线性升维->relu->线性降维(512维->2048维->512维)
作用:对向量每个位置上进行非线性变换,增强模型的表达能力
2)残差连接add+归一化norm:
将上一层归一化输出结果加在前馈网络输出中,防止变质、丢失
注意:编码器的输出结果会直接到解码器的多投注意力
三、解码器结构
解码器负责文本生成,代表模型GPT
解码器decoder6个解码器堆叠而成,每个掩码器包括 掩码注意力+多头注意力+前馈网络
1、掩码多头注意力+残差连接add+归一化norm
掩码的输入:在训练时就是训练集数据、正式环境就是用户输入
输入是目标语言的序列,为了训练,它被“右移”,并在开头加上起始符号<start〉,例如要生成“| love ai”输入是<start>ilove,输出是love ai<end>目的是让模型学会预测下一个词“Al”
确保每个位置只能注意到自身及之前的序列,防止解码时信息泄露。这种设计既增强了特征提取能力,又保持了自回归生成的时序约束
为什么需要掩码注意力?为了生成通顺语句、满足自回归的任务。
2、多头注意力+残差连接add+归一化norm
Q来自解码器上一层输出加权、K、V来自编码器的输出加权
为什么解码器需要多头注意力?参考源句信息,翻译、摘要这类“输入 → 输出”任务
3、前馈神经网络+残差连接add+归一化norm
同编码器该部分
四、输出部分
1、线性层 :
将解码器输出的高维特征向量映射到词表大小维度,为每个可能的词生成一个“原始分数”(logits)
2、多分类激活函数softmax:
将线性层的logits转换概率分布,选择概率最大的词

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 18
 0
- 0


 已为社区贡献3条内容

所有评论(0)