机器学习相关算法
一、概念
其核心是让计算机系统通过数据自动学习规律,并基于这些规律进行预测或决策,而无需显式编程。
-
有监督学习:使用带有标签的数据进行训练,如分类和回归。
如:knn,线性回归,逻辑回归,决策树,集成学习等算法
-
无监督学习:使用无标签数据,如聚类和降维。
-
半监督学习:结合少量有标签数据和大量无标签数据。
如:数据标注
-
强化学习:智能体通过与环境交互获取奖励,学习最优策略。
如:Agent+环境+奖励+反馈+代理
二、核心算法
1、有监督学习
(1)KNN(k-近邻):物以类聚,人以群分,通过距离远近来判断
(2)线性回归(回归算法):线性方程拟合数据,线 性
(3)逻辑回归(分类算法):线性回归+激活函数sigmoid+阈值
(4)决策树 (分类 + 回归):树形结果拟合数据,树节点-特征 叶子节点-分类
代表算法:id3,c4.5,CART 分裂方法不一样
(5)集成学习:
俩大核心思想:
1.bagging思想:装袋法 +有放回采样+平权投票+并行训练
算法:随机森林算法(RF)RandomGorest

2.Boosting思想:提升法+加权投票+串行训练
算法:AdaBoost GBDT XGBoost
关注上一个基学习器的不足

(6)朴素贝叶斯(概率统计)
2.无监督学习
聚类算法:根据样本之间的相似度划分成
算法:k-means
机器学习的定义:
样本:一条数据
特征:每个样本有多个特征
标签:要预测的东西
数据集:
训练集--训练阶段
验证集--训练阶段
测试集--测试阶段
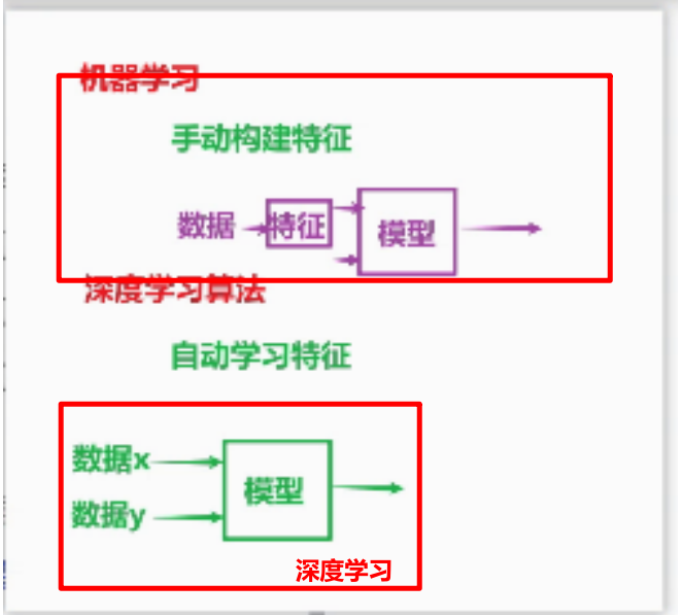
三、深度学习和机器学习的区分
机器学习:通过我们人类直接告诉机器,特征是什么,投入数据,进行训练。
深度学习:我们只需要投入数据,机器会根据数据的特征自动学习相关特征。
四、特征工程
特征工程分为五个子模块:
1.特征提取:我们拿到数据后,需要告诉模型什么是特征
2.特征预处理:这里主要是出现量纲个问题,模型会优先认为大数字的特征比较重要,所以这里需要进行处理
3.特征选择:一个事物有多个特征,通过需要筛选出强关联的特征,使模型训练的效果更好
4.特征降维:分析一个事务那些是主要成分
5.模型组合:可以通过特征组合,实现强相关

五、KNN算法详解
定义:通过计算距离,来预测数据属于那个分类,这里分为俩种类型,一种是分类(筛选出距离最近的几条数据,特征最多的数据),一种是回归(平均值计算)。
大量少排:通过计算距离样本的远近,先设置取距离预测数据最近的几条数据,进行排列,判断数据那种类型
平均值通过计算距离每个样本的距离,取平均值,最后看离那个样本近,就属于那个样本所属的区域。
这里我们使用的是欧氏距离计算远近,通过欧氏距离我们可以详细的算出与样本的差值。
六、数据集相关查看

七、模型训练过程
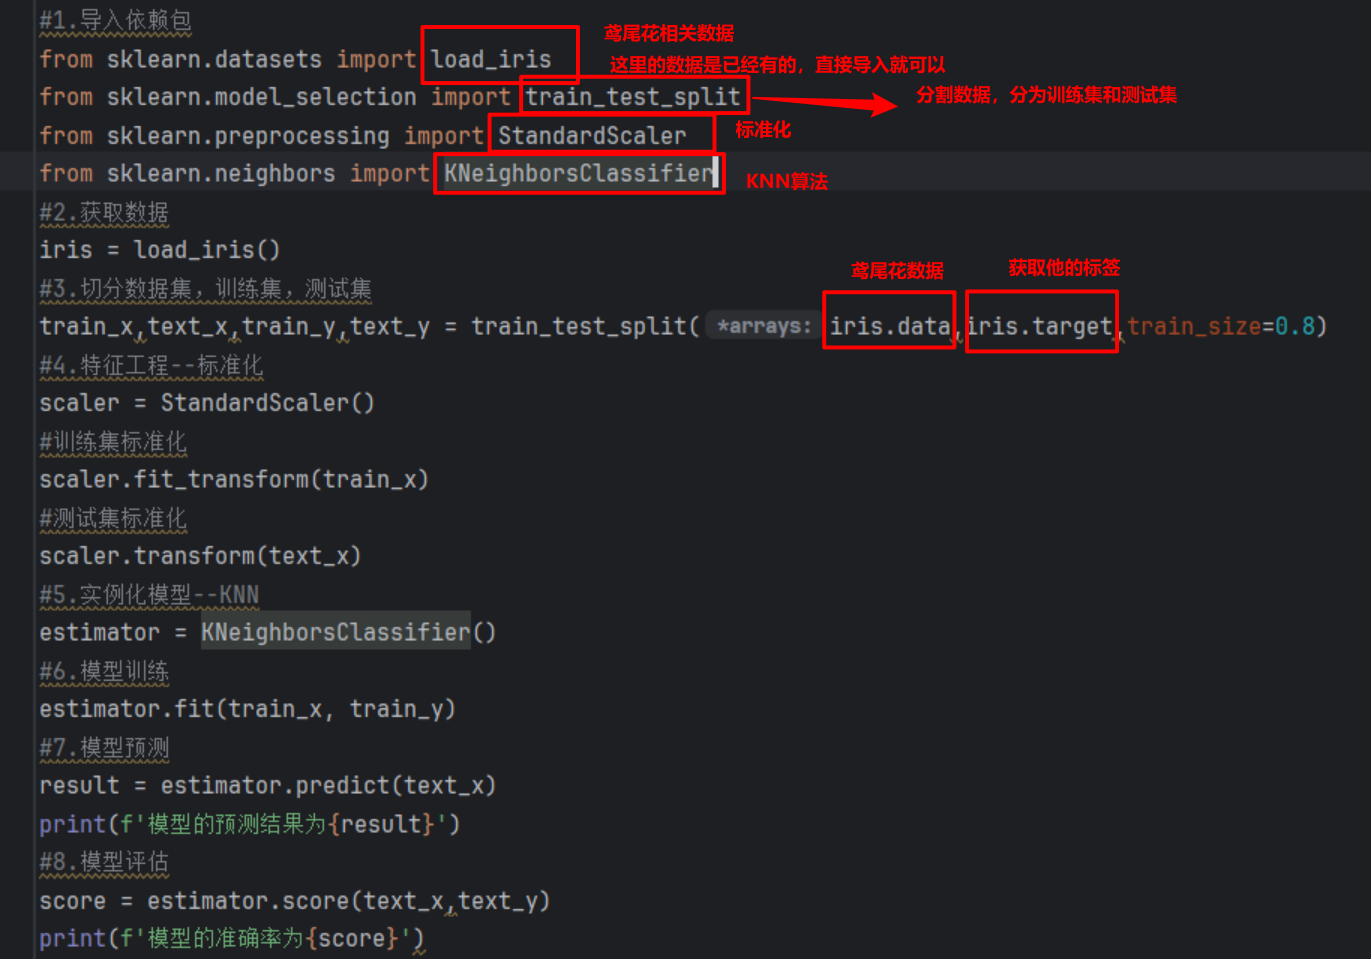
1.先进行导包,我们需要进程conda环境导入pip install scikit-learn这个包,然后在pycharm中导入,因为机器学习中的东西大部分都在sklearn中。
2.通过sklearn.datasets导入鸢尾花的数据集,并实例化
3.切分数据集,分为训练集和测试集
4.进行特征工程处理
5.算法实例化,我们这里用的是KNN
6.模型训练
7.模型预测
8.模型预估
9.相关包的详细介绍


有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐

 25
 0
- 0


 已为社区贡献2条内容

所有评论(0)