Linux I/O 模型详解与同步/异步、阻塞/非阻塞辨析
一、 Linux I/O 模型
Linux 系统提供了多种 I/O 模型来处理输入输出操作,主要区别在于数据准备阶段(等待数据从设备到内核缓冲区)和数据拷贝阶段(从内核缓冲区到用户缓冲区)的不同处理方式。
1. 阻塞 I/O(Blocking I/O)
-
工作流程:
-
进程调用
read()系统调用 -
内核等待数据准备(阻塞)
-
数据准备好后,内核拷贝数据到用户空间(阻塞)
-
数据拷贝完成,
read()返回,进程继续执行
-
-
特点:两个阶段都阻塞,简单易用,但并发性差
2. 非阻塞 I/O(Non-blocking I/O)
-
工作流程:
-
进程调用
read(),文件描述符设为O_NONBLOCK -
如果数据未准备好,立即返回
EAGAIN错误(不阻塞) -
进程需要轮询检查数据是否准备好
-
数据准备好后,内核拷贝数据到用户空间(阻塞)
-
-
特点:第一阶段不阻塞,第二阶段阻塞,需要轮询,CPU占用高
3. I/O 多路复用(I/O Multiplexing)
-
工作流程:
-
进程调用
select()/poll()/epoll()等待多个文件描述符 -
select() 阻塞等待,直到一个或多个fd就绪
-
进程遍历就绪的fd,调用
read()读取数据 -
内核拷贝数据到用户空间(阻塞)
-
-
特点:第一阶段阻塞在select,第二阶段阻塞,单线程可管理多个连接
-
核心函数:
-
select():有fd数量限制(1024),效率随fd数线性下降 -
poll():无数量限制,但效率问题类似select -
epoll():Linux特有,效率高,支持边缘触发和水平触发
-
4. 信号驱动 I/O(Signal-driven I/O)
-
工作流程:
-
进程设置信号处理函数(
SIGIO) -
内核在数据准备好时发送信号
-
进程在信号处理函数中调用
read() -
内核拷贝数据到用户空间(阻塞)
-
-
特点:第一阶段不阻塞,第二阶段阻塞,使用较少
5. 异步 I/O(Asynchronous I/O,AIO)
-
工作流程:
-
进程调用
aio_read()提交请求 -
立即返回,继续执行其他任务
-
内核自动完成数据准备和数据拷贝
-
内核通知进程操作完成(通过信号或回调)
-
-
特点:两个阶段都不阻塞,真正的异步
-
实现:Linux 原生 AIO(
libaio)和 POSIX AIO
二、 同步 vs 异步 vs 阻塞 vs 非阻塞
概念辨析
1. 阻塞 vs 非阻塞
关注点:等待时的进程状态
| 类型 | 核心特征 | 比喻 |
|---|---|---|
| 阻塞 | 调用后必须等待结果,进程被挂起(sleep) | 排队买奶茶,必须原地等做好 |
| 非阻塞 | 调用后立即返回,不等待结果,进程继续执行 | 下单后去逛商场,不时回来查看 |
-
关键判断:函数调用是否立即返回
-
场景:主要描述函数调用的行为
2. 同步 vs 异步
关注点:消息通知机制
| 类型 | 核心特征 | 比喻 |
|---|---|---|
| 同步 | 调用者主动等待/查询结果 | 自己不断检查快递状态 |
| 异步 | 被调用者主动通知调用者结果 | 快递员送货上门通知你 |
-
关键判断:结果获取是主动获取还是被动通知
-
场景:描述整个任务完成的通信方式
四象限图分析
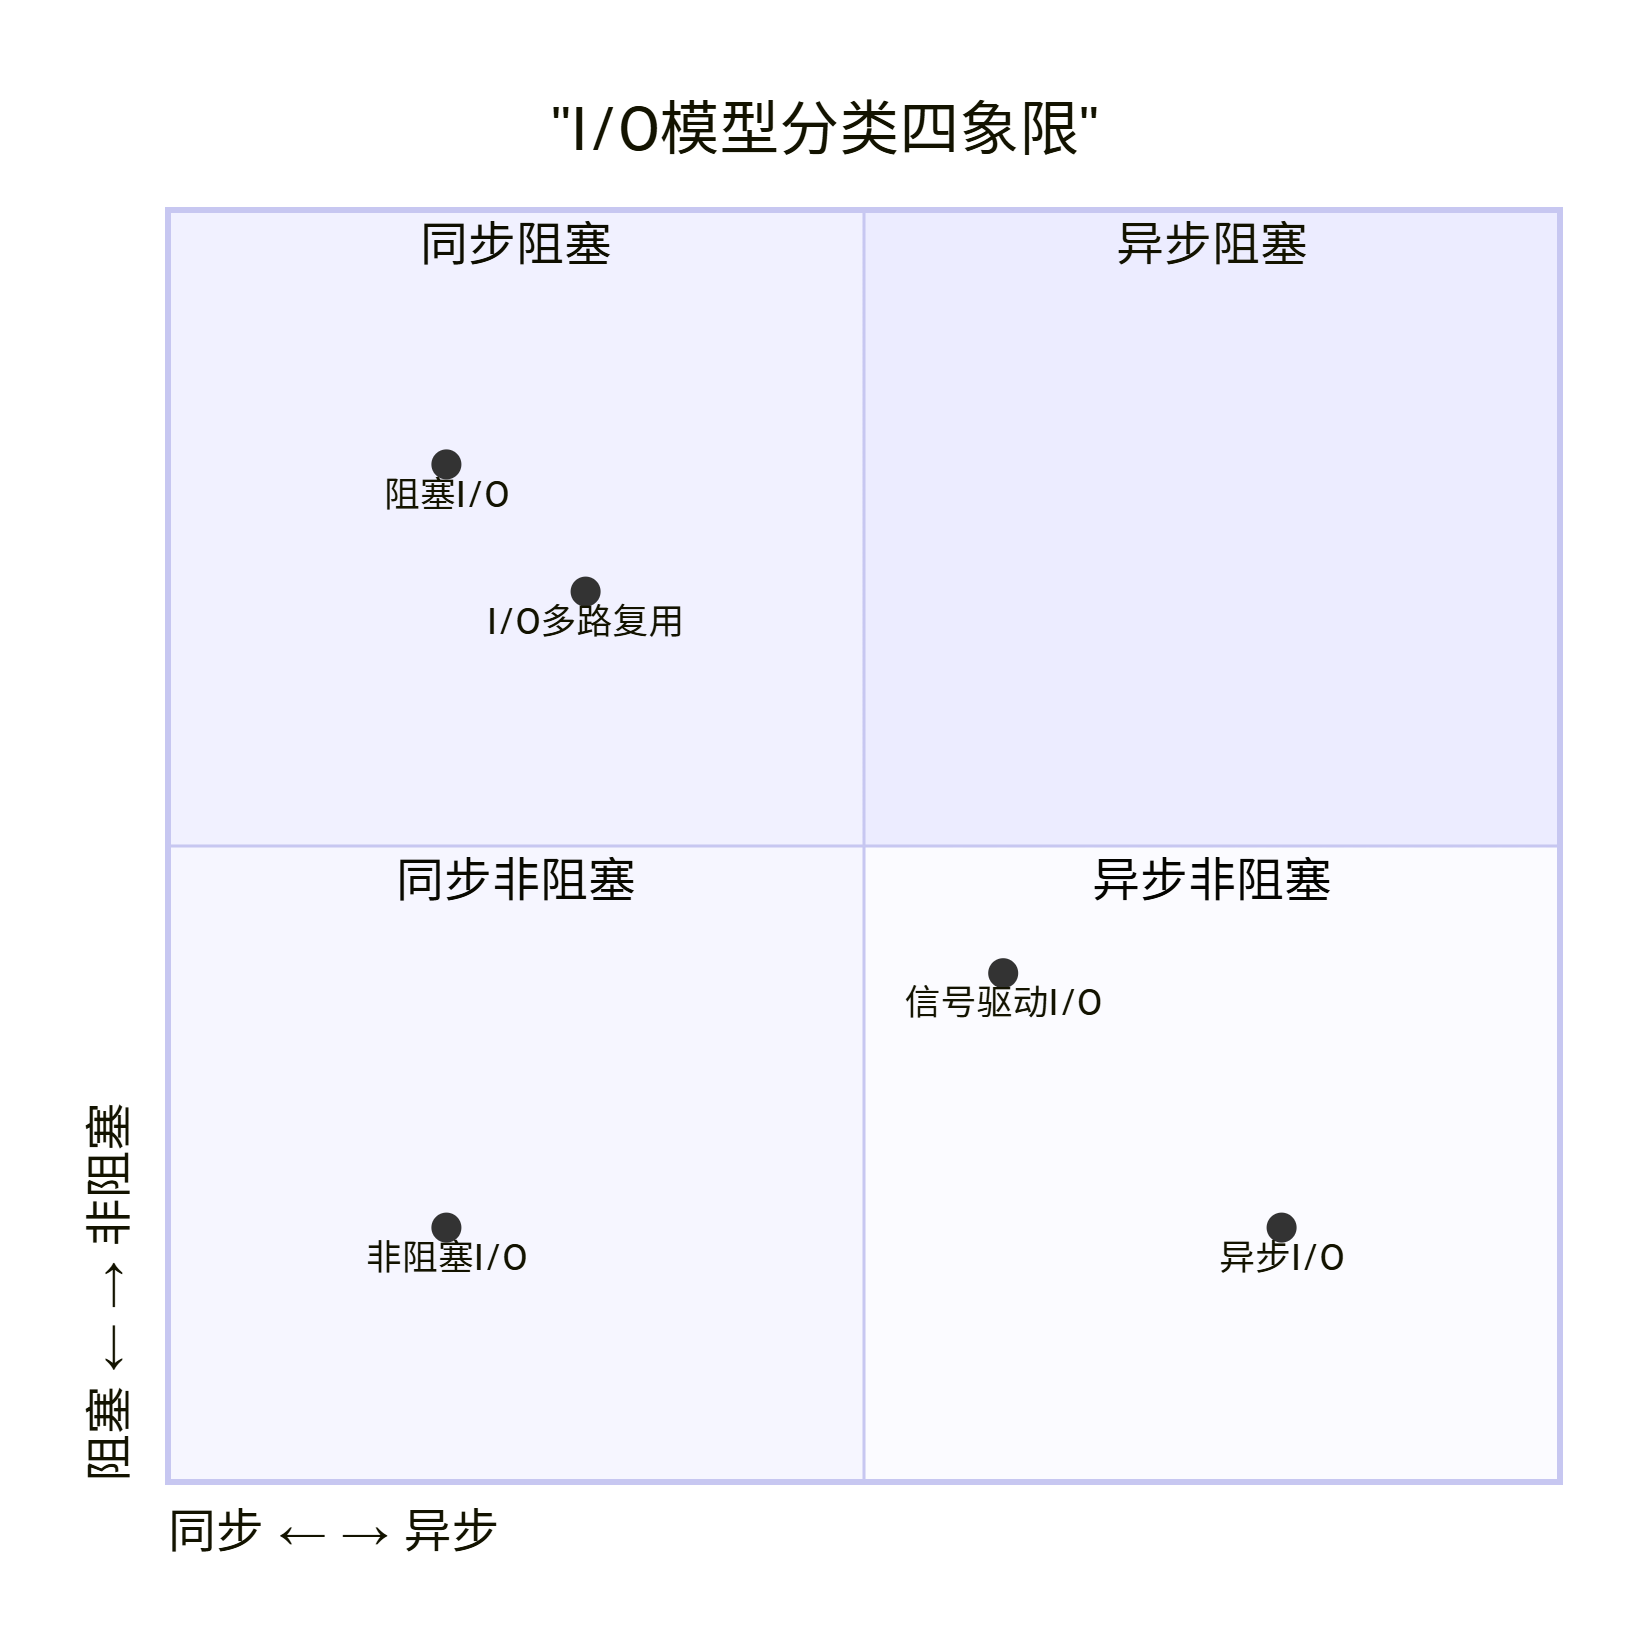
详细对比表
| 模型 | 第一阶段(数据准备) | 第二阶段(数据拷贝) | 同步/异步 | 阻塞/非阻塞 |
|---|---|---|---|---|
| 阻塞I/O | 阻塞 | 阻塞 | 同步 | 阻塞 |
| 非阻塞I/O | 非阻塞(轮询) | 阻塞 | 同步 | 非阻塞 |
| I/O多路复用 | 阻塞在select | 阻塞 | 同步 | 阻塞(select阻塞) |
| 信号驱动I/O | 非阻塞(信号通知) | 阻塞 | 同步 | 非阻塞 |
| 异步I/O | 非阻塞 | 非阻塞 | 异步 | 非阻塞 |
三、 重要概念澄清
1. I/O多路复用是同步还是阻塞?
-
本质是同步:因为应用程序需要主动调用
read()来获取数据 -
select本身是阻塞的:但可以同时监控多个fd,提高了效率
-
常被误解为"异步":实际是同步非阻塞的一种高效实现方式
2. 为什么说I/O多路复用效率高?
-
减少进程/线程数量:单线程可处理成千上万连接
-
避免频繁的上下文切换
-
epoll使用事件驱动,只有活跃连接才触发回调
3. 实际应用场景
-
阻塞I/O:简单客户端程序、顺序处理任务
-
非阻塞I/O:需要精细控制的高性能程序(需配合轮询)
-
I/O多路复用:高并发服务器(Nginx、Redis)
-
异步I/O:高性能磁盘I/O、数据库系统
4. Reactor vs Proactor模式
-
Reactor:基于I/O多路复用,应用程序主动读取数据(同步)
-
Proactor:基于异步I/O,操作系统完成操作后通知(异步)
四、 总结要点
-
同步/异步 关注的是结果通知机制
-
阻塞/非阻塞 关注的是等待时的进程状态
-
Linux的五种I/O模型中,只有 AIO是真正的异步
-
I/O多路复用(epoll) 虽然高效,但本质仍是同步
-
选择原则:
-
连接数少:阻塞I/O
-
连接数多但活跃少:I/O多路复用
-
需要极致性能:异步I/O + 多线程
-
记忆口诀
阻塞非阻塞,看等不等;
同步异步,看谁主动。
多路复用虽高效,同步本质不会变;
真异步要AIO,两段都不把进程占。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 33
 0
- 0


 已为社区贡献1条内容

所有评论(0)