【论文阅读||2025|上】Aligning generalization between humans and machines
论文来源:https://doi.org/10.1038/s42256-025-01109-4 (nature)
概要
根据人工智能最近的发展,包括生成式的方法,产生了能支持人类进行科学发现和行程决策的技术,但是在人和人工智能的团队协作中,让人工智能按照我们的偏好行事越来越重要。而本文提出在人与人工智能互动中,一个关键的点是人与人工智能的泛化方式不同。在认知科学中,人类的泛化涉及抽象和概念学习,但是人工智能泛化是机器学习中的域外泛化(深度学习)、符号AI中基于规则的推理,以及神经符号AI中的抽象(神经部分处理低级的、具体的感官数据,转化为高级的、符号化的概念或关系然后进行符号部分处理,在此基础上进行推理。)。作者结合人类认知科学的见解和人工智能的泛化方法,从三个维度来分析其共性和差异:泛化的概念、泛化的方法和泛化的评估。从这三个维度来分析并考虑在人和人工智能团队协作中的作用,让人与人工智能的协作更加的高效。
背景
人工智能的发展为人们在复杂任务中提供了有意义的支持,但实际上在复杂场景中,比如让人工智能为我们指导发明创新的想法和假设,但人工智能给出的答案准确性和可信性是需要考虑的,我们需要尽量提高这两者,也就是让人和人工智能之间泛化对齐,也就是如何让人工智能按照我们的思想去做事和反馈。在交互场景中,这种对齐的关键是人和机器泛化的互补方式,如下图所示:

人与机器的不同的泛化特点:
人类:擅长通过少数实例、组合性和稳定的泛化到有噪声和OOD数据,人类甚至可以根据已知的数据来判断超越了观察到的分布,即能判断从未见过的数据。出现这样的情况很大原因是因为通过进化和经验,人类建立了强大的因果关系驱动的知识先验,也就是我们的“常识”。
机器:数据驱动,即通过大量的数据统计分布,这种AI系统很难对不在已知分布的数据进行有效的概括和抽象,虽然有一部分的神经结构可能展现出与物理规律更好的一致性,但是如果在没有先验知识的情况下, 统计机器在所有分布上平均的泛化能力是恒定的。
人机合作的目标:为了更好的提高人机合作的效率,就是要双方能对齐相似目标的同时能弥补彼此的不足。例如大语言模型的泛化能力上,对主题文本的润色修辞超越大部分人,但是过渡的泛化会导致“幻觉”这一情况,有效的团队合作要求人类能评估人工智能的反应并且能知道人工智能这么做的原理即“解释”。
互补性评估:人与人工智能的互补性和有效人机合作的要求,让我们从传统评估方法,例如从准确性和具体实现的情况来分析,但基于人机合作的背景下,还需要增加一个新的维度:这个方法能否与人类有效互补。
神经符号AI:分析性方法(强在推理、解释)和基于实例的方法(强在适应、学习)本身具有互补性,而统计学习方法(如深度学习)则强在从原始数据中感知和模式识别。于是我们可以整合这三个方法的优点,然后组合出一个新的框架,旨在构建一个既能与人类在认知层面顺畅沟通(通过符号),又能从现实世界数据中自主学习(通过神经网络),还能灵活适应变化(通过实例记忆)的智能系统。
根据之前的三个维度:泛化的概念、泛化的方法、泛化的评估。我们需要关注以下四个问题:
- 什么是已知的泛化概念?
- 当前人工智能方法泛化的优势和劣势是什么?
- 当前如何评估泛化能力?
- 当前AI趋势对泛化理论、方法框架和评估实践有何影响?
人类与机器的泛化对比

概念学习与决策树
在早期认知心理学中,Bruner对人类概念学习进行研究,他们通过实验研究人类是如何对事物进行分类的。结论是人类会通过提出一系列“是/否”问题来形成概念规则。例如:它是水果,它是红色的,他的表面是光滑的,于是我们通过一系列的是或否得到它是一个苹果
由此研究者受此启发,创造了决策树算法,这种算法模仿人类的上诉行为,通过对数据特征的是/否问题来对数据进行分类,最终形成一个清晰、可解释的分类规则,类似人类头脑中的概念判断流程。
核心:人类的概念形成 -> 符号AI中的规则学习。
关系概念与结构学习
在认知心理学中,人类不仅能学习“苹果”这以具体的概念,还能学习更抽象的关系,例如“更大”,“在...之间”,“是...的联系”。
机器为了学习这种关系,需要能够表示事物之间关系的结构,于是出现了归纳逻辑编程方法(早期的机器学习),它可以从包含关系的数据(知识图谱)中学习逻辑规则,如从父母(A,B)和父母(B,C)的数据中学习出祖父母(A,C)规则。同时有些概念是递归定义的,例如一个“列表”可以是空的,或者是一个“元素”后跟着另一个“列表”,这启发了机器中处理递归结构(如树、链表)的学习算法。
核心:人类的关系抽象 -> AI对结构化数据和递归模型的学习。
上面的方法允许从少量示例中学习,并在模型归纳中考虑背景知识。
克服符号AI的脆弱性
在传统的符号AI规则中,这些是已经写死的,非黑即白的,例如,如果确定了天鹅是白色,一旦遇到反例或噪声数据,那么整个系统将失效不可信。这就是传统符号AI的脆弱性。
解决方案
统计关系学习:将概率与符号规则结合起来。规则不再是绝对真理,而是具有概率的。例如,“如果X是鸟,那么X会飞”的概率是0.95(因为鸵鸟和企鹅不会飞)。这样系统变得对噪声和例外情况更具有鲁棒性。
贝叶斯规则学习:利用贝叶斯定理,将学习视为在假设空间(即可能的规则集合) 中进行概率推断的过程。系统会评估不同规则解释数据的可能性,并选择最合理的那个。
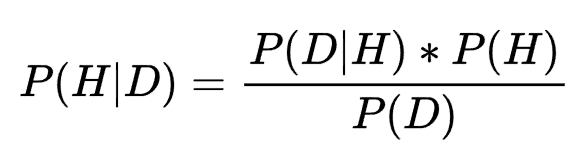
-
H:代表一个假设,即一条或一组潜在的规则。例如,“如果X是鸟,那么X会飞”。
-
D:代表我们观测到的数据。例如,我们见过天鹅、麻雀、鸽子都会飞,但也见过鸵鸟和企鹅不会飞。
-
P(H):这是先验概率。它表示在看到任何数据之前,我们认为假设H本身有多合理。例如,基于我们的常识,“生物通常具有移动能力”这条先验,可能会让我们认为“鸟会飞”是一个合理的初始假设。
-
P(D | H):这是似然概率。它表示如果规则H是正确的,那么我们观察到当前这批数据D的可能性有多大。
-
如果H是“所有鸟都会飞”,但我们观察到了不会飞的鸵鸟(数据D),那么
P(D|H)就会非常低,因为这条规则无法解释这个反例。 -
一个更灵活的规则,如“大多数鸟会飞,但有一些例外”,则会有更高的似然值。
-
-
P(H | D):这是后验概率,也是我们最终追求的目标。它表示在考虑了观测数据D之后,假设H为真的概率。
学习过程就是:寻找那个使后验概率 P(H | D) 最大的假设H。
隐式学习和相似理论
以上学习作为一种外显的方法,一些知识我们可以通过语言来描述表达,但是还有一部分的难以被定义的领域,人类采用类似内涵和相似性的认知方式。
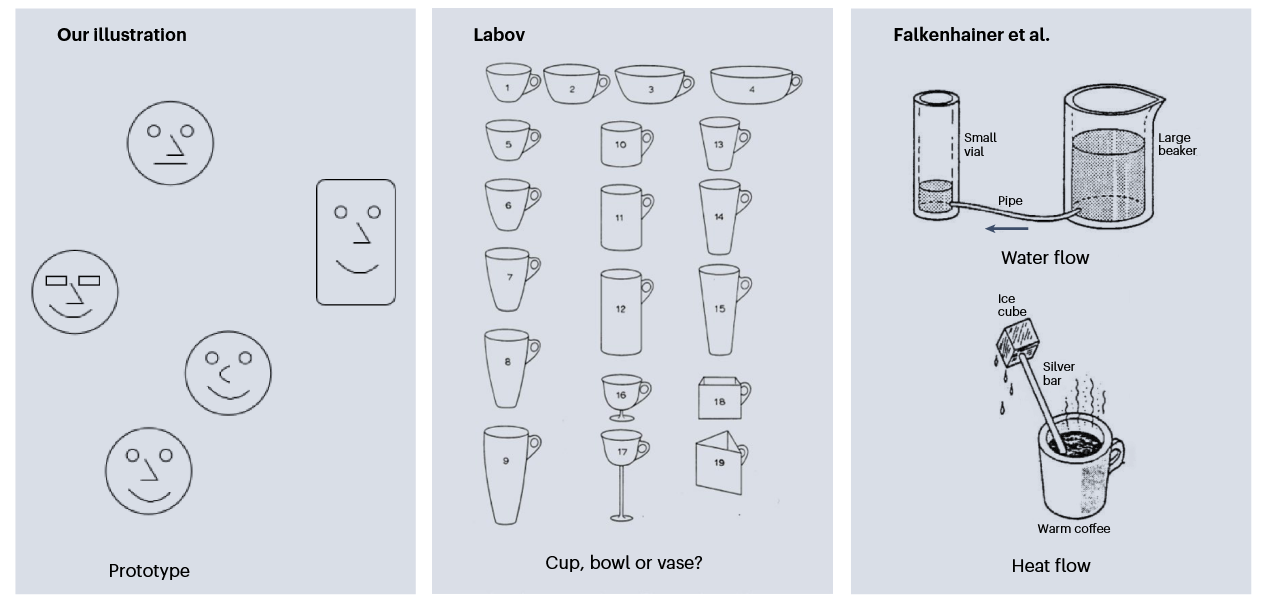
原型理论
我们认为每个类别(如“鸟”)都有一个心理上的 “原型”——即这个类别最典型、最理想的代表(如知更鸟是“鸟”的原型)。我们通过将新事物与这个原型进行相似性比较来分类。相似性在类别内最大化,在类别间最小化。
而在机器中,这种方法体现在k邻近方法。k-NN算法没有明确的规则。它存储所有训练样本(这些样本共同定义了“原型”区域)。当遇到新样本时,它找到最相似的k个邻居,并进行分类。这本质就是基于相似性的判断。
范例理论
我们并不总是与一个抽象的原型比较,有时我们会与具体的、记忆中的范例进行比较。这使得分类非常灵活和上下文依赖。Labov的经典实验。一个物体,在装汤的语境下被归类为“碗”,在插花的语境下被归类为“花瓶”。它的分类不是固定的,而是取决于上下文,以及它与记忆中“碗”或“花瓶”的范例的相似性。
这也对应k-最近邻和案例基于推理。这些方法直接依赖存储的具体实例,其判断会因选择的范例不同而改变,从而具备灵活性。
类比推理
类比不仅仅是通过外在特征的比较(例如太阳和柠檬都是黄色),更强大的在于内在结构的对比,例如:行星围绕太阳运动到电子围绕原子运动。
这对应类比推理引擎和迁移学习的高级形式。这些方法试图发现并映射不同领域之间共享的关系结构,而不仅仅是匹配表面特征。
| 人类认知理论 | 核心机制 | 对应AI方法 |
| 原型理论 | 与类比原型的相似性 | k-最近邻、聚类算法 |
| 范例理论 | 具体范例的相似性,依赖上下文 | k-最近邻、案例基于推理 |
| 类比推理 | 跨领域的关系结构相似性 | 类比推理、结构映射 |
神经网络方法
神经网络的提出最开始是为了模拟人脑的并行分布式处理,并解决符号AI的脆弱性,它通过大量单元的简单计算来学习。这种方法表现出了很强的鲁棒性,随着数据规模和算力的增长,神经网络在图像识别、自然语言处理人物上的实用性超过了符号系统,成为主流。
虽然神经网络取得了巨大的成功,但这种方法与人类认知有着根本差异,该论文指出三个核心点。
数据与语义的分离
神经网络中学习的是数据的统计规律,但是它并不理解数据的含义。(只懂语法不懂语义),但从人类的认知上,当我们学会了“猫”的概念,我们理解其语义——它是动物、会动、会叫、有生命。这使得我们能文件识别分布外样本。即使看到一张抽象画风格、从未见过的猫的图片,人类也能根据对齐语义的理解,认出它是猫。
ML最近才关注解决分布外泛化这个问题。
内隐知识与概念化解释的能力
人类的知识大部分是内隐的,例如我们学习一个概念“民主”,我们可以用语言描述其关键特征(选举、自由、权利等)。
但神经网络是一个黑箱,他的知识被编码在数百万个权重中,无法用人类可理解的概念来描述,这一观察催生了可解释AI领域。特别是基于概念和关系的解释方法,它们试图“打开黑箱”,通过识别模型内部激活与人类可理解概念(如“翅膀”、“喙”)之间的关联,来解释模型的决策。这是在试图减小机器内隐知识与人类外显解释之间的鸿沟。
基于因果推理与基于相关性的学习
人类的解释通常基于事件的因果历史,人类不专注于事件共变的表面层面,而是基于更深层的因果表征进行推理和学习。我们看到冰融化,会用“温度升高”这个原因来解释。我们天生构建因果模型来理解世界。但在神经网络中绝大多数模型学习的是变量之间的相关性,而非因果关系。它可能发现“冰淇淋销量”和“溺水人数”相关,但无法理解其背后共同的因果因子——“夏天”。
这个因果推理与相关性学习是我们重点要思考的。直接关系到人类智能与当前主流人工智能的本质区别。
基于相关性学习(是什么而非为什么)
例如现在面对“冰淇淋销量越高,溺水人数越多”这一现象,机器学习两个变量X(冰淇淋销量)和Y(溺水人数)经常同时增加和减少,那么模型会学习到他们之间存在相关性。通过最小化预测误差来发现数据中的复杂相关模式。
一个基于相关性的模型会准确地发现“冰淇淋销量”和“溺水人数”之间存在强烈的正相关关系。它可能会甚至用冰淇淋销量来预测溺水人数,并且可能在历史数据上表现得相当准确。
但是!它存在以下四点缺陷:
-
无法区分因果方向:是冰淇淋导致溺水?还是溺水促进了冰淇淋消费?模型不知道。
-
混淆变量:模型无法意识到有一个共同的、未观察到的原因——“夏天/高温”——同时导致了冰淇淋销量增加和更多人游泳(从而增加了溺水风险)。这种相关性是虚假的。
-
干预失效:如果我们根据这个模型采取行动,禁止销售冰淇淋以期减少溺水,我们会发现这完全是徒劳的。因为干预冰淇淋销量并没有改变天气,人们依然会去游泳。基于相关性的模型在面临干预 时是无效的。
-
分布外泛化能力差:如果我们将这个模型应用到一个常年炎热的热带城市,它的预测可能会完全失灵。
基于因果的推理(这样做,会如何)
这是人类直觉和科学思维的核心方式。理解变量之间的因果机制。关注原因与效应。试图构建一个关于世界如何运作的生成模型。简单来说就是我对系统进行干预,会发生什么?通过干预和反事实思考来确立因果性。
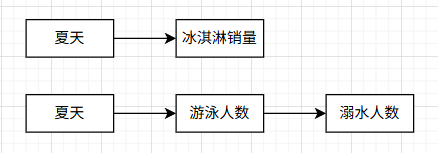
以上是根据因果推理之后的变量关系,现在我们强制干预系统,禁止冰淇淋销售,然后观察溺水人数如何变化,询问“如果当时...会怎样?”的问题。例如,“如果当时那个人没有吃冰淇淋,他是否还会溺水?” 这需要构建一个与事实相反的世界进行推理。
注意这里的禁止冰淇淋销售和冰淇淋销量为0是两个完全不同的获取信息方式:一个是被动观察世界,另一个是主动改变世界。例如被动观察(相关性)是会从数据中找到冰淇淋销量为0的日子,但那些数据可能在现实中表示冬天!模型最终的计算结果实际上是“冬天里的平均溺水人数”,而主动改变的则是强制在夏天把冰淇淋销量设置为0,而不改变其他任何条件!
一个具有因果推理能力的主体会构建如上所述的因果图。它会认识到,干预冰淇淋销量对溺水人数没有直接的因果影响。要减少溺水,必须干预其直接原因,比如增加救生员或修建护栏。
这篇论文强调,人类的泛化在本质上是因果性的。我们不会仅仅因为看到A和B总是一起出现,就认为它们有必然联系。我们会下意识地构建因果模型来解释为什么A和B会关联,这使得我们的泛化非常稳健和灵活。而当前AI的泛化在很大程度上是相关性的。它可能在训练数据分布内表现完美,但一旦环境发生变化(分布外),其基于相关性的泛化就会崩溃,产生荒谬甚至危险的错误(例如,将站在草地上的牛识别为羊,因为它在训练数据里只见过羊在草地上)。要实现人类与机器泛化的对齐,一个至关重要的方向就是让机器从“相关性的学习者”向“因果性的推理者”演进。
神经符号AI
既然纯粹的符号方法和纯粹的神经方法都有缺陷,那么神经符号AI将两者结合起来,神经方法作为内隐学习,从原始数据中学习感知,然后用符号方法作为外显推理,让模型具有可解释性、因果推理能力、组合性。达成“模型-数据”分离的结构。
通过“模型-数据”分离的结构,从而达成我们最终的目标——更好的人机协作,即与人类认知对齐,AI的输出必须是人类能够轻松理解和处理的。例如,提供基于概念的解释,而不是一堆激活值;用自然语言进行交流,而不是只有概率分数。
对齐多个方面包括:知识状态对齐、信息需求对齐、价值观对齐。
-
知识状态对齐:AI和人类对当前局势有共同的理解吗?(例如,医生知道病人的病史,AI模型也知道吗?)
-
信息需求对齐:AI提供的信息是人类在当下决策时真正需要的吗?(例如,在紧急情况下,需要的是关键结论而不是冗长的分析。)
-
价值观对齐:AI的建议是否符合人类的价值观和偏好?(例如,在医疗决策中,是倾向于激进治疗还是保守治疗?)
本文探讨核心:人类和AI在泛化方式上存在根本性的不对齐。如果人类无法理解AI的“思维过程”,或者AI无法提供符合人类认知习惯的解释,那么协作就会产生误解和不信任,最终导致团队效率下降。目前人机合作团队的表现无法比上单人或者单ai的顶尖水平。
未完待续......

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 22
 0
- 0


 已为社区贡献2条内容

所有评论(0)