大模型变身数据科学家!DeepAnalyze全攻略(超详细),看这篇就够了!
数据分析报告通常需要人类分析师花费数天甚至数周才能完成。而现在,一个只有8B参数的大模型模型,就能自动完成从原始数据到专业分析报告的全过程。
数据科学的"自动驾驶"难题:想象一下,你手里有一堆CSV文件和数据库,需要从中挖掘商业洞察、生成可视化图表、建立预测模型,最后写成一份完整的分析报告。这个过程涉及数据清洗、探索分析、建模、可视化等多个环节,每一步都需要专业知识和反复试错。
这正是"自动数据科学"要解决的核心挑战:能否让大模型像人类数据科学家一样,自主完成整个数据分析流程?
目前的大模型数据分析工具主要有两类:一类是专门处理单一任务的模型(比如只做表格问答或代码生成),另一类是基于预设流程的大模型助手(比如用GPT-4配合固定的工作流程)。但它们都有致命缺陷——无法真正"自主思考",只能按部就班执行人类设定的步骤。

DeepAnalyze:从"助手"到"专家":DeepAnalyze是首个专门为自动数据科学设计的"agent模型"。与传统方法最大的不同在于,它具备两项关键能力:
-
自主编排能力:能理解复杂任务需求,自动规划并协调一系列相互依赖的操作,而不需要人类预先定义工作流程。
-
适应性优化能力:能在真实环境中与数据交互,根据反馈不断调整策略,就像人类数据科学家在分析中会反复尝试和修正。

五种核心动作:DeepAnalyze设计了五种基本动作来与数据环境互动:
•分析(Analyze):进行规划、推理、自我验证
•理解(Understand):读取和理解数据库、表格等结构化数据
•编码(Code):生成Python代码处理数据
•执行(Execute):运行代码并收集环境反馈
•回答(Answer):产生最终输出
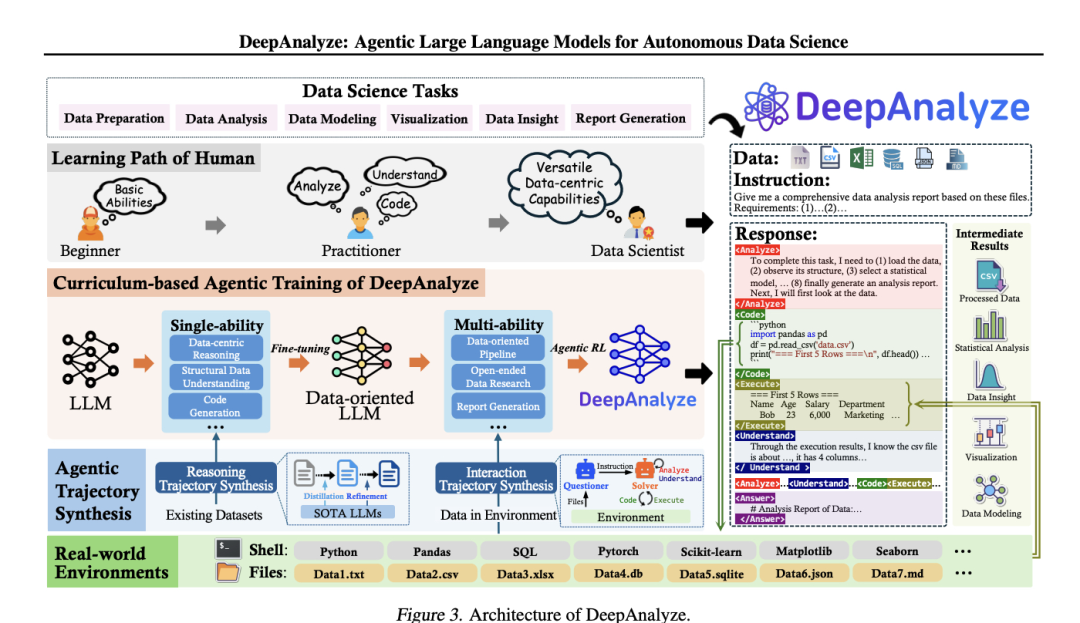
模型会自动在这些动作之间切换,无需人工干预。
像培养人类专家一样训练大模型:训练DeepAnalyze面临两大难题:奖励稀疏(任务太难,模型在早期很难成功,缺少正向反馈)和轨迹稀缺(缺少高质量的问题解决示例数据)。
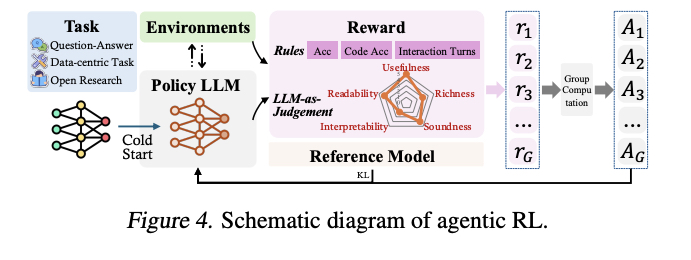
论文的解决方案是"课程式agent训练",模仿人类数据科学家的学习路径:
第一阶段:单项能力训练:就像学生先学习数学、编程、统计等基础课程,模型首先在推理、结构化数据理解、代码生成等单项能力上进行训练。
第二阶段:综合能力训练:在掌握基础技能后,通过强化学习让模型在真实环境中执行复杂任务。这个阶段采用混合奖励机制:
•对有标准答案的任务,根据准确性和交互质量评分
•对开放式研究任务,从报告的实用性、丰富性、合理性、可解释性和可读性五个维度评估
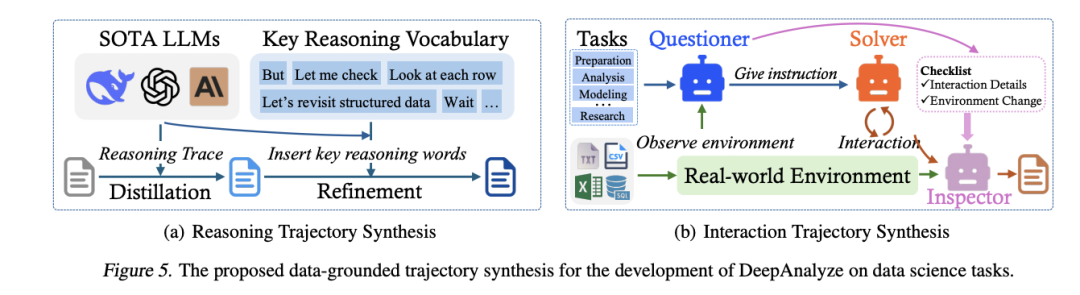
数据合成:创造训练样本:由于高质量的数据科学训练数据极为稀缺,团队开发了数据驱动的轨迹合成框架:
•推理轨迹合成:用先进的大模型模型提取推理过程,并通过关键词引导进行优化
•交互轨迹合成:构建多agent系统(提问者、解决者、检查者),自动生成完整的问题解决过程
最终构建了包含约50万样本的训练数据集DataScience-Instruct-500K。
实验结果:在12个数据科学基准测试中,仅有80亿参数的DeepAnalyze-8B,超越了大多数基于最先进商业模型(如GPT-4-Turbo、Claude 3.5 Sonnet)的系统。
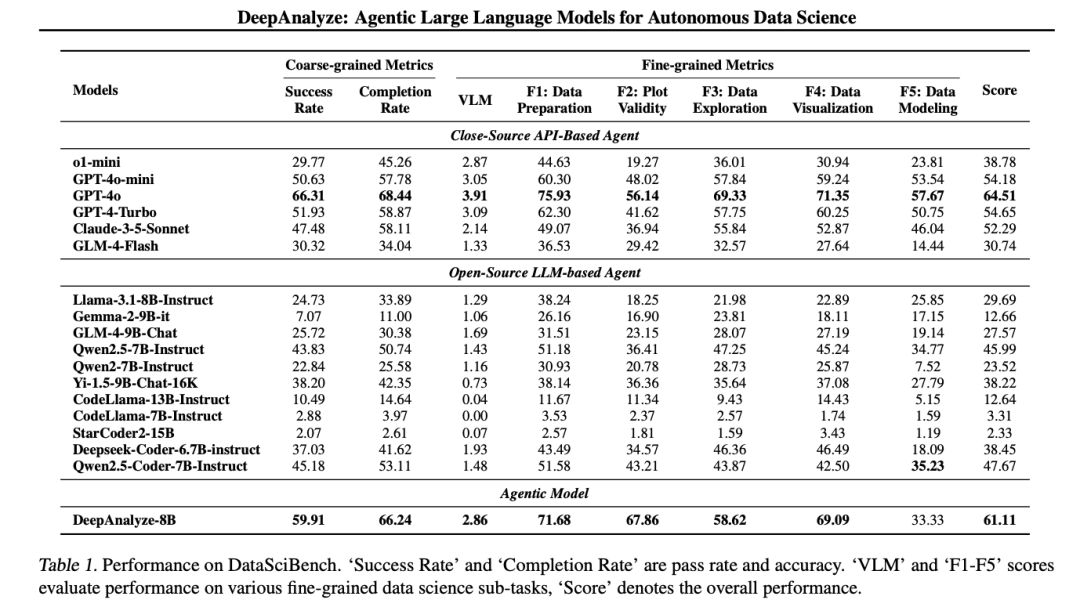
端到端数据科学流程:在DataSciBench测试中,DeepAnalyze-8B的表现仅次于GPT-4o,但不需要任何外部编排框架就能完成复杂任务。
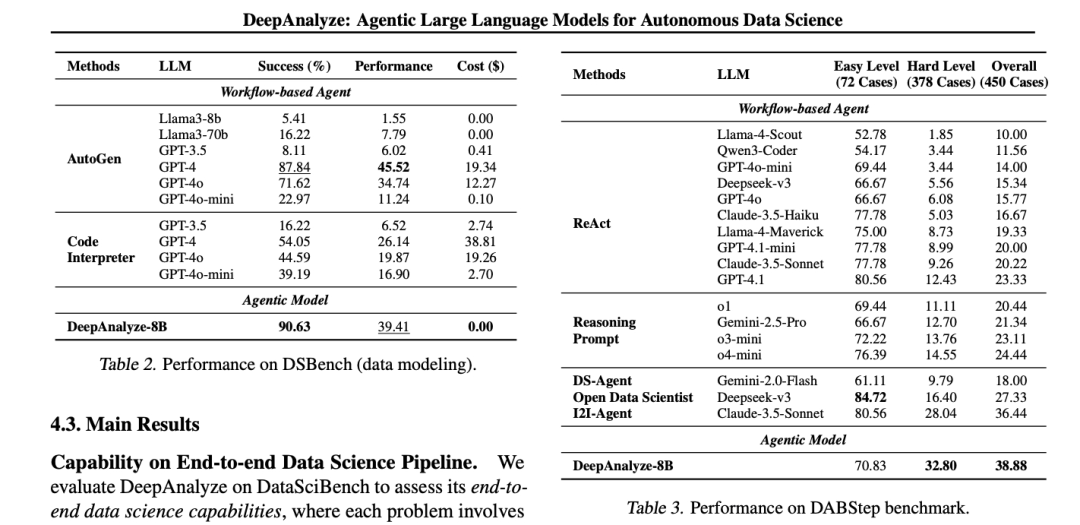
深度数据研究:研究团队构建了新基准DABStep-Research来评估深度研究能力。结果显示,DeepAnalyze-8B在五类任务(数据准备、分析、洞察提取、报告生成、开放式研究)中全面领先所有对比系统。
特别值得注意的是,商业模型在开放式研究任务上表现明显下滑,而DeepAnalyze-8B在没有明确指导的情况下仍能出色完成。它生成的报告在内容深度和结构化呈现上,已经接近专业分析师的水平。
其他能力表现
•代码生成:在DS-1000基准上超越GPT-4-Turbo
•表格问答:超越此前最佳模型Reasoning-Table
•数据分析和建模:在DSBench上达到与基于多种先进商业模型的系统相当的性能
DeepAnalyze标志着数据科学领域从"基于工作流的助手"向"agent模型"的范式转变。它不只是执行预设步骤的工具,而是能够自主思考、探索和优化的大模型数据科学家。
更重要的是,这项工作实现了数据科学界长期以来的目标:从原始数据自动提取可操作的洞察。研究团队已开源模型、代码和训练数据,为下一代智能数据系统(包括数据发现、数据治理、数据生态系统和数据管理)铺平了道路。
如何学习大模型 AI ?
我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
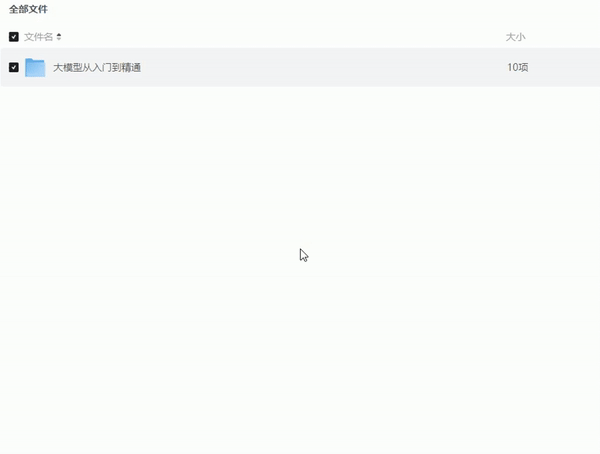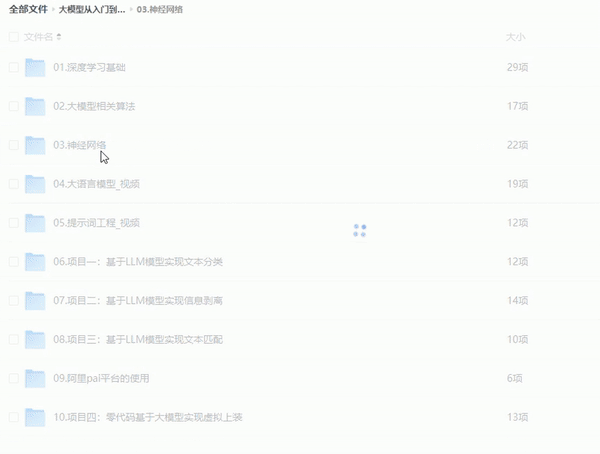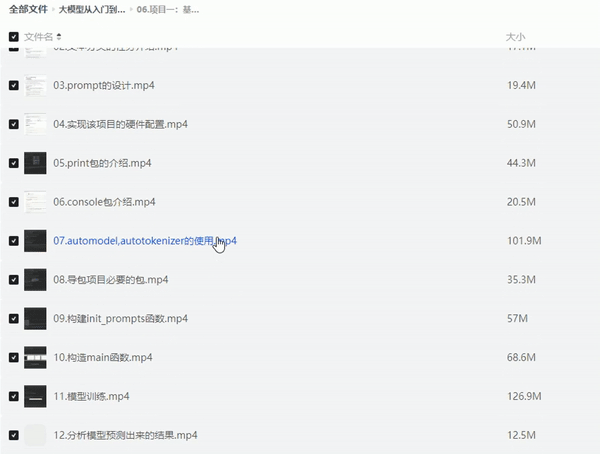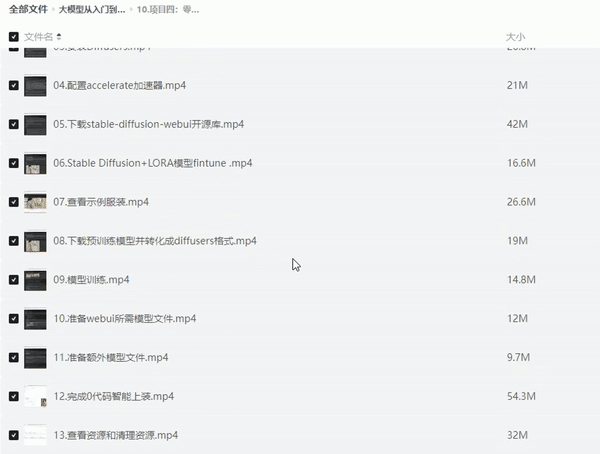
2025最新大模型学习路线
明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。
对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。
针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。
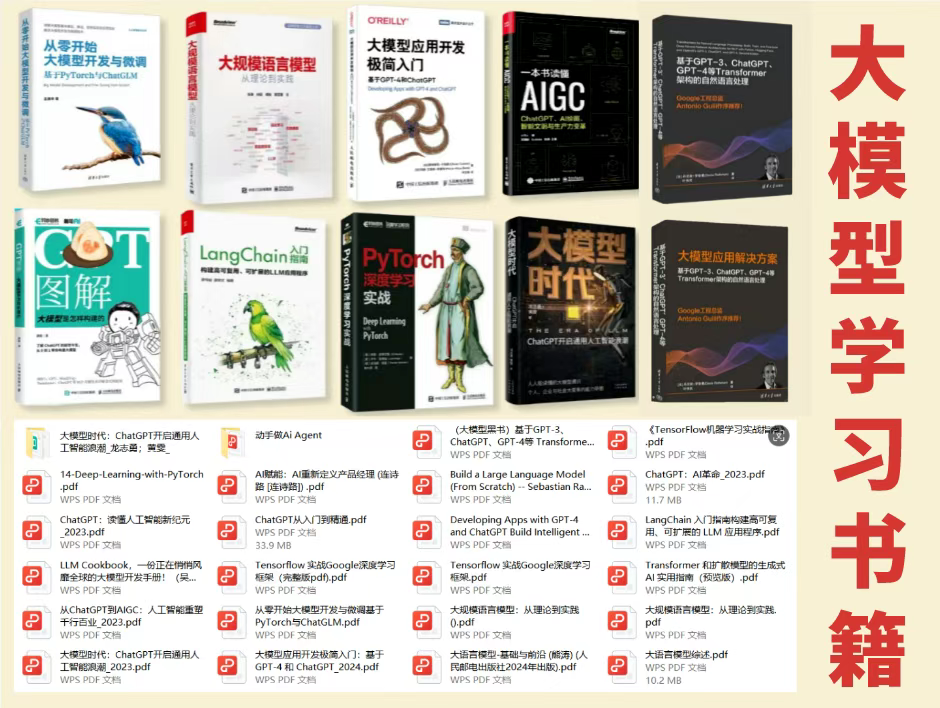
大模型经典PDF书籍
新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
配套大模型项目实战
所有视频教程所涉及的实战项目和项目源码等
博主介绍+AI项目案例集锦
MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
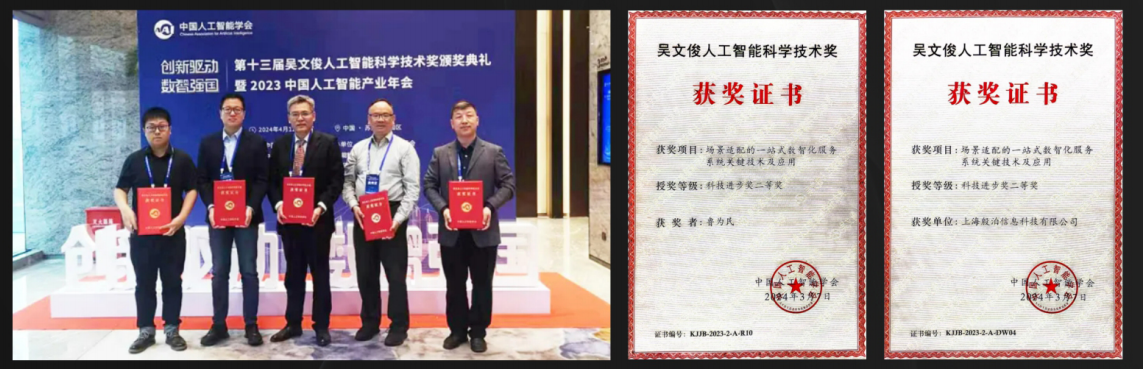
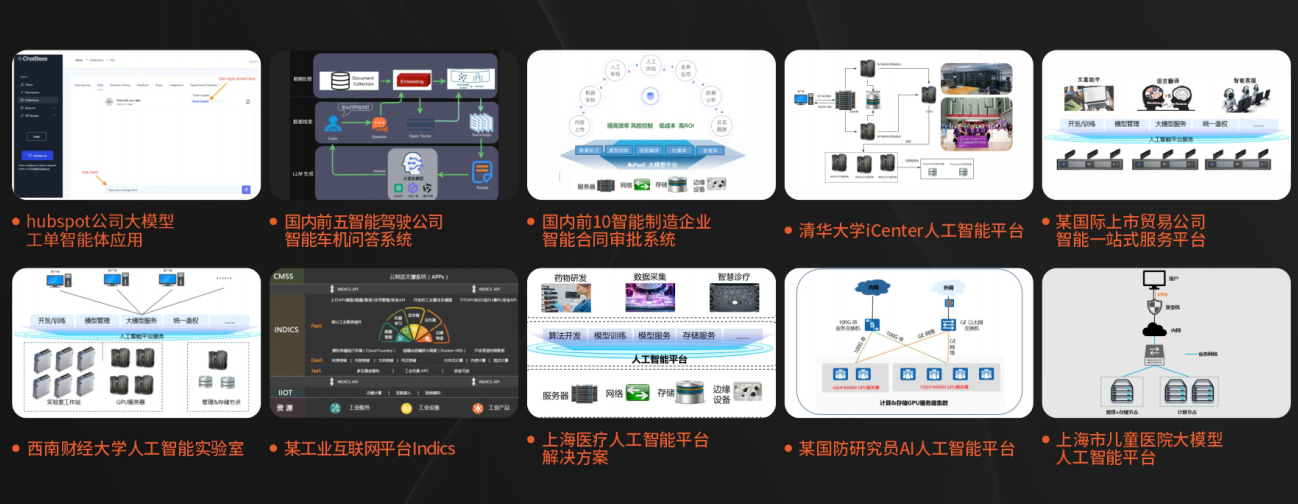
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

为什么要学习大模型?
2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
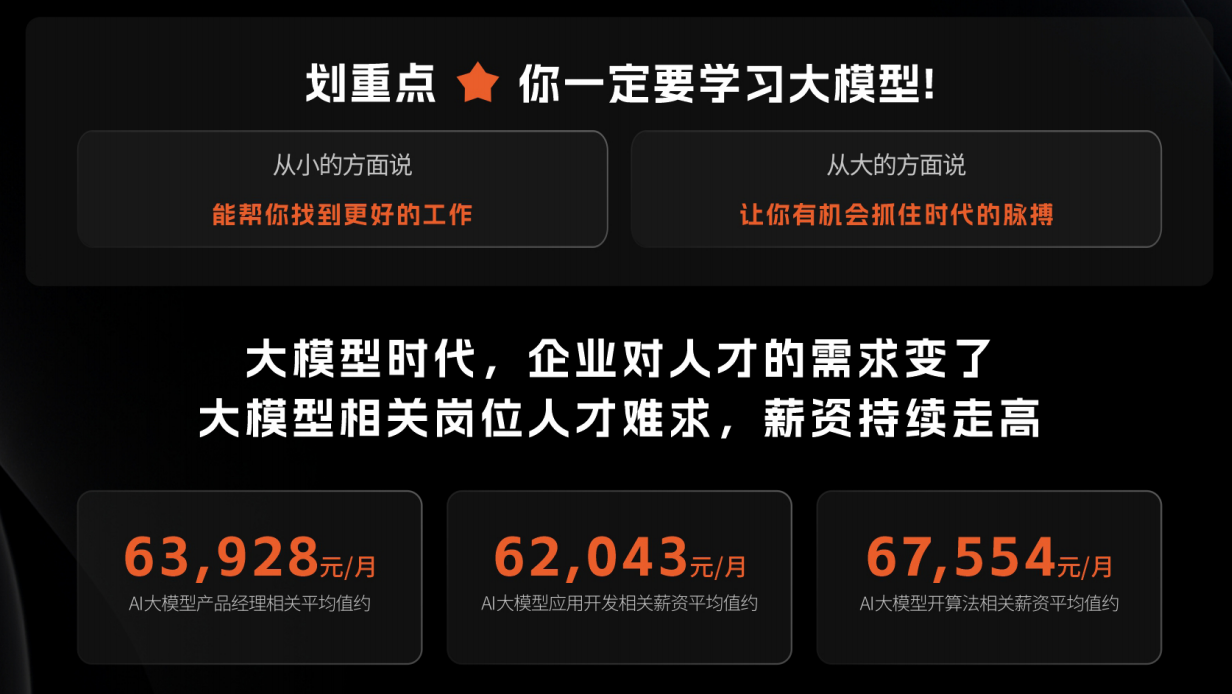
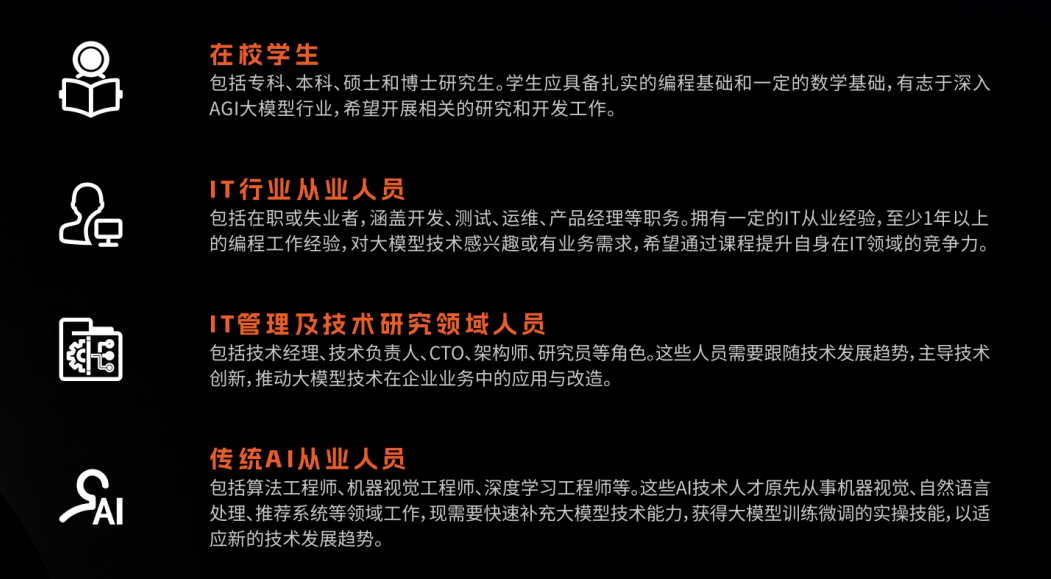
适合人群
- 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
- IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
- IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
- 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
课程精彩瞬间
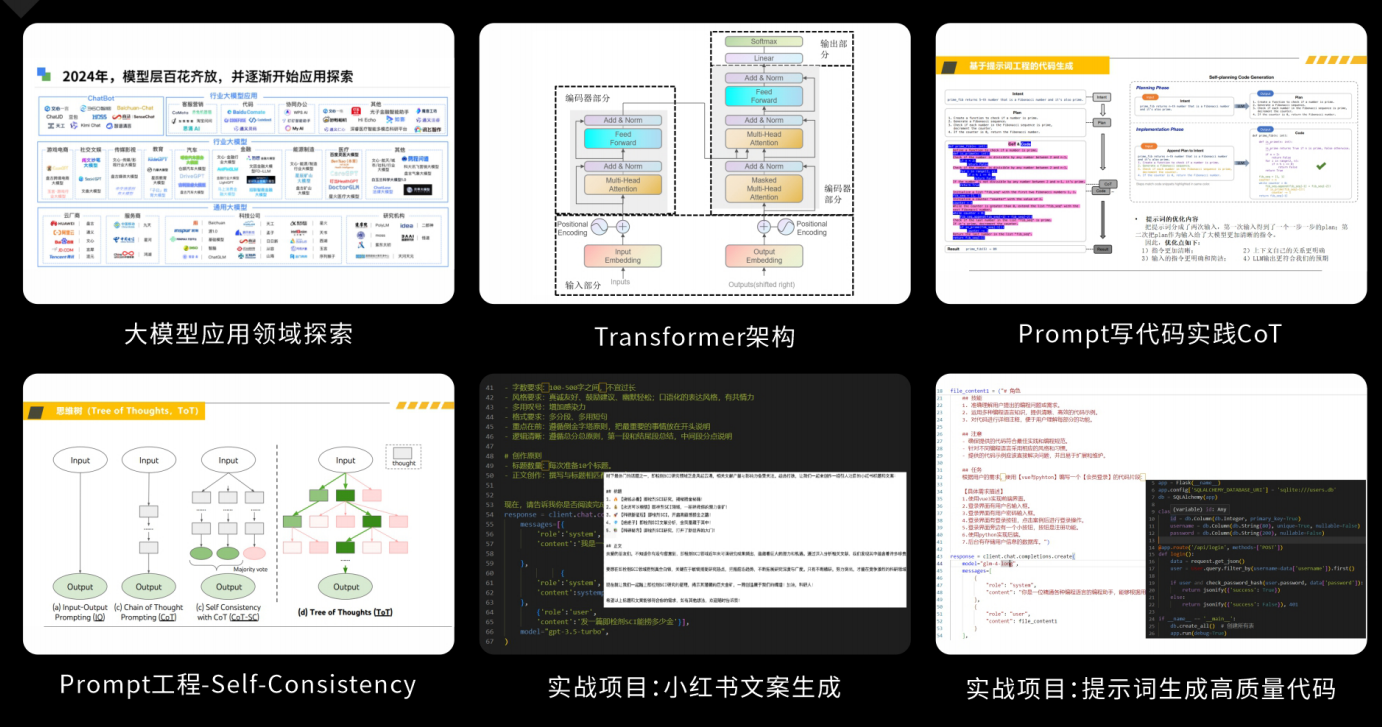
大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。
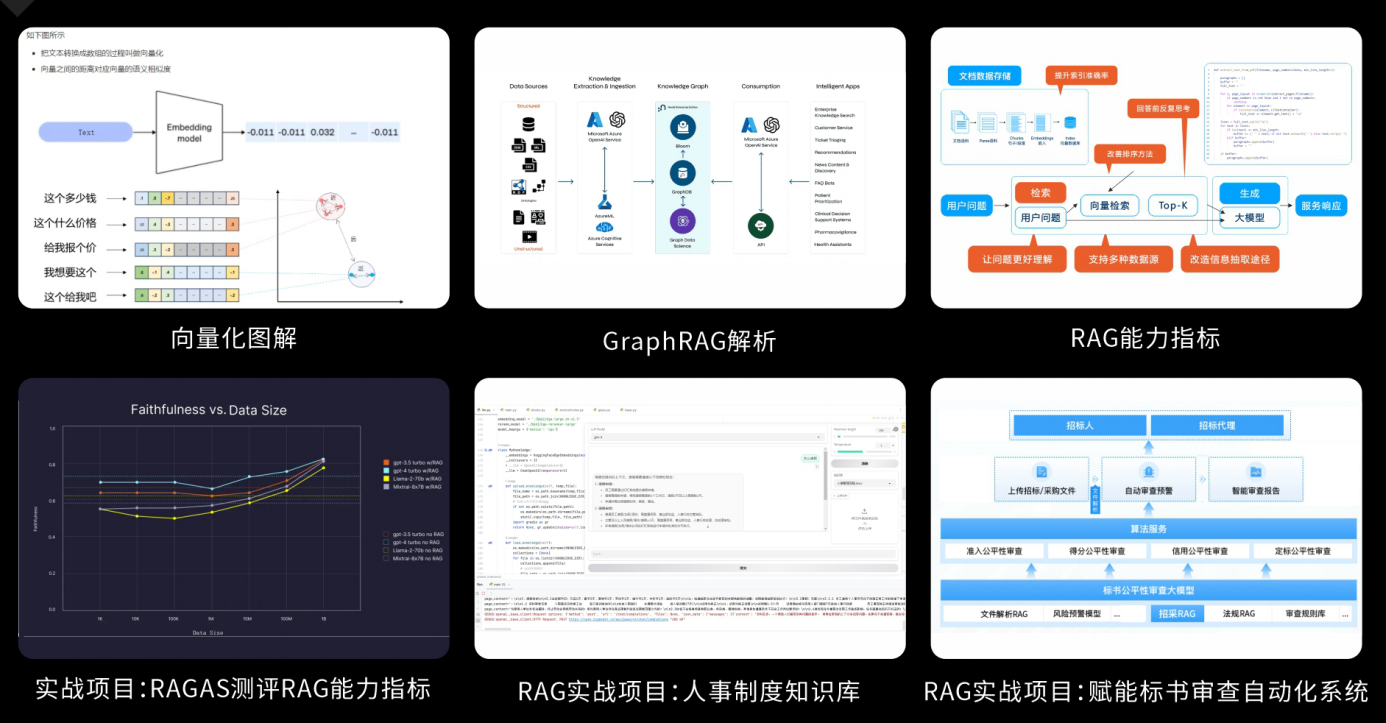
RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。
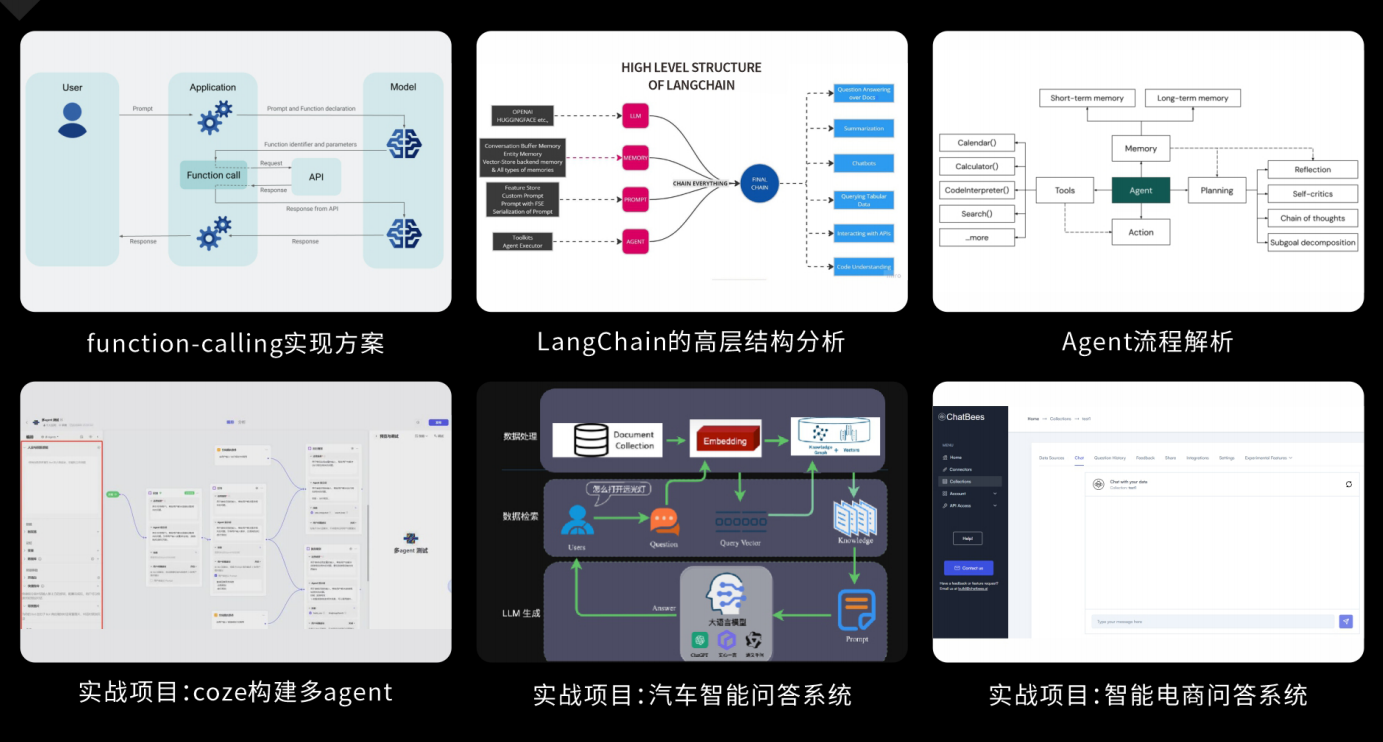
Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
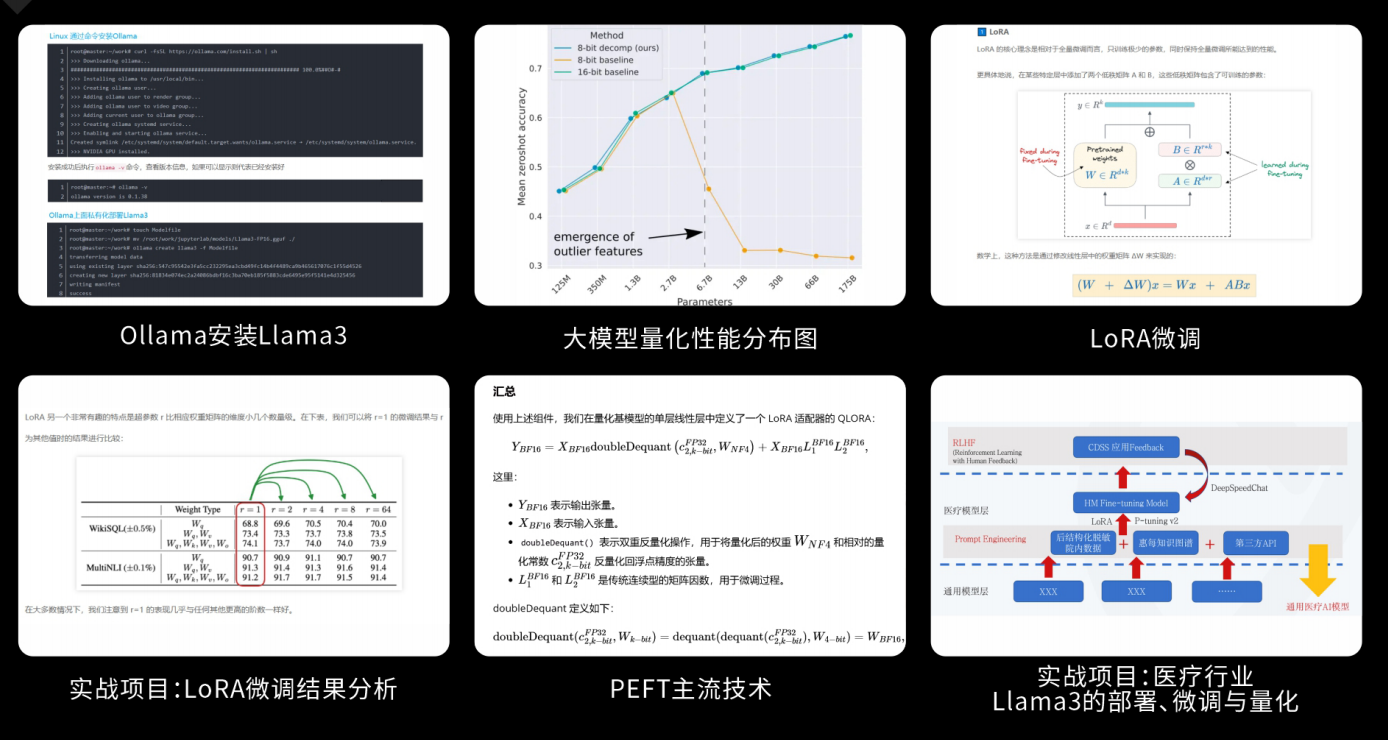
模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。
顶尖师资,深耕AI大模型前沿技术
实战专家亲授,让你少走弯路
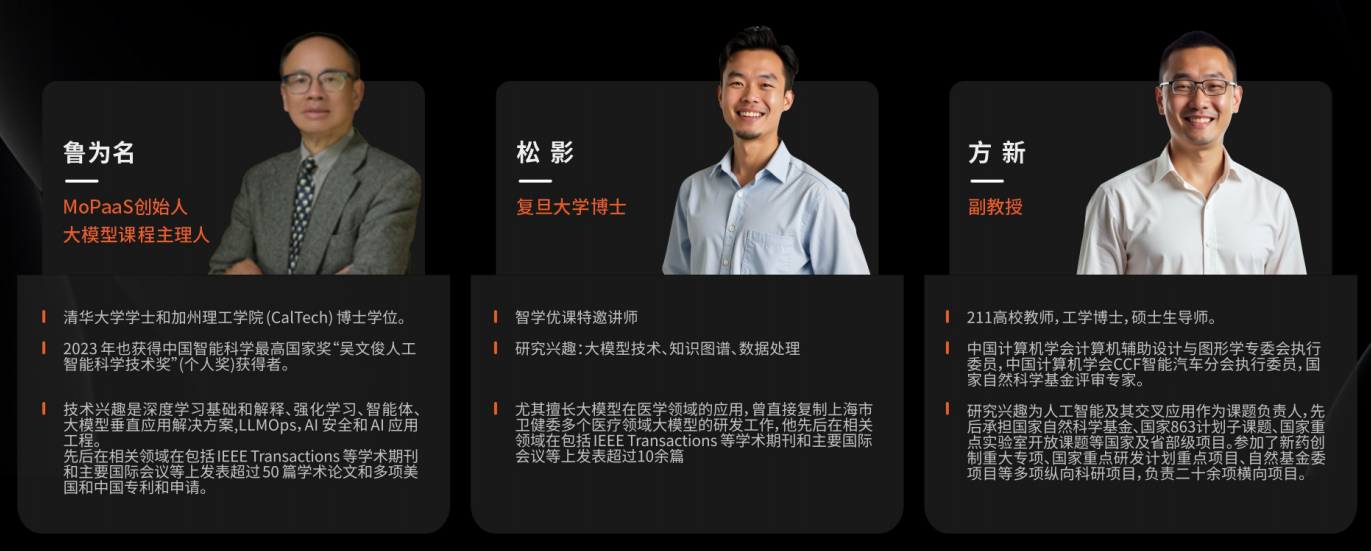
一对一学习规划,职业生涯指导
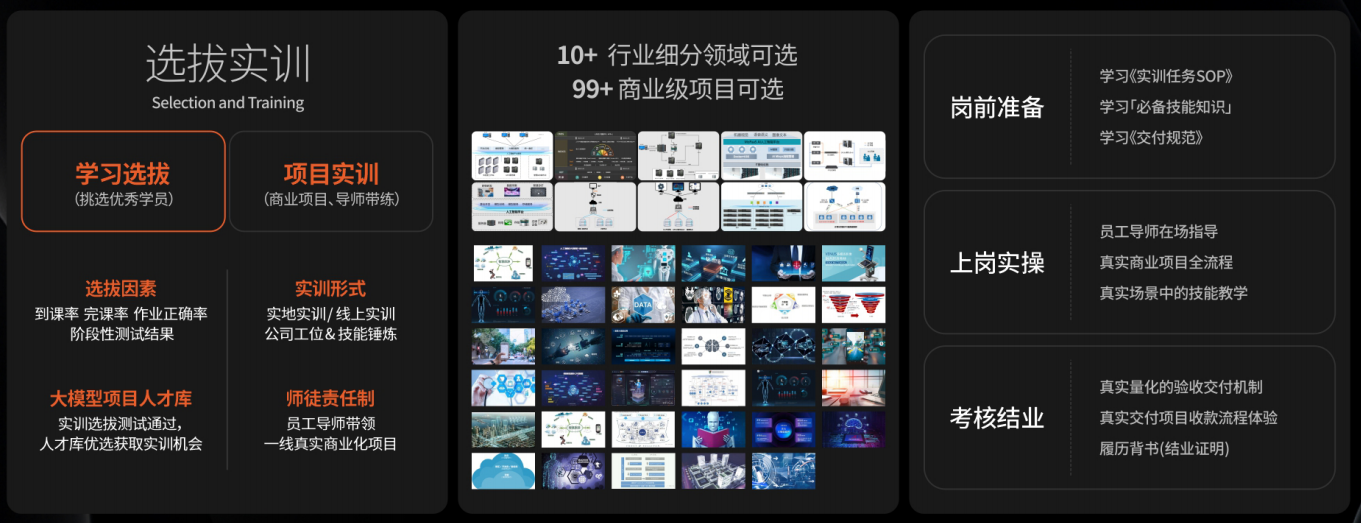
- 真实商业项目实训
- 大厂绿色直通车
人才库优秀学员参与真实商业项目实训
以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调
大厂绿色直通车,冲击行业高薪岗位
文中涉及到的完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 16
 0
- 0


 已为社区贡献722条内容

所有评论(0)