Mybatis1-搭建配置-简单应用-全局配置文件-Mapper映射文件-查询与关联查询
MyBatis 是一款优秀的持久层框架,它支持定制化 SQL、存储过程以及高级映射。MyBatis 避免了几乎所有的 JDBC 代码和手动设置参数以及获取结果集。MyBatis 可以使用简单的 XML 或注解来配置和映射原生信息,将接口和 Java 的 POJOs(Plain Old Java Objects,普通的 Java对象)映射成数据库中的记录。MyBatis本是apache的一个开源项目iBatis,2010年这个项目由apache software foundation迁移到了google code,并且改名为MyBatis。2013年11月迁移到Github。
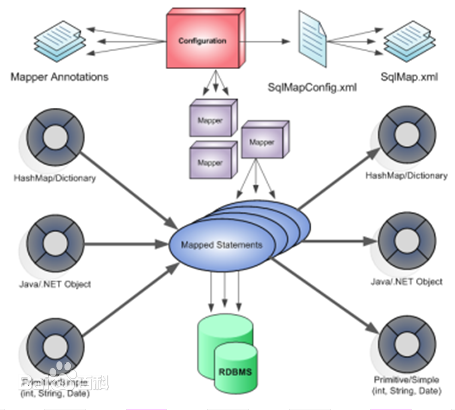
下载
下载地址:https://github.com/mybatis/mybatis-3,仅仅是一个jar包,我用maven自动导包,不去下载源码。
文档地址:http://www.mybatis.org/mybatis-3/zh/index.html,已打不开,我用的是https://mybatis.p2hp.com/index.html
搭建mybatis
本人在idea,或Eclipse中新建maven之jar或war工程,再导包。
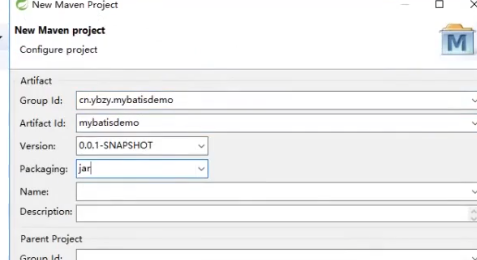
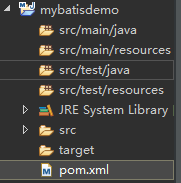
pom.xml加入依赖包,我们要用到的是mybatis,mysql驱动,日志包是必须的
<dependencies>
     <dependency>
       <groupId>org.mybatis</groupId>
       <artifactId>mybatis</artifactId>
       <version>3.4.6</version>
     </dependency>
     <dependency>
		<groupId>log4j</groupId>
		<artifactId>log4j</artifactId>
		<version>1.2.12</version>
	</dependency>
	<dependency>
			<groupId>commons-logging</groupId>
			<artifactId>commons-logging</artifactId>
			<version>1.2</version>
		</dependency>
	<dependency>
			<groupId>mysql</groupId>
			<artifactId>mysql-connector-java</artifactId>
			<version>8.0.16</version>
		</dependency>
		<dependency>
		   <groupId>org.slf4j</groupId>
		   <artifactId>slf4j-log4j12</artifactId>
		   <version>1.7.25</version>
		</dependency>
		<dependency>
			<groupId>junit</groupId>
			<artifactId>junit</artifactId>
			<version>4.10</version>
		</dependency>
  </dependencies>
log4j.properties:日志配置件
log4j.rootLogger = debug,stdout, D
log4j.appender.stdout = org.apache.log4j.ConsoleAppender
log4j.appender.stdout.Target = System.out
log4j.appender.stdout.Threshold = INFO
log4j.appender.stdout.layout = org.apache.log4j.PatternLayout
log4j.appender.stdout.layout.ConversionPattern=%d %p %m%n
log4j.appender.D = org.apache.log4j.DailyRollingFileAppender
log4j.appender.D.File = ./log4j.log
log4j.appender.D.Append = true
log4j.appender.D.Threshold = DEBUG
log4j.appender.D.layout = org.apache.log4j.PatternLayout
log4j.appender.D.layout.ConversionPattern=%d %p %m%n
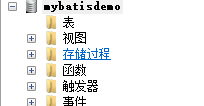
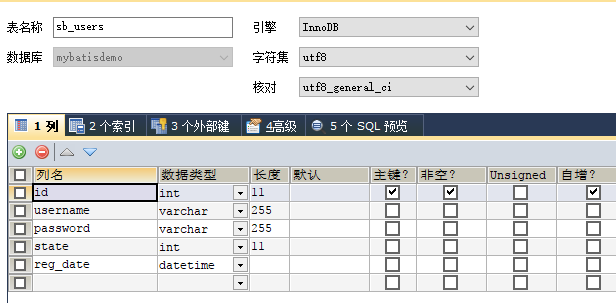
建一个mybatisdemo数据库与sb_users表
mybatis全局配置文件
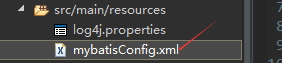
我可以从mybatis参考文档中的’入门’项中,拷呗过来,再改改。
<?xml version="1.0" encoding="UTF-8" ?>
<!DOCTYPE configuration
  PUBLIC "-//mybatis.org//DTD Config 3.0//EN"
  "https://mybatis.org/dtd/mybatis-3-config.dtd">
<configuration>
  <environments default="development">
    <environment id="development">
      <transactionManager type="JDBC"/>
      <dataSource type="POOLED">
        <property name="driver" value="com.mysql.cj.jdbc.Driver"/>
        <property name="url" value="jdbc:mysql://124.220.60.104:3306/mybatisdemo"/>
        <property name="username" value="root"/>
        <property name="password" value="xiong"/>
      </dataSource>
    </environment>
  </environments>
  <mappers>
    <mapper resource="cn/ybzy/mybatisdemo/model/UserMapper.xml"/>
  </mappers>
</configuration>
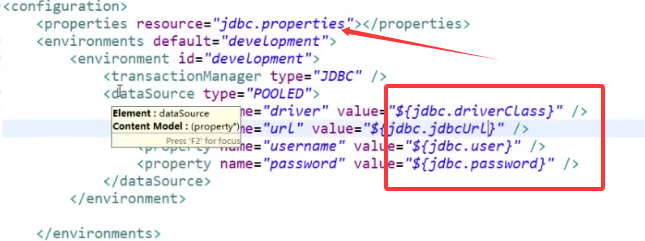
或可以这样配置全局配置文件,这样易修改,不过在springmvc中,不用这样搞,全在sprin gmvc中配
首先:在src/main/resources中建一个jdbc.properties
jdbc.user=root
jdbc.password=xiong
jdbc.driverClass=com.mysql.cj.jdbc.Driver
jdbc.jdbcUrl=jdbc:mysql://124.220.60.104:3306/mybatisdemo
然后:通过${}获取properties中的数据
应用mybatis
一,model类,建一个包(cn.ybzy.mybatisdemo.model),该包放模型类(PAJO),先来一个用户类。
public class User {
	private int id;
	private String username;
	private String password;
	private Date regDate;
	private int state;
	//get,set,toString,无参,有参构造函数

}
二,XXXMapper.xml文件,XXX与model类同名,在model包中建。
域名空间可以自定义,我在此把模型类包全名放进去了。
<?xml version="1.0" encoding="UTF-8" ?>
<!DOCTYPE mapper
  PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN"
  "https://mybatis.org/dtd/mybatis-3-mapper.dtd">
<mapper namespace="cn.ybzy.mybatisdemo.model">
  <select id="selectOneUser" resultType="cn.ybzy.mybatisdemo.model.User">
    select id,username,password,reg_date regDate,state from sb_users where id=#{id}
  </select>
</mapper>
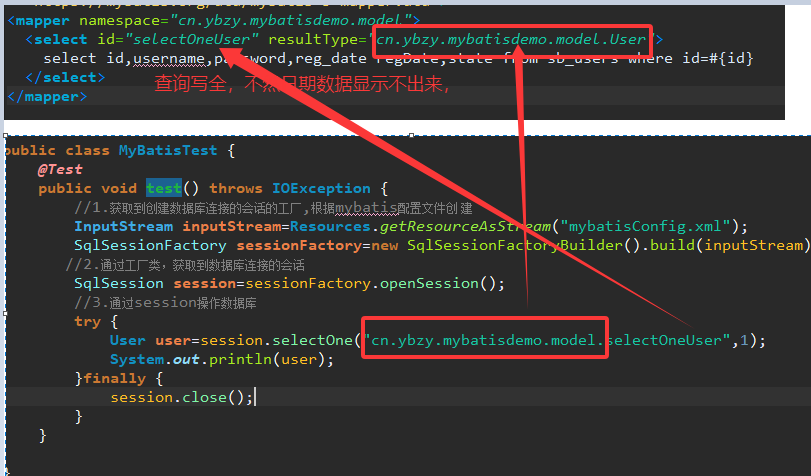
三,测试类中,测试,查询一条用记录,再包装成User对象。
注意:会话查询一条记录方法中,第一个参数是,Mapper.xml文件中域名空间名+查询的id名。
public class MyBatisTest {
	@Test
	public void test() throws IOException {
		//1.获取到创建数据库连接的会话的工厂,根据mybatis配置文件创 建
		InputStream inputStream=Resources.getResourceAsStream("mybatisConfig.xml");
		SqlSessionFactory sessionFactory=new SqlSessionFactoryBuilder().build(inputStream);
	   //2.通过工厂类,获取到数据库连接的会话
		SqlSession session=sessionFactory.openSession();
		//3.通过session操作数据库
		try {
			User user=session.selectOne("cn.ybzy.mybatisdemo.model.selectOneUser",1);
			System.out.println(user);
		}finally {
			session.close();
		}
	}

}
四,MyBatis入门例子升级
上一次课中查询一条User记录并封装到User对象中返回的功能是实现了,但是前面的实现的方法却是过时的,现在,我们更多的是实现面向接口来编程,所以Mybatis的查询方法就升级了:
1.建立与数据库对应的POJO类
2.建立mybatis的配置文件
3.在dao(mapper层)层你给model里的POJO类创建一个接口,不像Hibernate一样需要写它的实现类,这个接口是不直接写实现类的
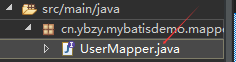
public interface UserMapper {
	/**
	 * 通过用户ID获取用户对象
	 * @param id
	 * @return
	 */
	public User getOneUserById(Integer id);

}
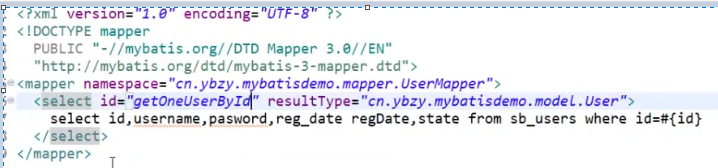
4.修改上次课的POJO对象和Mysql数据的表之间的映射配置UserMapper.xml:①namespace不能自定义了,必须写成上面的接口的全类名,UserMapper和接口实现绑定②select标签的id也不能自定义了,必须写成接口里的对应的方法的方法名,这里是:getOneUser,这样子sql语句和接口的方法绑定了
测试:
public class MyBatisTest {
	@Test
	public void test() throws IOException {
		//1.获取到创建数据库连接的会话的工厂,根据mybatis配置文件创 建
		InputStream inputStream=Resources.getResourceAsStream("mybatisConfig.xml");
		SqlSessionFactory sessionFactory=new SqlSessionFactoryBuilder().build(inputStream);
	   //2.通过工厂类,获取到数据库连接的会话
		SqlSession session=sessionFactory.openSession();
		//3.通过session操作数据库
		try {
			UserMapper mapper=session.getMapper(UserMapper.class);
			User user=mapper.getOneUserById(1);
			System.out.println(user);
		}finally {
			session.close();
		}
	}

}
mybatis全局配置之settings标签
MyBatis 的配置文件包含了会深深影响 MyBatis 行为的设置(settings)和属性(properties)信息。
settings
这是 MyBatis 中极为重要的调整设置,它们会改变 MyBatis 的运行时行为。下表描述了设置中各项的意图、默认值等。
| 设置参数 | 描述 | 有效值 | 黜认值 |
|---|---|---|---|
| cacheEnabled | 全局地开启或关闭配置文件中的所有映射器已经配置的任何缓存。 | true/false | true |
| lazyLoadingEnabled | 延迟加载的全局开关。当开启时,所有关联对象都会延迟加载。 特定关联关系中可通过设置fetchType属性来覆盖该项的开关状态。 | true/false | false |
| aggressiveLazyLoading | 当开启时,任何方法的调用都会加载该对象的所有属性。否则,每个属性会按需加载(参考lazyLoadTriggerMethods). | true / false | false (true in ≤3.4.1) |
| multipleResultSetsEnabled | 是否允许单一语句返回多结果集(需要兼容驱动)。 | true / false | true |
| useColumnLabel | 使用列标签代替列名。不同的驱动在这方面会有不同的表现, 具体可参考相关驱动文档或通过测试这两种不同的模式来观察所用驱动的结果。 | true/false | true |
| mapUnderscoreToCamelCase | 是否开启自动驼峰命名规则(camel case)映射,即从经典数据库列名 A_COLUMN 到经典 Java 属性名 aColumn 的类似映射。 | true/false | false |
| useGeneratedKeys | 允许 JDBC 支持自动生成主键,需要驱动兼容。 如果设置为 true 则这个设置强制使用自动生成主键,尽管一些驱动不能兼容但仍可正常工作(比如 Derby)。 | true/false | false |
| autoMappingBehavior | 指定 MyBatis 应如何自动映射列到字段或属性。 NONE 表示取消自动映射;PARTIAL 只会自动映射没有定义嵌套结果集映射的结果集。 FULL 会自动映射任意复杂的结果集(无论是否嵌套)。 | NONE, PARTIAL, FULL | PARTIAL |
| autoMappingUnknownColumnBehavior | 指定发现自动映射目标未知列(或者未知属性类型)的行为.NONE 不做任何反应,WARNING输出提醒日志 (‘org.apache.ibatis.session.AutoMappingUnknownColumnBehavior’ 的日志等级必须设置为 WARN)FAILING: 映射失败 (抛出 SqlSessionException) | NONE, WARNING, FAILING | NONE |
| defaultExecutorType | 配置默认的执行器。SIMPLE 就是普通的执行器;REUSE 执行器会重用预处理语句(prepared statements); BATCH 执行器将重用语句并执行批量更新。 | SIMPLE REUSE BATCH | SIMPLE |
| defaultStatementTimeout | 设置超时时间,它决定驱动等待数据库响应的秒数。 | 任意正整数 | Not Set (null) |
| defaultFetchSize | 为驱动的结果集获取数量(fetchSize)设置一个提示值。此参数只可以在查询设置中被覆盖。 | 任意正整数 | Not Set (null) |
| safeRowBoundsEnabled | 允许在嵌套语句中使用分页(RowBounds)。如果允许使用则设置为false。 | true/false | false |
| safeResultHandlerEnabled | 允许在嵌套语句中使用分页(ResultHandler)。如果允许使用则设置为false。 | true/false | false |
| localCacheScope | MyBatis 利用本地缓存机制(Local Cache)防止循环引用(circular references)和加速重复嵌套查询。 默认值为 SESSION,这种情况下会缓存一个会话中执行的所有查询。 若设置值为 STATEMENT,本地会话仅用在语句执行上,对相同 SqlSession 的不同调用将不会共享数据。 | SESSION | STATEMENT |
| jdbcTypeForNull | 当没有为参数提供特定的 JDBC 类型时,为空值指定 JDBC 类型。 某些驱动需要指定列的 JDBC 类型,多数情况直接用一般类型即可,比如 NULL、VARCHAR 或 OTHER。 | JdbcType 常量. 大多都为: NULL, VARCHAR and OTHER | OTHER |
| lazyLoadTriggerMethods | 指定哪个对象的方法触发一次延迟加载。 | 用逗号分隔的方法列表。 | equals,clone,hashCode,toString |
一个配置完整的 settings 元素的示例如下:
<settings>
  <setting name="cacheEnabled" value="true"/>
  <setting name="lazyLoadingEnabled" value="true"/>
  <setting name="multipleResultSetsEnabled" value="true"/>
  <setting name="useColumnLabel" value="true"/>
  <setting name="useGeneratedKeys" value="false"/>
  <setting name="autoMappingBehavior" value="PARTIAL"/>
  <setting name="autoMappingUnknownColumnBehavior" value="WARNING"/>
  <setting name="defaultExecutorType" value="SIMPLE"/>
  <setting name="defaultStatementTimeout" value="25"/>
  <setting name="defaultFetchSize" value="100"/>
  <setting name="safeRowBoundsEnabled" value="false"/>
  <setting name="mapUnderscoreToCamelCase" value="false"/>
  <setting name="localCacheScope" value="SESSION"/>
  <setting name="jdbcTypeForNull" value="OTHER"/>
  <setting name="lazyLoadTriggerMethods" value="equals,clone,hashCode,toString"/>
</settings>
<setting name="mapUnderscoreToCamelCase" value="false"/>默认是false, 所以我只能在sql语句中用别名的方式来建立映射关联,但是这个设置改为true,mybatis就会自动用驼峰命名法自动识别关联,就不用在sql语句里写别名了:regDate---reg_date
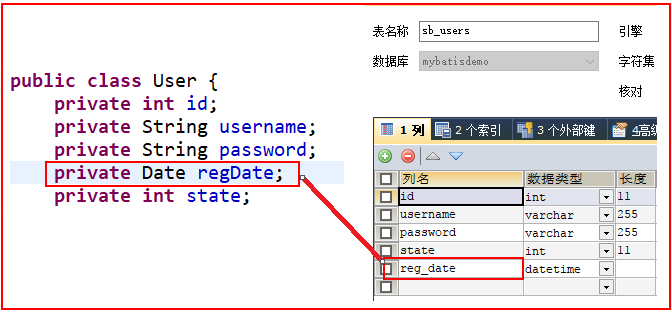
就如上面的入门示例中,我们在model类中,定义了private Date regDate,而在数数据库表中为reg_date,如不作这设置,则带号查询时,reg_date显示为null.
mybatis全局配置之environments标签
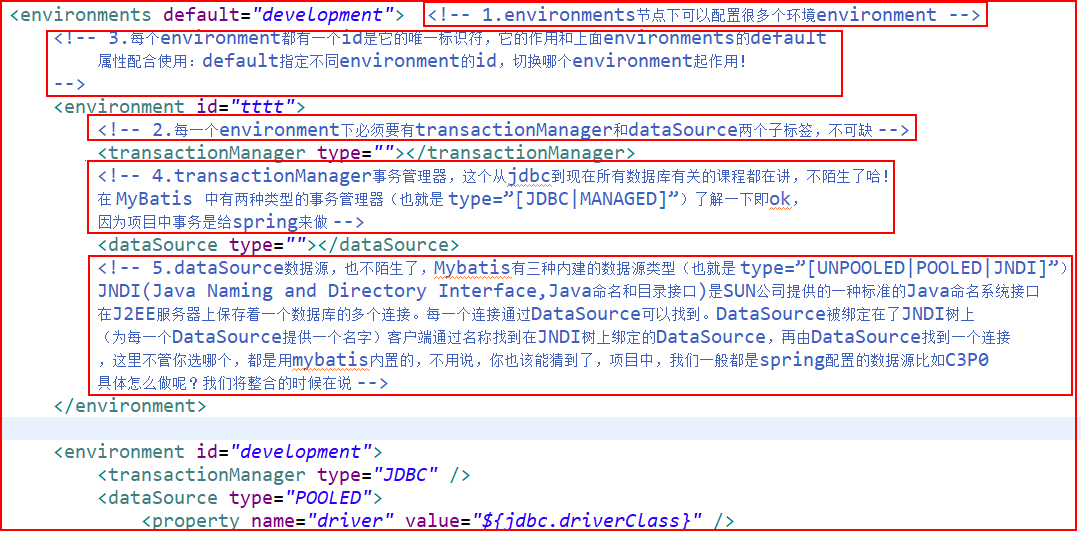
配置环境(environments)
MyBatis 可以配置成适应多种环境,这种机制有助于将 SQL 映射应用于多种数据库之中, 现实情况下有多种理由需要这么做。例如,开发、测试和生产环境需要有不同的配置。
不过要记住:尽管可以配置多个环境,每个 SqlSessionFactory 实例只能和其中一个绑定。 所以,如果你想连接两个数据库,就需要创建两个 SqlSessionFactory 实例,每个数据库对应一个。而如果是三个数据库,就需要三个实例,依此类推。
全局配置文件多数据库支持
在支持多数据库功能上,hibernate是十分方便的只要改驱动代码即可,而mybatis是比较麻烦的。我在此,用以前的项目(sshweb)来让hibernate持久化oracle数据库记录,再来本项目mybatisdemo比较,看看有什么不同的之处。
jdbb.properties
jdbc.user=root
jdbc.password=xiong
jdbc.driverClass=com.mysql.cj.jdbc.Driver
jdbc.jdbcUrl=jdbc:mysql://124.220.60.104:3306/spring5

orcl.user=root
orcl.password=cott
orcl.driverClass=oracle.jdbc.OracleDriver
orcl.jdbcUrl=jdbc:oracle:thin:@124.xx.xx.xx:1521:orcl

jdbc.acquireIncrement=5
jdbc.initialPoolSize=10
jdbc.minPoolSize=1
jdbc.maxPoolSize=100
jdbc.maxStatements=20
jdbc.maxStatementsPerConnection=5
spring.xml,修改数据库方言和数据库源的bean变量即可。
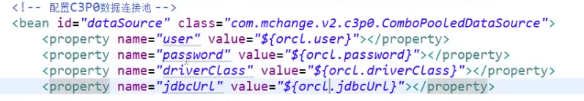
 <property name="hibernateProperties">
         <props>
           <prop key="hibernate.dialect">org.hibernate.dialect.Oracle10gDialect</prop>
ModelClass.hbm.xml模型类中的映射文件的自增长策略要改一下
<generator class="native" />
改为
<generator class="sequence">
    <param name="sequence">seq_id</param>
</generator>
这样就可以了,根本不用去改sql语句。这是hibernate给我们支持多数据库的巨大好处
mybatis支持多数据库的操作,因为mybatis的大我sql语句是我们自已写的,所以显得十分麻烦
jdbc.properties
jdbc.user=root
jdbc.password=xiong
jdbc.driverClass=com.mysql.cj.jdbc.Driver
jdbc.jdbcUrl=jdbc:mysql://124.220.60.104:3306/mybatisdemo

orcl.user=root
orcl.password=cott
orcl.driverClass=oracle.jdbc.OracleDriver
orcl.jdbcUrl=jdbc:oracle:thin:@124.xx.xx.xx:1521:orcl
mybatisConfig.xml
<?xml version="1.0" encoding="UTF-8" ?>
<!DOCTYPE configuration
  PUBLIC "-//mybatis.org//DTD Config 3.0//EN"
  "https://mybatis.org/dtd/mybatis-3-config.dtd">
<configuration>
  <settings>
     <setting name="mapUnderscoreToCamelCase" value="true"/><!--驼峰命名规则允许,这样就可以让java类与数据库表字段可以这样对应regDate对应reg_date,不然查询会出出null-->
  </settings>
  <environments default="mysql"><!-- 默认mysql -->
    <environment id="mysql">
      <transactionManager type="JDBC"/>
      <dataSource type="POOLED">
        <property name="driver" value="com.mysql.cj.jdbc.Driver"/>
        <property name="url" value="jdbc:mysql://124.220.60.104:3306/mybatisdemo"/>
        <property name="username" value="root"/>
        <property name="password" value="xiong"/>
      </dataSource>
    </environment>


    <environment id="oracle">
      <transactionManager type="JDBC"/>
      <dataSource type="POOLED">
        <property name="driver" value="${orcl.driverClass}"/>
        <property name="url" value="${orcl.jdbcUrl"/>
        <property name="username" value="${orcl.user}"/>
        <property name="password" value="${orcl.password}"/>
      </dataSource>
    </environment>

  </environments>
  <databaseIdProvider type="DB_VENDOR">
  <!-- 为各数据库起别名,以便在Mapper映射文件中用
           可用如下代码查询当前厂商名
     String databasemark=session.getConnection().getMetaData().getDatabaseProductName();
	 System.out.println(databasemark);

  -->
     <property name="MySQL" value="mysql"/>
     <property name="Oracle" value="oracle"/>
     <property name="SQL Server" value="sqlserver"/>

  </databaseIdProvider>
  <mappers>
    <mapper resource="cn/ybzy/mybatisdemo/model/UserMapper.xml"/>
  </mappers>
</configuration>
UserMapper.xml,要写多套一样的sql语句,不然出错。这就显得麻烦
<?xml version="1.0" encoding="UTF-8" ?>
<!DOCTYPE mapper
  PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN"
  "https://mybatis.org/dtd/mybatis-3-mapper.dtd">
<mapper namespace="cn.ybzy.mybatisdemo.mapper.UserMapper">
  <select id="getOneUserById" resultType="cn.ybzy.mybatisdemo.model.User" databaseId="mysql">
    <!-- select id,username,password,reg_date regDate,state from sb_users where id=#{id} -->
    select * from sb_users where id=#{id}
  </select>  <!-- mysql的 -->

  <select id="getOneUserById" resultType="cn.ybzy.mybatisdemo.model.User" databaseId="oracle">
    <!-- select id,username,password,reg_date regDate,state from sb_users where id=#{id} -->
    select * from sb_users where id=#{id}
  </select>  <!-- oracle的 -->

</mapper>
注意:如下图示所,在mybatis全局配置文件中配的数据库厂商别名,我们要在映射文件一一对应
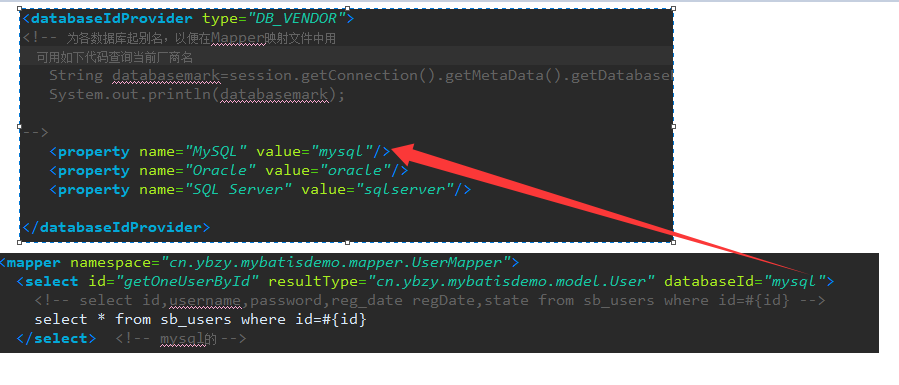
另附上oracle中创建与插入数据
在orcale中创建表:
create table sb_users (
	id int ,
	username varchar(50) ,
	password varchar(100) ,
	state int ,
	reg_date date
);
insert into sb_users (id, username, password, state, reg_date) values('2','admin2','172eee54aa664e9dd0536b063796e54e','1',to_date('2014-02-14','yyyy-mm-dd'));
insert into sb_users (id, username, password, state, reg_date) values('3','mmm','5c79b8413fe81742a4147c9373771394','1',to_date('2018-08-05','yyyy-mm-dd'));
insert into sb_users (id, username, password, state, reg_date) values('4','ttt','882eebb5c59d44a3b85c4adbe54d1ee','1',to_date('2018-08-05','yyyy-mm-dd'));
全局配置文件映射器(mappers-不是映射文件)
映射器(mappers)
既然 MyBatis 的行为已经由上述元素配置完了,我们现在就要定义 SQL 映射语句了。但是首先我们需要告诉 MyBatis 到哪里去找到这些语句。 Java 在自动查找这方面没有提供一个很好的方法,所以最佳的方式是告诉 MyBatis 到哪里去找映射文件。你可以使用相对于类路径的资源引用, 或完全限定资源定位符(包括 file:/// 的 URL),或类名和包名等。例如:
<!-- 使用相对于类路径的资源引用 -->
<mappers>
  <mapper resource="org/mybatis/builder/AuthorMapper.xml"/>
  <mapper resource="org/mybatis/builder/BlogMapper.xml"/>
  <mapper resource="org/mybatis/builder/PostMapper.xml"/>
</mappers>
<!-- 使用完全限定资源定位符(URL) -->
<mappers>
  <mapper url="file:///var/mappers/AuthorMapper.xml"/>
  <mapper url="file:///var/mappers/BlogMapper.xml"/>
  <mapper url="file:///var/mappers/PostMapper.xml"/>
</mappers>
<!-- 使用映射器接口实现类的完全限定类名,我用的是它 -->
<mappers>
  <mapper class="org.mybatis.builder.AuthorMapper"/>
  <mapper class="org.mybatis.builder.BlogMapper"/>
  <mapper class="org.mybatis.builder.PostMapper"/>
</mappers>
1.mapper class=“”,现在的例子中直接这样用,是绝对不行的,因为我的映射文件和接口没放在同一个包了,沿用了hibernate时的习惯,把映射文件放到了model包里了!
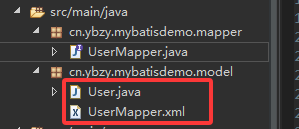
可以将包内的映射器接口实现全部注册为映射器 ,builder是一个包名,这样就是class="xxx.xxx.xxx.接口名“的批量注册,这是我们以后用的。
<mappers>
    <!-- <mapper resource="cn/ybzy/mybatisdemo/model/UserMapper.xml"/> -->
    <!-- <mapper class="cn.ybzy.mybatisdemo.mapper.UserMapper"/> -->
    <package name="cn.ybzy.mybatisdemo.mapper"/>
  </mappers>
2.所以想要使用class属性来讲mapper文件注入到全部配置文件里,就必须保证mapper的文件名和接口的文件名一样,只是后缀不一样,且必须都在一个包目录里才ok。
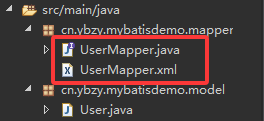
 <mappers>
    <!-- <mapper resource="cn/ybzy/mybatisdemo/model/UserMapper.xml"/> -->
    <mapper class="cn.ybzy.mybatisdemo.mapper.UserMapper"/>
  </mappers>
3.使用class属性来配置,还可以使用注解的方式来关联sql语句,这样子就可以不要UserMapper.xml
public interface UserMapper {
	/**
	 * 通过用户ID获取用户对象
	 * @param id
	 * @return
	 */
	@Select("select * from sb_users where id=#{id}")
	public User getOneUserById(Integer id);

}
在项目开发中,我们有这样的一个建议,注解上的sql往往是比较简单的和不怎么可能写好后会修改的,放这里,因为打包发布后,java文件是不能修改的,比较复杂和重要的,可能会发布以后要修改的sql语句,我们放到xml配置文件里,这样便于以后维护。
映射文件的配置
Mapper XML 文件
MyBatis 的真正强大在于它的映射语句,也是它的魔力所在。由于它的异常强大,映射器的 XML 文件就显得相对简单。如果拿它跟具有相同功能的 JDBC 代码进行对比,你会立即发现省掉了将近 95% 的代码。MyBatis 就是针对 SQL 构建的,并且比普通的方法做的更好。
SQL 映射文件有很少的几个顶级元素(按照它们应该被定义的顺序):
cache – 给定命名空间的缓存配置。
cache-ref – 其他命名空间缓存配置的引用。
resultMap – 是最复杂也是最强大的元素,用来描述如何从数据库结果集中来加载对象。
insert – 映射插入语句
update – 映射更新语句
delete – 映射删除语句
select – 映射查询语句
先把后增删改查实现出来,在细讲:
1,实现表增删改查
UserMaper.java
public interface UserMapper {
	/**
	 * 通过用户ID获取用户对象
	 * @param id
	 * @return
	 */

	public User getOneUserById(Integer id);
	/**
	 * 插入
	 * @param user
	 */
	public void insertUser(User user);
	/**
	 * 更新
	 * @param user
	 */
	public void updateUser(User user);
	/**
	 * 删除一条记录
	 * @param id
	 */
	public void deleteUser(int id);

}
UserMapper.xml
<mapper namespace="cn.ybzy.mybatisdemo.mapper.UserMapper">
  <select id="getOneUserById" resultType="cn.ybzy.mybatisdemo.model.User" databaseId="mysql">
    select * from sb_users where id=#{id}
  </select>  <!-- mysql的 -->

  <select id="getOneUserById" resultType="cn.ybzy.mybatisdemo.model.User" databaseId="oracle">
    select * from sb_users where id=#{id}
  </select>  <!-- oracle的 -->


  <!-- 下面的增删改,我不写oracle的了 -->
  <insert id="insertUser">
     insert into sb_users (username,password,state,reg_date)
        values(#{username},#{password},#{state},#{regDate});
  </insert>

  <update id="updateUser">
     update sb_users set username=#{username},
                         password=#{password},
                         state=#{state},
                         reg_date=#{regDate}
     where id=#{id}

  </update>

   <delete id="deleteUser">
      delete from sb_users where id=#{id}
   </delete>
</mapper>
MybatisTest.java
除了查询外,增删改都要用到commit()提交。
public class MyBatisTest {
	@Test
	public void test() throws IOException, SQLException {
		//1.获取到创建数据库连接的会话的工厂,根据mybatis配置文件创 建
		InputStream inputStream=Resources.getResourceAsStream("mybatisConfig.xml");
		SqlSessionFactory sessionFactory=new SqlSessionFactoryBuilder().build(inputStream);
	   //2.通过工厂类,获取到数据库连接的会话
		SqlSession session=sessionFactory.openSession();
		//拿到数据库厂商的名字
		 //String databasemark=session.getConnection().getMetaData().getDatabaseProductName();
		 //System.out.println(databasemark);
		//3.通过session操作数据库
		try {
			//User user=session.selectOne("cn.ybzy.mybatisdemo.model.selectOneUser",1);
			UserMapper mapper=session.getMapper(UserMapper.class);

			//查询一条记录并封装
			//User user=mapper.getOneUserById(1);
			//System.out.println(user);

			//添加记录
			User user=new User(2,"熊少文","admin123",new Date(),1);
			//mapper.insertUser(user);


			//修改一条记录
			//user.setUsername("熊少斌");
			//mapper.updateUser(user);


			//删除一条记录
			mapper.deleteUser(2);
			session.commit();
		}finally {
			session.close();
		}
	}

}
增改删是可以直接设置返回值的,不用在Mapper.xml文件中用resultType来设置。int, long, boolean 都可以是直接返回值类型,int 和long返回影响数据库条数,boolean影响的条数大于零就是true
2.映射文件获取新增记录的id
我们在讲JDBC的时候讲过在插入新数据值的时候需要获得到自动生成的那个主键id的值:
①获取PreparedStatement的对象的时候:
PreparedStatement st = conn.prepareStatement(sql,Statement.RETURN_GENERATED_KEYS );
②在执行SQL语句后:
st.executeUpdate();
ResultSet rs = st.getGeneratedKeys(); //得到插入行的主键
③最终拿到:
if(rs.next())
System.out.println(rs.getInt(1));
Mybatis是对jdbc封装后的工具,当然也能做jdbc能做所有操作,那么Mybatis怎么获取新增的记录的这个id值?这里有分了两种数据库,一种是mysql这样的数据库支持自动增长,还有一种就是Oracle这样的不支持id自增的:
首先,我们来看看mysql
我们设置的表id是自增长的,而我们插入数据时带的id不算数的。所以我们获取刚插入对象的id不是表中对应的,而是对象设定的。而查询封装后对象没有这方面的问题。
           User user=new User(10,"xiongshaowen10","xiong",new Date(),1);
			mapper.insertUser(user);
			System.out.println(user.getId());  //10,而我插入的数据库库中的由于自增长赋值为7
			session.commit();
处理:在生UserMapper.xml中把插入语句,增加两个属性,再执行上面的代码,就会查询到表中的id为7
<insert id="insertUser" useGeneratedKeys="true" keyProperty="id">
     insert into sb_users (username,password,state,reg_date)
        values(#{username},#{password},#{state},#{regDate});
  </insert>
然后:我们看看oracle
前面我们用hibernate做的sshweb项目切换oracle数据库的时候,主键id自增是通过配置序列来实现的
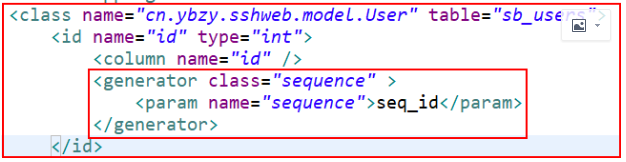
看看,这个配置本质上是怎么回事呢?本质是orcale为对应的表先添加一个序列列,这个序列列里的序列号是可以自增的:
create sequence userid_seq
minvalue 1                    //初始序号为1
maxvalue                     //不设最大序号,用默认就不写,这里也可以设置
start with 1                //从1开始计算
increment by 1               //每次增1
NOCYCLE                      //直累加,不循环
cache 20                     //缓存20个
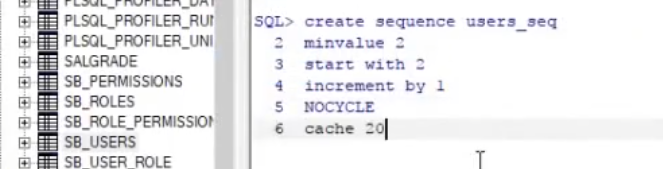
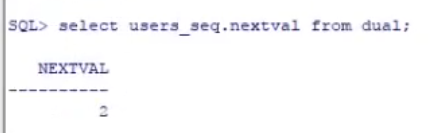
然后我们发起insert的sql语句的时候,在执行insert之前,我们先通过userid_seq .nextval(序列中的下一个数值),然后把这个值作为用户id插入数据库,这个序列值有个特性userid_seq.nextval拿一次,它递增一次,从而实现id值的自增长。
当前序列列增量的修改:alter sequence 序列名 increment by 数值;
删除序列列:drop sequence 序列名;
①select USERID_SEQ.nextval from dual; 然后在用这个值做id插入数据库。
② 还可一步到位:insert into sb_users (id,username,password,state,reg_date) values (userid_seq.nextval,‘tttt’,‘tt’,1,to_date(‘2018-09-01’,‘yyyy-MM-dd’));
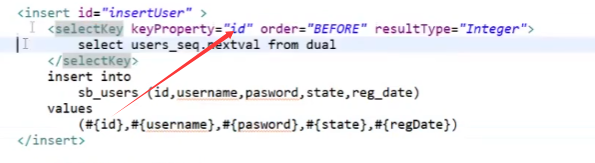
以上是orcale通过sequence实现自增长的本质,那么在Mybatis怎么搞呢?
UserMapper.xml
3.映射文件中获取多个参数的写法
到现在为止,我们前面的例子中,xml的映射文件中获取接口方法中传来的参数是直接用#{}的方式来获取的.
那么接下来,我们就具体来说一下获取参数里边的各种规则和用法:
1.单个参数,比如上面的getOneUser,只有一个id值作为参数
Mybatis对于只有一个参数的情况下,不会做任何处理,其实在getOneUser方法中,我们传递过来一个id值作为参数,xml文件中我们用#{id}来接收,因为只有一个参数实质上#{}里可以是任何字符串都可以(自定义),当然为了对应我们建议就用id。
2.多个参数的情况下,Mybatis会将参数封装为一个Map对象,#{}其实内部是从这个Map对象中获取数值,所以#{}里就不能像上面一个参数一样写任意字符串都可以了,可以有两种写法一种是:参数1对应param1,参数2对应param2.....另一种写法:参数1对应索引arg0,参数2对应索引arg1.......
UserMapper.java,UserMapper.xml
public interface UserMapper {
	/**
	 * 通过用户ID获取用户对象
	 * @param id
	 * @return
	 */
	public List<User> getUsersById(int start_id,int end_id);  //xml文件,查询的方法两参必须为param1,param2或arg1,arg2
	//......
}
xml文件中不支持>,<号,所以我们可以从网上查询对应的写法,如>=可写成<![CDATA[>=]]或>=
<mapper namespace="cn.ybzy.mybatisdemo.mapper.UserMapper">
<select id="getUsersById" resultType="cn.ybzy.mybatisdemo.model.User" databaseId="mysql">
select * from sb_users where id <![CDATA[>=]] #{param1} and id <= #{param2} <!--或#{arg1 |arg2} 获取大于等于某id到小于等于某id号的所有记录的集合,当然要改变接口的返回类型为List -->
</select>
测试:
public class MyBatisTest {
	@Test
	public void test() throws IOException, SQLException {
		//1.获取到创建数据库连接的会话的工厂,根据mybatis配置文件创 建
		InputStream inputStream=Resources.getResourceAsStream("mybatisConfig.xml");
		SqlSessionFactory sessionFactory=new SqlSessionFactoryBuilder().build(inputStream);
	   //2.通过工厂类,获取到数据库连接的会话
		SqlSession session=sessionFactory.openSession();
		//拿到数据库厂商的名字
		 //String databasemark=session.getConnection().getMetaData().getDatabaseProductName();
		 //System.out.println(databasemark);
		//3.通过session操作数据库
		try {
			//User user=session.selectOne("cn.ybzy.mybatisdemo.model.selectOneUser",1);
			UserMapper mapper=session.getMapper(UserMapper.class);

//查询记录并封装

			//查询从id某某到某的记录集合
			  List<User> users=mapper.getUsersById(1,4);
			  System.out.println(users);

         }
	}

}
//[User [id=1, username=xiongshaowen, password=123456, regDate=Thu Oct 30 09:38:28 CST 2025, state=1], User [id=3, username=熊少文, password=admin123, regDate=Sat Nov 01 10:25:45 CST 2025, state=1], User [id=4, username=徐会凤, password=xu, regDate=Sun Nov 02 14:48:25 CST 2025, state=1]]
这种写法,没有和接口方法中的名字对应起来,不爽!所以我们可以在接口方法中做点事情:加上一个@param(value)这样的注解,就可改变封装的map对象的key值,就可以实现接口方法里的参数名和xml文件内接收参数名对应一致了:
UserMapper.java
public List<User> getUsersById(@Param("start_id") Integer start_id,@Param("end_id") Integer end_id);
***UserMapper.xml```
<mapper namespace="cn.ybzy.mybatisdemo.mapper.UserMapper">
<select id="getUsersById" resultType="cn.ybzy.mybatisdemo.model.User" databaseId="mysql">
select * from sb_users where id >= #{start_id} and id <= #{end_id}
</select>
</mapper>
面对多个参数传递的问题,我们还有一种搞法,将多个参数值封装为一个POJO对象,直接传递对象过来就像上面的 insertuser方法一样,在xml文件里直接用#{POJO的属性名称}的形式来获取传过来的值,当然你说我要查询的数据不是我们model包里的任何一个POJO呢?要用这种方式,没有对应的POJO,我们可以自己构造一个与参数对应的封装对象,这个我们后面写分页查询的时候用的Pager类就是一个典型:
最后还有一种做法:既然面对多个参数传递的时候,Mybatis会把参数封装成Map对象,那么索性我干脆就传入一个Map对象也是可以的,xml文件里获取参数值就用#{Map的key值}:
UserMapper.java
public interface UserMapper {
	/**
	 * 通过用户ID获取用户对象
	 * @param id
	 * @return
	 */
	//public User getOneUserById(int id);
	//public List<User> getUsersById(int start_id,int end_id);  //xml文件,查询的方法两参必须为param1,param2或arg1,arg2
    //public List<User> getUsersById(@Param("start_id") Integer start_id,@Param("end_id") Integer end_id);
	public List<User> getUsersById(Map<String,Object> map);
	//....
}
UserMapper.xml与上面代码一样
测试:代码要改一下
    try {
			//User user=session.selectOne("cn.ybzy.mybatisdemo.model.selectOneUser",1);
			UserMapper mapper=session.getMapper(UserMapper.class);
			//Map参数法
			  Map<String,Object> map=new HashMap<String, Object>();
			  //下面的start_id,end_id,健要一一对应UserMapper.xml的方法中的参数名
			  map.put("start_id", 1);
			  map.put("end_id", 4);
			   List<User> users=mapper.getUsersById(map);
			  System.out.println(users);
	    }
如果参数类型是集合Collection(List,Set)或者是数组,Mybatis也会把这些类型的参数封装在一个Map对象中传递到xml文件,那么在xml文件里获取参数的方式也有特别的写法:::集合类型的变量,xml取值的时候map的key是collection,List集合的话写list也可以,数组的话key是array:
UserMapper.java,UserMapper.xml
public List<User> getUsersById(List<Integer> ids); //集合方式传递多个id号
select * from sb_users where id >= #{collection[0]} and id <= #{collection[1]}
测试:
         List<Integer> ids= new ArrayList<Integer>();
   		  ids.add(1);
   		  ids.add(4);
   		  List<User> users = mapper.getUsersById(ids);
   		  System.out.println(users);
数组方法
UserMapper.java,UserMapper.xml
public List<User> getUsersById(int[] ids); //集合方式传递多个id号
select * from sb_users where id >= #{array[0]} and id <= #{array[1]}
测试:
           int[] ids = {1,4};
   		  List<User> users = mapper.getUsersById(ids);
   		  System.out.println(users);
4.映射文件中获取参数的符号#{}和${}的区别
前面我们在xml映射文件中获取参数的符号都是用的#{}的方式,其实Mybatis还支持另一种符号来接收传递过来的参数值,就是${},他们是区别就在与底层使用jdbc的statement不一样:
#{}对应的是PreparedStatementd对象来执行sql语句
${}对应的是Statement对象来执行sql语句
反应在sql语句的异同就是用不用站位符:
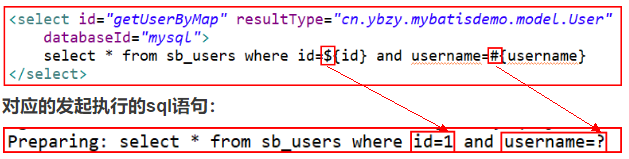
结论:
#{}没后sql注入攻击的安全问题,大多数我们都是使用它
${}有sql注入攻击的安全问题,特殊的情况下使用它,什么时候使用呢?
   凡是原生的jdbc不能使用占位符的地方,就只能使用它,因为PreparedStatementd中,可以用占位符的地方之后,
where条件语句的参数中,其他地方不能用,比用表名称,order by 排序字段,
这些地方是不能用?占位符的,
5.映射文件中#{}里的其他属性
#{}里除了可以写接收参数的名称外,还可以设置javaType,jdbcType,mode,numericScale,resultMap,typeHandler,jdbcTypeName这些属性的。
其他的属性除mode(存储过程相关讲到存储过程的时候在讲)外使用方式都是差不多,这里我用jdbcType解决oracle数据库不能识别mybatis的null值为例,说一下它的使用方法,mysql没有这个问题:
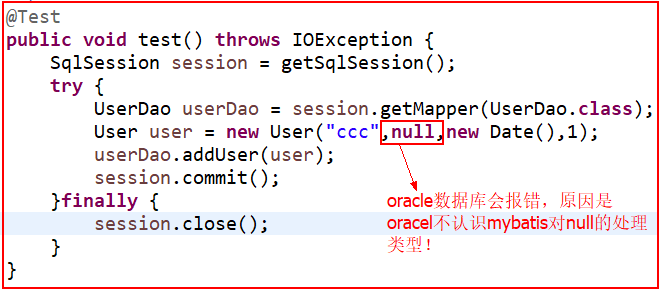
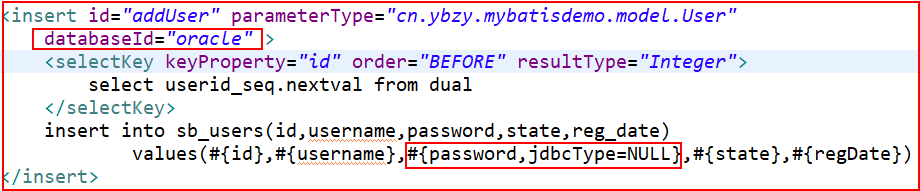
解决办法在对应的接收参数的#{}里设置jdbcType属性值为NULL,表示:如果这个字段为null,对应的数据类型也是null,oracle就能识别了:
上面是一种解决方案,Mybatis里还有另一种解决方案:
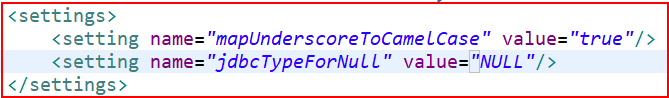
官方手册里,有一个全局变量jdbcTypeForNull,它的默认值是THER,也就是说当字段值为null的时候,Mybatis把这个字段的类型映射为了原生jdbc中的OTHER类型了,这个类型Mysql认识,Oracle不认识,所以报错,除上面的直接在映射文件的#{}里添加jdbcType属性外,还可以设置全局变量来解决:
6.映射文件中select标签resultType属性的使用
在入门例子中实现了数据库的最最基本操作“增删改查”,“查”是最复杂的,有各种各样的查询,所以对应到Mybatis中的select标签也是这四个操作中最复杂的,接下来我们就逐一的学习这里头的知识点:
首先我们来看一下:resultType属性的使用
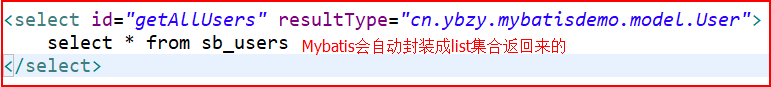
1.返回的结果是List集合的类型,select标签里的resultType类型设置为List集合里的元素类型
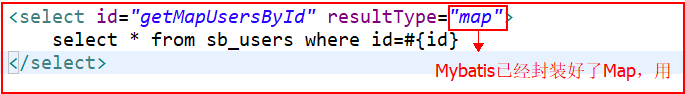
2.返回一个Map集合,key是列名称,value是列对应的值
public Map<String, Object> getMapUsersById(Integer id);
UserMapper.java
    /**
	 * 通过用户ID获取用户对象
	 * @param id
	 * @return
	 */
	//public User getOneUserById(int id);
	//public List<User> getUsersById(int start_id,int end_id);  //xml文件,查询的方法两参必须为param1,param2或arg1,arg2
    //public List<User> getUsersById(@Param("start_id") Integer start_id,@Param("end_id") Integer end_id);
	//public List<User> getUsersById(Map<String,Object> map);
	//public List<User> getUsersById(List<Integer> ids);   //集合方式传递多个id号
	public Map<String,Object> getOneUserById(int id);
测试:
try {
			//User user=session.selectOne("cn.ybzy.mybatisdemo.model.selectOneUser",1);
			UserMapper mapper=session.getMapper(UserMapper.class);

//返回类类型是Map,key是列名称,value是列对应的值
			  Map<String,Object> map=mapper.getOneUserById(1);
			  System.out.println(map);
	//{reg_date=2025-10-30 09:38:28.0, password=123456, id=1, state=1, username=xiongshaowen}
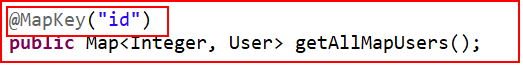
3.返回的查询结果也是Map集合,但我们要这样子的结构:Map<Integer,User>,Map中的key是User的id,Map的值是User对象,实现它的关键是我们要在接口的方法上加一个注解,告诉Mybatis用哪个字段做Map的key:
UserMapper.xml
<select id="getAllMapUsers" resultType="map" databaseId="mysql">
      select * from sb_users
  </select>
测试:
       Map<Integer, User> maps=mapper.getAllMapUsers();
	   System.out.println(maps);
{
  1={reg_date=2025-10-30 09:38:28.0, password=123456, id=1, state=1, username=xiongshaowen},
  3={reg_date=2025-11-01 10:25:45.0, password=admin123, id=3, state=1, username=熊少文},
  4={reg_date=2025-11-02 14:48:25.0, password=xu, id=4, state=1, username=徐会凤},
  8={reg_date=2025-11-07 09:52:53.0, password=xiong, id=8, state=1, username=xiongshaowen10}
}
映射文件中的select属性resultMap的使用
手册里resultType和resultMap介绍有点模糊,说清楚了resultType是期望的返回的类型,集合的话是集合包含的类型,不是集合本身,且这两个不能同时使用,resultMap没说清楚,这里我们明确一下:
其实两者的关系就是resultType解决数据表上的字段名称和JavaBean上的属性名称不一致的时候,前面介绍了两种方案,①在sql语句上起别名;②设置全局变量mapUnderscoreToCamelCase让符合驼峰命名约定的两个名字建立关联,如JavaBean属性名称regDate对应数据库字段名reg_date;其实这里还有第三种解决方案就是resultMap,它可以让我们指定定义数据库里的字段名称对应JavaBean的属性名称。
select属性resultMap的使用
1.使用resultMap自定义数据库字段名称和JavaBean的属性名称的对应关系,关键就是定义一组resultMap标签:
下面代码可以使模型类中的pasword对应表中的password两者相差一个s,但不会显示null,驼峰命名的对应显示也不为空,可以正常查询封装。
UserMapper.xml
 <select id="getOneUserById" resultType="user_rsm" databaseId="mysql">

      select * from sb_users where id=#{id}
  </select>
<resultMap type="cn.ybzy.mybatisdemo.model.User" id="user_rsm">
     <id property="id" column="id"/>
     <result property="pasword" column="password"/>
     <result property="regDate" column="reg_date"/>
     <result property="username" column="username"/>
     <result property="state" column="state"/>
  </resultMap>
测试:
    @Test
	public void test() throws IOException, SQLException {
		//1.获取到创建数据库连接的会话的工厂,根据mybatis配置文件创 建
		InputStream inputStream=Resources.getResourceAsStream("mybatisConfig.xml");
		SqlSessionFactory sessionFactory=new SqlSessionFactoryBuilder().build(inputStream);
	   //2.通过工厂类,获取到数据库连接的会话
		SqlSession session=sessionFactory.openSession();

		//3.通过session操作数据库
		try {
			//User user=session.selectOne("cn.ybzy.mybatisdemo.model.selectOneUser",1);
			UserMapper mapper=session.getMapper(UserMapper.class);

//查询记录并封装
			  User user=mapper.getOneUserById(2);
			  System.out.println("user:"+user);
	  }
}
2.使用resultMap实现关联查询(在hibernate中是自动完成的,Mybatis得我们手工配置)
试验步骤:
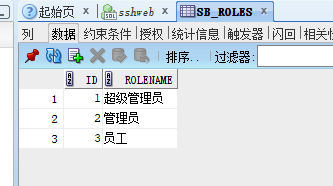
①新增Role类,和sb_roles表(不做外键,外键由代码维护关系),在User你新增属性Role role;一对多关系,用户是多的一方。
Role.java
public class Role {
	private int id;
	private String rolename;
	private List<User> users;   //角色与用户是一对多的关系,用户是多的
	//get,set,toString方法,toString方法不输出users,如有的话会你中有我,我中有你,死循环,可能会卡机。
}
User.java
private Role role; //关联查询中用到
②在UserDao.xml重写sql和resultMap(复杂的查询结果resultType是吃不够的,必须用resultMap)
③编写对应的resultMap(通过级联的方式建立关联):
   <select id="getOneUserById" resultMap="user_rsm" databaseId="oracle">
       select u.id,u.username,u.password,u.reg_date,u.state,r.id rid,r.rolename  from sb_users u,sb_roles r  where u.role_id=r.id and u.id=#{id}
  </select>  <!-- oracle的 -->
  <resultMap type="cn.ybzy.mybatisdemo.model.User" id="user_rsm">
     <id property="id" column="id"/>
     <result property="pasword" column="password"/>
     <result property="regDate" column="reg_date"/>
     <result property="username" column="username"/>
     <result property="state" column="state"/>
     <result property="role.id" column="rid"/>
     <result property="role.rolename" column="rolename"/>
  </resultMap>
测试:仍用上面的测试代码查询用户id为2的看看结果
user:User [id=2, username=熊少文, pasword=172eee54aa664e9dd0536b063796e54e, regDate=Fri Feb 14 00:00:00 CST 2014, state=1, role=Role [id=1, rolename=超级管理员]]
3.在上面的基础上使用association标签实现关联查询
 <select id="getOneUserById" resultMap="user_rsm" databaseId="oracle">
    select u.id,u.username,u.password,u.reg_date,u.state,r.id rid,r.rolename  from sb_users u,sb_roles r  where u.role_id=r.id and u.id=#{id}
  </select>  <!-- oracle的 -->
  <resultMap type="cn.ybzy.mybatisdemo.model.User" id="user_rsm">
     <id property="id" column="id"/>
     <result property="pasword" column="password"/>
     <result property="regDate" column="reg_date"/>
     <result property="username" column="username"/>
     <result property="state" column="state"/>
     <!-- 以下的方式,是通过级联的方法,实现关联查询 -->
     <!--
       <result property="role.id" column="rid"/>
       <result property="role.rolename" column="rolename"/>
      -->

      <!-- 以下的方法,通过子标签association来实现关联查询 -->
      <association property="role" javaType="cn.ybzy.mybatisdemo.model.Role">
         <id property="id" column="rid"/>  <!-- 是上面的select查询返回的r.id的别名 -->
         <result property="rolename" column="rolename"/>
      </association>
  </resultMap>
4.在上面的基础上使用association标签分步实现关联查询
试验步骤:
①把RoleDao.java接口和RoleDao.xml建好,定义一个getRoleById的方法
②修改UserMapper.xml的内容:
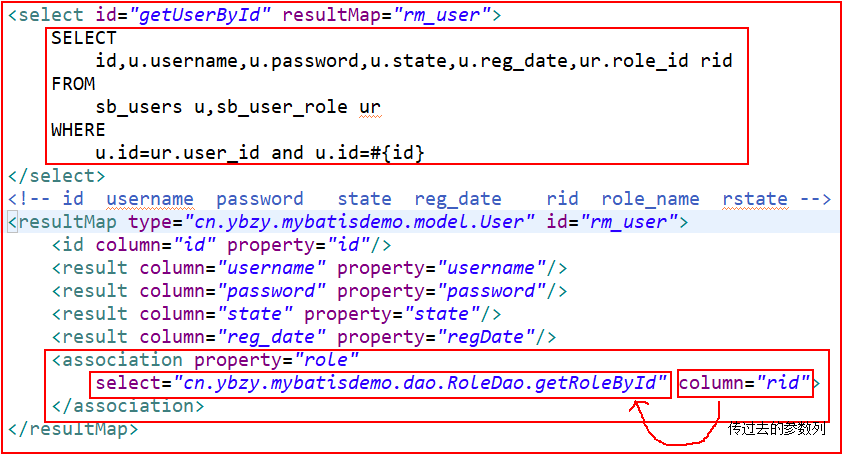
把2中的发起一条sql语句,变成了发起两条sql语句分步执行。
6.在分步查询的基础上配置懒加载
懒加载的概念,大家学习了我的Hibernate这门课,都不陌生了,Hibernate中,涉及到关联查询的时候,懒加载是默认就开启着的,前面讲过设计懒加载就是,在关联查询中,真正需要用到关联的对象的时候,才发起sql语句,从数据库中查询数据,从而实现提升数据库性能的目标。
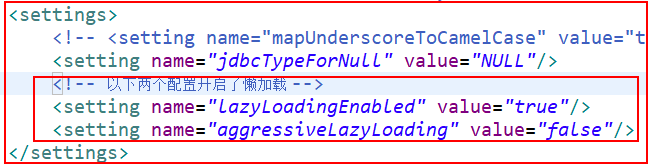
Mybatis作为一个优秀的ORM框架当然也支持懒加载,和Hibernate不同是,它默认情况下是禁止了懒加载的,要使用懒加载需要手动的开启,开启的方法就是配置两个全局变量:lazyLoadingEnabled设置为true,aggressiveLazyLoading设置为false
关联查询的对象是集合的处理
前面我们假设的是一个用户只能绑定一个角色,但实际上权限管理模型中,用户和角色之间是多对多的关系,也就是说,一个用户可以有多个角色与之绑定,所以在User对象中,角色的属性就必须是一个集合Set或者List,这里我们就用List集合在做例子:上面的一对多中,我们在Role.java中定义了一个成员List users;
RoleMapper.java
public interface RoleMapper {
	/**
	 * 查询一个角色,这个查询不能查出与关联的所有用户信息
	 * @param i
	 * @return
	 */
	public Role getOneRoleById(int i);
	/**
	 * 与role关联的users,以List集合查出来
	 */
	public Role getAllProRoleById(int id);


}
1.怎么在Mybatis中实现关联的List集合对象users的查询,关键就是collection标签的使用:
RoleMapper.xml
<mapper namespace="cn.ybzy.mybatisdemo.mapper.RoleMapper">
   <select id="getOneRoleById" resultType="cn.ybzy.mybatisdemo.model.Role">
      select * from sb_roles where id=#{id}
   </select>

   <select id="getAllProRoleById" resultMap="role_rsm" databaseId="oracle">  <!-- resultType返回的查询结果,不能是关联复杂的查询 -->
      select r.id,r.rolename,u.id uuid,u.username,u.password,u.reg_date,u.state from sb_roles r,sb_users u where u.role_id=r.id AND r.id=#{id}
   </select>
   <resultMap type="cn.ybzy.mybatisdemo.model.Role" id="role_rsm">
      <id property="id" column="id"/>
      <result property="rolename" column="rolename"/>
      <collection property="users" ofType="cn.ybzy.mybatisdemo.model.User">
          <id property="id" column="uuid"/>
          <result property="username" column="username"/>
          <result property="pasword" column="password"/>
          <result property="regDate" column="reg_date"/>
          <result property="state" column="state"/>

      </collection>
   </resultMap>
</mapper>
测试:
public class UserRoleTest {
	@Test
	public void test() throws IOException, SQLException {
		//1.获取到创建数据库连接的会话的工厂,根据mybatis配置文件创 建
		InputStream inputStream=Resources.getResourceAsStream("mybatisConfig.xml");
		SqlSessionFactory sessionFactory=new SqlSessionFactoryBuilder().build(inputStream);
	   //2.通过工厂类,获取到数据库连接的会话
		SqlSession session=sessionFactory.openSession();

		//3.通过session操作数据库
		try {
			//User user=session.selectOne("cn.ybzy.mybatisdemo.model.selectOneUser",1);
			RoleMapper roleMapper=session.getMapper(RoleMapper.class);

     //查询记录并封装
			  Role role=roleMapper.getAllProRoleById(1);
			  System.out.println("Role:"+role);


		}finally {
			session.close();
		}
	}


}
//Role:Role [id=1, rolename=超级管理员, users=[User [id=2, username=熊少文, pasword=172eee54aa664e9dd0536b063796e54e, regDate=Fri Feb 14 00:00:00 CST 2014, state=1, role=null], User [id=5, username=徐会凤, pasword=xuhuifeng, regDate=Mon Nov 17 00:00:00 CST 2025, state=1, role=null]]]
//打印结果中可以看到,id为1 的超级管理员有两个用户。
2.同样和association标签查询单个关联对象的属性一样,集合类型的关联属性也可以懒加载:也有select属性,该属性是查询用户的方法,它要在UserMapper中定义好。
1.UserMapper.java/UserMapper.xml
    /**
	 * 通过角色ID,查询用户集合
	 */
    public List<User> getUsersByRoleId(int roleId);
  <select id="getUsersByRoleId" resultType="cn.ybzy.mybatisdemo.model.User">
     select * from sb_users where role_id=#{role_id}
  </select>
2.RoleMapper.java不变,RoleMapper.xml修改如下
 <!-- 下面也实现查询单个角色,但可以显示角角色中所有用户的信息。 -->
   <select id="getAllProRoleById" resultMap="role_rsm" databaseId="oracle">  <!-- resultType返回的查询结果,不能是关联复杂的查询 -->
      <!-- select r.id,r.rolename,u.id uuid,u.username,u.password,u.reg_date,u.state from sb_roles r,sb_users u where u.role_id=r.id AND r.id=#{id} -->
       <!-- 分步实现:关联查询,升级一下,可以实现懒加载,就不用查询那么多字段了,当要显示用户信息时再发出sql语句 -->
       select * from sb_roles where id=#{id}
   </select>
   <resultMap type="cn.ybzy.mybatisdemo.model.Role" id="role_rsm">
      <!--
      <id property="id" column="id"/>
      <result property="rolename" column="rolename"/>
      <collection property="users" ofType="cn.ybzy.mybatisdemo.model.User">
          <id property="id" column="uuid"/>
          <result property="username" column="username"/>
          <result property="pasword" column="password"/>
          <result property="regDate" column="reg_date"/>
          <result property="state" column="state"/>

      </collection>
        -->
      <!-- 升级为分步查询关联,并懒加载之,注意:要用到UserMapper的方法-->
       <id property="id" column="id"/>
      <result property="rolename" column="rolename"/>
      <collection property="users" select="cn.ybzy.mybatisdemo.mapper.UserMapper.getUsersByRoleId" column="id">
      </collection>
   </resultMap>
3.mybatisConfig.xml全局配置文件中开启懒加载功能
-----
 <settings>
     <setting name="mapUnderscoreToCamelCase" value="true"/><!--驼峰命名规则允许,这样就可以让java类与数据库表字段可以这样对应regDate对应reg_date,不然查询会出出null-->
     <!-- 下面两个项,是开启懒加载功能 -->
     <setting name="lazyLoadingEnabled" value="true"/>
     <setting name="aggressiveLazyLoading" value="false"/>
  </settings>
  <environments default="oracle"><!-- 默认mysql -->
 -----
测试:分别执行下面三条输出语句,可以看出,只查角色名时,发送一条sql语句,其它都发送了两条sql语句
    //3.通过session操作数据库
		try {
			RoleMapper roleMapper=session.getMapper(RoleMapper.class);

     //查询记录并封装
			  Role role=roleMapper.getAllProRoleById(1);
			  //System.out.println("Role:"+role);
			  //System.out.println(role.getRolename());
			  System.out.println(role.getUsers().size());

		}finally {
			session.close();
		}
最后在总结一下,并补充两个知识点:
不管是association标签还是collection标签,在分步查询的时候,都可以用column属性,给select指定的sql语句传入某列的值做参数,这里补充的第一个知识点就是,前面的传参都是只传入了一个参数,所以,如果需要传入多个参数是怎么办? 可以封装成Map对象,写成这个的格式{key=value,…}
<collection property="users" select="cn.ybzy.mybatisdemo.mapper.UserMapper.getUsersByRoleId" column="{role_id=id,xxx=rolename}">
第二个知识点,其实前面已经提及了一下,就是全局虽然设置为了懒加载,但是如果某个关联对象查询,不想使用懒加载,要立即加载,不用在改回全局变量,只需要association标签或者collection标签设置上fetchType属性就可以,它有两个取值:lazy表示懒加载,eager表示立即加载!
 <collection property="users" fetchType="eager"
 select="cn.ybzy.mybatisdemo.mapper.UserMapper.getUsersByRoleId" column="{role_id=id,xxx=rolename}">
一级缓存
Mybatis和Hibernate一样,也有一级和二级缓存,同样默认开启的只有一级缓存,二级缓存也需要手动配置开启,我们先看看一级缓存:
通过一个实验,验证一级缓存的存在:只发送了一条sql查询语句
//测试一级缓存的存在性和默认开启性
			  UserMapper userMapper=session.getMapper(UserMapper.class);
			  User user1=userMapper.getOneUserById(2);
			  System.out.println(user1);

			  User user2=userMapper.getOneUserById(2);
			  System.out.println(user2);
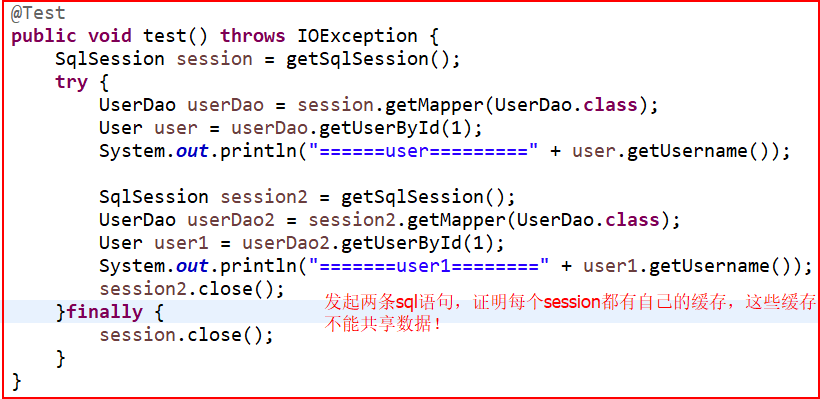
一级缓存又被称为session级别的缓存,mybatis一直默认是开启的,每个与数据库的链接回话都有各自自己的缓存,这些一级缓存之间是不能通信的,是相互独立的缓存空间!
通过几次实验,加深对一级缓存的理解:
第一个实验,查询同一个id的用户,但是用不同的sqlsession:
第二个实验,用同一个session,但是查询的id不一样:,没有肯定会发送sql语句。
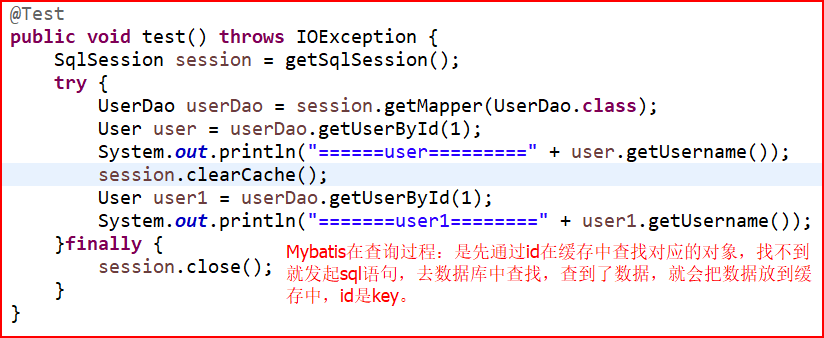
第三个实验,还是同一个session,查询相同id的user,但查询中间,手动把session里的缓存干掉:
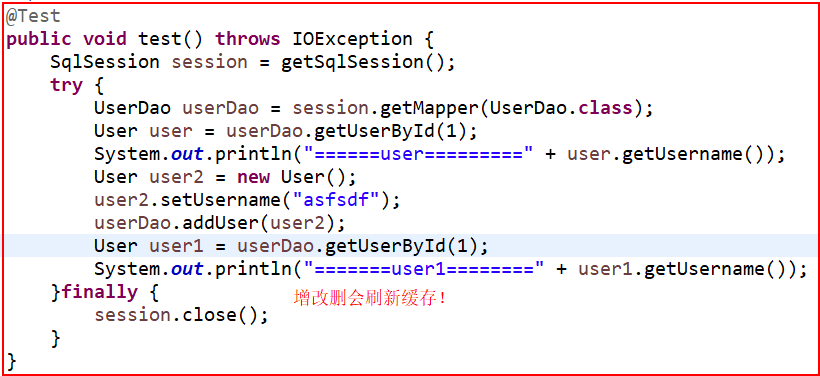
第四个实验,还是同一个session,查询相同id的user,查询中间,做了增改删:
二级缓存
Mybatis默认情况下二级缓存是关闭的,需要手工的配置开启,在开启之前,我们先说说二级缓存的基本知识点:
1.二级缓存又称为全局缓存,它是基于namespace级别的缓存,一个名称空间对应一个二级缓存,也就是说一般情况下同一个映射文件中的查询都共享一个共同的二级缓存空间。
2.一级缓存的生命周期随着一次会话session的关闭而清空,开启二级缓存的情况下,一级缓存里的数据,在清空或者提交之前会转存到二级缓存的空间中继续存在。
3.当一次会话sqlsession的缓存里如果存放着两个不同类型的对象,比如User和Role对象,当一级缓存清空之前,开起二级缓存的情况下,它们两个对象会分别存入各自的名称空间的二级缓存空间中;直白地时候就是一级缓存中两个对象是放在同一Map对象(缓存就是Map对象),在二级缓存中两个对象是分别放在两个独立的Map对象里的(各自的缓存空间里)。
使用二级缓存的实验:
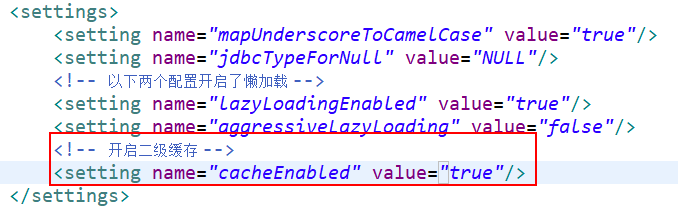
1.开启二级缓存:
①全局变量cacheEnabled设置为true
②在映射文件中添加一个标签
.........
<mapper namespace="cn.ybzy.mybatisdemo.mapper.UserMapper">
  <cache></cache>
  <select id="getUsersById" resultType=....
......
<cache/>这个简单语句的效果如下:
1.映射语句文件中的所有 select 语句将会被缓存。
2.映射语句文件中的所有 insert,update 和 delete 语句会刷新缓存。
3.缓存会使用 Least Recently Used(LRU,最近最少使用的)算法来收回。
4.根据时间表(比如 no Flush Interval,没有刷新间隔), 缓存不会以任何时间顺序 来刷新。
5.缓存会存储列表集合或对象(无论查询方法返回什么)的 1024 个引用。
6.缓存会被视为是 read/write(可读/可写)的缓存,意味着对象检索不是共享的,而 且可以安全地被调用者修改,而不干扰其他调用者或线程所做的潜在修改。
<cache/>这个标签中还有很多与缓存有关的属性:
- eviction可用的收回策略有:
LRU – 最近最少使用的:移除最长时间不被使用的对象。
FIFO – 先进先出:按对象进入缓存的顺序来移除它们。
SOFT – 软引用:移除基于垃圾回收器状态和软引用规则的对象。
WEAK – 弱引用:更积极地移除基于垃圾收集器状态和弱引用规则的对象。默认的是 LRU。 - flushInterval(刷新间隔)
可以被设置为任意的正整数,而且它们代表一个合理的毫秒 形式的时间段。默认情况是不设置,也
就是没有刷新间隔,缓存仅仅调用语句时刷新。 - size(引用数目)
可以被设置为任意正整数,要记住你缓存的对象数目和你运行环境的 可用内存资源数目。默认值
是 1024。 - readOnly(只读)属性可以被设置为 true 或 false。
只读的缓存会给所有调用者返回缓 存对象的相同实例。因此这些对象不能被修改。这提供了很重
要的性能优势。可读写的缓存 会返回缓存对象的拷贝(通过序列化) 。这会慢一些,但是安全,因此
默认是 false。
③Mybatis的二级缓存使用的序列化接口,所以,我们要使用二级缓存,我们的JavaBean就必须实现序列化接口,如果是关联查询,关联对象javabean也要系列化,并Mapper接口也要加<cache/>标签。
public class User implements Serializable {

	private static final long serialVersionUID = 1L;
	private int id;
	private String username;
	private String pasword;
	private Date regDate;
	private int state;
	private Role role;   //关联查询中用到
	//......
}
测试:以上面的关联查询测试UserRoleTest.java
@Test
	public void test() throws IOException, SQLException {
		//1.获取到创建数据库连接的会话的工厂,根据mybatis配置文件创 建
		InputStream inputStream=Resources.getResourceAsStream("mybatisConfig.xml");
		SqlSessionFactory sessionFactory=new SqlSessionFactoryBuilder().build(inputStream);
	   //2.通过工厂类,获取到数据库连接的会话
		SqlSession session=sessionFactory.openSession();

		//3.通过session操作数据库
		try {
			//User user=session.selectOne("cn.ybzy.mybatisdemo.model.selectOneUser",1);
			RoleMapper roleMapper=session.getMapper(RoleMapper.class);

		 //测试二级缓存,虽然一级缓存不一样了,但由于开启了二级缓存(全局的),所以还是发送了一条sql语句
			  UserMapper userMapper=session.getMapper(UserMapper.class);
			  User user1=userMapper.getOneUserById(2);
			  System.out.println(user1);
			  session.close();//第一个会话关闭之前,清空一级缓存,,清空之前会转到二级缓存里,这里不关闭第一个会话的话,会发送二条sql语句,相当于两个一级缓存中找对象,肯定是不一样的了。

			  SqlSession session2=sessionFactory.openSession();
			  UserMapper userMapper2=session2.getMapper(UserMapper.class);
			  User user2=userMapper2.getOneUserById(2);
			  System.out.println(user2);
			  session2.close();

		}finally {
			session.close();
		}
	}
}

//执行结果中,只看到了一条sql语句


/*2025-11-19 09:31:40,686 DEBUG ==>  Preparing: select u.id,u.username,u.password,u.reg_date,u.state,u.role_id rid,r.rolename from sb_users u,sb_roles r where u.role_id=r.id and u.id=?
2025-11-19 09:31:40,781 DEBUG ==> Parameters: 2(Integer)
2025-11-19 09:31:40,859 DEBUG <==      Total: 1
User [id=2, username=熊少文, pasword=172eee54aa664e9dd0536b063796e54e, regDate=Fri Feb 14 00:00:00 CST 2014, state=1, role=Role [id=1, rolename=超级管理员, users=null]]
2025-11-19 09:31:40,865 DEBUG Resetting autocommit to true on JDBC Connection [oracle.jdbc.driver.T4CConnection@77f99a05]
2025-11-19 09:31:40,865 DEBUG Closing JDBC Connection [oracle.jdbc.driver.T4CConnection@77f99a05]
2025-11-19 09:31:40,865 DEBUG Returned connection 2012846597 to pool.
2025-11-19 09:31:40,866 DEBUG Cache Hit Ratio [cn.ybzy.mybatisdemo.mapper.UserMapper]: 0.5
User [id=2, username=熊少文, pasword=172eee54aa664e9dd0536b063796e54e, regDate=Fri Feb 14 00:00:00 CST 2014, state=1, role=Role [id=1, rolename=超级管理员, users=null]]*/
使用缓存的配置总结
- 全局变量配置cacheEnabled:
ture(默认):开启二级缓存,
false:关闭二级缓存,但一级缓存不受影响 - 映射文件中mapper标签下:
配置有:开启二级缓存
没配置有:关闭二级缓存,一级缓存不受影响 - 每个select标签都可以设置useCache属性:
true(默认):上面1和2开启二级缓存后,二级缓存生效
false:哪怕上面1和2开启了二级缓存,二级缓存在这个select也会失效,
一级缓存不受影响 - 增改删查标签都可以设置flushCache属性:
增改删true(默认):执行增改删操作后,刷新缓存,把原来的缓存干掉,
注意这个设置有点特殊,干掉的缓存包括一、二级缓存
查false(默认):如果在查询标签上把它设置为true,等于禁用所有缓存 - 全部变量localCacheScope(了解):
SESSION(默认)开启一级缓存
STATEMENT:如果设置为这里,相当于关闭一级缓存
使用第三方缓存框架ehchache
Mybatis提供了很多与其他框架的整合解决方案:https://github.com/mybatis
ehcache缓存框架整合的文档地址:http://www.mybatis.org/ehcache-cache/
1.Maven工程配置pom.xml导入jar包
<dependency>
    <groupId>org.mybatis.caches</groupId>
    <artifactId>mybatis-ehcache</artifactId>
    <version>1.1.0</version>
</dependency>
因为ehcache的依赖slf4j这个日志的jar包,会和log4j的jar冲突,导致日志不能显示了,解决办法就整合他们,导入联合jar包,所以还要一个依赖:
<dependency>
  <groupId>org.slf4j</groupId>
  <artifactId>slf4j-log4j12</artifactId>
  <version>1.7.25</version>
  <scope>test</scope>
</dependency>
2.在映射文件中的mapper标签下配置开启ehcace缓存
<cache type="org.mybatis.caches.ehcache.EhcacheCache"/>
3.写一个ehcache缓存的配置文件ehcache.xml
<?xml version="1.0" encoding="UTF-8" ?>
<ehcache>
    <diskStore path="d:/ehcache/"/>
    <defaultCache
            maxElementsInMemory="10000"
            eternal="false"
            timeToIdleSeconds="120"
            timeToLiveSeconds="120"
            overflowToDisk="true"
            maxElementsOnDisk="10000000"
            diskPersistent="false"
            diskExpiryThreadIntervalSeconds="120"
            memoryStoreEvictionPolicy="LRU"
            />
</ehcache>
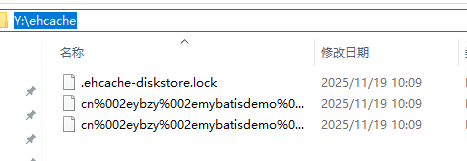
测试:仍运行上面二级缓测试的查询代码。为了快速看到效果我把maxElementsInMemory=“10000” 改为maxElementsInMemory=“1”
经过测试,我们的系统在y盘上自动建了个文件夹ehcache,并把溢出来的存放到了磁盘上
动态SQL标签
动态SQL标签1
动态 SQL
MyBatis 的强大特性之一便是它的动态 SQL。如果你有使用 JDBC 或其它类似框架的经验,你就能体会到根据不同条件拼接 SQL 语句的痛苦。例如拼接时要确保不能忘记添加必要的空格,还要注意去掉列表最后一个列名的逗号。利用动态 SQL 这一特性可以彻底摆脱这种痛苦。
动态 SQL 元素和 JSTL 或基于类似 XML 的文本处理器相似。在 MyBatis 之前的版本中,有很多元素需要花时间了解。MyBatis 3 大大精简了元素种类,现在只需学习原来一半的元素便可。MyBatis 采用功能强大的基于 OGNL 的表达式来淘汰其它大部分元素。
1.if的用法举例
1.1–我们来实现username的模糊查询:
模糊查询的时候,我想要当输入空字符串时或null时,查询所有用户信息,而不是[],那么就需要动态sql标签的if语句了.
UserMapper.java
public List<User> getUsersByLike(@Param("username") String username);
  //@Param("xxx"),让我们在映射文件xxx.xml中,查询,增,删,改中引用它,而不必担用其它名,好阅读。
UserMapper.xml
<!-- 动态sql应用 -->
  <!-- 模糊查询 -->
  <select id="getUsersByLike" resultType="cn.ybzy.mybatisdemo.model.User">
    select * from sb_users where username like #{username}
  </select>
UserRoleTest.java
   //动态sql应用测试
	 //1.模糊查询username
	List<User> users = userMapper.getUsersByLike("");
	System.out.println(users);  //[]
修改,添加动态sql标签
xml中不支持特殊符号(空,><…).可以网上查,如w3c手册中有介绍
<!-- 动态sql应用 -->
<select id="getUsersByLike" resultType="cn.ybzy.mybatisdemo.model.User">
<!-- select * from sb_users where username like #{username} -->
select * from sb_users where 1=1
<if test="username !=null and username != """>
and username like #{username}
</if>
<!-- 上面四行代码拼结为:1=1 and username like #{ussername},不过username作了判 断不能为null和空,否则查询所有记录 -->
</select>
1.2—where和trim标签的用法举例
我们还来实现模糊查询,不过这次是两个模糊查询的条件,username和password:
UserMapper.java
public List<User> getUsersByLike(@Param("username") String username,@Param("password") String password);
UserMapper.xml
<!-- 模糊查询 -->
<select id="getUsersByLike" resultType="cn.ybzy.mybatisdemo.model.User">
select * from sb_users where 1=1
<if test="username !=null and username != """>
and username like #{username}
</if>
<if test="password !=null and password != """>
and password like #{password}
</if>
</select>
上面的做法是我平时最爱干的一种解决办法,如果没有‘1=1’这字符串,又因为and,or等是双目运算符这样会出错,但是呢,Mybatis也想到这点,给我们提供了一种解决办法就是where标签,它的特殊作用就是能够去掉执行的sql的第一个条件前的多余的“and”或者“or”这种字符串:
修改为
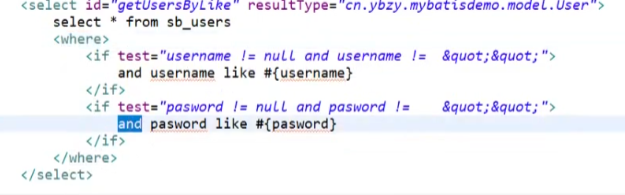
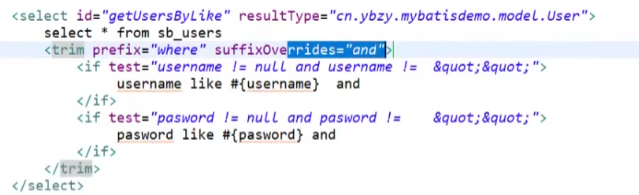
注意点:where标签只能去掉第一个条件的前面多余出来的(and 或 or)如1=1,并不能去掉后面的哈,这一点切记!那么如果我们非要写在后面写and或or呢,这时就只用能trim标签!
这个标签,有四个属性:
prefix:加前缀
prefixOverrides:如果发现字符串前有某个前缀,把它干掉
suffix:加后缀
suffixOverrides:发现某个后缀干掉
3.choose (when, otherwise)标签是使用举例
类似switch…case,从上到下匹配,找到匹配的条件,就结束匹配其他的!
UserMapper.java
//public List<User> getUsersByLike(@Param("username") String username);
 //public List<User> getUsersByLike(@Param("username") String username,@Param("password") String password);
 public List<User> getUsersByLikeChoose(@Param("username") String username,@Param("password") String password);
UserMapper.xml
<!-- 类似switch语句模糊查询,从上到下匹配,找到匹配的条件,就结束匹配其他的! -->
  <select id="getUsersByLikeChoose" resultType="cn.ybzy.mybatisdemo.model.User">
     select * from sb_users where
       <choose>
          <when test="username !=null and username != ''">
             username like #{username}
          </when>
          <when test="password !=null and password != ''">
             password like #{password}
          </when>
          <otherwise>
              1=1
          </otherwise>
       </choose>
  </select>
UserRoleTest.java
   List<User> users=userMapper.getUsersByLikeChoose("%少%", "fdsa");
   System.out.println(users);
   //[User [id=2, username=熊少文, pasword=172eee54aa664e9dd0536b063796e54e, regDate=Fri Feb 14 00:00:00 CST 2014, state=1, role=null],
  //User [id=6, username=熊少华, pasword=hua, regDate=Wed Nov 19 00:00:00 CST 2025, state=1, role=null]]
测试结果中可以看出,我们只要符合一个条件,其它条件不去管的,这里我有两条包含‘少’的记录,而fsda的密码一条都没有的,但查询获得了两条记录
4.set标签的示例
set这个标签是用在更新记录数据操作上的,看例子:
UserMapper.java
 /**
     * 动态sql应用,
     */
    //public List<User> getUsersByLike(@Param("username") String username);
    //public List<User> getUsersByLike(@Param("username") String username,@Param("password") String password);
    //public List<User> getUsersByLikeChoose(@Param("username") String username,@Param("password") String password);
    public void updateUserSet(User user);
UserMapper.xml
<!--动态SQL之 set标签修改 -->
    <update id="updateUserSet">
       update sb_users
             <set>
                 <if test="username !=null and username !=''">
                     username=#{username},
                 </if>
                 <if test="pasword !=null and pasword !=''">
                     password=#{pasword},   <!-- password是表列名,pasword是User成员变量名 -->
                 </if>
                 <if test="state !=null and state !=''">
                     state=#{state},
                 </if>
                 <if test="regDate !=null">
                     reg_date=#{regDate}
                 </if>
             </set>
         where id =#{id}
    </update>
UserRoleTest.java
{.......
      //3.set标签的使用,用于更新操作
			User user= new User();
			user.setId(5);
			user.setPassword("1232456");
			userMapper.updateUserSet(user);
			session.commit();

		}finally {
			session.close();
		}
		......
如果不用动态sql来做判断,则修改后,没有设置的字段值全为null.这显然不符合我们的要求,那就要如我前面学的hibernate中,用java代码来做判断,是十分头痛的。
5.foreach标签
在实际应用中,我常常需要根据多个id批量的操作:
查询指定数量id的记录:
collection="ids" : 接口上传过来的数值,数组或list集合或者map集合都可以
item="id" :设定遍历集合或数组里的每一个值的迭代变量
separator="," : 因为要构造出 (1,2,3)对象这种样子的字符串,每个对象设定中间的分隔符
open="(" : 因为要构造出 (1,2,3)这种样子的字符串,设定前缀的符号(
close=")": 因为要构造出 (1,2,3)这种样子的字符串,设计结尾的后缀)
index: 还有这个属性,数组或list集合的时候,设置索引变量,如果是Map集合就是map的key的迭代变量,这里的例子用不着这个。
UserMapper.java
  //通过多个id,查询所有的记录,不@Param指定参数名为ids,会报错,说找不到ids,这可能是名字太简了
    //public List<User> getUsersByIds(@Param("ids") List<Integer> ids);
    public List<User> getUsersByIds(@Param("ids") int[] ids);
UserMapper.xml
< <select id="getUsersByIds" resultType="cn.ybzy.mybatisdemo.model.User">
      <!-- select * from sb_users where id in(1,2,3) -->
      select * from sb_users where id in
         <foreach collection="ids" item="id" separator="," open="(" close=")">
            #{id}
         </foreach>
    </select>
UserRoleTest.java
{.......
      //4.foreach标签的使用,首先在接口中定义了参数 int[] ids
			int[] ids= {1,3,4};
			/*List<Integer> ids=new ArrayList<Integer>();
			ids.add(1);
			ids.add(3);
			ids.add(4);*/
			List<User> users= userMapper.getUsersByIds(ids);
			System.out.println(users);
		......
6.小批量保存记
6.1mysql数据库小批量保存记录
先让我们来理解一下,插入多记录的sql语句
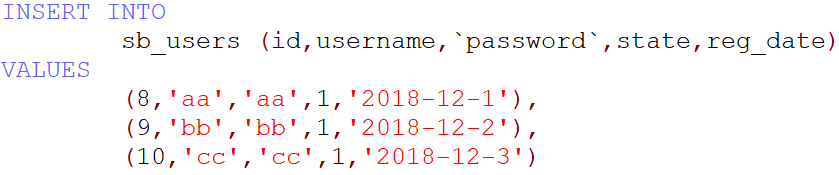
批量保存的sql语句,可以这么写!所以,我们可以利用foreache标签来对values后面的部分构造出来:
UserMapper.java
public void insertUsers(@Param("users") List<User> users); //oracle
UserMapper.xml
<!-- mysql,小批量插入 -->
    <insert id="insertUsers">
        <!-- insert into sb_users(username,password,state,reg_date) values ("xxx","123",1,"2011-11-12"),(xx),(xx) -->
        insert into sb_users (username,password,state,reg_date) values
          <foreach collection="users" item="user" separator="," >
             (#{user.username},#{user.password},#{user.state},#{user.regDate})
          </foreach>
    </insert>
UserRoleTest.java
{.......
      List<User> users = new ArrayList<>();
			User user1=new User("xiong1","xiong",new Date(),1);
			User user2=new User("xiong2","xiong",new Date(),1);
			User user3=new User("xiong3","xiong",new Date(),1);
			User user4=new User("xiong4","xiong",new Date(),1);
			users.add(user1);
			users.add(user2);
			users.add(user3);
			users.add(user4);
			userMapper.insertUsers(users);
			session.commit();
		......
6.2oracle数据库小批量保存记录,oracle没有自增长id号功能,所以我们要创建一个序列,让它从某值开始,如下是从第8开始,因为以前有7条记录了.
创建个序列
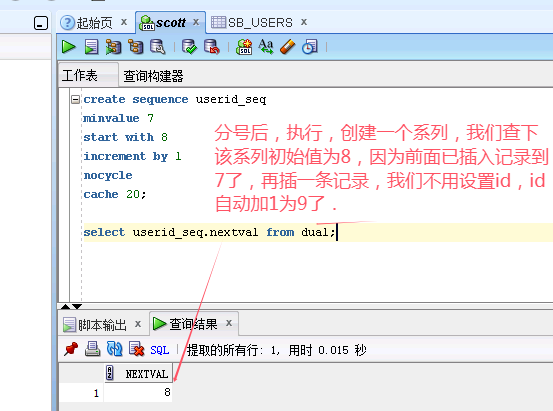
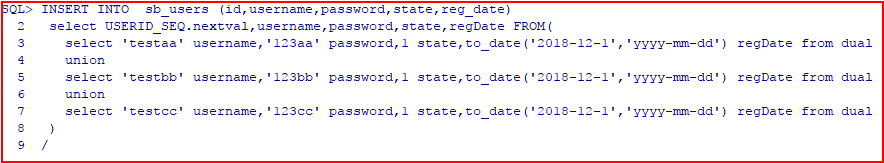
Oracle数据库和Mysql数据库不一样,它不支持insert...values(),(),()这种写法,它支持的是以下的begin...end和中间表的两种写法:
①begin…end的写法,中间的insert语句用分号分割:
UserMapper.java
public void insertUsersOracle(@Param("users") List<User> users); //oracle
UserMapper.xml
 <insert id="insertUsersOracle">
        <foreach collection="users" item="user"  open="begin" close="end;">
           insert into sb_users (id,username,password,state,reg_date) values
             (userid_seq.nextval,#{user.username},#{user.pasword},#{user.state},#{user.regDate});
          </foreach>
    </insert>
UserRoleTest.java
{.......
      List<User> users = new ArrayList<>();
			User user1=new User("xiong1","xiong",new Date(),1);
			User user2=new User("xiong2","xiong",new Date(),1);
			User user3=new User("xiong3","xiong",new Date(),1);
			User user4=new User("xiong4","xiong",new Date(),1);
			users.add(user1);
			users.add(user2);
			users.add(user3);
			users.add(user4);
			userMapper.insertUsersOracle(users);
			session.commit();
		......
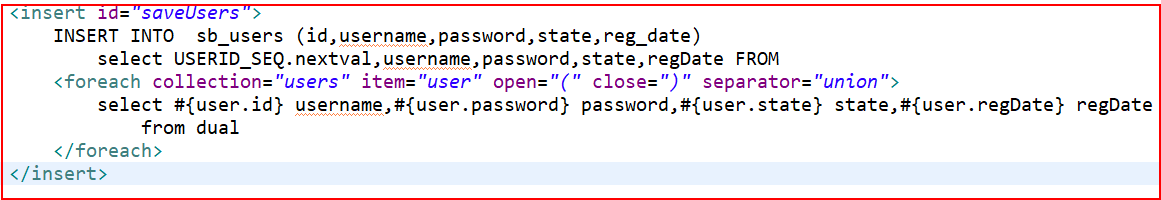
②中间表的写法:

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐

 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)