

决策树算法总结
算法思想
给定一个样本集合D,其中每个样本由若干个属性表示,决策树通过贪心策略(如 ID3 / C4.5 / CART)不断挑选最优的属性,将每个样本划分到不同的子树,再在各棵子树上通过递归对子树上的样本进行划分,直到满足一定的终止条件为止。
决策树的每个叶节点对应一个分类,非叶节点对应某个属性上的划分,根据样本在该属性上的不同取值将其划分为若干子集。
算法基本框架(伪代码)
策略对比
采用不同的贪心策略(属性选择度量标准不同)生成最终的决策树会引起BuildDecisionTree的不同;另外在实际应用中,可能还需要考虑处理缺失值、剪枝(避免过拟合)等问题。
ID3:采用信息增益
优点:
方法简单,学习能力强
缺点:
选择具有大量值的属性的倾向;没有考虑连续特征;属性相互关系强调不够,容易导致子树重复或某些属性被重复检验;容易过拟合
C4.5:采用增益率
C4.5是ID3算法的改进版本,采用增益率(Gain Ratio)作为分支指标,旨在克服信息增益偏向于选择取值数目较多的属性的问题。增益率通过引入一个分裂信息(Split Information)的项来惩罚取值数目多的属性
优点:尽量克服了ID3算法的缺点;能处理非离散数据或不完整数据
缺点:大量的运算耗费资源,且只能用于分类
CART:采用基尼指数
CART全称为Classification and Regression Tree,分类回归树,是如今主要使用的用于实现决策树的算法。
基尼指数用来衡量数据的不纯度或不确定性。
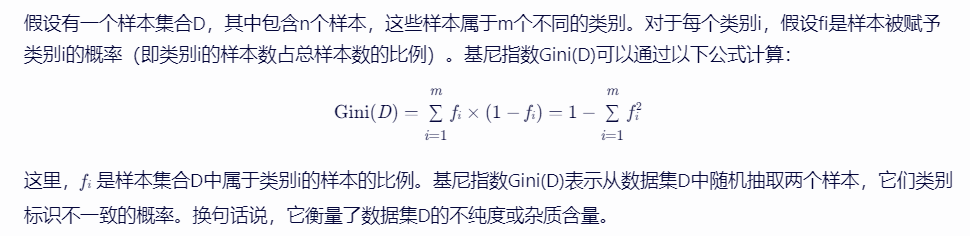
决策树中的基尼指数计算:
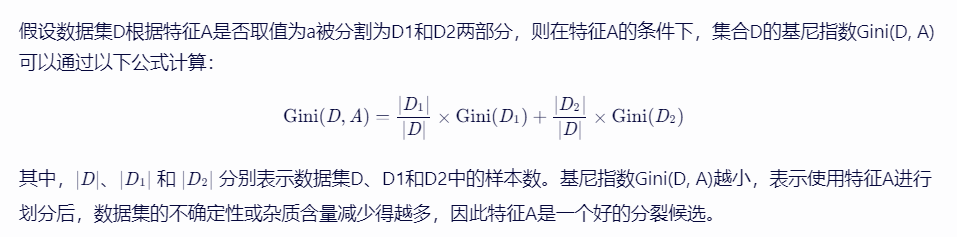
注:一般情况下,CART算法实现的决策树是一棵二叉树,而前两种算法生成的决策树一般是多叉树
实验-决策树模型实现葡萄酒分类
相关库的导入与说明
sklearn.tree.DecisionTreeClassifier
DecisionTreeClassifier是 scikit-learn 库中用于分类任务的决策树模型,实现了决策树的构建、分类预测、决策树评价。该模型通过递归地将特征空间划分为若干个简单的区域来做出预测,每个区域都输出一个简单的预测值(通常是该区域内训练样本中最常见的类别)。
sklearn.tree的export_graphviz()方法
常用调用形式:
该函数将决策树模型以 DOT 格式导出,通过生成的 DOT 文件,用户可以使用 Graphviz 的工具(如 dot 命令行工具,需要自行另外安装在系统中)将决策树转换为PNG图片或PDF文件,这样可直观地看到决策树的结构,可视化决策树的决策过程。
加载葡萄酒数据
通过PyCharm的调试功能可以看看sklearn内置的葡萄酒数据的相关信息。共有178个样本,每个样本13个特征,样本标签共3类。
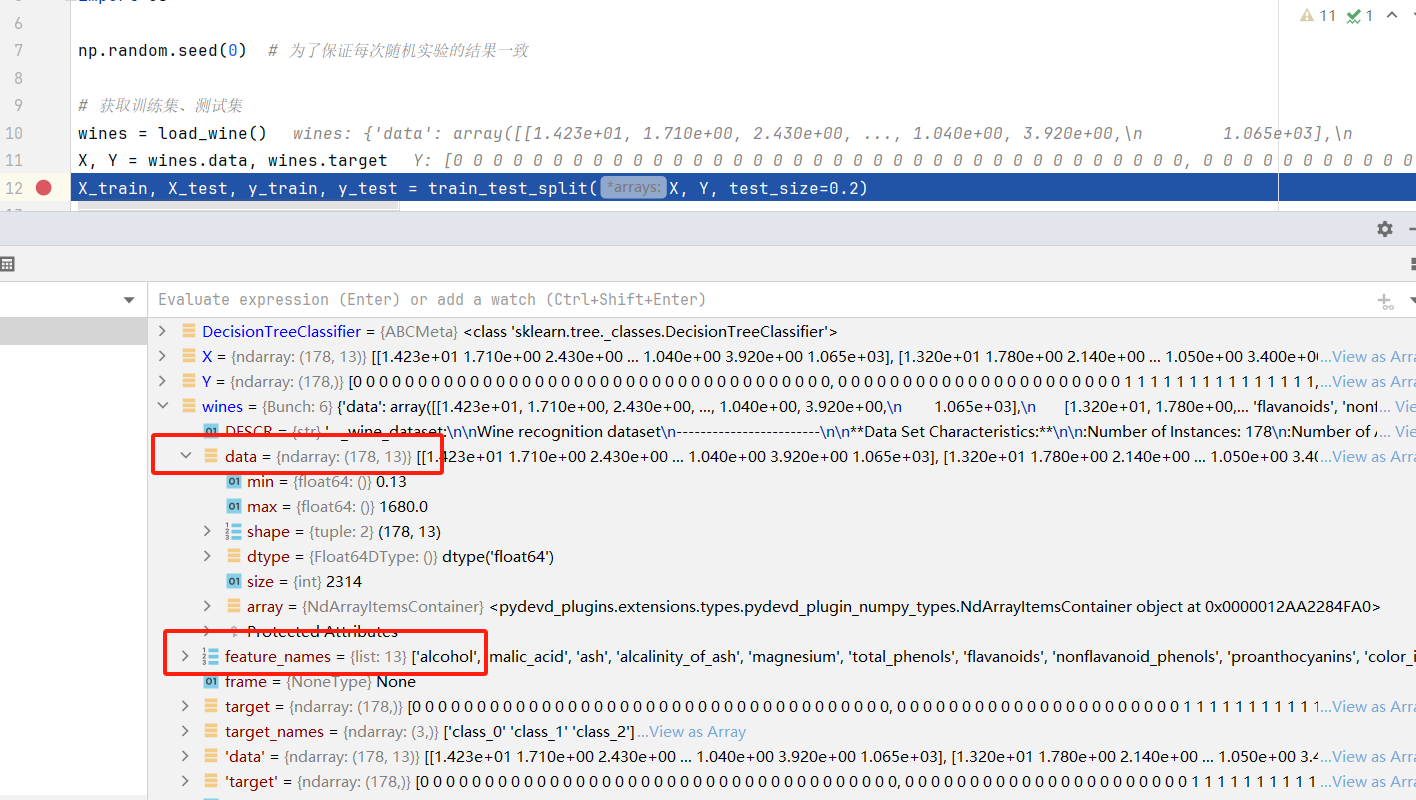
决策树三种构建策略的对比实验
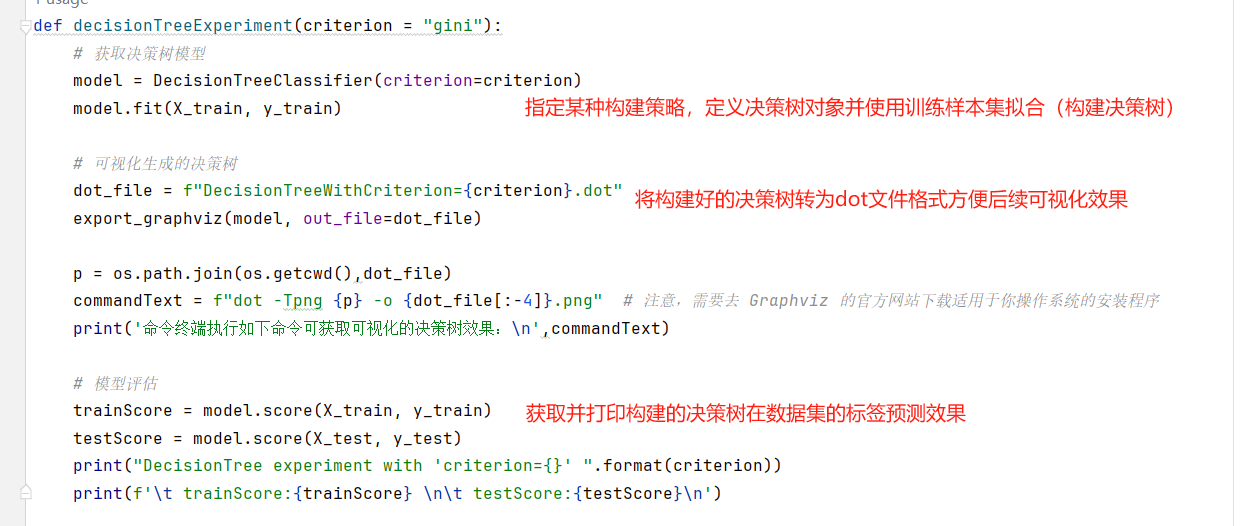
对比实验,三种决策树算法的应用:
运行结果:
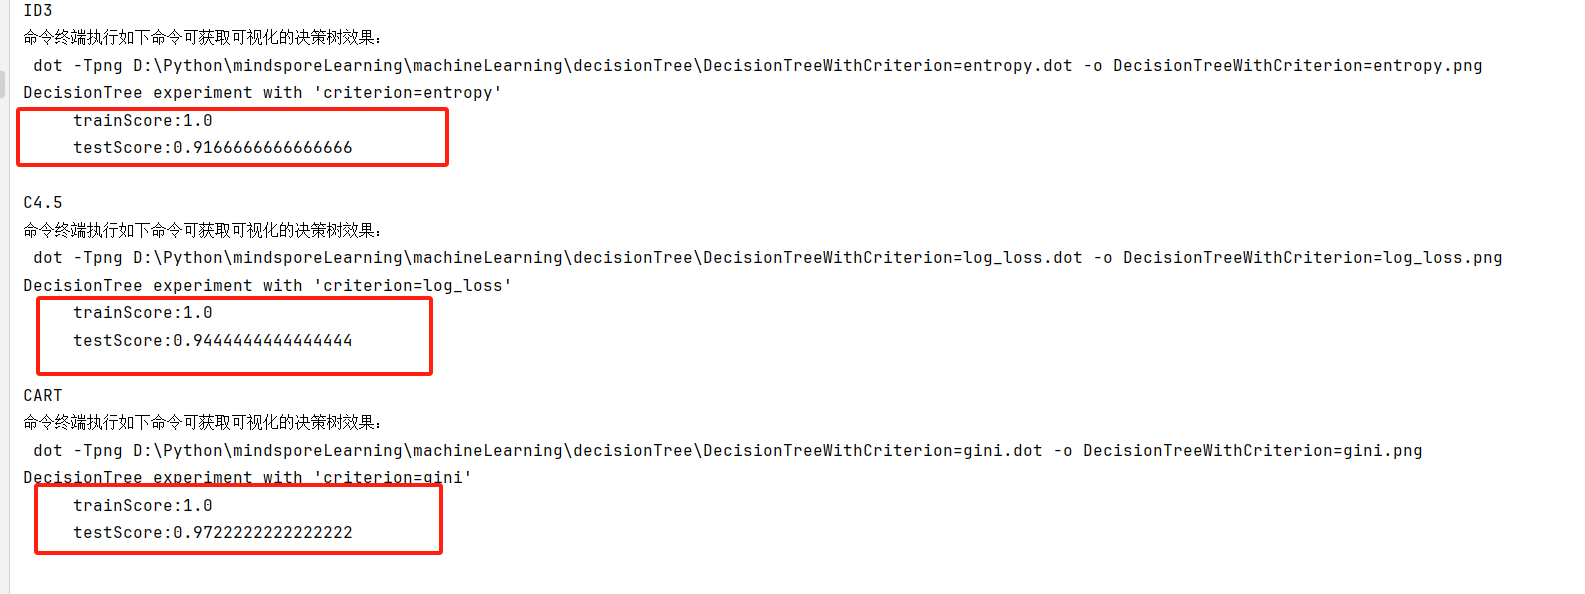
初步来看,ID3、C4.5、CART三种策略的效果依次增强。
决策树可视化
在安装了的系统的命令终端上执行dot命令将代码生成的三个dot文件转为png图片(将-Tpng替换为-Tpdf即将dot文件转为pdf文件):
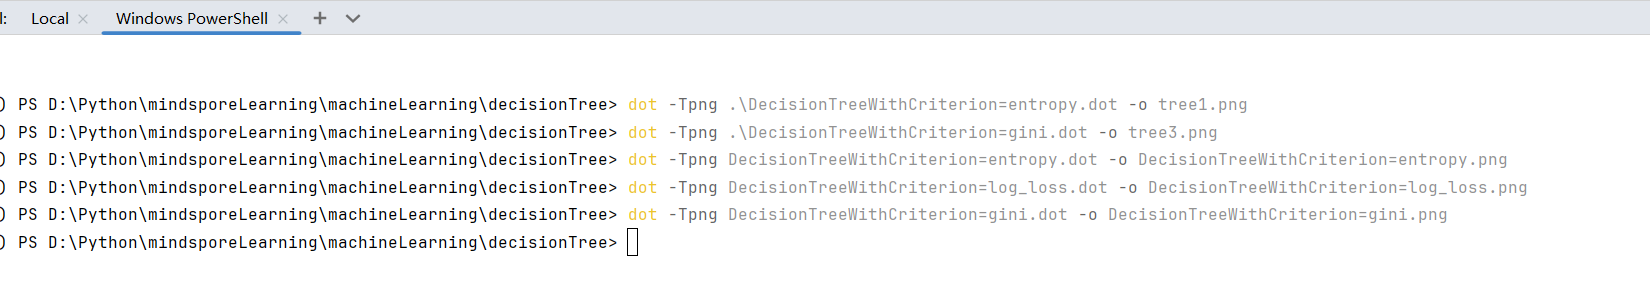
生成的三棵决策树中,除了使用gini标准生成的决策树外,其它两棵决策树的总节点数为样本的特征树目(13个)。
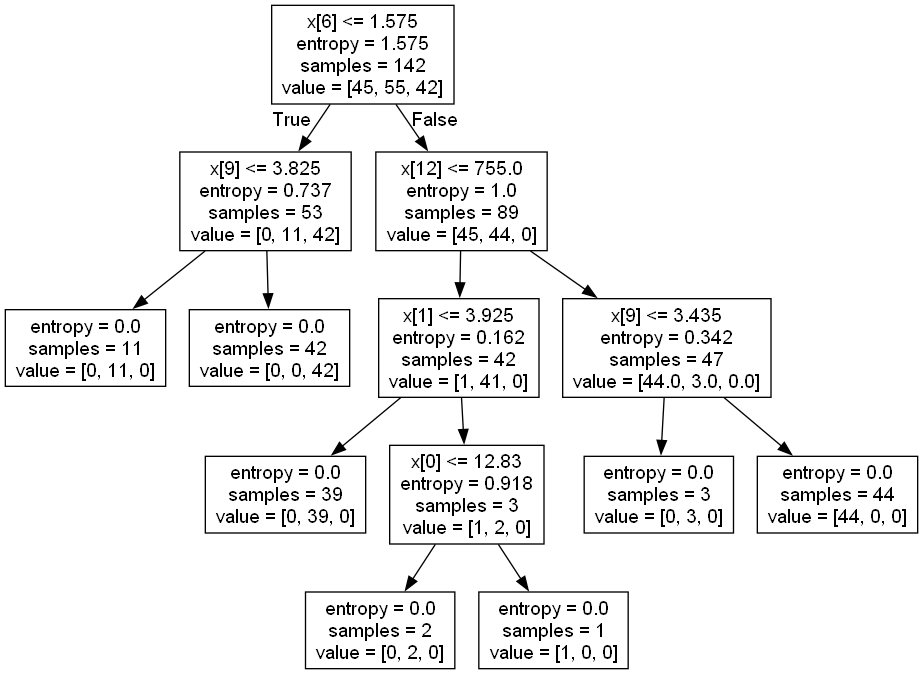
图中每个非叶子节点(下同)包含四个数据:决策条件(样本的某个特征的特征值,或者某个属性的属性值与特定数值的比较)、度量标准及其值、样本数、每个类别的个数。叶子节点没有“决策条件”这个数据是因为叶子节点不用再根据条件再进行分裂了。
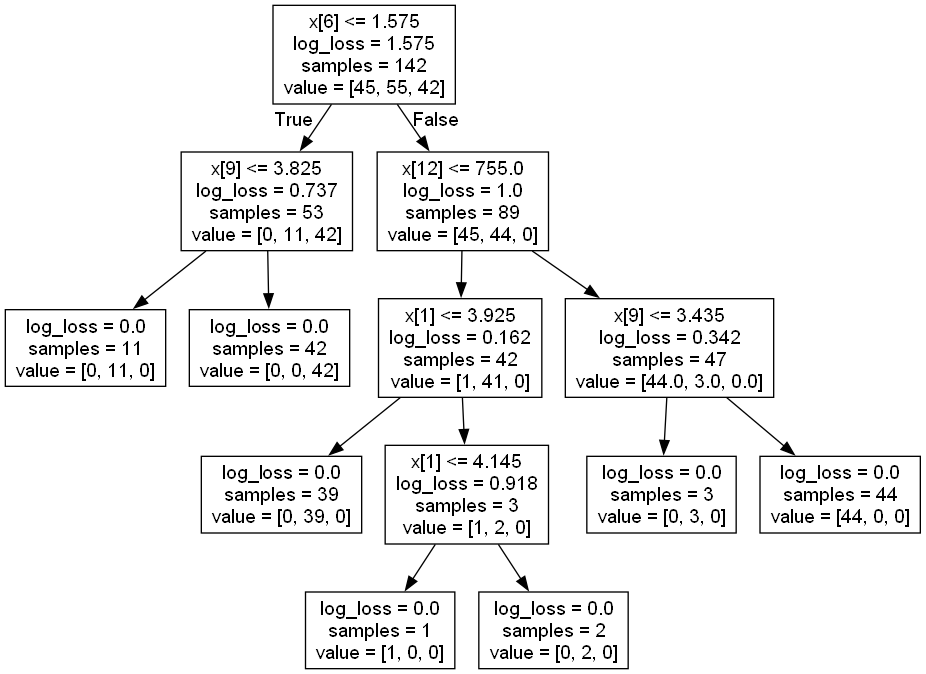
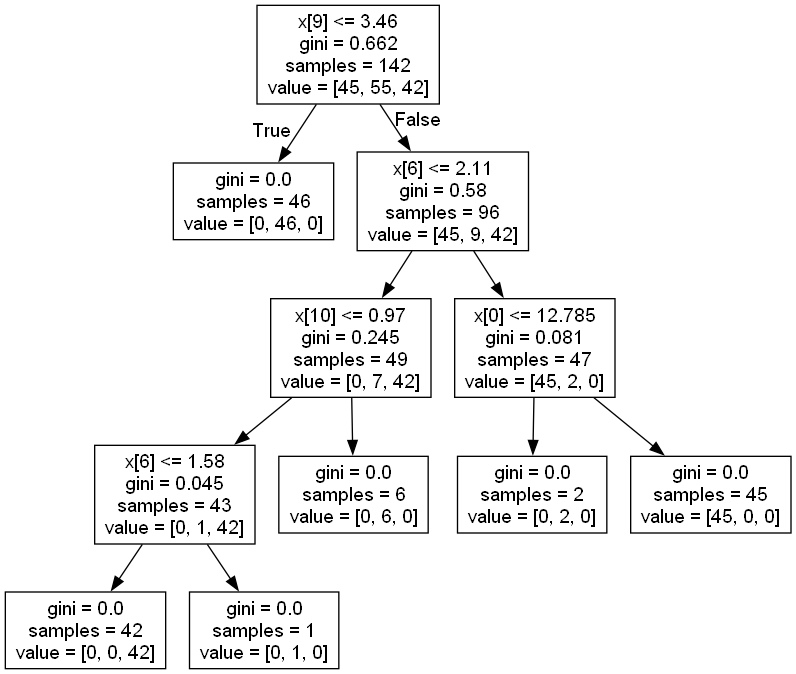
- 注:叶节点所包含的样本都属于同一类别,如value = [0, 0, 42]表示该叶节点只有42个标签为第三类的样本。这决定了决策树预测新样本的过程。
决策树预测新样本
构建好后的决策树对新样本进行预测的过程相对直观且系统化,一般过程:
- 从根节点开始:
- 将新样本的特征值输入到决策树的根节点。
- 特征值测试(决策条件判断):
- 在当前节点上,根据该节点的特征属性对新样本进行相应的测试。
- 测试结果将决定下一步应该走向哪个子节点。
- 递归遍历:
- 根据测试结果,移动到相应的子节点上。
- 在新的子节点上重复进行特征值测试,直到达到一个叶节点。
- 输出预测结果:
- 当达到叶节点时,该叶节点所代表的类别或数值即为对新样本的预测结果。
注:关注微信公众号——分享之心,后台回复“机器学习基础实验”获取完整代码和相关文档资料的地址(不断更新)。


 已为社区贡献1条内容

所有评论(0)