非极大值抑制(NMS)在目标检测中的改进与应用
NMS
引言
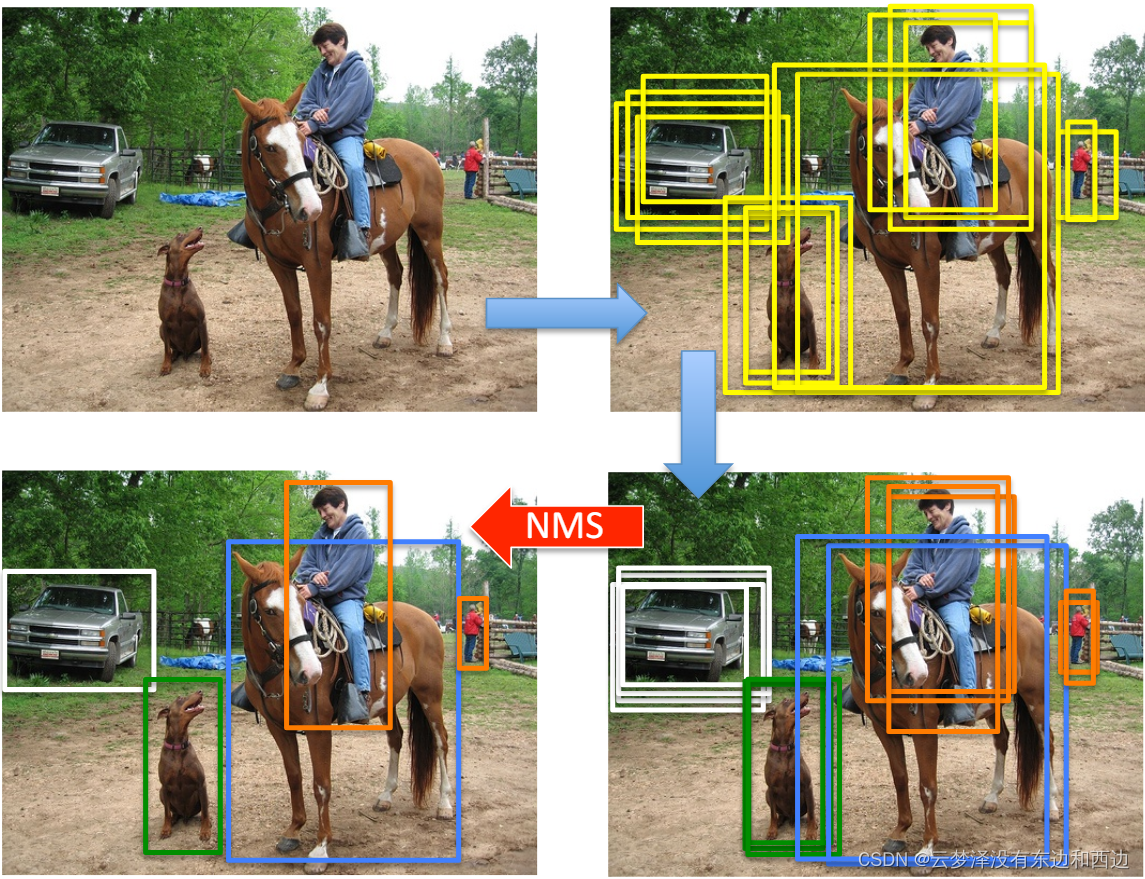
目标检测是计算机视觉领域的核心问题之一,它旨在识别图像中的目标并确定它们的位置。在目标检测的流程中,非极大值抑制(Non-Maximum Suppression,NMS)扮演着至关重要的角色。NMS用于筛选出最佳的候选框,去除多余的检测框,从而提高检测的精度。本文将详细介绍NMS的基本原理、改进方法以及在实际应用中的代码实现。
一、NMS的基本原理
1.1 核心思想
NMS算法的核心思想是:在目标检测中,经常会出现多个候选框重叠在一起的情况。这些重叠的候选框中,只有一个最佳的框能够最准确地表示目标的位置。NMS通过计算候选框之间的交并比(Intersection over Union,IoU),去除那些与最佳候选框重叠度较高的其他框。
1.2 算法步骤
- 置信度排序:根据候选框的置信度(通常是分类概率)进行排序。
- 选择最佳候选框:选择置信度最高的候选框作为当前最佳检测框。
- 计算IoU:计算当前最佳检测框与其他所有候选框的IoU。
- 抑制重叠框:删除与当前最佳检测框IoU大于预设阈值的其他候选框。
- 迭代处理:从剩余的候选框中选择置信度最高的框,重复步骤3和4,直到所有候选框都被处理。
1.3 示例说明
下面将通过一个例子说明NMS的使用方法,假设定位小猫,算法给出出了一系列的矩形框,NMS将给出最终的检测框。
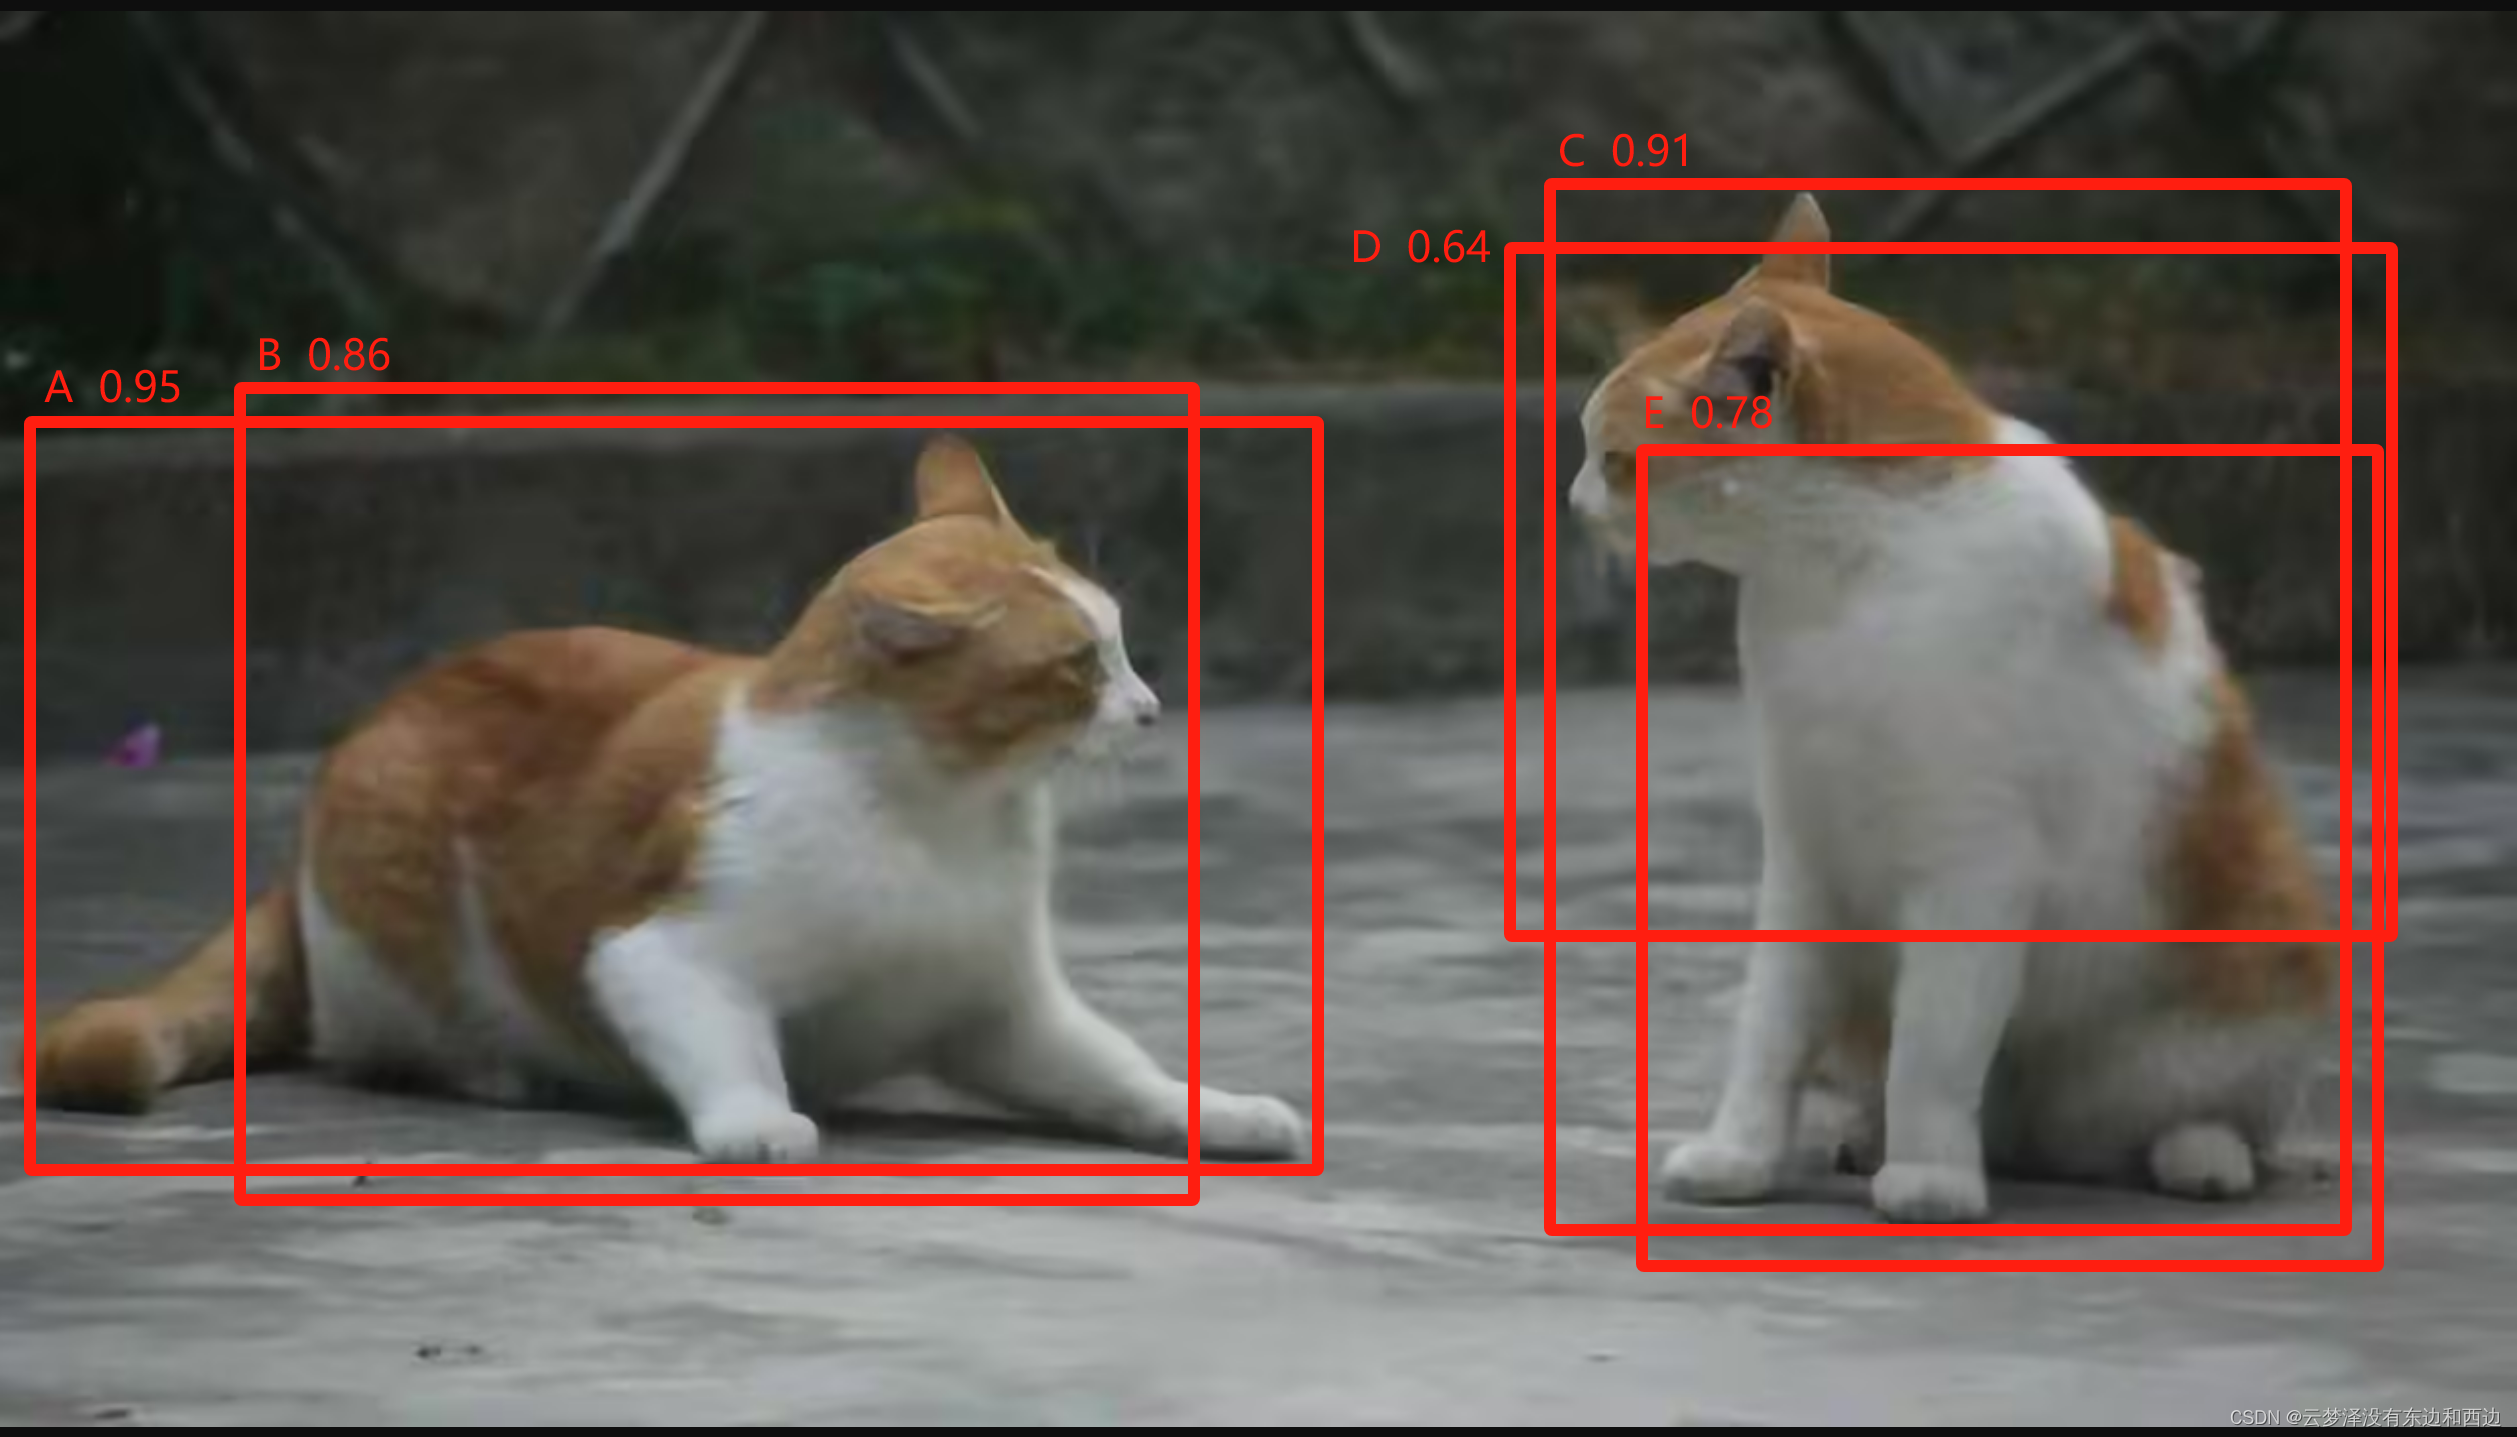
根据上图示例,假设集合S0中有A、B、C、D、E 5个检测框,检测框附近的数字代表对应的置信度分数,假设NMS的iou阈值是0.5,那么迭代过程如下:
第一轮:因为A的置信度分数最高,在集合S0中的其余候选框分别与A计算IoU,如果IoU>0.5则被删除。如图所示,B检测框将被删除,因为IoU计算说明了B与A是同一个目标,保留A这个置信度较高的框,CDE则是另一个目标。A框也将从集合S中删除,放入最终的检测结果中。此时,新的S1集合只剩C、D、E三个框。
第二轮:在新的S1集合中,C的置信度分数最高,集合S1中的剩余框分别与C计算IoU,因为D、E与C的IoU>0.5,所以D、E将从S1中移除,C也将作为结果从集合S1中移除,放入最终结果中。此时S1集合为空,循环结束。
最终结果为在这个5个中检测出了两个目标为A和C。
1.4 代码实现
1.3.2 NMS源码及注释
- 安装依赖库
import numpy as np
import matplotlib.pyplot as plt
#安装
#pip install numpy==1.19.5 -i https://pypi.tuna.tsinghua.edu.cn/simple/
#pip install matplotlib==3.2.2 -i https://pypi.tuna.tsinghua.edu.cn/simple/
- nms算法
#nms 算法
def py_cpu_nms(dets, thresh):
    #边界框的坐标
    x1 = dets[:, 0]#所有行第一列
    y1 = dets[:, 1]#所有行第二列
    x2 = dets[:, 2]#所有行第三列
    y2 = dets[:, 3]#所有行第四列
    #计算边界框的面积
    areas = (y2 - y1 + 1) * (x2 - x1 + 1) #(第四列 - 第二列 + 1) * (第三列 - 第一列 + 1)
    #执行度,包围盒的信心分数
    scores = dets[:, 4]#所有行第五列

    keep = []#保留

    #按边界框的置信度得分排序   尾部加上[::-1] 倒序的意思 如果没有[::-1] argsort返回的是从小到大的
    index = scores.argsort()[::-1]#对所有行的第五列进行从大到小排序,返回索引值

    #迭代边界框
    while index.size > 0: # 6 > 0,      3 > 0,      2 > 0
        i = index[0]  # every time the first is the biggst, and add it directly每次第一个是最大的,直接加进去
        keep.append(i)#保存
        #计算并集上交点的纵坐标(IOU)
        x11 = np.maximum(x1[i], x1[index[1:]])  # calculate the points of overlap计算重叠点
        y11 = np.maximum(y1[i], y1[index[1:]])  # index[1:] 从下标为1的数开始,直到结束
        x22 = np.minimum(x2[i], x2[index[1:]])
        y22 = np.minimum(y2[i], y2[index[1:]])

        #计算并集上的相交面积
        w = np.maximum(0, x22 - x11 + 1)  # the weights of overlap重叠权值、宽度
        h = np.maximum(0, y22 - y11 + 1)  # the height of overlap重叠高度
        overlaps = w * h# 重叠部分、交集

        #IoU:intersection-over-union的本质是搜索局部极大值,抑制非极大值元素。即两个边界框的交集部分除以它们的并集。
        #          重叠部分 / (面积[i] + 面积[索引[1:]] - 重叠部分)
        ious = overlaps / (areas[i] + areas[index[1:]] - overlaps)#重叠部分就是交集,iou = 交集 / 并集
        print("ious", ious)
        #               ious <= 0.7
        idx = np.where(ious <= thresh)[0]#判断阈值
        print("idx", idx)
        index = index[idx + 1]  # because index start from 1 因为下标从1开始
    return keep #返回保存的值
- 绘图
#画图函数
def plot_bbox(dets, c='k'):#c = 颜色 默认黑色
    # 边界框的坐标
    x1 = dets[:, 0]  # 所有行第一列
    y1 = dets[:, 1]  # 所有行第二列
    x2 = dets[:, 2]  # 所有行第三列
    y2 = dets[:, 3]  # 所有行第四列

    plt.plot([x1, x2], [y1, y1], c)#绘图
    plt.plot([x1, x1], [y1, y2], c)#绘图
    plt.plot([x1, x2], [y2, y2], c)#绘图
    plt.plot([x2, x2], [y1, y2], c)#绘图
    plt.title("nms")#标题
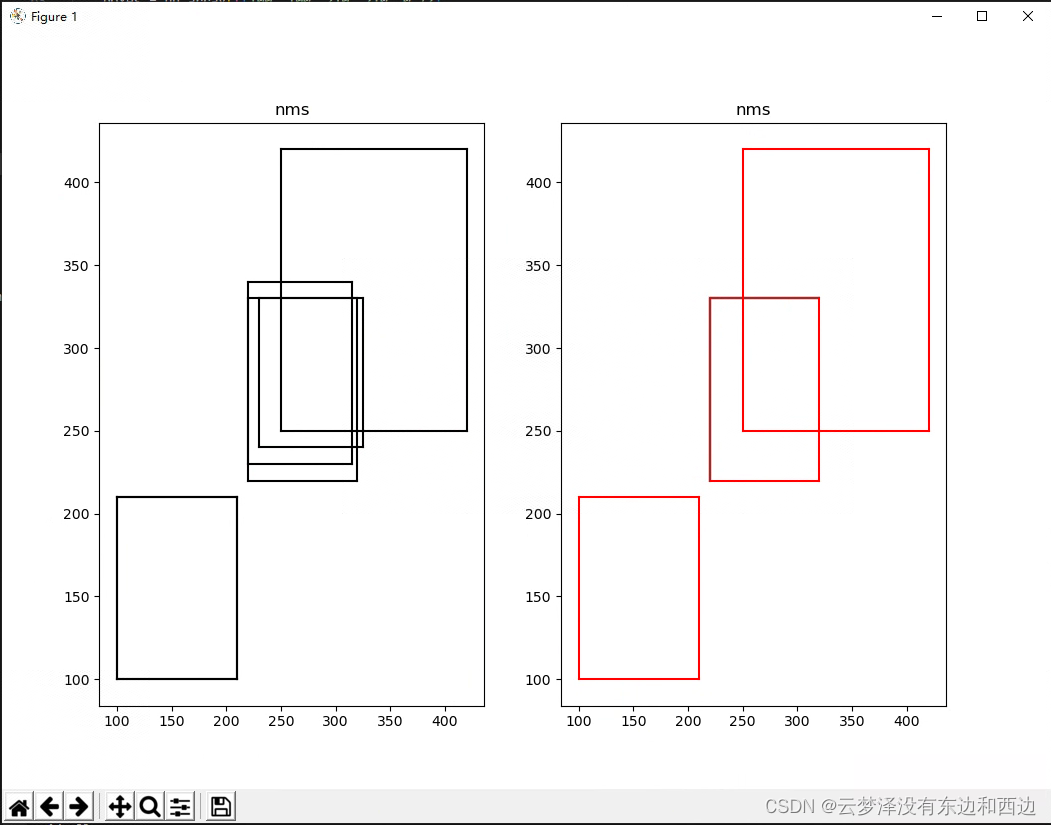
- 完整代码及输出图
#导入数组包
import numpy as np
import matplotlib.pyplot as plt#画图包

#画图函数
def plot_bbox(dets, c='k'):#c = 颜色 默认黑色
    # 边界框的坐标
    x1 = dets[:, 0]  # 所有行第一列
    y1 = dets[:, 1]  # 所有行第二列
    x2 = dets[:, 2]  # 所有行第三列
    y2 = dets[:, 3]  # 所有行第四列

    plt.plot([x1, x2], [y1, y1], c)#绘图
    plt.plot([x1, x1], [y1, y2], c)#绘图
    plt.plot([x1, x2], [y2, y2], c)#绘图
    plt.plot([x2, x2], [y1, y2], c)#绘图
    plt.title("nms")#标题

#nms 算法
def py_cpu_nms(dets, thresh):
    #边界框的坐标
    x1 = dets[:, 0]#所有行第一列
    y1 = dets[:, 1]#所有行第二列
    x2 = dets[:, 2]#所有行第三列
    y2 = dets[:, 3]#所有行第四列
    #计算边界框的面积
    areas = (y2 - y1 + 1) * (x2 - x1 + 1) #(第四列 - 第二列 + 1) * (第三列 - 第一列 + 1)
    #执行度,包围盒的信心分数
    scores = dets[:, 4]#所有行第五列

    keep = []#保留

    #按边界框的置信度得分排序   尾部加上[::-1] 倒序的意思 如果没有[::-1] argsort返回的是从小到大的
    index = scores.argsort()[::-1]#对所有行的第五列进行从大到小排序,返回索引值

    #迭代边界框
    while index.size > 0: # 6 > 0,      3 > 0,      2 > 0
        i = index[0]  # every time the first is the biggst, and add it directly每次第一个是最大的,直接加进去
        keep.append(i)#保存
        #计算并集上交点的纵坐标(IOU)
        x11 = np.maximum(x1[i], x1[index[1:]])  # calculate the points of overlap计算重叠点
        y11 = np.maximum(y1[i], y1[index[1:]])  # index[1:] 从下标为1的数开始,直到结束
        x22 = np.minimum(x2[i], x2[index[1:]])
        y22 = np.minimum(y2[i], y2[index[1:]])

        #计算并集上的相交面积
        w = np.maximum(0, x22 - x11 + 1)  # the weights of overlap重叠权值、宽度
        h = np.maximum(0, y22 - y11 + 1)  # the height of overlap重叠高度
        overlaps = w * h# 重叠部分、交集

        #IoU:intersection-over-union的本质是搜索局部极大值,抑制非极大值元素。即两个边界框的交集部分除以它们的并集。
        #          重叠部分 / (面积[i] + 面积[索引[1:]] - 重叠部分)
        ious = overlaps / (areas[i] + areas[index[1:]] - overlaps)#重叠部分就是交集,iou = 交集 / 并集
        print("ious", ious)
        #               ious <= 0.7
        idx = np.where(ious <= thresh)[0]#判断阈值
        print("idx", idx)
        index = index[idx + 1]  # because index start from 1 因为下标从1开始
    return keep #返回保存的值

def main():
    # 创建数组
    boxes = np.array([[100, 100, 210, 210, 0.72],
                      [250, 250, 420, 420, 0.8],
                      [220, 220, 320, 330, 0.92],
                      [100, 100, 210, 210, 0.72],
                      [230, 240, 325, 330, 0.81],
                      [220, 230, 315, 340, 0.9]])
    show(boxes)

def show(boxes):
    plt.figure(1)  # 画图窗口、图形
    plt.subplot(1, 2, 1)  # 子图
    plot_bbox(boxes, 'k')  # before nms 使用nms(非极大抑制)算法前
    plt.subplot(1, 2, 2)  # 子图
    keep = py_cpu_nms(boxes, thresh=0.7)  # nms(非极大抑制)算法
    print(keep)
    plot_bbox(boxes[keep], 'r')  # after nms 使用nms(非极大抑制)算法后
    plt.show()  # 显示图像

if __name__ == '__main__':
    main()
1.3.3 PaddlePaddle-Detection-YOLOv3的NMS算法c++实现
- 先定义计算IOU的函数
- 先获取交集区域的左上顶点和右下顶点坐标;
- 在获取这个区域的Width和Height,并求面积;
- 计算并集面积;
- 获得交并比。
注意:PaddleDetection::ObjectResult的输出tensor为[num_id, score, xmin, ymin, xmax, ymax]
//定义计算iou的函数
float get_iou_value(PaddleDetection::ObjectResult box2_info, PaddleDetection::ObjectResult box1_info) {
	float iou_value;
	//计算iou_value,先寻找两个框左上角的最大值,再寻找两个框右下角的最小值
	float x1 = max(box2_info.rect[0], box1_info.rect[0]);
	float y1 = max(box2_info.rect[1], box1_info.rect[1]);
	float x2 = min(box2_info.rect[2], box1_info.rect[2]);
	float y2 = min(box2_info.rect[3], box1_info.rect[3]);

	float w = max(x2 - x1, 0);
	float h = max(y2 - y1, 0);
	float insection_area = w * h;

	float box1_area = (box1_info.rect[2] - box1_info.rect[0])*(box1_info.rect[3] - box1_info.rect[1]);
	float box2_area = (box2_info.rect[2] - box2_info.rect[0])*(box2_info.rect[3] - box2_info.rect[1]);
	float union_area = box1_area + box2_area - insection_area;
	iou_value = insection_area / union_area;

	return iou_value;
}
- NMS算法实现:
//1.根据置信度,利用冒泡排序算法对检测结果进行排序
int boxes_num = im_result.size();
PaddleDetection::ObjectResult item_;
for (int i = 0; i < boxes_num -1; i++) {
	for (int j = 0; j < boxes_num - 1 - i; j++) {
		if (im_result[j].confidence < im_result[j + 1].confidence) {
			item_ = im_result[j];
			im_result[j] = im_result[j+1];
			im_result[j + 1] = item_;
		}
	}
}


//2.依次计算相邻两个box的iou,若iou大于设定阈值,则过滤低置信度的box
float conf_threshold = 0.7;

for (int i = 0; i < boxes_num - 1; ++i) {
	for (int j = i+1; j < boxes_num; ++j) {
		//计算iou
		float iou_value = get_iou_value(im_result[i], im_result[j]);
		if (iou_value > conf_threshold) {
			im_result.erase(im_result.begin() + j);
			--j;
			--boxes_num;
		}
	}
}
二、NMS算法的改进
在目标检测任务中,传统的NMS方法首先需要按照检测框预测的类别进行分类,然后对每个类别内的检测框独立应用NMS算法。然而,当预测的类别数量较多时,这种方法的效率会变得非常低。为了解决这个问题,研究者们提出了一种改进的NMS方法,其核心思想是在应用NMS之前,先对不同类别的预测框进行空间上的区分。
具体来说,这种方法首先确定所有预测框中坐标值最大的数值,我们称之为max_value。然后,根据每个预测框所属的类别索引indxs,计算出该类别的偏移量offsets,计算公式为offsets = indxs * max_value。这样,每个类别的预测框都会根据其类别索引获得一个相应的偏移量。
以类别索引为1的蓝色方框和类别索引为2的黄色方框为例,如果max_value为81,那么类别1的方框将获得偏移量81(即1 * 81),而类别2的方框将获得偏移量162(即2 * 81)。通过这种方式,原本在空间位置上相互靠近的不同类别的预测框就可以被有效地分隔开。
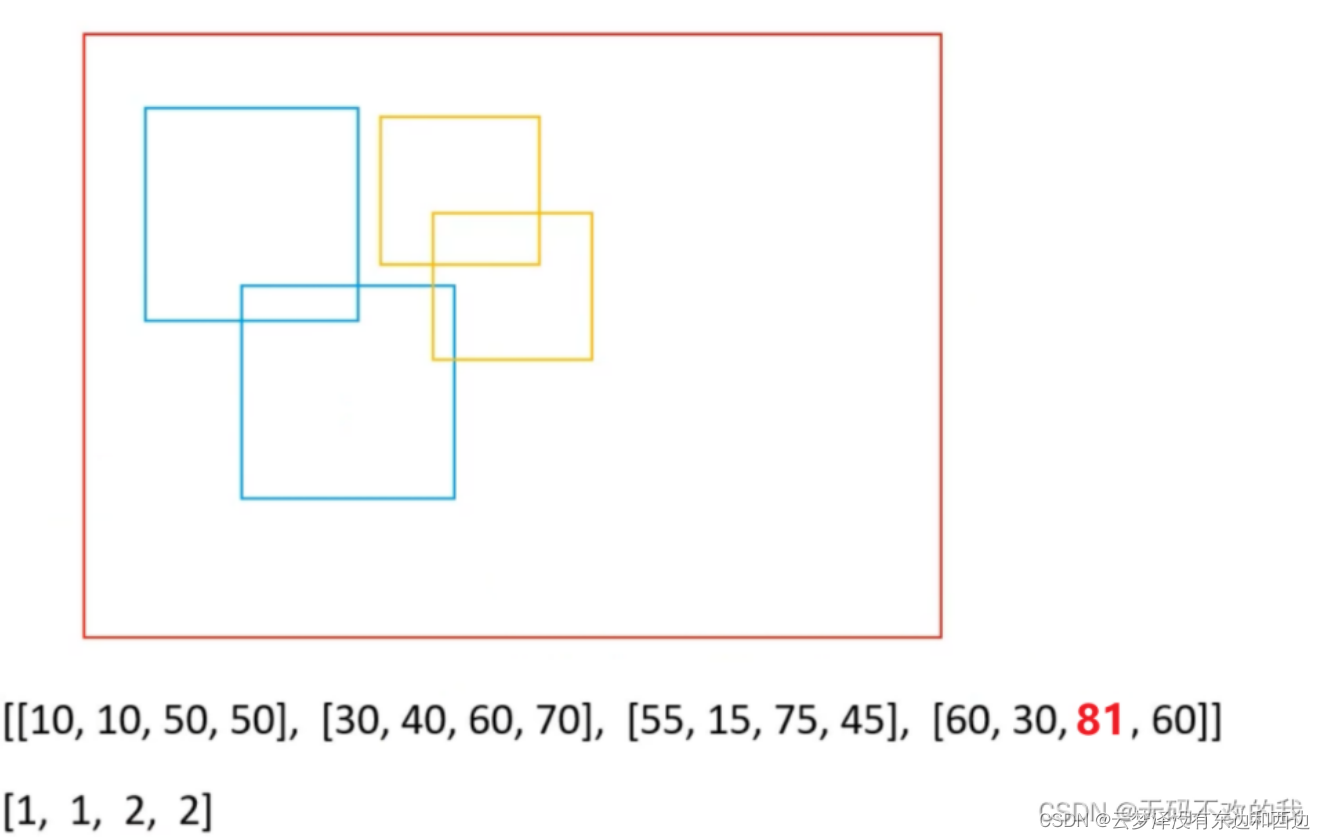
应用了偏移量之后,我们可以得到每个预测框的新坐标位置。接下来,就可以对所有类别的预测框统一进行一次性的NMS处理,而无需先对它们进行分类,再分别对每个类别应用NMS。这种方法不仅提高了处理效率,而且避免了在多类别情况下直接应用NMS可能导致的性能下降问题。
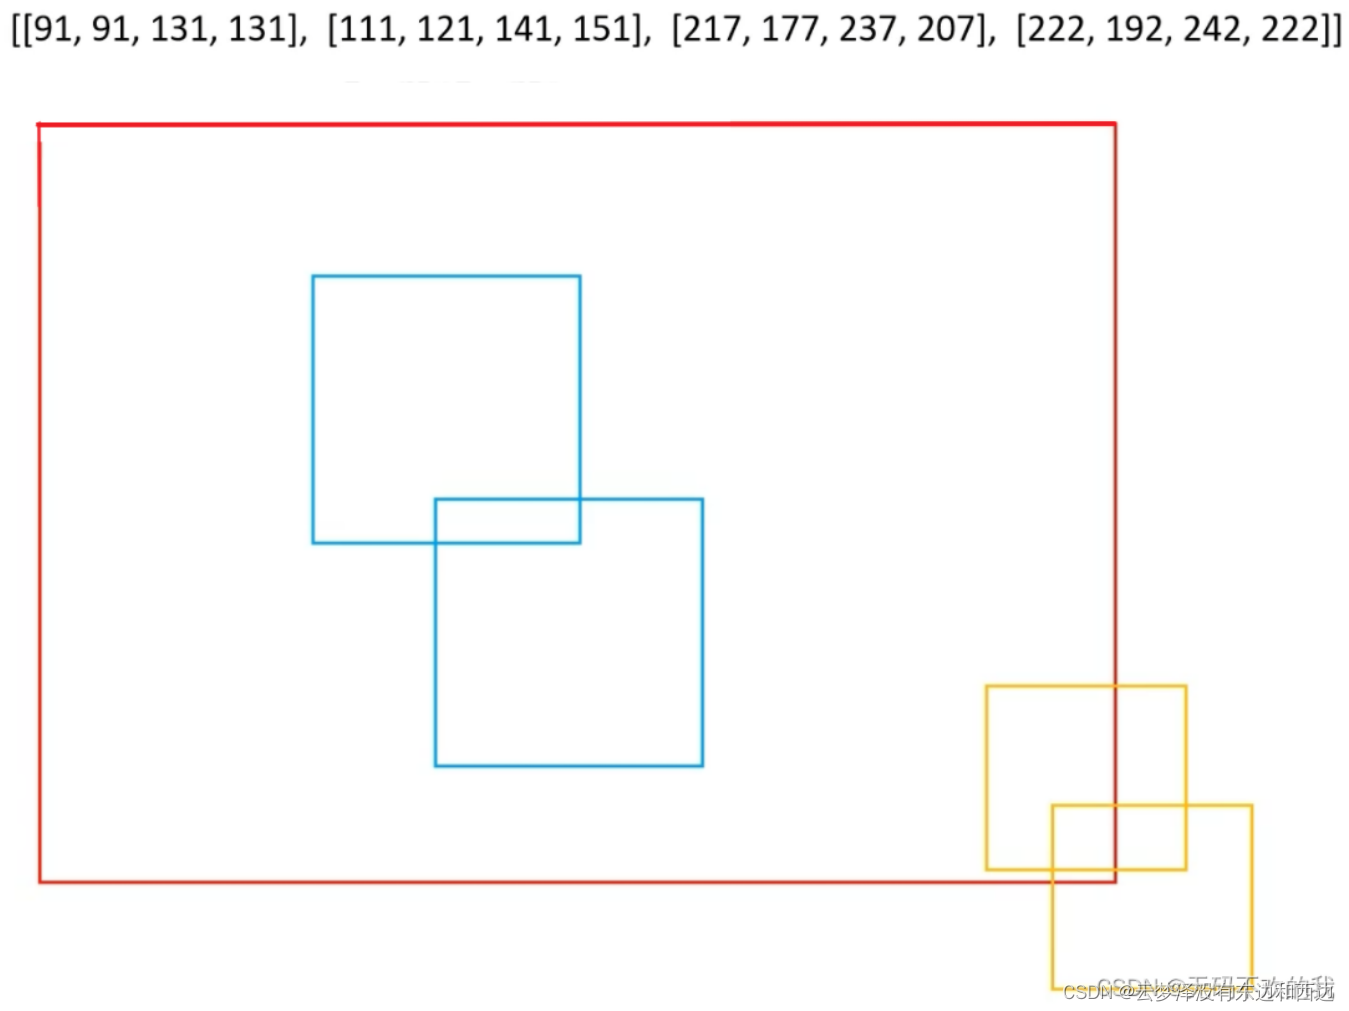
通过这种改进的NMS方法,目标检测算法能够更加高效地处理多类别预测框,提高了检测的准确性和速度。
参考文献

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 12
 0
- 0


 已为社区贡献1条内容

所有评论(0)