3.5 统计初步
本章系统阐述统计推断理论基础,涵盖大数定律、抽样分布、参数估计与假设检验等核心内容。以下从六个核心考点系统梳理知识体系:
考点一:大数定律与中心极限定理
1. 大数定律
- 切比雪夫不等式:
设随机变量 XXX 的数学期望 E(X)=μE(X)=\muE(X)=μ,方差 D(X)=σ2D(X)=\sigma^2D(X)=σ2,则对任意 ε>0\varepsilon>0ε>0:
P{∣X−μ∣≥ε}≤σ2ε2 P\{|X-\mu| \geq \varepsilon\} \leq \frac{\sigma^2}{\varepsilon^2} P{∣X−μ∣≥ε}≤ε2σ2 - 辛钦大数定律:
设独立同分布序列 {Xn}\{X_n\}{Xn} 满足 E(Xi)=μE(X_i)=\muE(Xi)=μ,则对任意 ε>0\varepsilon>0ε>0:
limn→∞P{∣1n∑k=1nXk−μ∣<ε}=1 \lim_{n \to \infty} P\left\{ \left| \frac{1}{n}\sum_{k=1}^n X_k - \mu \right| < \varepsilon \right\} = 1 n→∞limP{n1k=1∑nXk−μ<ε}=1
核心思想:大量样本的平均值具有稳定性,依概念收敛于理论均值。
2. 中心极限定理
设独立同分布序列 {Xn}\{X_n\}{Xn} 满足 E(Xi)=μE(X_i)=\muE(Xi)=μ,D(Xi)=σ2D(X_i)=\sigma^2D(Xi)=σ2,则:
limn→∞P{∑k=1nXk−nμσn≤x}=Φ(x)
\lim_{n \to \infty} P\left\{ \frac{\sum_{k=1}^n X_k - n\mu}{\sigma\sqrt{n}} \leq x \right\} = \Phi(x)
n→∞limP{σn∑k=1nXk−nμ≤x}=Φ(x)
核心思想:大量样本和 ∑Xk\sum X_k∑Xk 近似服从正态分布 N(nμ,nσ2)N(n\mu, n\sigma^2)N(nμ,nσ2)。
考点二:抽样分布
1. 统计量定义
- 统计量:不含有任何参数的样本函数。
- 常用的统计量:
- 样本均值:Xˉ=1n∑i=1nXi\bar{X} = \frac{1}{n}\sum_{i=1}^n X_iXˉ=n1∑i=1nXi
- 样本方差:S2S^2S2 = 1n−1∑i=1n(Xi−Xˉ)2\frac{1}{n-1}\sum_{i=1}^n (X_i - \bar{X})^2n−11∑i=1n(Xi−Xˉ)2 = 1n−1(∑i=1nXi2−nXˉ2)\frac{1}{n-1}(\sum_{i=1}^n X_i ^2-n \bar{X}^2)n−11(∑i=1nXi2−nXˉ2)
- 次序统计量:X(1)=min(Xi), X(n)=max(Xi)X_{(1)} = \min(X_i),\ X_{(n)} = \max(X_i)X(1)=min(Xi), X(n)=max(Xi)
- 样本矩
- 样本的 kkk 阶原点矩: Ak=1n∑i=1nXikA_k = \frac{1}{n}\sum_{i=1}^n X_i^kAk=n1∑i=1nXik
- 样本的 kkk 阶中心矩: Bk=1n∑i=1n(Xi−Xˉ)kB_k = \frac{1}{n}\sum_{i=1}^n (X_i - \bar{X})^kBk=n1∑i=1n(Xi−Xˉ)k
- S2S^2S2 ≠ B2B_2B2
2. 三大抽样分布
| 分布类型 | 定义 | 重要性质 |
|---|---|---|
| χ2\chi^2χ2分布 | X1,...,Xn∼N(0,1)X_1,...,X_n \sim N(0,1)X1,...,Xn∼N(0,1),则 ∑i=1nXi2∼χ2(n)\sum_{i=1}^n X_i^2 \sim \chi^2(n)∑i=1nXi2∼χ2(n) | 可加性(独立):χ2(n1)+χ2(n2)∼χ2(n1+n2)\chi^2(n_1) + \chi^2(n_2) \sim \chi^2(n_1+n_2)χ2(n1)+χ2(n2)∼χ2(n1+n2) |
| ttt分布 | X∼N(0,1), Y∼χ2(n)X \sim N(0,1),\ Y \sim \chi^2(n)X∼N(0,1), Y∼χ2(n),则 t=XY/n∼t(n)t = \frac{X}{\sqrt{Y/n}} \sim t(n)t=Y/nX∼t(n) | 对称性:t1−α(n)=−tα(n)t_{1-\alpha}(n) = -t_{\alpha}(n)t1−α(n)=−tα(n) |
| FFF分布 | U∼χ2(m), V∼χ2(n)U \sim \chi^2(m),\ V \sim \chi^2(n)U∼χ2(m), V∼χ2(n),则 F=U/mV/n∼F(m,n)F = \frac{U/m}{V/n} \sim F(m,n)F=V/nU/m∼F(m,n) | 倒数性质:F1−α(m,n)=1Fα(n,m)F_{1-\alpha}(m,n) = \frac{1}{F_{\alpha}(n,m)}F1−α(m,n)=Fα(n,m)1 |
3. 正态总体下的抽样分布
设 X1,...,Xn∼N(μ,σ2)X_1,...,X_n \sim N(\mu,\sigma^2)X1,...,Xn∼N(μ,σ2),则:
- 服从正态分布:Xˉ∼N(μ,σ2n)\bar{X} \sim N\left(\mu, \frac{\sigma^2}{n}\right)Xˉ∼N(μ,nσ2),标准化得:
U=Xˉ−μσ/n∼N(0,1)U = \frac{\bar{X}-\mu}{\sigma/\sqrt{n}} \sim N(0,1)U=σ/nXˉ−μ∼N(0,1) - 服从χ2\chi^2χ2分布:
(n−1)S2σ2∼χ2(n−1)\frac{(n-1)S^2}{\sigma^2} \sim \chi^2(n-1)σ2(n−1)S2∼χ2(n−1)
χ2=1σ2∑i=1n(Xi−μ)2∼χ2(n)\chi^2 = \frac{1}{\sigma^2}\sum_{i=1}^n (X_i - \mu)^2 \sim \chi^2(n)χ2=σ21i=1∑n(Xi−μ)2∼χ2(n) - 服从ttt分布 :
T=Xˉ−μS/n∼t(n−1)T = \frac{\bar{X}-\mu}{S/\sqrt{n}} \sim t(n-1)T=S/nXˉ−μ∼t(n−1)
4. 分位点的性质与意义
-
分位点的定义
对于一个随机变量 XXX,其分布函数为 F(x)F(x)F(x),给定概率水平α∈(0,1)\alpha \in (0,1)α∈(0,1),分位点 xαx_\alphaxα 是满足如下条件的值:
P(X≤xα)≥α且P(X≥xα)≥1−α P(X \leq x_\alpha) \geq \alpha \quad \text{且} \quad P(X \geq x_\alpha) \geq 1 - \alpha P(X≤xα)≥α且P(X≥xα)≥1−α
此时称 xαx_\alphaxα 为 α\alphaα 分位点。 -
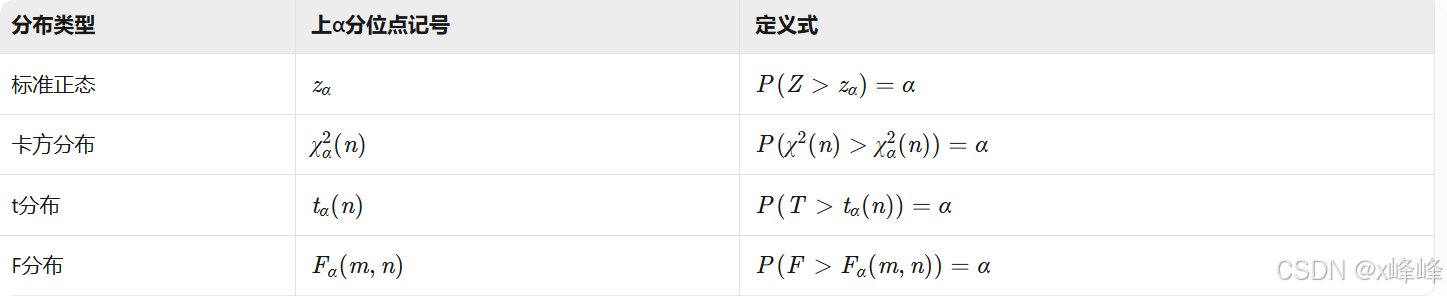
上α分位点
在假设检验中广泛使用上ααα分位点,记为 uαu_\alphauα:
P(X>uα)=α或等价于P(X≤uα)=1−α P(X > u_\alpha) = \alpha \quad \text{或等价于} \quad P(X \leq u_\alpha) = 1 - \alpha P(X>uα)=α或等价于P(X≤uα)=1−α
标准正态分布的上ααα分位点记为 zαz_\alphazα,满足:
P(Z>zα)=α,Z∼N(0,1) P(Z > z_\alpha) = \alpha, \quad Z \sim N(0,1) P(Z>zα)=α,Z∼N(0,1) -
常用分布的分位点表示
考点三:统计量的数字特征
| 统计量 | 期望 | 方差 |
|---|---|---|
| 样本均值 Xˉ\bar{X}Xˉ | E(Xˉ)=μE(\bar{X}) = \muE(Xˉ)=μ | D(Xˉ)=σ2nD(\bar{X}) = \frac{\sigma^2}{n}D(Xˉ)=nσ2 |
| χ2\chi^2χ2分布 | E(χ2(n))=nE(\chi^2(n)) = nE(χ2(n))=n | D(χ2(n))=2nD(\chi^2(n)) = 2nD(χ2(n))=2n |
| 样本方差 S2S^2S2 | E(S2)=σ2E(S^2) = \sigma^2E(S2)=σ2 | D(S2)=2σ4n−1D(S^2) = \frac{2\sigma^4}{n-1}D(S2)=n−12σ4 |
| 样本协方差 SXYS_{XY}SXY | E(SXY)=Cov(X,Y)E(S_{XY}) = \text{Cov}(X,Y)E(SXY)=Cov(X,Y) | 复杂表达式需特殊计算 |
考点四:参数估计
- 核心思想:用样本矩估计总体矩
1. 矩估计法
- 思路:用样本矩代替总体矩。
- 原点矩:样本矩----Ak=1n∑i=1nXikA_k= \frac{1}{n}\sum_{i=1}^n X_i^kAk=n1∑i=1nXik 、总体矩----μk=E(Xk)\mu_{k} = E(X^k)μk=E(Xk)
- 中心距:样本矩----Bk=1n∑i=1n(Xi−Xˉ)kB_k= \frac{1}{n}\sum_{i=1}^n (X_i - \bar{X})^kBk=n1∑i=1n(Xi−Xˉ)k 、总体矩----βk=E[(X−E(X))k]\beta_{k} = E[(X-E(X))^k]βk=E[(X−E(X))k]
- 步骤:
- 建立方程 Ak=μkA_k = \mu_kAk=μk 与 Bk=βkB_k = \beta_kBk=βk (
有几个未知数建立几个方程) - 解方程得参数估计量
- 建立方程 Ak=μkA_k = \mu_kAk=μk 与 Bk=βkB_k = \beta_kBk=βk (
2. 最大似然估计
- 似然函数:
离散型:L(θ)=∏i=1nP(Xi;θ)L(\theta) = \prod_{i=1}^n P(X_i;\theta)L(θ)=∏i=1nP(Xi;θ)
连续型:L(θ)=∏i=1nf(Xi;θ)L(\theta) = \prod_{i=1}^n f(X_i;\theta)L(θ)=∏i=1nf(Xi;θ) - 求解步骤:
- 取对数 lnL(θ)\ln L(\theta)lnL(θ)
- 对 θ\thetaθ 求导并令导数为零
- 解方程得 θ^MLE\hat{\theta}_{MLE}θ^MLE
考点五:估计量的评选标准
| 标准 | 数学定义 | 判定方法 |
|---|---|---|
| 无偏性 | E(θ^)=θE(\hat{\theta}) = \thetaE(θ^)=θ | 计算期望验证等式成立 |
| 有效性 | D(θ^1)<D(θ^2)D(\hat{\theta}_1) < D(\hat{\theta}_2)D(θ^1)<D(θ^2) | 比较方差大小 |
| 一致性 | limn→∞P(∣θ^−θ∣≥ε)=0\lim_{n \to \infty} P(|\hat{\theta}-\theta| \geq \varepsilon) = 0limn→∞P(∣θ^−θ∣≥ε)=0 | 应用大数定律或切比雪夫不等式 |
考点六:区间估计与假设检验
1. 区间估计
- 步骤:
- 构造枢轴量 T(X,θ)T(X,\theta)T(X,θ)(如 U=Xˉ−μσ/nU = \frac{\bar{X}-\mu}{\sigma/\sqrt{n}}U=σ/nXˉ−μ)
- 确定置信区间 P(a<T<b)=1−αP(a < T < b) = 1-\alphaP(a<T<b)=1−α
- 反解得到 θ\thetaθ 的区间估计
正态总体均值区间估计:
- σ2\sigma^2σ2 已知:μ∈(Xˉ±σnzα/2)\mu \in \left( \bar{X} \pm \frac{\sigma}{\sqrt{n}} z_{\alpha/2} \right)μ∈(Xˉ±nσzα/2)
- σ2\sigma^2σ2 未知:μ∈(Xˉ±Sntα/2(n−1))\mu \in \left( \bar{X} \pm \frac{S}{\sqrt{n}} t_{\alpha/2}(n-1) \right)μ∈(Xˉ±nStα/2(n−1))
2. 假设检验
- 两类错误:
错误类型 概率符号 发生条件 第一类错误 α\alphaα H0H_0H0 为真但被拒绝(弃真) 第二类错误 β\betaβ H0H_0H0 为假但被接受(存伪)
注:我们把犯第一类错误的概率称为显著性水平。
- 检验步骤:
- 建立原假设 H0H_0H0 与备择假设 H1H_1H1
- 确定检验统计量及其分布
- 给定显著性水平 α\alphaα,确定拒绝域
- 根据样本计算统计量值,判断是否拒绝 H0H_0H0
总结
本章重点掌握:
- 大数定律与中心极限定理的理论联系与区别
- 三大抽样分布的定义与正态总体的抽样分布性质
- 参数估计的双重方法(矩估计与极大似然估计)
- 假设检验的逻辑框架与两类错误的实际意义

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐


 18
 0
- 0


 已为社区贡献3条内容

所有评论(0)