从头开始的qwen2
参考:https://github.com/naklecha/llama3-from-scratch
qwen2模型架构

加载tokenizer
使用transformers库加载tokenizer
kenizer_config.json, merges.txt, vocab.json, tokenizer.json:这些都是与分词器(tokenizer)相关的文件 (相关文件可以去hugging face或魔塔社区下载)
- tokenizer_config.json:
这个文件包含了分词器的基本配置信息,如模型类型、是否添加前缀空间等。它告诉程序如何初始化分词器,以及一些特定于该分词器的行为参数。 - merges.txt:
在基于BPE(Byte Pair Encoding)或WordPiece等算法的分词器中使用。这个文件包含了一系列的合并规则,指定了哪些字符或子词应该被逐步合并在一起形成更大的单位。例如,“a”和“n”可能会根据这些规则合并成“an”。 - vocab.json 或 tokenizer.json:
vocab.json:这是词汇表文件,它定义了模型能够识别的所有单词或子词单元及其对应的唯一标识符(ID)。每个单词或子词映射到一个唯一的整数。
tokenizer.json:有时会使用这个文件来代替vocab.json,特别是对于更复杂的分词器设置。除了词汇表信息外,它可能还包含额外的配置细节或扩展功能。
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("/Users/zhaochenguang/Model/modelscope/Qwen2.5-1.5B-Instruct")
# test
tokenizer.decode(tokenizer.encode("Hello, world!"))
'Hello, world!'
读取权重文件
from safetensors.torch import load_file

# 定义文件路径
file_path = "/Users/zhaochenguang/Model/modelscope/Qwen2.5-1.5B-Instruct/model.safetensors"

# 使用 load_file 函数加载整个 .safetensors 文件
weights_dict = load_file(file_path)

# 检查读取的权重(可选)
for key in weights_dict.keys():
    print(f"Key: {key}, Tensor shape: {weights_dict[key].shape}")
Key: model.embed_tokens.weight, Tensor shape: torch.Size([151936,
1536]) Key: model.layers.0.input_layernorm.weight, Tensor shape:
torch.Size([1536]) Key: model.layers.0.mlp.down_proj.weight, Tensor
shape: torch.Size([1536, 8960]) Key:
model.layers.0.mlp.gate_proj.weight, Tensor shape: torch.Size([8960,
1536]) Key: model.layers.0.mlp.up_proj.weight, Tensor shape:
torch.Size([8960, 1536]) Key:
model.layers.0.post_attention_layernorm.weight, Tensor shape:
torch.Size([1536]) Key: model.layers.0.self_attn.k_proj.bias, Tensor
shape: torch.Size([256]) Key: model.layers.0.self_attn.k_proj.weight,
Tensor shape: torch.Size([256, 1536]) Key:
model.layers.0.self_attn.o_proj.weight, Tensor shape:
torch.Size([1536, 1536]) Key: model.layers.0.self_attn.q_proj.bias,
Tensor shape: torch.Size([1536]) Key:
model.layers.0.self_attn.q_proj.weight, Tensor shape:
torch.Size([1536, 1536]) Key: model.layers.0.self_attn.v_proj.bias,
Tensor shape: torch.Size([256]) Key:
model.layers.0.self_attn.v_proj.weight, Tensor shape: torch.Size([256,
1536]) Key: model.layers.1.input_layernorm.weight, Tensor shape:
torch.Size([1536]) Key: model.layers.1.mlp.down_proj.weight, Tensor
shape: torch.Size([1536, 8960]) Key:
model.layers.1.mlp.gate_proj.weight, Tensor shape: torch.Size([8960,
1536]) … Key: model.layers.9.self_attn.k_proj.bias, Tensor shape:
torch.Size([256]) Key: model.layers.9.self_attn.k_proj.weight, Tensor
shape: torch.Size([256, 1536]) Key:
model.layers.9.self_attn.o_proj.weight, Tensor shape:
torch.Size([1536, 1536]) Key: model.layers.9.self_attn.q_proj.bias,
Tensor shape: torch.Size([1536]) Key:
model.layers.9.self_attn.q_proj.weight, Tensor shape:
torch.Size([1536, 1536]) Key: model.layers.9.self_attn.v_proj.bias,
Tensor shape: torch.Size([256]) Key:
model.layers.9.self_attn.v_proj.weight, Tensor shape: torch.Size([256,
1536]) Key: model.norm.weight, Tensor shape: torch.Size([1536])
读取配置文件
读取配置文件,并初始化模型架构相关参数。
某些参数可以在上面的权重文件中体现出来。例如:num_hidden_layers、intermediate_size等
import json

with open("/Users/zhaochenguang/Model/modelscope/Qwen2.5-1.5B-Instruct/config.json") as f:
    config = f.read()

config = json.loads(config)

config
{‘architectures’: [‘Qwen2ForCausalLM’], ‘attention_dropout’: 0.0,
‘bos_token_id’: 151643, ‘eos_token_id’: 151645, ‘hidden_act’:
‘silu’, ‘hidden_size’: 1536, ‘initializer_range’: 0.02,
‘intermediate_size’: 8960, ‘max_position_embeddings’: 32768,
‘max_window_layers’: 21, ‘model_type’: ‘qwen2’,
‘num_attention_heads’: 12, ‘num_hidden_layers’: 28,
‘num_key_value_heads’: 2, ‘rms_norm_eps’: 1e-06, ‘rope_theta’:
1000000.0, ‘sliding_window’: 32768, ‘tie_word_embeddings’: True, ‘torch_dtype’: ‘bfloat16’, ‘transformers_version’: ‘4.43.1’,
‘use_cache’: True, ‘use_sliding_window’: False, ‘vocab_size’:
151936}
import torch

dim = config["hidden_size"] # 向量维度大小
n_layers = config["num_hidden_layers"] # transformer层数
n_heads = config["num_attention_heads"] # 多头注意力头数
n_kv_heads = config["num_key_value_heads"] # key和value的头数
bos_token_id = config["bos_token_id"] # 序列开始标志的ID
vocab_size = config["vocab_size"] # 词表大小
multiple_of = config["intermediate_size"] # 前馈网络层的维度
norm_eps = config["rms_norm_eps"] # 进行归一化时为了避免除零错误而添加的小数值
rope_theta = torch.tensor(config["rope_theta"]) # RoPE算法(Rotary Position Embedding)的一个参数,用于控制位置编码随序列长度增长的速度。
将文本转换为ids
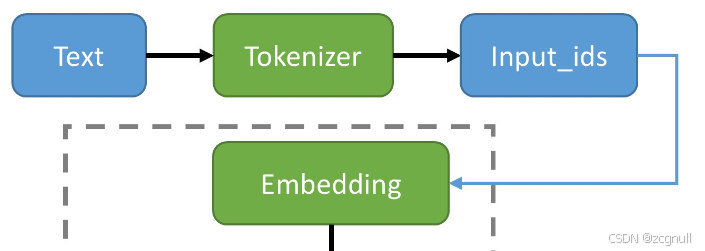
prompt = "特朗普是美国的" # 使用经典问题
tokens = [bos_token_id] + tokenizer.encode(prompt) # 开始增加序列开始标志的ID
print(tokens)
tokens = torch.tensor(tokens)
prompt_split_as_tokens = [tokenizer.decode([token]) for token in tokens]
print(prompt_split_as_tokens)
[151643, 105142, 20412, 100625, 9370] [‘<|endoftext|>’, ‘特朗普’, ‘是’,
‘美国’, ‘的’]
将token转换为嵌入
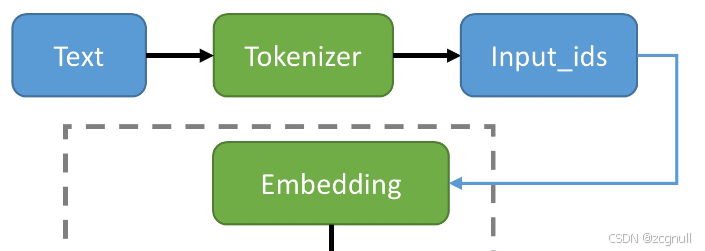
embedding_layer = torch.nn.Embedding(vocab_size, dim)
embedding_layer.weight.data.copy_(weights_dict["model.embed_tokens.weight"])
token_embeddings_unnormalized = embedding_layer(tokens).to(torch.float32)
token_embeddings_unnormalized.shape
torch.Size([5, 1536])
构建Transformer的第一层
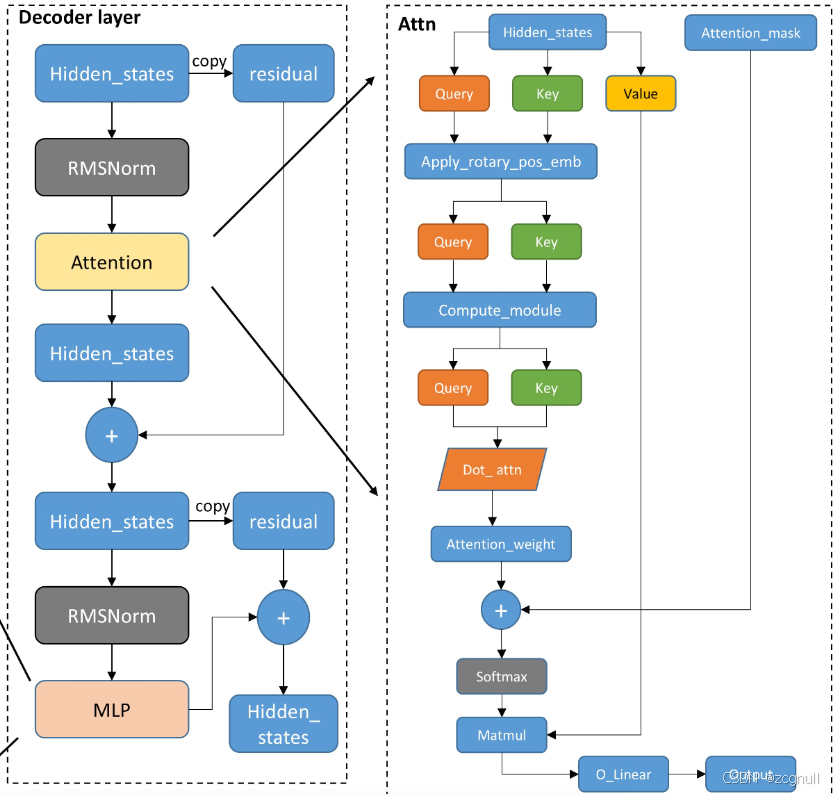
RMSNorm归一化
aˉi=aiRMS(a)gi,where RMS(a)=1n∑i=1nai2. \bar{a}_i = \frac{a_i}{\text{RMS}(\mathbf{a})} g_i, \quad \text{where } \text{RMS}(\mathbf{a}) = \sqrt{\frac{1}{n} \sum_{i=1}^{n} a_i^2}. aˉi=RMS(a)aigi,where RMS(a)=n1i=1∑nai2.
def rms_norm(tensor, norm_weights):
    return (tensor * torch.rsqrt((tensor.pow(2).mean(-1, keepdim=True) + norm_eps))) * norm_weights
token_embeddings = rms_norm(token_embeddings_unnormalized, weights_dict["model.layers.0.input_layernorm.weight"])
token_embeddings.shape
torch.Size([5, 1536])
Attention注意力机制
print(
    weights_dict["model.layers.0.self_attn.k_proj.weight"].shape,
    weights_dict["model.layers.0.self_attn.q_proj.weight"].shape,
    weights_dict["model.layers.0.self_attn.v_proj.weight"].shape,
    weights_dict["model.layers.0.self_attn.o_proj.weight"].shape
)
torch.Size([256, 1536]) torch.Size([1536, 1536]) torch.Size([256,
1536]) torch.Size([1536, 1536])
展开query
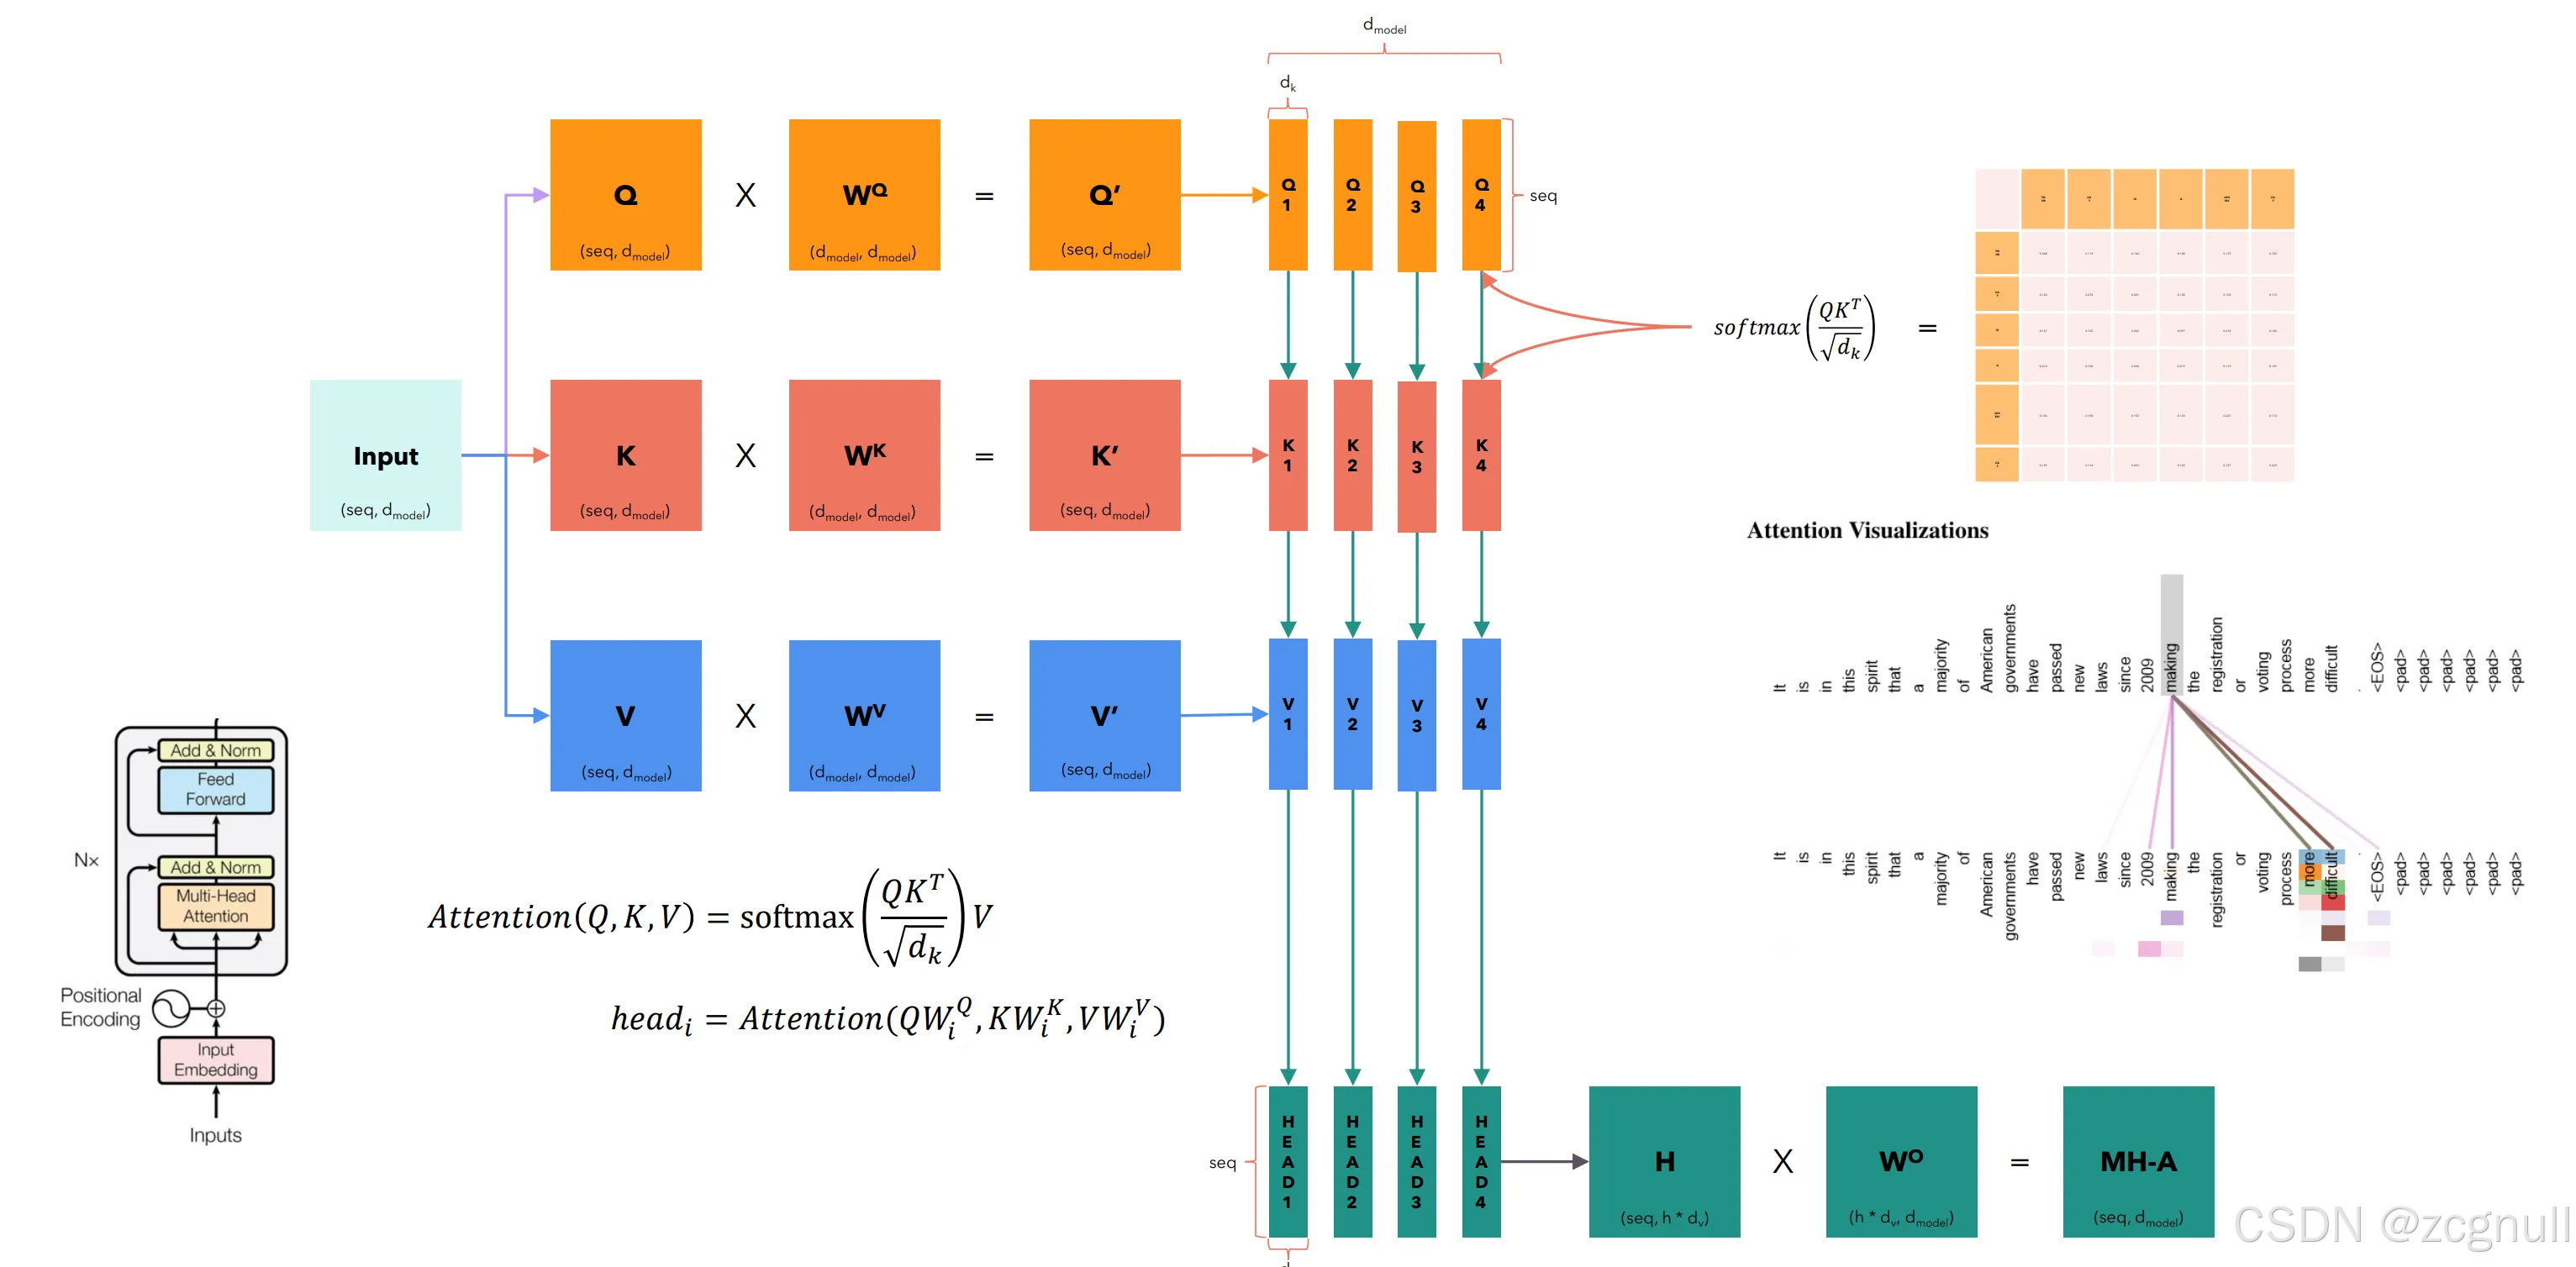
多头注意力的实现,下图只是一个示例。
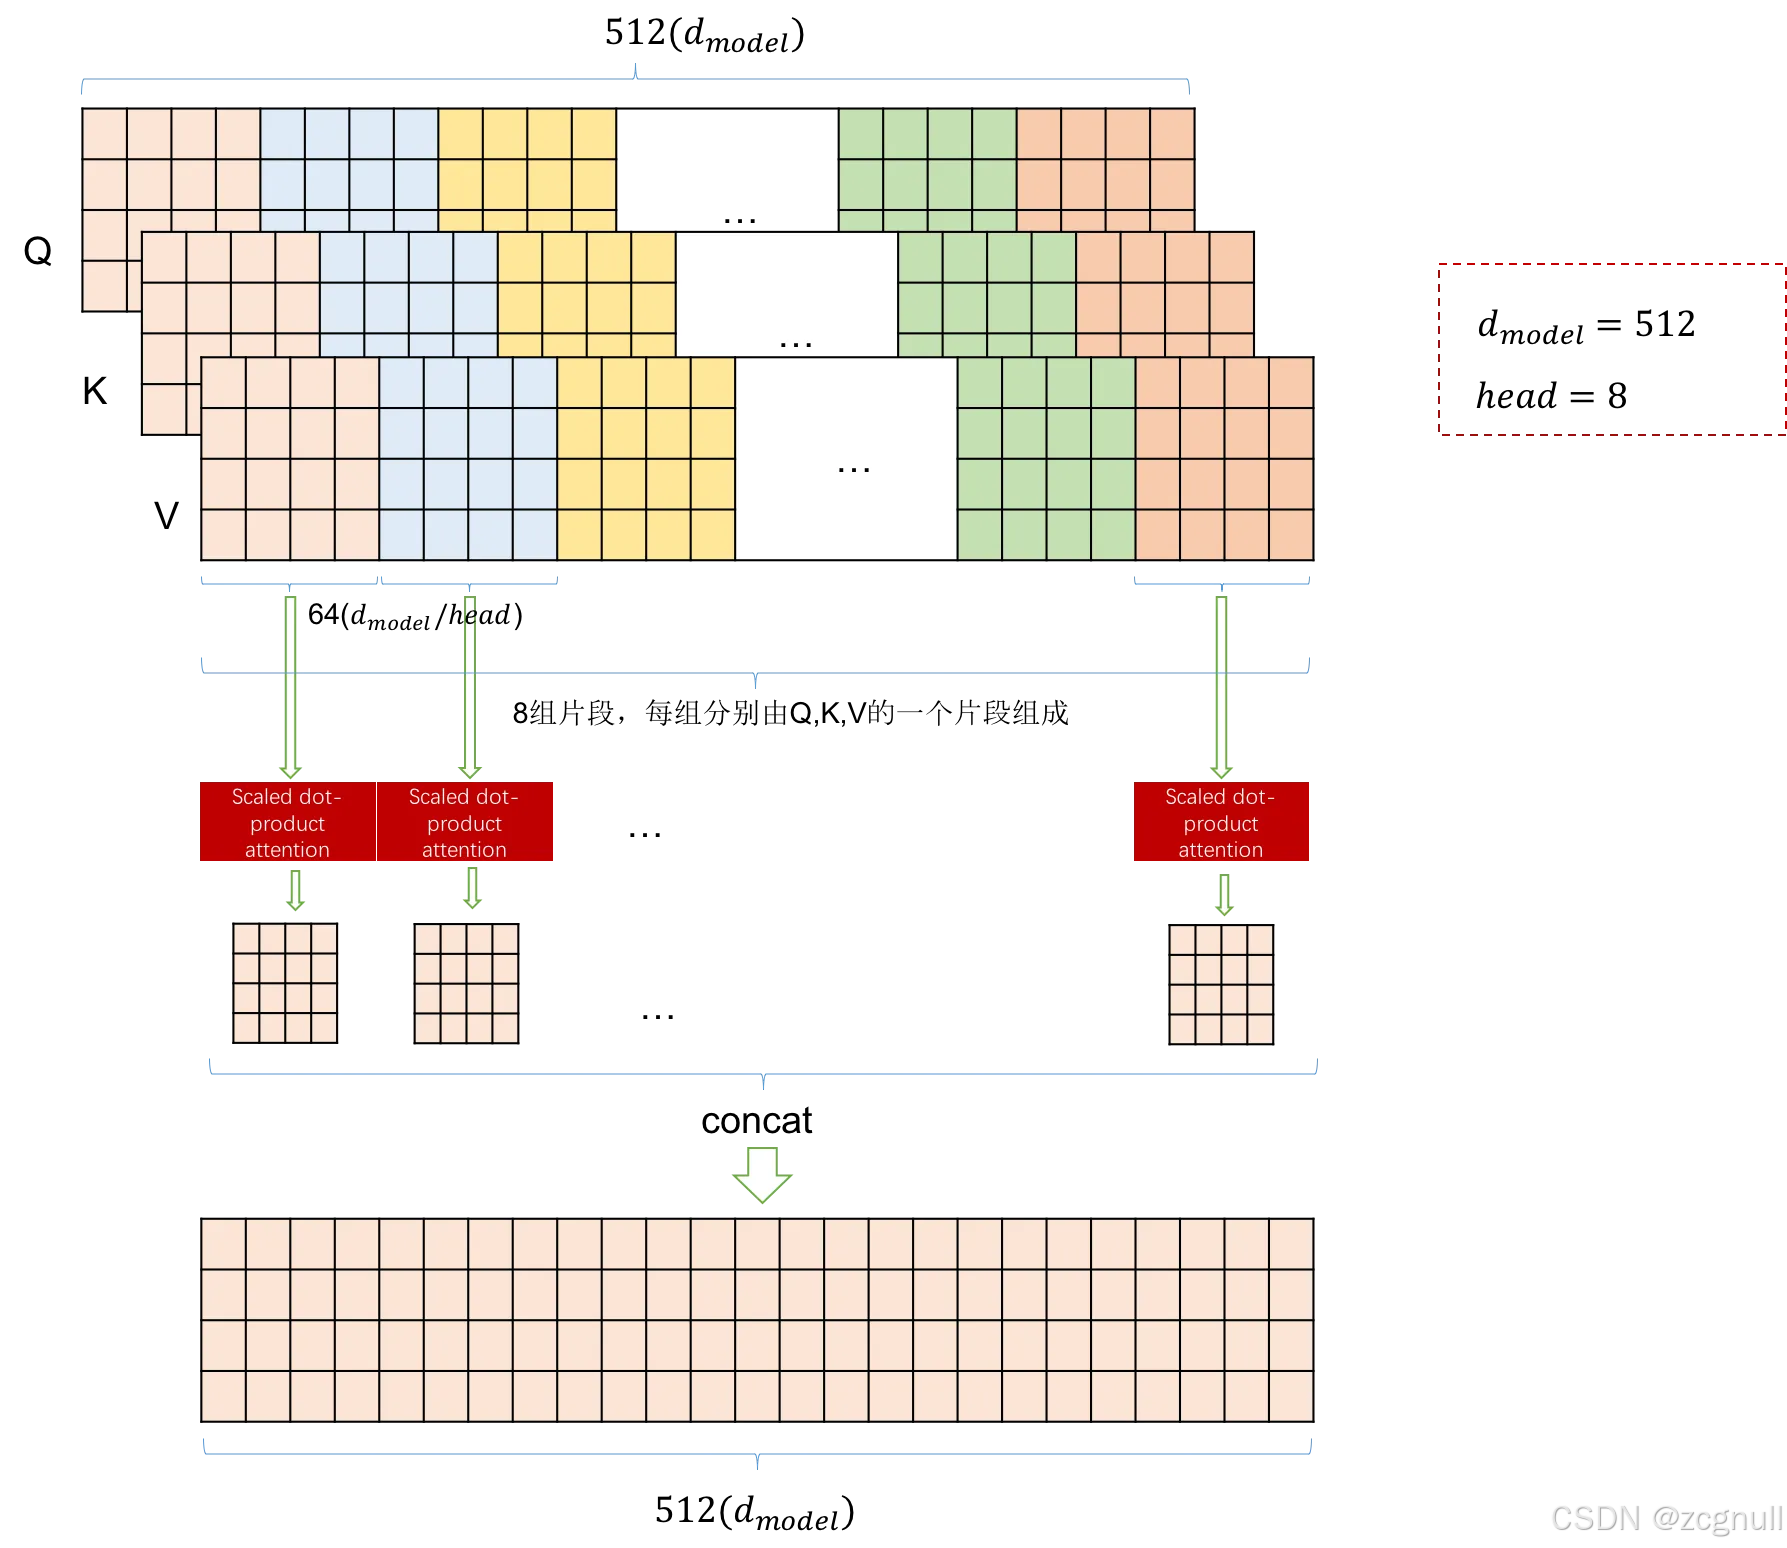
q_layer0 = weights_dict["model.layers.0.self_attn.q_proj.weight"]
head_dim = q_layer0.shape[0] // n_heads
q_layer0 = q_layer0.view(n_heads, head_dim, dim)
q_layer0.shape
torch.Size([12, 128, 1536])
q_layer0_bias = weights_dict["model.layers.0.self_attn.q_proj.bias"]
q_layer0_bias = q_layer0_bias.view(n_heads, head_dim)
q_layer0_bias.shape
torch.Size([12, 128])
实现第一层的第一个头
基本实现与Transformer相同,下图是Transformer架构的实现。
# 权重
q_layer0_head0 = q_layer0[0]
q_layer0_head0.shape
torch.Size([128, 1536])
# 偏置
q_layer0_head0_bias = q_layer0_bias[0]
q_layer0_head0_bias.shape
torch.Size([128])
# Q * W^Q + b
# q_per_token = torch.matmul(token_embeddings.to(torch.bfloat16), q_layer0_head0.T)
q_per_token = torch.matmul(token_embeddings.to(torch.bfloat16), q_layer0_head0.T) + q_layer0_head0_bias
q_per_token.shape
torch.Size([5, 128])
位置编码
RoPE旋转位置编码:https://blog.csdn.net/v_JULY_v/article/details/134085503
q_per_token_split_into_pairs = q_per_token.float().view(q_per_token.shape[0], -1, 2)  # q_m -> [q_m1, q_m2]
q_per_token_split_into_pairs.shape
torch.Size([5, 64, 2])
zero_to_one_split_into_64_parts = torch.tensor(range(64))/64
zero_to_one_split_into_64_parts
tensor([0.0000, 0.0156, 0.0312, 0.0469, 0.0625, 0.0781, 0.0938,
0.1094, 0.1250,
0.1406, 0.1562, 0.1719, 0.1875, 0.2031, 0.2188, 0.2344, 0.2500, 0.2656,
0.2812, 0.2969, 0.3125, 0.3281, 0.3438, 0.3594, 0.3750, 0.3906, 0.4062,
0.4219, 0.4375, 0.4531, 0.4688, 0.4844, 0.5000, 0.5156, 0.5312, 0.5469,
0.5625, 0.5781, 0.5938, 0.6094, 0.6250, 0.6406, 0.6562, 0.6719, 0.6875,
0.7031, 0.7188, 0.7344, 0.7500, 0.7656, 0.7812, 0.7969, 0.8125, 0.8281,
0.8438, 0.8594, 0.8750, 0.8906, 0.9062, 0.9219, 0.9375, 0.9531, 0.9688,
0.9844])
freqs = 1.0 / (rope_theta ** zero_to_one_split_into_64_parts)
freqs
tensor([1.0000e+00, 8.0584e-01, 6.4938e-01, 5.2330e-01, 4.2170e-01,
3.3982e-01,
2.7384e-01, 2.2067e-01, 1.7783e-01, 1.4330e-01, 1.1548e-01, 9.3057e-02,
7.4989e-02, 6.0430e-02, 4.8697e-02, 3.9242e-02, 3.1623e-02, 2.5483e-02,
2.0535e-02, 1.6548e-02, 1.3335e-02, 1.0746e-02, 8.6596e-03, 6.9783e-03,
5.6234e-03, 4.5316e-03, 3.6517e-03, 2.9427e-03, 2.3714e-03, 1.9110e-03,
1.5399e-03, 1.2409e-03, 1.0000e-03, 8.0584e-04, 6.4938e-04, 5.2330e-04,
4.2170e-04, 3.3982e-04, 2.7384e-04, 2.2067e-04, 1.7783e-04, 1.4330e-04,
1.1548e-04, 9.3057e-05, 7.4989e-05, 6.0430e-05, 4.8697e-05, 3.9242e-05,
3.1623e-05, 2.5483e-05, 2.0535e-05, 1.6548e-05, 1.3335e-05, 1.0746e-05,
8.6596e-06, 6.9783e-06, 5.6234e-06, 4.5316e-06, 3.6517e-06, 2.9427e-06,
2.3714e-06, 1.9110e-06, 1.5399e-06, 1.2409e-06])
freqs_for_each_token = torch.outer(torch.arange(5), freqs)
freqs_cis = torch.polar(torch.ones_like(freqs_for_each_token), freqs_for_each_token)
freqs_cis.shape
torch.Size([5, 64])
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['Arial Unicode MS', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

# 查看freqs_cis第3行
value = freqs_cis[3]
plt.figure()
for i, element in enumerate(value[:5]):
    plt.plot([0, element.real], [0, element.imag], color='blue', linewidth=1, label=f"Index: {i}")
    plt.annotate(f"{i}", xy=(element.real, element.imag), color='red')
plt.xlabel('Real')
plt.ylabel('Imaginary')
plt.title('Plot of one row of freqs_cis')
plt.show()
# 使用点积根据位置旋转query
q_per_token_as_complex_numbers = torch.view_as_complex(q_per_token_split_into_pairs)  # [q_m1, q_m2] -> [q_m1 + i q_m2]
q_per_token_as_complex_numbers.shape
torch.Size([5, 64])
# 应用旋转
q_per_token_as_complex_numbers_rotated = q_per_token_as_complex_numbers * freqs_cis
q_per_token_as_complex_numbers_rotated.shape
torch.Size([5, 64])
# 通过将复数视为实数来获取成对的查询
q_per_token_split_into_pairs_rotated = torch.view_as_real(q_per_token_as_complex_numbers_rotated) # [q_m1 + i q_m2] -> [q_m1, q_m2]
q_per_token_split_into_pairs_rotated.shape
torch.Size([5, 64, 2])
# 合并旋转后的对
q_per_token_rotated = q_per_token_split_into_pairs_rotated.view(q_per_token.shape) # [q_m1, q_m2] -> q_m
q_per_token_rotated.shape
torch.Size([5, 128])
Key(与Query的操作基本相同)
k_layer0 = weights_dict["model.layers.0.self_attn.k_proj.weight"]
k_layer0 = k_layer0.view(n_kv_heads, k_layer0.shape[0] // n_kv_heads, dim)
k_layer0.shape
torch.Size([2, 128, 1536])
k_layer0_bias = weights_dict["model.layers.0.self_attn.k_proj.bias"]
k_layer0_bias = k_layer0_bias.view(n_kv_heads, k_layer0_bias.shape[0] // n_kv_heads)
k_layer0_bias.shape
torch.Size([2, 128])
# 权重
k_layer0_head0 = k_layer0[0]
k_layer0_head0.shape
torch.Size([128, 1536])
# 偏置
k_layer0_head0_bias = k_layer0_bias[0]
k_layer0_head0_bias.shape
torch.Size([128])
# K * W^K + b
# k_per_token = torch.matmul(token_embeddings.to(torch.bfloat16), k_layer0_head0.T)
k_per_token = torch.matmul(token_embeddings.to(torch.bfloat16), k_layer0_head0.T) + k_layer0_head0_bias
k_per_token.shape
torch.Size([5, 128])
k_per_token_split_into_pairs = k_per_token.float().view(k_per_token.shape[0], -1, 2)
k_per_token_split_into_pairs.shape
torch.Size([5, 64, 2])
k_per_token_as_complex_numbers = torch.view_as_complex(k_per_token_split_into_pairs)
k_per_token_as_complex_numbers.shape
torch.Size([5, 64])
k_per_token_split_into_pairs_rotated = torch.view_as_real(k_per_token_as_complex_numbers * freqs_cis)
k_per_token_split_into_pairs_rotated.shape
torch.Size([5, 64, 2])
k_per_token_rotated = k_per_token_split_into_pairs_rotated.view(k_per_token.shape)
k_per_token_rotated.shape
torch.Size([5, 128])
将Query与Key相乘
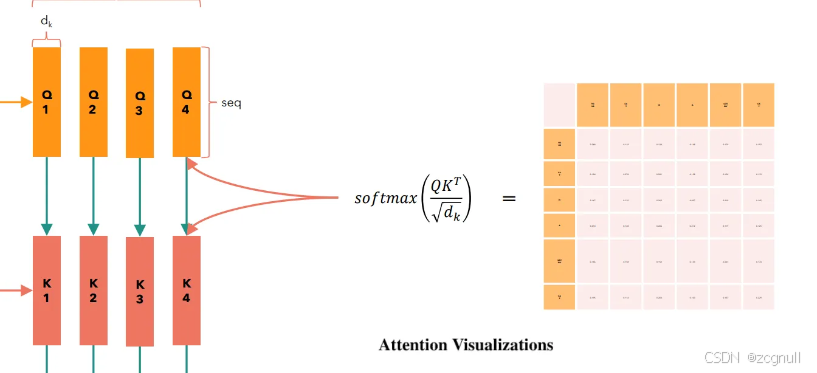
qk_per_token = torch.matmul(q_per_token_rotated, k_per_token_rotated.T)/(head_dim)**0.5
qk_per_token.shape
torch.Size([5, 5])
屏蔽Query-Key分数
def display_qk_heatmap(qk_per_token):
    _, ax = plt.subplots()
    im = ax.imshow(qk_per_token.to(float).detach(), cmap='viridis')
    ax.set_xticks(range(len(prompt_split_as_tokens)))
    ax.set_yticks(range(len(prompt_split_as_tokens)))
    ax.set_xticklabels(prompt_split_as_tokens)
    ax.set_yticklabels(prompt_split_as_tokens)
    ax.figure.colorbar(im, ax=ax)

display_qk_heatmap(qk_per_token)
mask = torch.full((len(tokens), len(tokens)), float("-inf"), device=tokens.device)
mask = torch.triu(mask, diagonal=1)
mask
tensor([[0., -inf, -inf, -inf, -inf],
[0., 0., -inf, -inf, -inf],
[0., 0., 0., -inf, -inf],
[0., 0., 0., 0., -inf],
[0., 0., 0., 0., 0.]])
qk_per_token_after_masking = qk_per_token + mask
display_qk_heatmap(qk_per_token_after_masking)
qk_per_token_after_masking_after_softmax = torch.nn.functional.softmax(qk_per_token_after_masking, dim=1).to(torch.bfloat16)
display_qk_heatmap(qk_per_token_after_masking_after_softmax)
Value
就像Key一样,Value权重也在每 6 个注意力头之间共享(以节省计算量)
v_layer0 = weights_dict["model.layers.0.self_attn.v_proj.weight"]
v_layer0 = v_layer0.view(n_kv_heads, v_layer0.shape[0] // n_kv_heads, dim)
v_layer0.shape
torch.Size([2, 128, 1536])
v_layer0_bias = weights_dict["model.layers.0.self_attn.v_proj.bias"]
v_layer0_bias = v_layer0_bias.view(n_kv_heads, v_layer0_bias.shape[0] // n_kv_heads)
v_layer0_bias.shape
torch.Size([2, 128])
v_layer0_head0 = v_layer0[0]
v_layer0_head0.shape
torch.Size([128, 1536])
v_layer0_head0_bias = v_layer0_bias[0]
v_layer0_head0_bias.shape
torch.Size([128])
v_per_token = torch.matmul(token_embeddings.to(torch.bfloat16), v_layer0_head0.T) + v_layer0_head0_bias
v_per_token.shape
torch.Size([5, 128])
qkv_attention = torch.matmul(qk_per_token_after_masking_after_softmax, v_per_token)
qkv_attention.shape
torch.Size([5, 128])
多头注意力机制
现在我要运行一个循环,对第一层的每个头部执行与上面的单元格完全相同的数学运算
qkv_attention_store = []

for head in range(n_heads):
    q_layer0_head = q_layer0[head]
    k_layer0_head = k_layer0[head//6] # key权重由 6 个头部共享
    v_layer0_head = v_layer0[head//6] # value权重由 6 个头部共享
    q_layer0_head_bias = q_layer0_bias[head]
    k_layer0_head_bias = k_layer0_bias[head//6] # key权重由 6 个头部共享
    v_layer0_head_bias = v_layer0_bias[head//6] # value权重由 6 个头部共享
    q_per_token = torch.matmul(token_embeddings.to(torch.bfloat16), q_layer0_head.T) + q_layer0_head_bias
    k_per_token = torch.matmul(token_embeddings.to(torch.bfloat16), k_layer0_head.T) + k_layer0_head_bias
    v_per_token = torch.matmul(token_embeddings.to(torch.bfloat16), v_layer0_head.T) + v_layer0_head_bias

    q_per_token_split_into_pairs = q_per_token.float().view(q_per_token.shape[0], -1, 2)
    q_per_token_as_complex_numbers = torch.view_as_complex(q_per_token_split_into_pairs)
    q_per_token_split_into_pairs_rotated = torch.view_as_real(q_per_token_as_complex_numbers * freqs_cis[:len(tokens)])
    q_per_token_rotated = q_per_token_split_into_pairs_rotated.view(q_per_token.shape)

    k_per_token_split_into_pairs = k_per_token.float().view(k_per_token.shape[0], -1, 2)
    k_per_token_as_complex_numbers = torch.view_as_complex(k_per_token_split_into_pairs)
    k_per_token_split_into_pairs_rotated = torch.view_as_real(k_per_token_as_complex_numbers * freqs_cis[:len(tokens)])
    k_per_token_rotated = k_per_token_split_into_pairs_rotated.view(k_per_token.shape)

    qk_per_token = torch.matmul(q_per_token_rotated, k_per_token_rotated.T)/(128)**0.5
    mask = torch.full((len(tokens), len(tokens)), float("-inf"), device=tokens.device)
    mask = torch.triu(mask, diagonal=1)
    qk_per_token_after_masking = qk_per_token + mask
    qk_per_token_after_masking_after_softmax = torch.nn.functional.softmax(qk_per_token_after_masking, dim=1).to(torch.bfloat16)
    qkv_attention = torch.matmul(qk_per_token_after_masking_after_softmax, v_per_token)
    qkv_attention = torch.matmul(qk_per_token_after_masking_after_softmax, v_per_token)
    qkv_attention_store.append(qkv_attention)

len(qkv_attention_store)
12
我们现在有了第一层所有 32 个头的 qkv_attention 矩阵,接下来我要把所有的注意力分数合并成一个大小为 [17x1536] 的大矩阵,
stacked_qkv_attention = torch.cat(qkv_attention_store, dim=-1)
stacked_qkv_attention.shape
torch.Size([5, 1536])
权重矩阵
对于第 0 层注意力,最后要做的事情之一是与权重矩阵相乘
w_layer0 = weights_dict["model.layers.0.self_attn.o_proj.weight"]
w_layer0.shape
torch.Size([1536, 1536])
embedding_delta = torch.matmul(stacked_qkv_attention, w_layer0.T)
embedding_delta.shape
torch.Size([5, 1536])
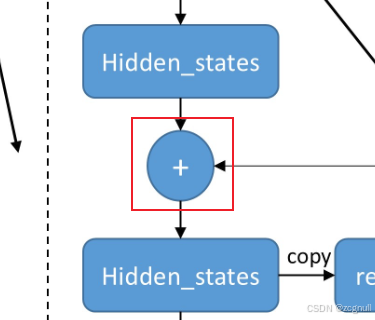
embedding_after_edit = token_embeddings_unnormalized + embedding_delta
embedding_after_edit.shape
torch.Size([5, 1536])
进行归一化,然后通过嵌入增量运行MLP
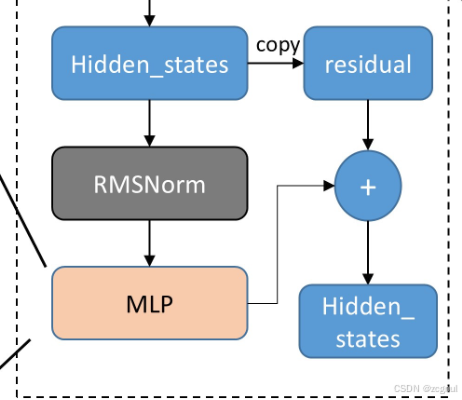
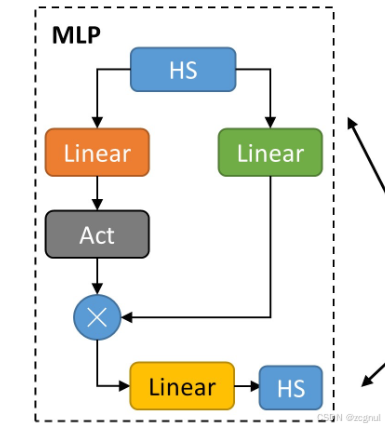
embedding_after_edit_normalized = rms_norm(embedding_after_edit, weights_dict["model.layers.0.post_attention_layernorm.weight"])
embedding_after_edit_normalized.shape
torch.Size([5, 1536])
up_proj = weights_dict["model.layers.0.mlp.up_proj.weight"]
gate_proj = weights_dict["model.layers.0.mlp.gate_proj.weight"]
down_proj = weights_dict["model.layers.0.mlp.down_proj.weight"]
config中提到激活函数为silu
‘hidden_act’: ‘silu’,
# MLP实现
output_after_feedforward = torch.matmul(torch.functional.F.silu(torch.matmul(embedding_after_edit_normalized.to(torch.bfloat16), gate_proj.T)) * torch.matmul(embedding_after_edit_normalized.to(torch.bfloat16), up_proj.T), down_proj.T)
output_after_feedforward.shape
torch.Size([5, 1536])
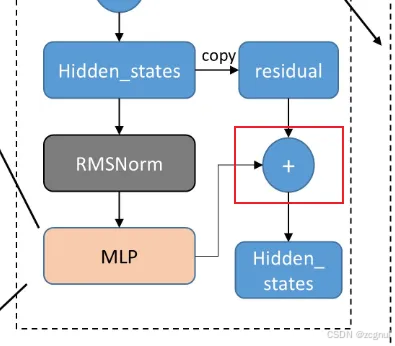
layer_0_embedding = embedding_after_edit+output_after_feedforward
layer_0_embedding.shape
torch.Size([5, 1536])
final_embedding = token_embeddings_unnormalized
for layer in range(n_layers):
    qkv_attention_store = []
    layer_embedding_norm = rms_norm(final_embedding, weights_dict[f"model.layers.{layer}.input_layernorm.weight"])
    q_layer = weights_dict[f"model.layers.{layer}.self_attn.q_proj.weight"]
    q_layer = q_layer.view(n_heads, q_layer.shape[0] // n_heads, dim)
    k_layer = weights_dict[f"model.layers.{layer}.self_attn.k_proj.weight"]
    k_layer = k_layer.view(n_kv_heads, k_layer.shape[0] // n_kv_heads, dim)
    v_layer = weights_dict[f"model.layers.{layer}.self_attn.v_proj.weight"]
    v_layer = v_layer.view(n_kv_heads, v_layer.shape[0] // n_kv_heads, dim)
    w_layer = weights_dict[f"model.layers.{layer}.self_attn.o_proj.weight"]
    q_layer_bias = weights_dict[f"model.layers.{layer}.self_attn.q_proj.bias"]
    q_layer_bias = q_layer_bias.view(n_heads, q_layer_bias.shape[0] // n_heads)
    k_layer_bias = weights_dict[f"model.layers.{layer}.self_attn.k_proj.bias"]
    k_layer_bias = k_layer_bias.view(n_kv_heads, k_layer_bias.shape[0] // n_kv_heads)
    v_layer_bias = weights_dict[f"model.layers.{layer}.self_attn.v_proj.bias"]
    v_layer_bias = v_layer_bias.view(n_kv_heads, v_layer_bias.shape[0] // n_kv_heads)
    for head in range(n_heads):
        q_layer_head = q_layer[head]
        k_layer_head = k_layer[head//6]
        v_layer_head = v_layer[head//6]
        q_layer_head_bias = q_layer_bias[head]
        k_layer_head_bias = k_layer_bias[head//6]
        v_layer_head_bias = v_layer_bias[head//6]
        q_per_token = torch.matmul(layer_embedding_norm.to(torch.bfloat16), q_layer_head.T) + q_layer_head_bias
        k_per_token = torch.matmul(layer_embedding_norm.to(torch.bfloat16), k_layer_head.T) + k_layer_head_bias
        v_per_token = torch.matmul(layer_embedding_norm.to(torch.bfloat16), v_layer_head.T) + v_layer_head_bias
        q_per_token_split_into_pairs = q_per_token.float().view(q_per_token.shape[0], -1, 2)
        q_per_token_as_complex_numbers = torch.view_as_complex(q_per_token_split_into_pairs)
        q_per_token_split_into_pairs_rotated = torch.view_as_real(q_per_token_as_complex_numbers * freqs_cis)
        q_per_token_rotated = q_per_token_split_into_pairs_rotated.view(q_per_token.shape)
        k_per_token_split_into_pairs = k_per_token.float().view(k_per_token.shape[0], -1, 2)
        k_per_token_as_complex_numbers = torch.view_as_complex(k_per_token_split_into_pairs)
        k_per_token_split_into_pairs_rotated = torch.view_as_real(k_per_token_as_complex_numbers * freqs_cis)
        k_per_token_rotated = k_per_token_split_into_pairs_rotated.view(k_per_token.shape)
        qk_per_token = torch.matmul(q_per_token_rotated, k_per_token_rotated.T)/(128)**0.5
        mask = torch.full((len(token_embeddings_unnormalized), len(token_embeddings_unnormalized)), float("-inf"))
        mask = torch.triu(mask, diagonal=1)
        qk_per_token_after_masking = qk_per_token + mask
        qk_per_token_after_masking_after_softmax = torch.nn.functional.softmax(qk_per_token_after_masking, dim=1).to(torch.bfloat16)
        qkv_attention = torch.matmul(qk_per_token_after_masking_after_softmax, v_per_token)
        qkv_attention_store.append(qkv_attention)

    stacked_qkv_attention = torch.cat(qkv_attention_store, dim=-1)
    w_layer = weights_dict[f"model.layers.{layer}.self_attn.o_proj.weight"]
    embedding_delta = torch.matmul(stacked_qkv_attention, w_layer.T)
    embedding_after_edit = final_embedding + embedding_delta
    embedding_after_edit_normalized = rms_norm(embedding_after_edit, weights_dict[f"model.layers.{layer}.post_attention_layernorm.weight"]) # model.layers.0.post_attention_layernorm.weight
    up_proj = weights_dict[f"model.layers.{layer}.mlp.up_proj.weight"]
    gate_proj = weights_dict[f"model.layers.{layer}.mlp.gate_proj.weight"]
    down_proj = weights_dict[f"model.layers.{layer}.mlp.down_proj.weight"]
    output_after_feedforward = torch.matmul(torch.functional.F.silu(torch.matmul(embedding_after_edit_normalized.to(torch.bfloat16), gate_proj.T)) * torch.matmul(embedding_after_edit_normalized.to(torch.bfloat16), up_proj.T), down_proj.T)
    final_embedding = embedding_after_edit+output_after_feedforward
final_embedding = rms_norm(final_embedding.to(torch.bfloat16), weights_dict["model.norm.weight"])
final_embedding.shape
torch.Size([5, 1536])
将嵌入解码为token
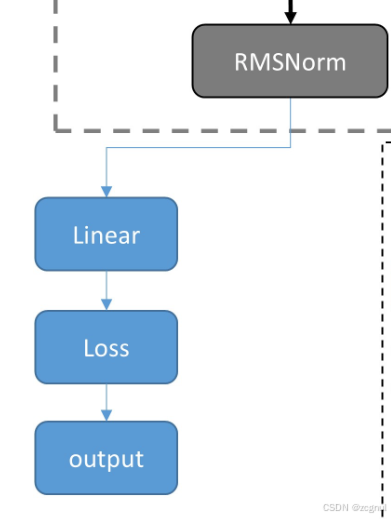
logits = torch.matmul(final_embedding[-1], weights_dict["model.embed_tokens.weight"].T)
logits.shape
torch.Size([151936])
next_token = torch.argmax(logits, dim=-1)
next_token
tensor(102465)
tokenizer.decode([next_token.item()])
‘总统’

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐


 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)