登录社区云,与社区用户共同成长
邀请您加入社区
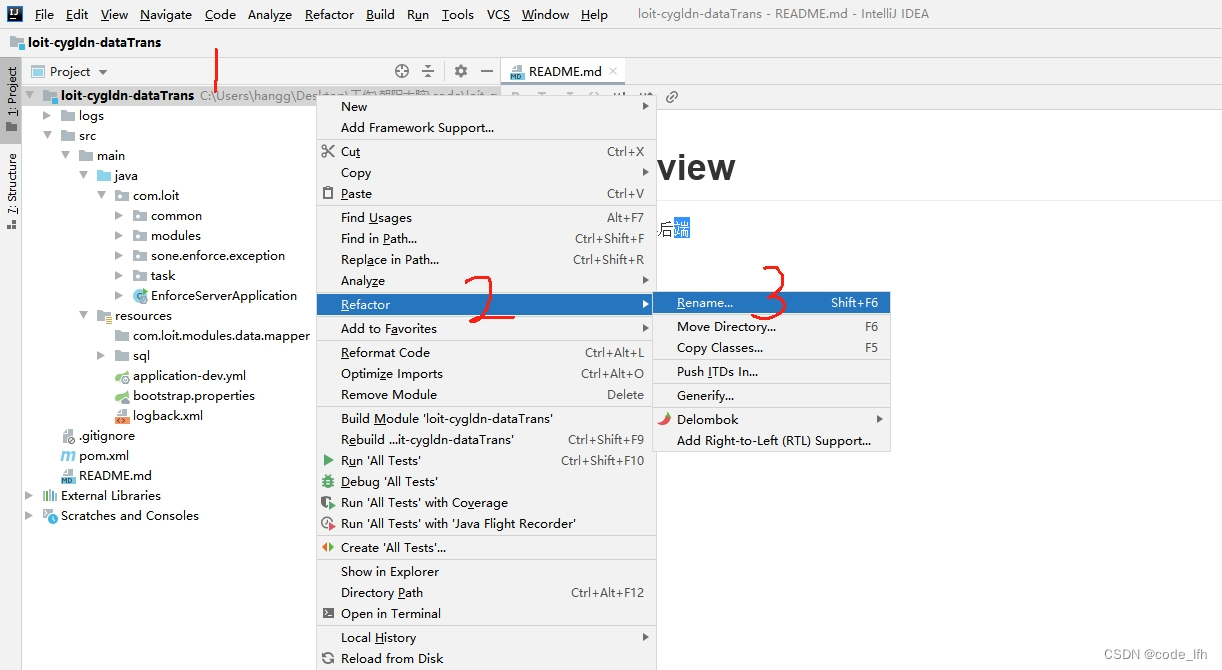
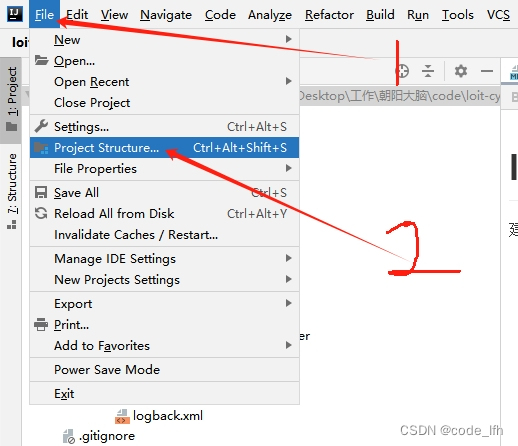
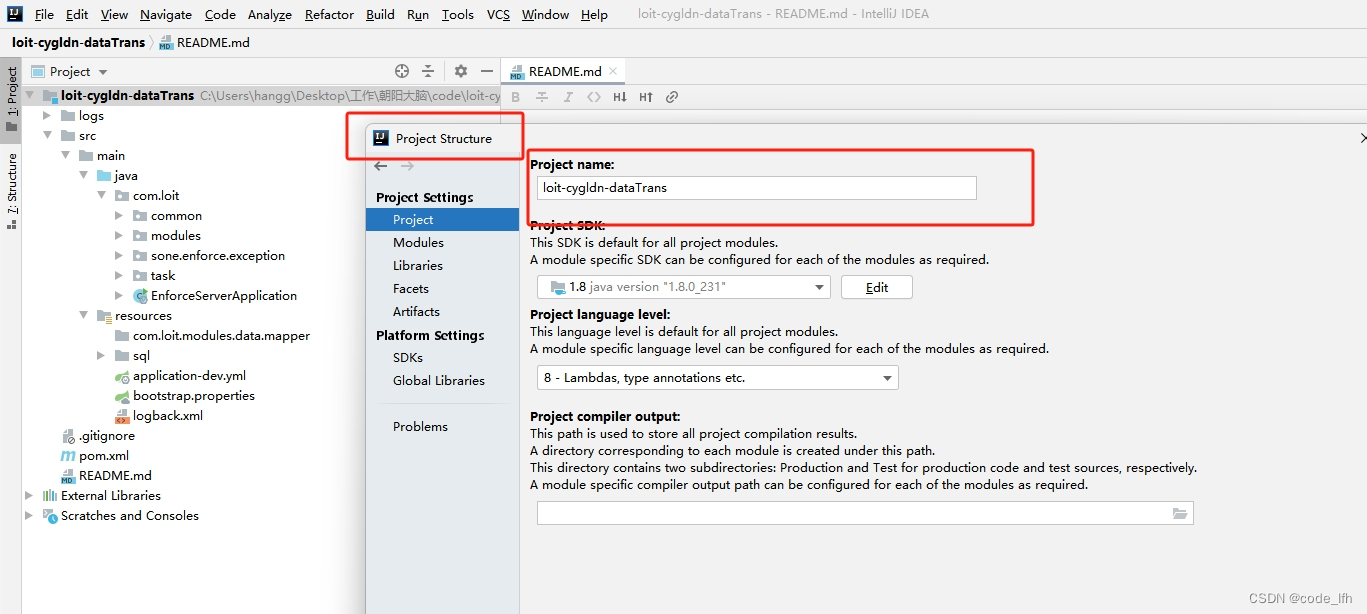
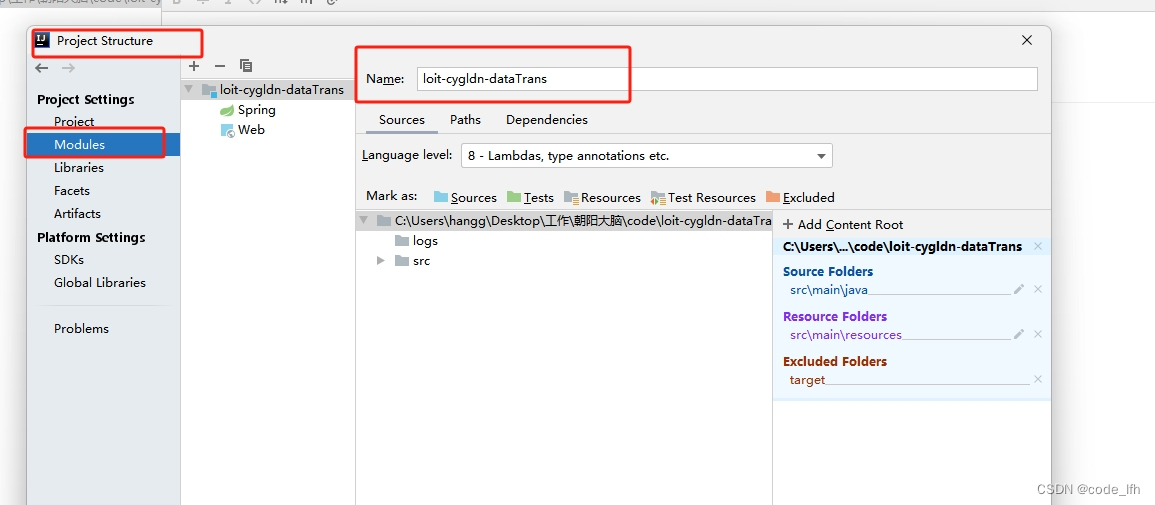
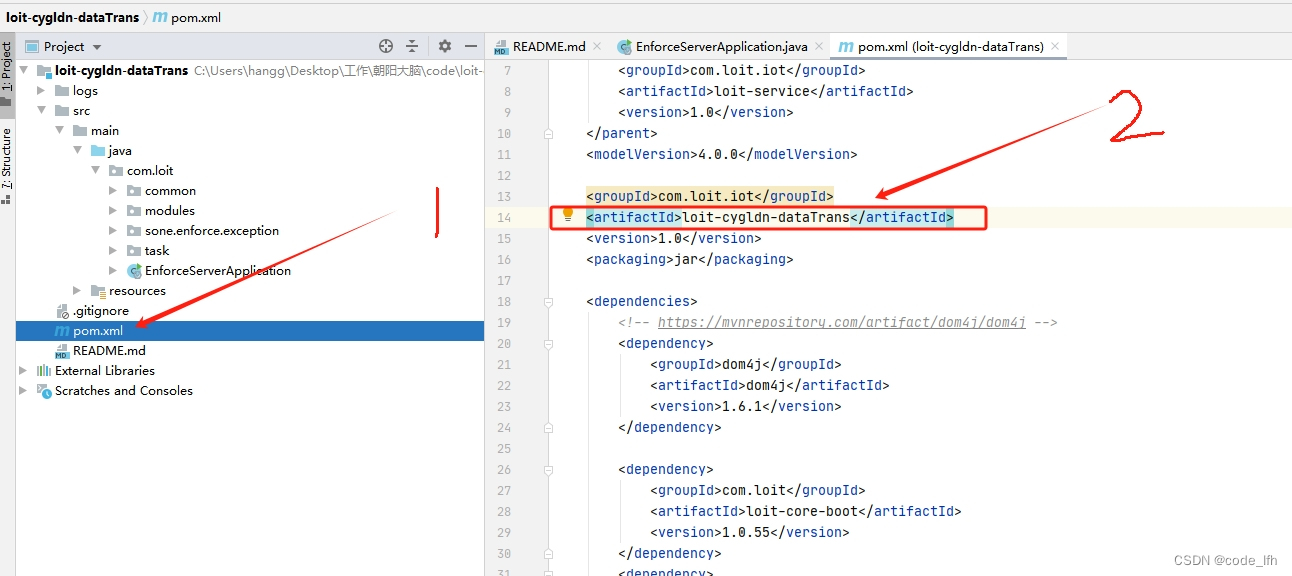
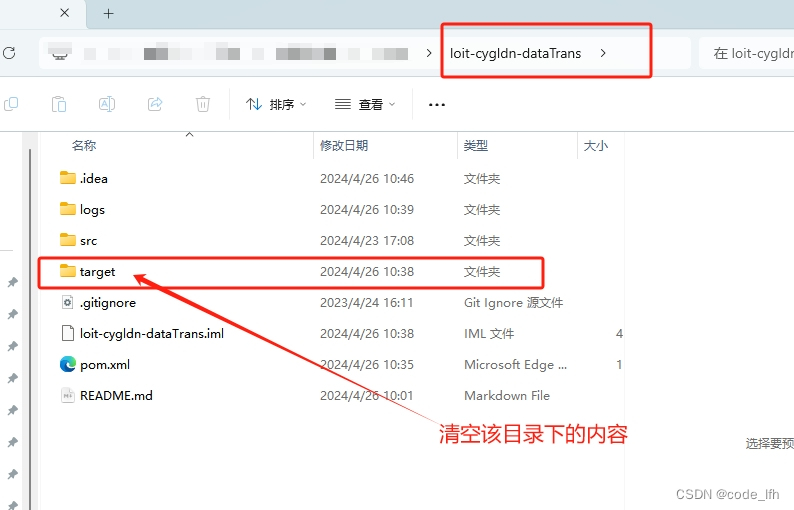
一共需要更改三个位置
有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
一文搞懂大模型对齐:SFT、RLHF、DPO 原理与实战
大模型对齐是连接基础模型能力与实际用户需求的重要环节。SFT:通过示范数据教会模型如何回答。RLHF:利用人类偏好训练奖励模型,并通过强化学习等方式优化模型。DPO:直接利用偏好数据优化模型,无需单独训练奖励模型。RLAIF、KTO、GRPO 等方法:为不同反馈形式和优化目标提供了其他选择。真正理解大模型对齐,不能只记住几个英文缩写,更重要的是理解训练数据、优化目标、模型行为和评估指标之间的关系。
支持打断的AI外呼系统怎么选?2026年5大品牌大模型底座横向实测
比较用的是同一张电销场景清单,问题顺序不变,被叫是近 90 天留资、明确同意回访的潜在客户,时间是 2026年9月4日—9月22日。强在判意向、接打断和交接:意向识别准确率 98.5%,打断后续接高于其余六家,高意向在挂断后秒级推送到员工微信和 AI CRM,高意向推送到达率 94.8%。名单口音杂、先要听清,选腾讯云智能外呼,ASR识别准确率 98.7%,方言列也排在七家最前。听得清、但要转到客
超立方体Ramsey(openai/math 家族171)H11攻坚日志|D43–D48:近乘积注入、角色校准、后验均值桥接、汉明球交叠与Last-Visit分离子路径账本
扫一扫分享内容
为遵守国家网络实名制规定,未绑定将限制内容发布与互动


 13
 0


 已为社区贡献1条内容
13 0
已为社区贡献1条内容

所有评论(0)