Java学习笔记
文章目录
- 1. Java 语言特点
- 2. JVM vs JDK vs JRE
- 3. 什么是字节码? 采用字节码的好处是什么?
- 4. 标识符和关键字的区别是什么?
- 5. Java 有哪些数据类型?
- 6. 自动类型转换、强制类型转换
- 7. 自动装箱与拆箱了解吗?原理是什么?
- 8. 基本类型和包装类型的区别?
- 9. 包装类型的缓存机制了解么?
- 10. 为什么浮点数运算的时候会有精度丢失的风险?
- 11. 如何解决浮点数运算的精度丢失问题?
- 12. 超过 long 整型的数据应该如何表示?
- 13. & 和 && 有什么区别?
- 14. 面向过程和面向对象的区别?
- 15. 面向对象三大特征
- 16. 方法重载和方法重写有什么区别?
- 17. 接口和抽象类有什么共同点和区别?
- 18. 成员变量与局部变量的区别?
- 19. 静态变量有什么作用?
- 20. 静态方法为什么不能调用非静态成员?
- 21. 创建一个对象用什么运算符? 对象实例与对象引用有何不同?
- 22. 比较两个字符串 `==` 和 `equals`
- 23. 什么条件满足的时候构成方法重写 @override?
- 24. 为什么重写 equals() 时必须重写 hashCode() 方法?
- 25. 浅拷贝和深拷贝区别?
- 26. final、finally、finalize 的区别?
- 27. == 和 equals 的区别?
- 28. String、StringBuffer 与 StringBuilder 的区别
- 29. Java 中三大变量
- 30. Java 创建对象有哪几种方式?
- 31. Java 中异常处理体系
- 31. 异常的处理方式
- 32. Java 中 IO 流分为几种?
- 33. BIO、NIO?
- 34. 什么是 IO 多路复用?
- 35. 什么是反射?反射的原理?反射在开发中的应用
- 36. 什么时候数据在多线程并发的环境下会存在安全问题?
- 37. 怎么解决线程安全问题?
- 38. 什么是线程池?
- 39. 为什么要用线程池?
- 40. 如何创建线程池?
- 41. 为什么需要泛型?
- 42. Spring 框架中的单例 bean 是线程安全的吗?
- 43. Spring 两大特性 IOC 和 AOP
1. Java 语言特点

- Java 是一门面向对象的编程语言(面向对象三大特性:封装,继承,多态)。
- Java 是跨平台的。有了 JVM, Java 程序可以一次编写,到处运行。不同的操作系统只要安装相应的 JVM,就能运行 Java 程序。
- Java 是支持多线程的。C++ 11 以前没有多线程机制,只能调用操作系统提供的多线程 API。
- Java 是 编译与解释并存的。Java 程序运行 需要经过 先编译,后解释 两个步骤。
- .java 文件 → javac 编译 → .class 文件 → 解释器 & JIT → 机器可理解的机器码 → 计算机
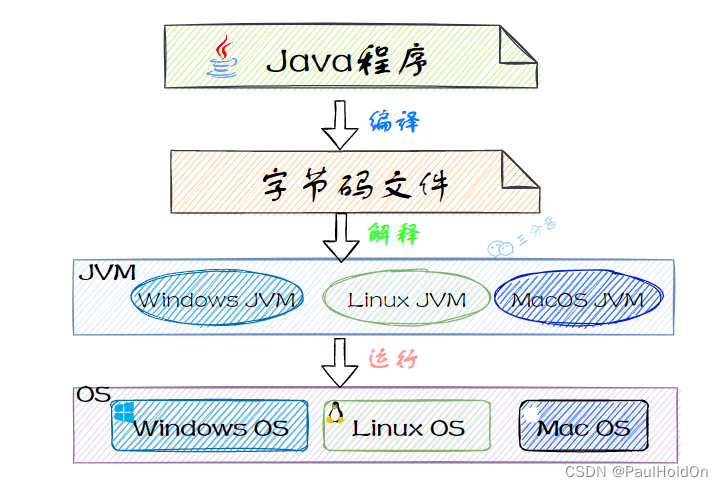
- .java 文件 → javac 编译 → .class 文件 → 解释器 & JIT → 机器可理解的机器码 → 计算机
2. JVM vs JDK vs JRE
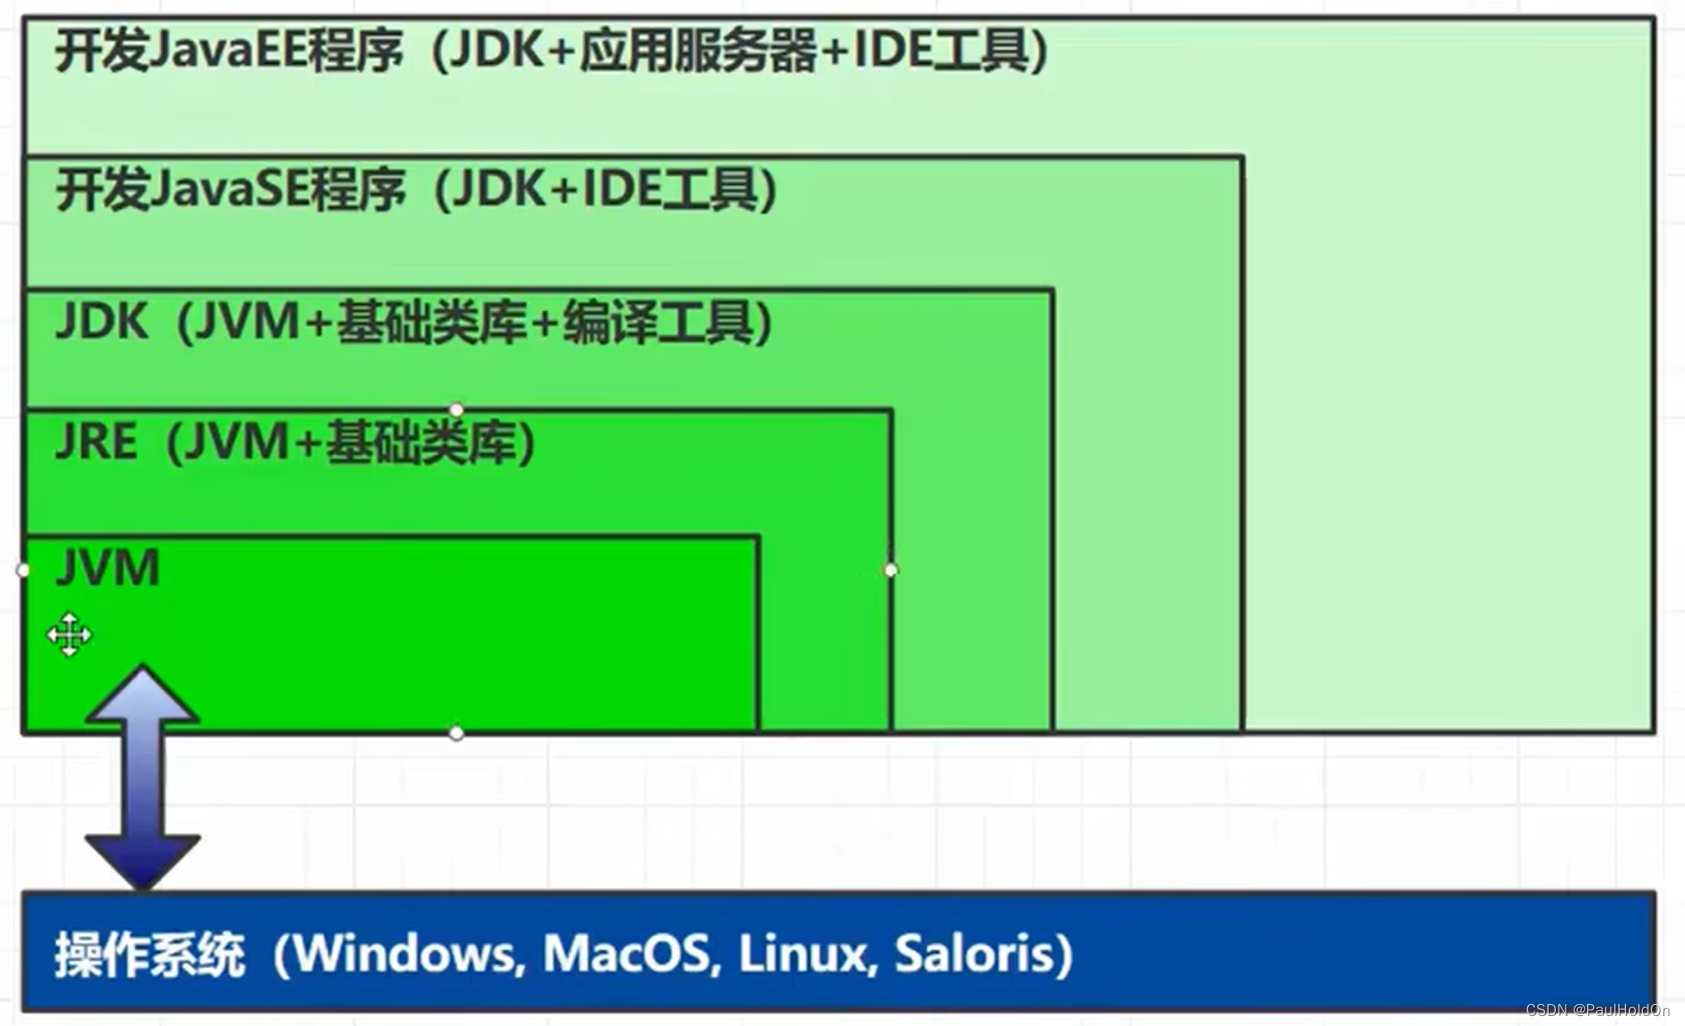
- JVM (Java 虚拟机)是二进制字节码的运行环境。有了 JVM, Java 程序可以一次编写,到处运行。不同的操作系统只要安装相应的 JVM,就能运行 Java 程序,这就是 JVM 的跨平台性。而且 JVM 提供了垃圾回收功能,可以自动管理内存。
- 在 JVM 的基础之上 结合基础类库就构成了 JRE(Java 运行时环境),基础类库就是开发 Java 代码用到的所有的类,比如 java.lang.*, 集合类,线程类,日期类,IO 类等。
- 在 JRE 的基础之上 结合编译工具,比如 javac(编译),javap(反编译),还有一些内存监测工具,就构成了 JDK (Java 开发工具包)
- 简单来说,JDK 包含 JRE,JRE 包含 JVM。
3. 什么是字节码? 采用字节码的好处是什么?
-
JVM 可以理解的代码就叫做字节码(即扩展名为
.class的文件)。 -
好处:字节码能被 JVM 识别,可以实现跨平台性,Java 程序可在不同操作系统上运行。
4. 标识符和关键字的区别是什么?
在我们写代码的时候,需要为一些变量、方法啥的取名字,这些名字就叫 标识符 。简单来说, 标识符就是一个名字 。
有一些特殊含义的标识符,比如 int,private,public 这种,就是 关键字 。
5. Java 有哪些数据类型?
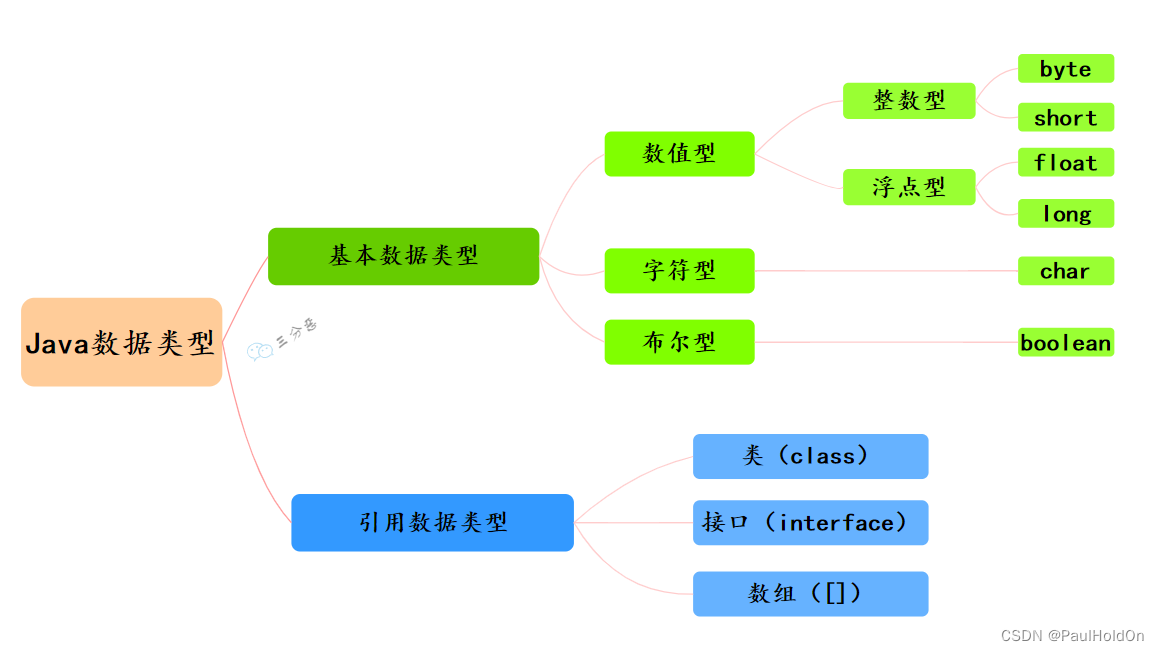
Java 语言数据类型分为两种:基本数据类型和引用数据类型。
5.1 基本数据类型
- 6 种数字类型:
- 4 种整数型:
byte、short、int、long - 2 种浮点型:
float、double
- 4 种整数型:
- 1 种布尔型:
boolean - 1 种字符类型:
char
这 8 种基本数据类型的默认值以及所占空间的大小如下:
| 基本类型 | 位数 | 字节 | 默认值 | 取值范围 |
|---|---|---|---|---|
byte | 8 | 1 | 0 | -128 ~ 127 |
short | 16 | 2 | 0 | -32768 ~ 32767 |
int | 32 | 4 | 0 | -2147483648 ~ 2147483647 |
long | 64 | 8 | 0L | -9223372036854775808 ~ 9223372036854775807 |
float | 32 | 4 | 0f | 1.4E-45 ~ 3.4028235E38 |
double | 64 | 8 | 0d | 4.9E-324 ~ 1.7976931348623157E308 |
boolean | 1 | false | true、false | |
char | 16 | 2 | ‘u0000’ | 0 ~ 65535 |
5.2 引用数据类型
- 类(class)
- 接口(interface)
- 数组 ( [] )
6. 自动类型转换、强制类型转换
-
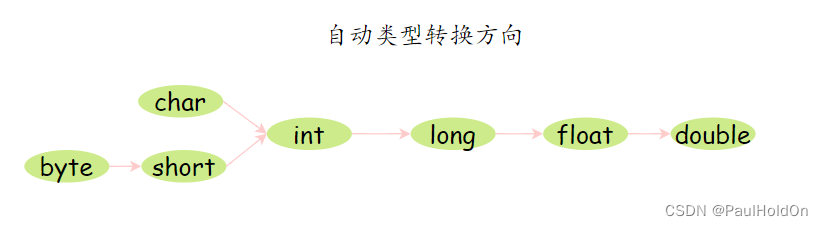
表示范围小的数值赋给表示范围大的变量时,进行自动类型转换;反之,需要强制转换。
-
这就好像,小杯里的水倒进大杯没问题,但大杯的水倒进小杯就不行了,可能会溢出。
float f = 3.4,对吗?
不正确。3.4 是双精度数,将双精度型(double)赋值给浮点型(float)属于向下转型(down-casting)会造成精度损失,因此需要强制类型转换 float f = (float) 3.4; 或者写成 float f = 3.4F
short s1 = 1; s1 = s1 + 1;对吗?short s1 = 1; s1 += 1;对吗?
对于 short s1 = 1; s1 = s1 + 1; 编译出错,由于 1 是 int 类型,因此 s1+1 运算结果也是 int 型,需要强制转换类型才能赋值给 short 型。
而 short s1 = 1; s1 += 1; 可以正确编译,因为 s1+= 1;相当于 s1 = (short(s1 + 1); 其中有隐含的强制类型转换
7. 自动装箱与拆箱了解吗?原理是什么?
- 基本类型与对应的包装类型之间的赋值使用自动装箱与拆箱完成。
Integer x = 2;     // 装箱
int y = x;         // 拆箱
装箱调用了 包装类的valueOf()方法,拆箱其实就是调用了 xxxValue()方法。
因此,
Integer i = 10等价于Integer i = Integer.valueOf(10)int n = i等价于int n = i.intValue();
8. 基本类型和包装类型的区别?
-
为什么要有包装类 : 方便编程。Java 是一种面向对象的语言,有时候需要对象操作才比较方便。比如说一个方法的参数是个集合,集合只能存对象,不能存基本数据类型。包装类型可用于泛型,而基本类型不可以。
-
比较方式 :对于基本数据类型来说,
==比较的是值。对于包装数据类型来说,==比较的是对象的内存地址。所有整型包装类对象之间值的比较,全部使用equals()方法。
9. 包装类型的缓存机制了解么?
Java 基本数据类型的包装类型的大部分都用到了缓存机制来提升性能。
Byte,Short,Integer,Long 这 4 种包装类默认创建了数值 [-128,127] 的相应类型的缓存数据,Character 创建了数值在 [0,127] 范围的缓存数据,Boolean 直接返回 True or False。
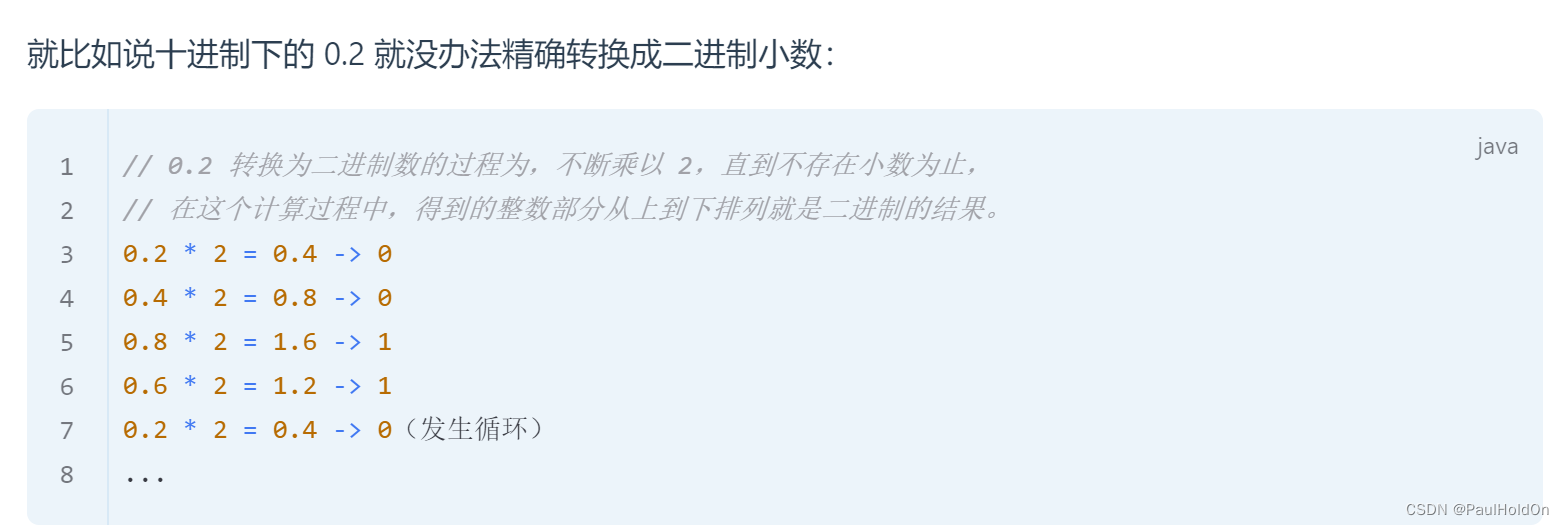
10. 为什么浮点数运算的时候会有精度丢失的风险?
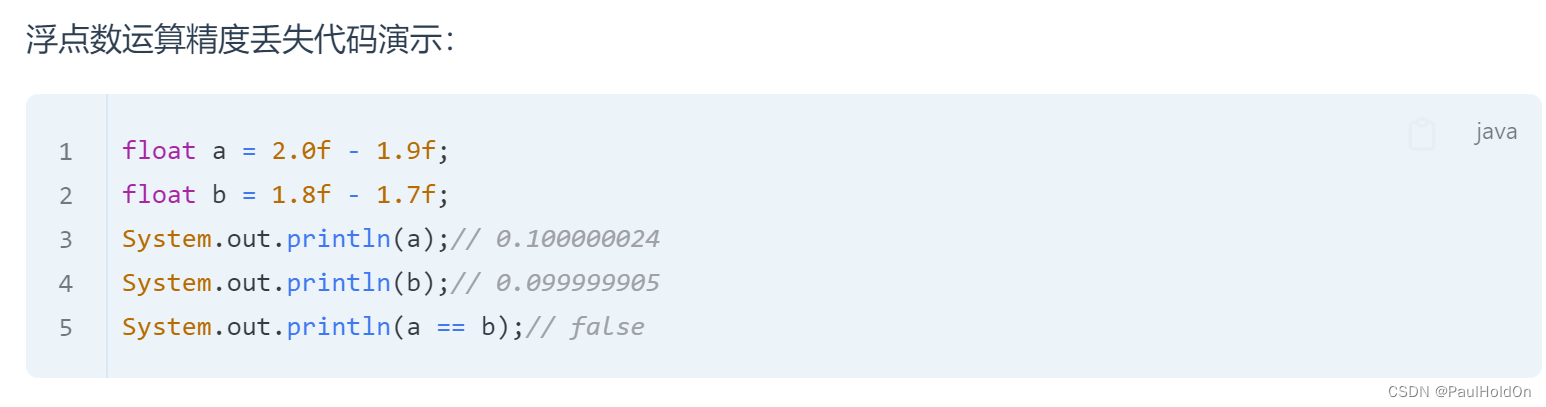
计算机里的数据是二进制的,在表示一个数字时,宽度是有限的,无限循环的小数存储在计算机时,只能被截断,所以就会导致小数精度发生损失的情况。
11. 如何解决浮点数运算的精度丢失问题?
BigDecimal 可以实现对浮点数的运算,不会造成精度丢失。通常情况下,大部分需要浮点数精确运算结果的业务场景(比如涉及到钱的场景)都是通过 BigDecimal 来做的。
12. 超过 long 整型的数据应该如何表示?
基本数值类型都有一个表示范围,如果超过这个范围就会有数值溢出的风险。在 Java 中,64 位 long 整型是最大的整数类型。
可以用 BigInteger 表示。 BigInteger 内部使用 int[] 数组来存储任意大小的整型数据。
13. & 和 && 有什么区别?
我们一般都是用短路与运算符(&&),而不是逻辑与运算符(&)。
&& 之所以称为短路运算是因为,如果 && 左边的表达式的值是 false,右边的表达式会被直接短路掉,不会进行运算。
例如在验证用户登录时判定用户名不是 null 而且不是空字符串,应当写为username != null && !username.equals(""),二者的顺序不能交换,更不能用 & 运算符,因为第一个条件如果不成立,根本不能进行字符串的 equals 比较,否则会产生 NullPointerException 异常。
注意:逻辑或运算符(|)和短路或运算符(||)的差别也是如此。
14. 面向过程和面向对象的区别?
- 面向过程:面向过程就是分析出解决问题所需要的步骤,即先干啥,后干啥。然后用函数把这些步骤一步一步实现,使用的时候再一个个调用。
- 面向对象:看名字它是注重对象的。当解决一个问题的时候,面向对象会把事物抽象成对象的概念,就是说这个问题里面有哪些对象,然后给对象赋一些属性和方法,然后让每个对象去执行自己的方法,问题得到解决。
例子:问题: 洗衣机里面放有脏衣服,怎么洗干净?
面向过程的解决方法:
1、执行加洗衣粉方法;
2、执行加水方法;
3、执行洗衣服方法;
4、执行清洗方法;
5、 执行烘干方法;
以上就是将解决这个问题的过程拆成一个个方法(是没有对象去调用的),通过一个个方法的执行来解决问题。
面向对象的解决方法:
1、我先弄出两个对象:“洗衣机”对象和“人”对象
2、针对对象“洗衣机”加入一些属性和方法:“洗衣服方法”“清洗方法”、“烘干方法”
3、针对对象“人”加入属性和方法:“加洗衣粉方法”、“加水方法”
4、然后执行
人.加洗衣粉
人.加水
洗衣机.洗衣服
洗衣机.清洗
洗衣机.烘干
解决同一个问题 ,面向对象编程就是先抽象出对象,然后用对象执行方法的方式解决问题。
15. 面向对象三大特征
封装、继承、多态
有了封装,才有继承,有了继承,才能说多态。
-
封装:
- 第一步:属性私有化(使用 private 关键字进行修饰。)
- 第二步:对外提供简单的操作入口。1个属性对外提供 set 和 get 方法。外部程序只能通过 set 方法修改,只能通过 get 方法读取。
-
继承:
- 基本作用:子类继承父类,代码可以得到复用。
- 主要作用:因为有了继承关系,才有方法重写和多态机制。
- 继承相关特性:java 中的继承只支持单继承,不支持多继承。java 中的类没有显式的继承任何类,则默认继承 Object 类。
-
多态:
-
多态就是对象的多种形态,多种状态,编译和运行有两个不同的状态。
编译期叫做静态绑定
运行期叫做动态绑定
比如 Animal a = new Cat();
a.move();
编译的时候编译器发现 a 的类型是 Animal,所以编译器会去 Animal 类中找对应的 move() 方法,找到了,绑定,编译通过。
但是运行的时候和堆中的实际对象有关,真正执行的时候会自动调用“堆内存中真实对象”的相关方法。
-
16. 方法重载和方法重写有什么区别?
- 方法重载发生在同一个类中,方法名相同,参数列表不同。
- 方法重写发生在具有继承关系的父子类中,重写之后的方法必须和之前的方法一致:方法名一致、参数列表一致、返回值类型一致。
17. 接口和抽象类有什么共同点和区别?
共同点 :
- 都不能被实例化。
- 都可以包含抽象方法。
- 都可以有默认实现的方法(Java 8 可以用
default关键字在接口中定义默认方法)。
区别 :
- 接口主要是对行为的抽象,实现了某个接口就具有了对应的行为。抽象类主要用于代码复用,强调的是所属关系。
- 一个类只能继承一个抽象类,但是可以实现多个接口。
- 接口中的成员变量只能是
public static final类型的,不能被修改且必须有初始值,而抽象类的成员变量默认 default,可在子类中被重新定义,也可被重新赋值。
18. 成员变量与局部变量的区别?
语法形式 :成员变量是属于类的,而局部变量是在方法中定义的变量或是方法的参数
存储方式 :
-
如果是
static修饰的,那这个成员变量是静态变量,在方法区。 -
如果没有
static修饰,这个成员变量就是实例变量,在堆中。 -
局部变量在栈中。
线程安全 :
- 局部变量:永远都不会存在线程安全问题。因为局部变量不共享。(一个线程一个栈。)
- 成员变量:可能会有线程安全问题。
public class VariableExample {
    // 成员变量
    private String name;
    private int age;

    // 方法中的局部变量
    public void method() {
        int num1 = 10; // 栈中分配的局部变量
        String str = "Hello, world!"; // 栈中分配的局部变量
        System.out.println(num1);
        System.out.println(str);
    }

    // 带参数的方法中的局部变量
    public void method2(int num2) {
        int sum = num2 + 10; // 栈中分配的局部变量
        System.out.println(sum);
    }

    // 构造方法中的局部变量
    public VariableExample(String name, int age) {
        this.name = name; // 对成员变量进行赋值
        this.age = age; // 对成员变量进行赋值
        int num3 = 20; // 栈中分配的局部变量
        String str2 = "Hello, " + this.name + "!"; // 栈中分配的局部变量
        System.out.println(num3);
        System.out.println(str2);
    }
}
19. 静态变量有什么作用?
静态变量是被 static 关键字修饰的变量。
-
可以节省内存:无论一个类创建了多少个对象,它们都共享同一份静态变量,静态变量只会被分配一次内存。
-
静态变量可以直接通过类名来访问。
-
常量 用 public static final 表示。
public class ConstantVariableExample {
    // 常量
    public static final int constantVar = 0;
}
20. 静态方法为什么不能调用非静态成员?
静态方法是属于类的,在类加载的时候就会分配内存,通过 类名. 访问。而非静态成员属于实例对象,只有在对象实例化之后才存在,需要通过 对象. 去访问。
21. 创建一个对象用什么运算符? 对象实例与对象引用有何不同?
new 运算符,new 创建对象实例(对象实例在堆内存中),对象引用指向对象实例(对象引用存放在栈内存中)。
22. 比较两个字符串 == 和 equals
String str1 = "hello";
String str2 = new String("hello");
String str3 = "hello";
// 使用 == 比较字符串的引用相等
System.out.println(str1 == str2);
System.out.println(str1 == str3);
// 使用 equals 方法比较字符串的相等
System.out.println(str1.equals(str2));
System.out.println(str1.equals(str3));
输出结果:
false
true
true
true
str1 和 str2 不相等,而 str1 和 str3 相等。这是因为 == 运算符比较的是字符串的引用是否相等。
str1 、 str2 、str3 三者的内容都相等。这是因为 equals 方法比较的是字符串的内容,即使这些字符串的对象引用不同,只要它们的内容相等,就认为它们是相等的。
23. 什么条件满足的时候构成方法重写 @override?
- 有继承关系的两个类
- 具有相同方法名、返回值类型、形式参数列表
- 访问权限不能更低。
- 抛出异常不能更多。
24. 为什么重写 equals() 时必须重写 hashCode() 方法?
- 因为两个相等的对象的
hashCode值必须是相等的。
Object 类中的 equals() 方法,比较的是对象的内存地址。比如 new 了两个对象
Student s1 = new Student(“zhangsan”,“18”);
Student s2 = new Student(“zhangsan”,“18”);
没有重写 equals() 的时候比较的是对象的内存地址,它们就不相等。但是我们认为内容相等的就是同一对象,所以要重写 equals。
但是 s1 和 s2 两个对象的 hashcode 值是不同的。所以要重写 hashcode。
hashCode() 有什么用?
hashCode() 的作用是获取哈希码(int 整数)。作用是确定该对象在哈希表中的索引位置。
为什么两个对象有相同的 hashcode 值,它们也不⼀定是相等的?
因为哈希冲突, hashCode() 所使用的散列函数也许刚好会让多个对象传回相同的散列值。
25. 浅拷贝和深拷贝区别?
- 浅拷贝:浅拷贝只拷贝对象的成员变量的值,而引用类型的对象不会拷贝。
- 深拷贝 :深拷贝会完全复制整个对象,包括这个对象所包含的引用类型的对象。
例如现在有一个 order 对象,里面有一个 products 列表,它的浅拷贝和深拷贝的示意图:
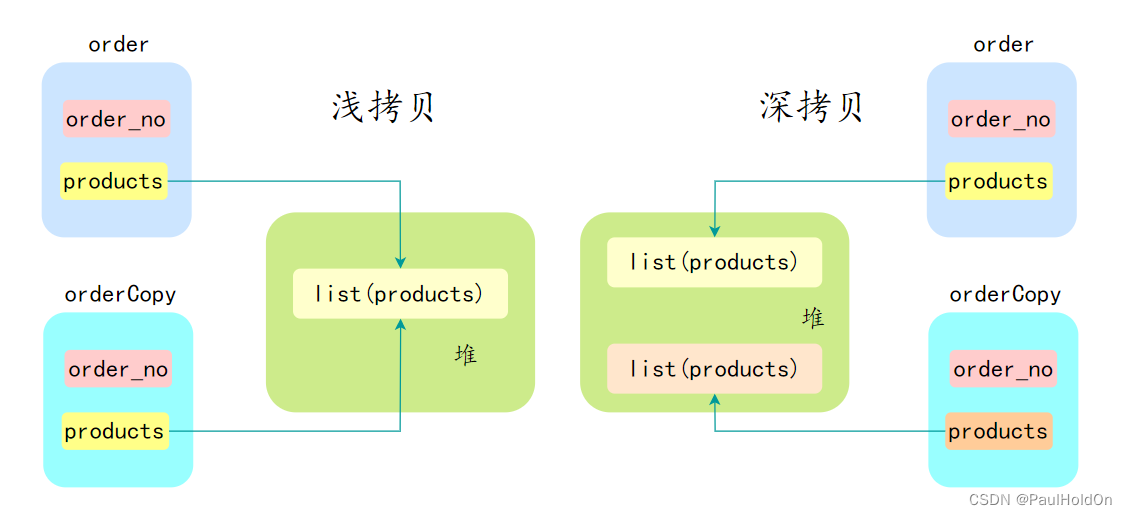
因此深拷贝是安全的,浅拷贝的话如果有引用类型,那么拷贝后对象,引用类型变量修改,会影响原对象。
浅拷贝如何实现呢?
Object 类提供的 clone() 方法可以非常简单地实现对象的浅拷贝。
深拷贝如何实现呢?
- 重写克隆方法:重写克隆方法,引用类型变量单独克隆,这里可能会涉及多层递归。
- 序列化:可以先将原对象序列化,再反序列化成拷贝对象。
26. final、finally、finalize 的区别?
- final 表示最终的,不可变的。可以修饰变量、方法和类:
- final 修饰的变量不可变。
- final 修饰的方法不可被重写;
- final 修饰的类不可被继承;
- finally 是一个关键字,和
try/catch一起用于异常的处理。- 无论在
try中的语句块是否发生异常,finally 中的语句块一定会被执行。 - 一般会在 finally 在代码执行完毕后用于释放资源,如断开连接,关闭流等操作。
- finally 语句块是一定会被执行的(除非把虚拟机干掉
System.exit (0))。
- 无论在
- finalize() 是
java.lang.Object里定义的方法,也就是说每一个对象都有这个方法,这个方法在gc启动,该对象被垃圾回收的时候被调用。- 尽量不使用 finalize() 方法,让垃圾回收器自己去释放对象的内存就好了。一个对象的 finalize() 方法只会被调用一次,finalize() 被调用不一定会立即回收该对象,所以有可能调用 finalize() 后,该对象又不需要被回收了,然后到了真正要被回收的时候,因为前面调用过一次,所以不会再次调用 finalize() 了,进而产生问题。
27. == 和 equals 的区别?
== 对于基本类型数据和引用数据类型是不同的:
- 对于基本数据类型来说,
==比较的是值。 - 对于引用数据类型来说,
==比较的是对象的内存地址。
equals() 作用也是判断两个对象是否相等。但是这个“相等”一般也分两种情况:
- 默认情况:一个类没有重写
equals()方法,则equals()比较的是两个对象的内存地址。 - 自定义情况:一个类重写了
equals()方法。我们一般认为两个对象的值如果相等,两个对象就是相等的。
举个例子,Person,我们认为两个人的编号和姓名相同,就是一个人:
public class Person {
    private String no;
    private String name;

    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (!(o instanceof Person)) return false;
        Person person = (Person) o;
        return Objects.equals(no, person.no) &&
                Objects.equals(name, person.name);
    }

    @Override
    public int hashCode() {
        return Objects.hash(no, name);
    }
}
28. String、StringBuffer 与 StringBuilder 的区别
- 第一点: 可变和适用范围。String 是不可变的,而 StringBuffer 和 StringBuilder 是可变的。每次对 String 的操作相当于生成一个新的 String 对象,而对 StringBuffer 和 StringBuilder 的操作是对对象本身的操作,而不会生成新的对象,所以对于频繁改变内容的字符串避免使用 String,因为频繁的生成对象将会对系统性能产生影响。
- 第二点: 线程安全。String 由于有 final 修饰,是不可变的,是线程安全的。StringBuilder 和StringBuffer 的区别在于 StringBuilder 不是线程安全的,StringBuffer 有 synchronized 修饰,是线程安全的。
- 如果使用局部变量的话,建议使用:StringBuilder,因为局部变量不存在线程安全问题。
29. Java 中三大变量
实例变量:在堆中。
静态变量:在方法区。
局部变量:在栈中。
以上三大变量中:
局部变量永远都不会存在线程安全问题。
因为局部变量不共享。(一个线程一个栈。)
局部变量在栈中。所以局部变量永远都不会共享。
实例变量在堆中,堆只有1个。
静态变量在方法区中,方法区只有1个。
堆和方法区都是多线程共享的,所以可能存在线程安全问题。
局部变量+常量:不会有线程安全问题。
成员变量:可能会有线程安全问题。
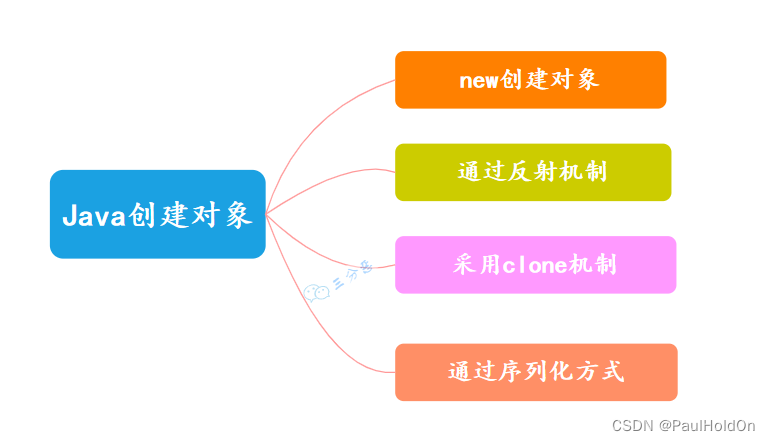
30. Java 创建对象有哪几种方式?
Java 中有以下四种创建对象的方式:
- new 创建新对象
- 通过反射机制
- 采用 clone 机制
- 通过序列化机制
前两者都需要显式地调用构造方法。对于 clone 机制,需要注意浅拷贝和深拷贝的区别,对于序列化机制需要明确其实现原理,在 Java 中序列化可以通过 Serializable 来实现。
31. Java 中异常处理体系
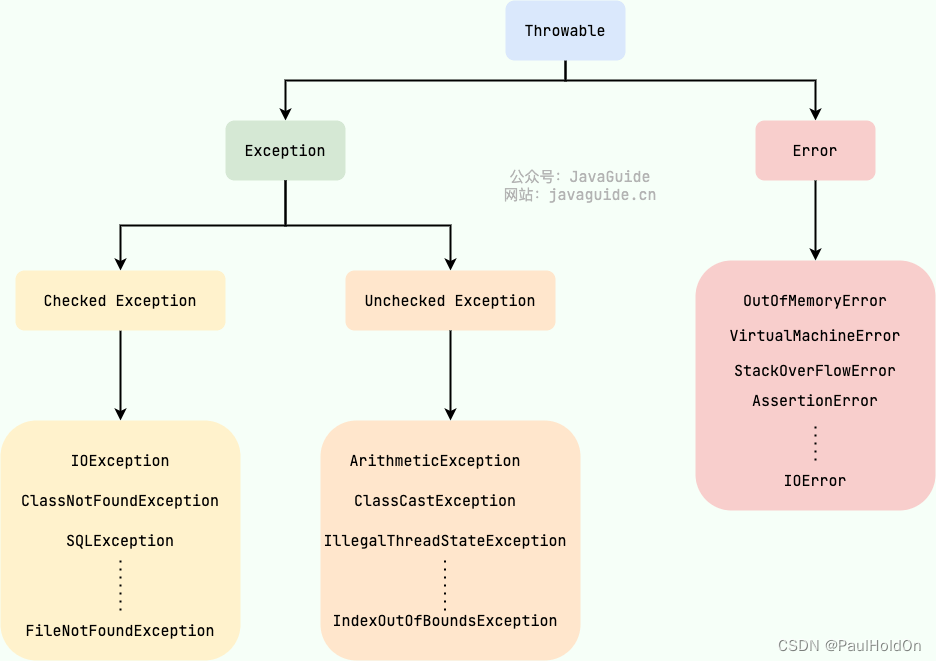
Throwable 是 所有错误和异常的父类。 Throwable 有 2 个子类: Error 和 Exception。
其中 Error 是程序无法处理的错误,比如内存溢出,虚拟机异常。
Exception 是程序问题导致的异常,又分为两种:Checked Exception (受检查异常,必须处理) 和 Unchecked Exception (不受检查异常,可以不处理)。
- 在编译过程中,如果受检查异常没有被处理的话,就没办法通过编译。常见的受检查异常有:IO 相关的异常、ClassNotFoundException、SQLException 等。
- 在编译过程中 ,我们即使不处理不受检查异常也可以正常通过编译。常见的不受检查异常有:空指针、数组下标越界等。
31. 异常的处理方式
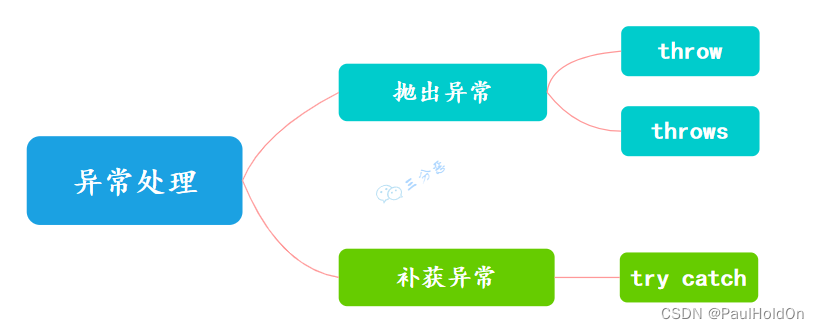
异常的处理主要有两种方式:用 try catch finally 捕获异常 或者 抛出异常。
其中 throws 是向上抛异常,throw 是手动建一个处理异常的类并抛出它。
32. Java 中 IO 流分为几种?
IO 流在 Java 中分为输入流和输出流,而根据数据的处理方式又分为字节流和字符流。
既然有了字节流,为什么还要有字符流?
字符流是由 Java 虚拟机将字节转换得到的,这个过程还算是比较耗时;
如果我们不知道编码类型的话,使用字节流的过程中很容易出现乱码问题。
33. BIO、NIO?
BIO 是传统的 IO,是阻塞的,NIO 是非阻塞的。
Java 中的 NIO 使我们可以进行非阻塞 IO 操作。比如说,单线程中从通道读取数据到缓冲区,同时可以继续做别的事情,当数据读取到缓冲区中后,线程再继续处理数据。写数据也是一样的,一个线程请求写入一些数据到通道,但不需要等待它完全写入,这个线程同时可以去做别的事情。
34. 什么是 IO 多路复用?
IO 多路复用:一个进程可以同时处理多个 IO 请求。
35. 什么是反射?反射的原理?反射在开发中的应用
什么是反射?
我们平时通过 new 来创建对象,这种方式是一种“正射”,这种方式在编译的时候就确定了对象的类型。
而如果我们想要动态地获取类里面的信息、创建类的实例、调用类里面的方法,这时候就需要用到反射。
反射的原理?
Java 程序的执行分为编译和运行两步,编译之后会生成字节码(.class)文件,JVM 进行类加载的时候,会加载字节码文件,将类的相关信息加载进方法区,反射就是去获取这些信息,然后进行各种操作。
反射的应用
正是因为反射,我们轻松地使用各种框架。
像 Spring 里的很多 注解 ,它的功能实现就是利用反射。
- @Component 注解就声明了一个类为 Spring Bean,
- @Value 注解可以读取到配置文件中的值。
这些都是基于反射操作类,然后获取到注解。注解本质上是一个标记,有了这个标记之后,我们就可以在编译或者运行阶段去识别这些标记,然后搞一些事情,这就是注解的用处。
- 比如 Spring 里面的 AOP,使用注解作为切点,做一些功能增强,这就是反射在程序运行时的应用。
- 比如使用 lombok,我们就不需要再写 getter、setter 这些方法。这就是注解在程序编译时的应用。
36. 什么时候数据在多线程并发的环境下会存在安全问题?
三个条件:
条件1:多线程并发。
条件2:有共享数据。
条件3:共享数据有修改的行为。
满足以上3个条件之后,就会存在线程安全问题。
37. 怎么解决线程安全问题?
专业术语叫做:线程同步 synchronized,让线程不能并发,线程必须排队执行。
38. 什么是线程池?
线程池是管理一系列线程的资源池。当有任务要处理时,直接从线程池中获取线程来处理,处理完之后线程并不会立即被销毁,而是等待下一个任务。
39. 为什么要用线程池?
如果没有线程池,用户每发起一个请求,就要新创建一个线程处理,创建新线程开销是很大的。比如有1000万个请求,那我们要创建1000万个线程对象,每个对象都要占内存,那电脑的系统很快就卡死了。我们又需要很多线程,又不能创建太多线程,需要使用线程池,它能够复用线程。
40. 如何创建线程池?
- 通过 ThreadPoolExecutor 构造函数来创建(推荐)。
- 通过 Executors 工具类 来创建。
41. 为什么需要泛型?
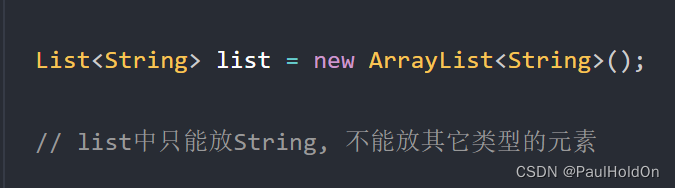
指定集合中元素的类型,避免取出集合元素时的类型转换异常。
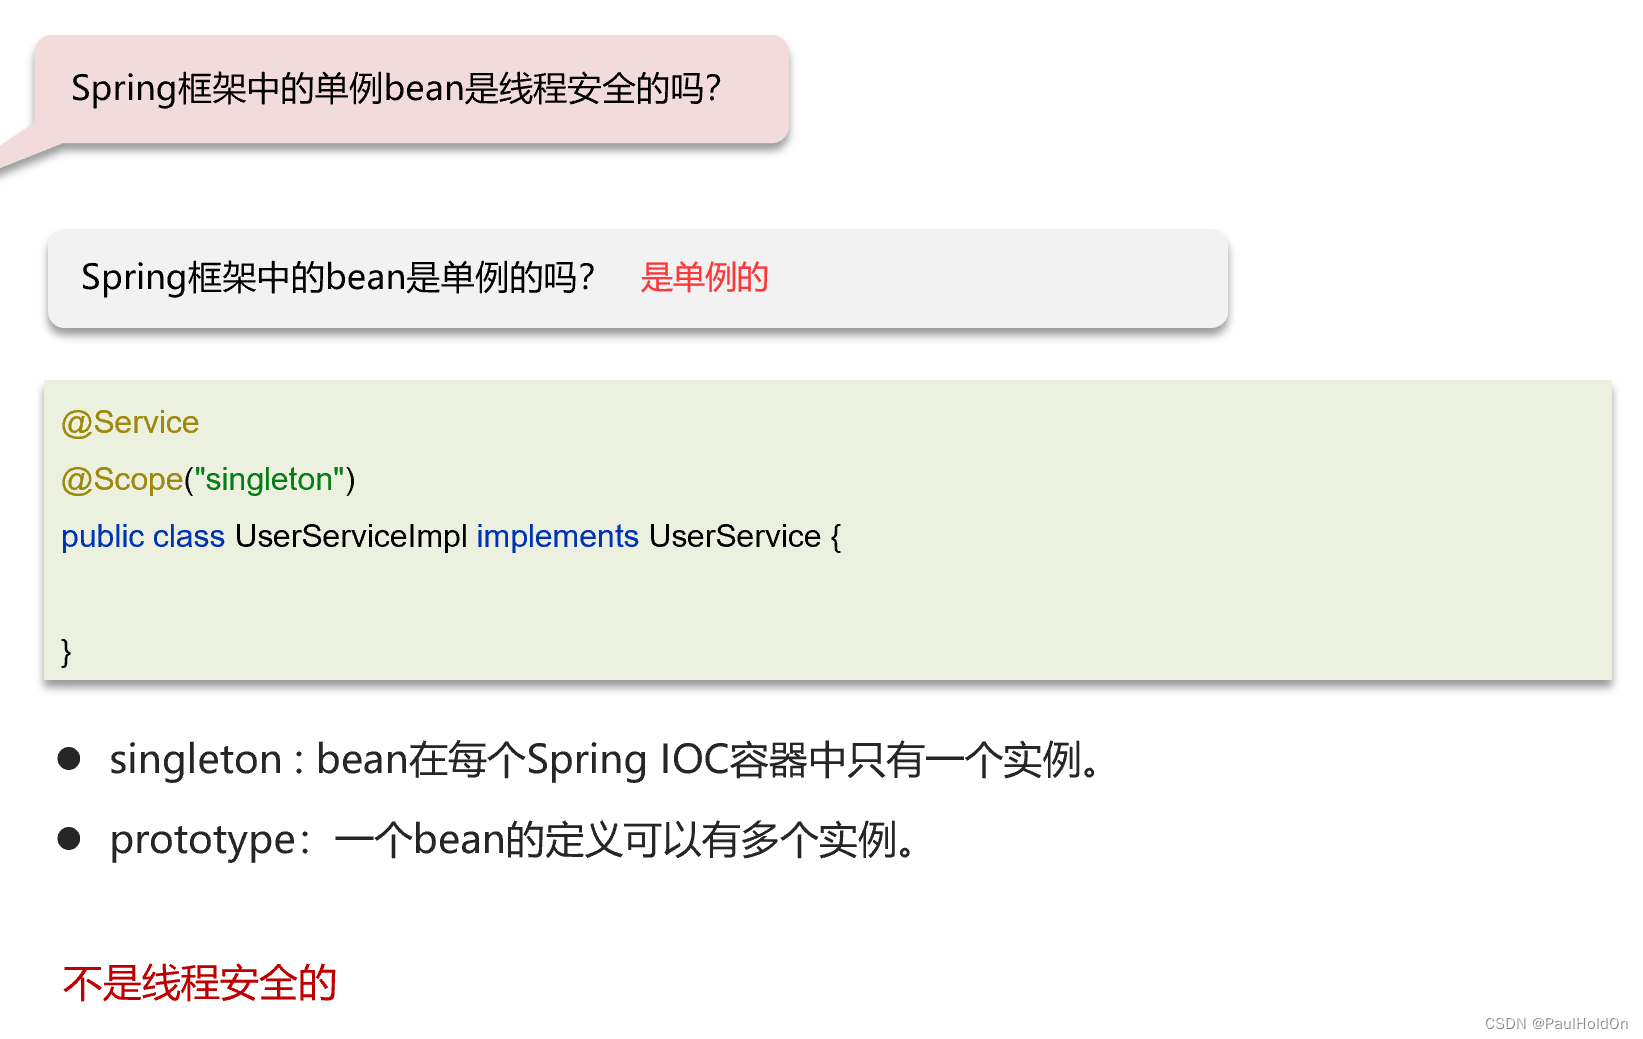
42. Spring 框架中的单例 bean 是线程安全的吗?
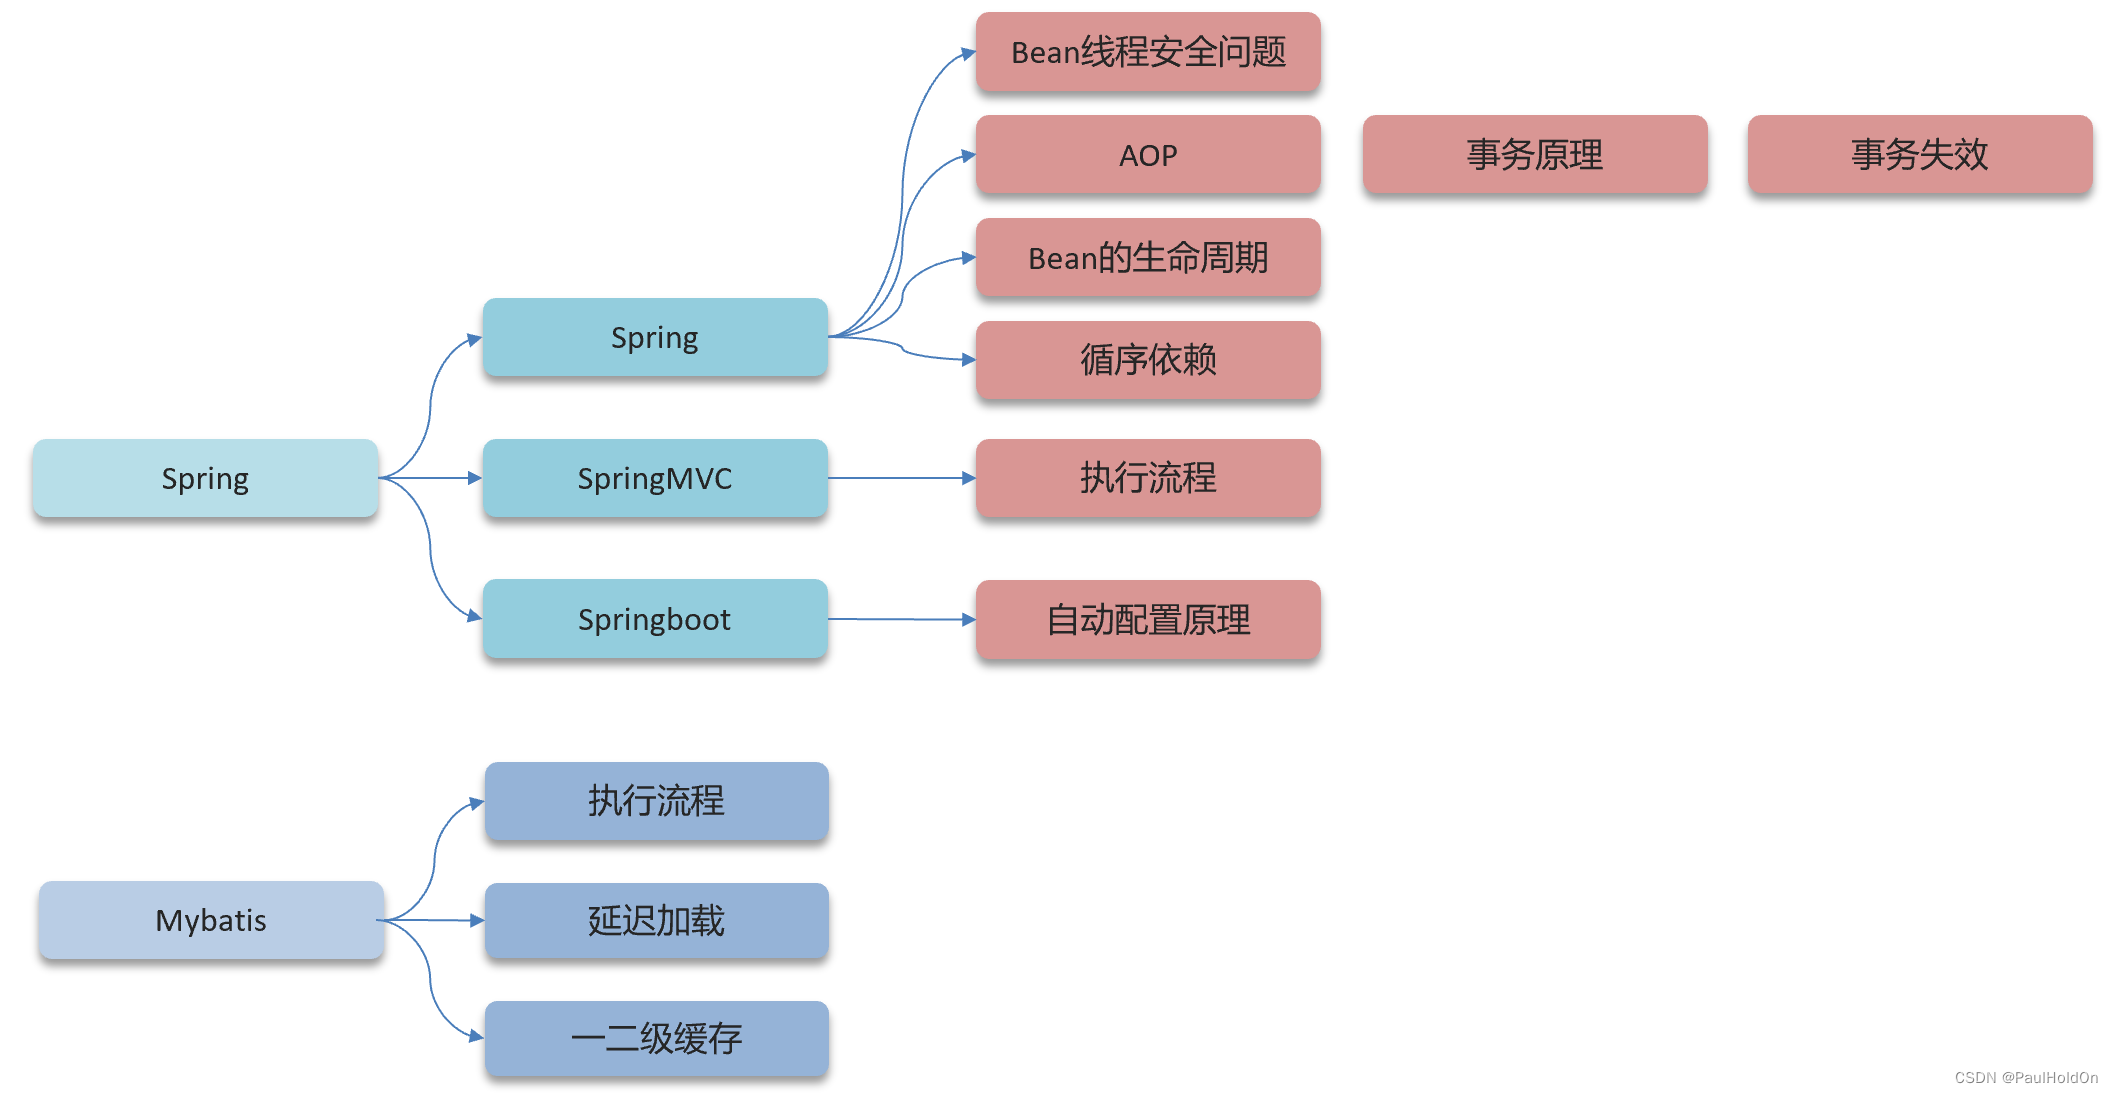
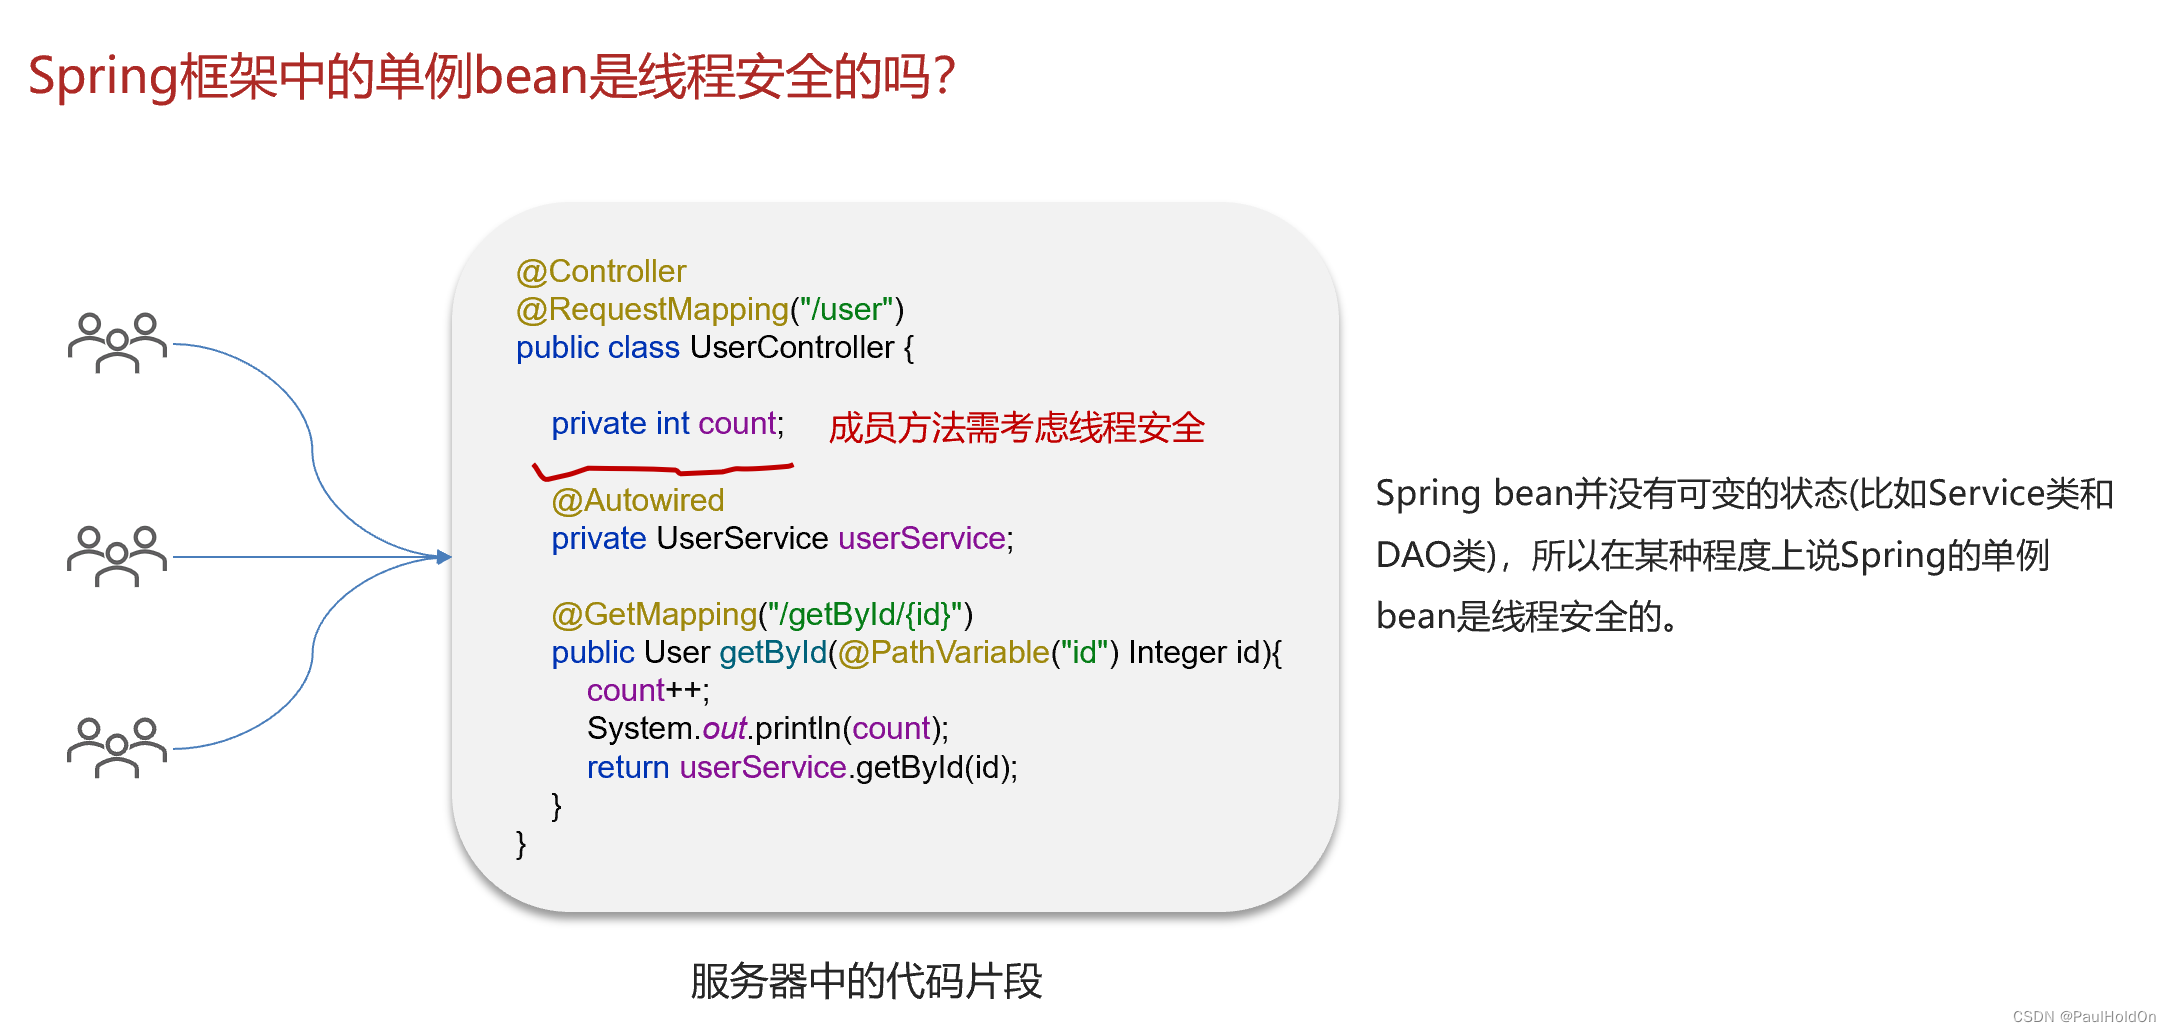
- 不是线程安全的。Spring 中有一个 @Scope 注解,默认的值就是 singleton,单例的。
- 一般在 bean 中注入的对象都是 Service 和 DAO 这样的无状态的对象,没有线程安全问题。
- 一般在开发中最好不要定义可修改的成员变量,因为要考虑线程安全问题。解决办法就是将 bean 的作用域 @Scope 由 “singleton(单例)”改为 “prototype(多例)”。
43. Spring 两大特性 IOC 和 AOP
什么是 IOC? 如何实现的?
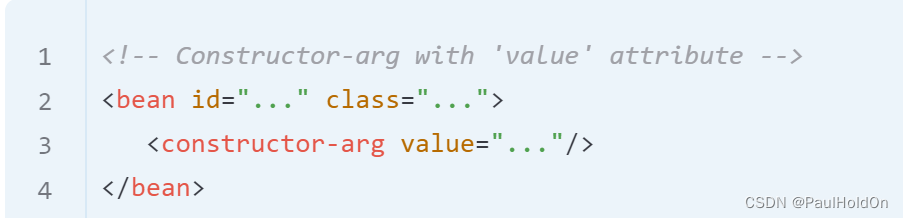
- IOC(控制反转)是一种设计思想,将原本手动创建对象的控制权,交给 Spring 容器来管理,由 Spring 容器帮我们创建对象。当我们需要创建一个对象的时候,只需要配置好相应的配置文件即可(Bean 就是那些被 IOC 容器所管理的对象),不用考虑对象是如何被创建出来的。
- Spring中的IOC的实现原理就是工厂模式加反射机制。
什么是 AOP?
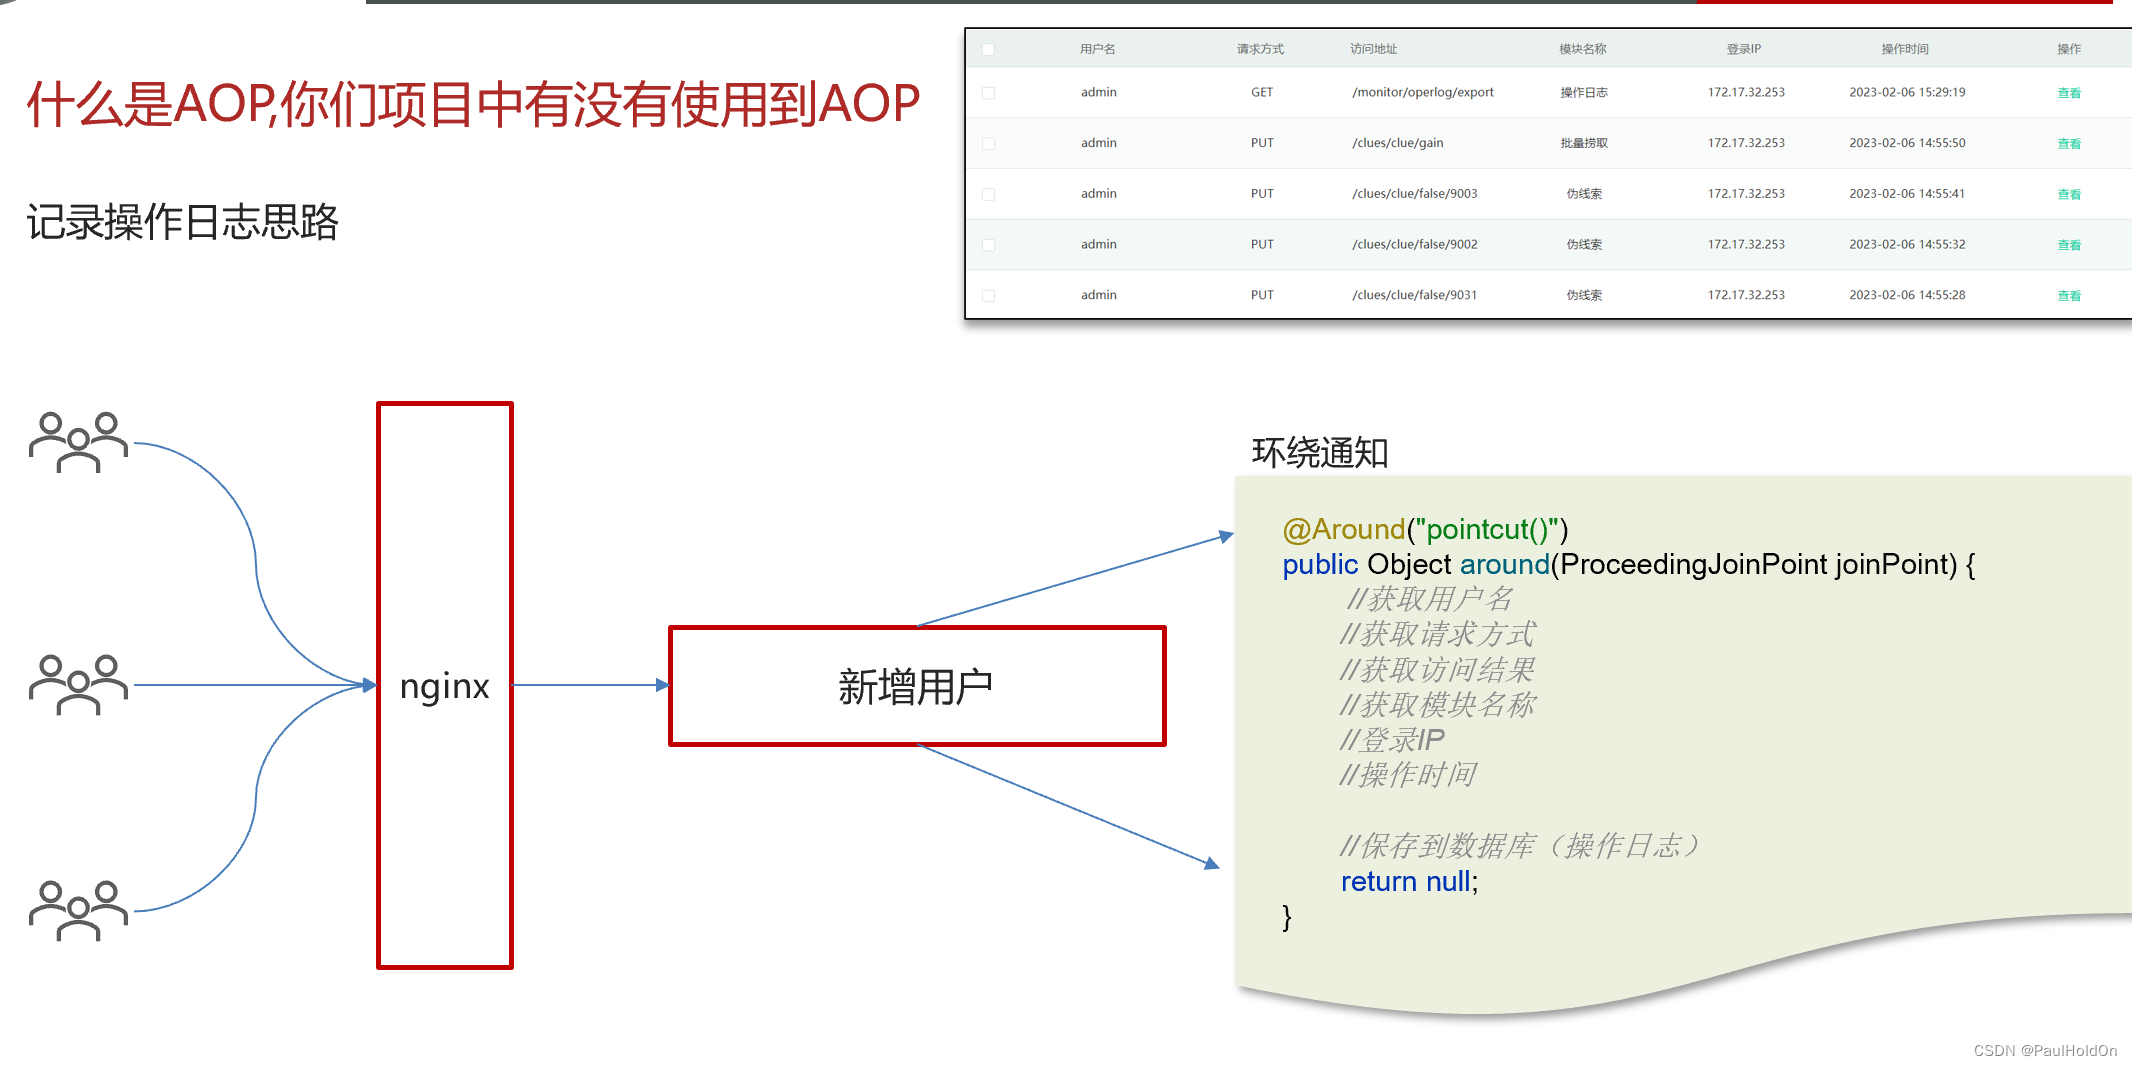
AOP(面向切面编程)是基于动态代理的。将公共的代码抽出来作为一个切面类,在这个切面类里做功能增强。主要是用来降低耦合,公共的代码不要和业务的代码写在一起。可以使用AOP用于后台管理系统中记录系统的操作日志,事务处理等。
AOP用于记录系统操作日志
AOP用于后台管理系统中记录系统操作日志:
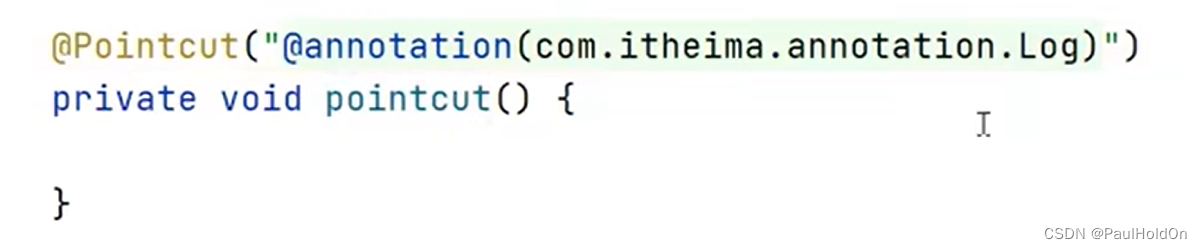
主要思路是这样的,使用AOP中的 环绕通知 和 切点表达式,这个表达式就是要找到要记录日志的方法,然后通过环绕通知进行功能增强,比如获取请求方法的参数,请求方式,登录的IP,操作时间等,将这些信息保存到数据库,记录操作日志就完成咯
切点表达式:
某个类加了Log注解,就会进入环绕通知,进行功能增强
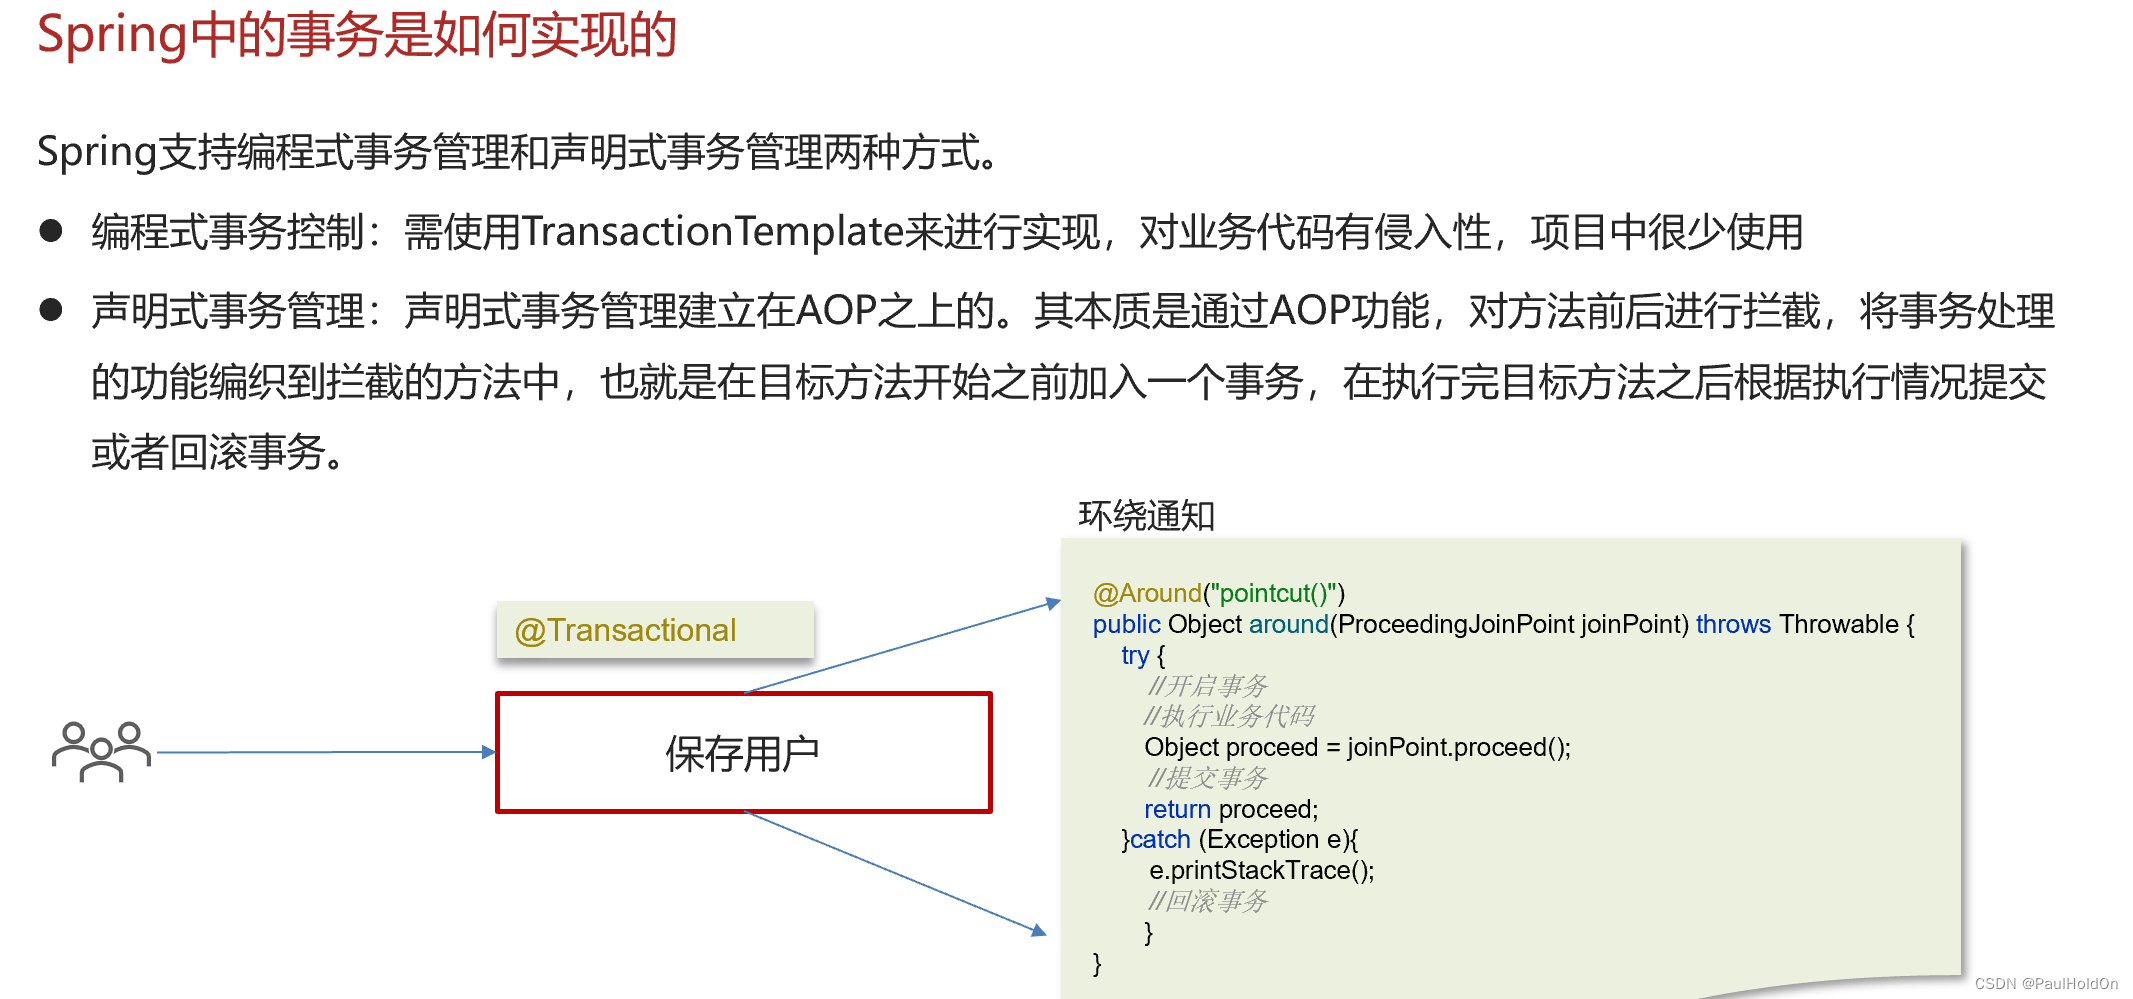
Spring中的事务是如何实现的?
Spring中的事务是AOP完成的,对方法前后进行拦截,在执行目标方法之前开启事务,执行完目标方法之后根据执行情况提交或者回滚事务,具体就是在方法或者类上加上@Transactional注解。

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 20
 0
- 0


 已为社区贡献2条内容

所有评论(0)