BILSTM原理介绍
BILSTM介绍
一、介绍
1.1 什么是LSTM和BILSTM?
LSTM的全称是Long Short-Term Memory,它是RNN(Recurrent Neural Network)的一种。LSTM由于其设计的特点,非常适合用于对时序数据的建模,如文本数据。BiLSTM是Bi-directional Long Short-Term Memory的缩写,是由前向LSTM与后向LSTM组合而成。两者在自然语言处理任务中都常被用来建模上下文信息。
1.2 为什么使用LSTM与BILSTM?
将词的表示组合成句子的表示,可以采用相加的方法,即将所有词的表示进行加和,或者取平均等方法,但是这些方法没有考虑到词语在句子中前后顺序。如句子“我不觉得他好”。“不”字是对后面“好”的否定,即该句子的情感极性是贬义。使用LSTM模型可以更好的捕捉到较长距离的依赖关系。因为LSTM通过训练过程可以学到记忆哪些信息和遗忘哪些信息。
但是利用LSTM对句子进行建模还存在一个问题:无法编码从后到前的信息。在更细粒度的分类时,如对于强程度的褒义、弱程度的褒义、中性、弱程度的贬义、强程度的贬义的五分类任务需要注意情感词、程度词、否定词之间的交互。举一个例子,“这个餐厅脏得不行,没有隔壁好”,这里的“不行”是对“脏”的程度的一种修饰,通过BiLSTM可以更好的捕捉双向的语义依赖。
二、BILSTM原理简介
2.1 LSTM介绍
2.1.1 总体框架
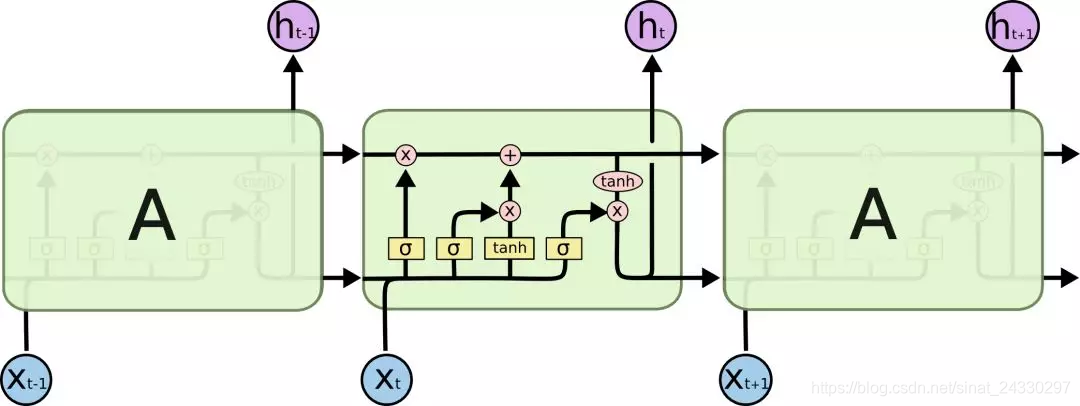
LSTM模型是由 t t t时刻的输入词 X t X_{t} Xt,细胞状态 C t C_{t} Ct,临时细胞状态 C t ~ \widetilde{^{C_{t}}} Ct ,隐层状态 h t h_{t} ht,遗忘门 f t f_{t} ft,记忆门 i t i_{t} it,输出门 o t o_{t} ot组成。LSTM的计算过程可以概括为,通过对细胞状态中信息遗忘和记忆新的信息使得对后续时刻计算有用的信息得以传递,而无用的信息被丢弃,并在每个时间步都会输出隐层状态 h t h_{t} ht,其中遗忘,记忆与输出由通过上个时刻的隐层状态 h t − 1 h_{t-1} ht−1和当前输入计算出来的遗忘门 f t f_{t} ft,记忆门 i t i_{t} it,输出门 o t o_{t} ot来控制。
总体框架如图1所示。
2.1.2 详细介绍计算过程
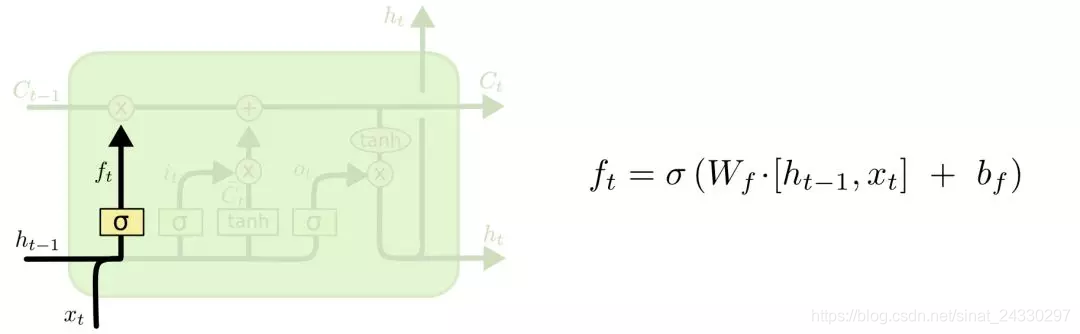
计算遗忘门,选择要遗忘的信息。
输入:前一时刻的隐层状态
h
t
−
1
h_{t-1}
ht−1,当前时刻的输入词
X
t
X_{t}
Xt
输出:遗忘门的值
f
t
f_{t}
ft
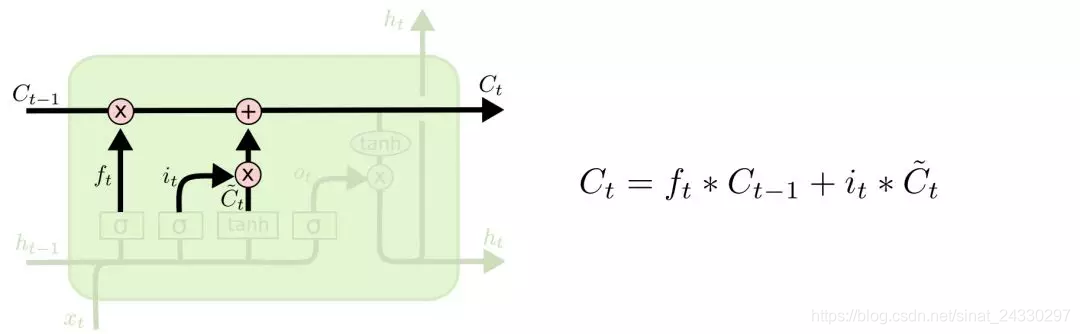
计算记忆门,选择要记忆的信息。
输入:前一时刻的隐层状态
h
t
−
1
h_{t-1}
ht−1,当前时刻的输入词
X
t
X_{t}
Xt
输出:记忆门的值
i
t
i_{t}
it,临时细胞状态
C
t
~
\widetilde{^{C_{t}}}
Ct

计算当前时刻细胞状态
输入:记忆门的值
i
t
i_{t}
it,遗忘门的值
f
t
f_{t}
ft,临时细胞状态
C
t
~
\widetilde{^{C_{t}}}
Ct
,上一刻细胞状态
C
t
−
1
C_{t-1}
Ct−1
输出:当前时刻细胞状态
C
t
C_{t}
Ct
计算输出门和当前时刻隐层状态
输入:前一时刻的隐层状态
h
t
−
1
h_{t-1}
ht−1,当前时刻的输入词
X
t
X_{t}
Xt,当前时刻细胞状态
C
t
C_{t}
Ct
输出:输出门的值
o
t
o_{t}
ot,隐层状态
h
t
h_{t}
ht

最终,我们可以得到与句子长度相同的隐层状态序列{
h
0
h_{0}
h0,
h
1
h_{1}
h1 , …,
h
n
−
1
h_{n-1}
hn−1}。
2.2 BILSTM介绍
前向的LSTM与后向的LSTM结合成BiLSTM。比如,我们对“我爱中国”这句话进行编码,模型如图6所示。

前向的
L
S
T
M
L
LSTM_{L}
LSTML依次输入“我”,“爱”,“中国”得到三个向量{
h
L
0
h_{L0}
hL0,
h
L
1
h_{L1}
hL1,
h
L
2
h_{L2}
hL2}。后向的
L
S
T
M
R
LSTM_{R}
LSTMR依次输入“中国”,“爱”,“我”得到三个向量{
h
R
0
h_{R0}
hR0,
h
R
1
h_{R1}
hR1,
h
R
2
h_{R2}
hR2}。最后将前向和后向的隐向量进行拼接得到{[
h
L
0
h_{L0}
hL0,
h
R
2
h_{R2}
hR2 ], [
h
L
1
h_{L1}
hL1,
h
R
1
h_{R1}
hR1], [
h
L
2
h_{L2}
hL2,
h
R
0
h_{R0}
hR0]},即{
h
L
0
h_{L0}
hL0,
h
L
1
h_{L1}
hL1,
h
L
2
h_{L2}
hL2}。
对于情感分类任务来说,我们采用的句子的表示往往是[
h
L
2
h_{L2}
hL2,
h
R
2
h_{R2}
hR2]。因为其包含了前向与后向的所有信息,如图7所示


有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐
 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)