记 mybatis-plus 批量插入为什么是单条的
·
记 mybatis-plus 批量插入saveBacth入坑过程
== 熊大==
背景:
- 每天定时从sftp上下载文件,解析文件组装参数然后批量入库,方便数据组抽数。
sftp上共五个文件其中有两个文件内容可能超过几百万而数据库是mysql所以决定分表。
-
按天分表结果就是表太多而且又浪费空间嫌疑所以pass。 -
按月分表程序运行一年后会导致单表数据过多所以也不符合pass。 -
按年月分表是比较符合业务需求并且不会太浪费空间所以决定按年月分表。
技术选择:
-
技术:sharding-jdbc、mybatis-plus -
数据库:mysql -
开发工具:idea -
调优工具:JProfiler
因为我们要批量插入所以用mybatis-plus自带的saveBatch方法。那为啥批量插入不用单条insert呢?
是因为一个批次插入只需要一次提交从而减少了io、网络消耗。而单条插入则相当于多次提交也就是说增加了更多的io、网络消耗。
解决办法
再次执行查看表每次递增数量:
入坑:
首先:自测放款文件。
代码如下: ` @Override
public void saveBatch() {
    StopWatch stopWatch1=new StopWatch();
    stopWatch1.start();
    batchLoanCheckFileHistoryServiceImpl.saveBatch(list());
    stopWatch1.stop();
    log.info("===========放款文件每批次插入耗时为{}",stopWatch1.getTotalTimeMillis());
    loanList.clear();
}`
每批次插入时间如下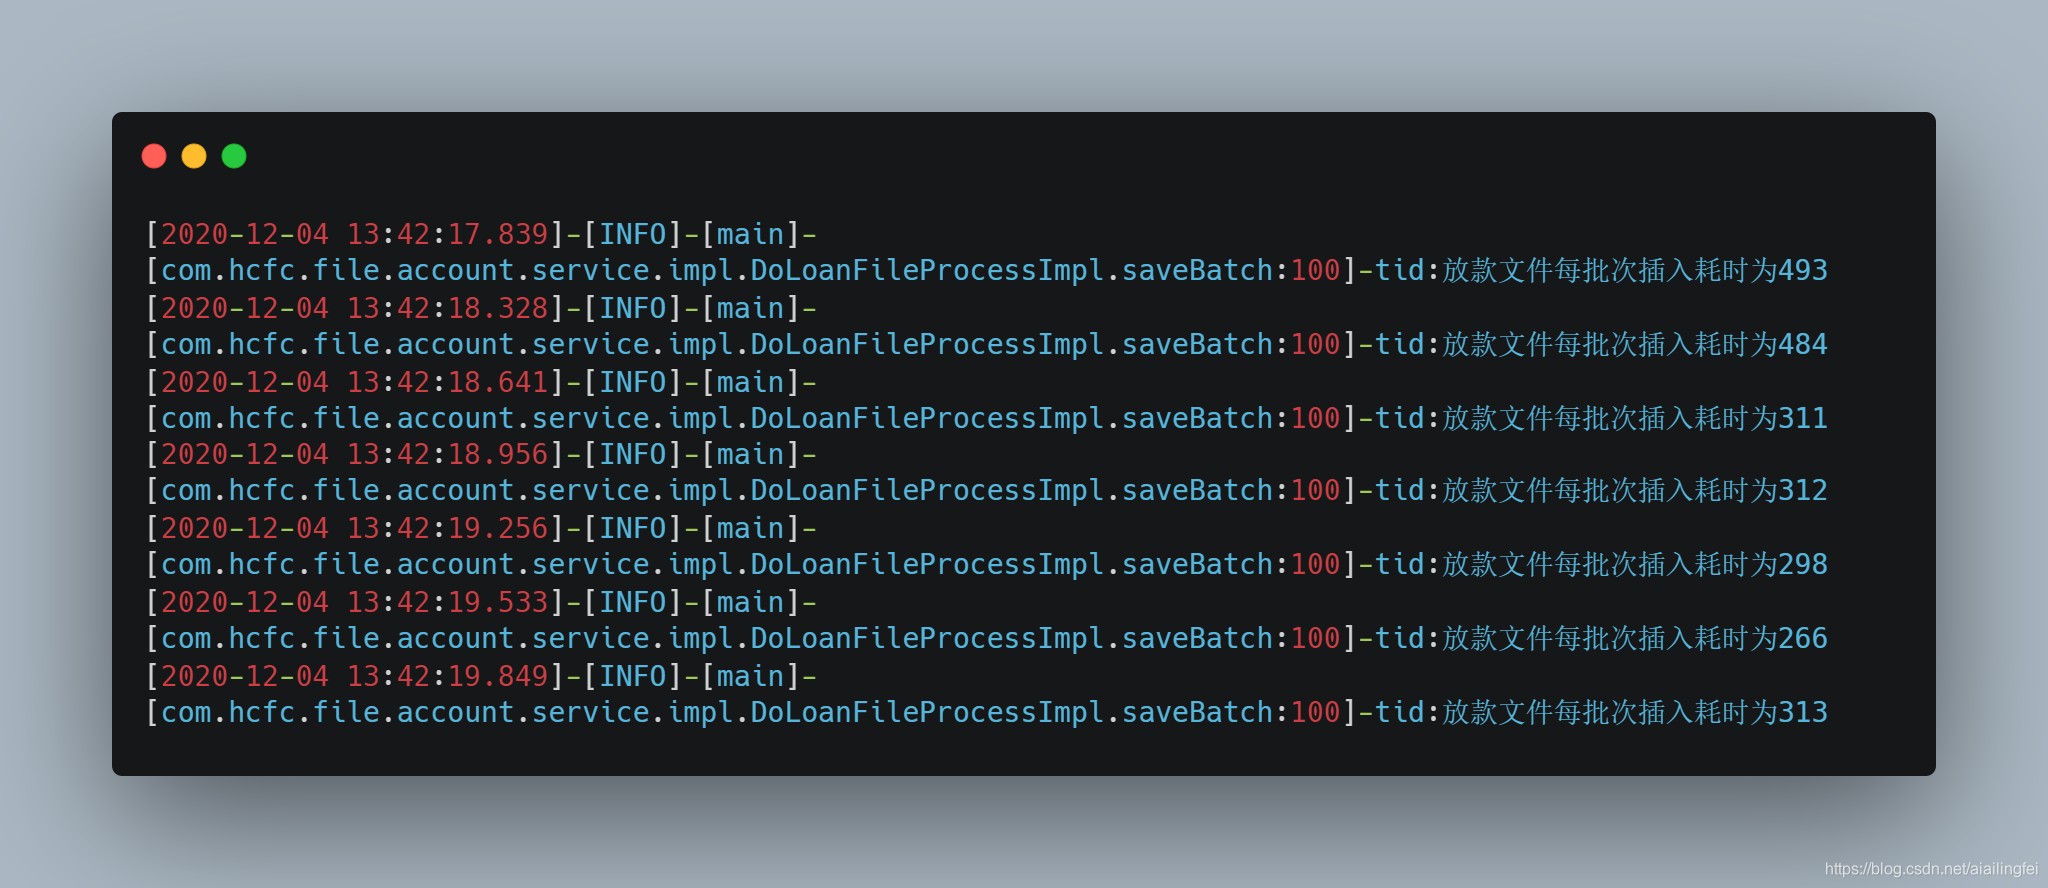
由日志可见每批次插入数据库时间为300-400毫秒之间(一个批次是1000条)一秒钟大概就是3000左右
其中在组织参数时候需要查询数据库理论来讲还可以接受。
逾期文件(大概370万得数据)
代码如下: @Override
public void saveBatch() {
    StopWatch stopWatch1=new StopWatch();
    stopWatch1.start();
    batchOverdueCustomerActualPaymentFileImpl.saveBatch(list());

    stopWatch1.stop();
    log.info("===========逾期文件落库{}",stopWatch1.getTotalTimeMillis());
    overdueCustomer.clear();
}
每批次插入时间如下: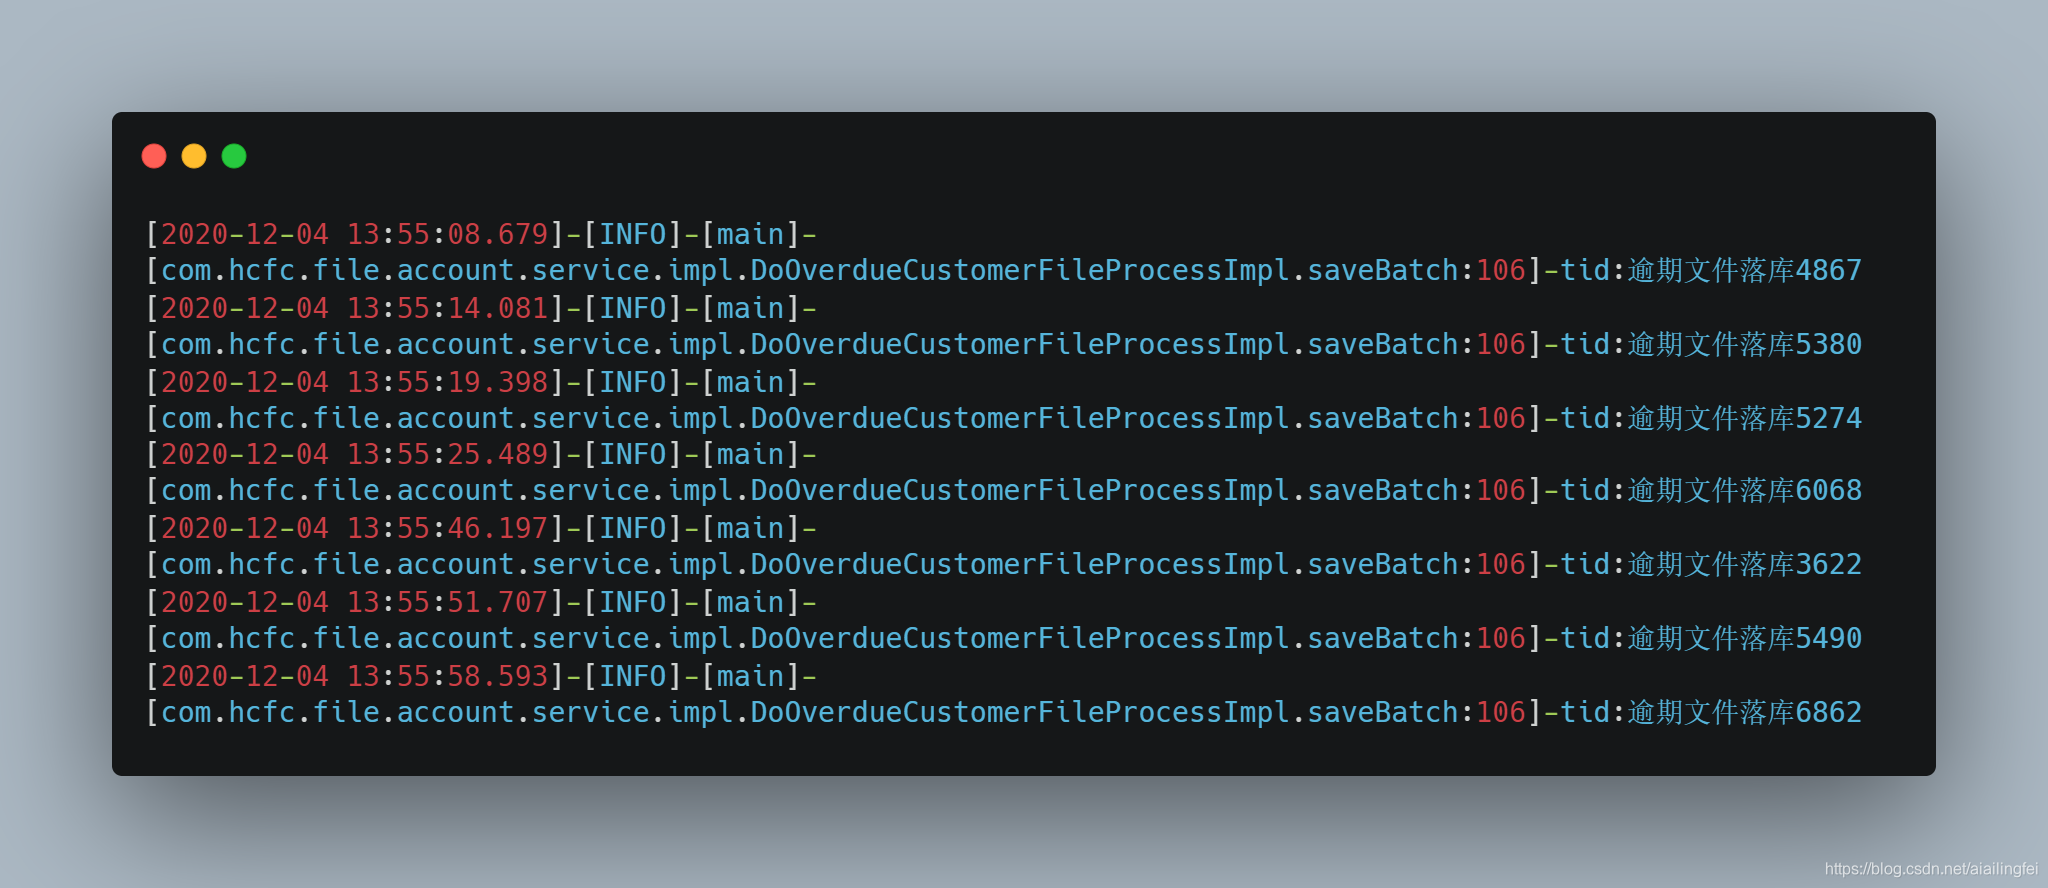
两次文件落库时间对比图如下:
通过对比发现逾期每批次落库时间竟然是放款的十几倍而且落库时间竟然高达5,6秒但是代码几乎一致为啥这个插入这么慢呢!是可忍孰不可忍,于是借助工具JProfiler进行调休看下运行时候到底哪里占用了时间。
(和idea集成请看博客link)
于是我又运行了下如图所示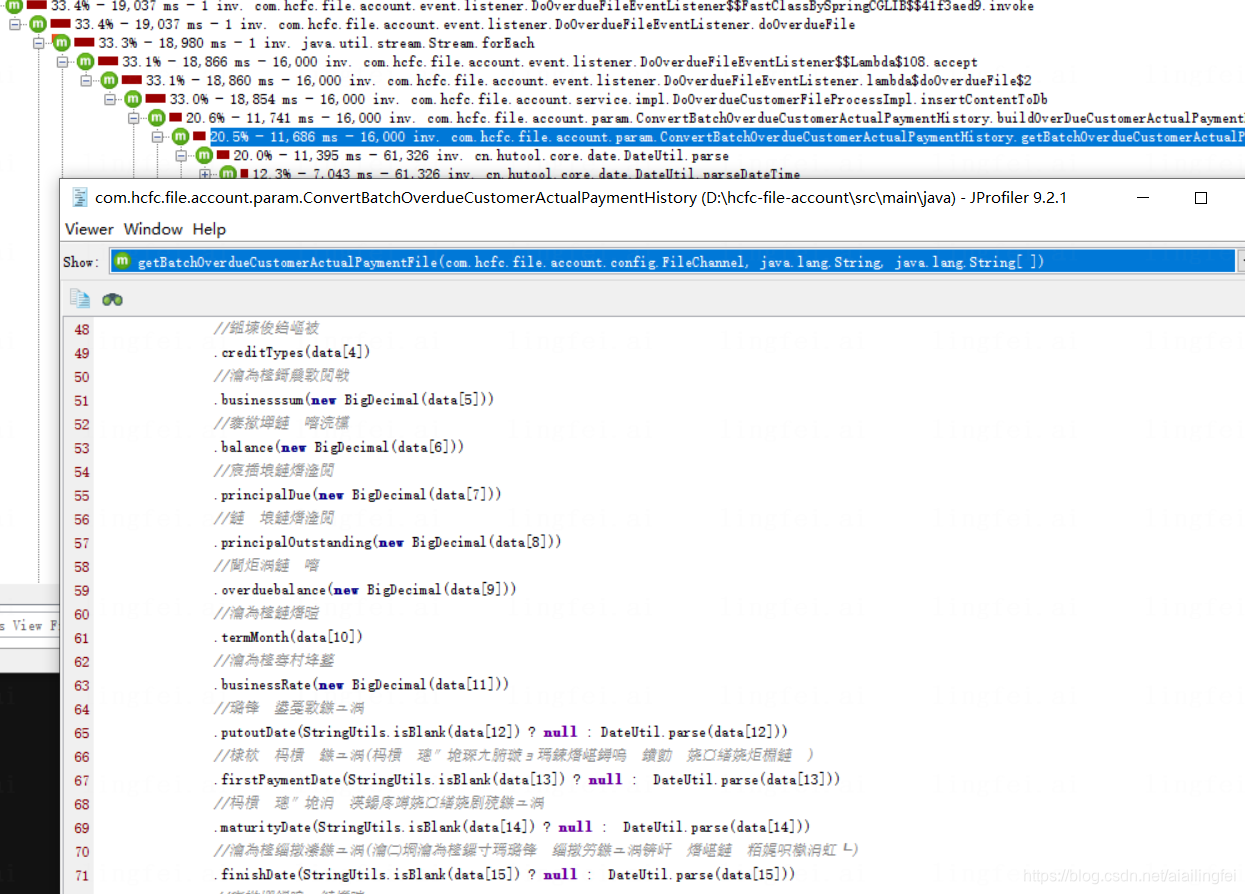
有图可见我在组织参数时候用了cn.hutool.core.date.DateUtil.parse这个方法而这个方法竟然占用了20%得时间于是我将他改成了简单时间转换SimpleDateFormate。
修改后运行如下图:
替换之后入库时间少了但是仍然在3-4秒之间仍然不能接受但是信心大增。
于是我再次运行使用神器JProfiler如下图: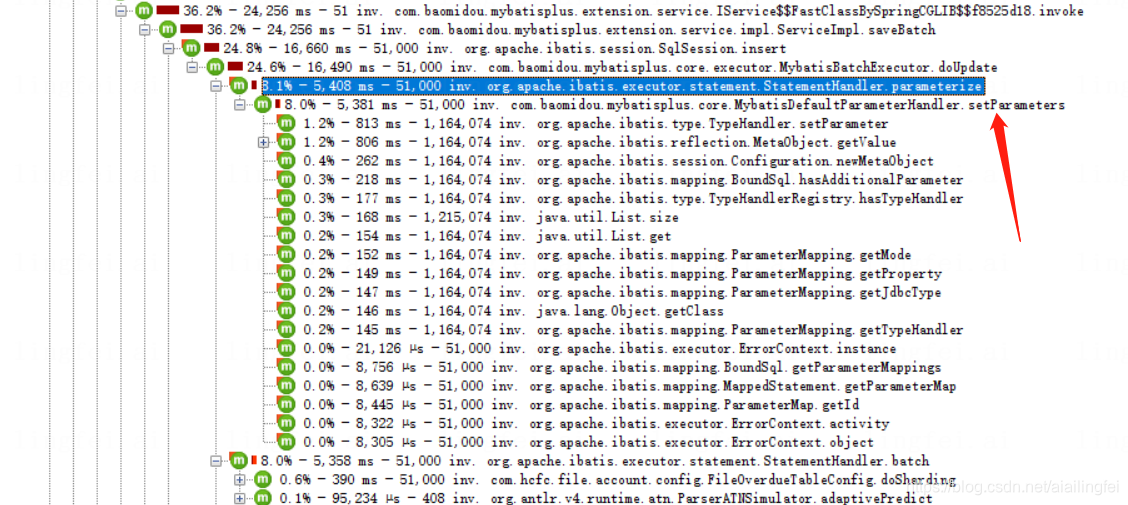
在组织参数时候竟然消耗了8%难道是字段过多反射消耗得性能。我内心窃喜于是采取了
如下操作:
-
暂时删除点字段和放款表字段数量保持一致 -
修改表得引擎由InnoDB改成(存储引擎)MYISAM
每批次插入时间如下图:
发现时间只是减少了一点点结果仍然是不可以接受。
仰天长叹太难了。
此时灵光一现又做了如下操作:
-
用loan文件与逾期文件插入时候做对比 -
对比看下sql执行过程
配置文件填上log-impl: org.apache.ibatis.logging.stdout.StdOutImpl
放款文件sql执行如下图: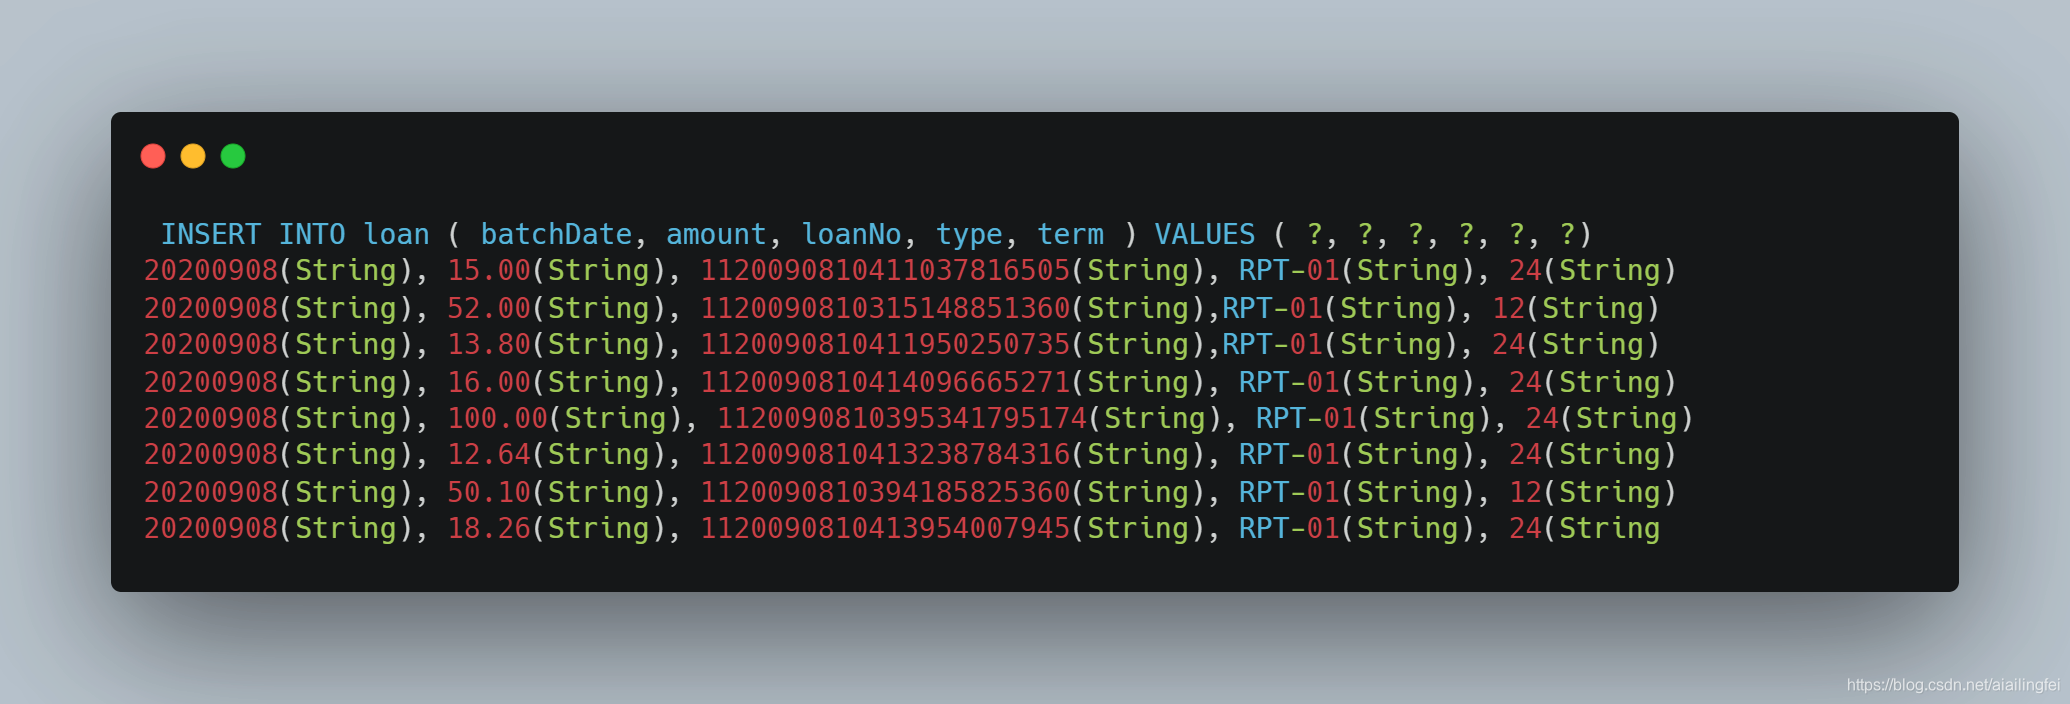
因内容较长原谅我不能完全贴出来发现他是一次性提交插入得。
逾期文件sql执行如下图: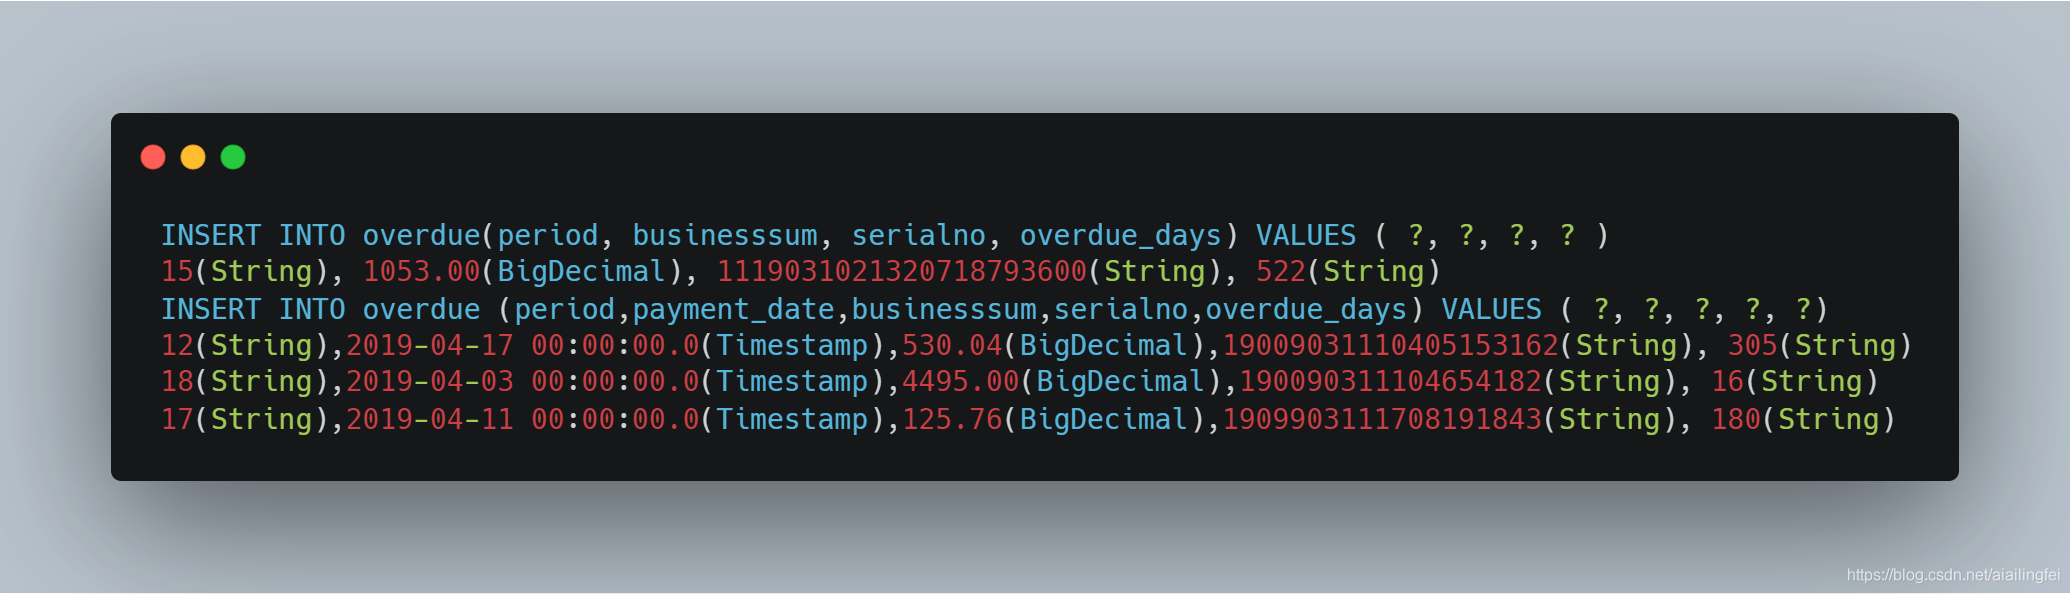
虽然代码几乎一样,但是插入时候完全不一样。逾期批次插入时候竟然不是每批次1000条插入得为啥呢?虽然此时仍然不知道为什么但是需要验证两个问题。
- plus自带得saveBatch是否有问题.
- 在插入得过程究竟是不是没批次1000条插入得。
- 在saveBatch得时候是不是传过去1000条。
首先验证第二个问题如下图: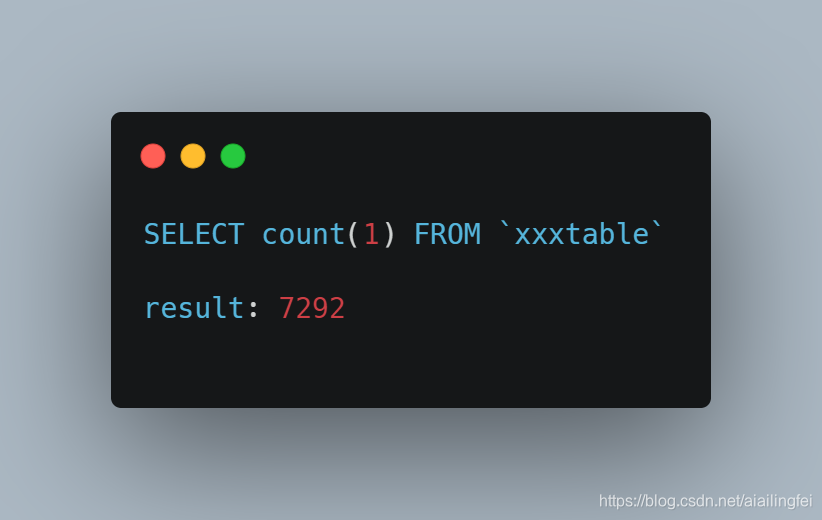
发现他的确不是按每批次1000条插入得。那是不是版本得问题呢。于是升级了版本由3.2---->3.4
然并软:仍然不是按每批次1000条插入得为什么呢?
深吸一口气,准备放大招debug,在debug的时候发现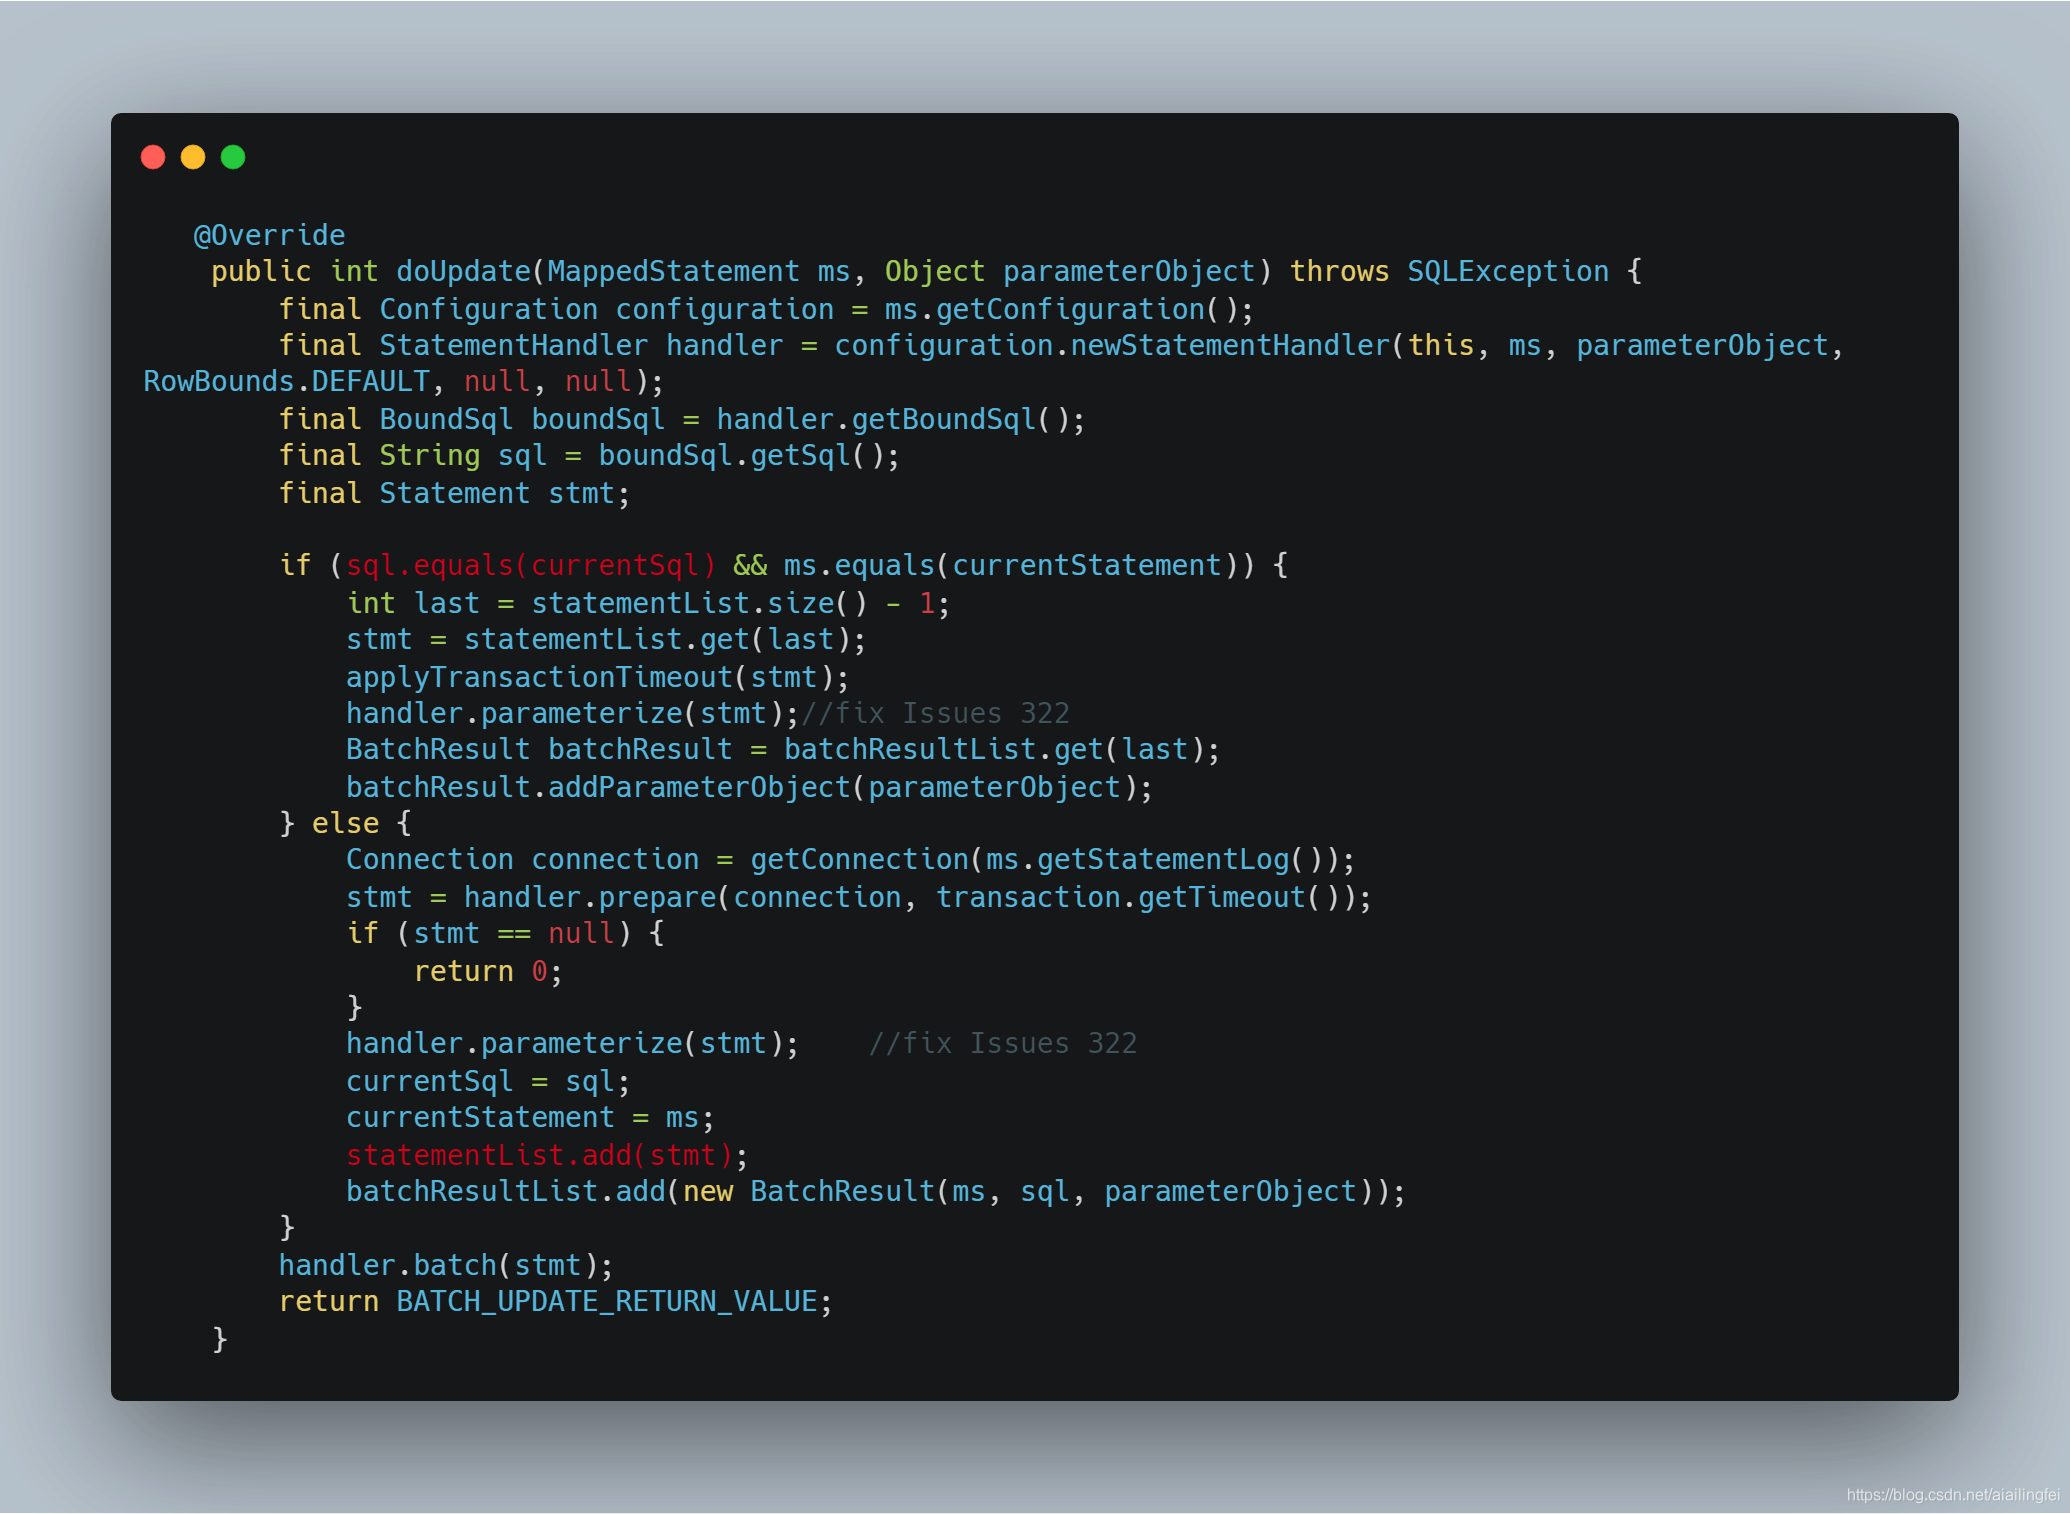
源码标红的地方会对比两个sql是否一致如果不一致则走进else将Statement加入到Statement集合中最后插入时候如下图注释
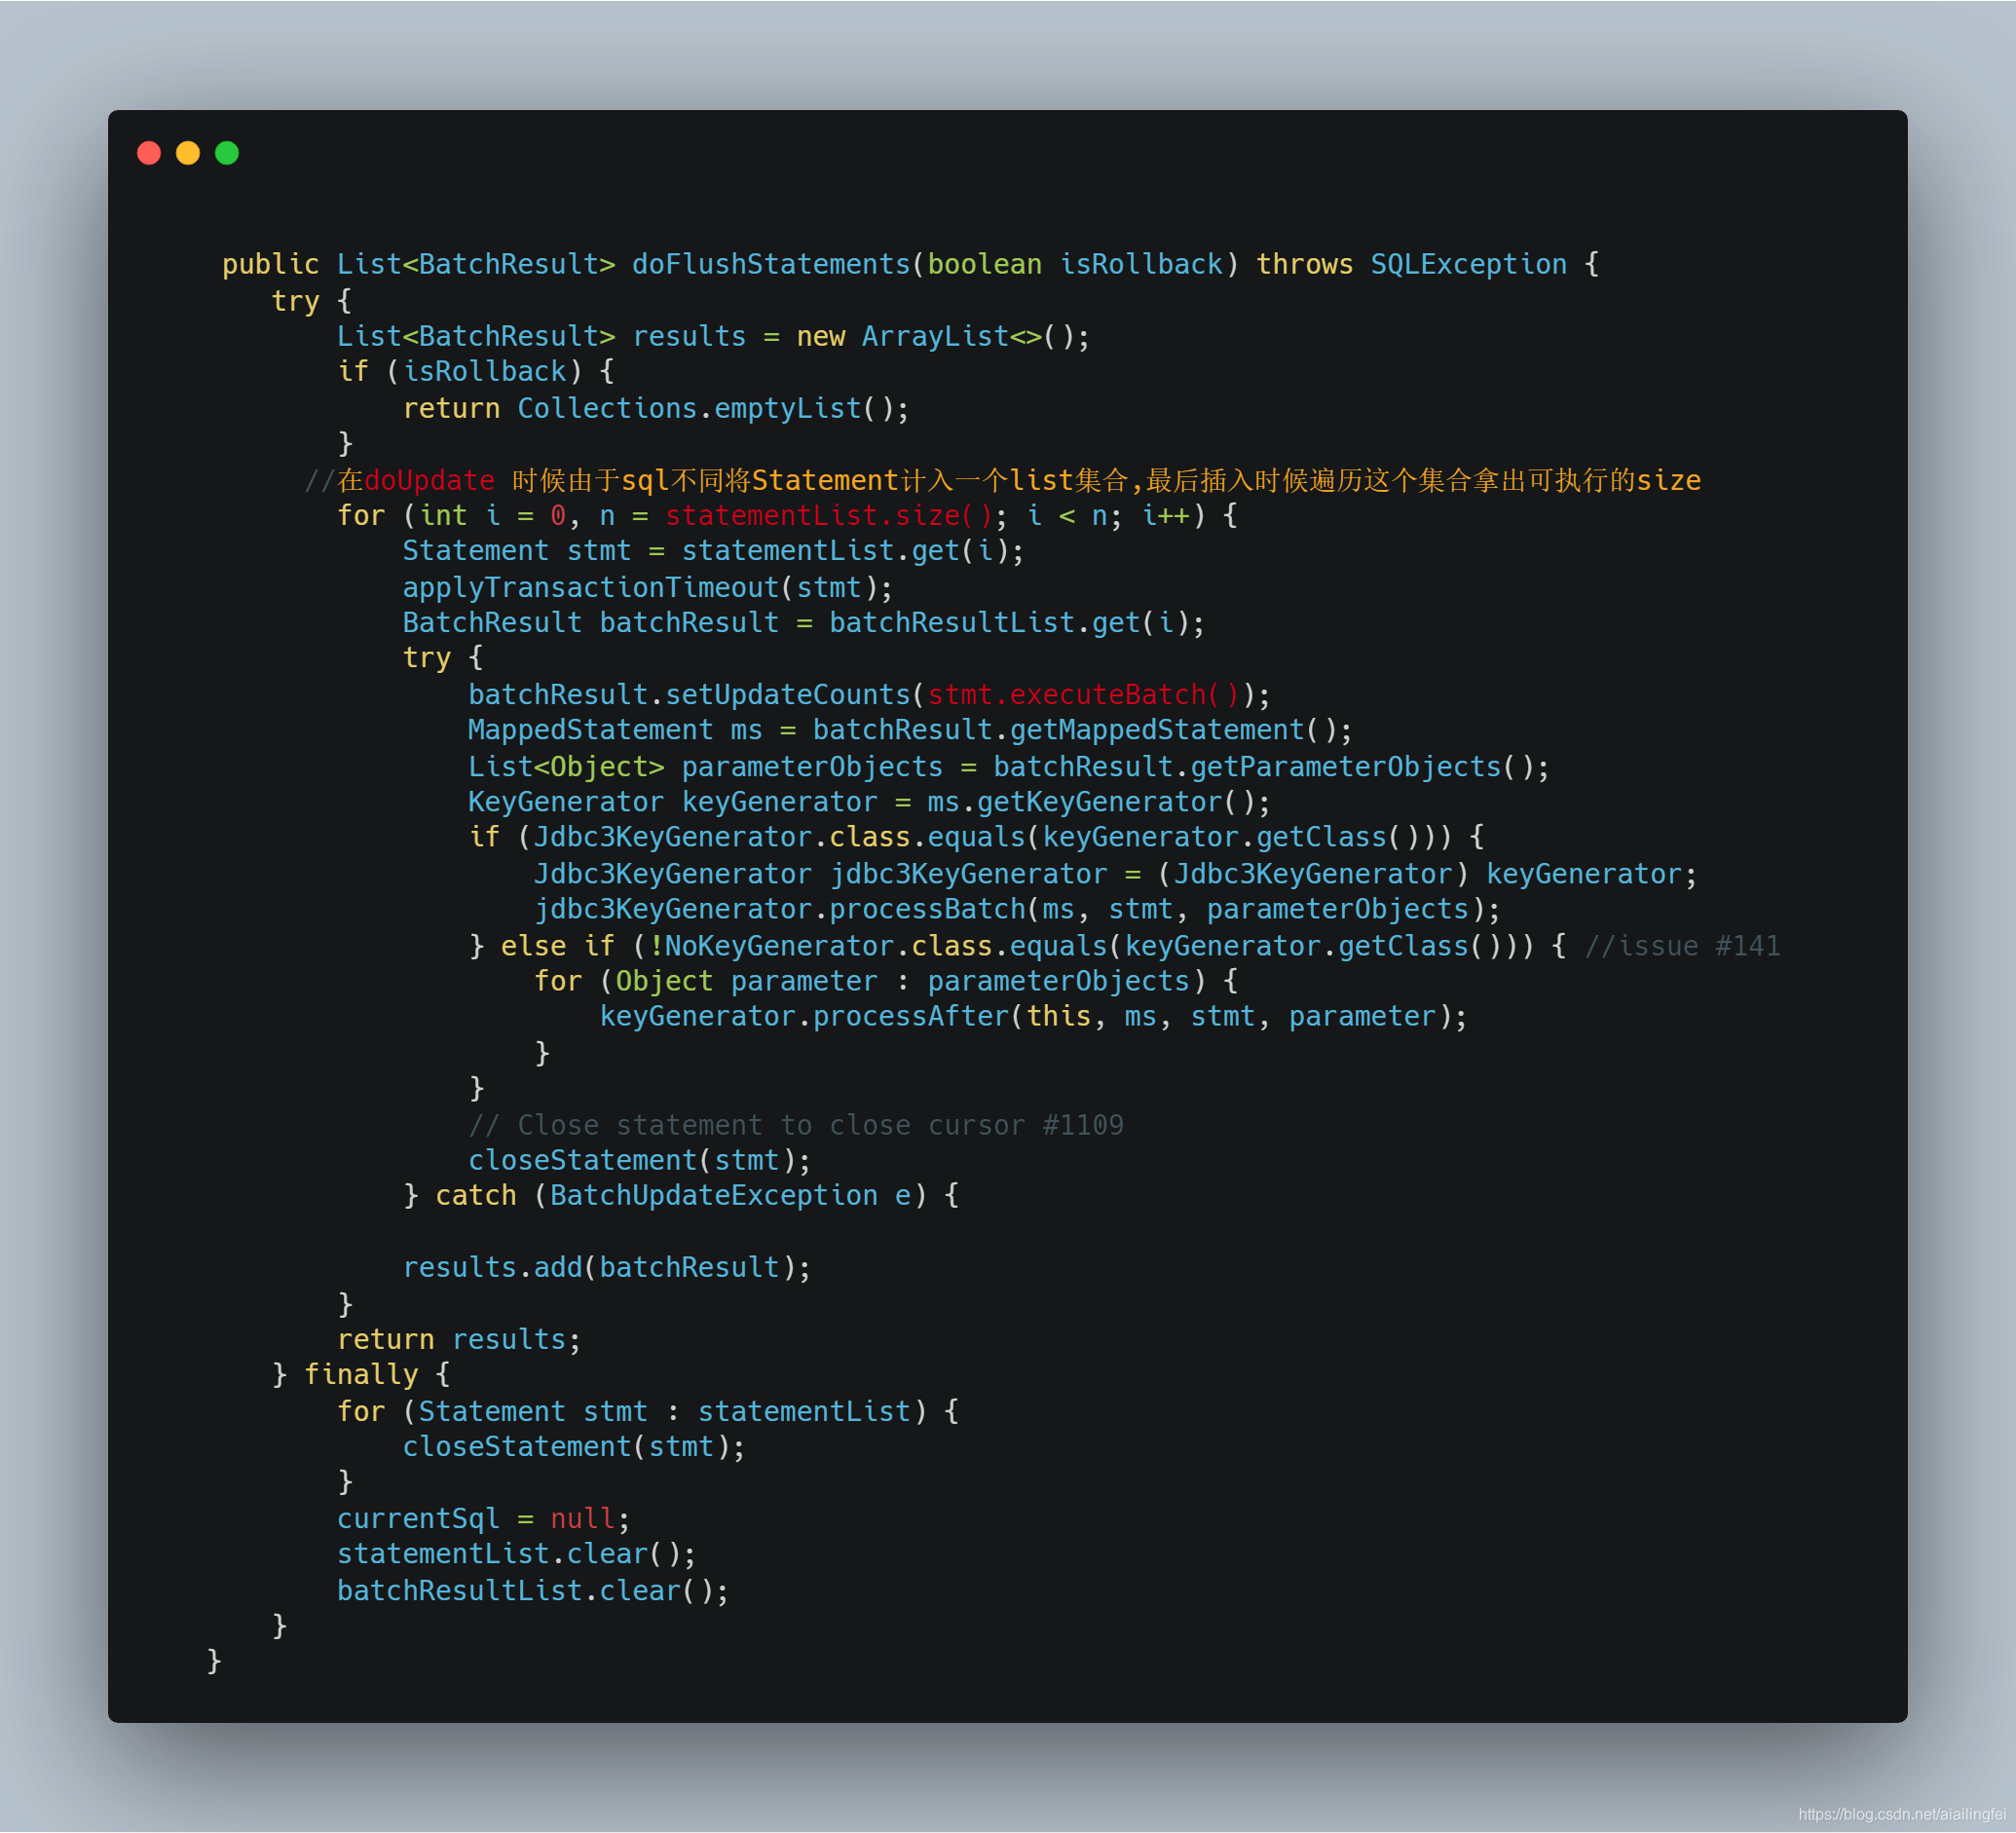
那么逾期文件落库的时候是否sql不一致呢于是我重新运行如下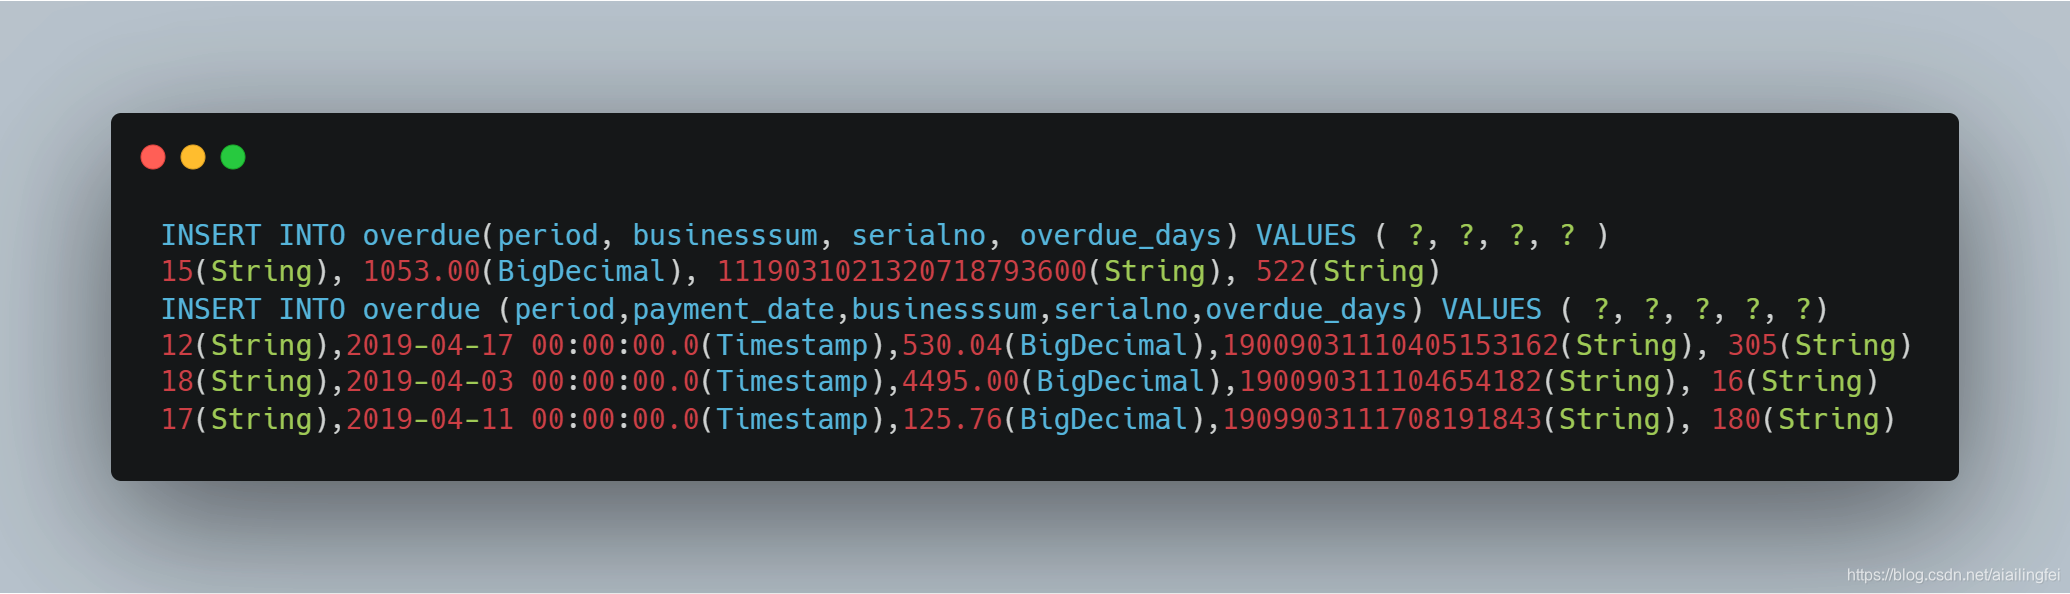
细心得人会发现这两个inser语句是不一样得比如第二个insert语句payment_date是有值得而第一个是没有得。也就是说是因为解析文件时有的列无值造成的原因那只要批量插入得时候每个sql保持一致就行。只需要在可能为空得列上添加@TableField(insertStrategy = FieldStrategy.IGNORED,fill = FieldFill.DEFAULT)(不知道是否有的兄弟跟我一样遇到过这个坑)
然后运行如下图: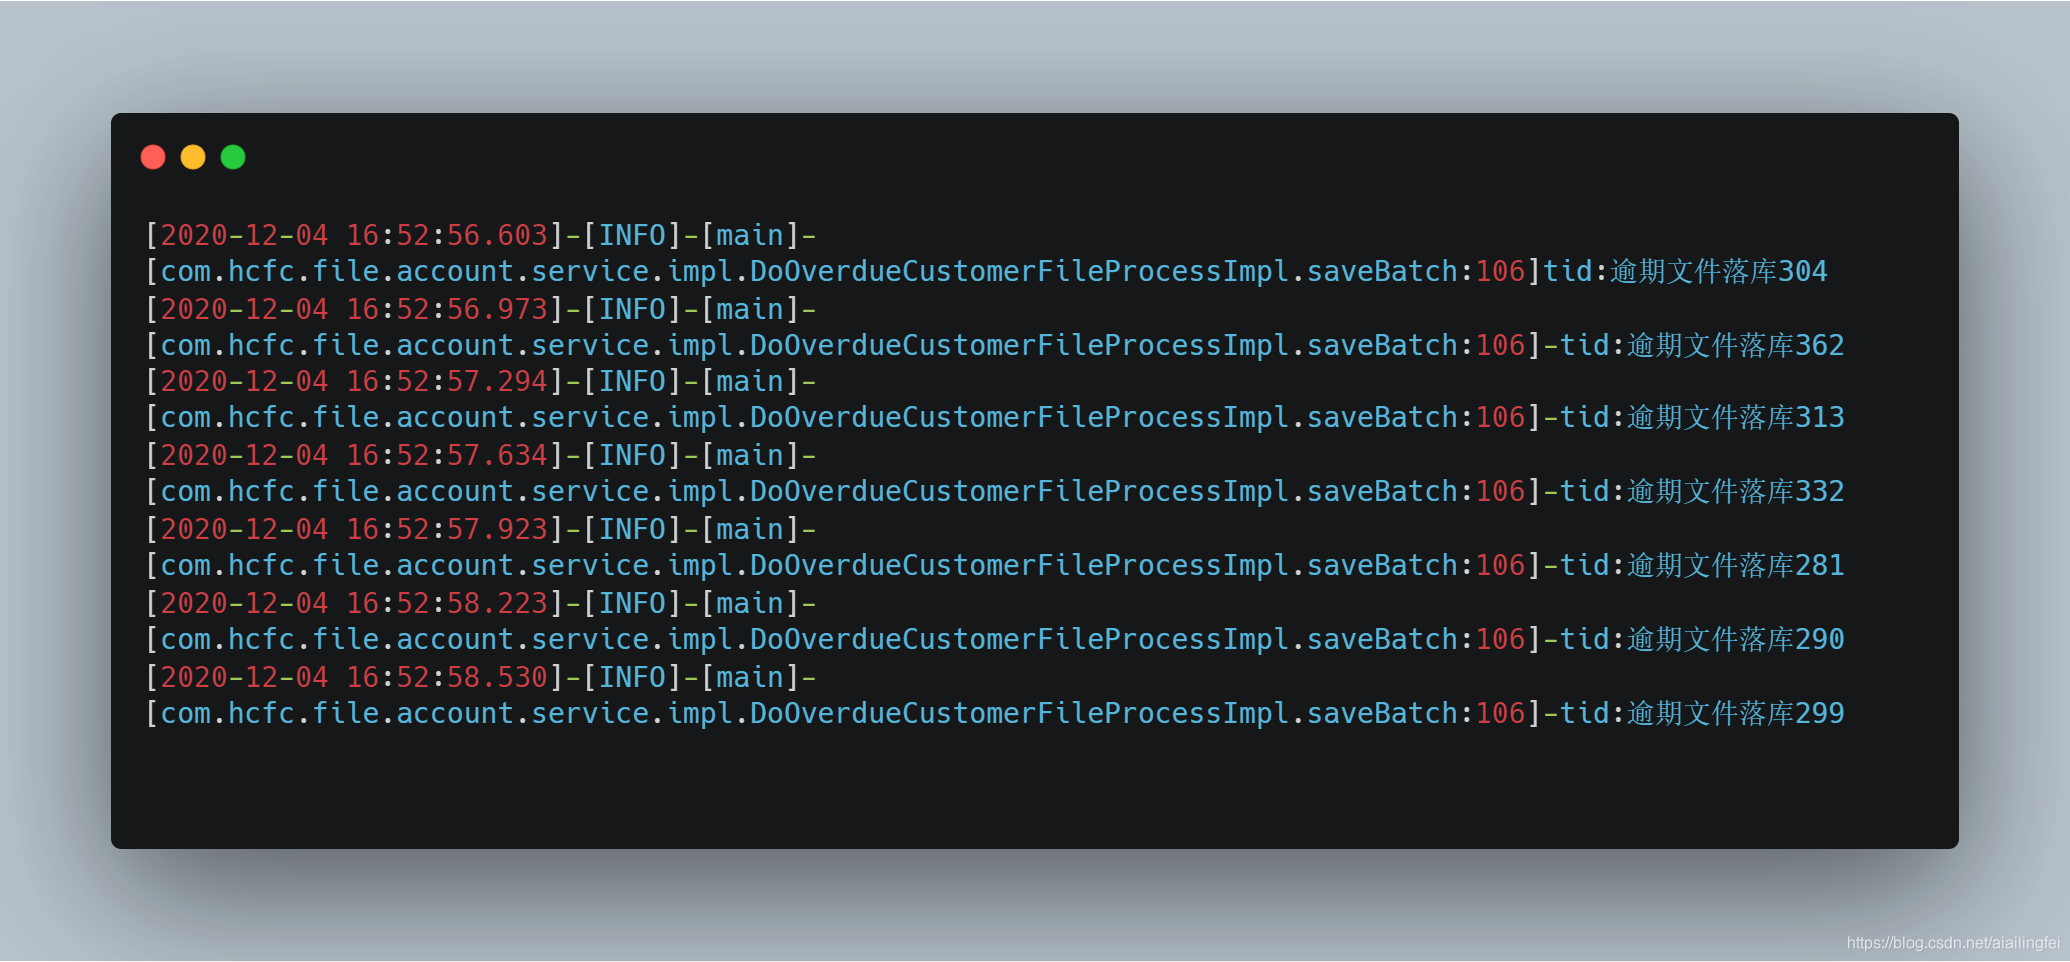
到此优化结束符合我们的预期。
结论:
虽然我每次传入了1000条但是sql不一致将不同的Statement加入集合插入的时候则遍历这个集合从而导致insert多次。
解决办法:
-
在可能为空的列上添加
@TableField(insertStrategy=FieldStrategy.IGNORED,
fill = FieldFill.DEFAULT)

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐


 8
 0
- 0


 已为社区贡献1条内容

所有评论(0)