各种激活函数及其图像
sigmoid
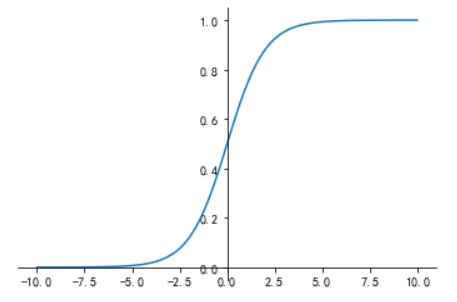
f ( z ) = 1 1 + e − z f(z)=\frac1{1+e^{-z}}f(z)=1+e−z1
其图像如下:
特点
- 能够将输入的连续实值变换为0到1之间的输出
缺点
- 在深度神经网络中梯度反向传播是容易造成梯度爆炸和梯度消失
sigmoid导数
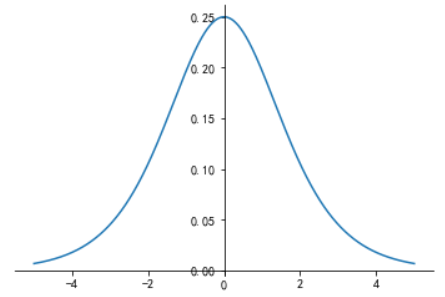
f ′ ( z ) = e − z ( 1 + e − z ) 2 = 1 1 + e − z − 1 ( 1 + e − z ) 2 f'(z) = \frac{e^{-z}}{(1+e^{-z})^2} = \frac1{1+e^{-z}} - \frac1{(1+e^{-z})^2}f′(z)=(1+e−z)2e−z=1+e−z1−(1+e−z)21
其导数图像如下:
tanh
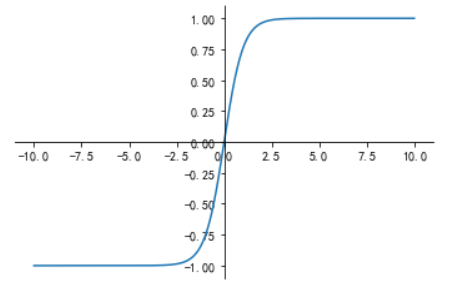
t a n h ( x ) = e x − e − x e x + e − x tanh(x) = \frac{e^x-e^{-x}}{e^x+e^{-x}}tanh(x)=ex+e−xex−e−x
其图像如下:
特点
解决了sigmoid函数不是zero-centered的问题, 但是梯度消失依旧存在
导数
t a n h ′ ( x ) = 1 − t a n h ( x ) 2 = 1 − ( e x − e − x e x + e − x ) 2 tanh'(x)=1-tanh(x)^2 = 1 - (\frac{e^x-e^{-x}}{e^x+e^{-x}})^2tanh′(x)=1−tanh(x)2=1−(ex+e−xex−e−x)2
导数图像

Relu
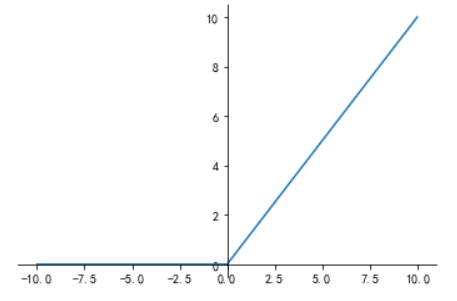
R e l u ( x ) = m a x ( 0 , x ) Relu(x)=max(0, x)Relu(x)=max(0,x)
函数图像
导数
R e l u ′ ( x ) = { 0 x ≤ 0 1 x > 0 Relu'(x) =
{01x≤0x>0{0x≤01x>0
Relu′(x)={01x≤0x>0
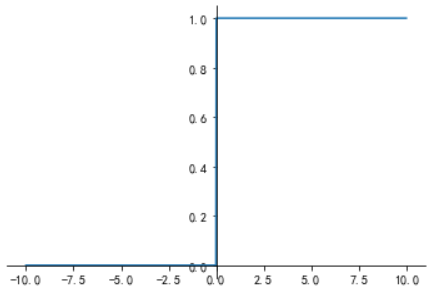
优点
- 解决了梯度消失问题
- 计算速度非常快
- 收敛速度远快于sigmoid和tanh
缺点
- 输出的不是zero-centered
- 有些神经元可能永远不会被激活(Dead ReLU)
- 不好的参数初始化
- 学习率过高, 导致网络不幸进入这种情况
Leaky Relu(PRelu)
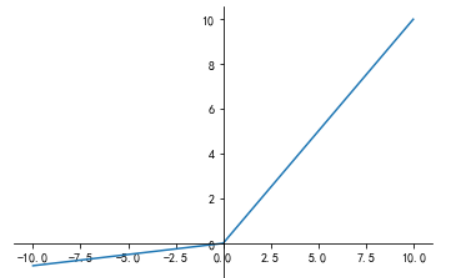
f ( x ) = m a x ( α x , x ) f(x) = max(\alpha x, x)f(x)=max(αx,x)
函数图像α = 0.1 \alpha=0.1α=0.1
导数
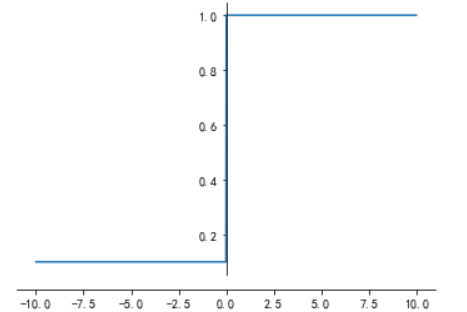
f ′ ( x ) = { α x ≤ 0 1 x > 0 f'(x) =
{α1x≤0x>0{αx≤01x>0
f′(x)={α1x≤0x>0
图像
特点
- 具有ReLU的所有优点
- 不会有Dead ReLU问题
ELU
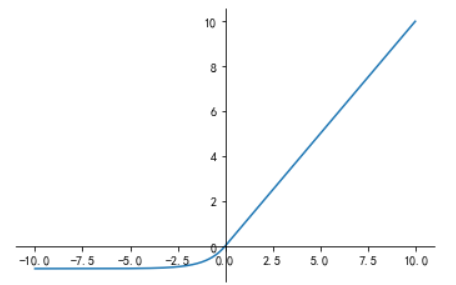
f ( x ) = { x x > 0 α ( e x − 1 ) x ≤ 0 f(x)=
{xα(ex−1)x>0x≤0{xx>0α(ex−1)x≤0
f(x)={xα(ex−1)x>0x≤0
函数图像α = 1 \alpha=1α=1
导数
f ′ ( x ) = { 1 x > 0 f ( x ) + α = α e x x ≤ 0 f'(x)=
{1f(x)+α=αexx>0x≤0{1x>0f(x)+α=αexx≤0
f′(x)={1f(x)+α=αexx>0x≤0
图像α = 1 \alpha=1α=1
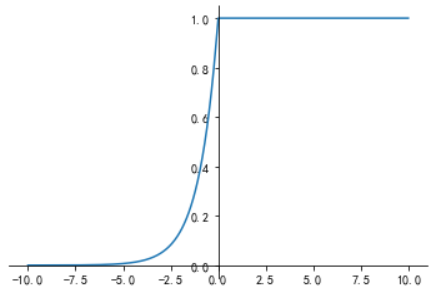
特点
- 类似于Leaky ReLU
- 计算量稍大
- 不会有Dead ReLU问题
- 均值接近于0
SELU
s e l u ( x ) = λ { x x > 0 α e x − α x ≤ 0 其 中 λ = 1.0507009873554804934193349852946 α = 1.6732632423543772848170429916717 selu(x) =\lambda
{xαex−αx>0x≤0{xx>0αex−αx≤0
\\ 其中\lambda=1.0507009873554804934193349852946\\ \alpha=1.6732632423543772848170429916717selu(x)=λ{xαex−αx>0x≤0其中λ=1.0507009873554804934193349852946α=1.6732632423543772848170429916717
函数图像
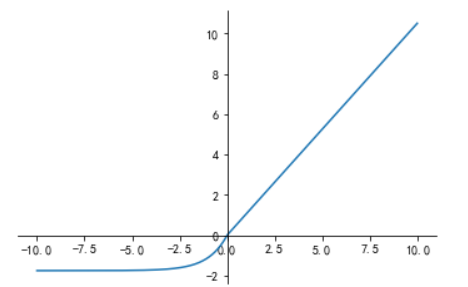
导数
s e l u ′ ( x ) = λ { 1 x > 0 α e x selu'(x)=\lambda
{1αexx>0{1x>0αex
selu′(x)=λ{1αexx>0
图像:
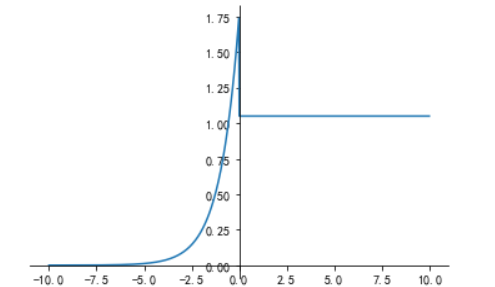
特点
- 在ELU的基础上求解了最佳的α \alphaα , 并且扩大了λ \lambdaλ倍,
- SELU拥有ELU所有的优点
- 不存在死区
SoftMax
f ( x i ) = e x i ∑ j = 1 n e x j f(x_i)=\frac{e^{x_i}}{\sum_{j=1}^ne^{x_j}}f(xi)=∑j=1nexjexi
简单地说, 就是当前元素的值就等与e的当前元素次方在所有元素的e的次方和的比例
导数
当 交 叉 熵 作 为 损 失 函 数 时 , L O S S = − ∑ i t i l n y i , 其 中 , t i 表 示 真 实 值 当 预 测 第 i 个 时 , 可 以 认 为 t i = 1 , 那 么 L O S S = − ∑ l n y i 因 为 s o f t m a x 的 和 为 1 , 那 么 e x i ∑ j = 1 n e x j , 对 L o s s 求 导 后 为 − ( 1 − ∑ i ≠ j n e x i ∑ j n e x j ) = y i − 1 当交叉熵作为损失函数时, LOSS=-\sum_it_ilny_i, 其中, t_i表示真实值 \\当预测第i个时, 可以认为t_i=1, 那么LOSS=-\sum lny_i\\因为softmax的和为1, 那么\frac{e^{x^i}}{\sum_{j=1}^ne^{x_{j}}},对Loss求导后为-(1-\frac{\sum^n_{i\neq j}e^{x_i}}{\sum^n_je^{x_j}})=y_i-1当交叉熵作为损失函数时,LOSS=−i∑tilnyi,其中,ti表示真实值当预测第i个时,可以认为ti=1,那么LOSS=−∑lnyi因为softmax的和为1,那么∑j=1nexjexi,对Loss求导后为−(1−∑jnexj∑i=jnexi)=yi−1
也就是说, 只要求出j i j_iji, 那么减一就是梯度.
特点
-
Softmax会将整个超空间按照分类个数进行划分
-
Softmax会比其他的激活函数更适合多分类问题最后的激活

有“AI”的1024 = 2048,欢迎大家加入2048 AI社区
更多推荐

 8
 0
- 0


 已为社区贡献6条内容

所有评论(0)